Autorhinweis: Am Beispiel von Meta Muse zeigt dieser Artikel, was beim Feinschliff eines KI-Agenten konkret geschliffen werden muss – der Schwerpunkt liegt auf Verhaltensabstimmung und Zustandssichtbarkeit – und liefert Schritte, die man direkt nachvollziehen kann.
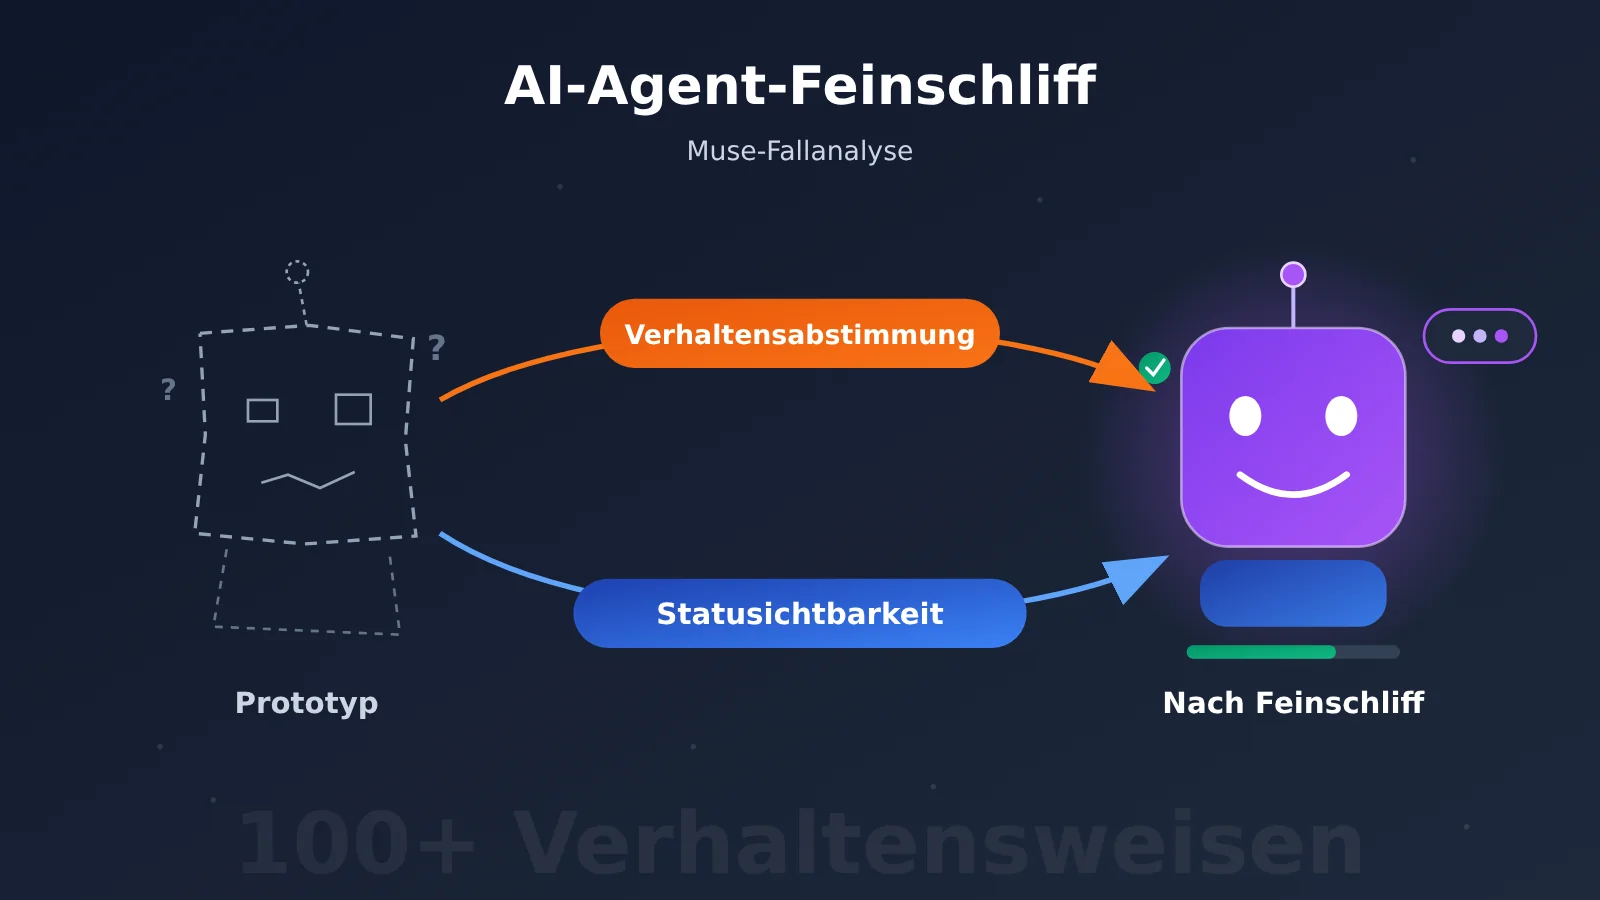
Viele Teams erleben beim Bau eines KI-Agenten dasselbe: Die Modellfähigkeiten reichen bereits aus, die Demo läuft reibungslos, doch nach ein paar Tagen echter Nutzung springen die Nutzer wieder ab. Das Problem liegt meist nicht im Modell selbst, sondern darin, dass zwei Ebenen nicht ausreichend geschliffen wurden: Verhaltensabstimmung und Zustandssichtbarkeit. Dieser Artikel nimmt Metas Muse als Fallbeispiel und schlüsselt auf, was beim Feinschliff eines KI-Agenten tatsächlich geschliffen wird.
Das ist kein weiterer schwammiger Essay nach dem Motto „Die Details entscheiden“. Öffentlichen Berichten zufolge hat das Muse-Team vor dem Launch über hundert konkrete Modellverhaltensweisen getestet und angepasst und lässt den Avatar mit Mimik und Gesten direkt anzeigen, was der Agent gerade tut. Beide Punkte lassen sich in konkrete Engineering-Aufgaben zerlegen.
Der Kernnutzen: Nach diesem Artikel kannst du „Feinschliff“ in eine Verhaltenscheckliste, eine Tabelle mit Zustandssignalen und einen Testablauf verwandeln und direkt in deinem eigenen Agentenprodukt einsetzen.
Hintergrund zum Feinschliff von KI-Agenten: Warum Muse eine genauere Betrachtung verdient
Zunächst zum Hintergrund des Falls. Berichten zufolge hat Reality Labs, der VR/AR-Bereich von Meta, allein im Jahr 2025 rund 19,2 Milliarden US-Dollar Verlust gemacht. Die Metaverse-Strategie gilt von außen betrachtet weithin als kostspieliger Fehlschlag. Danach zog sich Zuckerberg jedoch nicht auf das Werbegeschäft zurück, sondern investierte weiter in KI-Agenten. Rund sechs Wochen nach dem Start von Muse wurden laut Berichten bereits 10 Millionen Nutzer erreicht.
Zwei Details des Projekts hängen direkt mit dem Feinschliff zusammen. Erstens wird das Team von Alexander Wang und Nat Friedman von Scale AI geleitet; Wang zufolge kommen Modell- und Produktlinie zusammen auf weniger als 200 Personen. Das kleine Team ist Absicht: Es soll die Kompromisse und inkonsistenten Erfahrungen vermeiden, die entstehen, wenn große Teams Entscheidungen per Konsens treffen. Zweitens ist Muse nicht als „das intelligenteste Modell auf dem Markt“ positioniert. Seine Stärke liegt darin, die Lücke zwischen dem, was ein Modell technisch kann, und dem, wie es sich für normale Menschen im Alltag anfühlt, zu verkleinern – etwa bei Alltagsaufgaben wie Abos kündigen oder Rechnungen im Blick behalten.
Für Entwickler sind Umsatz und Größe von Muse wenig aussagekräftig. Aufschlussreich ist vielmehr, wie das Projekt Feinschliff versteht: Feinschliff ist eine Reihe konkreter, testbarer Verhaltensweisen – kein Marketingbegriff.
Kernpunkte bei der Ausarbeitung von KI-Agenten
Abstrahiert man die Herangehensweise von Muse, lassen sich die Feinarbeit an KI-Agenten in folgende Richtungen einordnen:
| Aspekt | Beschreibung | Nutzen für Anwender |
|---|---|---|
| Verhaltensabstimmung | Vor dem Launch wird konkretes Modellverhalten Punkt für Punkt getestet und angepasst (bei Muse über hundert Punkte) | Die Reaktionen des Agenten sind vorhersehbar und schwanken nicht ständig |
| Entscheidungsgrenzen | Klar festlegen, wann der Agent selbst handelt und wann er zuerst den Nutzer fragt | Weniger Störungen, ohne Kompetenzüberschreitung |
| Sichtbarkeit des Status | Mit visuellen oder textlichen Signalen zeigen, was der Agent gerade tut | Nutzer müssen nicht raten: „Hat es verstanden? Arbeitet es gerade?“ |
| Konsistenz der Erfahrung | Verhalten bleibt über verschiedene Einstiegspunkte und Seiten hinweg gleich | Kleine Reibungen summieren sich nicht zu spürbaren Nutzungskosten |
| Randfälle | Fehler, Unterbrechungen sowie zweite und dritte Tabs werden sorgfältig behandelt | Auch bei täglicher, wiederholter Nutzung bleibt es angenehm |
Schwerpunkt eins: Verhaltensabstimmung ist nicht gleich „schlaueres Modell“
„Das Modell ist sehr klug“ und „der Agent ist gut nutzbar“ sind zwei verschiedene Dinge. Ein sehr leistungsfähiges Modell kann trotzdem nerven, wenn es nicht weiß, wann es innehalten und nachfragen soll, wann es direkt handeln darf und wie es den Fortschritt meldet. Genau um diese Punkte geht es bei den über hundert Verhaltensweisen, die das Muse-Team abgestimmt hat.
Gegenstand der Verhaltensabstimmung ist die Reaktionsweise in konkreten Situationen, nicht die Modellparameter. Wenn der Nutzer zum Beispiel sagt: „Hilf mir, dieses Abo zu kündigen“ – sollte der Agent dann zuerst die gefundenen Abos auflisten und um Bestätigung bitten oder direkt handeln? Muss beim Erreichen der Zahlungsseite noch einmal bestätigt werden? Jeder solche Entscheidungspunkt ist eine Verhaltensweise, die getestet und festgelegt werden muss.
Schwerpunkt zwei: Sichtbarkeit des Status ist Designarbeit
Der Avatar von Muse zeigt über kleine Animationen an, „was gerade läuft“ – der Nutzer muss keine technischen Statusmeldungen lesen. Das beantwortet die Frage, die jeder hat, der eine Aufgabe an eine KI übergibt: Hat es verstanden, was ich meine? Macht es das wirklich?
Dieses Unsicherheitsgefühl zu beseitigen, ist Designarbeit – und zwar in jedem Winkel des Produkts, nicht nur im Demo-Ablauf. Berichten zufolge hat Meta vor der Veröffentlichung seiner Smartphone-App bereits Technologie zur Erzeugung sprachsynchroner Gesichtsausdrücke und Bewegungen entwickelt, um sich auf Echtzeit-Spracherlebnisse und künftige Wearables vorzubereiten. Die meisten Unternehmen schieben diese Ebene auf „nach der Validierung der Kernidee“ – Muse hat es vorgezogen.
AI-Agent-Feinschliff: Schnellstart mit 6 praktischen Schritten
Im Folgenden übertragen wir den Ansatz von Muse auf einen Prozess, den auch kleine und mittlere Teams umsetzen können. Es braucht keine Hundertschaft an Mitarbeitenden und kein Budget in Milliardenhöhe – sondern die Geduld, konsequent eine zweite und dritte Runde zu drehen.
Schritt 1: Verhaltenscheckliste für den AI-Agenten erstellen
Halten Sie zuerst die Entscheidungspunkte fest, auf die der Agent bei echten Aufgaben stößt. Notieren Sie zu jedem Punkt klar „Auslösebedingung, erwartetes Verhalten, Gegenbeispiel“. 30 bis 50 Einträge reichen für den Anfang; danach ergänzen Sie laufend anhand des Testfeedbacks. Hier eine kategorisierte Orientierung:
| Verhaltenskategorie | Typischer Entscheidungspunkt | Qualitätskriterium |
|---|---|---|
| Absichtsbestätigung | Die Anweisung ist mehrdeutig, z. B. „Kündige das Abo“ | Bei mehreren möglichen Optionen diese zur Auswahl stellen, statt selbst zu raten |
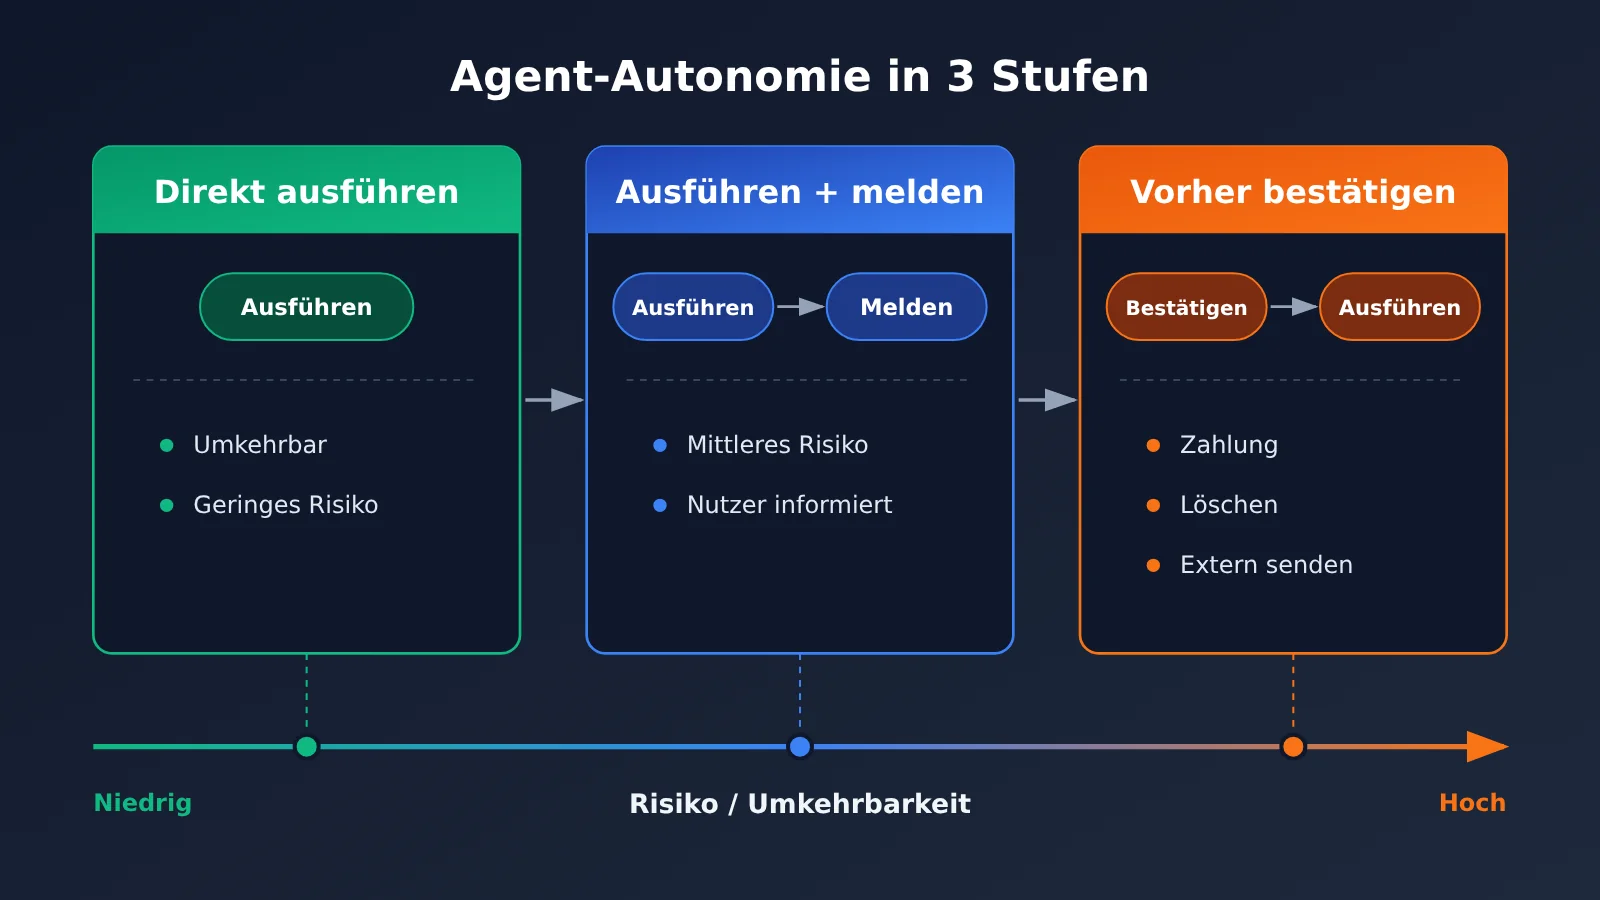
| Autonome Ausführung | Risikoarme, rückgängig machbare Aktionen | Direkt ausführen und danach kurz berichten |
| Blockierung bei hohem Risiko | Zahlungen, Löschungen oder das Versenden nach außen | Zwingend eine zweite Bestätigung einholen und die Folgen erläutern |
| Fortschrittsbericht | Mehrstufige, zeitaufwendige Aufgaben | Bei jedem wichtigen Schritt sichtbares Feedback geben |
| Fehlerbehandlung | Website nicht erreichbar, fehlende Berechtigungen | Ursache und nächsten Schritt empfehlen; nicht stillschweigend scheitern |
| Aufgabenabschluss | Aufgabe abgeschlossen | Ein klares „Erledigt“-Signal und eine Zusammenfassung des Ergebnisses liefern |
Schritt 2: Die Grenze zwischen Autonomie und Bestätigung des KI-Agenten ziehen
Nachdem die Liste erstellt ist, muss für jede Art von Operation ein „Autonomiegrad“ festgelegt werden. Üblich ist eine Einteilung in drei Stufen: direkt ausführen, nach der Ausführung informieren, vor der Ausführung bestätigen. Die Entscheidung hängt vor allem von zwei Punkten ab: ob sich die Operation rückgängig machen lässt und wie hoch die Kosten eines Fehlschlags sind.
Genau bei diesem Schritt entstehen am häufigsten Meinungsverschiedenheiten im Team. Deshalb arbeitet Muse mit einem kleinen Team: Grenzfragen brauchen eine Person, die die Verantwortung für das Gesamterlebnis trägt und die Entscheidung trifft – man kann nicht jeden Baustein nach eigenem „lokal sinnvollem“ Ermessen entscheiden lassen. Sonst passiert es, dass dieselbe Operation auf Seite A eine Bestätigung verlangt, auf Seite B aber direkt ausgeführt wird.
Schritt 3: Interne Zustände des KI-Agenten auf sichtbare Signale für Nutzer abbilden
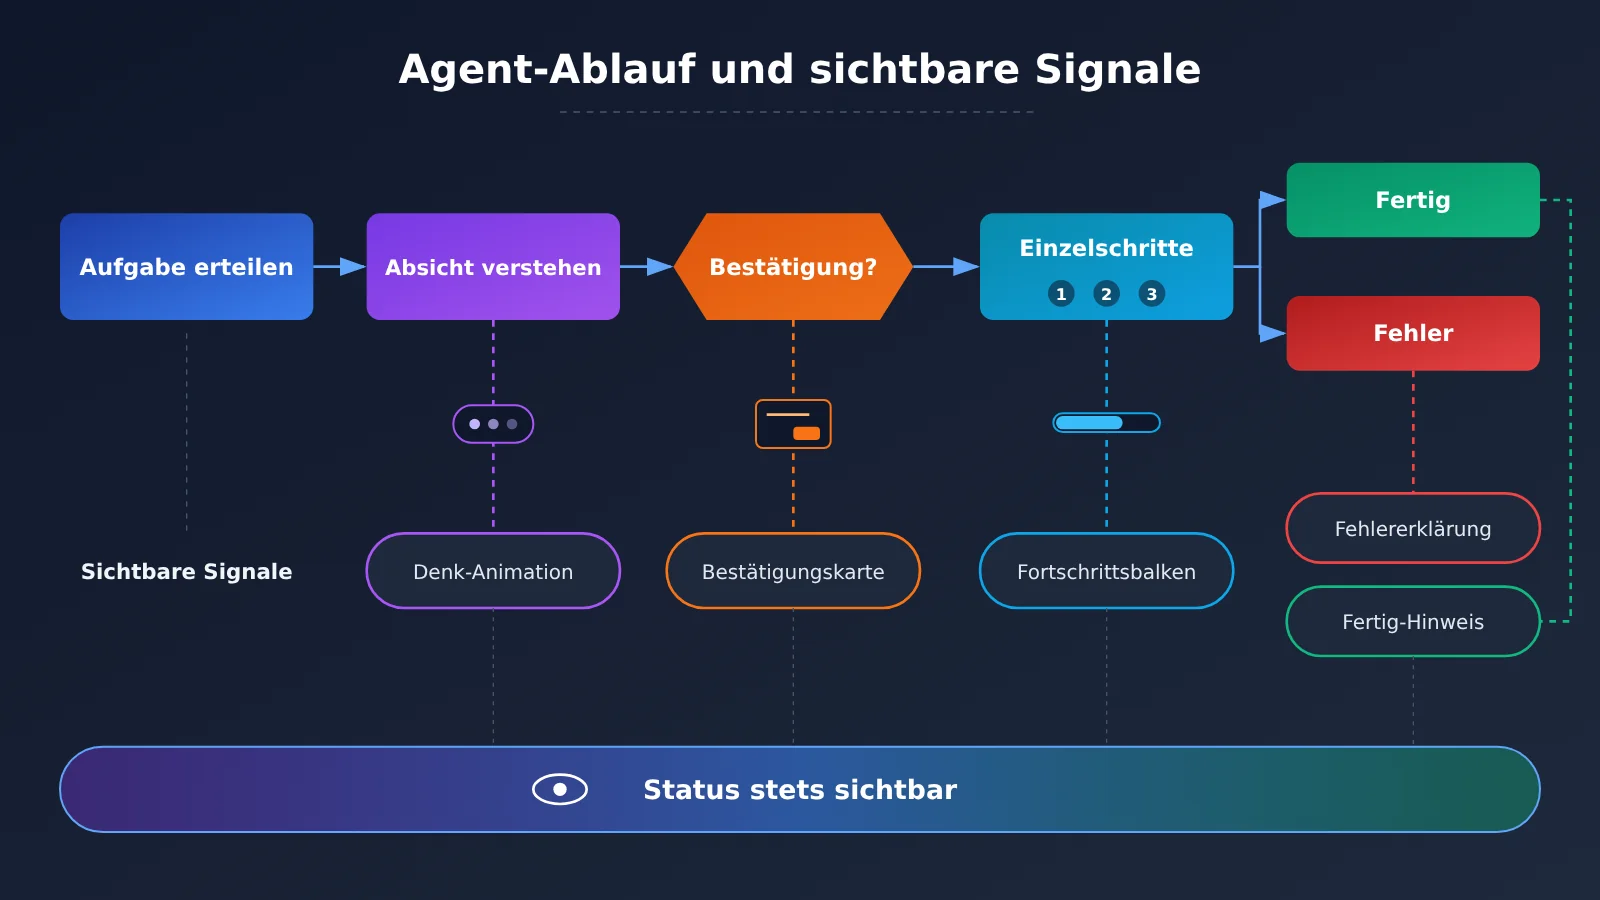
Der Agent hat intern viele Zustände, aber Nutzer interessieren sich nur für wenige davon. In der Praxis fasst man die internen Zustände zu 5 bis 6 Zuständen zusammen, die Nutzer verstehen, und entwirft dann für jeden Zustand ein festes Signal:
| Interner Zustand des Agenten | Sichtbares Signal für Nutzer | Häufiges Gegenbeispiel |
|---|---|---|
| Absicht analysieren / Planen | Denk-Animation oder „Ich verstehe deine Anfrage“ | Ein paar Sekunden leerer Bildschirm, Nutzer denkt, es hängt |
| Tool aufrufen / externen Dienst ansprechen | Name des aktuellen Schritts anzeigen, z. B. „Abo-Seite wird geöffnet“ | Rohen Tool-Namen oder JSON direkt anzeigen |
| Auf Bestätigung durch Nutzer warten | Bestätigungskarte hervorheben, Konsequenzen benennen | Bestätigungsfrage in einem langen Antworttext verstecken |
| In Ausführung (mehrere Schritte) | Schrittweiser Fortschritt, Erledigtes und Laufendes markieren | Nur ein einzelnes rotierendes Lade-Symbol |
| Abgeschlossen | Klare Fertig-Markierung und Ergebniszusammenfassung | Die Antwort endet, aber es wird nicht gesagt, ob die Aufgabe erfolgreich war |
| Fehler / Unterbrechung | Ursache und mögliche Aktionen in verständlicher Sprache erklären | Technische Fehlermeldung oder gar kein Feedback |
Technisch lassen sich diese Signale über die Streaming-Ausgabe der Modell-API steuern. Im OpenAI-kompatiblen Format werden bei aktiviertem stream Inhalte und Tool-Aufrufe abschnittsweise zurückgegeben; bei Streaming-Events im Anthropic-Messages-Format werden Textblöcke und tool_use-Blöcke unterschieden. Das Frontend hört auf diese Events und schaltet auf den entsprechenden sichtbaren Zustand um – es muss nicht auf das Ende der gesamten Antwort warten.
Schritt 4: Testset für das Verhalten von KI-Agenten entwerfen
Für jedes Verhalten sollte es einen passenden Testfall geben, der mindestens drei Situationen abdeckt: „normale Eingabe, mehrdeutige Eingabe, fehlerhafte Umgebung“. Beim Testen kommt es nicht nur darauf an, ob die Antwort richtig ist, sondern auch auf Folgendes:
- Wird dort nachgefragt, wo eine Bestätigung nötig ist, und wird dort nicht gestört, wo keine Rückfrage angebracht ist?
- Erscheinen die Statussignale in jeder Phase rechtzeitig?
- Verhält sich der Agent konsistent, wenn derselbe Auftrag über verschiedene Einstiegspunkte gestartet wird?
- Kann der Nutzer nach einem Fehler verstehen, was schiefgelaufen ist, und weiß er, was als Nächstes zu tun ist?
Es empfiehlt sich, das Testset festzuschreiben und nach jeder Änderung der Eingabeaufforderung, jedem Modellwechsel oder jeder Anpassung der Tools vollständig durchlaufen zu lassen – so vermeiden Sie, dass Sie eine Sache reparieren und dabei drei andere kaputtmachen.
Schritt 5: Vergleich auf verschiedenen Basis-Modellen für KI-Agenten
Muse macht einen Punkt deutlich: Der Wert der Feinschliff-Ebene hängt nicht vom „stärksten Modell“ ab. Dieselbe Verhaltensliste kann sich bei unterschiedlichen Modellen unterschiedlich auswirken. Deshalb braucht es einen Quervergleich, um die Kombination zu finden, die die Verhaltensstandards erfüllt und gleichzeitig kostengünstig ist.
| Feinschliff-Schritt | Zentrale Anforderung an das Modell | Auswahlansatz | Verfügbare Plattform |
|---|---|---|---|
| Intent-Erkennung und Planung | Stabiles Reasoning, Befolgen von Anweisungen | Bevorzugt Flaggschiff- oder Reasoning-Modelle wählen | APIYI apiyi.com, offizielle API |
| Ausführung von Tool-Aufrufen | Stabiles Format für Funktionsaufrufe | Modelle wählen, die bei Tool-Aufrufen zuverlässig sind | APIYI apiyi.com, offizielle API |
| Fortschrittstexte / Statusmeldungen | Schnelle Antwort, geringe Kosten | Leichte, schnelle Modelle wählen | APIYI apiyi.com, offizielle API |
| Batch-Auswertung des Testsets | Große Menge, reproduzierbar | Preis-Leistungs-starke Modelle als Prüfer wählen | APIYI apiyi.com, offizielle API |
🎯 Technischer Hinweis: Für den Vergleich mehrerer Modelle können Sie diese einheitlich über APIYI apiyi.com aufrufen. APIYI bietet die in diesem Artikel behandelten APIs der wichtigsten großen Sprachmodelle und ist sowohl mit dem OpenAI- als auch dem Anthropic-Schnittstellenformat kompatibel. Derselbe Agent-Code kann durch Ändern des Parameters
modelverglichen werden, ohne für jeden Anbieter eine eigene Anpassungsschicht zu schreiben. Einbindung und Schnittstellenadressen entnehmen Sie bitte dem Dokumentationszentrum von APIYI unter docs.apiyi.com.
Schritt 6: Das AI-Agent-Erlebnis kontinuierlich in einer zweiten und dritten Runde nachschärfen
In den Referenzmaterialien gibt es ein Bild: Es reicht nicht, nur die Restaurantfassade zu renovieren; auch die Toiletten müssen sauber sein. Heutige AI-Tools liefern schnell eine schöne erste Version. Das verleitet eher dazu, immer neue erste Versionen zu bauen, statt an den Teilen des bestehenden Produkts zu arbeiten, die zwar funktionieren, sich aber schlecht anfühlen.
Empfehlung: Wähle jede Woche aus echten Nutzungsprotokollen die Stellen aus, an denen Nutzer zögern, dieselbe Frage wiederholt stellen oder mittendrin aufgeben, und ergänze damit in Schritt 1 die Verhaltensliste. Produkte, die immer wieder genutzt werden, entstehen genau in diesen unscheinbaren zweiten und dritten Durchgängen.
💰 Kostenhinweis: Die Verhaltenstestsets müssen wiederholt laufen, wodurch ein spürbares Aufrufvolumen entsteht. Zu den Eingabe- und Ausgabepreisen der einzelnen Modelle sowie zur Abrechnungslogik für Caching orientiere dich bitte an den tatsächlichen Daten auf der APIYI-Preisseite https://docs.apiyi.com/models; in diesem Artikel nennen wir keine konkreten Preise.
Vergleich der Optimierungsansätze für AI-Agenten
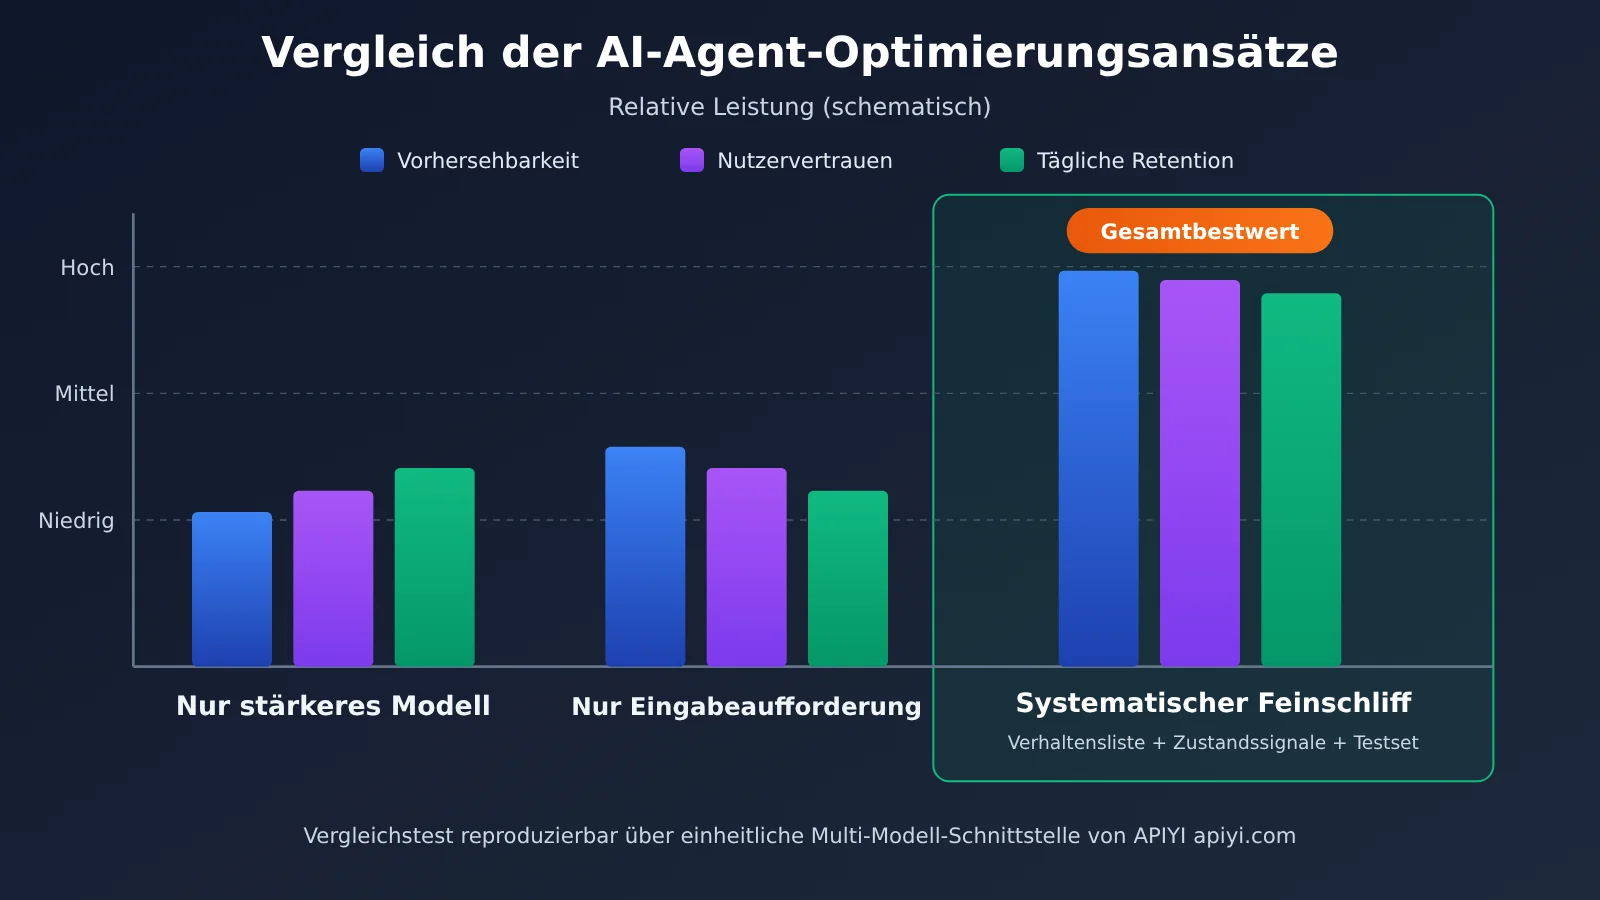
| Ansatz | Kernvorgehen | Geeignete Szenarien | Wesentliche Einschränkungen |
|---|---|---|---|
| Nur ein stärkeres Modell einsetzen | Das Basismodell upgraden und hoffen, dass sich das Erlebnis von selbst verbessert | Frühe Prototypen mit deutlich begrenzten Fähigkeiten | Höhere Kosten; Verhaltensprobleme wie nötige Bestätigungen und Fortschrittsberichte bleiben bestehen |
| Nur die Eingabeaufforderung ändern | Regeln in der System-Eingabeaufforderung anhäufen | Kleinere Reparaturen einzelner Probleme | Mit jeder weiteren Regel wird es unübersichtlicher; ohne Tests geraten sie leicht in Konflikt |
| Systematische Optimierung | Verhaltensliste + Autonomiegrenzen + Statussignale + Testset | Auf alltägliche Aufgaben ausgerichtete Agenten für echte Nutzer | Hoher Anfangsaufwand; jemand muss die Verantwortung für das Gesamterlebnis übernehmen |
Einordnung der Optimierungsansätze im Vergleich
Analyse von „nur das Modell wechseln“: Stärkere Modelle liegen bei komplexem Reasoning tatsächlich vorn, aber sie wissen nicht von selbst, welche Aktionen in deinem Produkt zuerst bestätigt werden müssen und wie der Fortschritt angezeigt werden soll. Systematische Optimierung setzt dagegen direkt an der Reibung an, die Nutzer spüren. Dass Muse ohne das stärkste Modell ein ordentliches frühes Wachstum erzielt hat, ist ein Beispiel dafür.
Analyse von „nur die Eingabeaufforderung ändern“: Prompt-Korrekturen wirken schnell und eignen sich für Einzelprobleme. Ohne Verhaltensliste und Testset geraten Regeln jedoch leicht in Konflikt: Eine reparierte Stelle beeinträchtigt eine andere. Für Agenten, die langfristig betrieben werden sollen, ist systematische Optimierung zuverlässiger.
💡 Hinweis zum Vergleich: Die Unterschiede zwischen den Ansätzen sollten an den eigenen Geschäftsdaten überprüft werden. Über APIYI apiyi.com kannst du dasselbe Testset auf mehreren Modellen vergleichend laufen lassen und dann zusammen mit den Daten der Preisseite Aufwand und Ertrag abwägen.
Häufige Fragen (FAQ) zum Feinschliff von AI-Agenten
F1: Was genau ist mit dem Feinschliff eines AI-Agenten gemeint?
Damit ist gemeint, das Verhalten eines Agenten bei echten Aufgaben Punkt für Punkt zu testen, anzupassen und festzuschreiben – einschließlich der Fragen, wann er nachfragt, wann er eigenständig handelt, wie er den Fortschritt meldet und wie er Fehler erklärt. Gleichzeitig soll der Nutzer jederzeit sehen können, in welchem Zustand der Agent gerade ist. Das ist testbare Ingenieursarbeit und keine vage „Optimierung des Nutzererlebnisses“.
F2: Worin unterscheidet sich Verhaltensabstimmung von Prompt-Engineering?
Prompt-Engineering ist eines der Werkzeuge, die Verhaltensabstimmung ist das Ziel und die Methodik. Bei der Verhaltensabstimmung definiert man zuerst eine „Liste der erwarteten Verhaltensweisen“ und ein Testset, setzt diese dann mit Prompts, Tool-Design, Frontend-Interaktion und weiteren Mitteln um und prüft kontinuierlich per Regression, ob alles noch stimmt. Wer nur Prompts ändert, ohne ein Testset aufzubauen, kann Konsistenz kaum garantieren.
F3: Wie groß sind Nutzerbasis und Team von Muse?
Berichten zufolge hat Muse rund sechs Wochen nach dem Start 10 Millionen Nutzer erreicht. Laut Alexander Wang umfassen Modell- und Produktteam zusammen weniger als 200 Personen. Gemessen an den Milliarden-Nutzern, die Meta sonst gewohnt ist, sind das erst frühe Ergebnisse – als Nächstes müssen die Servicekosten sinken und die Skalierung wachsen.
F4: Für welche Agenten-Szenarien eignet sich sichtbarer Status am besten?
Vor allem für diese Szenarien:
– **Aufgaben mit To-do-Charakter**: mehrstufige Abläufe wie Abos kündigen, Rechnungen verfolgen oder Formulare ausfüllen;
– **Zeitintensive Aufgaben**: Aufgaben, bei denen mehrere Websites besucht oder mehrere Tools aufgerufen werden und die entsprechend lange dauern;
– **Risikoreiche Aktionen**: Abläufe mit Zahlungen, Löschungen oder externem Versand, bei denen der Nutzer ausdrücklich bestätigen muss.
F5: Wie baut man schnell eine Testumgebung für den Feinschliff mit mehreren Modellen auf?
So geht man vor:
1. Bei APIYI apiyi.com registrieren und einen API-Schlüssel holen;
2. In der Doku unter docs.apiyi.com nachsehen und über das OpenAI- oder Anthropic-kompatible Format anbinden;
3. Mit demselben Verhaltens-Testset nacheinander den Parameter `model` umschalten und die Ergebnisse vergleichen;
4. Anhand der tatsächlichen Abrechnungsdaten auf der Preisseite https://docs.apiyi.com/models die passende Modellkombination auswählen.
F6: Welche Kosten und Grenzen hat ein systematischer Feinschliff?
– **Anfänglicher Aufwand**: Verhaltensliste und Testset brauchen Zeit; kurzfristig sieht man keine „neuen Funktionen“;
– **Aufrufkosten**: Regressionstests rufen das Modell immer wieder auf; die Abrechnung richtet sich nach der Preisseite der jeweiligen Plattform;
– **Organisatorische Anforderungen**: Jemand muss die Gesamtverantwortung für das Erlebnis übernehmen, sonst werden die Grenzregeln durch Kompromisse zwischen den Beteiligten inkonsistent;
– **Grenzen**: Feinschliff kann harte Lücken in den Modellfähigkeiten nicht ausgleichen. Ist die Leistung deutlich zu schwach, hilft nur ein Modellwechsel.
Die wichtigsten Kernpunkte beim Feinschliff von AI-Agenten
- Feinschliff ist testbar: Vor dem Launch von Muse wurden über hundert konkrete Modellverhalten angepasst.
- Nutzerfreundlich heißt nicht am klügsten: Der Vorteil von Muse liegt darin, die Reibung bei der Nutzung zu verringern – nicht darin, das stärkste Modell zu sein.
- Grenzen brauchen eine Entscheidungsinstanz: Regeln dafür, wann autonom ausgeführt und wann vorher nachgefragt wird, müssen einheitlich sein – nicht jedes Modul entscheidet für sich allein.
- Der Zustand muss sichtbar sein: Mit Signalen beantworten wir die Frage des Nutzers: „Hat es verstanden? Arbeitet es? Ist es fertig?“
- Randfälle zählen genauso viel: Fehlermeldungen, Abbrüche, ein zweiter Browser-Tab und der Demo-Ablauf werden gleich behandelt.
- Der Vergleich mehrerer Modelle ist stabiler: Über die einheitliche Schnittstelle von APIYI lassen sich verschiedene Modelle mit demselben Testsatz vergleichen.
Zusammenfassung
Die Kernpunkte beim Feinschliff eines AI-Agenten:
- Verhaltensabstimmung: Entscheidungspunkte in eine Checkliste überführen, für jeden Punkt Auslösebedingung, erwartetes Verhalten und Gegenbeispiel festhalten und mit einem Testsatz kontinuierlich regressiv prüfen.
- Sichtbarkeit des Zustands: Interne Zustände zu wenigen, für Nutzer verständlichen Signalen zusammenfassen, die sich durch den gesamten Ablauf von Verstehen, Ausführen, Bestätigen, Abschließen und Fehlerfall ziehen.
- Kontinuierliche Iteration: Reibungspunkte in echten Nutzungsprotokollen finden und konsequent eine zweite und dritte Runde drehen, statt immer wieder die erste Version neu zu bauen.
Die Erfahrungen von Muse gelten genauso für kleine und mittlere Teams: Das kleine Team übernimmt die entscheidenden Weichenstellungen, nimmt langweilige Details ernst und ändert nach einem Fehlschlag das, was wirklich zählt – und versucht es dann erneut. All das setzt nicht voraus, dass man zuerst Milliardenbeträge in zweistelliger Höhe verbrennt.
Wenn Sie für Ihren eigenen Agenten ein Verhaltenstest-Set aufbauen möchten, können Sie über APIYI apiyi.com schnell einen Vergleich über mehrere Modelle hinweg durchführen. Die Plattform ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel; Hinweise zur Anbindung finden Sie unter docs.apiyi.com, die Abrechnung richtet sich nach der Preisseite https://docs.apiyi.com/models.
📚 Referenzen
- MindStudio – Fallstudie zu Meta’s Muse: Hintergrund, Team und die Details beim Feinschliff von Muse
- Link:
mindstudio.ai/blog/meta-muse-ai-companion-lessons -
Beschreibung: Hauptquelle für die Fakten in diesem Fallbeispiel, veröffentlicht am 4. November 2026
-
APIYI Dokumentationszentrum: Anleitung zur einheitlichen Anbindung mehrerer Modelle
- Link:
docs.apiyi.com -
Beschreibung: Zugangswege für OpenAI- und Anthropic-kompatible Formate
-
APIYI Modellpreisseite: Abrechnungsgrundlagen und Einzelpreise der einzelnen Modelle
- Link:
docs.apiyi.com/models - Beschreibung: Für Eingabe- und Ausgabepreise sowie Cache-Preise gelten die tatsächlichen Werte auf dieser Seite
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die offizielle APIYI-Website apiyi.com, um sich über die Praxis der Agent-Optimierung auszutauschen. Weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com