Anmerkung des Autors: Zu Fable 5.5 und GPT-6.2 Astra gibt es öffentliche Demos, aber keinen Vergleich anhand derselben Aufgaben. Dieser Artikel ordnet die Aussagekraft von sechs Demos ein, vergleicht die offiziellen Spezifikationen und Preise der aktuellen Spitzenmodelle Fable 5.1 und GPT-6 Astra und stellt eine reproduzierbare Evaluierungsmethode für die Modellauswahl vor.
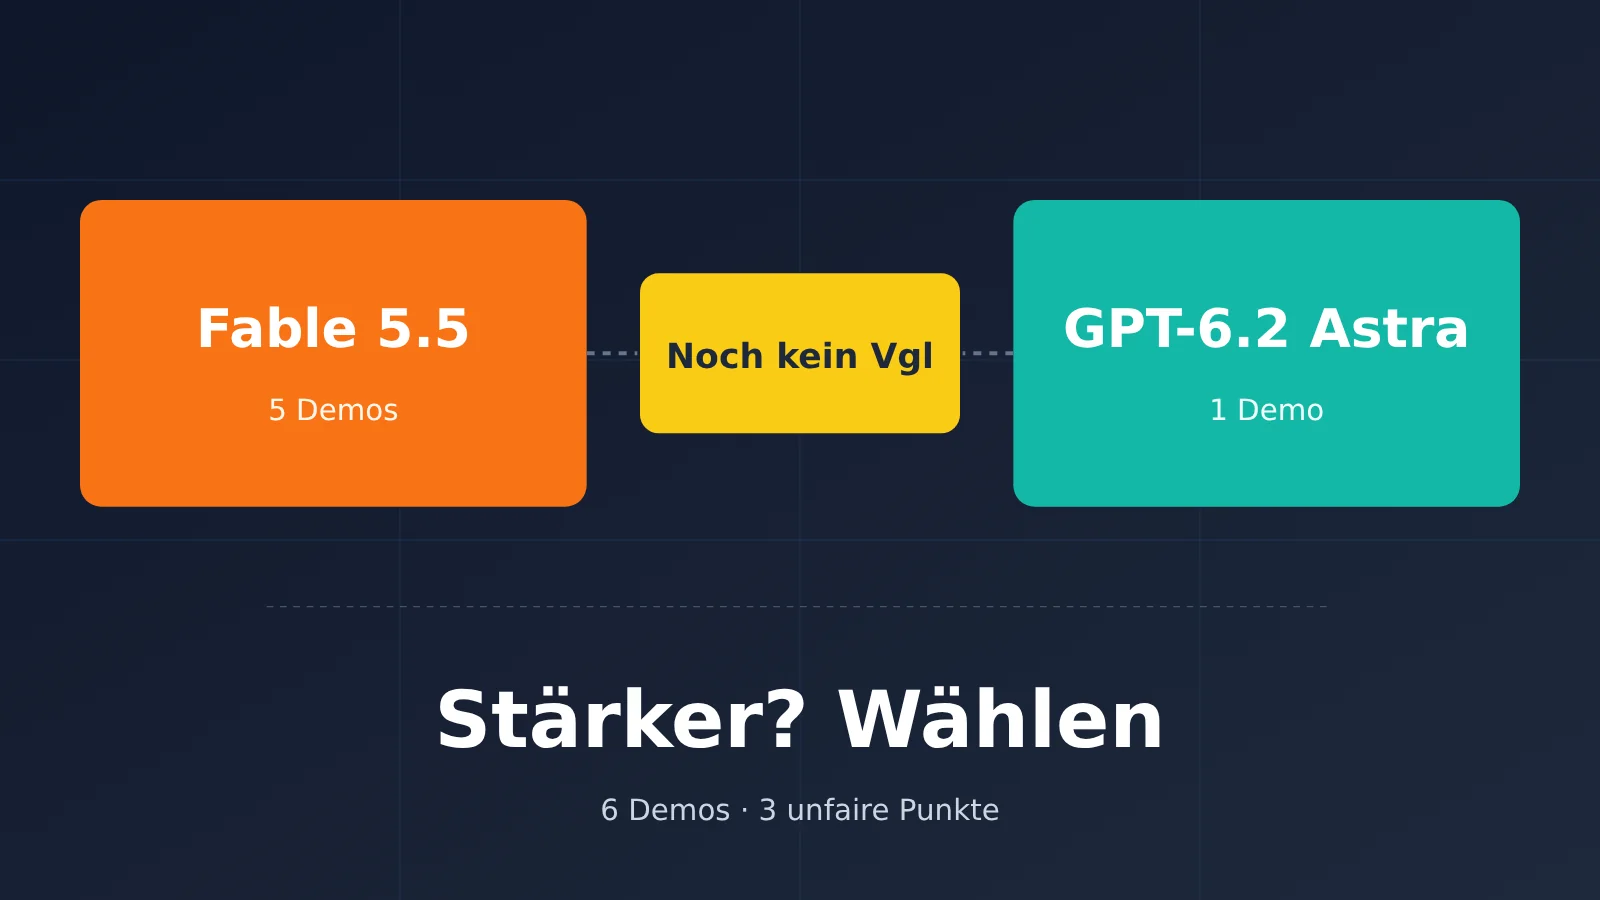
Das Fazit vorweg: Ob Fable 5.5 oder GPT-6.2 Astra stärker ist, lässt sich derzeit nicht beantworten. Beide Modelle sind noch nicht offiziell veröffentlicht. Stand 03.11.2026 führt Anthropic in seinem Modellkatalog weiterhin Fable 5.1, OpenAI weiterhin GPT-6 Astra (Quelle: offizielle Modellseiten beider Anbieter; Evidenzgrad: offizielle Dokumentation). Die öffentlichen Demos beider Modelle stammen von @notjazii und sind auf derselben Testplattform eines Drittanbieters, Model Tests, zu sehen. Sie bearbeiten aber nicht dieselben Aufgaben. Für Fable 5.5 gibt es fünf Arbeiten, darunter ein Spiel, einen Kurzfilm sowie SVG- und WebGL-Beispiele. Für GPT-6.2 Astra gibt es nur eine Pixelanimations-GIF. Bei unterschiedlichen Aufgaben lässt sich kein Sieger bestimmen.
Deshalb erstellt dieser Artikel keine Rangliste, sondern beantwortet drei Fragen: Was belegen diese Demos – und was nicht? Wie unterscheiden sich die offiziell verfügbaren Spezifikationen von Fable 5.1 und GPT-6 Astra, die sich heute vergleichen lassen? Und wie lässt sich eine eigene Evaluierung mit 20 bis 50 Aufgaben vorbereiten, die nach Veröffentlichung der neuen Modelle allein durch Austausch des Modellnamens erneut ausgeführt werden kann? Auf andere Gerüchte wie Mythos 5.5 oder Gemini 4 Carbon geht dieser Artikel nicht ein.
Dies ist kein Kompromissartikel nach dem Motto „Beide haben ihre Stärken“. Wo die Belege nicht ausreichen, steht das klar dabei. Wo ein Urteil möglich ist, gibt es eine konkrete Empfehlung.
Öffentliche Demos von Fable 5.5 und GPT-6.2 Astra im Überblick
Fazit: Die Demos zeigen, dass beide Modelle lauffähige Ergebnisse erstellen können. Da sich Aufgaben, Anzahl und Leistungsstufen unterscheiden, lassen sie sich aber nicht direkt vergleichen.
Die Website Model Tests führt insgesamt 11 Projekte von 8 Modellen auf. Jeder Eintrag ist mit Datum, Modell und Typ versehen (Quelle: Website, Beleglage: Angaben der Community). Die folgende Tabelle zeigt alle 6 Werke, die Fable 5.5 und GPT-6.2 Astra zugeschrieben werden. Die Modellzuordnung beruht jeweils auf den Angaben der Autoren.
| Werk | Angabe des Autors | Typ | Datum | Inhalt |
|---|---|---|---|---|
| VoxelCraft | Fable 5.5 xhigh | Spielbares HTML-Spiel | 2026-11-01 | Minecraft-Klon in einer einzigen Datei, mit Überlebens- und Kreativmodus, Crafting, Öfen, Verzauberungen, Redstone, Dorfbewohnern, mehreren Biomen, Nether und End |
| The Last Page | Fable 5.5 xhigh | 66-sekündiger Kurzfilm mit Ton | 2026-11-02 | Fuchs, Bibliothek im Mondlicht, Sturm aus Buchseiten, Flug zu den Wolken |
| Open Me | Fable 5.5 xhigh | Interaktives WebGL-Erlebnis | 2026-11-02 | WebGL2 mit Raymarching und generativer Musik, benötigt eine dedizierte GPU |
| Acorn Bread on a Stick | Fable 5.5 xhigh | Handgeschriebenes SVG | 2026-11-02 | Illustration eines Eichelbrots |
| Fruit Basket | Fable 5.5 max | Reines Vektor-Stillleben | 2026-11-02 | 3000×2400, ohne Bitmaps, realistischer Obstkorb |
| Tsukimi Moon Ferry | GPT 6.2 Astra Max | Animiertes Pixel-Art-GIF | 2026-11-02 | Japanische Flussstadt bei Vollmond: Burg, Fuji, rote Brücke, fliegende Koi, schwimmende Laternen und Fähre |
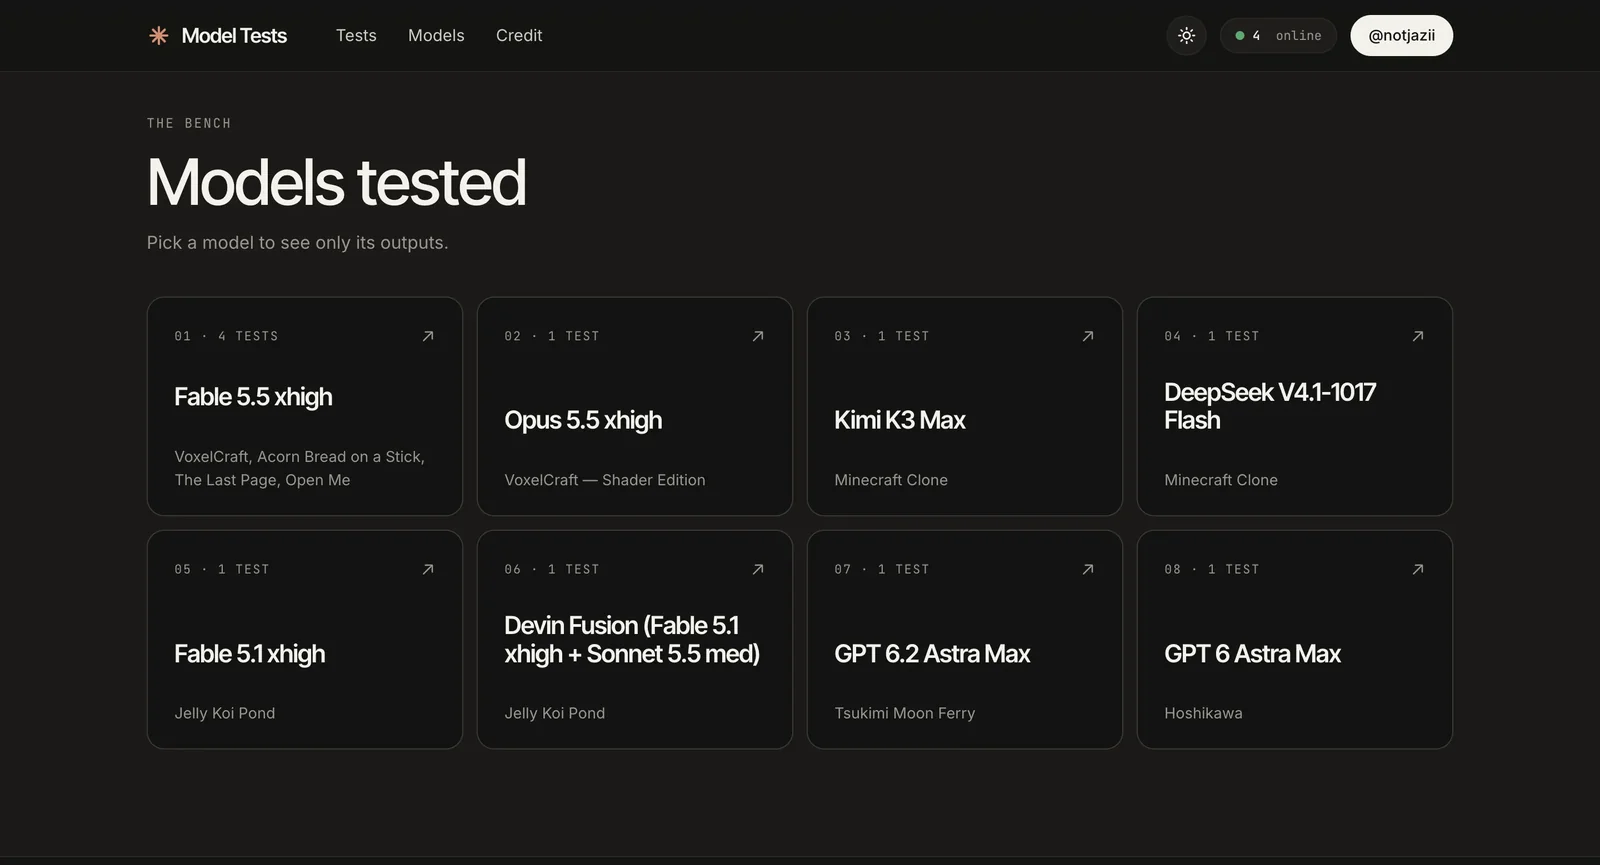
Bildunterschrift: Die Modellliste von Model Tests. Fable 5.5 xhigh sind 4 Tests zugeordnet, GPT-6.2 Astra Max nur 1 und GPT-6 Astra Max ebenfalls 1 (Screenshot vom 2026-11-03).
Auf der Website gibt es weitere Werke zum Vergleich. Hoshikawa ist GPT 6 Astra Max zugeordnet und zeigt ebenfalls eine Pixelanimation einer japanischen Kleinstadt bei Vollmond (2026-11-02). Der Stil ähnelt Tsukimi Moon Ferry – es ist der einzige Vergleich auf der Website zwischen der alten und der neuen OpenAI-Version mit einer nahezu identischen Aufgabe. VoxelCraft — Shader Edition ist Opus 5.5 xhigh zugeordnet (2026-11-01) und basiert auf derselben Aufgabe wie VoxelCraft von Fable 5.5. Auch Kimi K3 Max und DeepSeek V4.1-1017 Flash haben jeweils einen Minecraft-Klon erstellt (2026-10-17).
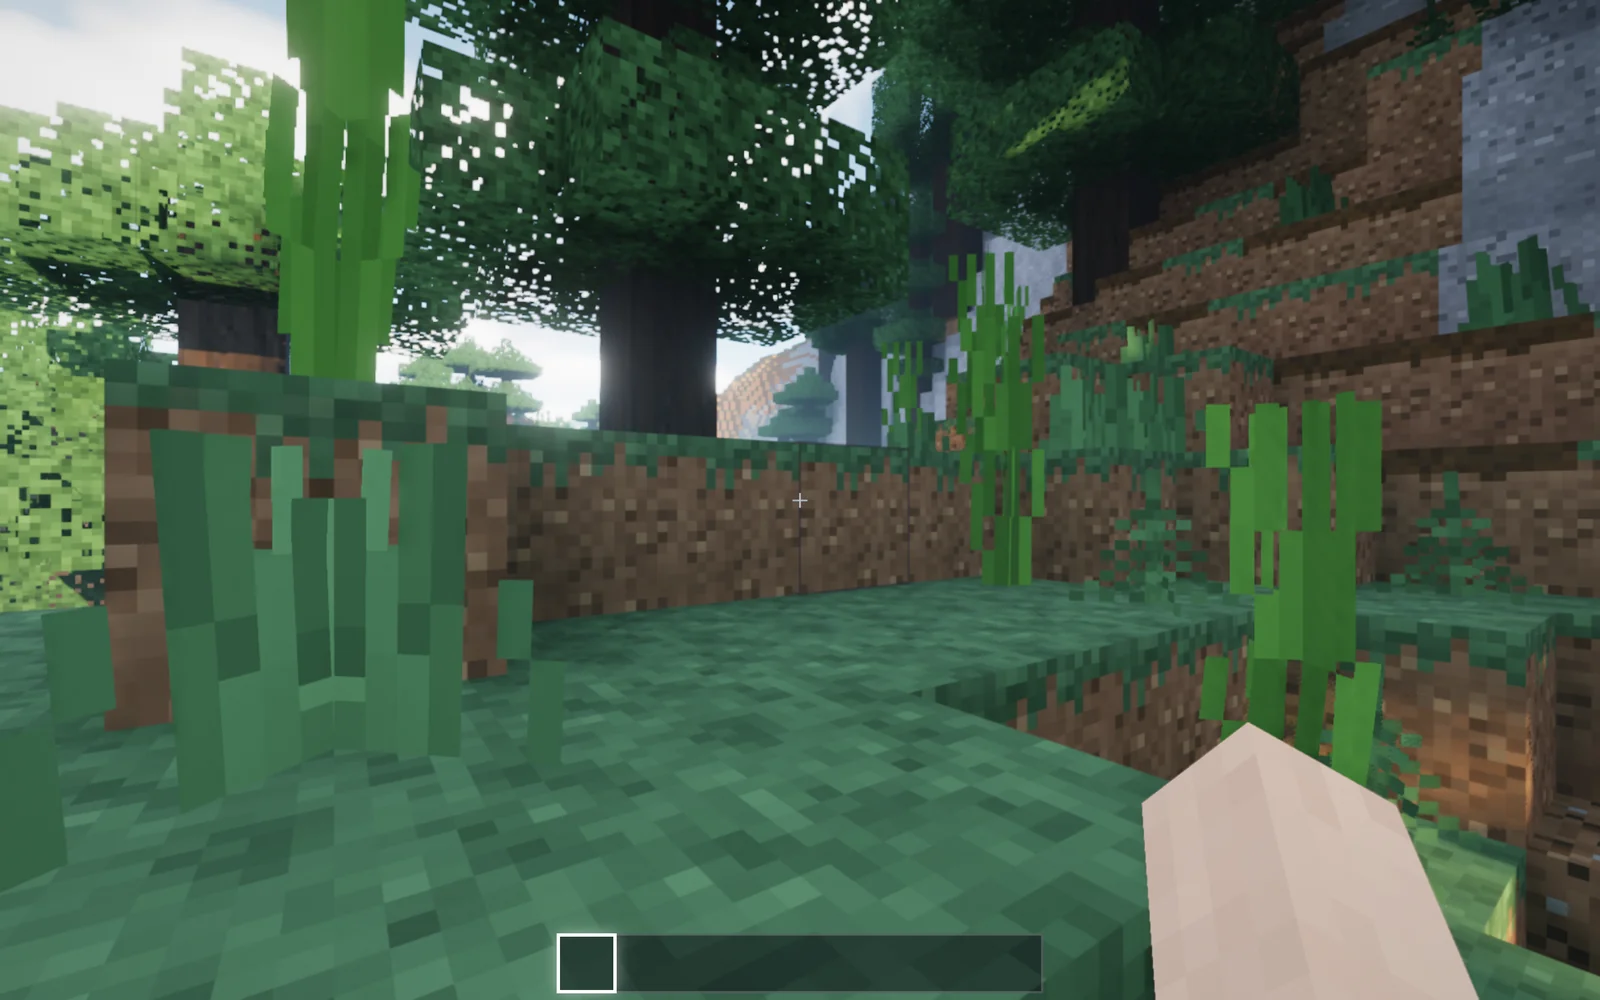
Bildunterschrift: VoxelCraft von Fable 5.5 xhigh, ein Minecraft-Klon in einer einzigen Datei, der sich direkt nach dem Öffnen spielen lässt (Screenshot vom 2026-11-03).
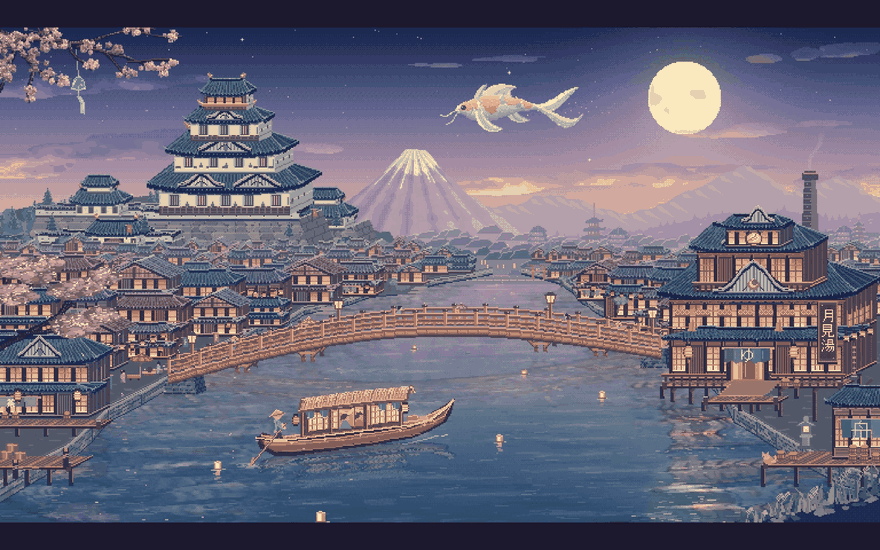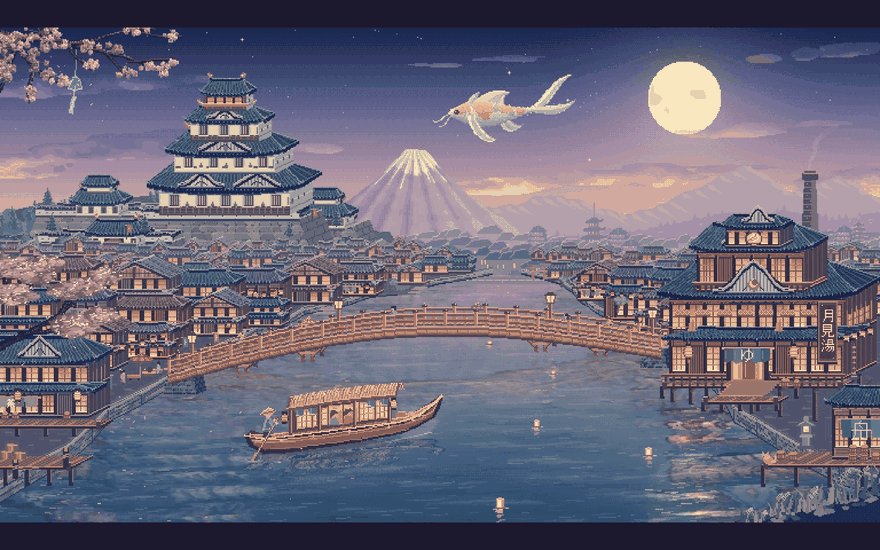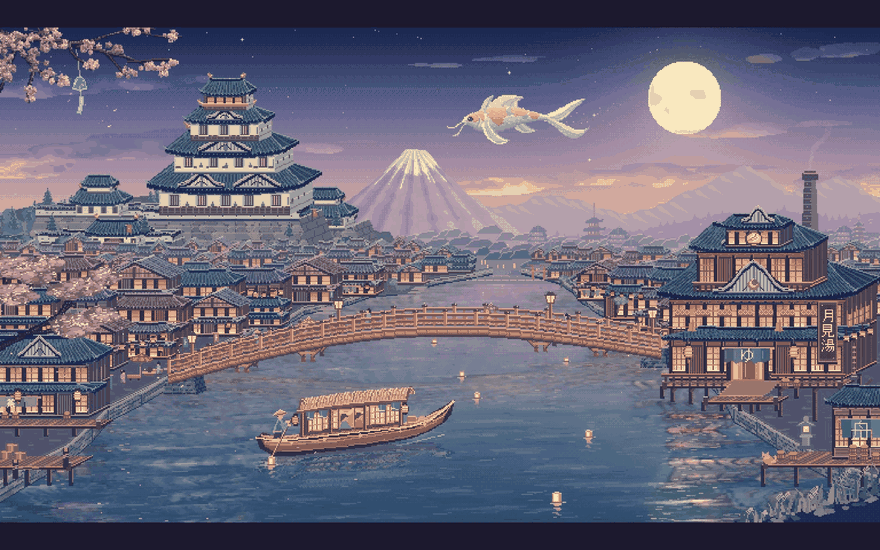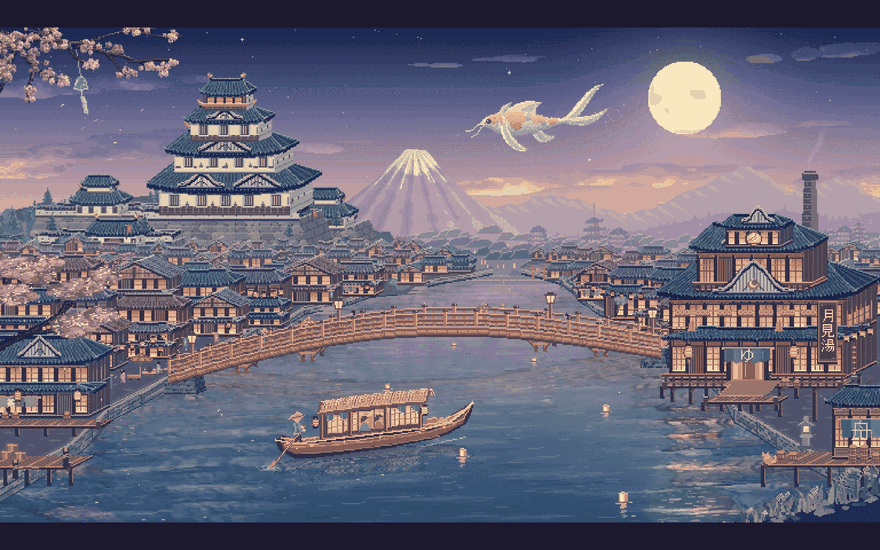
Bildunterschrift: Tsukimi Moon Ferry von GPT-6.2 Astra Max, ein Pixelanimations-GIF mit einer japanischen Flussstadt bei Vollmond (Bildschirmaufnahme vom 03.11.2026).
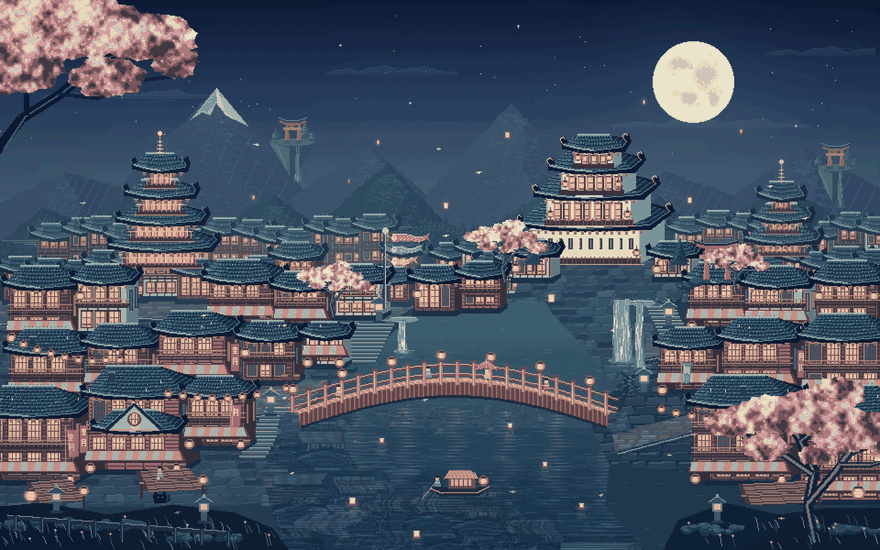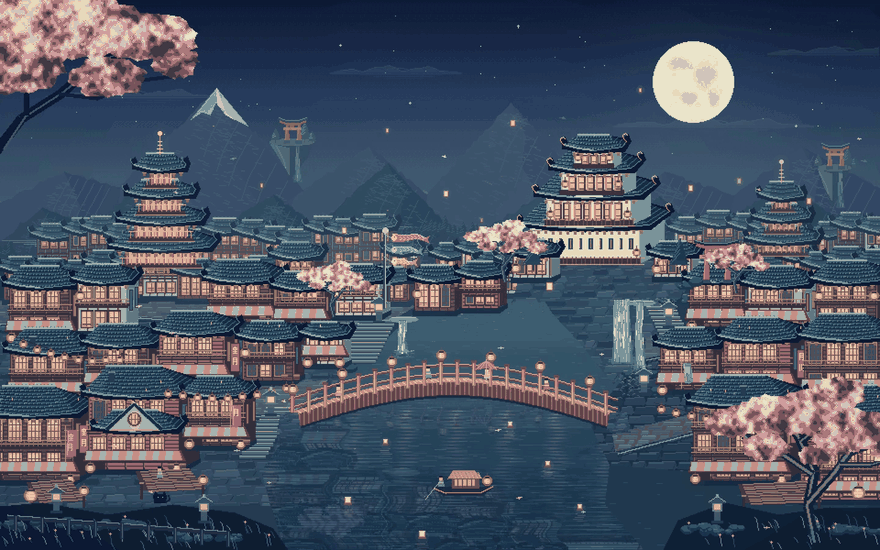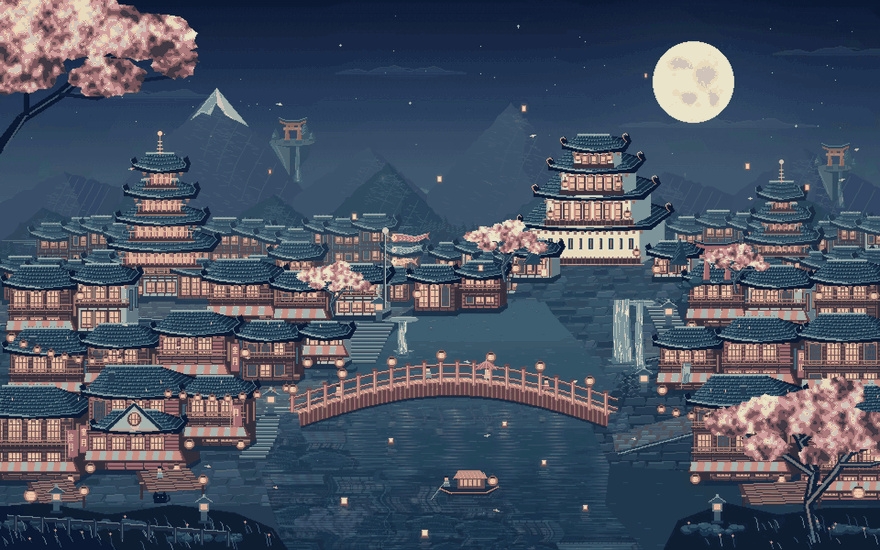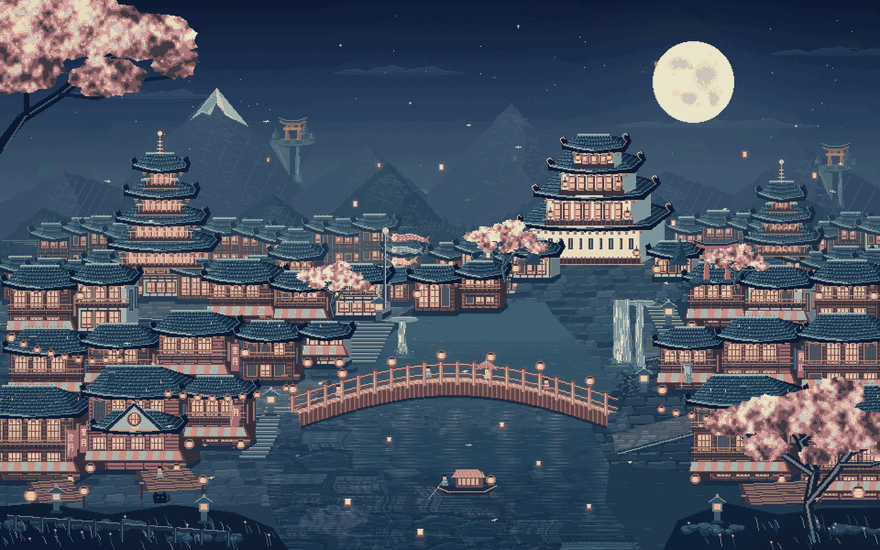
Bildunterschrift: Zum Vergleich Hoshikawa von GPT-6 Astra Max, von derselben Website und im selben Stil, als Gegenstück zur Pixelanimation von 6.2 (Bildschirmaufnahme vom 03.11.2026).
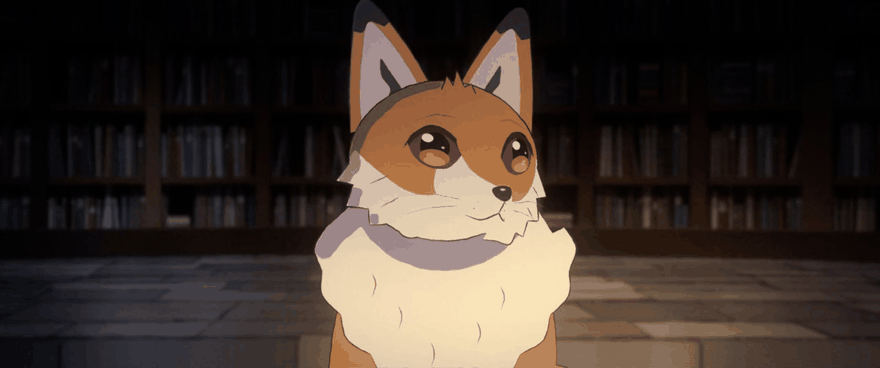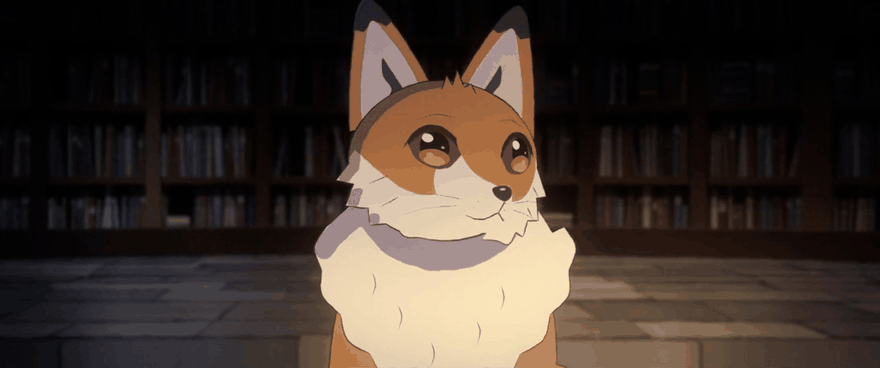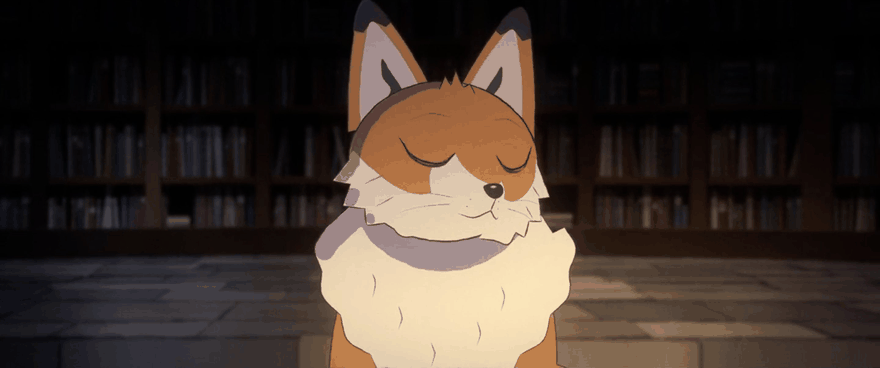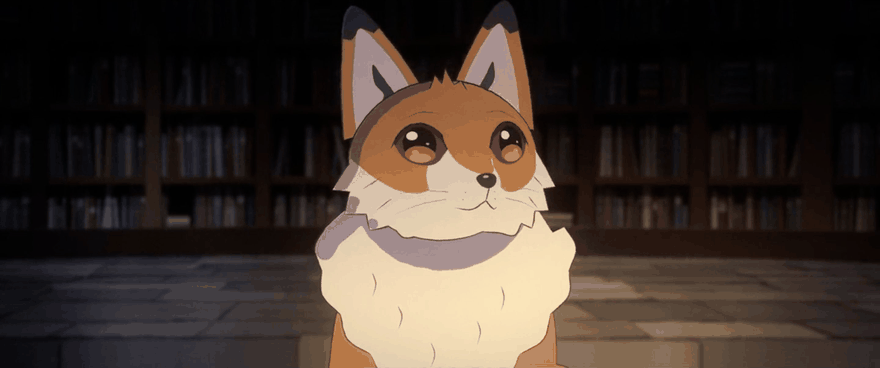
Bildunterschrift: Der 66 Sekunden lange Kurzfilm The Last Page von Fable 5.5 xhigh, hier ein Ausschnitt mit dem Fuchs in der Bibliothek im Mondlicht (GIF-Ausschnitt vom 03.11.2026, ohne Ton).
Jelly Koi Pond ist das einzige Werk auf der Website, für das Kosten und Dauer angegeben sind. Die Version mit Fable 5.1 xhigh benötigte rund 1 Stunde und 40 Minuten und kostete $25; die Kombination Devin Fusion (Fable 5.1 xhigh plus Sonnet 5.5 med) benötigte rund 1 Stunde und kostete $11 (Datum: 21.10.2026, Evidenzgrad: Angaben aus der Community). Für alle anderen Werke auf der Website sind weder Dauer noch Kosten veröffentlicht; dieser Artikel nimmt auch keine Schätzungen vor.
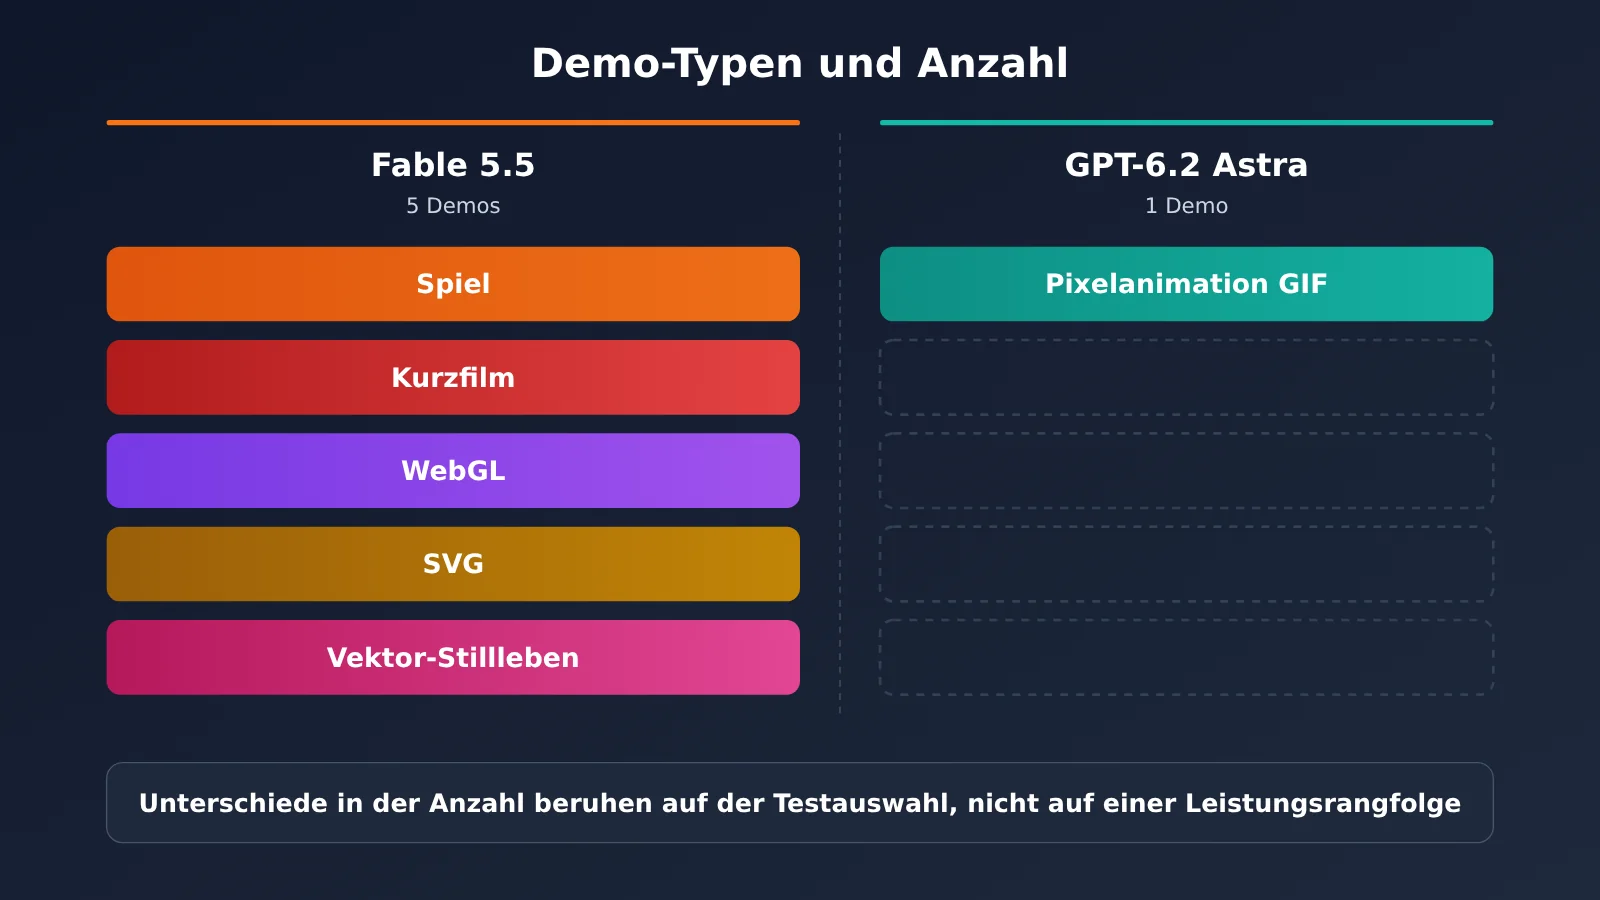
Die Grafik zeigt die Verteilung nach Demo-Typ und Anzahl, keine Rangliste der Fähigkeiten. Wer den tatsächlichen Unterschied zwischen den aktuellen Flaggschiffmodellen der beiden Anbieter bei eigenen Aufgaben untersuchen möchte, kann auf APIYI apiyi.com claude-fable-5-1 und gpt-6-astra mit demselben API-Schlüssel aufrufen.
Fable 5.5 vs. GPT-6.2 Astra: Drei Punkte, die nur auf den ersten Blick fair sind
Fazit: Dieselbe Website und derselbe Autor lassen einen direkten Vergleich vermuten. Tatsächlich gibt es aber mindestens drei Ungleichheiten.
Ungleichheit 1: Völlig unterschiedliche Aufgaben
Die fünf Arbeiten von Fable 5.5 decken vier Kategorien ab: Spiele, Kurzfilme, WebGL und SVG. GPT-6.2 Astra wurde dagegen nur mit Pixelanimationen getestet. Keine einzige Aufgabe wurde von beiden Modellen bearbeitet. Bei Pixelanimationen geht es um Bildkomposition und Konsistenz zwischen den Einzelbildern, bei Spielen in einer einzigen Datei dagegen um die Organisation umfangreichen Codes und die Zustandsverwaltung. Die Ergebnisse lassen sich nicht direkt miteinander vergleichen. Als Vergleich mit einem Vorgängermodell taugt GPT-6.2 Astra nur gegenüber GPT-6 Astra (Hoshikawa) auf derselben Website, Fable 5.5 nur gegenüber Opus 5.5 (VoxelCraft — Shader Edition).
Zweiter Kritikpunkt: Inferenzstufen, Datumsangaben und Anzahl sind nicht vergleichbar
Die meisten Beispiele für Fable 5.5 sind mit xhigh gekennzeichnet, nur Fruit Basket mit max. Bei GPT-6.2 Astra steht Max. Unterschiedliche Stufen bedeuten unterschiedliche Inferenzbudgets – die Qualität der Ergebnisse lässt sich deshalb nicht direkt vergleichen. Auch die Anzahl ist mit 5 zu 1 unausgeglichen. Sie zeigt lediglich, was der Autor zum Testen ausgewählt hat, und ist kein offizielles Testergebnis. Aus der Zahl der Demos auf die Leistungsfähigkeit zu schließen, gehört zu den häufigsten Fehlinterpretationen in dieser Diskussion.
Kritikpunkt 3: Die Modellzuordnung lässt sich nicht überprüfen
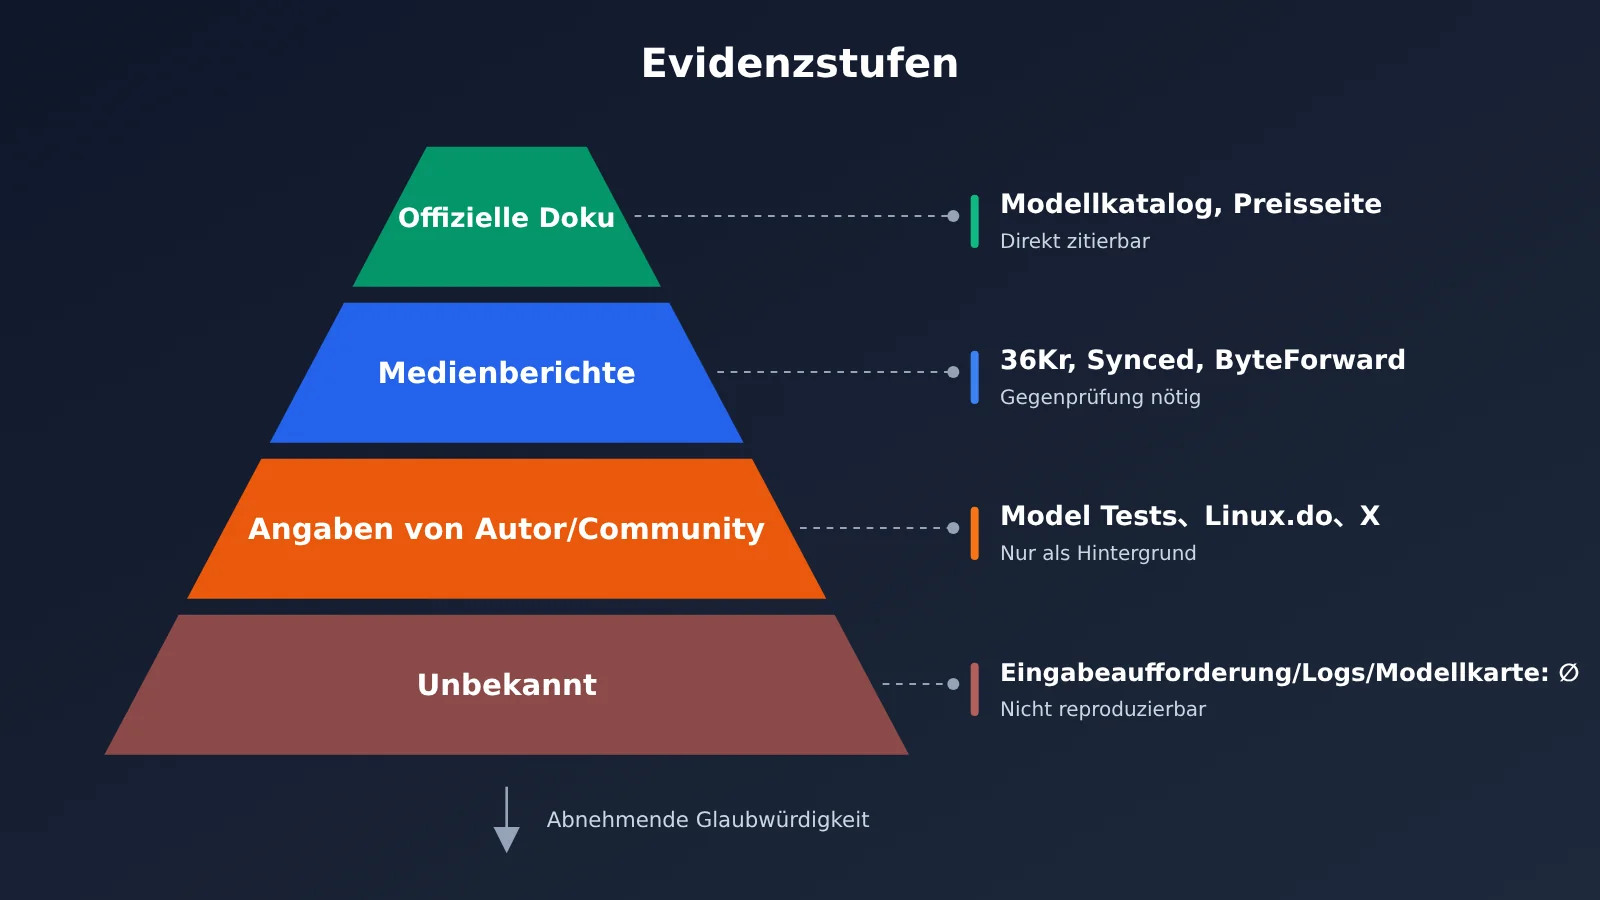
Für keine der Demos wurden Eingabeaufforderungen, Aufrufprotokolle oder Model Cards veröffentlicht. Die Zuordnung zu einem Modell hängt damit vollständig von den Angaben der Autoren ab. ByteForward berichtete bei einer Prüfung am 11-02, dass einige als „Fable 5.5“ gekennzeichnete Demos möglicherweise auf Opus-5.5-Anfragen beruhen, die an ein neues Modell weitergeleitet wurden, während in der Modellauswahl weiterhin Opus 5.5 angezeigt wurde (Evidenzstufe: einzelner Medienbericht). Unter diesen Voraussetzungen lässt sich nur schreiben: „Der Autor gibt Fable 5.5 an“ – nicht: „Fable 5.5 hat das erstellt“.
Die folgende Tabelle ordnet die derzeitigen Aussagen zu den beiden Modellen nach Evidenzstufe. Wer die Informationen im Team weitergibt, sollte die Evidenzstufe ebenfalls nennen.
| Aussage | Quelle | Datum | Evidenzstufe |
|---|---|---|---|
| Im Anthropic-Katalog steht weiterhin Fable 5.1, kein Fable 5.5 | Anthropic-Preis- und Nachrichtenseite | Abgerufen am 11-03 | Offizielle Dokumentation |
| Im OpenAI-Katalog steht weiterhin GPT-6 Astra, kein GPT-6.2 Astra | OpenAI-Modellkatalog | Abgerufen am 11-03 | Offizielle Dokumentation |
LiteLLM nimmt einen Preiseintrag für azure_ai/claude-fable-5-5 auf |
TestingCatalog-Eintrag | 10-13 | Dokumentation durch Dritte |
| Fable 5.5 unterstützt 1M Eingabe und 128.000 Ausgabe | 36 氪/新智元 | 11-02 | Einzelner Medienbericht |
| GPT-6.2 Astra wird in einer zusammenfassenden Bewertung als „deutlicher Sprung nach vorn“ bezeichnet | 机器之心/新浪 | 11-02 | Medienzusammenfassung, ohne Benchmark |
| In einer Nutzungsübersicht entfallen 1,6 % auf gpt-6.2-astra | Linux.do @fourfour | 11-01 | Eigenangabe aus der Community |
| In einer Nutzungsübersicht entfallen 19,8 % auf gpt-6.2-astra | X @TokenGremlin | 11-01 | Eigenangabe aus der Community |
| Modellzuordnung der Demos auf Model Tests | Autor @notjazii | 11-01 bis 11-02 | Angabe des Autors |
| Einige Fable-5.5-Demos beruhen tatsächlich auf weitergeleiteten Opus-5.5-Anfragen | ByteForward | 11-02 | Einzelner Medienbericht |
Die Nutzungsdaten zu GPT-6.2 Astra verdienen eine Einordnung. Der Linux.do-Beitrag zeigt die Verteilung der Codex-Nutzung vom 25. bis 31. Oktober: 97,7 % entfallen weiterhin auf gpt-6-astra, nur 1,6 % auf gpt-6.2-astra. In 12 der 13 Abrechnungszeilen desselben Beitrags steht weiterhin gpt-6-astra, bei Geschwindigkeiten zwischen 44 und 73 tok/s. TokenGremlin zeigte auf X eine Variante mit 19,8 %, die deutlich größere Verbreitung fand (rund 155.000 Aufrufe). Beide Zahlen stammen aus Screenshots persönlicher Accounts, nicht aus offiziellen Daten. 机器之心 weist selbst darauf hin, dass die Screenshots lediglich belegen, „dass Nutzer berichten, Zugang erhalten zu haben“. GPT-6.2 Betelgeuse / Bel ist zudem ein anderer, bereits früher kursierender Codename für ein Basismodell und nicht mit 6.2 Astra gleichzusetzen.
Auch die Einschätzungen aus der Community widersprechen sich. Manche halten Fable 5.5 für stärker, andere sehen es gleichauf mit Opus 5.5. Zu GPT-6.2 Astra sagen einige, es sei schwächer als Opus 5.5; andere sprechen nur von einer schrittweisen Verbesserung, wieder andere sehen es in mehreren Bereichen vor Opus 5.5. Für keine dieser Aussagen liegen Benchmarks oder Angaben zum Stichprobenumfang vor. Sie eignen sich daher nur als Hintergrundinformation.
Fable 5.1 vs. GPT-6 Astra: Offizielle Spezifikationen und Preise im Vergleich
Fazit: Für neue Modelle gibt es noch keine offiziellen Spezifikationen. Vergleichbar sind daher nur die aktuellen Flaggschiffmodelle. Die Stückpreise sind gleich, die eigentlichen Unterschiede liegen bei der Abrechnung langer Eingaben, dem Wissensstand und den Reasoning-Stufen.
Die offiziellen Preise von Fable 5.1 und GPT-6 Astra betragen jeweils $10 für die Eingabe und $50 für die Ausgabe pro Million Tokens. Beide geben maximal 128K Tokens aus; die Kontextfenster betragen 1M beziehungsweise 1.05M. Die Daten in der folgenden Tabelle stammen von den offiziellen Modellseiten beider Anbieter, abgerufen am 2026-11-03. Als Belege dienen die offiziellen Dokumentationen.
| Spezifikation | Fable 5.1 | GPT-6 Astra |
|---|---|---|
| Modell-ID | Offizielles Fable 5.1 von Anthropic | gpt-6-astra |
| Kontextfenster | 1M | 1.05M |
| Maximale Ausgabe | 128K | 128K |
| Wissensstand | 2026-06 | 2026-04-30 |
| Reasoning-Steuerung | Adaptive thinking ist immer aktiviert, der Standardwert für effort ist high | low / medium / high / xhigh / max |
| Tool-Funktionen | Siehe offizielle Dokumentation | Funktionsaufrufe, Websuche, Dateisuche, computer use |
Die unterschiedliche Reasoning-Steuerung wirkt sich direkt auf die Gestaltung von Tests aus. Bei Fable 5.1 ist Adaptive thinking immer aktiviert, und effort steht standardmäßig auf high; GPT-6 Astra bietet fünf wählbare Stufen. Ihre Bezeichnungen entsprechen einander nicht. Die Stufen lassen sich deshalb nur annähernd aufeinander abstimmen, sind aber nicht vollständig gleichwertig. Bei Tests empfiehlt es sich, die gewählte Stufe zu dokumentieren, statt anzunehmen, dass high gleich high ist.
Die offiziellen Stückpreise sind zwar gleich, bei den Abrechnungsdetails gibt es aber erhebliche Unterschiede. Die folgende Tabelle zeigt sowohl die offiziellen Preise als auch die auf der APIYI-Plattform gelisteten Preise, jeweils in US-Dollar pro Million Tokens.
| Abrechnungsposten | Fable 5.1 offiziell | GPT-6 Astra offiziell | Bei APIYI apiyi.com gelistet |
|---|---|---|---|
| Eingabe | $10 | $10 | claude-fable-5-1 $10; gpt-6-astra von 0 bis 272,000 Tokens $10 |
| Lange Eingaben | Innerhalb von 1M konstant $10 | Siehe offizielle Seite | gpt-6-astra von 272,001 bis 1,050,000 Tokens $20 |
| Ausgabe | $50 | $50 | Beide $50 |
| Cache-Treffer/-Lesen | $0.25 | Siehe offizielle Seite | claude-fable-5-1 $0.25; gpt-6-astra $1 |
| Cache-Schreiben | 5 Minuten $12.50, 1 Stunde $20 | Siehe offizielle Seite | Siehe Modellliste der Plattform |
| Endpunkte | messages | responses, chat | claude-fable-5-1: chat / messages; gpt-6-astra: responses / chat |
Für Teams, die lange Dokumente analysieren oder große Codebasen verstehen müssen, ist diese Tabelle hilfreicher als die Frage „Welches Modell ist stärker?“. Überschreitet eine einzelne Eingabe 272.000 Tokens, verdoppelt sich der Eingabepreis für gpt-6-astra auf $20; bei claude-fable-5-1 bleibt er innerhalb von 1M bei $10. Auch der Preis für das Cache-Lesen unterscheidet sich um den Faktor 4 ($0.25 gegenüber $1). Wenn du denselben langen Kontext wiederholt nutzt, machen sich beide Unterschiede auf der Rechnung deutlich bemerkbar. Maßgeblich für Modelle und Preise ist die Modellliste der Plattform.
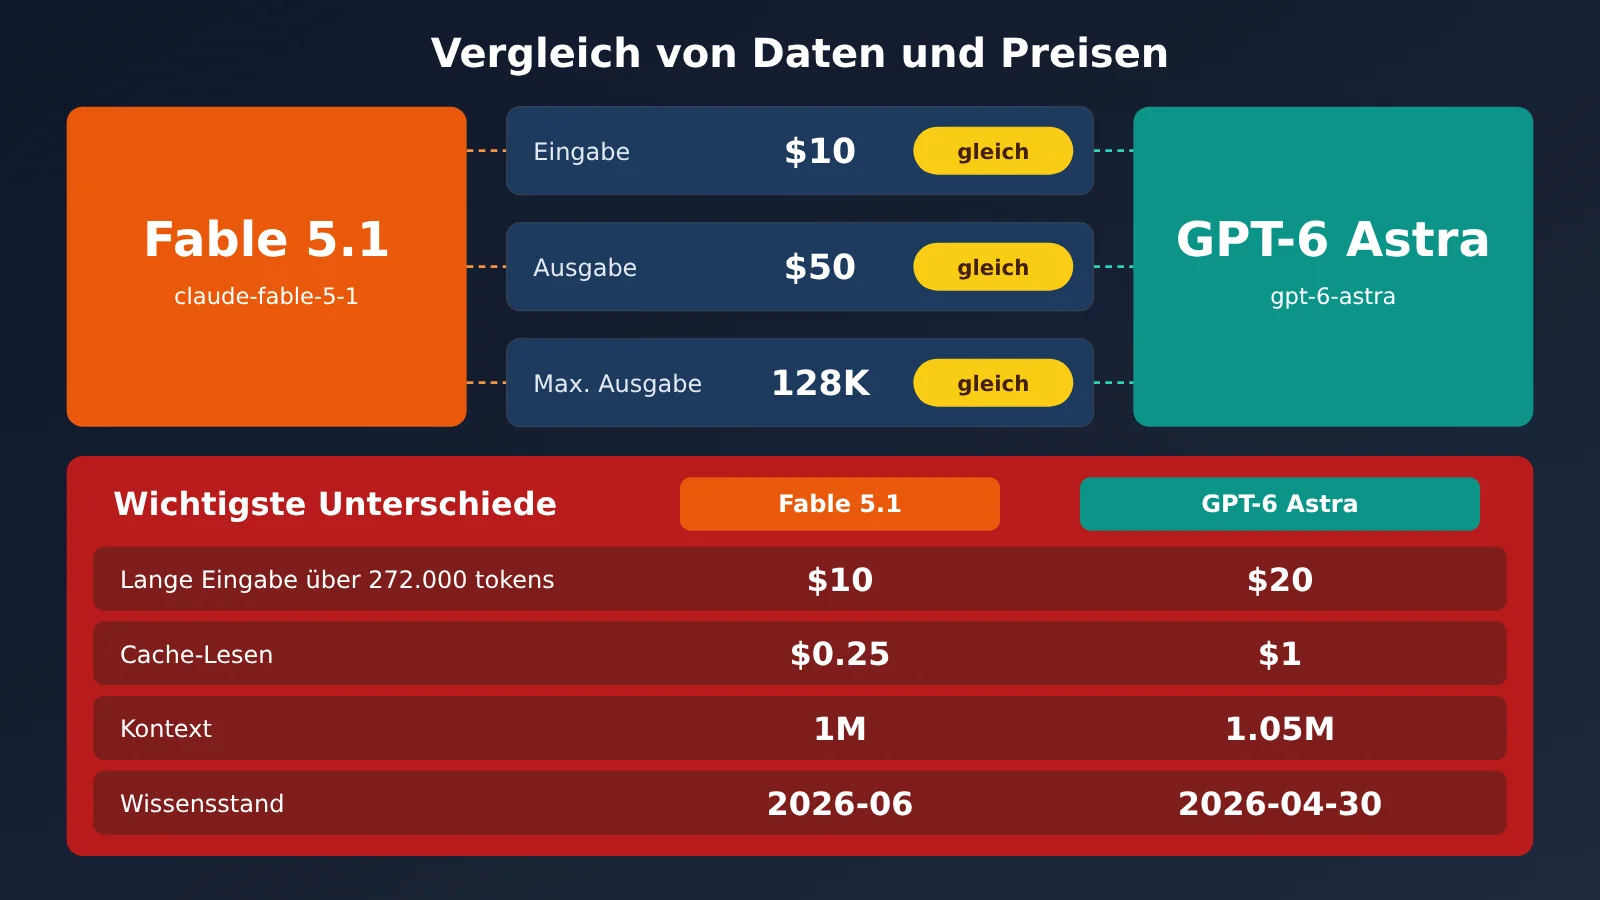
Die Preise in der Grafik stammen von den offiziellen Modellseiten und der Preisschnittstelle der Plattform APIYI apiyi.com. Sie wurden am 2026-11-03 abgerufen.
Was lässt sich vor dem Start von Fable 5.5 und GPT-6.2 Astra nutzen?
Fazit: Für die neuen Modelle gibt es noch keine offizielle API. Was Sie jetzt schon tun können: Mit den aktuellen Flaggschiffmodellen beider Anbieter Baselines ermitteln und das Evaluierungsframework vorbereiten.
Stand 2026-11-03 liefert die Modellschnittstelle von APIYI 259 Modelle, die Preisschnittstelle insgesamt 277. Darunter sind gpt-6-astra, gpt-6.1-sol, gpt-6.1-terra, gpt-6-luna und claude-fable-5-1, aber weder gpt-6.2-astra noch claude-fable-5-5. Die aktuellen Flaggschiffmodelle beider Anbieter lassen sich also bereits mit demselben API-Schlüssel direkt vergleichen. Eine am selben Tag mit claude-fable-5-1 gestartete Messages-Anfrage mit max_tokens von 32 lieferte HTTP 200 zurück – die Schnittstelle ist erreichbar.
Die Anbindung ist mit dem OpenAI SDK kompatibel. Setzen Sie base_url auf https://api.apiyi.com/v1 und verwenden Sie als Modellnamen claude-fable-5-1 beziehungsweise gpt-6-astra. Falls Sie Anthropics natives Messages-Format benötigen: claude-fable-5-1 unterstützt auch dieses. Für gpt-6-astra können Sie den Responses- oder den Chat-Endpunkt nutzen.
🚀 Schnellstart: Registrieren Sie sich bei APIYI apiyi.com und nutzen Sie das kostenlose Testguthaben für neue Nutzer. Testen Sie
claude-fable-5-1undgpt-6-astrazunächst mit 3 bis 5 Aufgaben. Prüfen Sie, ob das Ausgabeformat und die Token-Erfassung stimmen, bevor Sie den vollständigen Aufgabenkatalog einsetzen.
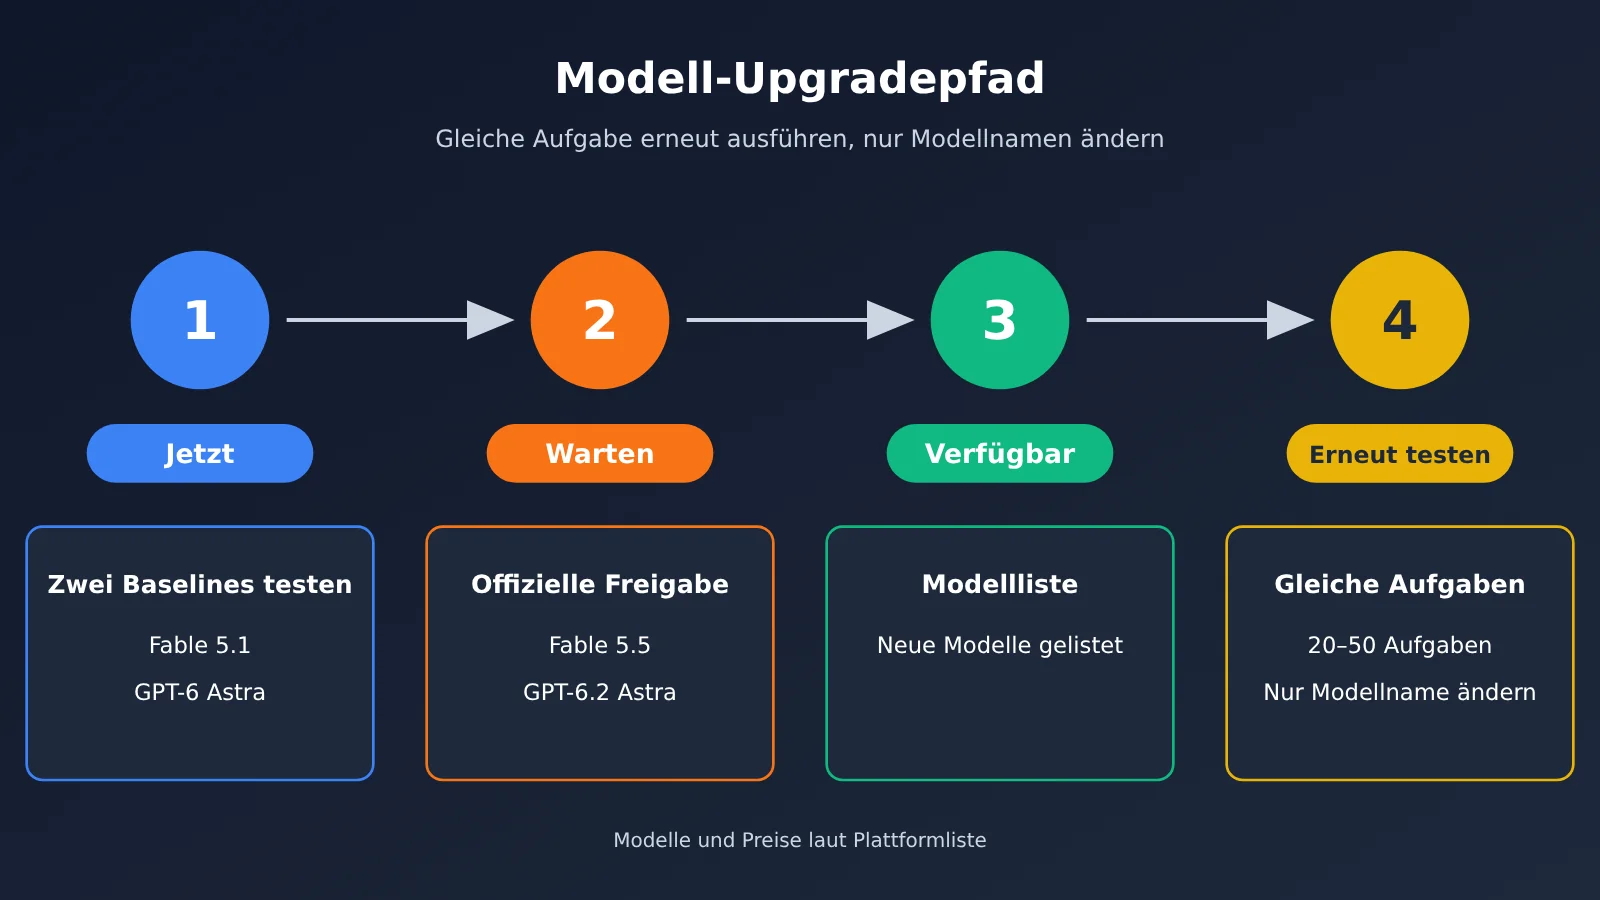
Der Vorteil liegt nicht darin, die Leistung der neuen Modelle schon im Voraus zu kennen. Sie können vielmehr Aufgabenkatalog, Bewertungskriterien und Dokumentation vorbereiten. Sobald Fable 5.5 oder GPT-6.2 Astra offiziell verfügbar ist, muss das Team nur noch den Modellnamen ändern und kann innerhalb von ein bis zwei Tagen Ergebnisse für den eigenen Anwendungsfall erhalten – ohne sich auf Demos und Screenshots anderer verlassen zu müssen.
Fable 5.5 vs. GPT-6.2 Astra: Wie auswählen und testen?
Fazit: Sie müssen nicht auf neue Modelle warten. Legen Sie zunächst mit den aktuellen Spitzenmodellen eine Baseline fest. Die Entscheidung sollte auf 20 bis 50 eigenen Aufgaben beruhen – nicht auf öffentlichen Demos.
Stand 2026-11-03 sind Fable 5.5 und GPT-6.2 Astra noch nicht bei APIYI verfügbar. Sobald die Modelle erscheinen, werden wir beide so schnell wie möglich aufnehmen. Verbindliche Angaben zu Modellnamen und Preisen finden Sie in der Modellliste der Plattform. Bis dahin können Sie anhand der folgenden Szenarien eine erste Einschätzung treffen:
- Lange Dokumente, große Codebasen und wiederholt genutzte lange Kontexte: Testen Sie zuerst
claude-fable-5-1. Der Eingabepreis bleibt innerhalb von 1M unverändert, und das Lesen aus dem Cache kostet nur $0.25. Das macht die Kosten besser planbar. - Fein einstellbares Reasoning-Budget, Websuche oder Computer Use: Testen Sie zuerst
gpt-6-astra. Es bietet fünf Reasoning-Stufen, und die offiziell aufgeführten Tool-Funktionen sind umfassender. - Frontend-Aufgaben in einer einzelnen Datei und kreative Visualisierungen: Für beide Modelle gibt es Beispielarbeiten. Die Angaben dazu stammen jedoch von den jeweiligen Autoren. Nutzen Sie sie nur als Inspiration und prüfen Sie die Modelle anhand eigener Aufgaben.
- Aktualität des Wissens ist wichtig: Der Wissensstand von Fable 5.1 reicht bis 2026-06, der von GPT-6 Astra bis 2026-04-30. Der Unterschied beträgt rund zwei Monate und lässt sich gegebenenfalls durch Recherche-Tools ausgleichen.
So richten Sie Ihre eigene Evaluation ein
Das Grundprinzip der Evaluation lautet: „Alles bleibt gleich, nur der Modellname ändert sich.“ Gehen Sie dazu wie folgt vor:
- Wählen Sie 20 bis 50 Aufgaben aus dem tatsächlichen Arbeitsalltag aus. Decken Sie dabei die wichtigsten Typen wie Code, lange Dokumente und strukturierte Ausgaben ab und legen Sie für jede Aufgabe ein Erfolgskriterium fest.
- Halten Sie die System- und Benutzer-Eingabeaufforderungen, die maximale Anzahl an Ausgabe-Token und die Reasoning-Stufe konstant. Erfassen Sie bei Fable 5.1 den Wert für
effort, bei GPT-6 Astra den Namen der Stufe. - Erfassen Sie für jede Aufgabe die Input- und Output-Token, die End-to-End-Laufzeit sowie die manuelle Bewertung, ob die Aufgabe bestanden wurde.
- Kennzeichnen Sie Aufgaben mit mehr als 272.000 Input-Token separat und berechnen Sie die Kosten anhand der tatsächlich geltenden Preisstaffel.
- Führen Sie zunächst Baseline-Tests mit
claude-fable-5-1undgpt-6-astradurch. Sobald ein neues Modell verfügbar ist, ändern Sie nur den Modellnamen und führen denselben Aufgabensatz erneut aus.
Die Ergebnistabelle sollte mindestens die folgenden Felder enthalten, damit Sie die Ergebnisse später zwischen Modellen und über die Zeit vergleichen können:
| Feld | Erfasste Daten | Zweck |
|---|---|---|
| Aufgaben-ID und -typ | Code / langes Dokument / strukturierte Ausgabe usw. | Erfolgsquote nach Szenario aufschlüsseln |
| Modellname und Reasoning-Stufe | z. B. gpt-6-astra high |
Gleiche Bedingungen bei erneuten Durchläufen sicherstellen |
| Input- / Output-Token | Von der Plattform zurückgegebene usage-Daten |
Tatsächliche Kosten pro Aufgabe berechnen |
| Laufzeit | Von der Anfrage bis zur vollständigen Antwort | Nutzererfahrung bewerten |
| Manuell als bestanden bewertet | Ja / Nein + Begründung | Abschliessender Qualitätsindikator |
💡 Empfehlung: Wenn Sie die Modelle beider Anbieter mit demselben API-Schlüssel testen, vermeiden Sie, dass Netzwerk- und Rate-Limit-Unterschiede zwischen mehreren Konten die Ergebnisse verfälschen. Über APIYI apiyi.com können Sie beide einheitlich aufrufen. Die erfassten
usage-Felder haben dasselbe Format, sodass sich die Ergebnisse leichter zusammenführen lassen.
Häufige Fragen und Handlungsempfehlungen
F1: Zeigen die Demos auf Model Tests, dass Fable 5.5 stärker ist als GPT-6.2 Astra?
Nein. Die beiden Modelle haben nicht dieselbe Aufgabe bearbeitet. Auch die Reasoning-Stufen, die Daten und die Anzahl der Ergebnisse unterscheiden sich. Welches Modell jeweils verwendet wurde, geht zudem nur aus den Angaben der Autoren hervor. Die Demos zeigen also höchstens, dass beide Modelle laut diesen Angaben lauffähige oder anschaubare Ergebnisse erzeugen können.
F2: Sind Fable 5.5 und GPT-6.2 Astra erschienen? Wann sind sie verfügbar?
Stand 2026-11-03 führen die offiziellen Modellverzeichnisse beider Anbieter keines der beiden Modelle. Auch ein verlässliches Veröffentlichungsdatum gibt es nicht. Bei APIYI sind Fable 5.5 und GPT-6.2 Astra zu diesem Zeitpunkt ebenfalls noch nicht verfügbar. Wir werden beide Modelle schnellstmöglich aufnehmen; welche Modelle zu welchen Preisen verfügbar sind, steht in der Modellliste der Plattform. Nach der Aufnahme finden Sie sie direkt in der Modellliste auf APIYI unter apiyi.com.
F3: Ist der Screenshot mit 19,8 % Traffic glaubwürdig?
Er stammt aus einem persönlichen Screenshot des X-Nutzers TokenGremlin. Ein früherer Beitrag auf Linux.do zeigte nur 1,6 %, und die Modellauswahl zeigte weiterhin GPT-6 Astra. Auch die Berichte verschiedener Nutzer stimmen nicht überein. Beide Zahlen beruhen auf Angaben aus der Community und sind keine offiziellen Daten. Sie zeigen lediglich, dass der Modellname in den Nutzungsdetails einiger Konten aufgetaucht ist.
F4: Sollte man auf neue Modelle warten oder zunächst aktuelle Spitzenmodelle nutzen?
Unsere Empfehlung: Nutzen Sie zunächst die aktuellen Spitzenmodelle. Fable 5.1 und GPT-6 Astra haben die gleichen Stückpreise, gehören beide zur Leistungsspitze und lassen sich schon jetzt produktiv einsetzen. Noch wichtiger ist es, zunächst einen eigenen Katalog mit Evaluierungsaufgaben aufzubauen. So können Sie neue Modelle nach ihrer Veröffentlichung schnell beurteilen. Auf APIYI unter apiyi.com können Sie mit kostenlosem Testguthaben zunächst kleine Stichproben durchführen und Ihren Evaluierungsprozess überprüfen.
F5: Wenn die aktuellen Spitzenmodelle gleich viel kosten, können sich die Gesamtkosten trotzdem unterscheiden?
Ja. Bei `gpt-6-astra` steigt der Eingabepreis von $10 auf $20, sobald eine einzelne Eingabe 272,000 Tokens überschreitet. Das Lesen aus dem Cache kostet $1, bei `claude-fable-5-1` dagegen $0.25. Besonders deutlich sind die Unterschiede bei langen Kontexten und häufigen Cache-Treffern. Berechnen Sie die Kosten daher am besten anhand Ihrer tatsächlichen Token-Verteilung.
Handlungsempfehlung
Teams, die diesen Monat ein Modell auswählen, empfehlen wir drei Schritte: Stellen Sie diese Woche 20 bis 50 Aufgaben aus Ihrem Arbeitsalltag samt Erfolgskriterien zusammen. Testen Sie dann bei APIYI apiyi.com mit demselben API-Schlüssel claude-fable-5-1 und gpt-6-astra als zwei Baselines. Erfassen Sie dabei Token-Verbrauch, Laufzeit und die Erfolgsquote bei manueller Bewertung. Sobald Fable 5.5 oder GPT-6.2 Astra offiziell veröffentlicht und auf der Plattform verfügbar sind, ändern Sie nur den Modellnamen und führen denselben Test erneut durch. So erhalten Sie Vergleichsdaten für Ihre eigenen Aufgaben unter gleichen Bedingungen – zuverlässiger als jede Demo oder jeder Screenshot. Maßgeblich für Modellnamen und Preise ist die Modellliste der Plattform.
Quellen
- OpenAI-Modellverzeichnis: Offizielle Spezifikationen und Preise für GPT-6 Astra
- Link:
developers.openai.com/api/docs/models - Hinweis: Abgerufen am 03.11.2026; GPT-6.2 Astra war nicht im Verzeichnis aufgeführt
- Anthropic-Plattform: Preis- und Modellseiten: Offizielle Spezifikationen, Preise und Cache-Abrechnung für Fable 5.1
- Link:
platform.claude.com - Hinweis: Abgerufen am 03.11.2026; Fable 5.5 wurde weder auf der Preis- noch auf der Nachrichtenseite genannt
- Model Tests, unabhängige Testseite: Sammlung öffentlicher Demos des Autors @notjazii
- Link:
model-tests.vercel.app - Hinweis: Die Angaben zu den verwendeten Modellen stammen vom Autor selbst; Eingabeaufforderungen und Aufrufprotokolle liegen nicht vor
Autor: APIYI-Technikteam
Technischer Austausch: Besuchen Sie die Startseite von APIYI apiyi.com, um uns zu kontaktieren. Informationen zu Modellen und zur Integration finden Sie unter docs.apiyi.com