Zusammenfassung: Dieser Artikel zeigt, wie man mit dem OpenAI Python SDK die Tencent Hunyuan Hy4 API im nicht-streamenden Modus aufruft, einen ersten reinen Text-Request durchführt und wie man anschließend das Ergebnis prüft, die Kosten schätzt, die Rechnung abgleicht und häufige Fehlermeldungen behandelt.
Direkte Antwort: Die Tencent Hunyuan Hy4 API lässt sich über die OpenAI-kompatible Schnittstelle von APIYI anbinden. Drei Konfigurationen genügen, um den ersten Request abzuschicken:
- Key: unter
api.apiyi.com/tokenerstellen und in der UmgebungsvariableAPIYI_API_KEYablegen. - SDK Base URL:
https://api.apiyi.com/v1. - Modell-ID:
hy4.
Der zugehörige HTTP-Endpunkt ist POST https://api.apiyi.com/v1/chat/completions. Stand 21.11.2026 liegen die Preise für Hy4 in der Preistabelle pro Million Token bei: Input ohne Cache-Treffer $0.85, Output $2.55, Cache-Lesen $0.045. Die tatsächliche Abrechnung richtet sich nach der APIYI-Preistabelle unter docs.apiyi.com/models (Kategorie Tencent).
Die Timeline sieht so aus: Tencent veröffentlichte am 4. November die finale Version von Hy4, am 20. November wurden die Gewichte freigegeben. APIYI hat das Modell bereits vor der Gewichtsfreigabe gelistet, die Ankündigung dazu findet sich unter docs.apiyi.com/news/hy4-launch. Die Ankündigung enthält bereits ein Streaming-Beispiel, deshalb behandelt dieser Artikel nur die anderen vier Punkte: nicht-streamender Aufruf, Ergebnisprüfung, Rechnungsabgleich und Fehlerbehandlung. Die Ankündigung erwähnt, dass Hy4 Bild-Input unterstützt; dieser Artikel zeigt ausschließlich reinen Text. Video, Responses-API und Computer Use liegen außerhalb des Umfangs dieses Artikels, und der Artikel enthält keinerlei Messdaten.
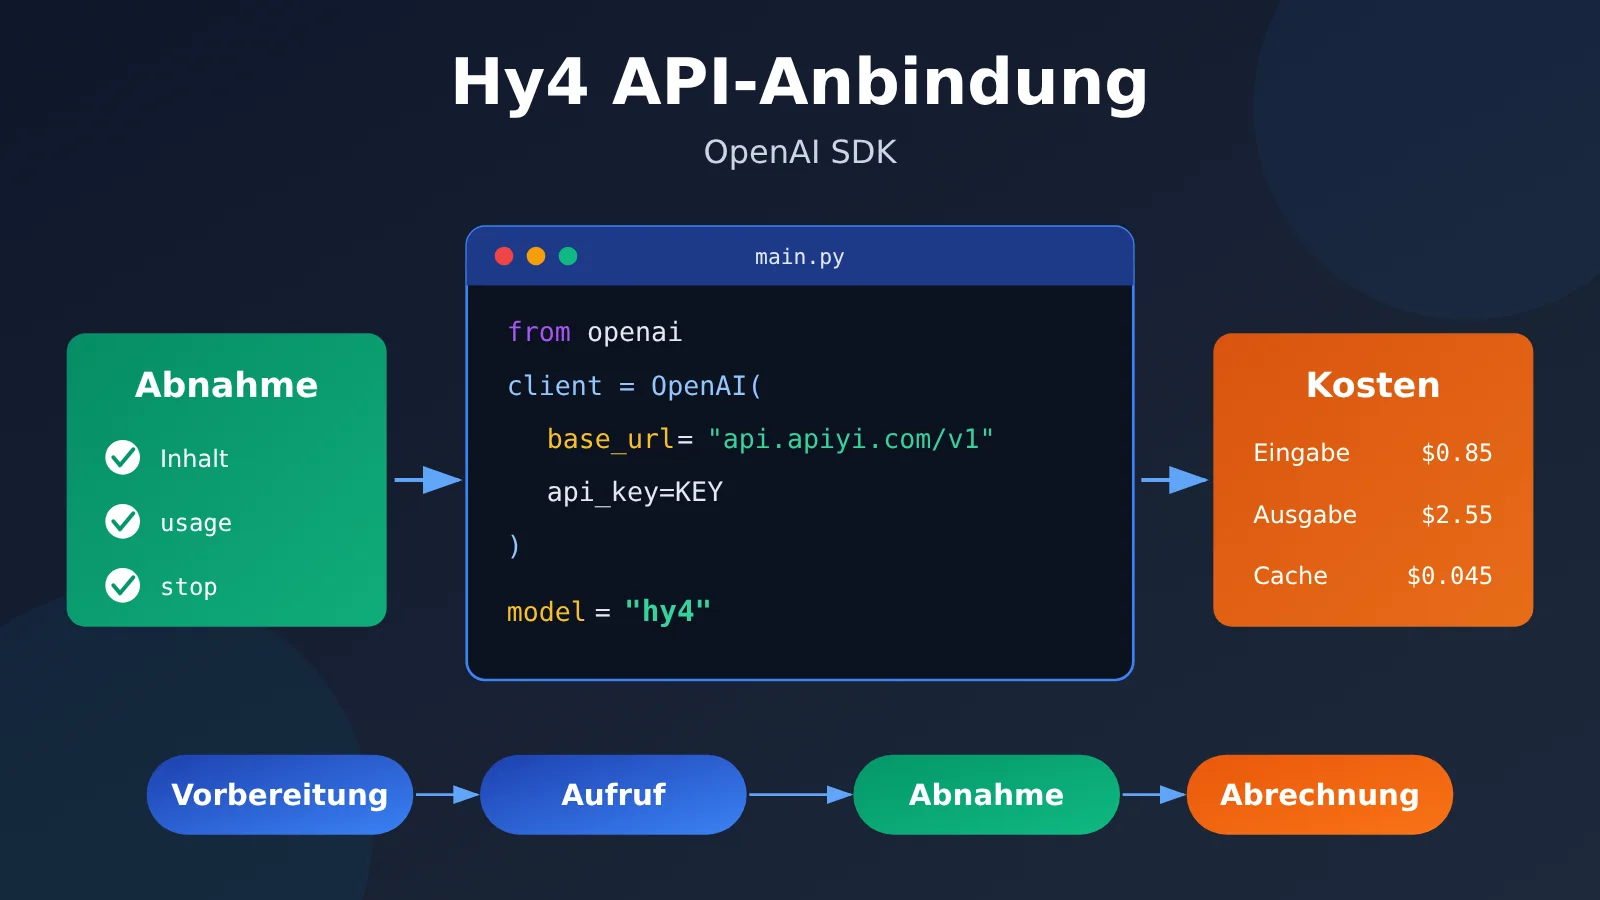
Wissenslandkarte und Lesereihenfolge für die Hy4-API-Integration von Tencent Hunyuan
Der gesamte Ablauf besteht aus vier Schritten, wobei die Ausgabe des vorherigen Schritts jeweils die Eingabe des nächsten ist. Es empfiehlt sich, in der nummerierten Reihenfolge zu lesen. Abschnitt 4 kann bei Fehlermeldungen separat nachgeschlagen werden.
| Schritt | Zugehöriger Haupttext | Warum er hier steht | Abnahmekriterien |
|---|---|---|---|
| Anfrage vorbereiten | 1.1, 1.2 | Sind Endpunkt, Modellname oder Key falsch geschrieben, schlagen alle folgenden Schritte fehl | Das SDK lässt sich importieren, die Umgebungsvariable kann den Key lesen, im Code steht kein Klartext-Key |
| Erster Aufruf | 2.1, 2.2 | Zuerst mit einem kurzen Text ohne Kundendaten bestätigen, dass die Verbindung steht | Der zurückgegebene Inhalt lautet „Produkt=Hunyuan, Version=Hy4″, es gibt keine Kürzung, und usage sowie request ID wurden gespeichert |
| Abrechnung prüfen | 3.1, 3.2 | Erst nachdem die Verbindung steht, die Kosten schätzen, um zu beurteilen, ob das Aufrufvolumen erhöht werden kann | Die geschätzten Werte lassen sich Punkt für Punkt mit dem Verbrauchsprotokoll der Konsole abgleichen |
| Fehlerbehebung | 4 | Wenn ein Schritt fehlschlägt, die Ursache anhand von Fehlercode und Fehlerkörper lokalisieren | Konfigurationsfehler, Berechtigungsprobleme, Ratenbegrenzung und Timeout unterscheiden können und beurteilen, ob ein Wiederholungsversuch möglich ist |
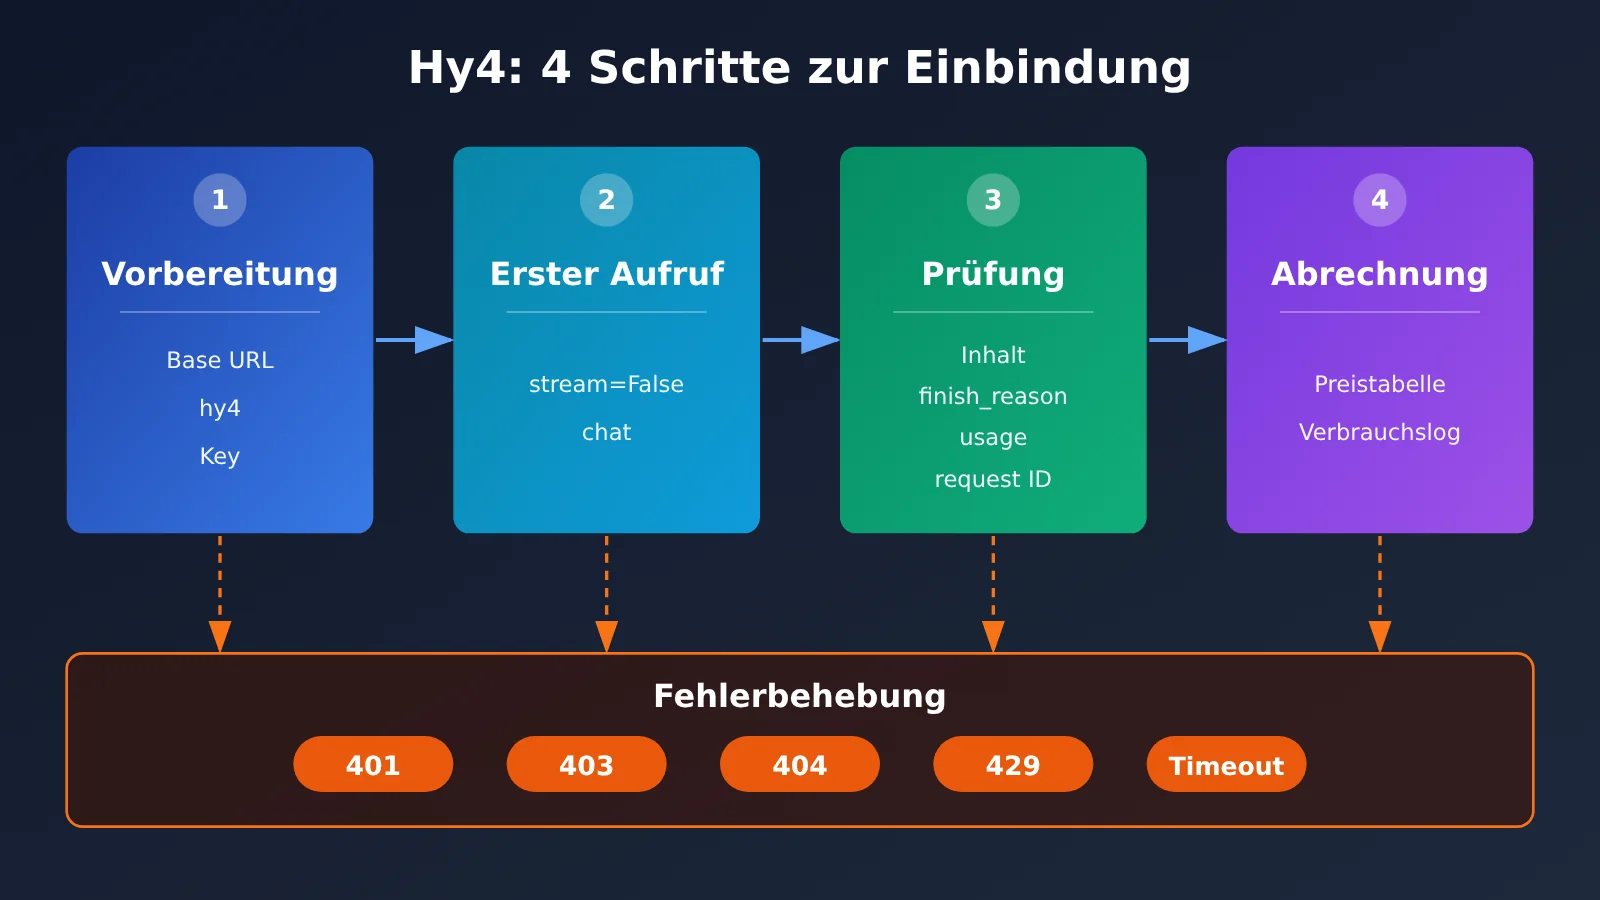
To Know: Begriffe rund um die Hy4-API
| Begriff | Kurze Erklärung |
|---|---|
| Nicht-streamend (stream=False) | Das Modell gibt nach Abschluss der Generierung das komplette Ergebnis auf einmal zurück, was die gesamte Prüfung von Inhalt und Verbrauch erleichtert |
| finish_reason | Der Grund für das Ende dieser Generierung. stop bedeutet normales Ende, length bedeutet, dass die Längenobergrenze erreicht und der Text gekürzt wurde |
| usage | Das Token-Verbrauchsfeld in der Antwort, üblich sind prompt_tokens (Eingabe) und completion_tokens (Ausgabe) |
| request ID | Die Kennung einer einzelnen Anfrage, mit der sich dieser Aufruf im Protokoll lokalisieren lässt. Nicht jede Antwort enthält sie zwangsläufig |
| Cache-Lesen | Der Teil der Eingabe, der den Cache getroffen hat, wird zu einem separaten Cache-Lese-Preis abgerechnet |
| Gruppe (Default/SVIP) | Die Gruppe, zu der das Token gehört, bestimmt, welche Modelle dieses Token aufrufen kann |
1. Vorbereitung der Tencent Hunyuan Hy4 API-Anfrage
1.1 Hy4-Modell und Endpunkt konfigurieren
Bitte überprüfen Sie die Konfigurationsoptionen einzeln. Die meisten fehlgeschlagenen ersten Aufrufe scheitern an diesem Schritt.
| Konfigurationsoption | Wert | Beschreibung |
|---|---|---|
| SDK base_url | https://api.apiyi.com/v1 |
Nur bis /v1 angeben, das SDK hängt automatisch /chat/completions an |
| HTTP-Endpunkt | POST https://api.apiyi.com/v1/chat/completions |
Diese Adresse verwenden, wenn Sie kein SDK einsetzen und HTTP-Anfragen direkt senden |
| Modell-ID | hy4 |
Der Modellname der offiziellen Version, in Kleinbuchstaben unverändert eintragen |
| Verfügbare Gruppen | Default, SVIP | Die Gruppe, in der sich das Token befindet, muss Hy4 enthalten |
| Ausgabemodus | stream=False |
In diesem Artikel wird durchgängig der nicht-streamende Modus verwendet |
Der häufigste Fehler besteht darin, den vollständigen Endpunkt in base_url einzutragen. Das SDK hängt an diese Adresse erneut /chat/completions an, wodurch der Pfad doppelt vorkommt und schließlich ein 404 zurückgegeben wird. Die vollständige Beschreibung der kompatiblen Schnittstelle finden Sie unter docs.apiyi.com/api-capabilities/openai/compatible.
1.2 OpenAI SDK installieren und Key sicher speichern
Die Projektadresse des offiziellen Python SDK lautet github.com/openai/openai-python. Es wird empfohlen, in einer virtuellen Umgebung zu installieren, um Versionskonflikte mit bereits im System vorhandenen Paketen zu vermeiden:
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
python -m pip install openai
Der Key wird unter api.apiyi.com/token erstellt. Achten Sie bei der Erstellung darauf, dass die Gruppe des Tokens Hy4 aufrufen kann. Schreiben Sie den Key nach Erhalt in die Umgebungsvariablen des aktuellen Terminals und nicht in die Codedatei:
export APIYI_API_KEY="你的令牌" # Windows PowerShell: $env:APIYI_API_KEY="你的令牌"
Beachten Sie beim Key-Management folgende Punkte:
- Der Code liest den Key ausschließlich über
os.environ['APIYI_API_KEY']. Ist keine Umgebungsvariable gesetzt, verwenden Sie die interaktive Eingabe mitgetpass; die Eingabe wird nicht auf dem Bildschirm angezeigt. - Wenn Sie den Key in einer
.env-Datei speichern, nehmen Sie sie in.gitignoreauf, damit sie nicht ins Repository gelangt. - Wenn der Key in Screenshots, Logs oder Tickets auftaucht, ersetzen Sie ihn zunächst durch eine Maske wie
sk-***.
Akzeptanzprüfung: Führen Sie im Terminal python -c "import openai, os; print(openai.__version__, bool(os.environ.get('APIYI_API_KEY')))" aus. Wenn Versionsnummer und True ausgegeben werden, ist dieser Schritt abgeschlossen.
2. Die erste Hy4-Anfrage mit dem OpenAI SDK senden
2.1 Vollständiges Python-Beispiel ohne Streaming
Diese erste Anfrage erledigt nur eine einfache Aufgabe: Aus einem öffentlichen Satz werden Produktname und Versionsnummer extrahiert, ohne jegliche Kundendaten. Diese Gestaltung hat zwei Vorteile. Erstens ist die Ausgabe kurz und die Kosten sind niedrig. Zweitens ist die Antwort eindeutig, sodass sich leicht beurteilen lässt, ob sie richtig ist.
Ein paar Einstellungen im Beispiel verdienen eine Erklärung:
max_retries=0deaktiviert die automatische Wiederholung im SDK. In Abschnitt 4 wird beschrieben, dass der Server die Anfrage nach einem Timeout möglicherweise bereits ausgeführt hat; ein automatisches erneutes Senden kann dann zu doppelter Abrechnung führen. Ob wiederholt werden soll, muss daher ein Mensch entscheiden.- Die
with-Anweisung schließt die Verbindung nach dem Aufruf. - Wenn das
usage-Feld fehlt, gibt der Code ausdrücklich „缺失“ aus und behandelt es nicht als 0. So werden bei der späteren Abrechnung keine Kosten übersehen.
import os
import re
from getpass import getpass
from openai import OpenAI

key = os.environ.get("APIYI_API_KEY") or getpass("输入 APIYI_API_KEY:")

PROMPT = "仅从这句话提取产品和版本:腾讯混元 Hy4 正式版已上线。请只写一行:产品=…;版本=…"

with OpenAI(
    base_url="https://api.apiyi.com/v1",   # OpenAI-kompatible APIYI-Schnittstelle
    api_key=key,
    timeout=60.0,
    max_retries=0,                         # Automatische Wiederholung deaktivieren; bei Fehlern entscheidet ein Mensch, ob erneut gesendet wird
) as client:
    result = client.chat.completions.create(
        model="hy4",
        messages=[{"role": "user", "content": PROMPT}],
        stream=False,
    )

request_id = getattr(result, "_request_id", None)
print("request_id:", request_id if request_id else "响应未提供")

if not result.choices:
    raise SystemExit("未通过:choices 为空,没有返回正文")

choice = result.choices[0]
content = (choice.message.content or "").strip()
print("finish_reason:", choice.finish_reason)
print("content:", content)

usage = getattr(result, "usage", None)
prompt_tokens = getattr(usage, "prompt_tokens", None) if usage else None
completion_tokens = getattr(usage, "completion_tokens", None) if usage else None
print("prompt_tokens:", prompt_tokens if prompt_tokens is not None else "缺失(不按 0 处理)")
print("completion_tokens:", completion_tokens if completion_tokens is not None else "缺失(不按 0 处理)")


def accept(text: str, finish_reason) -> tuple[bool, str]:
    if not text:
        return False, "正文为空"
    if finish_reason == "length":
        return False, "输出被截断"
    t = re.sub(r"\s+", "", text)
    t = t.replace(":", "=").replace(":", "=").replace(";", ";")
    prod = re.search(r"产品=([^;\n]+)", t)
    ver = re.search(r"版本=([^;\n]+)", t)
    if not prod or not ver:
        return False, "缺少产品或版本字段"
    strip_punct = lambda s: re.sub(r"[。..,,、!!??\"“”'‘’]", "", s)
    if "混元" not in strip_punct(prod.group(1)):
        return False, f"产品值错误:{prod.group(1)}"
    if strip_punct(ver.group(1)) != "Hy4":
        return False, f"版本值错误:{ver.group(1)}"
    return True, "通过"


ok, reason = accept(content, choice.finish_reason)
print("验收:", reason)
Weitere Hinweise zur Antwortstruktur finden sich unter docs.apiyi.com/api-capabilities/openai/response-handling.
2.2 Abnahmekriterien für die erste Hy4-Anfrage
Bei der Abnahme werden nur zwei Felder in message.content geprüft: Der Produktwert enthält „混元“, der Versionswert ist „Hy4“. Unterschiede bei vollbreiten oder halbbreiten Doppelpunkten und Semikolons sowie bei der Satzschlusszeichensetzung sind zulässig. Nachfolgend eine Zeile, die die Anforderung erfüllt – dies ist ein illustratives Format, keine tatsächlich gemessene Antwort:
产品=腾讯混元;版本=Hy4
Die folgenden Fälle gelten ausnahmslos als nicht bestanden – sie dürfen nicht durchgewunken werden, nur weil es „ungefähr gleich aussieht“:
| Situation | Bewertung | Grund |
|---|---|---|
| choices ist leer oder content ist ein leerer String | Nicht bestanden | Kein Antworttext erhalten – die Kette läuft also nicht wirklich durch |
finish_reason ist length |
Nicht bestanden | Ausgabe wurde abgeschnitten, Ergebnis unvollständig |
| Version als Hy3, Hunyuan oder ein anderer Wert geschrieben | Nicht bestanden | Falscher Feldwert |
| Nur Unterschiede bei Voll-/Halbbreite von Satzzeichen, Leerzeichen oder Doppelpunkten | Bestanden | Zulässige Formatabweichung |
Nach bestandener Abnahme notieren Sie die Request-ID (falls in der Antwort vorhanden), den Anfragezeitpunkt, den Modellnamen, prompt_tokens und completion_tokens. Diese Angaben werden in Abschnitt 3.2 bei der Rechnungsprüfung benötigt.
3. Hy4-API-Kosten schätzen und prüfen
3.1 Einen Batch-Job anhand der Preistabelle kalkulieren
Die Eingabe der ersten Anfrage ist sehr kurz, die Kosten sind vernachlässigbar; sie taugt kaum als Grundlage für eine Kostenschätzung. Im Folgenden wechseln wir zu einem hypothetischen Szenario, das nichts mit der kurzen Beispielanfrage zu tun hat: Ein Job hat 100.000 Token Eingabe, alle ohne Cache-Treffer, und 20.000 Token Ausgabe. Eingabe und Ausgabe werden jeweils mit ihrem eigenen Stückpreis berechnet:
| Abrechnungsposten | Angenommene Nutzung | Preis (pro Million Token) | Kosten |
|---|---|---|---|
| Eingabe ohne Cache-Treffer | 100.000 | $0.85 | $0.085 |
| Ausgabe | 20.000 | $2.55 | $0.051 |
| Gesamt | — | — | $0.136 |
Die Rechnung lautet 0,1 × 0,85 + 0,02 × 2,55 = 0,136. Bei der Schätzung sind zwei Punkte zu beachten:
- Der Ausgabepreis ist dreimal so hoch wie der Preis für Eingaben ohne Cache-Treffer. Bei Jobs mit hohem Ausgabevolumen bestimmen die Ausgaben den Großteil der Kosten.
- Wenn completion_tokens bereits den Reasoning-Teil des Modells enthält, addieren Sie die Reasoning-Kosten nicht noch einmal separat; sonst wird doppelt gerechnet.
3.2 Cache-Bucket und tatsächliches Abrechnungsprotokoll auseinanderhalten
„Cache-Lesevorgänge“ sind ein separat abgerechneter Anteil, aber die Felder werden in verschiedenen Antworten nicht unbedingt gleich aufgeteilt. Deshalb gibt es keinen allgemein gültigen Feldnamen, der ein exaktes Ergebnis garantiert. Verlässlich ist es, zuerst in der Abrechnung zu prüfen, ob die Token mit Cache-Treffer bereits in der Gesamteingabe enthalten sind.
Wenn die Abrechnung bestätigt, dass der Cache-Anteil bereits in der Gesamteingabe enthalten ist, ziehen Sie den Cache-Anteil einmal von der Gesamteingabe ab und berechnen dann getrennt. Im Folgenden übernehmen wir die Annahmen aus 3.1 und nehmen zusätzlich an, dass von den 100.000 Eingabetoken 40.000 einen Cache-Treffer haben:
| Abrechnungsposten | Angenommene Nutzung | Preis (pro Million Token) | Kosten |
|---|---|---|---|
| Eingabe ohne Cache-Treffer | 60.000 | $0.85 | $0.051 |
| Cache-Lesevorgänge | 40.000 | $0.045 | $0.0018 |
| Ausgabe | 20.000 | $2.55 | $0.051 |
| Gesamt | — | — | $0.1038 |
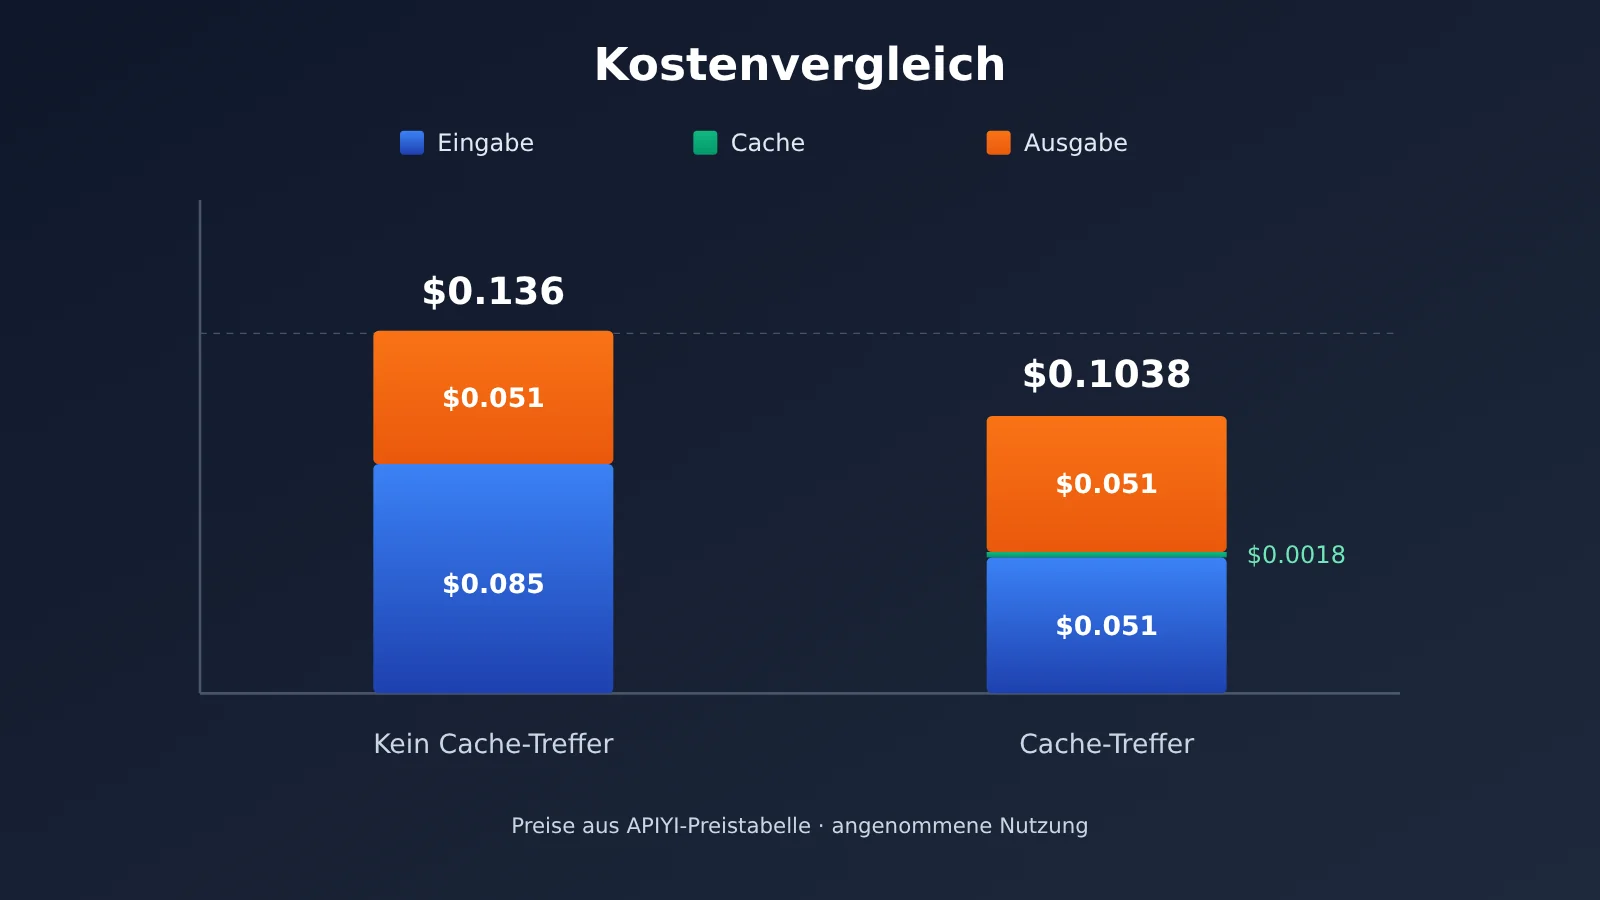
Schätzwerte dienen nur als Referenz; maßgeblich ist letztlich das Abrechnungsprotokoll. Zum Prüfen filtern Sie in der Konsole unter api.apiyi.com/log die entsprechenden Einträge:
- Den Zeitraum anhand der Anfragezeit eingrenzen.
- Wenn die Antwort eine Request-ID enthält, können Sie damit genau diese Anfrage lokalisieren.
- Stellen Sie sicher, dass das Modell
hy4ist und das Token mit dem Token übereinstimmt, das der Code tatsächlich verwendet. - Vergleichen Sie Eingabe-, Cache- und Ausgabemenge sowie den abgebuchten Betrag im Protokoll mit den Schätzwerten.
Die genaue Bedeutung der Protokollfelder finden Sie unter docs.apiyi.com/faq/log-billing-explained.
4. Fehlerbehebung bei der Hy4-API
Bei der Fehlerbehebung schauen Sie zuerst auf den HTTP-Statuscode und lesen dann die konkreten Informationen im Fehlerbody. Wenn Sie nur den Statuscode betrachten, kommt es leicht zu Fehleinschätzungen – so kann etwa ein 429 völlig unterschiedliche Ursachen haben. Fangen Sie am ursprünglichen Request aus Abschnitt 2.1 die SDK-Ausnahmen ab: Bei Verbindungs-Timeouts prüfen Sie APITimeoutError, bei anderen Verbindungsfehlern APIConnectionError; wenn Sie eine Fehlerantwort erhalten, protokollieren Sie aus APIStatusError den status_code, die request_id und den Fehlerbody. Prüfen Sie zuerst das Ergebnis des bestehenden Requests und entscheiden Sie dann, ob ein Retry nötig ist; vor dem Weitergeben anonymisieren Sie den Fehlerbody. Die Reihenfolge sieht so aus:
| Fehler | Zuerst prüfen | Retry? |
|---|---|---|
| 401 | Ist der API-Schlüssel korrekt, ist er noch gültig, und zeigt die base_url auf https://api.apiyi.com/v1 |
Vor Korrektur der Konfiguration nicht wiederholen |
| 403 | Anhand des Fehlerbodys prüfen, ob es sich um ein Problem mit Gruppenberechtigungen handelt, und sicherstellen, dass die Gruppe des Tokens Hy4 enthält | Vor Korrektur der Berechtigungen nicht wiederholen |
| 404 | Wurde der Pfad doppelt mit /chat/completions zusammengesetzt, lautet der Modellname hy4 |
Vor Korrektur der Konfiguration nicht wiederholen |
| 429 | Anhand des Fehlerbodys entscheiden, ob es sich um eine temporäre Ratenbegrenzung oder ein unzureichendes Kontingent handelt | Bei temporärer Ratenbegrenzung ist ein begrenzter Retry mit Backoff möglich; bei unzureichendem Kontingent müssen Sie zuerst aufladen oder das Kontingent anpassen |
| Verbindungsfehler | Sind Netzwerk, Proxy und DNS in Ordnung, und stimmen Protokoll und Domain der base_url | Nach Wiederherstellung des Netzwerks kann wiederholt werden |
| Timeout | Zuerst in api.apiyi.com/log nach dem Zeitpunkt suchen und prüfen, ob die Anfrage bereits ausgeführt wurde |
Wenn bereits ausgeführt, nicht erneut senden; erst wenn nicht ausgeführt, wiederholen |
Zwei Fälle verdienen besondere Beachtung: 429 und Timeouts:
- Backoff-Retry bei 429: Gilt nur für temporäre Ratenbegrenzung. Die Anzahl der Wiederholungen muss begrenzt sein, und der Abstand zwischen den Versuchen wird schrittweise verlängert. Bei unzureichendem Kontingent führt kein Retry zum Erfolg, egal wie oft.
- Timeout: Dass der Client innerhalb von 60 Sekunden keine Antwort erhalten hat, bedeutet nicht, dass der Server die Anfrage nicht verarbeitet hat. Wenn der Server bereits fertig ist, wird durch direktes erneutes Senden die Anfrage ein zweites Mal ausgeführt – und die Kosten werden ein zweites Mal berechnet. Deshalb sollten Sie zuerst die Logs prüfen, bestätigen, dass die Anfrage nicht ausgeführt wurde, und dann erneut senden.
Wenn Sie den technischen Support kontaktieren müssen, anonymisieren Sie vor dem Absenden die sensiblen Informationen im Fehlerbody und in den Logs – etwa API-Schlüssel und Kundendaten – und fügen Sie dann Statuscode, Anfragezeitpunkt, Modellname und Request-ID bei. Wie Fehlermeldungen aufbewahrt und eingereicht werden, steht unter docs.apiyi.com/api-manual/error-reporting.
Wenn alle Fehlerbehebungen abgeschlossen sind, führen Sie das Beispiel aus Abschnitt 2.1 einmal erneut aus; die gesamte Prozedur gilt nur dann als bestanden, wenn alle drei Bedingungen gleichzeitig erfüllt sind:
- Die Abnahmefunktion gibt „Bestanden“ aus.
finish_reasonist nichtlength.- In den Konsolen-Logs findet sich zum selben Zeitpunkt ein Eintrag mit dem Modell
hy4, und die verbrauchte Menge stimmt mit der lokal protokolliertenusageüberein.