Anhand von Migrations-, Kundenservice- und Codebeispielen mit GPT-6.1 Sol und GPT-6.2 Sol zeigt dieser Artikel, wie man zuerst die fachlichen Abnahmebedingungen fixiert, dann die Reasoning-Stufe auswählt, die diese zuverlässig erfüllt, und schließlich die Kosten pro bestandener Aufgabe berechnet.
Fazit vorweg: Beim Wechsel der Stufe sollte man vergleichen, „wie viel Geld und Zeit jede bestandene Aufgabe kostet“; der Listenpreis pro Aufruf ist nur einer der Faktoren. In den veröffentlichten Tests mit kleinem Stichprobenumfang erreichte low bei GPT-6.2 Sol sowohl bei Kundenservice-Fragen zu Richtlinien als auch bei einer Reihe von Codeaufgaben die gleiche Anzahl bestandener Aufgaben wie medium und war dabei schneller. Bei den Codeaufgaben lagen die aus dem Listenpreis abgeleiteten Kosten für low bei etwa 70 % von medium. Damit dieses Ergebnis trägt, müssen zwei Bedingungen erfüllt sein: Ihre Aufgaben müssen den Testaufgaben ausreichend ähnlich sein, und die Abnahmeschwelle darf nicht nur die Bestehensquote prüfen, sondern muss auch halluzinierte Links, Betragsfelder und Nacharbeit kontrollieren. Bei Aufgaben mit Konflikten zwischen Quellen, komplexen Tool-Abhängigkeiten oder leicht zu übersehenden Einschränkungen sollte man medium und höhere Stufen weiterhin separat prüfen.
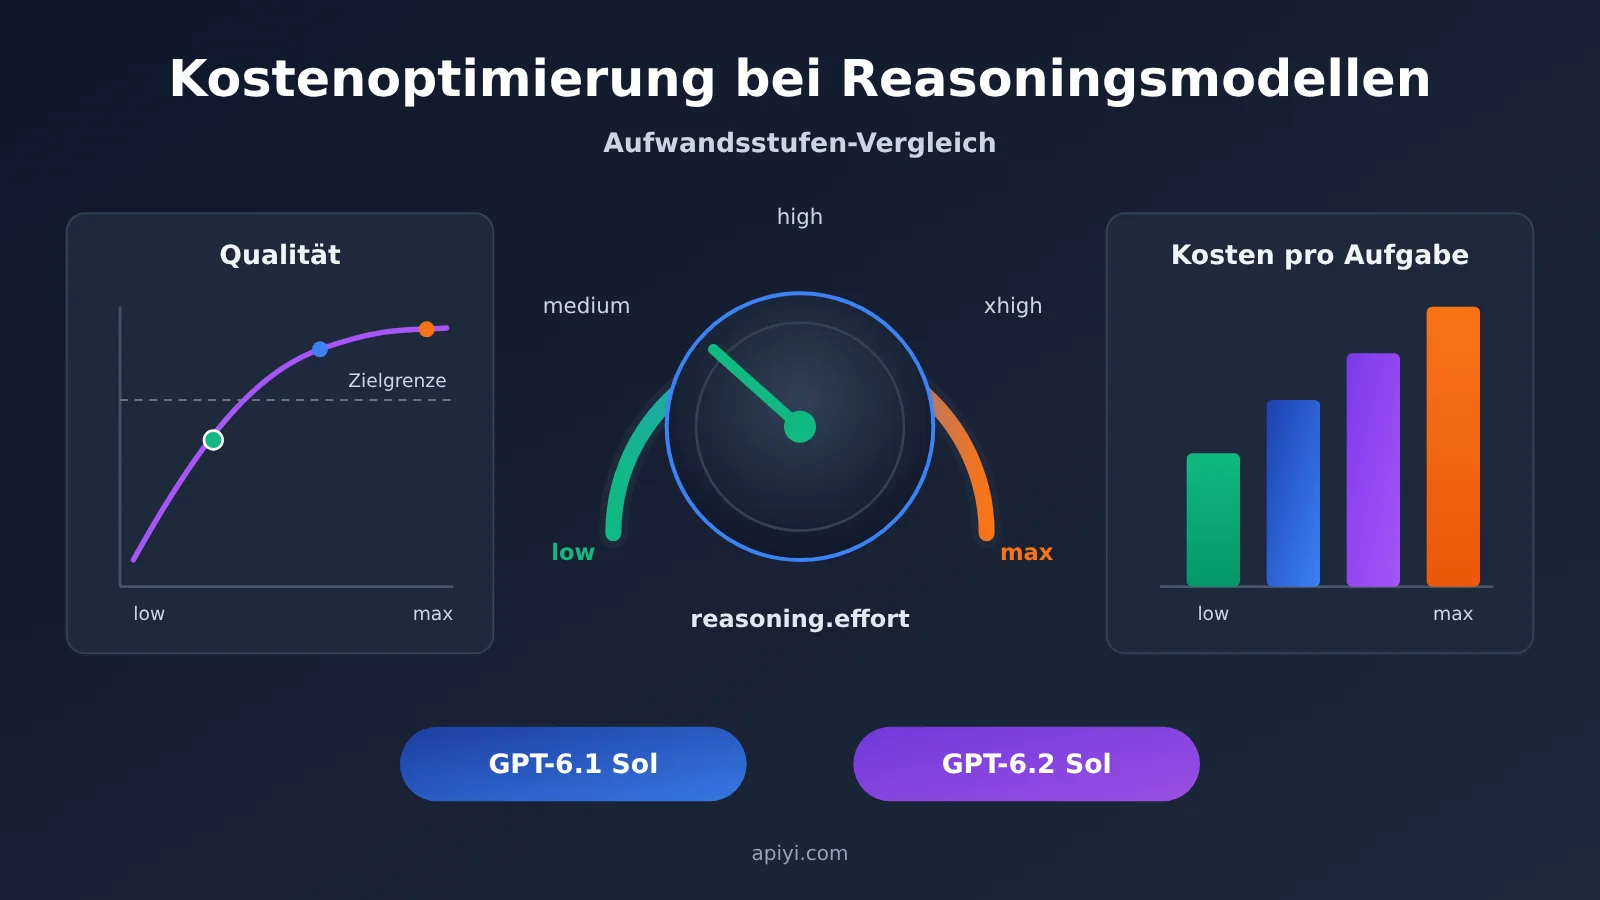
Kurzvergleich der Effort-Stufen bei Reasoning-Modellen
Die folgende Tabelle fasst die Evidenzgruppen zusammen, die in diesem Artikel verwendet werden; jede Zeile nennt Quelle und Erhebungsgrundlage. Zahlen aus unterschiedlichen Quellen dürfen nicht direkt addiert oder gemischt werden.
| Vergleichsdimension | GPT-6.1 Sol | GPT-6.2 Sol | Was die Differenz bedeutet |
|---|---|---|---|
| Verfügbare Stufen (OpenAI-Dokumentation) | low, medium, high, xhigh, max | Dieselben fünf Stufen; none wird abgelehnt |
Beim Wechsel von Modellen, die none/minimal erlauben, muss die Einstiegsstufe angepasst werden |
| APIYI-Listenpreis für kurzen Kontext (Übersichtstabelle vom 2026-11-20, USD pro Million Token) | Eingabe $2, Cache-Lesen $0.10, Ausgabe $10 | Wie links | Bei kurzem Kontext sind die Preise beider Generationen gleich; Kostenunterschiede entstehen vor allem durch das Nutzungsvolumen |
| Eingabepreis bei mehr als 272,000 Eingabe-Token | APIYI und OpenAI Standard führen beide $4 auf | APIYI führt $3 auf, OpenAI Standard $4 | Bei langen Eingaben entstehen Preisunterschiede zwischen den Kanälen |
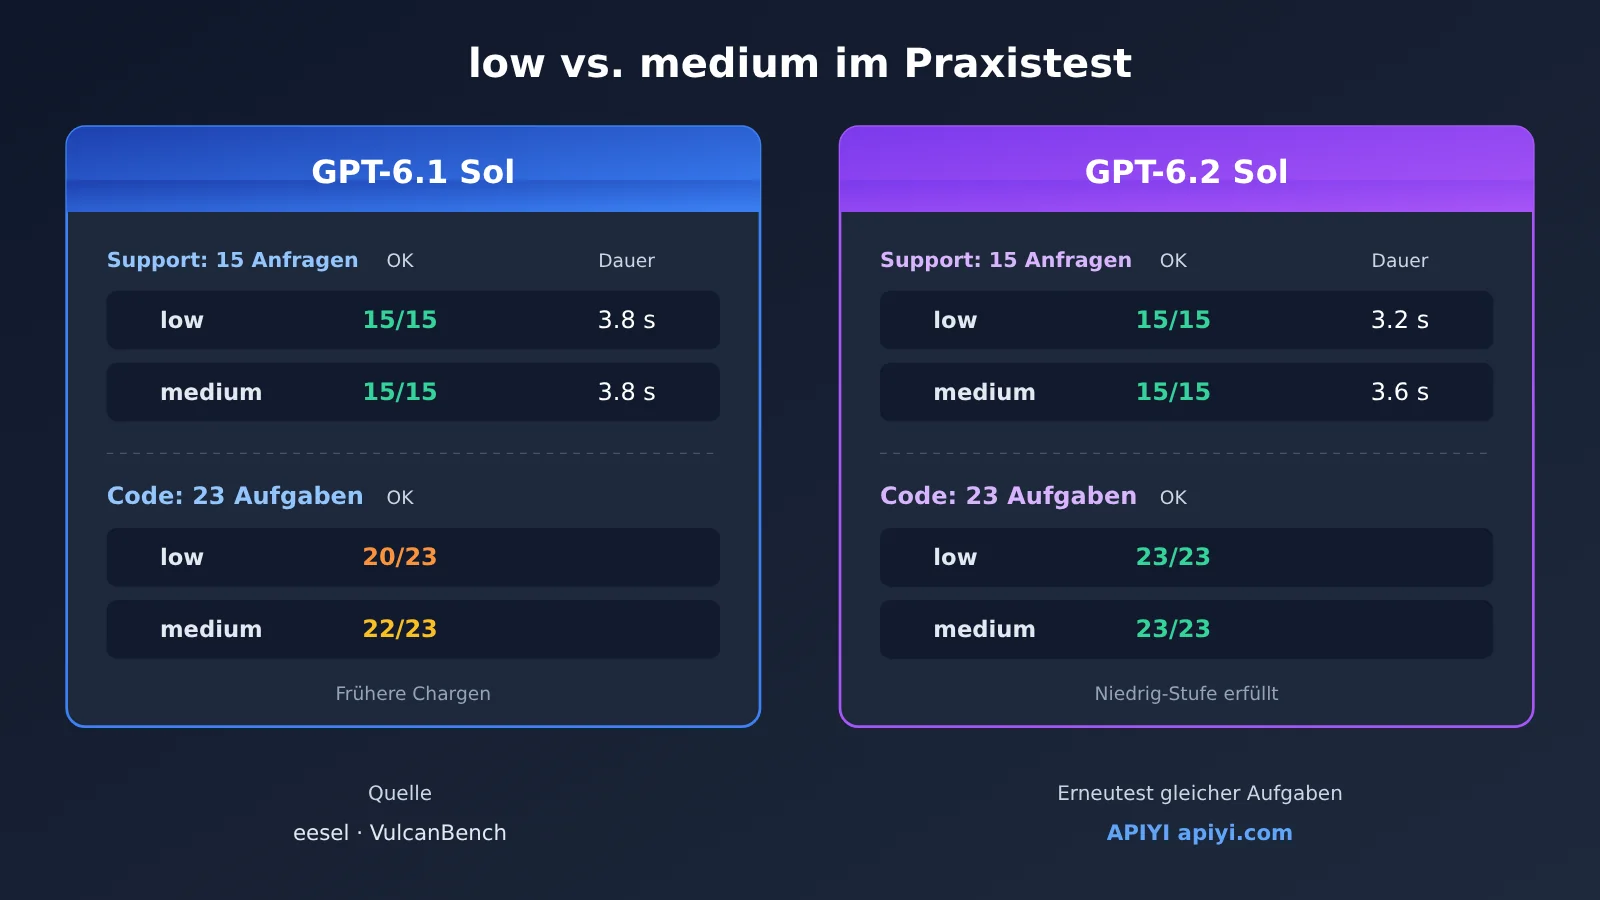
| eesel-Kundensupport, 15 Tickets (low / medium) | 15/15, 3.8 Sekunden; 15/15, 3.8 Sekunden | 15/15, 3.2 Sekunden; 15/15, 3.6 Sekunden | Gleiche Erfolgsquote; die Kostenunterschiede zwischen den Stufen sind gering |
| VulcanBench, 23 Coding-Aufgaben (low / medium) | 20/23; 22/23 (früherer Batch) | 23/23; 23/23 | 6.2 Sol erreicht die Zielmarke bereits in der niedrigen Stufe; die versionsübergreifenden Zahlen stammen aus unterschiedlichen Batches |
| Artificial Analysis Index (zitiert über OrcaRouter, low / medium) | 35; 46 | 41; 53 | Aggregierter Index eines Drittanbieters; die Stufenbezeichnungen werden von der jeweiligen Evaluierung selbst zugeordnet |
Der Hauptteil ist wie folgt gegliedert: Abschnitt 1 klärt, ob eine Anbindung möglich ist und wie die Abrechnung erfolgt; Abschnitt 2 betrachtet Messergebnisse für dieselben Aufgaben; Abschnitt 3 beschreibt Migrations- und Abnahmeschritte; Abschnitt 4 behandelt das Umschalten der Stufe mitten in einer laufenden Mehrfachrunde. Wenn Sie Modell-Routing und Preise bereits geprüft haben, können Sie direkt mit Abschnitt 2 beginnen.
Wichtige Begriffe zu Reasoning-Effort-Stufen
| Begriff | Erklärung |
|---|---|
reasoning.effort |
Feld in der Responses API, mit dem sich die Denkintensität des Modells festlegen lässt |
| Reasoning-Token | Der Reasoning-Aufwand, den das Modell verbraucht, um eine Antwort zu erarbeiten. Er ist in den abgerechneten output_tokens enthalten und muss von der für Nutzer sichtbaren Ausgabe unterschieden werden |
low / medium |
Zwei Reasoning-Stufen. Auch beim Wechsel derselben Stufe auf eine neue Version ist eine erneute Abnahme nötig |
| Cache-Lesepreis | Gilt nur für den Teil der Eingabe, der einen wiederverwendbaren Präfix trifft; lässt sich nicht direkt aus der Gesamt-Tokenzahl ableiten |
| Anfragepräfix | Der Kontext, der vor der aktuellen Nachricht bereits vorhanden ist. Änderungen an der frühen Historie wirken sich auf die Wiederverwendung von Cache und Reasoning-Elementen aus |
configuration_update |
Eingabeelement in Responses-Sitzungen, die diese Funktion unterstützen, mit dem sich die nachfolgende Konfiguration anpassen lässt |
| Abnahmeschwelle | Der minimal akzeptable Standard für Richtlinienkorrektheit, bestandene Funktionalität oder das Nacharbeitsniveau |
| Kosten pro konformem Task | Die Aufruf-, Retry-, Tool- und manuellen Nacharbeitskosten des gesamten Versuchs, geteilt durch die Anzahl der Tasks, die den Standard erfüllen |
1. Vor der Kostenoptimierung von Reasoning-Modellen: Wann sich das Anpassen der Effort-Stufe lohnt
1.1 Integration der beiden Sol-Generationen bei APIYI
Laut den Plattform-Updates von APIYI wurde GPT-6.1 Sol am 2026-09-30 freigeschaltet, GPT-6.2 Astra und Sol wurden am 2026-11-18 als verfügbar angekündigt. Die Preisübersicht vom 2026-11-20 zeigt, dass beide Sol-Varianten sowohl die responses– als auch die chat-Route anbieten; beteiligte Gruppen sind CodexResponses, Codex_Reverse, Default und SVIP. Welche Fähigkeiten ein Konto tatsächlich aufrufen kann, richtet sich nach der Gruppe, in der das Token liegt.
Laut OpenAI-Dokumentation unterstützen beide Sol-Generationen Chat Completions und Responses, aber Tool-Aufrufe müssen über Responses laufen; die Stufe wird über reasoning.effort festgelegt. Sobald also Geschäftsprozesse Tool-Schritte wie Bestellabfragen oder Code-Ausführung enthalten, sollten Evaluation und Produktivsetzung einheitlich die Responses-Route verwenden, damit die Verhaltensunterschiede der beiden Routen nicht in die Vergleichsergebnisse einfließen.
1.2 Zwei Preisschemata: APIYI-Listenpreis und Standardpreis des Upstreams
| Modell-ID (APIYI-Übersicht, 2026-11-20) | Standard-Input | Cache-Lesen | Output | Verfügbare Plattformen |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI offiziell |
gpt-6.1-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI offiziell |
gpt-6-sol |
$2 | $0.20 | $10 | APIYI |
gpt-6.2-astra |
$8 | $0.40 | $40 | APIYI |
Die obige Tabelle enthält die Standardpreise für kurzen Kontext in USD pro Million Token. Die von OrcaRouter zusammengestellte Upstream-Preiskarte nennt für beide Sol-Generationen identische Preise für Input, Cache-Lesen und Output und führt zusätzlich $2.50 für Cache-Schreiben auf. Der lange Kontext muss separat geprüft werden: Bei gpt-6.2-sol listet APIYI derzeit $3 für Input über 272,000 Token, während OpenAI offiziell Standard $4 ansetzt; bei gpt-6.1-sol sind es auf beiden Seiten $4. Für Cache- und Output-Preise der langen Stufe gelten die Echtzeit-Abrechnungsregeln des jeweiligen Kanals.
1.3 Kosten aus echten Antworten und Abrechnungen ablesen
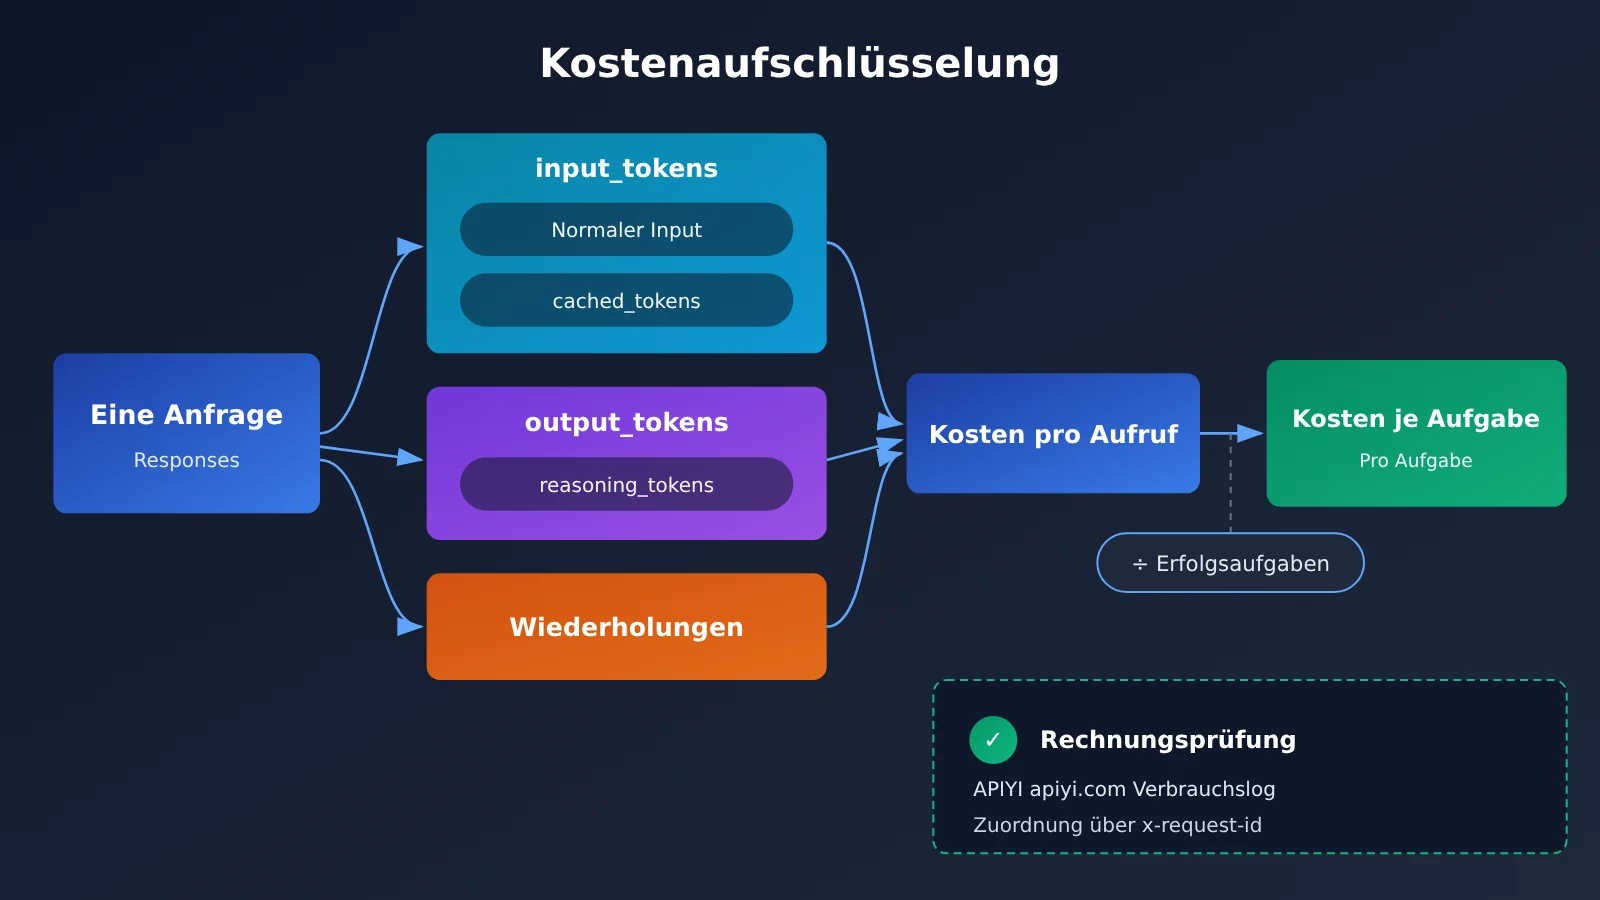
Listenpreise dienen nur zur Schätzung. Im Folgenden zeigen wir anhand eines hypothetischen Rechenbeispiels, wie sich die Kosten aufschlüsseln. Angenommen, jede Runde umfasst 12.000 Eingabe-Token und es fallen keine Cache-Schreibvorgänge und Tool-Gebühren an:
- Präfix beibehalten: aus dem Cache gelesene Token 9.000, Ausgabe-Token insgesamt 1.000, geschätzt rund $0.0169.
- Präfix geändert: aus dem Cache gelesene Token sinken auf 3.000, Ausgabe-Token insgesamt steigen auf 1.600, geschätzt rund $0.0343.
Von der Differenz zwischen beiden Fällen entfallen etwa $0.0114 darauf, dass 6.000 Eingabe-Token vom Cache-Preis wieder auf den regulären Preis wechseln, und etwa $0.0060 auf die zusätzlichen 600 Ausgabe-Token. Dies sind hypothetische Daten; die tatsächliche Differenz richtet sich nach usage. Falls Cache-Schreibvorgänge separat ausgewiesen werden, sollten reguläre Eingabe, Cache-Lesevorgänge und Cache-Schreibvorgänge als drei sich gegenseitig ausschließende Kategorien getrennt berechnet werden.
So lässt sich die tatsächliche Abrechnung prüfen: Verknüpfen Sie die x-request-id aus dem Antwort-Header mit den Einträgen type=2 im Verbrauchsprotokoll von APIYI, rechnen Sie mit quota ÷ 500,000 den tatsächlich abgerechneten Dollarbetrag aus und protokollieren Sie zugleich Modell, Token-Gruppe, Aufrufzeitfenster, Eingabe- und Ausgabemenge sowie die Anzahl der Wiederholungsversuche.
Das folgende Minimalbeispiel zeigt einen Aufruf und liest gleichzeitig die für die Diagnose benötigten Nutzungsfelder aus:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("输入:", u.input_tokens, "缓存命中:", u.input_tokens_details.cached_tokens)
print("总输出:", u.output_tokens, "其中推理:", u.output_tokens_details.reasoning_tokens)
🚀 Schnellstart: Es empfiehlt sich, das obige Beispiel zunächst mit dem kostenlosen Neukundenkontingent auf APIYI apiyi.com auszuführen und sicherzustellen, dass die angezielte Gruppe
cached_tokensundreasoning_tokenskorrekt zurückgibt, bevor Sie mit der Batch-Evaluierung beginnen.
2. Vergleich in derselben Aufgabe: Messergebnisse für die Stufen low und medium
2.1 Kundenservice-Tickets: Der Nutzen der niedrigen Stufe ist gering
Die Tester von eesel haben am 2026-11-18 über die Responses API für beide Sol-Generationen jeweils die Stufen low und medium getestet, insgesamt 60 Aufrufe. Jede Konfiguration deckte dieselben 15 Tickets ab, darunter Rückerstattungen, Logistikabfragen und fehlgeschlagene Bestell-Tools, die manuell nach einer fiktiven SaaS-Richtlinie bewertet wurden.
| Konfiguration (eesel, 15 Tickets) | Bestanden | Durchschnittliche Dauer | Listenpreis umgerechnet/1.000 Stück |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3.8 Sekunden | $1.32 |
| GPT-6.1 Sol medium | 15/15 | 3.8 Sekunden | $1.35 |
| GPT-6.2 Sol low | 15/15 | 3.2 Sekunden | $1.41 |
| GPT-6.2 Sol medium | 15/15 | 3.6 Sekunden | $1.42 |
In diesen Daten unterscheiden sich low und medium pro 1.000 Stück nur um ein paar Cent; die Wahl der Stufe richtet sich daher eher nach der Latenz als nach den Kosten. Zudem ist GPT-6.2 Sol nach den gemessenen Verbrauchswerten bei diesen Kundenservice-Aufgaben sogar etwas teurer als 6.1 Sol. Wichtiger noch: Obwohl alle vier Konfigurationen eine perfekte Bestehensquote erreichen, stellte der Autor fest, dass 6.2 Sol Logistik-Links ausgibt, die in der Tool-Antwort gar nicht existieren. Das zeigt: Wenn die Abnahme im Kundenservice nur darauf achtet, ob „die Richtlinie korrekt beantwortet“ wurde, gehen solche Probleme durch. Die Herkunft von Links und Feldern muss separat geprüft werden. Diese Belege gelten nur für diesen Ticketsatz, diesen Bewertungsmaßstab und die OpenAI-Testumgebung.
2.2 Code-Aufgaben: Die Kosten pro Aufgabe in der niedrigen Stufe lohnen sich zu messen
VulcanBench hat am 19.11.2026 mit Codex GPT-6.2 Sol auf demselben Testset aus 23 Aufgaben stufenweise durchlaufen lassen, insgesamt 115 Läufe. Die Beträge in der folgenden Tabelle sind aus den Laufbelegen nach den API-Listenpreisen umgerechnet und nicht die tatsächliche Abrechnung eines APIYI-Kontos.
| Konfiguration (VulcanBench, 23 Aufgaben) | Bestanden | Durchschnittliche Dauer | Listenpreis-Umrechnung/Aufgabe | Gesamtwert |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2,8 Minuten | $0,23 | 88,44 |
| GPT-6.2 Sol medium | 23/23 | 4,4 Minuten | $0,33 | 88,94 |
| GPT-6.2 Sol max | — | 11,3 Minuten | $0,55 | 88,74 |
| GPT-6.1 Sol low (historische Charge) | 20/23 | 6,9 Minuten | $0,31 | — |
| GPT-6.1 Sol medium (historische Charge) | 22/23 | 10,6 Minuten | $0,40 | — |
Betrachtet man nur die Gruppe GPT-6.2 Sol: low und medium haben die gleiche Anzahl bestandener Aufgaben, die Kosten pro Aufgabe sind rund 30 Prozent niedriger, und auch die Dauer ist kürzer; der Gesamtwert von max liegt nicht über dem von medium. Ein versionsübergreifender Vergleich erfordert Vorsicht: Die Daten von 6.1 Sol stammen aus einer historischen Auswertung desselben Aufgaben-Sets und gehören zu einer anderen Testcharge. Der Gesamtwert ist eine Bewertung der Codequalität und damit ein anderes Maß als die Testbestehensrate – das eine kann das andere nicht ersetzen.
Der von OrcaRouter weitergegebene Artificial Analysis Index v5.0.1 (abgerufen am 20.11.2026) liefert eine andere Perspektive: In der Stufe low erreicht 6.2 Sol 41 Punkte bei $0,18 pro Aufgabe, 6.1 Sol 35 Punkte bei $0,16; in der Stufe medium sind es 53 Punkte bei $0,41 bzw. 46 Punkte bei $0,36. Die Stufenbezeichnungen in diesem Gesamtranking folgen der Zuordnung des Anbieters der Auswertung – das Framework, das Sie verwenden, muss nicht dieselbe Zuordnung nutzen.
💡 Auswahlempfehlung: Die beiden oben genannten Messungen zeigen, dass die Bestehensgrenze, die Wiederholungsrate und manuelle Nacharbeit die „günstigste Stufe“ verändern können – aber sie sind nicht die Rechnung Ihres eigenen Geschäfts. Wir empfehlen, auf APIYI apiyi.com mit derselben Gruppe und derselben Stichprobe erneut zu testen und erst dann zu entscheiden.
3. Migrationsreihenfolge und Abnahmeschwellen für die Kostenoptimierung von Reasoning-Modellen
3.1 Zuerst die Baseline beibehalten, dann die Stufe anpassen
Nach der Empfehlung im OpenAI-Dokument „Using GPT-6.2“ sollte bei der Migration jeweils nur eine Variable geändert werden:
- Bisher 6.1 Sol
low: Zuerst auf 6.2 Sollowals Vergleich umstellen und dannmediumseparat testen. - Bisher 6.1 Sol
medium: Zuerst das Modell wechseln, abermediumbeibehalten; nach erfolgreicher Abnahme dann mit demselben Aufgabensatzlowvergleichen. - Neuintegration: Mit
mediumbeginnen. - Migration von Modellen, die
noneoderminimalzulassen: GPT-6.2 Sol zunächst mitlowtesten.
Bei einfachen Aufgaben mit klaren Einschränkungen kann die Prüfung mit low beginnen; bei zusammengesetzten Aufgaben wird je nach Ergebnis stufenweise hochgestuft. Während der Evaluierung sollten Eingabeaufforderungen, Werkzeugdefinitionen, Gruppierungen und Testbeispiele konstant gehalten werden. Gleichzeitig sollten gemäß den offiziellen Hinweisen nicht mehr geeignete Parameter entfernt werden, zum Beispiel in Responses-Anfragen temperature, top_p und top_logprobs.
3.2 Abnahmeschwellen je Szenario definieren
| Szenario | Abnahmeschwelle | Wann eine Hochstufung in Betracht gezogen werden sollte |
|---|---|---|
| Standard-Kundenservice | Richtlinienkonsistenz, korrekte Betragsfelder, Auslösebedingungen für die Eskalation an einen Menschen; Links und Ticketnummern müssen aus der Werkzeugrückgabe stammen | Wenn richtlinienübergreifende Konflikte oder die Verkettung mehrerer Werkzeuge betroffen sind |
| Codeänderungen | Tests bestanden, zentrale Funktionen vollständig, Umfang der Nacharbeit im Code-Review | Wenn die Erfolgsquote auf niedriger Stufe sinkt oder die Nacharbeit deutlich zunimmt |
| Kurze Inhalte | Einhaltung von Einschränkungen, Faktenfelder, Dauer der manuellen Überarbeitung | Wenn Einschränkungen übersehen werden oder Faktenfehler auftreten |
Die Kosten pro bestandener Aufgabe berechnen sich wie folgt: Die Kosten für Aufrufe, Wiederholungen, Werkzeuge und manuelle Nacharbeit werden addiert und anschließend durch die Anzahl der bestandenen Aufgaben geteilt. Wenn low die vereinbarte Schwelle erreicht, kann low gewählt werden; wenn low mehrere Wiederholungen oder manuelle Nachbesserungen erfordert, kann die Ersparnis auf dem Papier durch den zusätzlichen Aufwand aufgezehrt werden.
💰 Kostenoptimierung: Bei Stufenvergleichen können Sie bei APIYI apiyi.com für die Evaluierung separate Token anlegen; dann lassen sich die Logs direkt nach Token und Modell filtern, was die tatsächlichen Kosten der gesamten Testreihe leichter nachvollziehbar macht.
4. Die Effort-Stufe mitten in einer mehrrundigen Sitzung anpassen
4.1 Die Stufe mit configuration_update ändern und den Präfix beibehalten
In einer OpenAI-HTTP-Responses-Sitzung mit einem einzelnen Agenten, die diese Funktion unterstützt, bleibt reasoning.effort auf Anfrageebene beim Ausgangswert. Setze den folgenden Eintrag vor die nächste Benutzernachricht:
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
Diese Einstellung bleibt bis zur nächsten Aktualisierung wirksam. Der Vorteil: Frühere Verlaufsdaten müssen nicht umgeschrieben werden, und der Anfragepräfix bleibt unverändert. Laut OpenAI-Dokumentation kann das Bearbeiten früherer Verlaufsdaten ab GPT-6.2 einen prefix_mismatch auslösen, wodurch vorhandene Reasoning-Elemente entfernt werden. Ein Wechsel der Modellfamilie oder der Wechsel zu einem weniger leistungsfähigen Modell kann ebenfalls Reasoning-Elemente entfernen. Das Umschreiben des Präfixes ist mit zwei Kosten verbunden: Cache-Lesevorgänge können zurückgehen, und nach dem Verlust nutzbarer Reasoning-Elemente können zusätzliche Reasoning-Ausgaben anfallen. Laut offizieller Erläuterung löst weder das Löschen ganzer Einträge bei unveränderten übrigen Einträgen noch das Anhängen neuer Einträge nach den Reasoning-Elementen diese Entfernung aus; die Anzahl der Cache-Treffer kann sich jedoch trotzdem ändern. Außerdem werden bei GPT-6.2 die instructions auf oberster Ebene hinter input angehängt und als ungecachte Eingabe abgerechnet.
4.2 Kontextkomprimierung und Hinweise zum Routing bei APIYI
Bei serverseitigem context_management kann die aktualisierte Konfiguration bestehen bleiben. Übergibt man einen Verlauf mit einem alten configuration_update direkt an den eigenständigen Endpunkt /responses/compact, wird die Anfrage abgelehnt. Richtig ist, laut offizieller Anleitung zuerst die Konfigurationseinträge abzutrennen und nach Abschluss der Komprimierung einen aktuellen Konfigurationseintrag anzuhängen.
Auf APIYI ist derzeit das sicherste Vorgehen, den input-Verlauf selbst zu verwalten und nicht auf previous_response_id zu setzen. Der Grund: Die native Aufrufanleitung von APIYI ist in diesem Punkt widersprüchlich – im Haupttext heißt es, die verkettete Fortsetzung funktioniere nicht, während die FAQ festhält, dass sie am 2026-09-02 in Tests funktioniert habe. Die APIYI-Dokumentation führt derzeit auch keine Validierungsergebnisse für configuration_update in den jeweiligen Gruppen auf. Daher sollten solche spezifischen Konfigurationen, die Rücksendung verschlüsselter Reasoning-Elemente und Cache-Diagnosefelder zunächst in einer kurzen Sitzung im Zielkanal separat validiert und erst nach bestätigter Verfügbarkeit in den regulären Workflow übernommen werden.
🎯 Technische Empfehlung: Führe zunächst auf der Responses-Route von APIYI apiyi.com eine kurze Sitzung mit zwei Runden durch und vergleiche für die beiden Muster „nur anhängen“ und „Präfix umschreiben“ die Werte von
cached_tokens,reasoning_tokensund die Laufzeit. Erst nachdem das Verhalten bestätigt ist, entscheide, wie die Anpassung der Stufe mitten im Gespräch umgesetzt wird.
Ein letzter Satz: Grundlage für die Wahl der Stufe sollten die Kosten pro bestandener Aufgabe unter festen Abnahmekriterien sein. Auf APIYI apiyi.com zeigt ein eigener Vergleichslauf mit den eigenen Beispieldaten und der eigenen Abrechnung mehr als jede Bestenliste.
Referenzen
- OpenAI „Using GPT-6.2“: Empfehlungen zu Migration und Einstiegs-Effort-Stufe
- Link:
developers.openai.com/api/docs/guides/latest-model
- Link:
- OpenAI „Reasoning models“:
configuration_updateund Wiederverwendung von Reasoning-Elementen- Link:
developers.openai.com/api/docs/guides/reasoning
- Link:
- OpenAI „Compaction“: Regeln zur Kontextkomprimierung
- Link:
developers.openai.com/api/docs/guides/compaction
- Link:
- OpenAI „Keep the prefix unchanged“: Präfix- und Cache-Diagnose
- Link:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Link:
- eesel AI „GPT-6.2 Sol: what’s new, pricing, benchmarks“: Praxistest mit Support-Tickets, 2026-11-18
- Link:
eesel.ai/blog/gpt-6-2-sol
- Link:
- VulcanBench „GPT-6.2 Sol across effort levels“: Coding-Aufgaben Stufe für Stufe bewertet, 2026-11-19
- Link:
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- Link:
- OrcaRouter „GPT-6.2 vs GPT-6.1 Sol“: Preiskarte und übernommene Gesamtindex-Werte, 2026-11-20
- Link:
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- Link:
- APIYI „Preisübersicht aller Modelle“: Daten aktualisiert am 2026-11-20
- Link:
docs.apiyi.com/models
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Sie erreichen uns gerne über die Startseite von APIYI apiyi.com – weitere Hinweise zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.