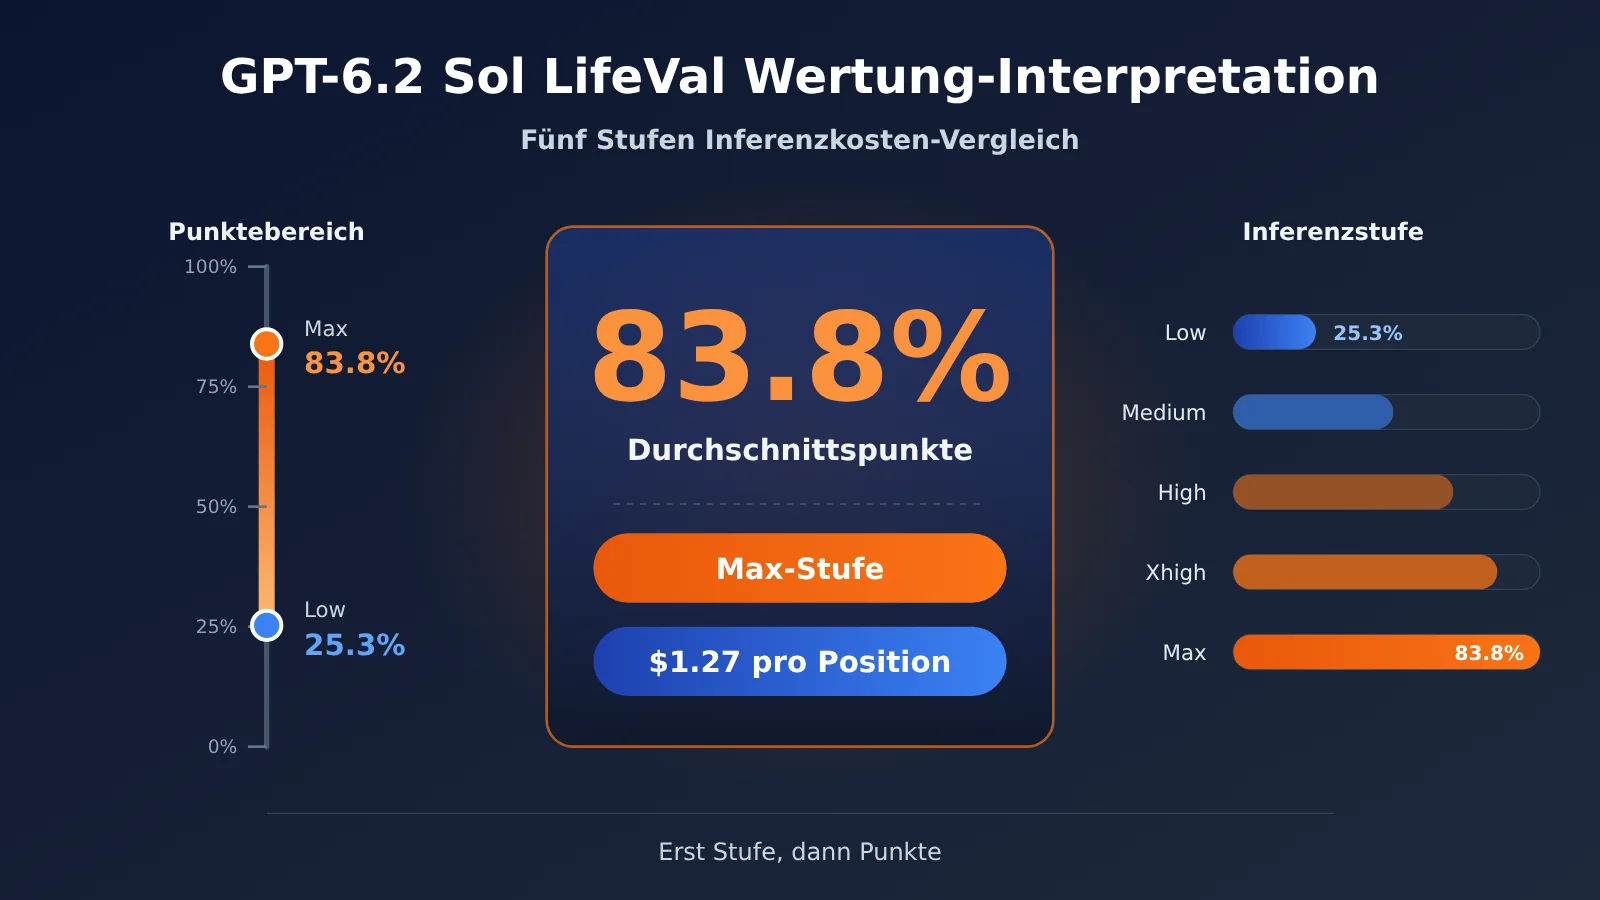
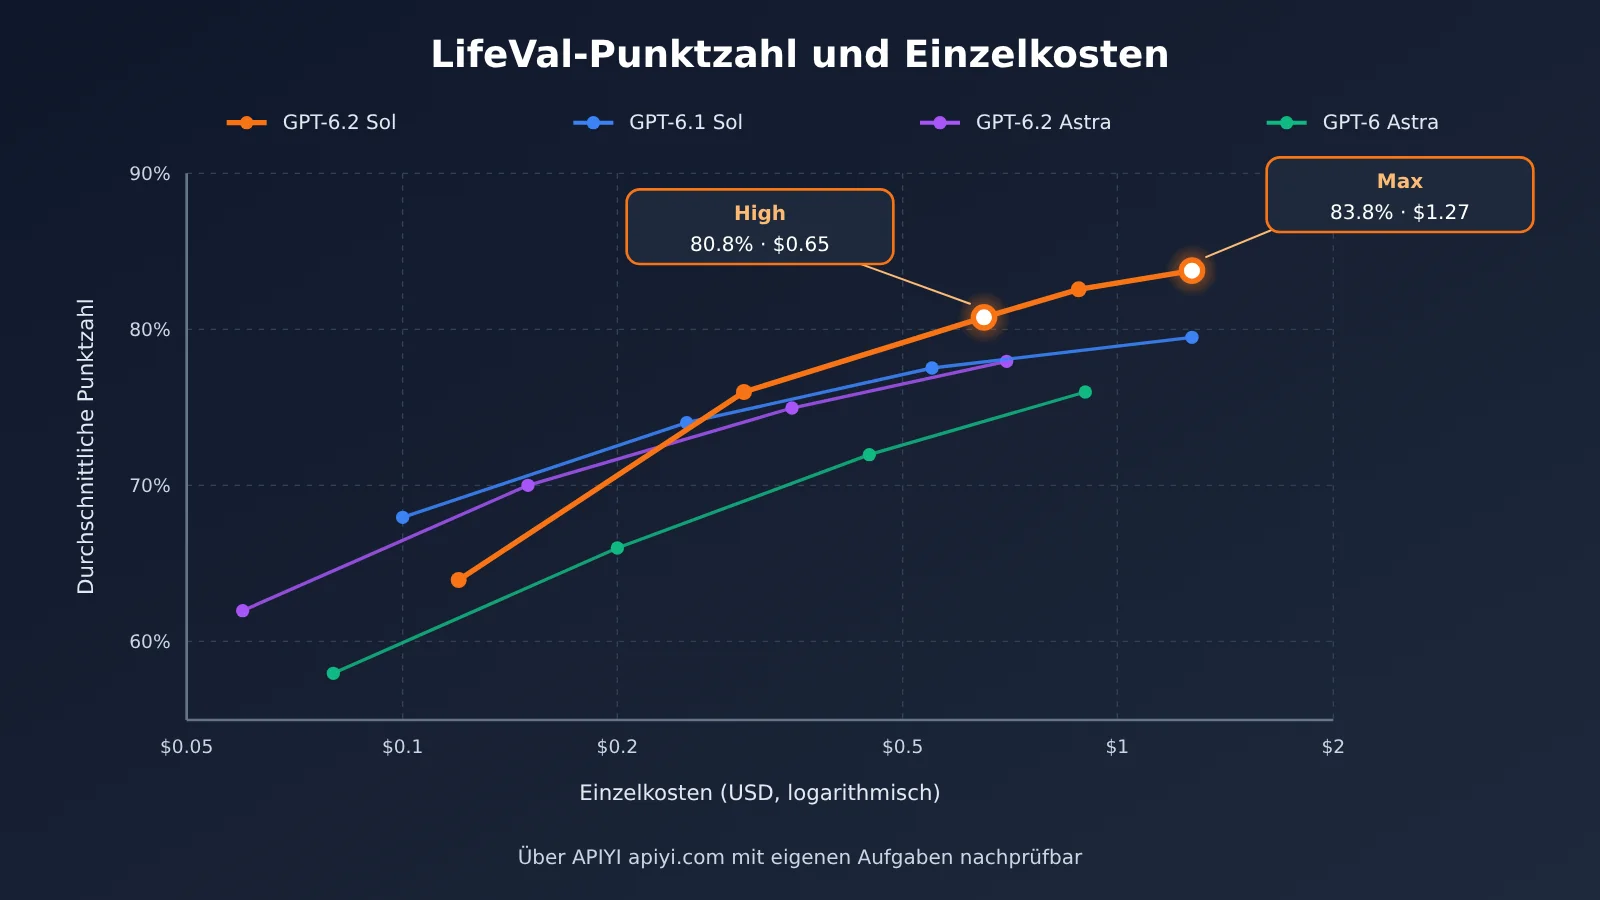
83.8 % ist nicht „83.8 % aller Aufgaben wurden vollständig erledigt“, sondern die durchschnittliche LifeVal-Punktzahl von GPT-6.2 Sol auf der Max-Reasoning-Stufe. Dieser Wert ergibt sich, indem jede Aufgabe anhand ihrer Bewertungsrubrik einzeln bepunktet und anschließend zusammengefasst wird; die durchschnittlichen Kosten pro Aufgabe liegen bei $1.27. Dasselbe Modell erreicht in der Low-Stufe nur 25.3 %, in der High-Stufe 80.8 % bei Kosten von $0.65 pro Aufgabe. Wenn man also die LifeVal-Leistung von GPT-6.2 Sol diskutiert, muss man zuerst klarstellen, um welche Stufe es geht.
Das Fazit: Die offizielle Rangliste liefert eine Kombination aus Punktzahl und Kosten für bestimmte Aufgaben und eine bestimmte Umgebung – kein Gesamtranking, das man direkt in sein eigenes Produkt übernehmen könnte. In den LifeVal-Daten ist die High-Stufe ein sinnvoller Ausgangspunkt für erste Tests. Welche Stufe am Ende verwendet wird, muss man weiterhin anhand der eigenen Aufgaben, der erzeugten Artefakte und des tatsächlichen Zustands validieren.
Was Sie aus diesem Artikel mitnehmen
- Welche Aufgaben LifeVal misst und wie man 83.8 % korrekt formuliert.
- Punktzahl und Kosten der fünf Reasoning-Stufen von GPT-6.2 Sol sowie der Vergleich auf gleicher Stufe mit GPT-6.1 Sol, GPT-6 Astra und GPT-6.2 Astra.
- Warum die offizielle Aussage „etwa ein Siebtel der Kosten“ und der „deutliche Rückgang in der Low-Stufe“ gleichzeitig zutreffen können.
- Wie man die Validierungsmethode von LifeVal übernehmen kann, um für den eigenen Alltagsassistenten reproduzierbare Evaluationsaufgaben zu entwerfen.
Überblick: Die Tabelle „To Know“ erklärt zuerst die Evaluationsbegriffe, die später im Text gebraucht werden; der Kurzüberblick zu den Auswirkungen erläutert dann getrennt, worauf normale Nutzer und Entwickler jeweils achten sollten. Der Abschnitt „Objektive Fakten“ beschreibt der Reihe nach die Herkunft der LifeVal-Aufgaben und die Art der Punktevergabe sowie die Stufendaten aus der am 17. November veröffentlichten Grafik. Der Abschnitt „Analyse und Einordnung“ schlüsselt zunächst die Bezugsgrößen mehrerer Vergleiche auf, gibt dann ein direkt anpassbares Validierungsbeispiel für einen Routen- und Terminassistenten und erläutert die Grenzen der Übertragbarkeit.
To Know: Schlüsselkonzepte für das Verständnis der GPT-6.2 Sol LifeVal-Bewertung
| Konzept | Kurze Erklärung |
|---|---|
| LifeVal | OpenAI-Benchmark, der misst, wie gut KI-Assistenten personalisierte alltägliche digitale Aufgaben erledigen |
| Personalisierter Kontext | Informationen wie Nutzerpräferenzen, frühere Daten und aufgabenspezifische Bedingungen, die beeinflussen, was als „akzeptable Antwort“ gilt |
| Bewertungsraster | Zerlegt die Erledigung einer Aufgabe in mehrere einzeln prüfbare Anforderungen |
| Kontrollierte Umgebung | Voreingestellte Testumgebung mit Apps, Daten und Ausgangszustand, damit sich die Ergebnisse von Aktionen überprüfen lassen |
| Zustandsunterschiede im Backend | Vor und nach dem Test erfasste Änderungen des App-Zustands, mit denen geprüft wird, ob Tool-Aktionen tatsächlich wirksam waren |
| Durchschnittlicher Reward-Wert | Zusammengefasster Kennwert aus den nach Bewertungsraster vergebenen Punkten je Aufgabe; die Prozentwerte in den veröffentlichten Grafiken sind solche „Durchschnittswerte“ |
| Reasoning-Intensität | Einstellung für den Reasoning-Aufwand des Modells; dieser Artikel vergleicht Low, Medium, High, Xhigh und Max |
| Kosten pro Aufgabe | Durchschnittliche Kosten je Aufgabe im Auswertungsdiagramm; sie variieren mit Modellnutzung und Preisen |
GPT-6.2 Sol LifeVal: Die Auswirkungen im Überblick
- Normale Nutzer: Wenn Sie „83,8 %“ sehen, verstehen Sie das als „durchschnittliche Punktzahl bei einer Reihe alltäglicher Aufgaben englischsprachiger Nutzer in den USA“ – nicht als Erfolgsquote. Beachten Sie außerdem, dass dasselbe Modell je nach Reasoning-Stufe stark variiert. Die Produkterfahrung hängt davon ab, welche Stufe der Anbieter wählt.
- Produktmanager: Die Low-Stufe ist am günstigsten, schneidet in LifeVal diesmal aber deutlich schlechter ab als die Low-Stufe des vorherigen Sol-Modells. Übernimmt man bei einem Upgrade die Stufenkonfiguration der alten Version, kann es passieren, dass „das neue Modell schlechter abschneidet“.
- API-Entwickler: Nachahmenswert ist LifeVals Abnahmedesign, bei dem Lieferobjekte, Umgebungszustand und Antwort jeweils separat bewertet werden. Ein Quervergleich von Low, Medium und High mit demselben Satz eigener Aufgaben ist verlässlicher, als direkt Benchmark-Zahlen zu zitieren.
Objektive Fakten: Mit welchen Aufgaben wird GPT-6.2 Sol bei LifeVal getestet?
Herkunft und Veröffentlichungszeitraum von LifeVal
LifeVal ist eine Evaluation von OpenAI zur Messung personalisierter alltäglicher Agent-Aufgaben. Die OpenAI-Forschungsseite ist auf den 2. November 2026 datiert, das zugehörige Paper auf den 3. November. Am 17. November veröffentlichte OpenAI GPT-6.2 Astra und GPT-6.2 Sol und fügte auf der Release-Seite eine LifeVal-Grafik bei, die die nach Modellstufen aufgeschlüsselten Ergebnisse der neuen Modelle enthält (Grafik-Kennung lifeval-v2).
Die Aufgabenverteilung im Paper stammt aus Zeitverwendungsstudien in den USA und mehreren anderen Ländern und orientiert sich zusätzlich an einer Umfrage zur Zahlungsbereitschaft unter der US-Bevölkerung; am Ende wurden die Alltagsaktivitäten in 148 Kategorien gegliedert. Die Experimente im Paper umfassten 169 Aufgaben. Zu beachten ist, dass das Paper selbst nur Modelle bis GPT-6 Astra evaluiert – die nach Stufen aufgeschlüsselten Zahlen der GPT-6.2-Reihe tauchen erst in der späteren offiziellen Release-Grafik auf.
Laut offizieller Positionierung richtet sich Sol an hochfrequente tägliche Arbeit, routinemäßiges Programmieren und skalierbare mehrstufige Agenten, während Astra auf schwierigere Reasoning-Aufgaben und professionelle Ergebnisse abzielt. Diese Positionierung passt zu den „alltäglichen Assistentenaufgaben“, die LifeVal misst.
Aufgabendesign von LifeVal: dieselbe Anforderung, je nach Person unterschiedliche passende Antworten
Das Besondere an LifeVal ist die „Personalisierung“. Nehmen wir das Vergleichen von Schulen nach einem Umzug: Je nach Alter der Kinder, Pendelroute und Vorlieben beim Schulbezirk sehen die passenden Antworten anders aus. Ein weiteres Beispiel ist die Wohnungssuche, bei der man Budget und Pendelzeit gegeneinander abwägt – die Obergrenze beim Budget und die akzeptable Pendeldauer entscheiden unmittelbar darüber, welche Angebote als passende Ergebnisse gelten.
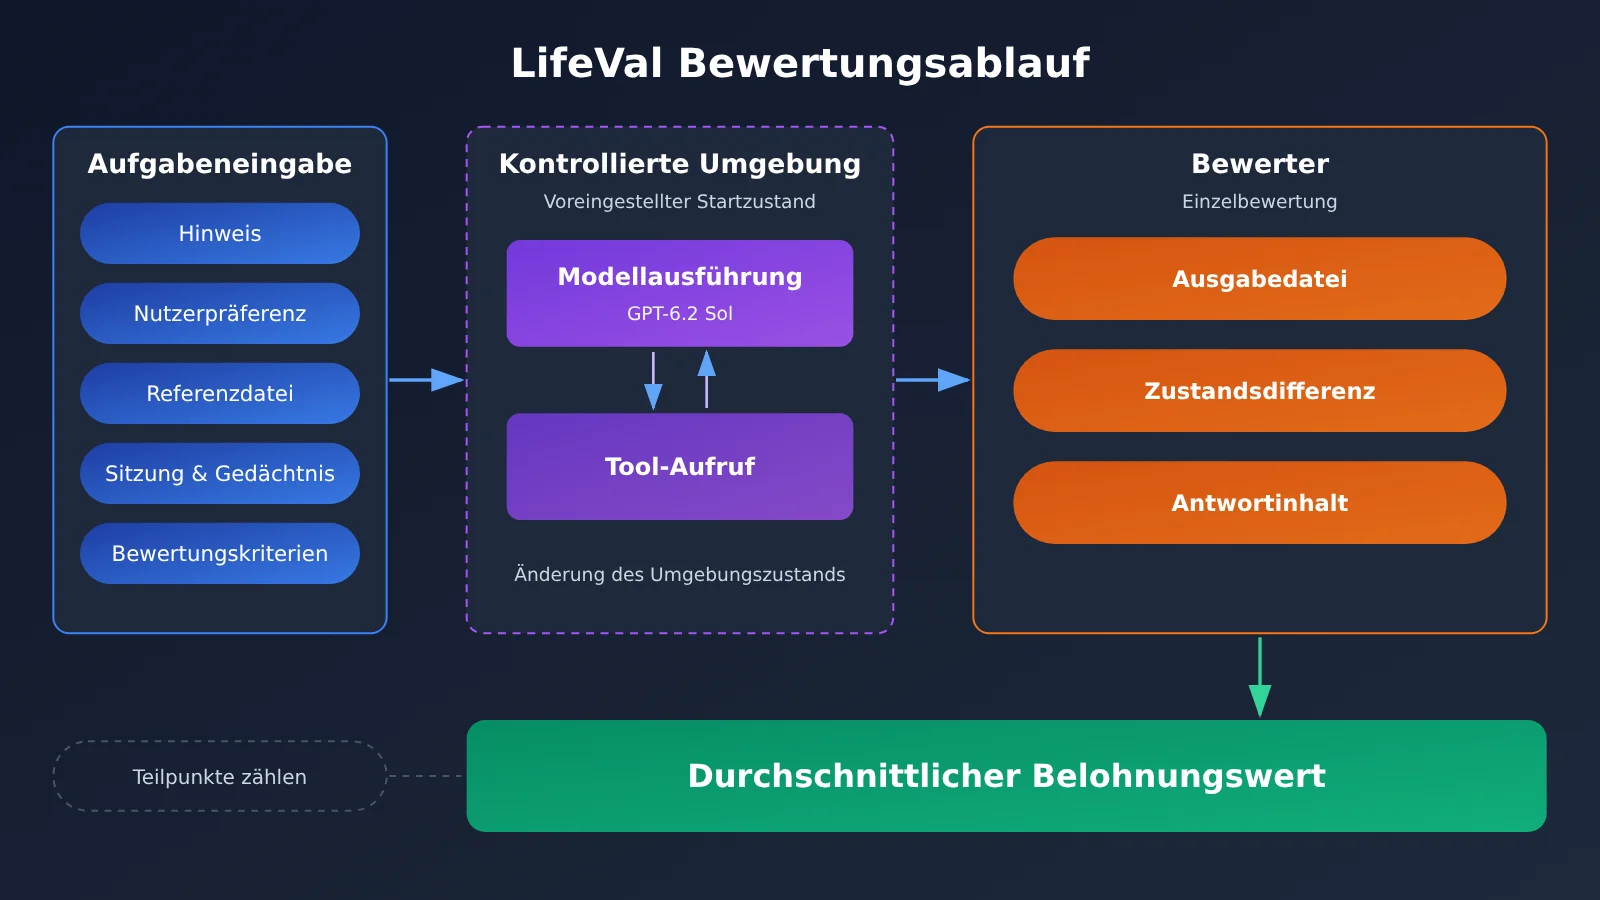
Nach der Definition im Paper enthält jede Aufgabe eine Eingabeaufforderung, Nutzerpräferenzen, Referenzdateien, zugehörige Sitzungen und Erinnerungen, ein Bewertungsraster sowie eine kontrollierte Umgebung mit vorab festgelegtem Zustand. Nach der Ausführung kann der Bewerter drei Arten von Dingen prüfen: die vom Modell gelieferten Dateien, den Zustand der Umgebung vor und nach den Tool-Operationen und die Antwort des Modells – und anschließend die einzelnen Anforderungen der Aufgabe jeweils separat bewerten.
Warum 83.8 % nur als „durchschnittliche Punktzahl“ bezeichnet werden kann
Die y-Achse der Ergebnisgrafik im Paper zeigt den durchschnittlichen Reward-Wert. Deshalb sollte 83.8 % als „durchschnittliche Punktzahl“ formuliert werden – nicht als „83.8 % der Aufgaben wurden vollständig erfolgreich ausgeführt“. Eine Aufgabe trägt auch dann teilweise Punkte bei, wenn nur ein Teil der Bewertungskriterien erfüllt wurde.
Das Paper nennt außerdem einige Einschränkungen: In der Offline-Umgebung und in gecachten Webseiten gibt es weiterhin teilweise zeitabhängige Informationen, und die Stichprobe besteht überwiegend aus englischsprachigen Nutzern in den USA. Das heißt, die Punktzahlen lassen sich nicht ohne Weiteres auf andere Regionen, andere Sprachen oder andere App-Ökosysteme übertragen.
Die Veröffentlichungsgrafik von GPT-6.2 Sol LifeVal: fünf Stufen mit Punktzahl und Kosten pro Aufgabe
Die folgende Tabelle gibt die öffentlich zugänglichen Daten aus der interaktiven LifeVal-Grafik auf der OpenAI-Veröffentlichungsseite vom 17. November 2026 wieder. Jede Zelle enthält „durchschnittliche Punktzahl / durchschnittliche Kosten pro Aufgabe (USD)“. Es handelt sich um von OpenAI selbst gemeldete öffentliche Benchmark-Daten, nicht um Messungen einer unabhängigen Institution.
| Modell | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25.3% / $0.089 | 70.3% / $0.38 | 80.8% / $0.65 | 82.6% / $0.88 | 83.8% / $1.27 |
| GPT-6.1 Sol | 66.8% / $0.52 | 75.5% / $0.73 | 77.1% / $0.88 | 77.8% / $0.96 | 79.5% / $1.27 |
| GPT-6.2 Astra | 46.3% / $0.59 | 78.9% / $1.56 | 83.1% / $2.41 | 83.7% / $2.94 | 86.1% / $4.23 |
| GPT-6 Astra | 67.5% / $3.51 | 74.3% / $5.30 | 76.0% / $6.52 | 77.5% / $6.94 | 79.8% / $9.04 |
Der Text der Ankündigung lautet: In LifeVal erzielt Sol eine höhere Punktzahl als GPT-6 Astra, bei etwa einem Siebtel der Kosten. Vergleichsobjekt ist hier das Flaggschiff der vorherigen Generation, GPT-6 Astra, nicht das GPT-6.2 Astra desselben Zeitraums. Nur die andere Vergleichsgruppe, FrontierCode 2.0, in der Ankündigung bezieht sich auf GPT-6.2 Astra – beim Lesen sollte man diese beiden Schlussfolgerungen nicht miteinander vermischen.
📌 Hinweis zur Datenbasis: Die „Kosten pro Aufgabe“ in der Tabelle sind Durchschnittswerte aus der offiziellen Benchmark-Grafik und hängen von der Eingabelänge, der Ausgabelänge und der Tool-Nutzung des jeweiligen Benchmarks ab. Die Kosten für deine eigenen Aufgaben musst du mit echten Anfragen neu messen. Über APIYI apiyi.com kannst du mit demselben Key nacheinander die verschiedenen Stufen von Sol durchlaufen lassen und die Abrechnung direkt vergleichen.
API-Zugangsinformationen zu GPT-6.2 Sol
Die API-Modell-ID lautet gpt-6.2-sol und ist sowohl über Responses als auch über Chat Completions aufrufbar. Funktionsaufrufe und integrierte Tools laufen dabei über den Responses-Pfad; keiner der beiden Endpunkte akzeptiert die Reasoning-Stufe none. Der offizielle Standardpreis für kurze Kontexte liegt bei $2.00 für die Eingabe und $10.00 für die Ausgabe (USD pro Million Token, wobei die Ausgabe bereits die Reasoning-Token enthält) – identisch mit GPT-6.1 Sol.
Stand 20. November 2026 ist gpt-6.2-sol sowohl in der öffentlichen Modellübersicht als auch in der Preis-API von APIYI gelistet, mit Kennzeichnung der Einstiegspunkte responses und chat. Die Preisgestaltung für den Kurzkontext-Bereich entspricht der offiziellen Variante; die tatsächlich verfügbaren Gruppen, Parameterbereiche und die Abrechnung richten sich nach der aktuellen Konfiguration und den Abrechnungsdaten auf APIYI apiyi.com.
Analyse und Einschätzung: Wie „ein Siebtel der Kosten“ und der Rückgang bei Low in GPT-6.2 Sol LifeVal gleichzeitig Bestand haben können
Zuerst die Vergleichsobjekte und die Bezugsgrößen angleichen
Dasselbe Diagramm kann sowohl den Eindruck eines „großen Fortschritts“ als auch den eines „deutlichen Rückschritts“ vermitteln – der eigentliche Grund dafür ist, dass die Vergleichsobjekte und die Stufen (Tiers) unterschiedlich sind. Die Differenzen und Verhältnisse in der folgenden Tabelle sind aus den offiziell veröffentlichten Werten berechnet.
| Vergleichsgruppe | Werte beider Seiten | Punktedifferenz | Kostenverhältnis |
|---|---|---|---|
| 6.2 Sol Max vs. Flaggschiff der vorherigen Generation GPT-6 Astra Max | 83.8%/$1.27 vs 79.8%/$9.04 | +4.0 Prozentpunkte | ca. 14.0%, also „etwa ein Siebtel“ |
| 6.2 Sol Max vs. 6.1 Sol Max | 83.8%/$1.27 vs 79.5%/$1.27 | +4.3 Prozentpunkte | gleiche Kosten |
| 6.2 Sol Low vs. 6.1 Sol Low | 25.3%/$0.089 vs 66.8%/$0.52 | −41.5 Prozentpunkte | Kosten niedriger, aber die Punktzahl sinkt deutlich |
| 6.2 Sol Medium vs. 6.1 Sol Medium | 70.3%/$0.38 vs 75.5%/$0.73 | −5.2 Prozentpunkte | Kosten etwa die Hälfte |
| 6.2 Sol High vs. 6.1 Sol Max | 80.8%/$0.65 vs 79.5%/$1.27 | +1.3 Prozentpunkte | etwa die Hälfte |
| 6.2 Sol Max vs. 6.2 Astra Max | 83.8%/$1.27 vs 86.1%/$4.23 | −2.3 Prozentpunkte | ca. 30% |
Bei diesen Zahlen beschreiben die „Prozentpunkte“ die Differenz der Durchschnittswerte, während das „Kostenverhältnis“ das Verhältnis der durchschnittlichen Einzelkosten beschreibt – beides lässt sich nicht ineinander umrechnen. Das „ein Siebtel“ gilt nur in der Gruppe „6.2 Sol Max vs. GPT-6 Astra Max“. Vergleicht man stattdessen mit dem zeitgleichen GPT-6.2 Astra, liegt Sol in der Max-Stufe sogar um 2.3 Prozentpunkte niedriger.
💡 Hinweis zur Auswahl: Der Unterschied zwischen verschiedenen Stufen desselben Modells kann größer sein als der zwischen verschiedenen Modellen. Es empfiehlt sich, zunächst auf APIYI apiyi.com mit einem festen Aufgabensatz einen stufenweisen Vergleich durchzuführen und erst dann die Standardstufe festzulegen, statt die Stufenkonfiguration des alten Modells einfach zu übernehmen.
Das Signal der Low-Stufe: Ein Upgrade ist kein „blinder Austausch“
Die Low-Stufe von 6.2 Sol erreicht in LifeVal nur 25,3 % und liegt damit 41,5 Prozentpunkte unter der Low-Stufe von 6.1 Sol. In den offiziellen Veröffentlichungsunterlagen heißt es, dass Sol bei einigen Aufgaben weniger Output-Token verbraucht; die durchschnittlichen Kosten pro Einzelaufgabe liegen in der Low-Stufe zudem nur bei 0,089 US-Dollar. Eine naheliegende Vermutung ist: Bei personalisierten mehrstufigen Aufgaben reicht der geringe Reasoning-Aufwand nicht aus, um Präferenzvorgaben und Tool-Operationen abzudecken. Das ist lediglich eine Vermutung; die offiziellen Angaben liefern keine Erklärung für den Rückgang der Low-Stufe.
Für Produktteams ist die Auswirkung unmittelbar. Wenn Ihre Anwendung bei 6.1 Sol bisher aus Kostengründen die Low-Stufe verwendet hat und Sie einfach die Modell-ID wechseln, ohne die Stufe anzupassen, kann die Qualität bei komplexen Alltagsaufgaben deutlich sinken. Im Gegensatz dazu liegt die Max-Stufe bei gleichen Kosten pro Einzelaufgabe um 4,3 Prozentpunkte über der vorherigen Sol-Generation – was zeigt, dass die Leistungsobergrenze des neuen Modells tatsächlich gestiegen ist.
Warum High in dieser Bewertung vorrangig getestet werden sollte
Bei 6.2 Sol betragen die Zuwächse zwischen benachbarten Stufen von High zu Xhigh und dann zu Max nur 1,8 bzw. 1,2 Prozentpunkte, während die durchschnittlichen Kosten pro Einzelaufgabe jeweils um 0,23 und 0,39 US-Dollar steigen. Die High-Stufe erzielt für 0,65 US-Dollar 80,8 % und liegt damit bereits über der Max-Stufe von 6.1 Sol und der Max-Stufe von GPT-6 Astra. Für LifeVal allein betrachtet ist High ein Ausgangspunkt, bei dem „Qualität und Kosten einigermaßen im Gleichgewicht“ sind.
Allerdings hat dieses Urteil drei Voraussetzungen: Die Aufgabenverteilung ähnelt LifeVal, Sprache und Anwendungsumgebung ähneln dem Szenario US-englischer Nutzer, und die Kostenstruktur ähnelt dem Input-Output-Verhältnis dieser Bewertung. Wenn auch nur eine dieser Bedingungen nicht erfüllt ist, kann sich die Schlussfolgerung ändern. In der Praxis ist es ratsamer, mit High zu beginnen und dann anhand der Erfolgsquote bei den eigenen Aufgaben zu entscheiden, ob man auf Medium heruntergeht oder auf Xhigh oder Max hochstuft.
Analyse und Bewertung: Deinen eigenen GPT-6.2 Sol-Assistenten nach dem LifeVal-Ansatz abnehmen
Eine risikoarme Aufgabe zur Familienreise konstruieren
Das Wertvollste, was man von LifeVal lernen kann, ist nicht die Punktzahl selbst, sondern die Methode der „Abnahme anhand von Liefergegenständen und Zuständen“. Hier ist ein Beispiel für eine Familienreise: Dem Assistenten werden vorab drei harte Einschränkungen vorgegeben – Start- und Zielort, barrierefreie Reisebedingungen und eine Budgetobergrenze. Er soll einen Kandidatenvorschlag mit verifizierbarer Route sowie einen editierbaren Terminplan-Entwurf abliefern.
| Bewertungspunkt | Prüfmethode | Automatisierbar |
|---|---|---|
| Standortbedingung erfüllt? | Start- und Zielpunkt im Vorschlag stimmen mit der Eingabe überein | Automatisch prüfbar |
| Barrierefreiheitsbedingung erfüllt? | Die Routenbeschreibung deckt die Barrierefreiheitsanforderungen explizit ab | Teilweise automatisch, manuelle Stichprobe nötig |
| Budget nicht überschritten? | Beträge im Vorschlag parsen und mit der Obergrenze vergleichen | Automatisch prüfbar |
| Können die Links die Informationen stützen? | Links erreichbar und der Inhalt stimmt mit dem Vorschlag überein | Manuelle Prüfung nötig |
| Existiert die Terminplan-Entwurfsdatei? | Vorher-/Nachher-Zustand der Ausgabedatei oder des Kalendereintrags prüfen | Automatisch prüfbar |
| Wird bei fehlenden Schlüsselinformationen nachgefragt? | Datum und weitere Angaben absichtlich weglassen und prüfen, ob aktiv nachgefragt wird | Manuelle Beurteilung nötig |
Diese Bewertungspunkte entsprechen den drei Abnahmewegen von LifeVal: den Liefergegenständen (Terminplan-Entwurf), den Zustandsänderungen (ob Dateien oder Einträge tatsächlich geschrieben wurden) und der Antwortqualität (Erfüllung der Bedingungen und aktives Nachfragen). Führe dieselbe Aufgabensammlung jeweils mit Low, Medium und High aus und entscheide dann anhand von Erfüllungsquote und Kosten über die anfängliche Stufe.
Minimalbeispiel: GPT-6.2 Sol aufrufen und den Reasoning-Verbrauch erfassen
Das folgende Beispiel ruft gpt-6.2-sol über die Responses-Schnittstelle auf und liest dabei sowohl die Output-Tokens als auch die darin enthaltenen Reasoning-Tokens aus – praktisch, wenn Sie die Kosten pro Einzelposten später nachrechnen wollen.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Vergleichsskript für die Stufen anzeigen (Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Ein Schlüssel genügt, um mehrere Stufen zu vergleichen
)

# Kurzer Kontext, Standardpreise, USD / Million Token (Output enthält bereits Reasoning-Tokens)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # Absichtlich ohne Datumsangabe, um zu prüfen, ob aktiv nachgefragt wird
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """Bewertet Punkt für Punkt nach den Bewertungskriterien und liefert einen Score von 0 bis 1"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
Die automatischen Prüfungen im Skript decken nur die „maschinell überprüfbaren“ Bewertungspunkte ab – die Echtheit der Links und die Qualität der Rückfragen müssen Sie weiterhin manuell stichprobenartig kontrollieren. Bei den Parameterwerten der Reasoning-Stufen (insbesondere den Strings für Xhigh und Max) halten Sie sich bitte an die aktuelle offizielle Dokumentation sowie an die Parameterbeschreibung des jeweiligen Anbieters/Kanals.
🚀 Schnellstart: Registrieren Sie sich bei APIYI apiyi.com und erhalten Sie ein kostenloses Testkontingent. Die Plattform bietet eine OpenAI-kompatible Schnittstelle – das obige Skript läuft nach dem Austausch des Keys sofort durch. Ideal, um vor der endgültigen Wahl der Stufe eine kleine Testrunde zur Abnahme zu fahren.
Die Übertragungsgrenzen der LifeVal-Ergebnisse von GPT-6.2 Sol
Um die LifeVal-Ergebnisse auf das eigene Produkt zu übertragen, sollte man mindestens drei Unterschiede berücksichtigen. Erstens Sprache und Region: Die Stichprobe der Studie besteht überwiegend aus US-englischsprachigen Nutzern; in chinesischsprachigen Szenarien ist das Ökosystem der Karten-, Zahlungs- und Kalender-Apps völlig anders. Zweitens die Umgebung: LifeVal läuft in einer kontrollierten Umgebung mit zwischengespeicherten Webseiten, während ein echtes Produkt auf Netzwerkschwankungen, fehlgeschlagene Tool-Autorisierungen und unterschiedliche Kontozustände trifft. Drittens die Kostenstruktur: Die offiziellen Einzelposten-Kosten entsprechen dem Eingabe-Ausgabe-Verhältnis dieser Evaluierung; bei langen Kontextanfragen mit mehr als 272K Eingabe wird insgesamt auf einen höheren Tarif umgestellt, sodass die Einzelposten-Kosten stark von den Diagrammen abweichen können.
Eine sinnvolle Nutzung besteht daher darin, die offiziellen Diagramme als Grundlage für die „Eingrenzung der Kandidaten“ zu verwenden und das eigene Aufgabenset als Grundlage für die „endgültige Entscheidung“. Für einen komplexen Alltagsassistenten kann man zunächst mit der Stufe High eine Baseline aufbauen und dann separat testen, ob Medium die entscheidenden harten Randbedingungen einhält und ob Xhigh oder Max den manuellen Nacharbeitungsaufwand deutlich reduzieren – und dabei mit der tatsächlichen Erfolgsquote und der Rechnung argumentieren.
Sobald dein Aufgabenset, die Bewertungskriterien und die Umgebungsprüfungen bereit sind, ist ein Modell-Upgrade nicht mehr „Modellwechsel nach Rangliste“, sondern ein Engineering-Prozess, der sich jedes Mal erneut testen lässt. Wenn du wiederholt zwischen mehreren Modellen und Stufen vergleichen musst, kannst du über die einheitliche Schnittstelle von APIYI apiyi.com GPT-6.2 Sol, GPT-6.2 Astra und weitere in dasselbe Abnahmeskript einbinden und laufen lassen.
Referenzen
-
OpenAI GPT-6.2 Astra und Sol – Ankündigung (inkl. LifeVal-Stufendiagrammen)
- Link:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - Hinweis: Veröffentlicht am 17.11.2026, Quelle der Stufendaten in diesem Artikel
- Link:
-
LifeVal-Forschungsseite und Paper
- Link:
openai.com/index/lifeval,cdn.openai.com/pdf/lifeval.pdf - Hinweis: Herkunft der Aufgaben, Bewertungsmethodik und Einschränkungen (Paper §3–§5)
- Link:
-
GPT-6.2 Sol – Modellkarte und offizielle Preisgestaltung
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Hinweis: Kontextspezifikation, Abrechnungsregeln für kurze und lange Kontexte sowie Limits
- Link:
-
APIYI – Modellübersicht
- Link:
docs.apiyi.com/models.md - Hinweis: Öffentlich gelistete Modelle, Einstiegspunkte und Preisinformationen
- Link:
Autor: APIYI-Team
Technischer Austausch: Sie erreichen uns gerne über die offizielle APIYI-Website apiyi.com; weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com