Autorhinweis: Dieser Artikel zeigt, wie Sie über APIYI mit zwei Protokollen die erste Anfrage an Gemini 4 Neon senden und welche Felder und Logs Sie nach einer erfolgreichen Anfrage prüfen sollten.
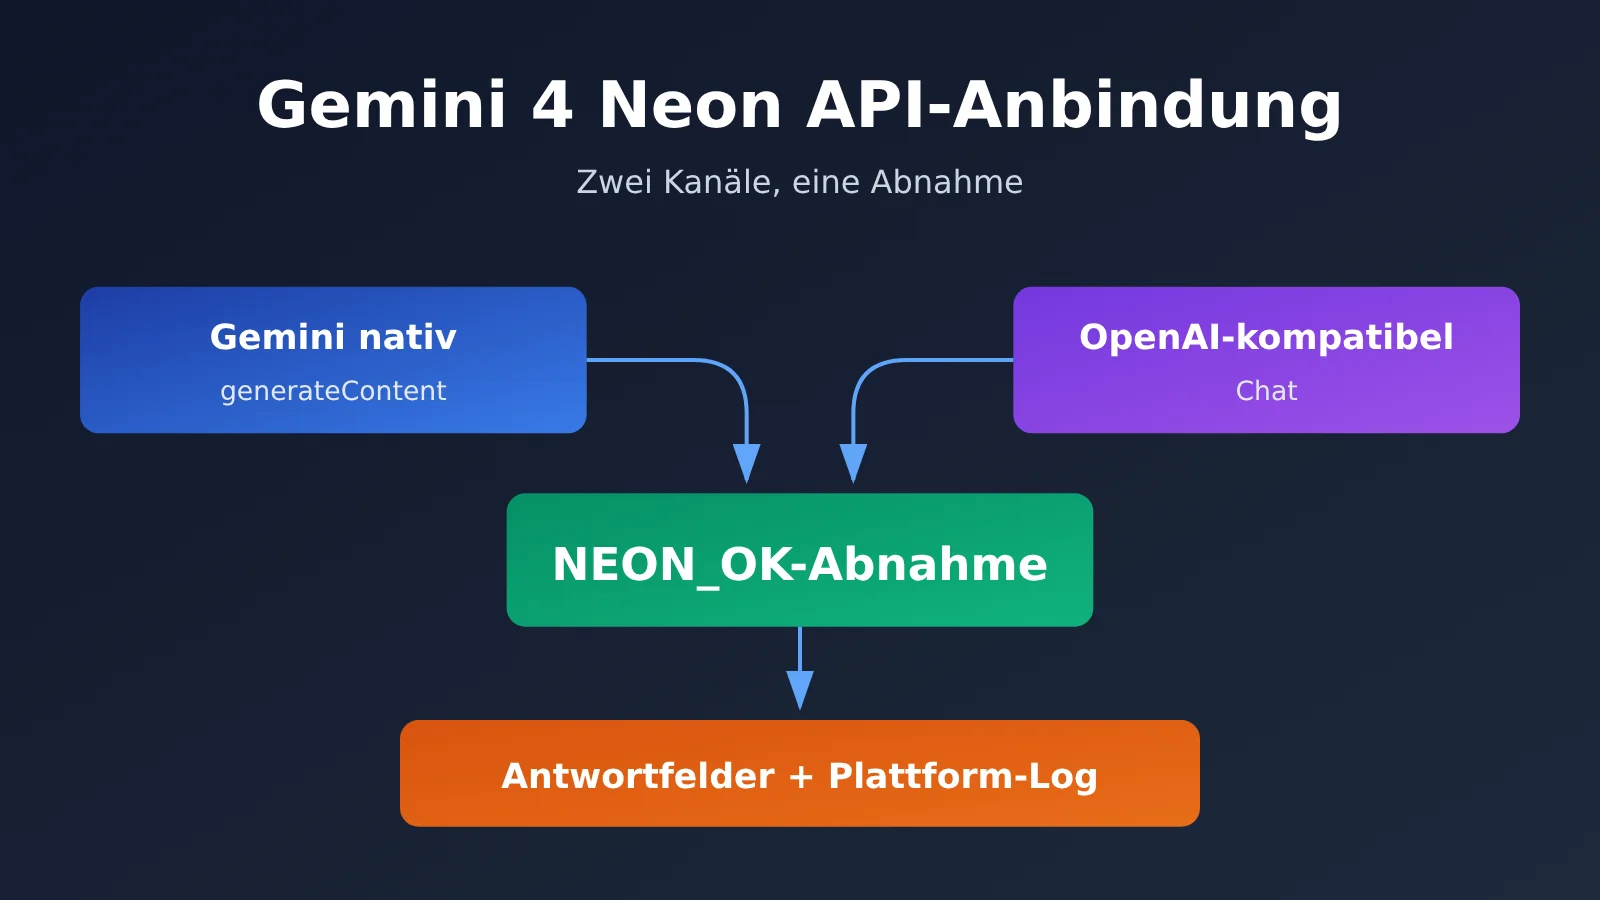
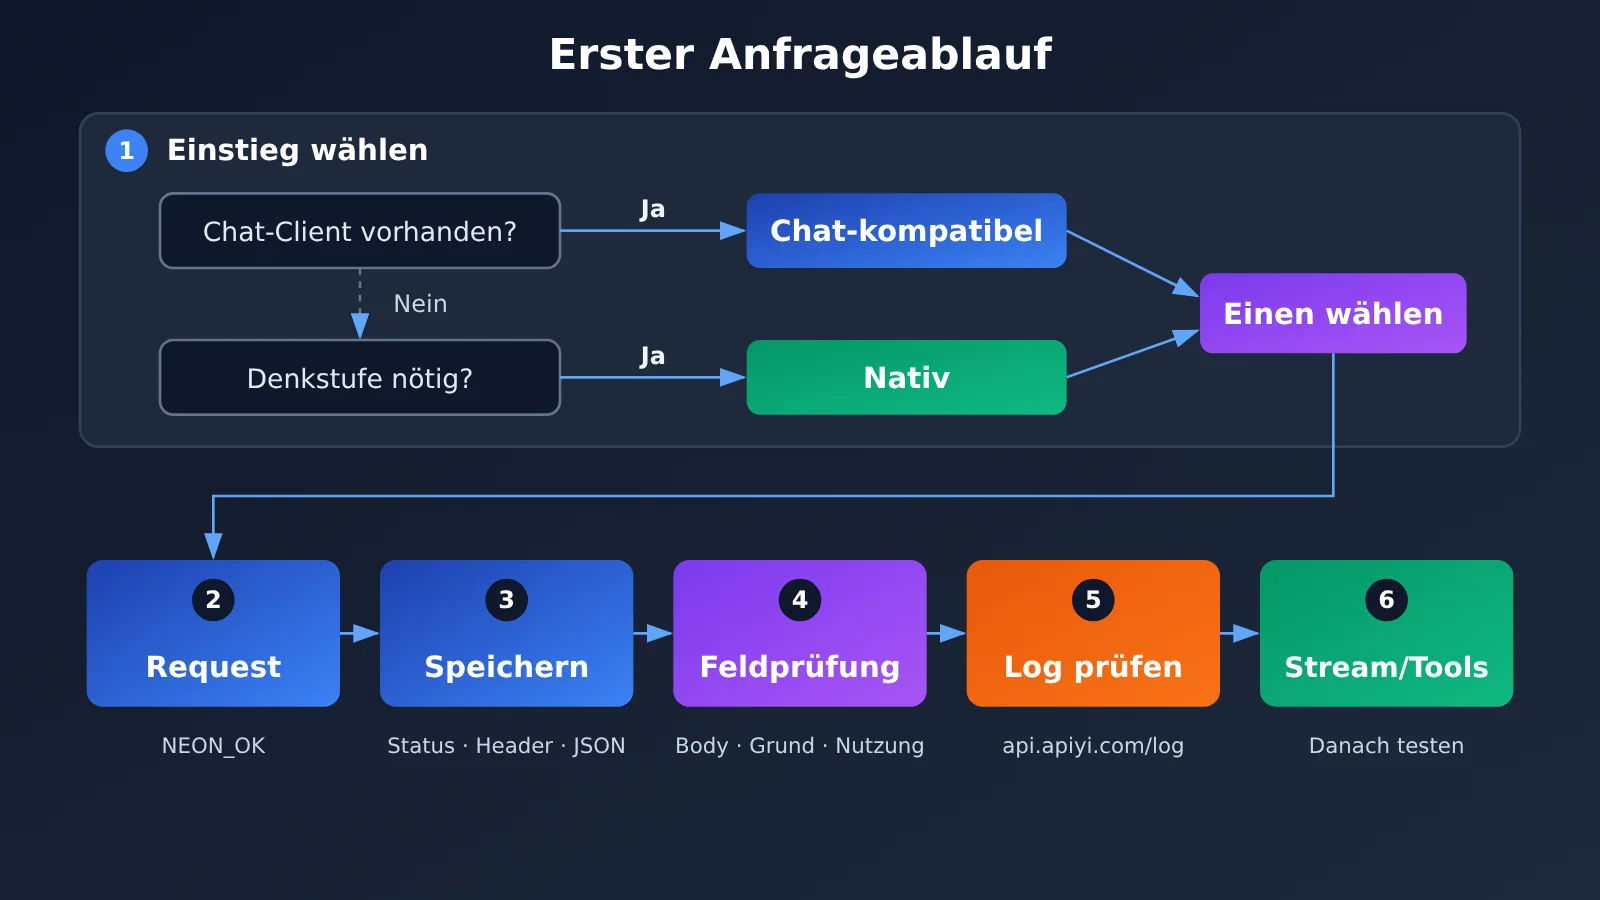
Fazit vorweg: Wenn in Ihrem Projekt bereits ein OpenAI-Chat-Client vorhanden ist, nutzen Sie den OpenAI-kompatiblen Chat-Completions-Einstiegspunkt. Sie müssen nur base_url und den Modellnamen ändern. Wenn Sie die Denkstufe von Gemini explizit festlegen möchten, nutzen Sie den nativen generateContent-Einstiegspunkt von Gemini und geben Sie die Stufe in generationConfig.thinkingConfig.thinkingLevel an. Unabhängig davon, welchen Weg Sie wählen, bringen Sie zuerst mit derselben kurzen Eingabeaufforderung reinen Text zum Laufen und prüfen dann anhand von HTTP-Status, Antworttext, Stop-Grund, Nutzungsdaten und Plattform-Logs, ob alles passt. Erst wenn diese Prüfung bestanden ist, testen Sie Streaming-Ausgabe, Tool-Aufrufe und weitere Funktionen.
Hintergrund: Google hat am 18. November 2026 im AI-Studio-Changelog Gemini 4 Neon veröffentlicht und die allgemeine Verfügbarkeit (GA) angekündigt. APIYI hat am 20.11.2026 um 11:45 Uhr (Peking-Zeit) die Listung bestätigt; im öffentlichen Preisverzeichnis ist gemini-4-neon zu sehen, die verfügbaren Gruppen sind default und svip. Die Beispiele in diesem Artikel wurden anhand der APIYI-Dokumentation und der SDK-Dokumentation erstellt. Es wurden keine kostenpflichtigen Schnittstellen aufgerufen, und der Artikel enthält keine tatsächlichen Messstatistiken.
Gemini 4 Neon API: Wissenskarte und Index für die Anbindung
Der gesamte Anbindungsprozess besteht aus drei Schritten: Schnittstelle wählen, Anfrage senden, Ausgabe und Logs prüfen. Die Ausgabe jedes Schritts ist die Eingabe für den nächsten. Die folgende Tabelle bündelt die Reihenfolge dieser drei Schritte, die Gründe für die Anordnung und das jeweilige Ziel. Sie kann als Wissenskarte oder als Leseindex dienen.
| Nr. | Schritt | Was der vorherige Schritt liefert | Warum diese Reihenfolge | Ziel dieses Schritts |
|---|---|---|---|---|
| 1 | Einstiegspunkt wählen (1.1 Chat-kompatibel / 1.2 nativ und Thinking-Level) | Dein bestehender Code-Stack und die Anforderungen an das Thinking-Level | Der Einstiegspunkt bestimmt URL, Authentifizierungsweise und Feldstruktur; alle nachfolgenden Schritte hängen davon ab | Eine Protokollvariante festlegen und nicht auf zwei Wegen gleichzeitig Fehler suchen |
| 2 | Dieselbe kurze Anfrage senden (2.1 natives cURL / 2.2 Python SDK) | Den festgelegten Einstiegspunkt und das Anfrageformat | Mit einer festen, kurzen Eingabeaufforderung lassen sich Unterschiede in den Modellfähigkeiten ausblenden; so wird nur geprüft, ob die Verbindungskette funktioniert | Vollständigen Statuscode, Antwort-Header und Antwort-Body erhalten |
| 3 | Prüfung (3.1 Felder / 3.2 Identität und Logs / 3.3 Belege bei Fehlschlag sichern) | Die in Schritt 2 gespeicherte Rohantwort | Zuerst die Antwort selbst prüfen, dann mit den Plattform-Logs abgleichen – die Belege von nah nach fern | Feststellen, ob „Text erfolgreich“ zutrifft; falls nicht, nachvollziehbare Belege hinterlegen |
Leseempfehlung: Wer nur eine der beiden Protokollvarianten nutzt, liest in Abschnitt 1 den passenden Unterabschnitt und geht danach direkt zu 2.1 oder 2.2; Abschnitt 3 sollte vollständig gelesen werden.
To Know: Wichtige Begriffe zur Gemini 4 Neon API
| Begriff | Kurze Erklärung |
|---|---|
generateContent |
Die native, nicht streamende Generierungs-Schnittstelle von Gemini; im Request-Body werden die Inhalte mit contents und parts strukturiert |
thinkingLevel |
Das Feld für das Thinking-Level unter generationConfig.thinkingConfig der nativen Schnittstelle; im Beispiel dieses Artikels ist der Wert high |
| thought part | Ein Part in der nativen Antwort, der als Denkinhalt markiert ist; beim Zusammensetzen des Antworttexts muss er ausgeschlossen werden |
finishReason / finish_reason |
Die Stop-Grund-Felder der nativen bzw. der kompatiblen Schnittstelle |
X-Shellapi-Request-Id |
Die von APIYI im Roh-Header der Antwort oder in Fehlermeldungen zurückgegebene Request-ID; hilft bei der Fehlerbehebung |
1 Zugangspunkt für die Gemini-4-Neon-API wählen
Beide Einstiegspunkte führen zum selben Modell; der Unterschied liegt in der Protokollform und darin, welche Parameter sich steuern lassen. Unten folgt zunächst ein Vergleich, danach erläutern zwei kurze Abschnitte die Auswahlgründe.
| Vergleichspunkt | OpenAI-kompatibler Chat | Gemini nativ |
|---|---|---|
| Adresse | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| Geeignet für | Projekte mit vorhandenem OpenAI SDK oder Chat-Client | Projekte, die Gemini-Parameter explizit steuern müssen |
| Denkstufe | In diesem Artikel werden keine entsprechenden Parameter übergeben | thinkingConfig.thinkingLevel |
| Position des Textkörpers | choices[0].message.content |
text (nicht thought) in candidates[0].content.parts |
| Modellkennung | model in der Antwort |
modelVersion in der Antwort (falls zurückgegeben) |
1.1 Kompatibilitätseinstieg für Gemini 4 Neon: vorhandenen Chat-Client weiterverwenden
Wenn vorhandener Code auf dem OpenAI Python SDK oder einem anderen Chat-Completions-Client basiert, ist die Änderung mit dem geringsten Aufwand, base_url auf https://api.apiyi.com/v1 umzustellen und als Modellnamen gemini-4-neon anzugeben; die Nachrichtenstruktur bleibt unverändert. Der Vorteil: Der Code der Geschäftslogik muss praktisch nicht angepasst werden, und bei Problemen lässt sich leichter erkennen, ob sie im Netzwerk, bei der Authentifizierung oder beim Modell liegen.
Bei diesem Weg sollten einige Grenzen klar sein. Erstens: reasoning_effort nicht übergeben. Googles eigene Kompatibilitätsschicht bildet es zwar ab, das heißt aber nicht, dass der Kompatibilitätseinstieg von APIYI dieselbe Zusage macht. Zweitens: Die Schnittstelle /v1/responses wird in diesem Artikel nicht verwendet. Drittens: Die alte Schreibweise thinkingBudget und die Stufe minimal liegen ebenfalls außerhalb des Umfangs dieses Artikels. Wenn Sie die Denkstufe tatsächlich steuern müssen, wechseln Sie bitte zum nativen Einstieg in 1.2.
1.2 Nativer Einstieg für Gemini 4 Neon: Denkstufe explizit festlegen
Der native Einstieg verwendet die eigene Request-Struktur von Gemini. Die Denkstufe wird explizit über generationConfig.thinkingConfig.thinkingLevel übergeben; im dedizierten Beispiel von APIYI ist der verwendete Wert "high". Die native Antwort trennt außerdem Denkinhalt und Textkörper in verschiedene parts, daher muss beim Auslesen des Textkörpers aktiv gefiltert werden; Abschnitt 2.1 zeigt die konkrete Vorgehensweise.
Zur Authentifizierung: Dieses native Beispiel nutzt den Header Authorization: Bearer und nicht die bei Gemini offiziell übliche Schreibweise mit dem key-Parameter. Beim Migrieren vorhandenen nativen Codes sollte man diese Stelle zuerst prüfen.
2 Eine identische kurze Anfrage an die Gemini 4 Neon API senden
Beide Protokolle verwenden dieselbe Eingabeaufforderung: Reply with exactly NEON_OK and nothing else. Die erwartete Ausgabe dieser Eingabeaufforderung ist sehr kurz, und das Ergebnis lässt sich leicht beurteilen. Kommt nicht NEON_OK zurück, deutet das auf ein Problem in der Kette oder beim Parsen hin – Störfaktoren wie „unterschiedlicher Antwortstil des Modells“ lassen sich damit ausschließen. Der API-Schlüssel wird stets aus der Umgebungsvariable APIYI_API_KEY gelesen und darf nicht in Code oder die Befehlshistorie geschrieben werden.
2.1 Natives cURL für Gemini 4 Neon und JSON-Werteauslesen
Der folgende Befehl speichert HTTP-Statuscode, Antwortheader und JSON-Antworttext getrennt voneinander. In Abschnitt 3 (Abnahme) werden alle drei verwendet.
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
Beim Auslesen des Textkörpers müssen alle text-Einträge in candidates[0].content.parts, die nicht thought sind, zusammengefügt werden – es reicht nicht, nur den ersten Part zu nehmen. Das folgende Beispiel nutzt jq; falls jq nicht installiert ist, kann jedes beliebige JSON-Parsing-Tool verwendet werden:
# Textkörper: nicht-thought text zusammenfügen
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# Stop-Grund, Nutzung, Modellversion (bei nicht vorhandenem Feld null ausgeben, nicht selbst einen Wert einsetzen)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# Plattform-Anfragekennung
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 Aufruf von Gemini 4 Neon über das Python OpenAI SDK und Auslesen der Antwort
Für den kompatiblen Endpunkt verwenden wir with_raw_response. So erhalten wir sowohl das geparste Objekt als auch die rohen Antwortheader. Mit max_retries=0 werden die automatischen Wiederholungsversuche des SDK deaktiviert. Dadurch wird verhindert, dass ein Fehler durch einen erneuten Versuch verdeckt wird, und es entstehen auf der Plattform nicht mehrere Logeinträge, bei denen unklar ist, zu welcher Anfrage sie gehören.
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # APIYI OpenAI-kompatibler Endpunkt
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # Vor dem Loggen prüfen, ob keine sensiblen Daten wie Schlüssel enthalten sind
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
Bei diesem Code gibt es einen Punkt, auf den man besonders achten sollte: Wenn choices leer ist, sollte man nicht direkt choices[0] schreiben. Sonst wird ein IndexError ausgelöst und das eigentliche Problem verdeckt. Verbindungsfehler haben weder einen HTTP-Statuscode noch Antwortheader und müssen daher getrennt von APIStatusError behandelt werden.
3 Abnahme des ersten Requests an die Gemini 4 Neon API
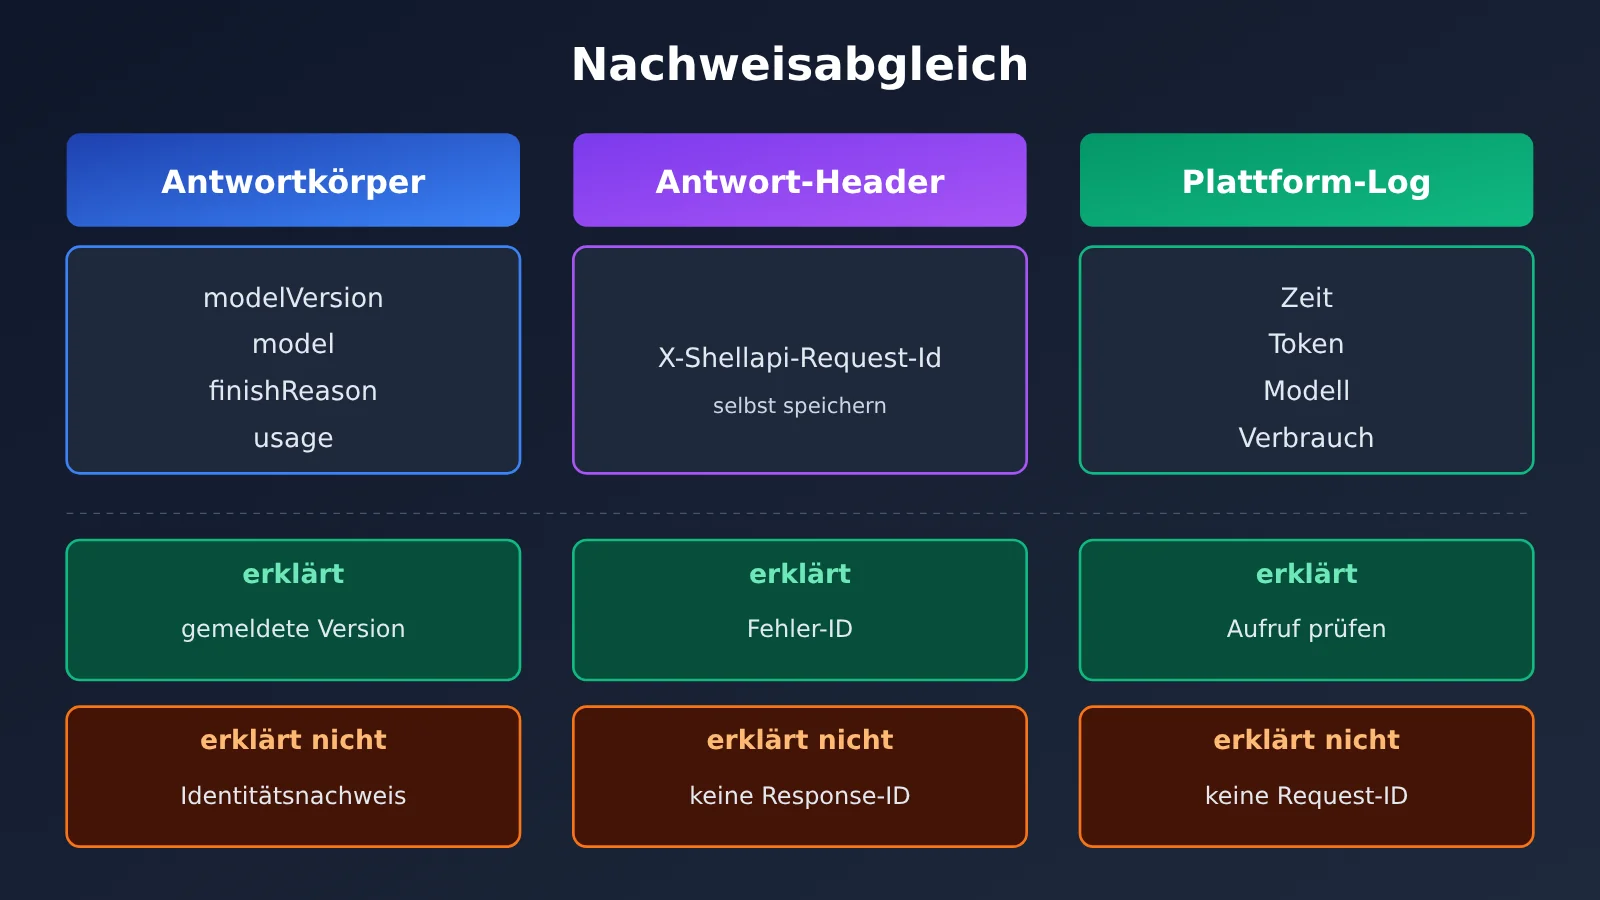
Ziel der Abnahme ist festzustellen, ob die Aussage „reine Textanfrage erfolgreich“ tatsächlich zutrifft. Ein HTTP-2xx-Status zusammen mit dem erwarteten Antwortkörper NEON_OK belegt lediglich, dass diese eine Textanfrage erfolgreich war. Er beweist weder die Identität des Modells noch taugt er als Ergebnis eines Leistungstests.
3.1 HTTP-Status, Antwortkörper, Stoppgrund und Nutzung
| Prüfpunkt | Natives Feld | Kompatibilitätsfeld | Erfolgsbedingung |
|---|---|---|---|
| HTTP-Status | gespeicherter status | raw.status_code |
2xx |
| Antwortkörper | Verkettung des text-Anteils ohne Thought-Inhalte |
choices[0].message.content |
entspricht NEON_OK |
| Stoppgrund | candidates[0].finishReason |
choices[0].finish_reason |
erfasst und mit dem Antwortkörper konsistent |
| Nutzung | usageMetadata |
usage |
erfasst, um sie mit den Logs abzugleichen |
Wenn ein Feld in der Antwort nicht vorhanden ist, vermerken Sie es als „nicht zurückgegeben“ und leiten Sie seinen Wert nicht aus Erfahrungswerten ab. Der Stoppgrund ist immer zusammen mit dem Antwortkörper zu betrachten. Ist der Antwortkörper leer und der Stoppgrund kein normaler Abschluss, liegt das Problem in der Regel im Generierungsprozess und nicht im Parsing-Code.
3.2 Was native modelVersion, kompatibles model und Logs jeweils belegen können
Diese Angaben belegen jeweils unterschiedlich viel; beim Dokumentieren sollten sie nicht gegeneinander ausgetauscht werden:
| Information | Quelle | Kann belegen | Kann nicht belegen |
|---|---|---|---|
modelVersion |
Nativer Response-Body (falls zurückgegeben) | Die vom Response selbst angegebene Modellversion | Kann nicht allein als Identitätsnachweis dienen |
model |
Kompatibler Response-Body | Der vom Response selbst angegebene Modellname | Wie oben |
| Plattform-Logs | api.apiyi.com/log |
Abgleich dieses Aufrufs anhand von Zeit, Token, Modell und Nutzung | Die Konsole zeigt keine Request-ID an |
X-Shellapi-Request-Id |
Ursprünglicher Response-Header oder Fehlermeldung | Die Request-ID, die die Plattform zur Fehlersuche verwendet | Sie ist weder responseId noch die Chat-id noch die _request_id des SDK |
Beim Abgleich der Logs sollten Sie den Sendezeitpunkt des Requests, das verwendete Token, den Modellnamen gemini-4-neon und die Nutzungswerte heranziehen. Da die Konsole keine Request-ID anzeigt, müssen Sie X-Shellapi-Request-Id selbst aus den Response-Headern speichern; nachträglich lässt sie sich in der Konsole nicht nachschlagen.
3.3 Wie Sie bei Gemini 4 Neon Belege sichern, wenn der Antwortkörper fehlt oder die Anfrage fehlschlägt
Wenn eine Anfrage fehlschlägt oder kein Antwortkörper vorliegt, nicht sofort einen neuen Versuch starten, sondern die Belege in dieser Reihenfolge sichern:
- Den HTTP-Statuscode speichern. Bei einem Verbindungsfehler zusätzlich den Fehlertyp notieren.
- Die ursprünglichen Response-Header speichern und daraus
X-Shellapi-Request-Identnehmen. - Den ursprünglichen Response-Body bzw. die Fehlermeldung speichern und dabei sensible Inhalte wie den API-Schlüssel entfernen.
- Den Stop-Grund und die Usage (falls vorhanden) festhalten, außerdem den Zeitpunkt der Anfrage, den Namen des verwendeten Tokens und den Modellnamen.
- Unter
api.apiyi.com/loganhand von Zeit und Token den passenden Eintrag suchen und dann mit den oben gesammelten Materialien die Fehlerbehebung nach der Request-ID-Dokumentation der Plattform durchführen.
Zum nativen Response gibt es noch einen Punkt zu beachten. Wenn in parts nur Thought-Inhalte stehen, ist der gefilterte Antwortkörper leer. In diesem Fall sollte man ehrlich vermerken, dass der gefilterte Antwortkörper leer ist, und die Thought-Inhalte nicht als Antwortkörper behandeln, nur um eine Ausgabe zu bekommen.
Nachdem die Abnahme für reinen Text in einer einzelnen Runde auf die oben beschriebene Weise bestanden ist, können Sie je nach Projektbedarf Streaming-Ausgabe, Tool-Aufrufe und weitere Fähigkeiten prüfen. Für jede zusätzlich geprüfte Fähigkeit gilt dasselbe separate Abnahmeverfahren: dieselbe Anfrage, die ursprüngliche Antwort speichern, mit dem Log abgleichen. Benchmark-Ergebnisse und Preise werden in diesem Artikel nicht behandelt; dazu orientieren Sie sich bitte an den offiziellen Ankündigungen und am öffentlichen Katalog von APIYI.
Referenzen
- Google AI Studio Änderungsprotokoll (2026-11-18):
aistudio.google.com/docs/changelog - Aufbau von Gemini GenerateContentResponse:
aistudio.google.com/api-reference/generate-content - APIYI-Ankündigung zur Einführung von Gemini 4 Neon mit Beispielen für beide Protokolle:
docs.apiyi.com/news/gemini-4-neon-launch.md - APIYI: Verarbeitung von Gemini-Responses:
docs.apiyi.com/api-capabilities/gemini/response-handling - APIYI: Verarbeitung OpenAI-kompatibler Responses:
docs.apiyi.com/api-capabilities/openai/response-handling - APIYI: Fehlerbehebung mit der Request-ID:
docs.apiyi.com/faq/request-id-troubleshooting - openai-python: Zugriff auf die ursprüngliche Antwort:
github.com/openai/openai-python
Auch eine Reise von tausend Meilen beginnt mit einem einzigen Schritt. — Daodejing (Laozi)