Anmerkung des Autors: Die öffentlich zugänglichen Scores von Gemini 4 Neon werden hier nach Programmierung, Wissensarbeit und Wissenschaft aufgeschlüsselt. Zu jedem Punkt ist die Quelle angegeben, damit du einschätzen kannst, welche Art von Arbeit du dem Modell überlassen solltest.
Am 18. November 2026 veröffentlichte Google Gemini 4 Neon. In seinem Ankündigungsbeitrag beschrieb Sundar Pichai die Positionierung als „schneller erledigen“ bei komplexer Softwareentwicklung, Wissensarbeit und wissenschaftlichen Abläufen. Am selben Tag veröffentlichte DeepMind die Model Card, und Artificial Analysis brachte einen Artikel mit Messungen von Drittanbietern sowie eine Modellseite heraus. Damit waren plötzlich mehrere öffentliche Datensätze verfügbar.
Das Problem: Diese Zahlen basieren auf unterschiedlichen Messgrundlagen. Der Google-Blog ist eine offizielle Selbstauskunft; die Vergleichstabelle in der Model Card nennt zwar Claude Opus 5.5 und GPT-6.2 Sol, doch in den Bewertungshinweisen steht, dass Ergebnisse für Nicht-Gemini-Modelle standardmäßig aus den Selbstauskünften der jeweiligen Anbieter stammen. Nur Artificial Analysis liefert eine Messung von Drittanbietern. Dieser Artikel verwendet den 19. November 2026 als Stichtag für die Datenprüfung, behält bei jedem Punkt die Quellenkennzeichnung bei und führt Zahlen, die nicht übereinstimmen, nebeneinander auf, statt sie zu mitteln.
Das Wichtigste: Nach dem Lesen dieses Artikels hast du eine Tabelle nach Aufgabentyp. Du siehst, bei welchen Punkten in den Bereichen Programmierung, Lesen von Material und Wissenschaft die offiziellen Angaben den ersten Platz beanspruchen, bei welchen die Konkurrenz in der Model Card besser abschneidet und bei welchen Gemini in der Drittmessung nur 1 Punkt voraus ist.
Gemini 4 Neon – die Kernpunkte: zuerst der Einstieg, dann drei Bereiche
Der Gesamtwert ist die Zahl, die die meisten zuerst sehen. Der Artikel von Artificial Analysis zeigt, dass Gemini 4 Neon in der xhigh-Denkstufe einen Intelligenzwert von 61 erreicht und insgesamt auf Platz 3 liegt – vor ihm GPT-6.2 Astra (max) und Claude Fable 5.2 (max). Der Google-Blog (offizielle Selbstauskunft) nennt ebenfalls 61 und Platz 3 und ergänzt: „liegt hinter größeren, langsameren Modellen zurück“. In der Spalte AA Index v5.0.1 der Modellkarte steht ebenfalls 61; zum Vergleich: Opus 5.5 mit 59, Sol mit 57.
Diese 61 ist in allen drei Quellen identisch, aber sie ist nur ein Einstieg. Der Gesamtwert vermischt Programmierung, Materiallektüre und Wissenschaft, während die Arbeit, die du abliefern musst, normalerweise nur in einen dieser Bereiche fällt. Die folgende Tabelle erklärt zunächst die Art der drei Quellenkategorien; die späteren Abschnitte schlüsseln dann Block für Block auf.
| Quelle | Art | Was wir damit in diesem Artikel betrachten |
|---|---|---|
| Google-Blog | Offizielle Selbstauskunft | Bei welchen Punkten Google den ersten Platz reklamiert und die jeweiligen Punktzahlen |
| DeepMind-Modellkarte | Offizielle Zusammenfassung; Nicht-Gemini-Ergebnisse stammen meist aus Selbstauskünften der jeweiligen Anbieter | Punkt-für-Punkt-Vergleich in drei Spalten: Neon, Opus 5.5 und Sol |
| Artificial-Analysis-Artikel | Messung durch Dritte | Coding Agent Index, GDP.pdf, MKA usw. |
| Artificial-Analysis-Modellseite | Messung durch Dritte, nach Denkstufe aufgeschlüsselt | Unterschiede der Intelligenzwerte über die vier Denkstufen |
Wo Gemini 4 Neon in der Familie steht
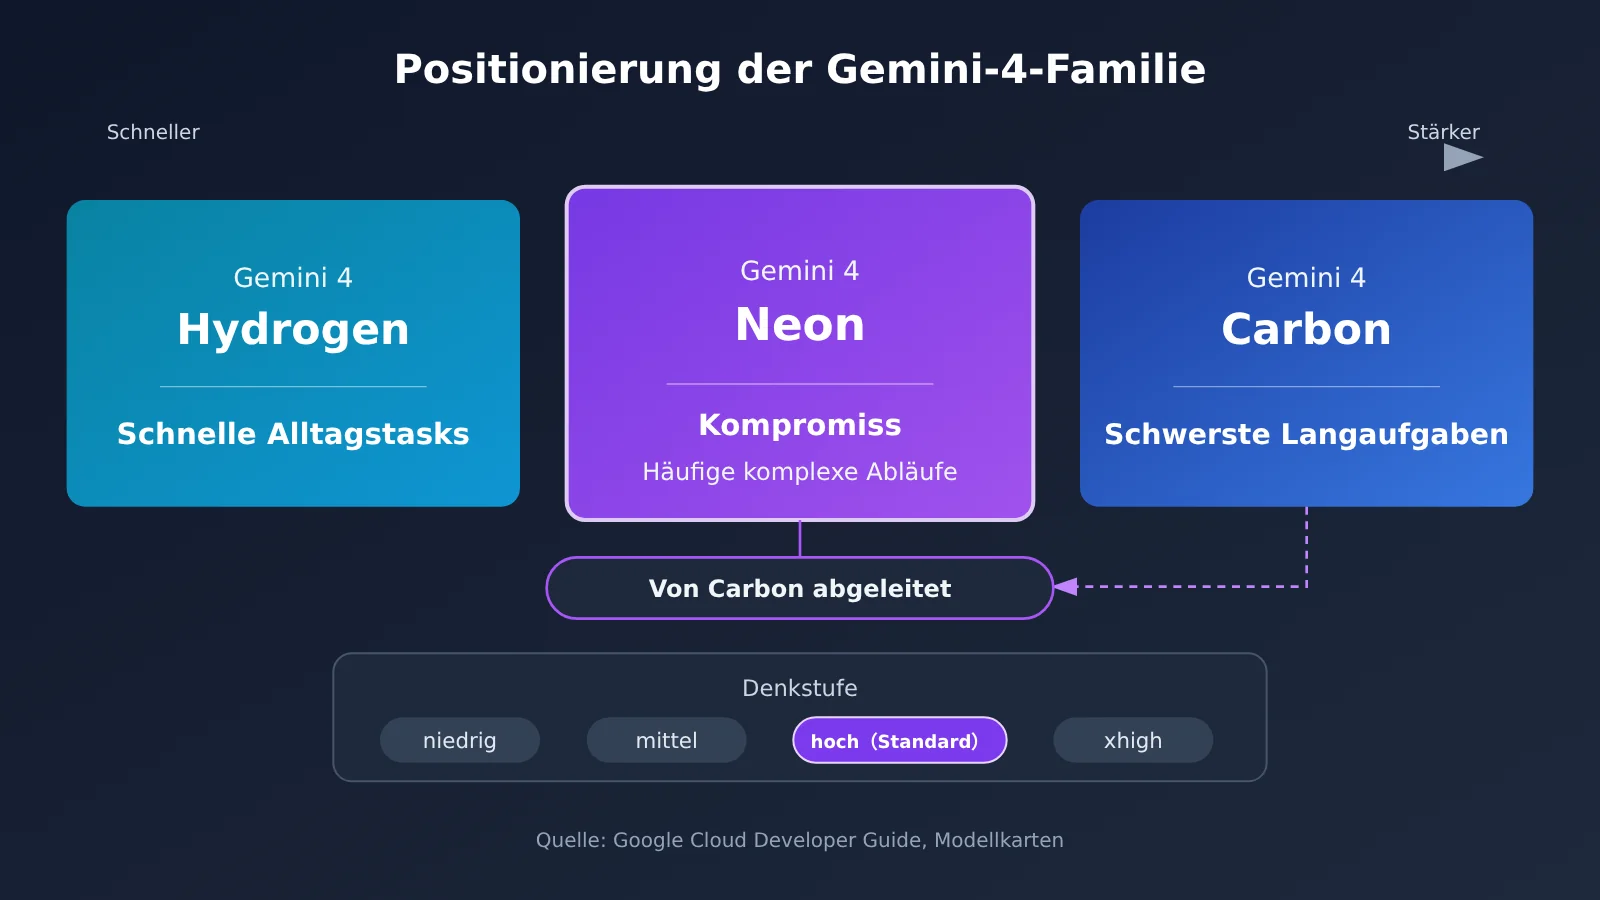
Die Modellkarte gibt an, dass Gemini 4 Neon aus Gemini 4 Carbon abgeleitet wurde, mit Wissensstand März 2026; als Eingabe werden Text, Bild, Audio und Video unterstützt, das einheitliche Kontextfenster umfasst bis zu 1 Million Token. Der Google-Cloud-Entwicklerleitfaden verortet es zwischen Hydrogen (schneller Alltagszyklus) und Carbon (komplexe Langstrecke), und der offizielle Blog beschreibt es als für hochfrequente, komplexe Abläufe gedacht.
Wer diese Positionierung versteht, kann die späteren Scores besser einordnen. Die Vergleichspartner von Neon unterscheiden sich je nach Quelle: Die Modellkarte enthält nur zwei Spalten, Opus 5.5 und Sol; Fable 5.2, Astra und Carbon fehlen dort. Artificial Analysis vergleicht es dagegen vor allem mit Carbon, Fable und Opus. Bei den Detailvergleichen füllt dieser Artikel keine Lücken mit Werten aus anderen Zellen.
Gemini 4 Neon Programmierfähigkeiten: Zwei Vorsprünge, zwei knapp hinter Opus
Programmierung ist der Bereich, dem der Google-Blog am meisten Platz widmet. Laut offizieller Angabe erreicht Gemini 4 Neon im Artificial Analysis Coding Agent Index 58,6 und damit insgesamt Platz 1. Der Artificial-Analysis-Artikel nennt 59, gemessen mit Neon xhigh auf der Antigravity CLI. Die Werte 58,6 und 59 stammen aus zwei Quellen; dieser Artikel behält beide bei.
Den Vorsprung gegenüber Drittanbietern muss man separat betrachten. Im Artificial-Analysis-Artikel kommen Fable xhigh auf Claude Code und Opus 5.5 max beide auf 58, Carbon high auf 55. Das heißt: Neons Vorsprung gegenüber diesen beiden Claude-Modellen beträgt 1 Punkt.
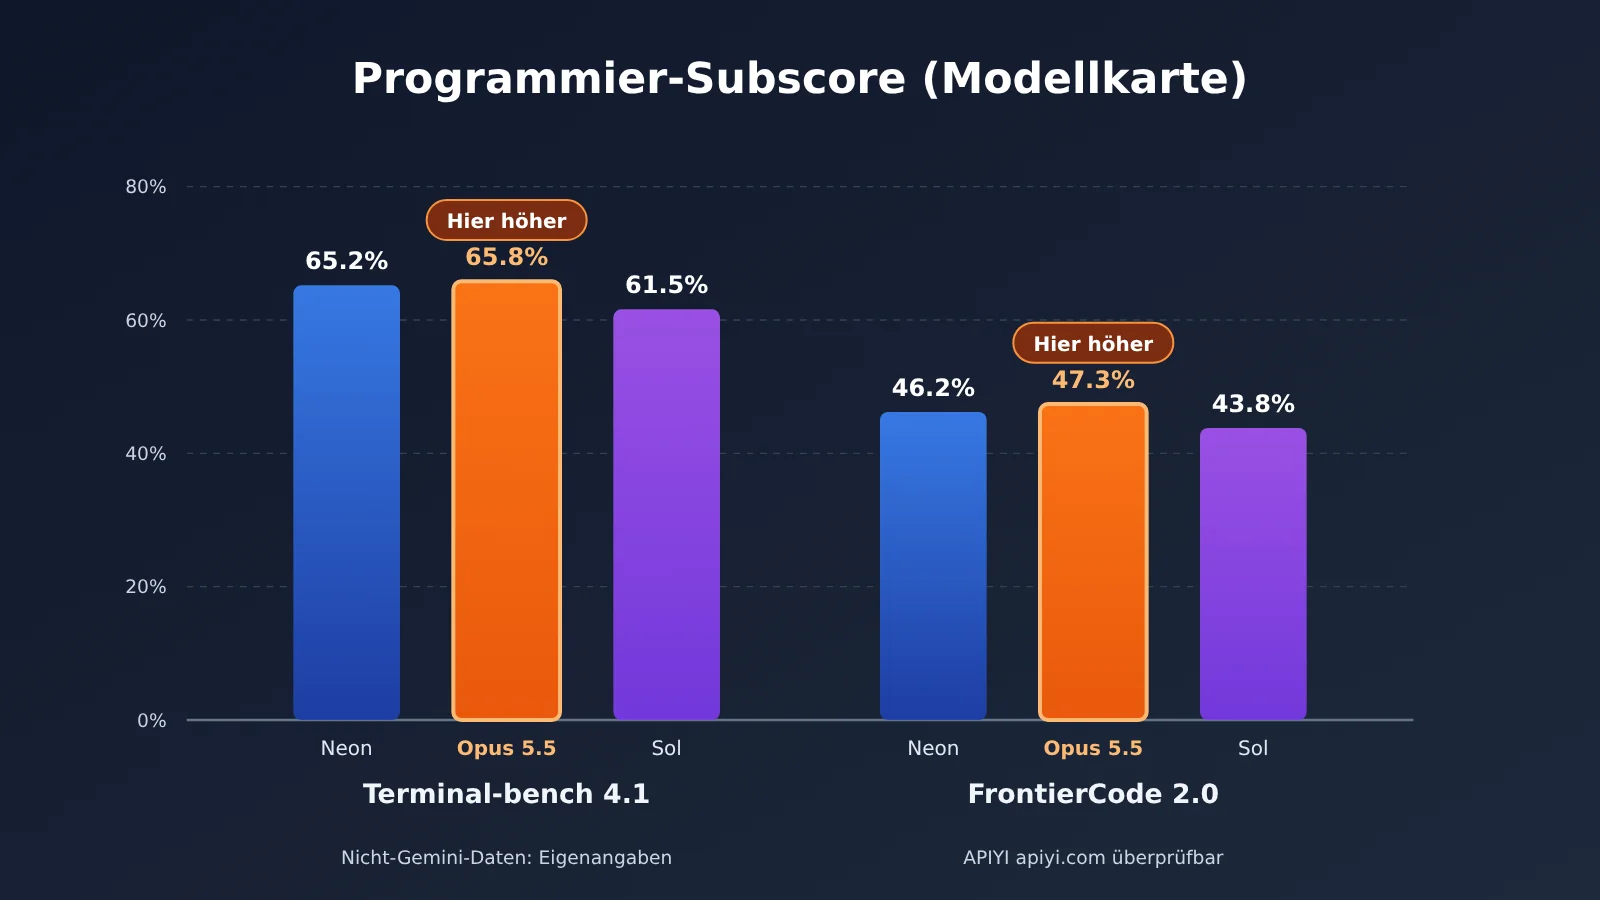
Die Modellkarte schlüsselt das feiner auf; bei zwei Punkten liegt Opus 5.5 vorn.
| Programmier-Benchmark (Modellkarte) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| CursorBench 4.1 | 65,4 % | 58,1 % | – |
| Terminal-bench 4.1 (nach Betrugsbereinigung) | 65,2 % | 65,8 % | 61,5 % |
| FrontierCode 2.0 | 46,2 % | 47,3 % | 43,8 % |
| SWE-sweep Hersteller-Harness | 39,0 % | 10,1 % | 8,3 % |
| SWE-sweep mini-SWE-Harness | 12,8 % | 3,6 % | 11,6 % |
Wie die Programmierwerte von Gemini 4 Neon zu lesen sind
Bei Terminal-bench 4.1 liegt Opus 5.5 bei 65,8 %, Neon bei 65,2 %; bei FrontierCode 2.0 liegt Opus 5.5 bei 47,3 %, Neon bei 46,2 %. Der Abstand beträgt jeweils etwa einen Prozentpunkt, aber die Richtung ist: Opus liegt leicht vorn. Im offiziellen Blog ist der FrontierCode-2.0-Wert von 46,2 % als Standardstufe „high“ ausgewiesen.
Die beiden SWE-sweep-Zahlen werden am leichtesten falsch gelesen. 12,8 % ist das Ergebnis unter dem mini-SWE-Harness, 39,0 % das Ergebnis in Google Antigravity (Hersteller-Harness). Der offizielle Blog beschreibt den Unterschied zwischen beiden als eine durch das Harness ermöglichte Freischaltung; er spiegelt die Wirkung der Toolchain wider und sollte nicht so gelesen werden, als sei das Modell selbst dreimal so gut. Zu beachten ist außerdem, dass Sol unter dem mini-SWE-Harness 11,6 % erreicht – recht nah an Neons 12,8 %.
Gemini 4 Neon in der Wissensarbeit: meist führend, Chartography liegt bei Sol vorn
Im Bereich der Wissensarbeit führt der offizielle Blog eine ganze Reihe von „Platz 1“-Nennungen auf. Legal Research Bench und Tax Agent Bench werden beide als Platz 1 bezeichnet, doch der Blog nennt für diese beiden keine Prozentwerte; auch die Finanz-, Buchhaltungs-, Tabellenmodellierungs- und komplexen Constraint-Aufgaben auf Surge gelten überwiegend als Platz 1, ebenfalls ohne Einzelpunktzahlen. Diese Angaben lassen sich nur als offiziell selbst gemeldete Rankings festhalten – in diesem Artikel ergänze ich keine Zahlen.
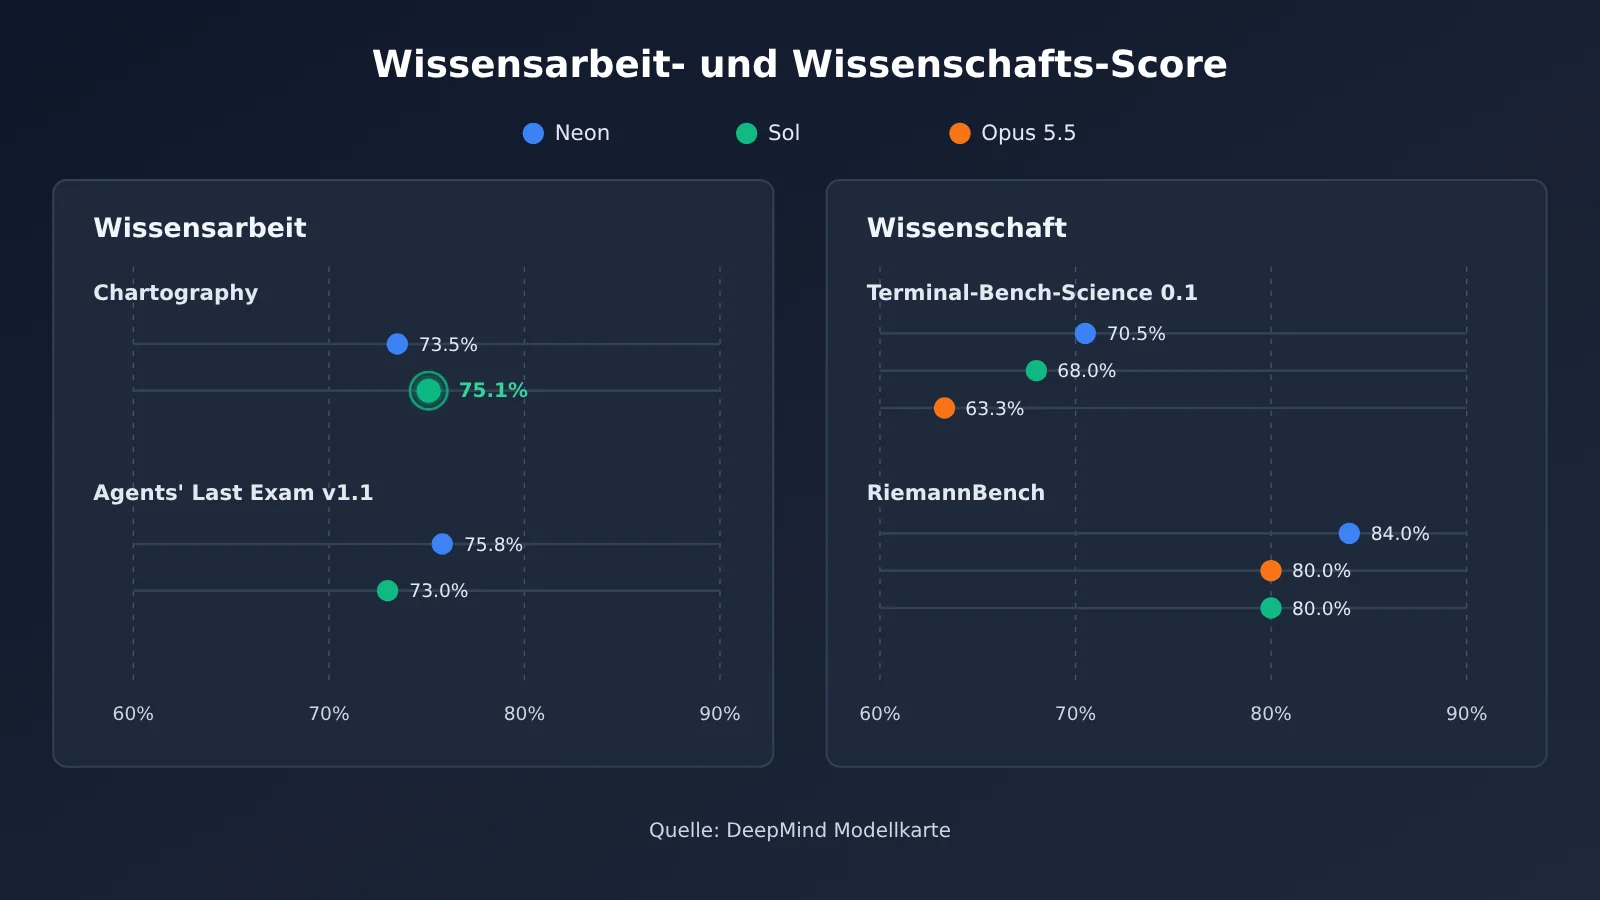
Bei den Posten mit Punktzahlen lässt sich die Modellkarte zum Vergleich heranziehen. Zapier AutomationBench steht im offiziellen Blog auf Platz 1 mit 56,3 %, Andon Labs Vending-Bench 2 auf Platz 1 mit 16.843 US-Dollar. Chartography ist in diesem Abschnitt der einzige Unterpunkt, bei dem Sol höher liegt: Sol 75,1 %, Neon 73,5 %.
Messungen von Dritten liefern mehr Details. Ein Artikel von Artificial Analysis zeigt: Bei GDP.pdf erreicht Neon high 33,4 %, Neon xhigh dagegen nur 28,0 %, Carbon high kommt auf 28,4 % – ein höherer Denkmodus führt also nicht zwangsläufig zu einer besseren Punktzahl. Bei AA-Briefcase kommt Neon xhigh auf insgesamt 1700 Elo und 1771 Elo in der Darstellungsqualität, mehr als die 1726 von Claude Sonnet 5.5 max. Beim MKA-Posten nennt der Artificial-Analysis-Artikel für Neon 56 %, nah an den 57 % von Fable max und zwei Punkte über Carbon; die Modellkarte gibt 56,5 % an – beide Werte bleiben jeweils für sich stehen.
Gemini 4 Neon: wissenschaftliche Fähigkeiten – drei Benchmarks laut Herstellerangaben „best in class“
Die Wissenschaft ist der Bereich der drei, in dem die offizielle Formulierung am stärksten ausfällt. Im Google-Blog werden Terminal-Bench Science mit 70.5 %, RiemannBench mit 84.0 % und HLE-Diamond mit 71.3 % als die drei „best in class“ bezeichnet – eine Angabe des Herstellers selbst. Die Vergleichstabelle in der Modellkarte stimmt damit überein: Bei allen drei Werten liegt Neon über Opus 5.5 und Sol, doch auch die Vergleichsspalten sind eine Zusammenfassung der jeweiligen Herstellerangaben.
| Wissens- und Wissenschafts-Benchmarks (Modellkarte) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents‘ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| GraphWalks (256k–1M, BFS F1) | 95.2% | 66.8% | 80.1% |
| MKA Climb WSR | 56.5% | 53.0% | 52.7% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
GraphWalks erreicht im langen Kontextbereich von 256k bis 1M 95.2 % und liegt damit deutlich vor Opus 5.5 mit 66.8 % – das ist besonders relevant für Szenarien, in denen sehr lange Materialien gelesen werden müssen. Bei Terminal-Bench-Science kommt Sol auf 68.0 %, was 2.5 Prozentpunkte unter Neons 70.5 % liegt; das ist der kleinste Abstand unter den drei Wissenschafts-Benchmarks.
Gemini 4 Neon nach Aufgaben: eine Übersichtstabelle
Fasst man die drei Teile zusammen und ordnet sie nach den drei Fällen „offiziell Platz 1“, „Modellkarte: Konkurrent höher“ und „Drittanbieter: nur 1 Punkt Vorsprung“, erhält man die folgende Tabelle nach Aufgaben. Sie beantwortet nicht, wer insgesamt am stärksten ist – sie zeigt nur, auf welcher Evidenz die Punktzahlen der einzelnen Aufgabentypen beruhen.
| Aufgabentyp | Offiziell selbst gemeldeter Platz 1 | Modellkarte: Konkurrent höher | Drittanbieter: 1 Punkt Abstand |
|---|---|---|---|
| Programmieren | Coding Agent Index 58.6, insgesamt Platz 1 | Terminal-bench 4.1, FrontierCode 2.0: Opus 5.5 höher | Coding Agent Index 59 gegenüber 58 bei Fable xhigh und Opus 5.5 max |
| Wissensarbeit | Legal Research Bench, Tax Agent Bench, AutomationBench, Vending-Bench 2 | Chartography: Sol höher | MKA 56 % gegenüber 57 % bei Fable max (Neon 1 Punkt niedriger) |
| Wissenschaft | Terminal-Bench Science, RiemannBench, HLE-Diamond | keine | kein separater Drittanbieter-Wert für Wissenschaft |
| Gesamteinstieg | Vals Index Platz 2 (70.9 %) | keine | AA-Intelligenzwert 61, 1 Punkt höher als Carbon high |
Gemini 4 Neon: Vor- und Nachteile im Überblick
Vorteile
- In drei wissenschaftlichen Benchmarks durchgehend vorn: Sowohl die eigenen Angaben des Anbieters als auch die Model Card zeigen, dass Terminal-Bench Science, RiemannBench und HLE-Diamond über den beiden Vergleichsmodellen liegen.
- Stark beim Lesen langer Kontexte: Laut Model Card erreicht GraphWalks im Bereich von 256k–1M einen BFS-F1 von 95,2 %, was dem einheitlichen Fenster von 1 Million Token entspricht.
- Deutlicher Hebel durch die Toolchain: SWE-sweep kommt im Harness des Anbieters auf 39,0 % – das zeigt, dass der Nutzen in einer Agent-Umgebung wie Antigravity spürbar größer ist.
- Vollständige multimodale Eingaben: Die Model Card nennt Text, Bild, Audio und Video als Eingabeformate; die Modellseite von Artificial Analysis zeigt dagegen, dass Opus 5.5 nur Text und Bilder als Eingabe akzeptiert.
Einschränkungen
- Beim Programmieren nicht in jeder Disziplin vorn: Bei Terminal-bench 4.1 und FrontierCode 2.0 liegt Opus 5.5 etwas höher. Für reine Terminal- oder Frontier-Code-Aufgaben sollten Sie beide Modelle testen.
- Bei der Diagramm-Interpretation ist die Konkurrenz stärker: In Chartography liegt Sol höher. Bei diagrammlastigen Reporting-Aufgaben sollten Sie Sol in den Vergleich einbeziehen.
- Eine höhere Stufe garantiert keine besseren Ergebnisse: Im Artikel von Artificial Analysis liegt xhigh bei GDP.pdf unter high – die Denkstufe muss je nach Aufgabe angepasst werden.
- Strenge Parameterbeschränkungen: Der Entwicklerleitfaden gibt an, dass die Übergabe von
thinking_budgetoderMINIMALeinHTTP 400zurückgibt; explizites Kontext-Caching wird nicht unterstützt, es greift nur das implizite Caching über gemeinsam genutzte Präfixe ab 4096 Token.
Zu Preis und Geschwindigkeit nur ein Satz: Beim Kostenvergleich pro Aufgabe mit Carbon gibt es unterschiedliche Bezugsgrößen – Google selbst nennt 32 % weniger, der Artikel von Artificial Analysis etwa 17 % weniger. Das gehört in den eigenen Beitrag zur Preisgestaltung; die Laufzeit und Ausgabegeschwindigkeit der einzelnen Denkstufen heben wir uns für den Geschwindigkeitsbeitrag auf.
Gemini 4 Neon Schnellstart: Erst die Aufgabe festlegen, dann die Denkstufe
Für den Einstieg empfiehlt sich ein Vorgehen in drei Schritten: Wählen Sie zuerst anhand der obigen Übersicht den Aufgabentyp, dann die Denkstufe, und prüfen Sie schließlich in der APIYI-Modellübersicht, ob die bereits verfügbaren Modelle der Gemini 4-Familie ausreichen.
- Aufgabentyp wählen: Bei wissenschaftlicher Argumentation und beim Lesen langer Materialien sollten Sie Neon wegen seiner Stärken zuerst in Betracht ziehen. Bei Terminal-Programmierung und Diagrammverständnis nehmen Sie Opus 5.5 oder Sol ebenfalls in die Kandidatenliste auf.
- Denkstufe wählen: Im Entwicklerleitfaden ist angegeben, dass Neon nur die vier Stufen
low,medium,highundxhighbietet, standardmäßighigh. Die Modellseite von Artificial Analysis zeigt für die vier Denkstufen Intelligenzwerte von 44, 55, 60 und 61; zwischenhighundxhighliegt nur 1 Punkt Unterschied, und in GDP.pdf schneidethighsogar besser ab. Daher kann man bei den meisten Aufgaben mit der Standardstufe beginnen. - Verfügbare Modelle prüfen: Bei Orchestrierungsaufgaben können Sie wie im Entwicklerleitfaden vorgehen: Die Hauptsteuerung übernimmt ein starkes Modell, schnelle Teilaufgaben gehen an
gemini-4-hydrogen. Für die schwierigsten Long-Horizon-Aufgaben sollten Siegemini-4-carbonin Betracht ziehen.
Zu den Endpunktadressen: Beim OpenAI-kompatiblen Interface setzen Sie base_url auf https://api.apiyi.com/v1; das native Gemini-Interface verwendet https://api.apiyi.com und die Version v1beta. Lesen Sie den API-Schlüssel aus einer Umgebungsvariable, z. B. APIYI_API_KEY, und schreiben Sie keinen Klartextschlüssel in den Code. Beim Aufruf setzen Sie model einfach auf gemini-4-carbon oder gemini-4-hydrogen; in der APIYI-Modellübersicht sind die Endpunkte für beide chat und gemini.
Die folgende Tabelle zeigt die zum Vergleich geeigneten Modelle aus der am 2026-11-16 aktualisierten APIYI-Modellübersicht (docs.apiyi.com/models.md) und der am 2026-11-19 abgefragten Preis-API (api.apiyi.com/api/pricing, insgesamt 285 Modelle); die Einheit ist US-Dollar pro Million Token.
| Modell-ID | Eingabe | Cache-Lesen | Ausgabe | Verfügbare Plattform |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | APIYI-Modellübersicht, Preis-API |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | APIYI-Modellübersicht, Preis-API |
claude-opus-5-5 |
4 | 0.2 | 20 | APIYI-Modellübersicht, Preis-API |
gpt-6.2-sol |
2 (bei Eingaben über 272000 Token: 3) | 0.1 | 10 (höhere Stufe der Preis-API: ca. 11.25) | APIYI-Modellübersicht, Preis-API |
Die Werte 2/10 für gemini-4-carbon sind der aktuelle Preis im APIYI-Sortiment und entsprechen Googles Einführungspreis bis zum 2026-11-30. Auf der Preisseite von Google AI Studio ist Gemini 4 Neon mit 3.00 US-Dollar für die Eingabe und 15.00 US-Dollar für die Ausgabe pro Million Token gelistet; es gibt keine kostenlose Stufe. In der APIYI-Modellübersicht und in der Preis-API ist es noch nicht aufgeführt. Es ist derzeit nicht verfügbar; wir werden dieses Modell so schnell wie möglich aufnehmen. Modellbezeichnungen und Preise richten sich nach der Modellliste der Plattform.
🚀 Einstiegstipp: Bevor Neon verfügbar ist, können Sie über APIYI apiyi.com mit demselben API-Schlüssel
gemini-4-carbon,claude-opus-5-5undgpt-6.2-solseparat aufrufen und Ihre eigenen Programmier- oder Reporting-Aufgaben jeweils einmal durchlaufen lassen, um zunächst festzustellen, welche Aufgaben Fähigkeiten auf Neon-Niveau erfordern.
Häufige Fragen (FAQ)
Q1: Wie ist Gemini 4 Neon positioniert?
Mittelklasse-Modell der Gemini-4-Familie, das Google am 2026-11-18 veröffentlicht hat. Es ist eine Adaption von Carbon; im Entwicklerhandbuch steht es zwischen Hydrogen und Carbon, und der offizielle Blog beschreibt es als ausgelegt für hochfrequente, komplexe Workflows. Die Modell-ID lautet `gemini-4-neon`.
Q2: Gemini 4 Neon kommt auf 61 im Gesamtwert – welcher Platz ist das?
Laut dem Artikel von Artificial Analysis erreicht das Modell in der xhigh-Stufe 61 Punkte und liegt im Gesamtranking auf Platz 3, davor GPT-6.2 Astra (max) und Claude Fable 5.2 (max). Der Google-Blog und die Modellkarte nennen ebenfalls 61, das passt zusammen. Der Gesamtwert taugt aber nur als Einstiegspunkt – die Einzelwerte sollte man je nach Aufgabe betrachten.
Q3: Sind es beim Coding Agent Index jetzt 58.6 oder 59?
Beide stimmen, sie kommen nur aus unterschiedlichen Quellen. 58.6 ist die Zahl aus dem Google-Blog (offizielle Selbstauskunft), 59 ist der Wert, den der Artificial-Analysis-Artikel mit Neon xhigh in der Antigravity CLI gemessen hat. Man sollte die beiden weder zusammenführen noch mitteln.
Q4: Der Unterschied zwischen 12.8 % und 39.0 % bei SWE-sweep – was sagt das aus?
Das sind Ergebnisse aus zwei verschiedenen Harnesses: 12.8 % stammen aus dem mini-SWE-Harness, 39.0 % aus Google Antigravity. Der offizielle Blog erklärt die Lücke damit, dass der Harness hier viel freischaltet. Bei der Auswahl sollte man deshalb darauf achten, in welcher Agent-Umgebung man tatsächlich arbeitet.
Q5: In welchen Benchmarks liegen die Konkurrenten über Gemini 4 Neon?
In der Modellkarte liegen bei Terminal-bench 4.1 und FrontierCode 2.0 Claude Opus 5.5 leicht vorn, bei Chartography GPT-6.2 Sol. Im Artificial-Analysis-Artikel kommt Fable max bei MKA auf 57 % und liegt damit über den 56 % von Neon.
Q6: Kann ich Gemini 4 Neon schon per API aufrufen?
Auf Google-Seite ist das Modell bereits über die Gemini API in AI Studio und weitere Kanäle verfügbar. In der Übersichtstabelle und der Preis-Schnittstelle von APIYI apiyi.com findet sich `gemini-4-neon` derzeit noch nicht – es ist also noch nicht gelistet. Wir stellen dieses Modell so schnell wie möglich bereit; maßgeblich für Bezeichnung und Preis ist die Modellliste der Plattform.
Q7: Womit kann ich bis zur Bereitstellung testweise arbeiten?
Bis dahin kannst du bei APIYI apiyi.com über die OpenAI-kompatible Adresse `https://api.apiyi.com/v1` die Modelle `gemini-4-carbon` oder `gemini-4-hydrogen` aufrufen. Mit demselben Key lassen sich auch `claude-opus-5-5` und `gpt-6.2-sol` für Quervergleiche nutzen. Neue Nutzer erhalten ein kostenloses Testkontingent.
Q8: Welche Aufruflimits gelten für Gemini 4 Neon?
Im Entwicklerhandbuch steht: Es gibt nur vier Denkstufen, von `low` bis `xhigh`; wer `thinking_budget` oder `MINIMAL` übergibt, bekommt `HTTP 400` zurück. Explizites Kontext-Caching wird nicht unterstützt. Das Gesamtlimit liegt bei 1048576 Token inklusive Ein- und Ausgabe, die Standardausgabe pro Abschnitt bei maximal 65536.
Gemini 4 Neon: die wichtigsten Erkenntnisse
- Der Gesamtscore ist nur der Einstieg: AA-Intelligenzscore 61 und Platz 3 stimmen in allen drei Quellen überein – bei der Modellauswahl muss trotzdem nach Aufgabe differenziert werden.
- Im Coding liegt Opus 5.5 bei zwei Werten vorn: In der Modellkarte sind Terminal-bench 4.1 und FrontierCode 2.0 bei Opus 5.5 leicht höher.
- Drittanbieter-Wertung im Coding: 1 Punkt vorn: Coding Agent Index 59 gegenüber 58 bei Fable xhigh und Opus 5.5 max.
- Bei Wissensarbeit meist vorn: Bei Chartography liegt Sol höher; bei GraphWalks ist der Langkontext-Vorteil am deutlichsten.
- In der Wissenschaft nennt der Hersteller drei Benchmarks „best in class“: Auch im Vergleich der Modellkarten liegt Neon vorn, doch die Daten der Wettbewerber sind Selbstarauskünfte der jeweiligen Anbieter.
- Thinking-Stufe startet bei high: high und xhigh unterscheiden sich im Intelligenzscore nur um 1 Punkt, bei GDP.pdf liegt high vorn.
- Zum Einstieg zuerst die bereits verfügbaren Modelle testen: Vor dem Launch von Neon lassen sich auf APIYI apiyi.com mit Carbon und Hydrogen erste Aufgaben ausführen.
Fazit
Wie stark Gemini 4 Neon ist, wird viel klarer, wenn man es in drei Bereiche aufteilt:
- Coding: Laut Hersteller Platz 1 im Coding Agent Index, in der Drittanbieter-Wertung beträgt der Vorsprung nur 1 Punkt, und in der Modellkarte liegt Opus 5.5 bei zwei Werten leicht vorn.
- Wissensarbeit: Bei AutomationBench, dem Langkontext-Benchmark GraphWalks und weiteren liegt Neon meist vorn; bei Chartography liegt Sol höher.
- Wissenschaft: Drei Benchmarks nennt der Hersteller „best in class“, der Vergleich in der Modellkarte zeigt ebenfalls durchgängig einen Vorsprung – der Bereich mit der konsistentesten Evidenzbasis der drei.
Am besten ordnen Sie Ihre Aufgabe zuerst einer dieser Kategorien zu und prüfen dann anhand der Übersichtstabelle in diesem Artikel, ob Sie Neon wirklich brauchen. Vor dem Launch können Sie über APIYI apiyi.com mit einer einheitlichen Schnittstelle Gemini 4 Carbon, Hydrogen sowie Opus und Sol zum Vergleich aufrufen; sobald gemini-4-neon verfügbar ist, tauschen Sie einfach die Modell-ID aus und testen erneut.
📚 Referenzen
-
Google Blog – Introducing Gemini 4 Neon: Offizieller Ankündigungsbeitrag und selbst gemeldete Scores
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Beschreibung: Die offiziell selbst gemeldeten Rankings sowie Coding- und Wissenschafts-Scores
- Link:
-
DeepMind Model Card – Gemini 4 Neon: Dreispaltige Vergleichstabelle und Modellspezifikationen
- Link:
deepmind.google/models/model-cards/gemini-4-neon/ - Beschreibung: Einzelne Scores für Neon, Opus 5.5 und Sol; Ergebnisse, die nicht von Gemini stammen, sind standardmäßig selbst gemeldet von den jeweiligen Anbietern
- Link:
-
Google Cloud Entwicklerleitfaden – Gemini 4 Neon: Parameter und Aufrufeinschränkungen
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Beschreibung: Thinking-Stufen, Token-Limits, Caching und Fehlercodes
- Link:
-
Artificial Analysis Artikel – Gemini 4 Neon intelligence gain: Messung durch Dritte
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Beschreibung: Coding Agent Index 59, GDP.pdf, MKA usw.
- Link:
-
Artificial Analysis Modellseite – Gemini 4 Neon: Indizes nach Thinking-Stufe aufgeschlüsselt
- Link:
artificialanalysis.ai/models/gemini-4-neon - Beschreibung: Vergleich der Intelligenz-Scores in vier Stufen
- Link:
-
APIYI Modellübersicht: Verfügbare Modelle und Preise
- Link:
docs.apiyi.com/models.md - Beschreibung: Modelle und Preise richten sich nach der Modellliste der Plattform
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com