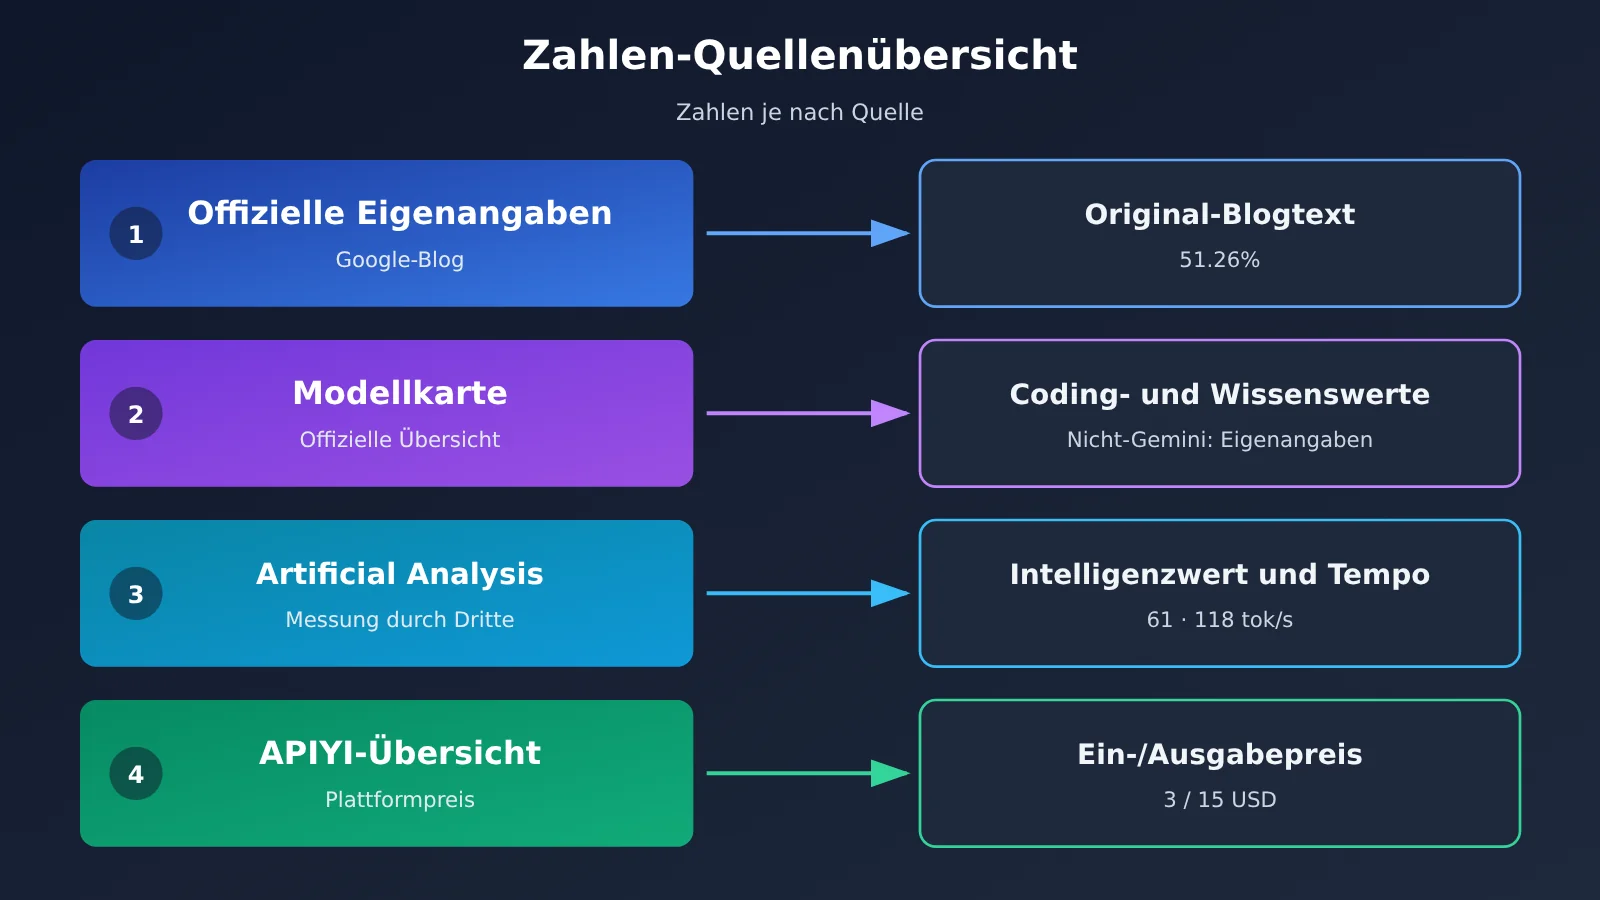
Anmerkung des Autors: Dieser Artikel betrachtet die öffentlich verfügbaren Zahlen von Gemini 4 Neon und Claude Opus 5.5 getrennt nach Coding und Wissensarbeit und gibt für jede Zahl an, ob sie aus der offiziellen Selbstauskunft, der Modellkarte, der Artificial-Analysis-Modellseite, einem Artificial-Analysis-Artikel, der APIYI-Übersichtstabelle oder der Preis-API stammt.
Wenn dein Workflow bereits Claude Opus 5.5 integriert hat, wirft das am 2026-11-18 veröffentlichte Gemini 4 Neon eine direkte Frage auf: Wer bei demselben Projekt die höheren Zahlen liefert – und ob diese Zahlen mit demselben Maßstab gemessen wurden. Der Google-Blog, die DeepMind-Modellkarte und Artificial Analysis haben am Tag der Veröffentlichung Zahlen genannt, aber ihre Definitionen, Stufen und Testframeworks unterscheiden sich.
Der Datenstand dieses Artikels: 2026-11-19. Alle Zahlen stammen aus öffentlich zugänglichen Quellen, und für jede Zahl ist die Quelle angegeben. Coding und Wissensarbeit werden getrennt betrachtet, Modellkarte und Artificial Analysis in zwei Abschnitten behandelt. Welches Modell besser zu dir passt, hängt davon ab, welche Zeilen dir wichtig sind.
Der Kernnutzen: Nach dem Lesen dieses Artikels weißt du, wie die dreispaltige Tabelle der Modellkarte von Gemini 4 Neon zu lesen ist, was Intelligenz-Score, Kosten pro Aufgabe, Laufzeit und Ausgabegeschwindigkeit auf Artificial Analysis jeweils bedeuten und wie du auf APIYI die Modellbezeichnung und den Listenpreis von Claude Opus 5.5 findest.
Gemini 4 Neon und Claude Opus 5.5: Kernpunkte
Zuerst eine Tabelle zum schnellen Überblick. Jede Zeile nennt die Einstellungsstufe und die Quelle; die Messbedingungen der beiden Zahlen in derselben Zeile müssen nicht identisch sein.
| Dimension | Gemini 4 Neon | Claude Opus 5.5 | Quelle |
|---|---|---|---|
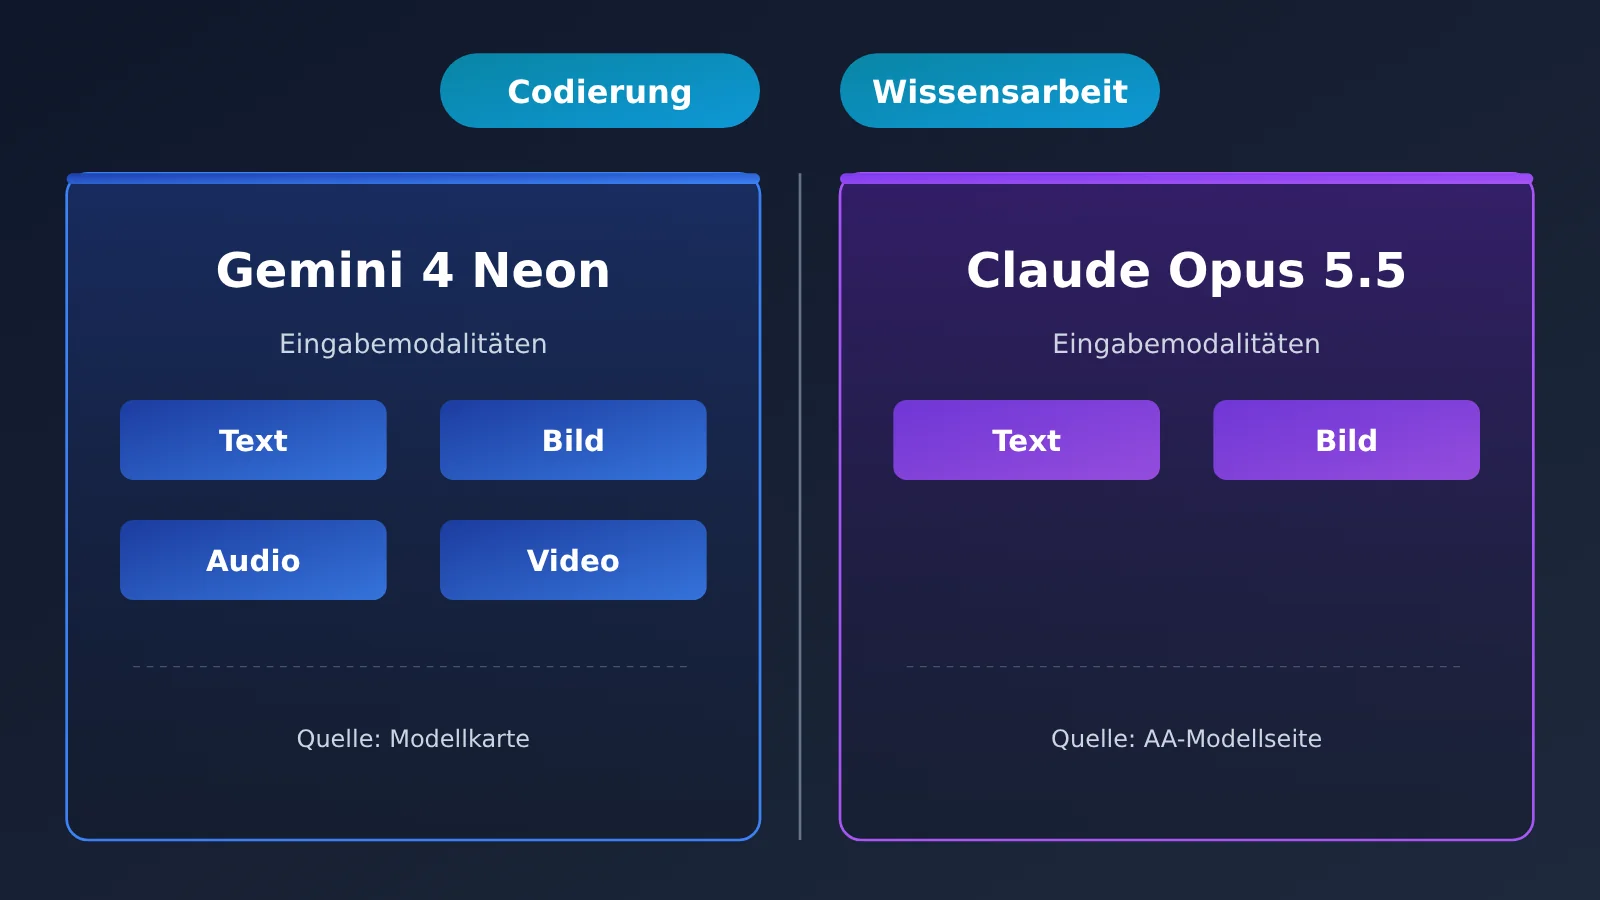
| Eingabemodalitäten | Text, Bilder, Audio, Video | Text, Bilder | Model Card / Artificial-Analysis-Modellseite |
| Intelligenzindex (Index v5.0.1) | 61 (xhigh) | 59 (max) | Artificial-Analysis-Modellseite |
| Terminal-bench 4.1 (cheating-bereinigt) | 65,2 % | 65,8 % | Model Card (Nicht-Gemini-Ergebnisse: Angaben der jeweiligen Anbieter) |
| FrontierCode 2.0 | 46,2 % (Standard: high) | 47,3 % | Model Card |
| Kosten pro Aufgabe | 6,44 US-Dollar | 10,04 US-Dollar | Artificial-Analysis-Modellseite |
| Ausgabegeschwindigkeit | 110 Token/s | 118 Token/s | Artificial-Analysis-Modellseite |
| Listenpreis (Eingabe / Ausgabe, pro Million Token) | 3 / 15 US-Dollar | 4 / 20 US-Dollar | Google-AI-Studio-Preisseite / Artificial-Analysis-Modellseite |
Die Zahlenverteilung von Gemini 4 Neon und Claude Opus 5.5
In dieser Tabelle gibt es für beide Seiten Zeilen mit höheren Werten. Bei den meisten Unterpunkten der Model Card und beim Intelligenzindex von Artificial Analysis (61 gegenüber 59) liegt Gemini 4 Neon höher. Bei Terminal-bench 4.1 (65,8 % gegenüber 65,2 %), FrontierCode 2.0 (47,3 % gegenüber 46,2 %) und der Ausgabegeschwindigkeit (118 gegenüber 110 Token/s) liegt Claude Opus 5.5 höher.
Die Eingabemodalitäten muss man separat betrachten. Laut Model Card kann Gemini 4 Neon Text, Bilder, Audio und Video als Eingabe verarbeiten. Laut der Modellseite von Artificial Analysis verarbeitet Claude Opus 5.5 als Eingabe nur Text und Bilder. Wenn Ihre Aufgabe die direkte Verarbeitung von Audio oder Video erfordert, entscheidet dieser Punkt über die Auswahl. Geht es in der Aufgabe nur um Text und Screenshots, macht dieser Punkt keinen Unterschied.
Gemini 4 Neon vs. Claude Opus 5.5: Wie man die dreispaltige Tabelle der Modellkarte liest
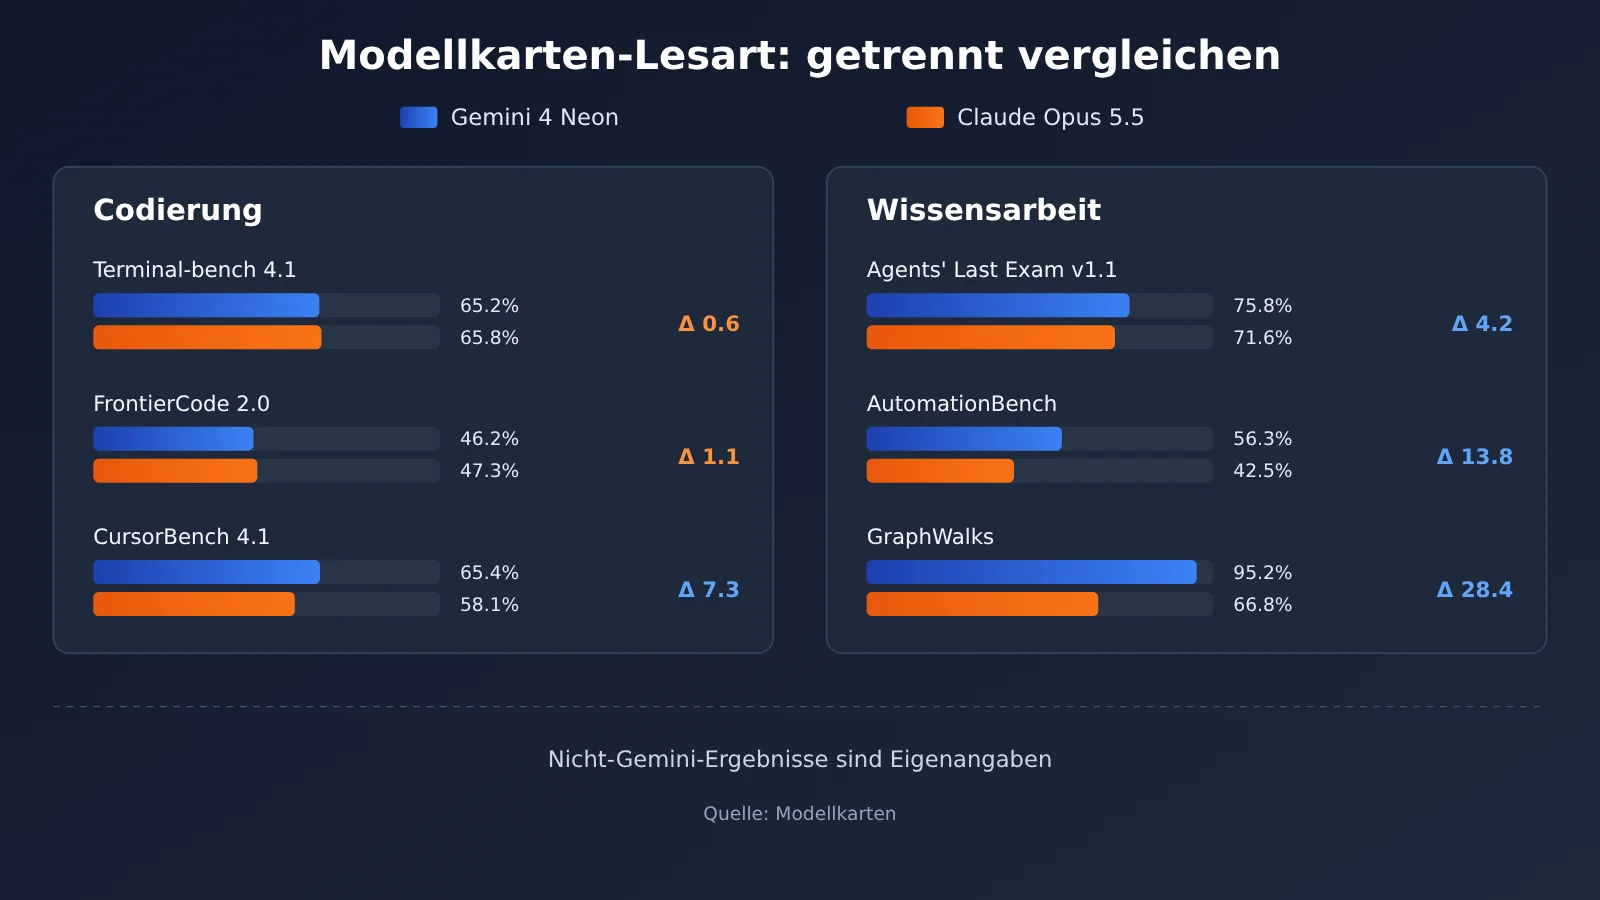
Die Vergleichstabelle in der DeepMind-Modellkarte hat nur drei Spalten: Gemini 4 Neon, Claude Opus 5.5 und GPT-6.2 Sol. Dieser Artikel betrachtet nur die ersten beiden Spalten. Im PDF mit den Auswertungshinweisen steht ausdrücklich, dass die Ergebnisse für Nicht-Gemini-Modelle standardmäßig aus den Angaben der jeweiligen Anbieter selbst stammen. Diese Tabelle ist also eine offizielle Zusammenfassung – die Spalten wurden nicht von ein und demselben Labor am selben Tag nachgemessen. Beim Lesen sollte man deshalb jede Zelle als eine öffentliche Erklärung betrachten.
Codierungsbezogene Unterpunkte von Gemini 4 Neon und Claude Opus 5.5
Hier sind die Zeilen der Modellkarte, die mit Codierung und sicherer Programmierung zusammenhängen.
| Unterpunkt (Modellkarte) | Gemini 4 Neon | Claude Opus 5.5 | Höherer Wert |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | Neon |
| Terminal-bench 4.1 (Genauigkeit nach Cheat-Bereinigung) | 65.2% | 65.8% | Opus |
| FrontierCode 2.0 | 46.2% (standardmäßig high) | 47.3% | Opus |
| SWE-sweep Hersteller-Harness | 39.0% | 10.1% | Neon |
| SWE-sweep mini-SWE-Harness | 12.8% | 3.6% | Neon |
| CWE-Bench v2 | 70.7% | 67.1% | Neon |
| WebExploitBench v1.2 | 51.3% | 37.1% | Neon |
Beim Lesen dieser Tabelle sind drei Punkte zu beachten.
- Beide Unterpunkte, bei denen Opus höher liegt, gehören zum Kern-Coding. Terminal-bench 4.1 und FrontierCode 2.0 messen beides Mal Terminal-Bedienung und Code-Aufgaben; der Abstand beträgt 0,6 bzw. 1,1 Prozentpunkte. Bei Neon ist der FrontierCode-Wert mit der Standardstufe high gekennzeichnet.
- Die beiden SWE-sweep-Zeilen verwenden zwei verschiedene Harnesses. Neon erreicht in Google Antigravity 39.0 %, im mini-SWE-Harness 12.8 %. Der Google-Blog schreibt diesen Abstand dem Harness zu, das hier mehr Spielraum freigibt – man sollte ihn deshalb nicht so lesen, dass die Modelle selbst um den Faktor drei auseinanderliegen. Vergleicht man zwei Modelle, sollte man das unter demselben Harness tun, also 39.0 % gegen 10.1 % oder 12.8 % gegen 3.6 %.
- Dieselbe Zahl wird in verschiedenen Quellen unterschiedlich geschrieben. WebExploitBench erscheint in der Modellkarte als 51.3 %, im Google-Blog als 51.26 %. Beide Schreibweisen werden originalgetreu übernommen, ohne eine davon auszuwählen.
Gemini 4 Neon und Claude Opus 5.5: Wissens- und Wissenschafts-Unterkategorien
Für Wissensarbeit, wissenschaftliches Reasoning und langen Kontext gibt es mehr Unterkategorien; in diesem Bereich liegt Neon in den meisten Fällen höher.
| Unterpunkt (Modellkarte) | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| AA Index v5.0.1 | 61 | 59 |
| Vals Index v2.2 | 70.9% | 70.1% |
| AutomationBench | 56.3% | 42.5% |
| Agents‘ Last Exam v1.1 | 75.8% | 71.6% |
| RiemannBench | 84.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% |
| HLE-Diamond | 71.3% | 67.9% |
| MKA Climb WSR | 56.5% | 53.0% |
| Chartography | 73.5% | 66.3% |
| LVBench | 89.0% | 83.7% |
| GraphWalks (256k bis 1M, F1 bei BFS) | 95.2% | 66.8% |
Die Unterschiede fallen je nach Zeile unterschiedlich aus. Beim Vals Index beträgt der Unterschied nur 0.8 Prozentpunkte, bei GraphWalks sind es 28.4 Prozentpunkte; letzterer misst die Graph-Traversierung bei extrem langem Kontext von 256k bis 1M Token. Wenn Ihre Wissensarbeit darin besteht, in langen Dokumenten zu recherchieren und Schlussfolgerungen zu ziehen, sollten Sie die GraphWalks-Zeile besonders beachten. Wenn es um Geschäftsautomatisierung geht, liegt der Vergleich von 56.3% zu 42.5% beim AutomationBench näher an Ihrem Anwendungsfall.
Im Google-Blog werden außerdem einige Platzierungen in Form offizieller Selbstauskünfte genannt, zum Beispiel Platz 1 bei Legal Research Bench und Tax Agent Bench sowie auf Surge in Finanzen, Buchhaltung und Tabellenmodellierung meist Platz 1. Der Blog nennt für diese Projekte keine Prozentwerte und führt auch keine entsprechenden Zahlen für Opus auf; daher lassen sich diese Platzierungen nicht direkt in die Vergleichstabelle der beiden Modelle aufnehmen.
Gemini 4 Neon vs. Claude Opus 5.5: Wie man die vier Zahlen von Artificial Analysis liest
Artificial Analysis ist eine Messung von Drittanbietern und gehört einem anderen System an als die Modellkarten. Auf der jeweiligen Modellseite werden für jede Denkstufe Intelligenzwert, Kosten pro Aufgabe, Dauer und Ausgabegeschwindigkeit angegeben. Der zentrale Vergleich in diesem Abschnitt ist Neon xhigh gegen Opus max – das sind die jeweils höchsten Stufen der beiden Anbieter auf ihren Modellseiten, doch die beiden Stufen sind nicht gleichwertig.
| Kennzahl (Artificial Analysis Modellseite, v5.0.1) | Gemini 4 Neon (xhigh) | Claude Opus 5.5 (max) |
|---|---|---|
| Intelligenzwert | 61 | 59 |
| Kosten pro Aufgabe | 6.44 US-Dollar | 10.04 US-Dollar |
| Dauer pro Aufgabe | 21.5 Minuten | 24.5 Minuten |
| Ausgabegeschwindigkeit | 110 Token/Sekunde | 118 Token/Sekunde |
| Zeit bis zum ersten Antwort-Token | 56.51 Sekunden | 335.85 Sekunden |
| Ausgabe-Token beim Indexlauf | 283 Millionen | 218 Millionen |
| Listenpreis (Eingabe / Ausgabe) | 3.00 / 15.00 US-Dollar | 4.00 / 20.00 US-Dollar |
| Mischpreis | 2.21 US-Dollar | 2.94 US-Dollar |
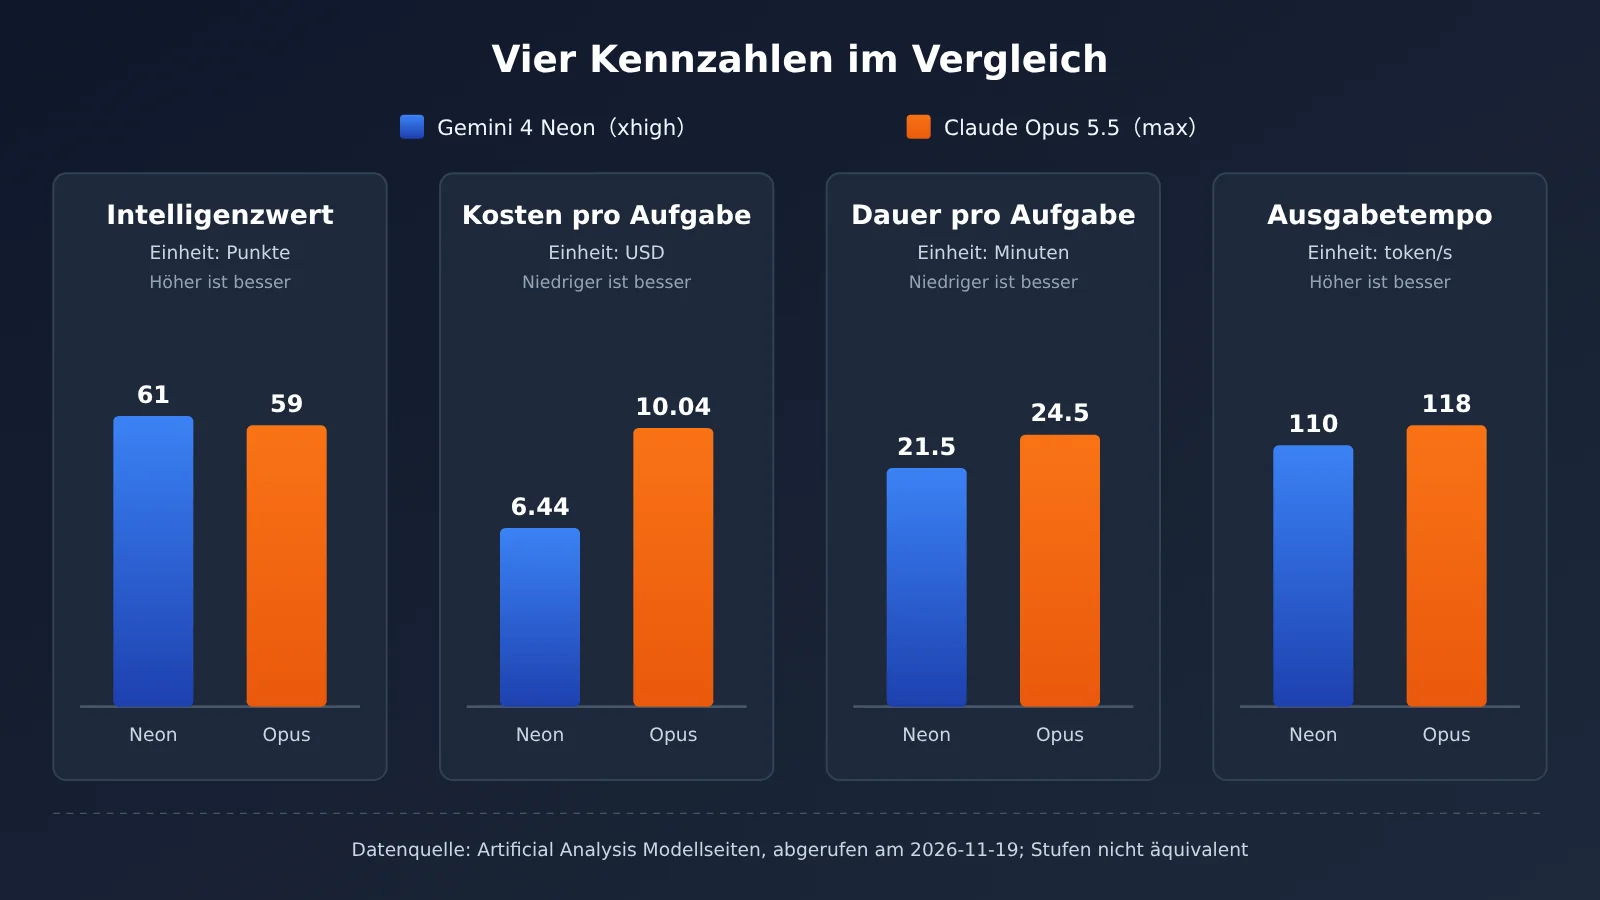
📊 Zum Diagramm: Die Zahlen in der obigen Grafik stammen von der Artificial Analysis Modellseite und spiegeln die Abrechnung des Indexlaufs durch den Dritten wider. Beim Aufruf von Claude Opus 5.5 über APIYI apiyi.com sind die Modellliste und die Listenpreise der Plattform maßgeblich.
Kosten pro Aufgabe: eine Rechnung aus der Rangliste
6,44 US-Dollar gegenüber 10,04 US-Dollar pro Aufgabe – das ist der Betrag, den Artificial Analysis nach dem Durchlauf seines Index errechnet hat. Es handelt sich um eine Zahl aus der Rangliste, nicht um Ihre Rechnung bei APIYI. Dieser Wert hängt sowohl vom Stückpreis als auch vom Verbrauch ab. Laut den Daten auf der Modellseite hat Neon beim Indexlauf 283 Millionen Token ausgegeben, mehr als die 218 Millionen von Opus – doch der Stückpreis liegt bei 3/15 US-Dollar gegenüber 4/20 US-Dollar bei Opus. Ihre tatsächlichen Kosten richten sich nach der Eingabelänge Ihrer Aufgabe, der Ausgabelänge und der Cache-Trefferquote.
Laufzeit, Ausgabegeschwindigkeit und Zeit bis zum ersten Token
Bei der Ausgabegeschwindigkeit liegt Opus vorn: 118 gegenüber 110 Token/Sekunde. Die Laufzeit pro Aufgabe ist dagegen bei Neon kürzer: 21,5 gegenüber 24,5 Minuten. Die beiden Zahlenpaare widersprechen sich nicht, denn die Laufzeit umfasst auch das Warten auf das erste Token und die gesamte Ausgabemenge. Laut Modellseite beträgt die Zeit bis zum ersten Antwort-Token bei Opus max 335,85 Sekunden, bei Neon xhigh 56,51 Sekunden. In interaktiven Szenarien wirkt sich die Zeit bis zum ersten Token stärker auf das Nutzererlebnis aus als der Durchsatz.
Vergleich auf gleicher Stufe und Coding-Score
Senkt man die Stufe ab, ändern sich auch die Zahlen auf der Modellseite. Neon high liegt bei 60 Punkten, 14.8 Minuten und 101 Token/Sekunde, Opus xhigh bei 57 Punkten, 16.1 Minuten und 107 Token/Sekunde, Opus high bei 52 Punkten, 9.3 Minuten und 108 Token/Sekunde. Bei Neon beträgt die Zeit bis zum ersten Token über die drei Stufen high, medium und low 40.64 Sekunden, 20.14 Sekunden und 13.93 Sekunden. Diese Zahlen stammen aus den FAQ der Modellseite und stehen nicht in derselben Spalte wie die Übersichtstabelle oben.
Beim Coding nennt der Artificial-Analysis-Artikel einen Coding Agent Index: Neon xhigh kommt in der Antigravity CLI auf 59, Opus 5.5 max in Claude Code auf 58 – die beiden laufen in unterschiedlichen CLIs. Im Google-Blog steht 58.6, das ist eine Selbstauskunft des Anbieters und eine andere Zahl als die 59 im Artikel. Derselbe Artikel nennt außerdem die Kosten pro Coding-Aufgabe: 6.86 US-Dollar für Neon, 12.61 US-Dollar für Opus 5.5 max.
Szenario-Empfehlungen für Gemini 4 Neon und Claude Opus 5.5
Die folgenden Einschätzungen stützen sich auf die obigen Zahlen. Es sind Empfehlungen, keine Tatsachen. Bitte prüfen Sie sie anhand Ihrer eigenen Aufgabenbeispiele nach.
Szenarien, in denen Gemini 4 Neon tendenziell die bessere Wahl ist
- Audio und Video direkt als Eingabe: Laut Modellkarte unterstützt Neon Audio und Video, Opus nimmt Text und Bilder als Eingabe.
- Retrieval-Reasoning über sehr lange Kontexte: GraphWalks 95.2% gegenüber 66.8%, Neons einheitliches Kontextfenster umfasst bis zu 1048576 Token (Google-Cloud-Entwicklerhandbuch).
- Automatisierung von Geschäftsprozessen und Knowledge-Work-Agenten: AutomationBench 56.3% gegenüber 42.5%, Agents‘ Last Exam v1.1 75.8% gegenüber 71.6% (Modellkarte).
- Interaktionen, die empfindlich auf die Wartezeit bis zum ersten Token reagieren: Laut der Artificial-Analysis-Modellseite liegt Neon xhigh bei 56.51 Sekunden bis zum ersten Token, Opus max bei 335.85 Sekunden.
Szenarien, in denen Sie besser bei Claude Opus 5.5 bleiben
- Coding rund um Terminal-Operationen: Terminal-bench 4.1 steht bei 65.8% gegenüber 65.2% (Modellkarte).
- Code-Aufgaben im Stil von FrontierCode: 47.3% gegenüber 46.2% (Modellkarte, bei Neon ist high die Standardstufe).
- Durchsatz bei langen Ausgaben: Ausgabegeschwindigkeit 118 gegenüber 110 Token/Sekunde (Artificial-Analysis-Modellseite).
- Workflows, die bereits tief in Claude Code oder den messages-Endpunkt eingebunden sind: Die Migrationskosten müssen mitgerechnet werden.
So ruft man Claude Opus 5.5 bei APIYI auf und prüft den Status von Gemini 4 Neon
Modell-IDs und Preise von Claude Opus 5.5 bei APIYI
Wer bereits mit Opus arbeitet, kann bei APIYI (apiyi.com) mit demselben Key Modell-IDs und Preise abgleichen. Die Übersichtstabelle von APIYI, docs.apiyi.com/models.md, nennt als Aktualisierungszeitpunkt den 2026-11-16 09:39 (UTC+8). Die Preis-API api.apiyi.com/api/pricing wurde am 2026-11-19 abgefragt, Version shell-api-modelmak-v1, insgesamt 285 Modelle.
| Modell-ID | Eingabe / Cache-Lesen / Ausgabe (USD pro Million Token) | Endpoint | Gruppe (APIYI-Übersicht) | Gruppen-ID (Preis-API) |
|---|---|---|---|---|
claude-opus-5-5 |
4 / 0.2 / 20 | chat, messages | ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
claude-opus-5-5-thinking |
4 / 0.2 / 20 | chat, messages | wie oben | wie oben |
gemini-4-neon |
nicht verfügbar | — | — | — |
Die Gruppennamen stimmen in beiden Quellen nicht ganz überein, deshalb sind in der Tabelle beide Schreibweisen erhalten. In der Preis-API entspricht model_ratio = 1 einem Eingabepreis von 2 USD pro Million Token, und completion_ratio = 5 bedeutet, dass der Ausgabepreis das Fünffache des Eingabepreises beträgt. Das deckt sich mit der Schreibweise der ersten Stufe in der Übersichtstabelle, sodass ihr die Preise oben mit dieser Regel selbst nachrechnen könnt.
Weder in der APIYI-Übersichtstabelle noch in der Preis-API findet sich gemini-4-neon, auch keine eigene Modellseite dafür. Das Modell ist derzeit noch nicht verfügbar; wir bringen es so bald wie möglich online. Maßgeblich für Modell-IDs und Preise ist die Modellliste der Plattform. Zum Vergleich: Die Preisseite von Google AI Studio nennt für Neon als kostenpflichtige Preise 3,00 USD für Eingabe, 15,00 USD für Ausgabe (einschließlich Thinking-Tokens) und 0,15 USD für Caching, jeweils pro Million Token. Es gibt keine kostenlose Stufe, und nur implizites Caching wird unterstützt.
Aufrufschritte
- Legt den Schlüssel in einer Umgebungsvariable ab, zum Beispiel
APIYI_API_KEY. Der Code liest ausschließlich die Umgebungsvariable und enthält keinen Klartext. - Bei einem OpenAI-kompatiblen Client setzt ihr
base_urlaufhttps://api.apiyi.com/v1. - Ins Feld
modelkommtclaude-opus-5-5oderclaude-opus-5-5-thinking; den Endpoint wählt ihr je nach Bedarf als chat oder messages. - Wählt die Gruppe passend zu eurem Anwendungsfall. Maßgeblich für die Gruppennamen sind die Schreibweisen in der Übersichtstabelle und in der Preis-API.
- Wenn ihr nach der Verfügbarkeit von Neon Vergleichstests macht, beachtet: Der Entwicklerleitfaden von Google Cloud gibt an, dass es nur die Thinking-Stufen low, medium, high und xhigh gibt, Standard ist high. Wird
thinking_budgetoderMINIMALübergeben, antwortet der Dienst mit HTTP400. Explizites Context-Caching wird nicht unterstützt; implizites Caching greift automatisch für gemeinsame Prefixe ab 4096 Token.
🚀 Schnellstart: Fahrt zuerst mit einem Dutzend eigener echter Aufgaben eine Baseline auf Opus und notiert dabei Ausgabe-Tokens und Laufzeit. Sobald Neon bei APIYI (apiyi.com) verfügbar ist, vergleicht mit derselben Stichprobe und derselben Thinking-Stufe – so erhaltet ihr Zahlen, die zu eurem eigenen Geschäft passen.
Entscheidungsempfehlung zu Gemini 4 Neon und Claude Opus 5.5
💡 Empfehlung: Wenn Ihre Arbeit überwiegend aus Terminal- und Code-Aufgaben besteht, sind die Unterschiede in den Modellkarten und bei Artificial Analysis sehr gering; Opus liegt bei Terminal-bench 4.1 und FrontierCode 2.0 etwas höher, es gibt keinen klaren Grund zu wechseln. Wenn Ihre Arbeit eher in Richtung Wissensorganisation, langes Kontextfenster und multimodale Eingaben geht, liegt Neon bei den meisten Unterkategorien der Modellkarte vorn, und es lohnt sich, es nach der Veröffentlichung so bald wie möglich vergleichend zu testen. Das ist eine Einschätzung, keine Tatsache.
Was die Kosten angeht, sollten Sie die 6,44 und 10,04 US-Dollar von Artificial Analysis nicht direkt für die Budgetplanung heranziehen. Übertragen Sie auch nicht den Satz aus dem Google-Blog – „Die Standard-high-Kosten pro Aufgabe liegen 32 % niedriger als bei Carbon“ – auf Opus; das ist Googles eigene Rechnung, und der Vergleichsgegenstand ist nicht Opus.
Häufig gestellte Fragen (FAQ)
F1: Wie ist Gemini 4 Neon positioniert?
Laut Google-Blog (offizielle Selbstauskunft) und Google-Cloud-Entwicklerleitfaden liegt Neon zwischen Hydrogen (schnelle alltägliche Ausführung) und Carbon (komplexe, langfristige Aufgaben) und richtet sich an hochfrequente, komplexe Abläufe. In der Modellkarte steht, dass es von Gemini 4 Carbon abgeleitet ist und der Wissensstand bei März 2026 liegt.
F2: Wer hat beim Coding die höheren Zahlen – Gemini 4 Neon oder Claude Opus 5.5?
Das muss man getrennt betrachten. In der Modellkarte liegt Opus bei Terminal-bench 4.1 (65,8 % gegenüber 65,2 %) und FrontierCode 2.0 (47,3 % gegenüber 46,2 %) vorn, Neon liegt bei CursorBench 4.1 und SWE-sweep vorn. Der Coding Agent Index im Artificial-Analysis-Artikel liegt bei 59 zu 58, allerdings laufen beide in unterschiedlichen CLIs.
F3: Sind die Intelligenzwerte 61 zu 59 im selben Bereich verglichen?
Nein. Das ist Neon xhigh gegen Opus max, jeweils die höchste Stufe auf der Modellseite. Vergleicht man Neon high (60) mit Opus xhigh (57), ändert sich der Abstand. Der Intelligenzwert 61 ist im Google-Blog, in der Modellkarte und bei Artificial Analysis konsistent.
F4: Kann ich die Kosten von 6,44 USD gegenüber 10,04 USD pro Aufgabe als meine Rechnung ansehen?
Nein. Das sind die Leaderboard-Kosten aus dem Index-Lauf von Artificial Analysis und hängen von deren Aufgabensatz und der Output-Token-Menge ab. Die tatsächliche Rechnung richtet sich nach deinem eigenen Input-, Output- und Cache-Verbrauch sowie nach den Preisen der Plattform. Bei APIYI apiyi.com liegt der Listenpreis für Opus bei 4 USD Input, 0,2 USD Cache-Read und 20 USD Output (pro Million Token).
F5: Kann ich Gemini 4 Neon jetzt schon bei APIYI aufrufen?
Weder in der APIYI-Übersichtstabelle (Stand 2026-11-16) noch in der Preis-Schnittstelle (abgerufen am 2026-11-19) gibt es `gemini-4-neon`. Das Modell ist noch nicht gelistet; wir werden es so schnell wie möglich aufnehmen. Modellbezeichnung und Preise gelten gemäß der Modellliste der Plattform. Vorerst kannst du auf apiyi.com mit `claude-opus-5-5` Baseline-Samples laufen lassen, um dich auf den späteren Vergleich vorzubereiten.
F6: Warum ist Opus bei der Output-Geschwindigkeit schneller, braucht aber pro Aufgabe länger?
Die Dauer enthält die Wartezeit auf das erste Token. Laut der Modellseite von Artificial Analysis beträgt das erste Antwort-Token bei Opus max 335,85 Sekunden, bei Neon xhigh 56,51 Sekunden. Die Output-Geschwindigkeit spiegelt nur den Durchsatz wider, nachdem die Ausgabe begonnen hat.
F7: Welche Einschränkungen haben diese Vergleiche?
Ergebnisse zu Nicht-Gemini-Modellen in der Modellkarte stammen standardmäßig aus Selbstauskünften der jeweiligen Anbieter. Der Coding Agent Index existiert in zwei Versionen, 58,6 und 59, MKA in zwei Versionen, 56,5 % und 56 % – beide werden hier unverändert wiedergegeben. Die 12,8 % und 39,0 % bei SWE-sweep stammen aus zwei verschiedenen Harnesses. Die Ranglisten und Sicherheitszahlen im Google-Blog sind offizielle Selbstauskünfte und keine unabhängigen Nachmessungen.
Gemini 4 Neon und Claude Opus 5.5: Wichtigste Erkenntnisse
- Beide Modelle liegen bei einzelnen Werten vorn: Neon ist bei den meisten Teilwerten der Modellkarte und beim Intelligenzwert höher, Opus bei zwei Coding-Werten und bei der Ausgabegeschwindigkeit.
- Die Modellkarte ist die offizielle Zusammenfassung: Nicht-Gemini-Ergebnisse sind Selbstauskünfte der jeweiligen Anbieter, keine am selben Tag erneut durchgeführten Tests.
- Die Stufen müssen klar genannt werden: Der Intelligenzwert vergleicht Neon xhigh mit Opus max.
- Die Kosten pro Aufgabe sind die in der Rangliste ausgewiesene Abrechnung: 6.44 USD gegenüber 10.04 USD – das ist nicht die Plattformrechnung.
- Bei den Modalitäten gibt es Unterschiede: Neon kann Audio und Video als Eingabe verarbeiten, Opus nur Text und Bilder.
- Einstieg: Opus ist bei APIYI bereits gelistet, Neon noch nicht – maßgeblich ist die Modellliste der Plattform.
Zusammenfassung
Der Vergleich von Gemini 4 Neon und Claude Opus 5.5 muss getrennt nach Coding und Wissensarbeit betrachtet werden:
- Coding-Linie: Opus liegt bei Terminal-bench 4.1 und FrontierCode 2.0 leicht vorn, Neon bei CursorBench 4.1 und bei SWE-sweep unter demselben Harness.
- Wissensarbeits-Linie: Bei den meisten Teilwerten der Modellkarte liegt Neon vorn; die Unterschiede bei GraphWalks und AutomationBench sind am deutlichsten.
- Die vier Werte von Artificial Analysis: Intelligenzwert 61 gegenüber 59, Kosten pro Aufgabe 6.44 gegenüber 10.04 USD, Laufzeit 21.5 gegenüber 24.5 Minuten, Ausgabegeschwindigkeit 110 gegenüber 118 Token/s; die Stufen sind Neon xhigh gegenüber Opus max.
Es empfiehlt sich, zunächst mit eigenen Aufgabenbeispielen eine Opus-Baseline aufzubauen und nach der Verfügbarkeit von Neon mit derselben Stufe zu vergleichen. Bei APIYI apiyi.com können Sie die Preise und Gruppen für claude-opus-5-5 und claude-opus-5-5-thinking einsehen und mit demselben API-Schlüssel den Aufruf sowie den späteren Wechsel durchführen.
📚 Referenzen
-
Sundar Pichai – Ankündigungspost: Veröffentlichungskanäle für Gemini 4 Neon
- Link:
x.com/sundarpichai/status/2123167780988125621 - Beschreibung: Offiziell angegebener Verfügbarkeitsumfang
- Link:
-
Google-Blog: Introducing Gemini 4 Neon: Offiziell angegebene Benchmark-, Preis- und Sicherheitszahlen
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Beschreibung: Coding Agent Index 58.6, Erläuterungen zum SWE-sweep-Harness
- Link:
-
DeepMind-Modellkarte: Dreispaltige Vergleichstabelle und Bewertungserläuterungen
- Link:
deepmind.google/models/model-cards/gemini-4-neon/ - Beschreibung: Nicht-Gemini-Ergebnisse stammen standardmäßig aus den Selbstangaben der jeweiligen Anbieter
- Link:
-
Google Cloud-Entwicklerleitfaden: Modell-IDs, Denkstufen und Caching-Regeln
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Beschreibung: Auslösebedingungen für HTTP 400
- Link:
-
Google AI Studio-Preisseite: Kostenpflichtige Neon-Preise
- Link:
aistudio.google.com/docs/pricing - Beschreibung: Kein kostenloser Tarif, nur implizites Caching wird unterstützt
- Link:
-
Artificial Analysis-Artikel: Neon-Intelligenzwert und Kosten pro Coding-Aufgabe
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Beschreibung: Messung durch Drittanbieter, Coding Agent Index 59
- Link:
-
Artificial Analysis-Modellseite: Daten zu Neon und Opus 5.5 nach Stufen
- Link:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/claude-opus-5-5 - Beschreibung: Abgerufen am 2026-11-19, Index v5.0.1
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; Modelle und Preise finden Sie im Dokumentationszentrum unter docs.apiyi.com.