Autorenhinweis: In diesem Artikel sind die Gesamtscores von Drittanbietern, die offiziellen Listenpreise, die Cache-Read-Preise und die Verfügbarkeit bei APIYI für GPT-6.2 Sol und Claude Opus 5.5 getrennt aufbereitet – damit Sie das Modell anhand der Aufgabe auswählen und nicht anhand eines einzigen Gesamtscores.
OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Viele Teams arbeiten bereits mit Claude Opus 5.5 und müssen nun entscheiden, ob ein Wechsel sinnvoll ist. Dieser Artikel vergleicht GPT-6.2 Sol und Claude Opus 5.5 und gibt Empfehlungen entlang der Aspekte Gesamtscore, Listenpreis, Cache-Read, Protokoll und aktueller Verfügbarkeit.
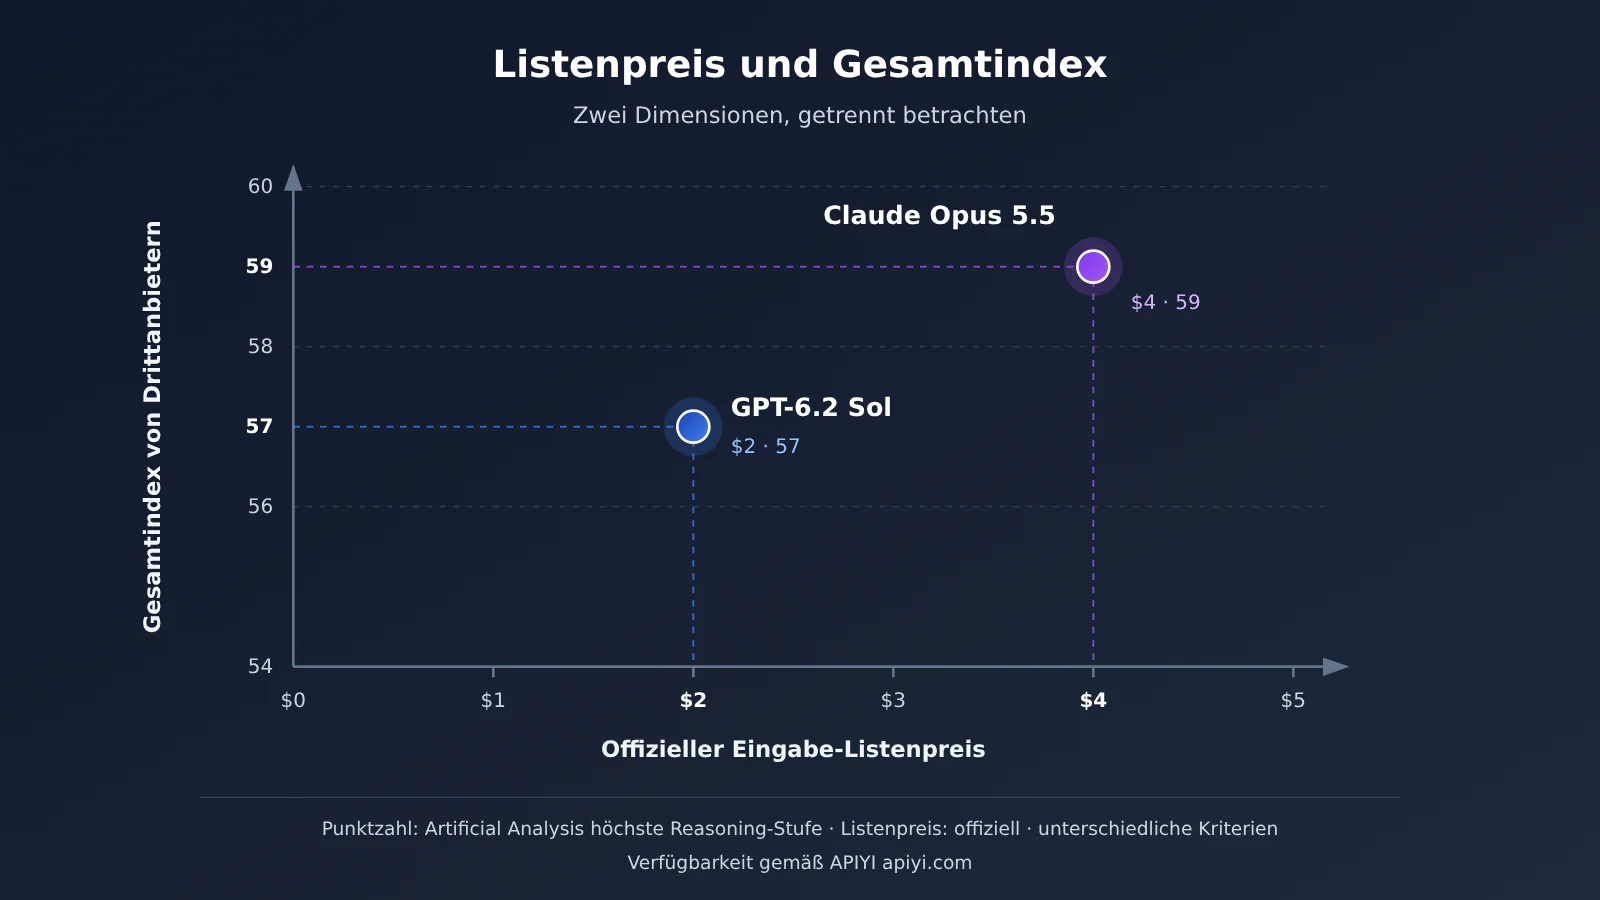
Das hier ist kein Artikel, der verkünden will, welches Modell stärker oder günstiger ist. Im Drittanbieter-Gesamtindex liegt die höchste Variante von Sol 2 Punkte unter der höchsten Variante von Opus. Nach den offiziellen Listenpreisen für kurze Kontexte kostet Sol bei Eingabe, Ausgabe und Cache-Read jeweils rund die Hälfte von Opus. Diese beiden Fakten muss man zusammen betrachten – jede für sich allein reicht als Entscheidungsgrundlage nicht aus.
Kernnutzen: Nach der Lektüre dieses Artikels kennen Sie die Gesamtscores, Listenpreise und Cache-Read-Preise beider Modelle, wissen, welche Zahlen offiziell selbst gemeldet und welche von Drittanbietern gemessen wurden – und welches der beiden Modelle Sie derzeit bei APIYI aufrufen können.
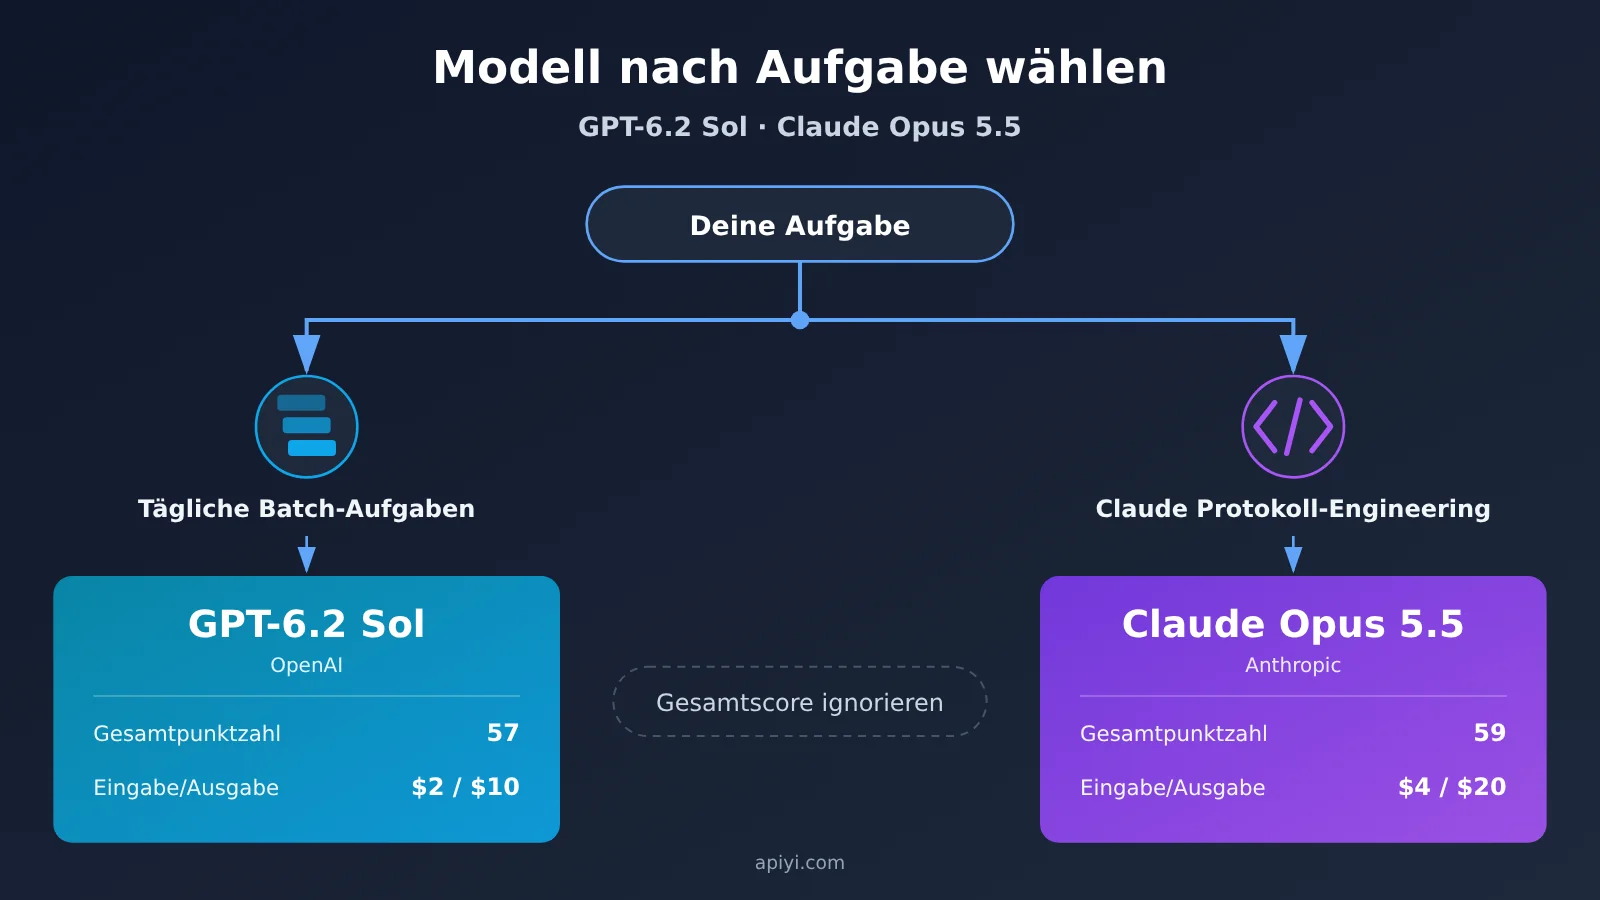
GPT-6.2 Sol und Claude Opus 5.5: Die wichtigsten Unterschiede auf einen Blick
Zuerst die fünf Informationsgruppen, die man bei der Modellauswahl am häufigsten braucht, kompakt in einer Tabelle. Jede Zeile nennt die Quelle der Zahlen – in den folgenden Abschnitten gehen wir jeweils genauer darauf ein.
| Vergleichskriterium | GPT-6.2 Sol | Claude Opus 5.5 | Zahlenquelle |
|---|---|---|---|
| Gesamtscore von Drittanbietern (höchste Reasoning-Stufe) | 57 (Max-Stufe) | 59 (höchste Stufe) | Artificial Analysis, Drittanbieter |
| Offizieller Preis für Eingabe / Ausgabe bei kurzem Kontext | $2 / $10 | $4 / $20 | Offizielle Preise der jeweiligen Anbieter, pro 1 Million Token |
| Preis für Cache-Lesezugriffe | $0.10 | $0.20 | OpenAI-Modellseite; Opus aus der Preisliste von Anthropic übernommen |
| Kontextfenster / maximale Ausgabe | 1,050,000 / 128,000 | 1M / 128K | Offizielle Modellseiten und Dokumentation |
| Aktueller Status bei APIYI | Noch nicht gelistet | Verfügbar, claude-opus-5-5 |
Modell-Gesamtübersicht und Pricing-API von APIYI |
2 Punkte weniger im Gesamtscore und rund halber Listenpreis – warum beides zusammen betrachten?
Wer nur auf den Gesamtscore schaut, kommt zu dem Schluss „Opus liegt vorn“; wer nur auf den Listenpreis schaut, zu dem Schluss „Sol ist pro Token günstiger“. Beide Schlüsse sind nicht falsch – aber jeder erzählt nur die halbe Geschichte. Der Gesamtscore gibt die durchschnittliche Leistung über einen Mix verschiedener Aufgaben wieder, der Listenpreis den Preis pro 1 Million Token. Wie hoch deine echte Rechnung am Ende ausfällt, hängt davon ab, wie viele Token jede einzelne Aufgabe verbraucht.
Außerdem stammt der Abstand von 2 Punkten aus Tests von Artificial Analysis mit der höchsten Reasoning-Stufe. Läuft dein Einsatz mit der Standard-Reasoning-Stufe oder weicht deine Art von Aufgaben stark von den Benchmarks dieses Index ab, lässt sich dieser Vorsprung nicht unbedingt eins zu eins übertragen. Deshalb der Ansatz dieses Artikels: erst die Zahlen sauber auf den Tisch legen, dann anhand des Aufgabentyps entscheiden.
GPT-6.2 Sol und Claude Opus 5.5: Listenpreise und Cache-Read im Vergleich
Bei dieser Modellwahl sind die Preise der Teil, der am häufigsten missverstanden wird. Die folgende Tabelle führt die offiziellen Listenpreise und die Plattformpreise von APIYI getrennt auf; alle Zahlen gelten pro 1 Million Token, standardmäßig in der Standardstufe für kurze Kontexte.
| Preispunkt | GPT-6.2 Sol offizieller Listenpreis | Claude Opus 5.5 offizieller Listenpreis | Claude Opus 5.5 auf APIYI | GPT-6.2 Sol auf APIYI |
|---|---|---|---|---|
| Eingabe | $2 | $4 | $4 | noch nicht gelistet |
| Ausgabe | $10 | $20 | $20 | noch nicht gelistet |
| Cache-Read | $0.10 | $0.20 | $0.2 | noch nicht gelistet |
| Cache-Write | 30 Minuten $2.50; 12 Stunden $5 | 5 Minuten $5; 1 Stunde $8 (Preisangabe laut Zitat) | gemäß Plattformliste | noch nicht gelistet |
| Regel für sehr lange Eingaben | ab 272K Aufschlag auf den ganzen Auftrag | in den Quellen nicht abgedeckt | gemäß Plattformliste | noch nicht gelistet |
Der offizielle Listenpreis von GPT-6.2 Sol für kurze Kontexte liegt bei $2 für die Eingabe, $10 für die Ausgabe und $0.10 für Cache-Read. Laut Ankündigungstext übernimmt das Modell die API-Token-Preise von GPT-6.1 Sol. Auf APIYI ist GPT-6.2 Sol noch nicht gelistet – wir werden das Modell so bald wie möglich verfügbar machen. Modellbezeichnung und Preise richten sich nach der Modellliste der Plattform.
Die offiziellen Listenpreise von Claude Opus 5.5 liegen bei $4 für die Eingabe und $20 für die Ausgabe. Der Cache-Read-Preis von $0.20 und die Cache-Write-Preise (5 Minuten $5, 1 Stunde $8) stammen aus einer Wiedergabe der Anthropic-Preisliste; beim Schreibpreis gilt die offizielle Anthropic-Seite als maßgeblich. In der APIYI-Gesamttabelle (Datenstand 2026-11-17 15:54 Uhr, UTC+8) sind sowohl claude-opus-5-5 als auch claude-opus-5-5-thinking gelistet, mit Plattformpreisen von $4 / $20 / $0.2. Diese Positionen können Sie direkt in der Modellliste auf APIYI unter apiyi.com nachprüfen.
Ein wichtiger Hinweis: Die in der APIYI-Gesamttabelle derzeit sichtbaren Modelle gpt-6.1-sol ($2 / $10 / $0.1) und gpt-6-sol ($2 / $10 / $0.2) sind beide nicht die Version 6.2. Ihre Preise dürfen nicht als Plattformpreise von GPT-6.2 Sol betrachtet werden und geben auch keinen Aufschluss über die Fähigkeiten von 6.2.
GPT-6.2 Sol: Die 272K-Regel zur Abrechnung der gesamten Anfrage
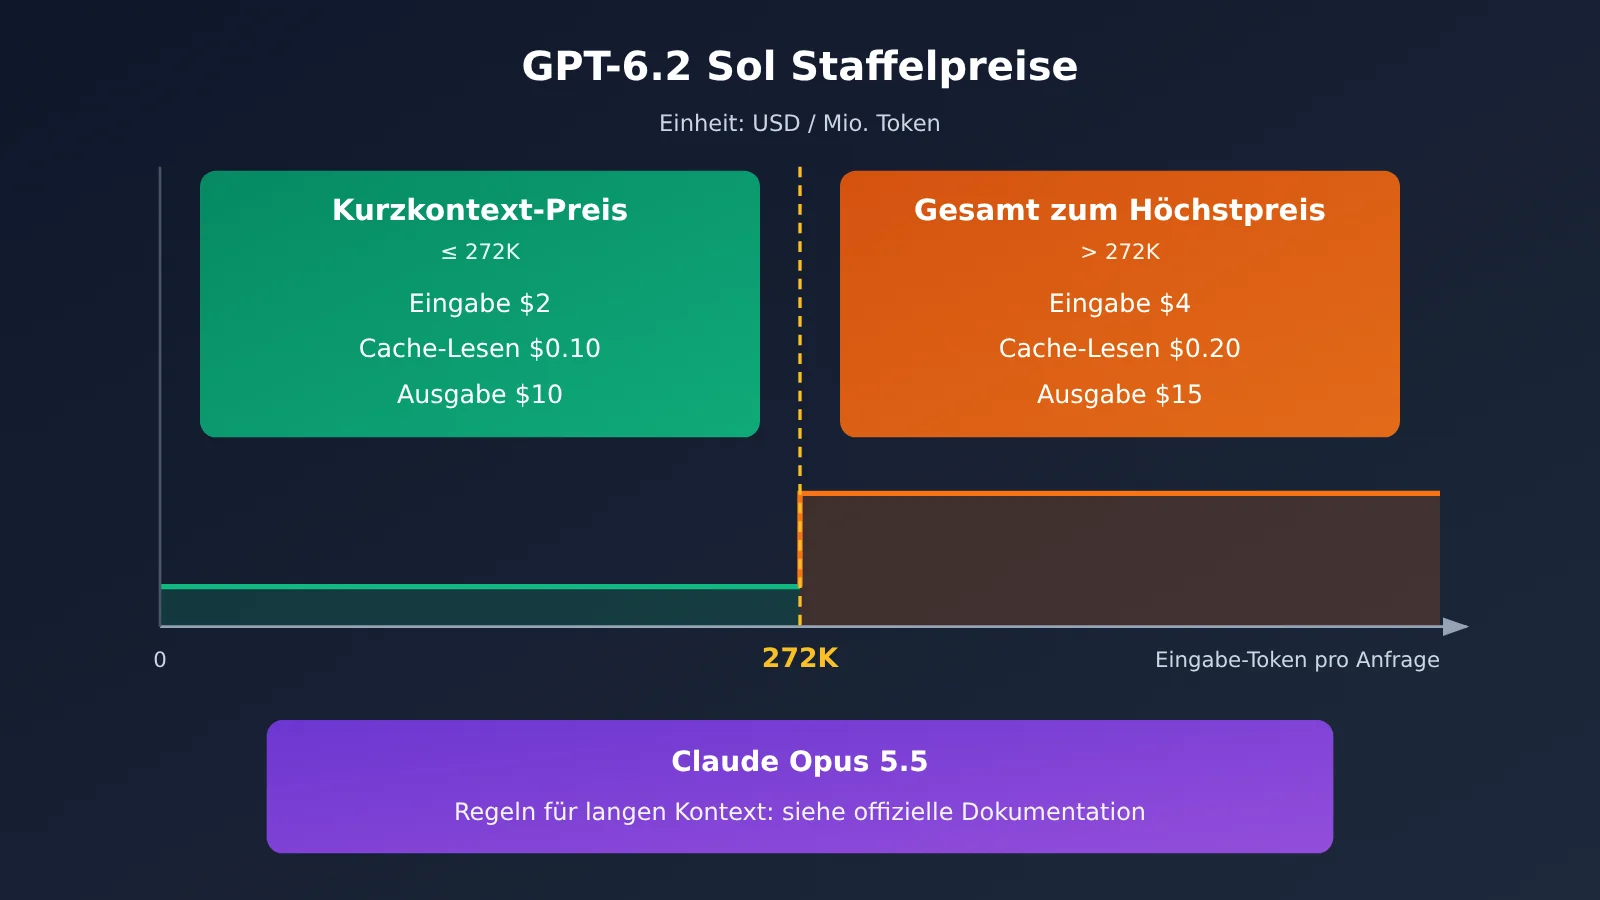
Auf der OpenAI-Modellseite heißt es: Liegt die Eingabe einer einzelnen Anfrage über 272K Token, verdoppeln sich die Einheitspreise für Eingabe und Cache, und die Ausgabe wird mit dem 1,5-Fachen des Kurzkontext-Preises berechnet. Entscheidend ist: Die komplette Anfrage wird dann zu den neuen Preisen abgerechnet – nicht nur der Teil, der die Grenze überschreitet. Umgerechnet auf Sol heißt das: $4 für die Eingabe, $0.20 für Cache-Lesezugriffe und $15 für die Ausgabe.
Diese Regel macht sich bei Aufgaben mit langen Dokumenten deutlich bemerkbar. Wenn deine typischen Anfragen häufig in der Nähe von 272K liegen, schrumpft der Listenpreis-Vorteil von „etwa der Hälfte“ spürbar. Ob es bei Opus 5.5 eine vergleichbare Regel für lange Kontexte gibt, decken die diesem Artikel zugrunde liegenden Quellen nicht ab – schau am besten direkt in der Anthropic-Dokumentation nach, bevor du die beiden vergleichst.
Abgesehen davon kostet Sols Batch 50 % des Standardpreises, während Fast das Doppelte des Standardpreises für dieselbe Kontextlänge kostet. Ultrafast kostet bis zum 28.02.2027 (Pazifische Zeit) das Dreifache des Standardpreises, ab dem 01.03.2027 das Sechsfache.
Beispielrechnung für eine einzelne Anfrage auf Basis der Listenpreise
Zur Veranschaulichung folgt eine rein mathematische Beispielrechnung nach den offiziellen Listenpreisen – sie entspricht keiner realen Abrechnung. Angenommen, eine Anfrage umfasst 100.000 Token Eingabe und 10.000 Token Ausgabe, ohne Cache-Nutzung: Sol landet bei etwa $0.20 + $0.10 = $0.30, Opus bei etwa $0.40 + $0.20 = $0.60.
Diese Rechnung steht auf zwei Annahmen: Beide Modelle verbrauchen für dieselbe Aufgabe gleich viele Token, und die Anfrage überschreitet 272K nicht. In der Praxis hängt der Verbrauch der Reasoning-Token von Modell, Reasoning-Aufwand und Aufgabe ab – die echten Kosten kennst du also erst, wenn du deine eigene Aufgabe einmal durchlaufen lässt und nachrechnest.
GPT-6.2 Sol und Claude Opus 5.5: Leistungszahlen – zwei Methodiken getrennt lesen
Die Leistungszahlen stammen aus zwei Quellen: zum einen aus dem unabhängigen Benchmark von Artificial Analysis, zum anderen aus den offiziellen Eigenangaben in OpenAIs Ankündigungsbeiträgen und auf den Modellseiten. Die beiden Datensätze unterscheiden sich in Aufgaben, Reasoning-Stufen und Kostenmethodik – deshalb werden sie im Folgenden getrennt aufgeführt und nicht zu einem einzigen Fazit verschmolzen.
Unabhängiger Gesamtindex von Artificial Analysis (Intelligence Index v5.0.1)
| Modell und Reasoning-Stufe | Gesamtindex | Kosten pro Aufgabe im Gesamtindex | Hinweis |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 57 | $1.01 | 2 Punkte über GPT-6.1 Sol |
| GPT-6.2 Sol (Xhigh) | 56 | nicht separat ausgewiesen | Drittquelle |
| GPT-6.2 Sol (High) | 55 | nicht separat ausgewiesen | Drittquelle |
| GPT-6.2 Sol (Medium) | 53 | nicht separat ausgewiesen | Drittquelle |
| GPT-6.2 Sol (Low) | 41 | nicht separat ausgewiesen | Drittquelle |
| Claude Opus 5.5 (höchste Stufe) | 59 | in den Quellen nicht abgedeckt | aus demselben Artikel |
Die $1.01 von Sol sind lediglich die durchschnittlichen Kosten, die in diesem Gesamtindex für eine Aufgabe anfallen – kein Einheitspreis für alle Aufgaben und auch nicht dafür gedacht, mit Kostenzahlen aus anderen Quellen verrechnet zu werden. Zu den Kosten pro Aufgabe von Opus 5.5 in diesem Index enthalten die Referenzquellen keine Angabe; dieser Artikel nimmt deshalb keine Hochrechnung vor.
Derselbe unabhängige Artikel nennt noch einige bemerkenswerte Einzelergebnisse. Im Coding Agent Index (Codex harness, Max) liegt Sol 3 Punkte unter GPT-6.1 Sol – der Hauptgrund sind 14 Punkte weniger bei SWE-Atlas-QnA-AA, wodurch wichtige Fakten leichter übersehen werden. Bei AA-Omniscience (Max) liegt Sols Halluzinationsrate bei 55 %. In der Research Preview von AA-Robotics v0.1 erreicht Sol 78. Für diese Einzelkennzahlen fehlen Vergleichswerte zu Opus 5.5 – sie eignen sich also nur dazu, Sols eigene Stärken und Schwächen einzuordnen.
Offizielle Selbstangaben von OpenAI zu GPT-6.2 Sol
Die folgenden Zahlen stammen sämtlich aus OpenAIs Veröffentlichung – es sind also offizielle Selbstangaben, bei denen meist OpenAIs eigene Modelle als Vergleich dienen, nicht Claude Opus 5.5:
- FrontierCode 2.0 (von Cognition entwickelt; prüft, ob Änderungen an echten Codebasen von den Maintainern gemergt werden): Sol und GPT-6.2 Astra liegen weniger als 0,5 Punkte auseinander, bei etwa einem Fünftel der Kosten – beide mit der Max-Stufe.
- LifeVal (ein von OpenAI selbst erstellter Satz Alltagsaufgaben): Sol schneidet besser ab als GPT-6 Astra, bei etwa einem Siebtel der Kosten.
- GDPval v2 (offizielle interne Evaluierung): Sol liegt 5,3 Punkte über GPT-6.1 Sol.
- AA-3D-Elo aus menschlichen Blindbewertungen (laut offizieller Angabe): Sol erreicht 1259.
Warum sich die beiden Zahlensets nicht zusammenrechnen lassen
Der Gesamtindex von Drittanbietern basiert auf einer festen Aufgabengruppe, die mit der höchsten Reasoning-Stufe durchlaufen wird; die offiziellen Selbstangaben sind dagegen meist relative Aussagen der Art „um wie viel besser als die Vorgängergeneration“ oder „ein Bruchteil der Kosten“. Benchmarks, Reasoning-Stufen und Kostenberechnung unterscheiden sich in beiden Fällen. Wer „im Gesamtscore 2 Punkte niedriger“ und „bei einem offiziellen Test nahe an Astra“ einfach aneinanderklebt, kann daraus nicht ableiten, dass „Sol insgesamt stärker“ oder „Opus insgesamt stärker“ ist.
Die praktischere Lesart lautet: Der Drittanbieter-Gesamtscore zeigt dir, wo die beiden Modelle bei gemischten Allzweck-Aufgaben ungefähr stehen; die offiziellen Selbstangaben verraten dir, in welchen Szenarien OpenAI Sol gezielt optimiert hat – etwa bei Alltagsaufgaben und Aufgaben rund ums Code-Mergen. Letztlich zählt aber weiterhin, wie die Modelle bei deinen eigenen Aufgaben abschneiden.
GPT-6.2 Sol und Claude Opus 5.5: Spezifikations- und Protokollunterschiede
Neben Benchmark-Werten und Preisen entscheidet vor allem die Anbindung darüber, ob sich ein Modell sofort umstellen lässt. Die folgende Tabelle zeigt die Unterschiede bei Spezifikationen und Endpoints beider Modelle.
| Spezifikation | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Eingabemodalitäten | Text, Bilder (kein Audio, kein Video) | In den Referenzquellen nicht separat aufgeführt |
| Kontextfenster | 1.050.000 (maximale Eingabe 922.000) | 1M |
| Maximale Ausgabe | 128.000 | 128K |
| Wissensstand | 2026-06-01 | 2026-06 |
| Reasoning-Intensität | Unterstützt Reasoning-Tokens; die API erlaubt nicht, effort auf none zu setzen | Standardwert für effort ist medium |
| Offizielle Endpoints | Chat Completions, Responses, Batch | Anthropic Messages |
| APIYI-Endpoints | Derzeit noch nicht verfügbar | chat, messages |
Wenn deine Toolchain auf das Messages-Protokoll von Claude setzt – etwa bei Claude Code oder einem Agenten auf Basis des Anthropic SDK –, bietet APIYI für Opus 5.5 sowohl den chat- als auch den messages-Endpoint an. Die Gruppen umfassen ClaudeCode, Claude_Reverse, Claude_Enterprise, Default und SVIP. Der Wechselaufwand beschränkt sich im Wesentlichen darauf, die base URL und den API-Schlüssel anzupassen.
GPT-6.2 Sol hingegen setzt auf OpenAIs Chat Completions und Responses. Auf der offiziellen Modellseite ist ausdrücklich vermerkt, dass Realtime, Assistants, Fine-Tuning, Bilderzeugung, Video und Sprache nicht unterstützt werden – diese Anforderungen deckt das Modell also nicht ab.
Szenario-Empfehlungen für GPT-6.2 Sol und Claude Opus 5.5
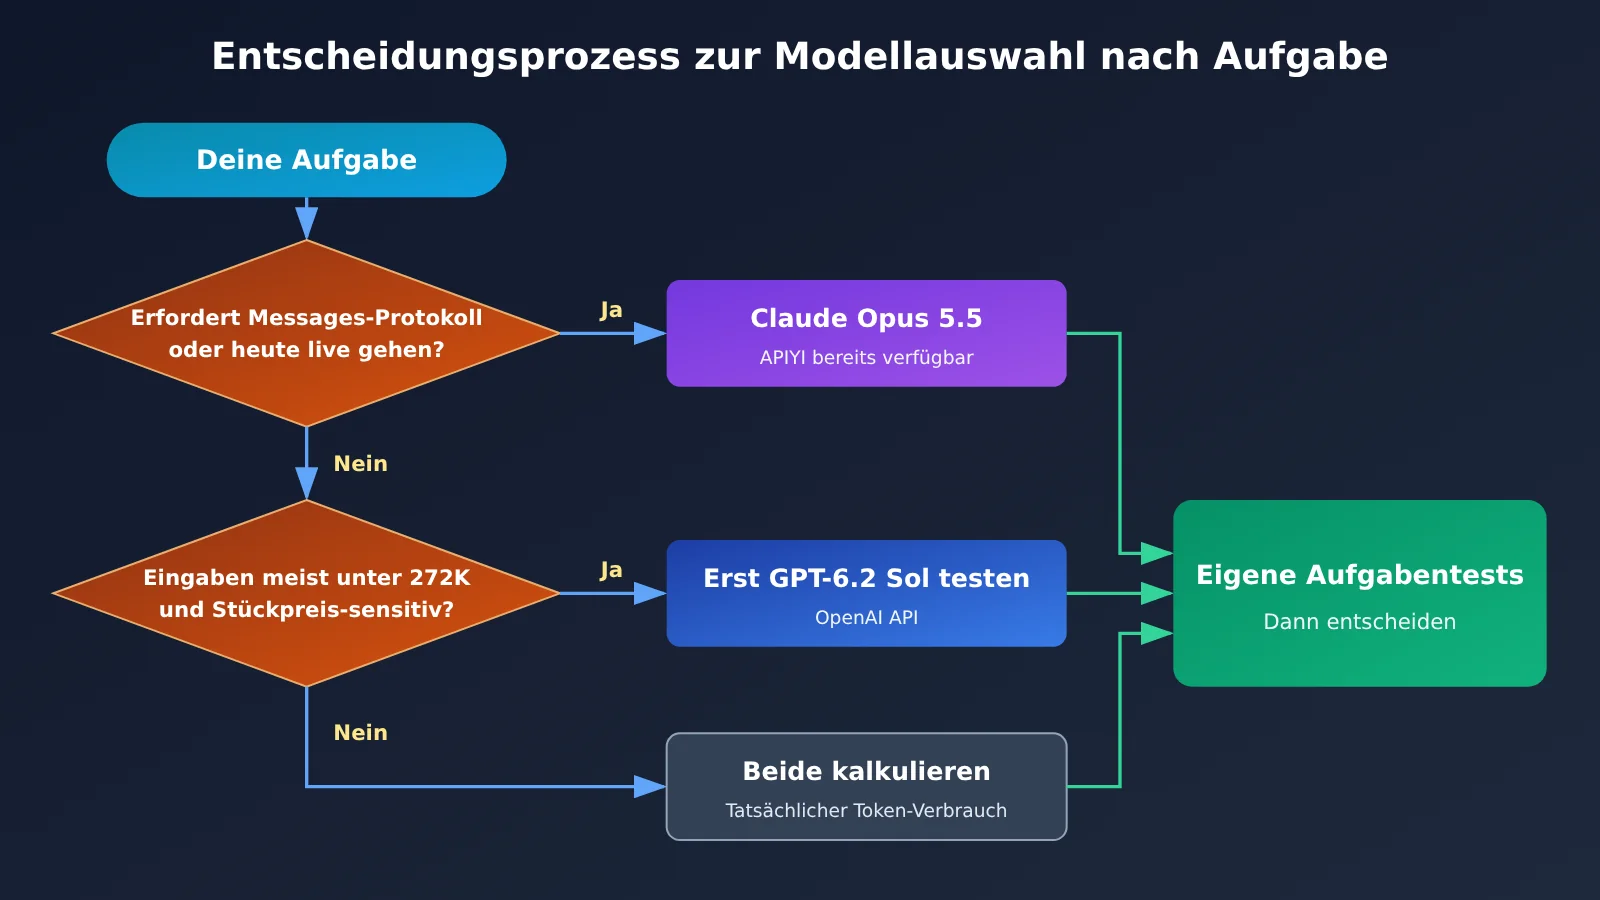
Die Auswahl nach Aufgabe ist verlässlicher als die Auswahl nach Gesamtpunktzahl. Im Folgenden erläutern wir zwei Szenariotypen und fassen zum Schluss alles in einer Tabelle zusammen.
Szenarien, in denen Claude Opus 5.5 die richtige Wahl ist
- Claude-Protokoll erforderlich: Dein bestehender Code basiert auf Anthropic Messages, oder du nutzt Tools wie Claude Code – der Anpassungsaufwand für einen Protokollwechsel übersteigt die Differenz beim Stückpreis.
- Sofortiger Go-Live: Opus 5.5 ist bei APIYI bereits gelistet und lässt sich sofort anbinden, ohne auf das Erscheinen eines neuen Modells zu warten.
- Gesamtpunktzahl als hartes Kriterium: Deine Aufgabe liegt nah an gemischten Allgemein-Benchmarks, und die 2 Punkte in der höchsten Reasoning-Stufe wirken sich tatsächlich auf das Ergebnis aus.
Szenarien, in denen GPT-6.2 Sol zuerst geprüft werden sollte
- Preisempfindliche alltägliche Batch-Aufgaben: Der offizielle Listenpreis für kurze Kontexte liegt bei etwa der Hälfte von Opus, und auch Cache-Lesevorgänge kosten die Hälfte – ideal für Szenarien mit hoher Anfragefrequenz und starker Wiederverwendung von Eingabeaufforderungen.
- Anfragen meist unter 272K: Nur so profitierst du zuverlässig vom Kurzkontext-Preis und vermeidest den Aufschlag auf die gesamte Anfrage.
- Bereits im OpenAI-Protokoll-Ökosystem: Mit Responses oder Chat Completions sind die Anpassungen für die Migration minimal.
Zu beachten ist: „Sol zuerst prüfen“ heißt nicht, dass Sol die höhere Gesamtpunktzahl hat – die Zahlen von Drittparteien zeigen genau das Gegenteil. Gemeint ist: In preisempfindlichen Szenarien mit eher alltäglichen Aufgaben lohnt es sich, die eigenen Aufgaben zunächst einmal mit Sol durchlaufen zu lassen.
| Aufgabentyp | Bevorzugte Wahl | Wichtigster Grund | Verfügbare Plattform |
|---|---|---|---|
| Engineering-Aufgaben mit Claude Code / Messages-Protokoll | Claude Opus 5.5 | Protokoll-nativ, keine Anpassungen nötig | APIYI apiyi.com, bereits gelistet |
| Produktivaufgaben, die sofort online gehen müssen | Claude Opus 5.5 | derzeit abrufbar | APIYI, bereits gelistet |
| Häufige Alltagsaufgaben mit Wiederverwendung des Eingabeaufforderungs-Cache | GPT-6.2 Sol | Offizielle Listenpreise für Eingabe, Ausgabe und Cache-Lesen jeweils etwa halb so hoch | OpenAI API; bei APIYI noch nicht gelistet |
| Langdokumenten-Aufgaben über 272K | Beide Modelle anhand des tatsächlichen Token-Verbrauchs kalkulieren | Sol hat eine Aufschlagsregel für die gesamte Anfrage | Maßgeblich ist die Modellliste der jeweiligen Plattform |
| Q&A-Szenarien, in denen übersehene Kernfakten kritisch sind | Zuerst gezielte Evaluation durchführen | Sol zeigt bei SWE-Atlas-QnA-AA einen Rückgang (Drittanbieter-Zahlen) | Maßgeblich ist die Modellliste der jeweiligen Plattform |
GPT-6.2 Sol und Claude Opus 5.5: Schneller Einstieg
Derzeit lässt sich Claude Opus 5.5 direkt über APIYI aufrufen. Die Einbindung läuft in folgenden Schritten ab – es sind ausschließlich Konfigurationsänderungen nötig, keine zusätzlichen Abhängigkeiten:
- Registrieren Sie sich bei APIYI und erstellen Sie einen API-Schlüssel; neue Nutzer erhalten ein kostenloses Testguthaben.
- Setzen Sie die Base URL Ihres Clients auf
https://api.apiyi.com/v1– das ist die Adresse der OpenAI-kompatiblen Schnittstelle. - Tragen Sie als Modellnamen
claude-opus-5-5ein; wenn Sie einen expliziten Denkprozess (Thinking) benötigen, weichen Sie aufclaude-opus-5-5-thinkingaus. - Verwenden Sie einen Client im Anthropic-Stil, läuft die Anfrage direkt über den messages-Endpunkt; mit dem OpenAI SDK nutzen Sie den chat-Endpunkt.
- Führen Sie mit 5 bis 10 echten Geschäftsanfragen eine Evaluierungsrunde durch, notieren Sie die Token-Zahlen für Eingabe, Ausgabe und Cache-Treffer und berechnen Sie daraus anhand der Plattformpreise von $4 / $20 / $0.2 die Kosten pro Aufgabe.
Die Modell-ID von GPT-6.2 Sol lautet gpt-6.2-sol. Offiziell ist das Modell über die OpenAI API aufrufbar und zudem in ChatGPT Work und Codex für die Tarife Plus, Pro, Enterprise und Edu freigeschaltet. Bei APIYI ist es noch nicht gelistet – wir nehmen es so bald wie möglich ins Angebot auf; maßgeblich für Modelle und Preise ist die Modellliste der Plattform. Bis es so weit ist: Bitte nutzen Sie gpt-6.1-sol nicht als Ersatz für Evaluierungen – es handelt sich nicht um dasselbe Modell.
🚀 Schnellstart: Am besten bringen Sie
claude-opus-5-5zunächst bei APIYI (apiyi.com) mit dem kostenlosen Guthaben zum Laufen und notieren den Token-Verbrauch Ihrer Aufgaben. Sobaldgpt-6.2-solgelistet ist, führen Sie dieselben Anfragen mit derselben Base URL erneut aus und ändern nur den Modellnamen – so lassen sich Kosten und Ergebnisse beider Modelle direkt in einer gemeinsamen Tabelle vergleichen.
Entscheidungsempfehlungen für GPT-6.2 Sol und Claude Opus 5.5
💡 Auswahl-Empfehlung: Wer das Claude-Protokoll braucht und das Modell schon heute aufrufen können möchte, wählt Claude Opus 5.5. Wer dagegen ein Alltagsmodell mit niedrigerem offiziellen Listenpreis sucht, sollte vor allem einen Blick auf GPT-6.2 Sol werfen – aber behaupten Sie nicht, dass sein Gesamtscore höher liegt. Am Ende zählt der Test mit Ihren eigenen Aufgaben: Über die einheitliche Schnittstelle von APIYI (apiyi.com) können beide Modelle denselben Aufrufcode nutzen, und beim Wechsel ändern Sie nur den Modellnamen.
Bei der konkreten Umsetzung sind drei Punkte zu beachten. Erstens: Beim Testen müssen die Reasoning-Stufen beider Modelle aufeinander abgestimmt sein – der Drittanbieter-Gesamtscore basiert auf der höchsten Stufe, während Opus standardmäßig auf „medium“ läuft. Bei unterschiedlichen Stufen ändern sich sowohl die Punktzahl als auch der Token-Verbrauch. Zweitens: Bei Aufgaben mit stabilen Eingabeaufforderungs-Präfixen sollten Sie den Cache mit einrechnen. Der Cache-Lesepreis liegt bei beiden Modellen bei einem Zwanzigstel des Eingabepreises; bei hoher Trefferquote wird die Differenz auf der Rechnung entsprechend vergrößert oder verkleinert. Drittens: Bei langen Dokumenten müssen Sie Szenarien mit mehr als 272K unbedingt separat betrachten.
Häufige Fragen (FAQ)
Q1: Wie sind GPT-6.2 Sol und Claude Opus 5.5 jeweils positioniert?
GPT-6.2 Sol ist ein Modell, das OpenAI am 17. November 2026 veröffentlicht hat. Es nimmt Text und Bilder als Eingabe entgegen und gibt Text aus; das Kontextfenster umfasst 1.050.000 Token. Offiziell wird es als effizientes Modell für alltägliche und echte Arbeitsaufgaben positioniert. Claude Opus 5.5 stammt von Anthropic und bietet ein Kontextfenster von 1M Token, eine maximale Ausgabe von 128K Token sowie medium als Standard-Reasoning-Stufe.
Q2: Welches Modell ist stärker – GPT-6.2 Sol oder Claude Opus 5.5?
Keine einzelne Gesamtpunktzahl beantwortet diese Frage. Im unabhängigen Composite-Index von Artificial Analysis liegt Sols Max-Stufe bei 57, Opus‘ höchste Stufe bei 59. In den offiziellen Eigenangaben punktet Sol bei Projekten wie FrontierCode 2.0 und LifeVal – verglichen wird dort allerdings hauptsächlich mit OpenAIs eigenen Modellen. Unser Tipp: Testen Sie anhand Ihrer konkreten Aufgaben, statt allein nach der Gesamtpunktzahl zu wählen.
Q3: Kann man GPT-6.2 Sol derzeit über APIYI aufrufen?
Noch nicht. Weder in der Gesamtmodellliste von APIYI (Stand: 17.11.2026, 15:54 Uhr, UTC+8) noch in der öffentlichen Preis-API ist `gpt-6.2-sol` enthalten. GPT-6.2 Sol ist aktuell noch nicht gelistet – wir werden das Modell so bald wie möglich verfügbar machen. Maßgeblich für Modellnamen und Preise ist stets die Modellliste der Plattform.
Q4: Welche Preise und Endpunkte gelten für Claude Opus 5.5 bei APIYI?
Sowohl `claude-opus-5-5` als auch `claude-opus-5-5-thinking` sind bereits verfügbar. Die Plattform weist folgende Preise aus: Eingabe $4, Ausgabe $20, Cache-Lesen $0,2 (jeweils pro 1 Million Token). Die Endpunkte unterstützen chat und messages. Mit ein und demselben API-Schlüssel von APIYI (apiyi.com) können Sie das Modell aufrufen; als Base-URL geben Sie `https://api.apiyi.com/v1` an.
Q5: Kann man Sols Kosten von $1,01 pro Aufgabe direkt für die eigene Kalkulation übernehmen?
Nein. Die $1,01 sind die Durchschnittskosten, die Artificial Analysis für die Aufgaben des Composite-Index in der Reasoning-Stufe Max gemessen hat – sie gelten ausschließlich für genau diese Testsuite. Je nach Länge Ihrer Aufgaben und Ihrem Reasoning-Aufwand fallen bei Ihnen andere Kosten an. Die Kosten pro Aufgabe von Opus 5.5 in diesem Index sind in den Unterlagen dieses Artikels nicht erfasst; sie lassen sich also auch nicht heranziehen, um die beiden Werte gegeneinander zu rechnen.
Q6: Wie verhält sich GPT-6.2 Astra zu Sol – und sollte man es ebenfalls in Betracht ziehen?
Astra ist ein weiteres Modell aus derselben Veröffentlichungsrunde. Die offiziellen Preise für den kurzen Kontext betragen: Eingabe $8, Cache-Lesen $0,40, Ausgabe $40; im unabhängigen Composite-Index schneidet es besser ab als Sol. Bei APIYI ist GPT-6.2 Astra derzeit noch nicht gelistet – wir werden das Modell so bald wie möglich verfügbar machen; maßgeblich für Modellnamen und Preise ist die Modellliste der Plattform. Dieser Artikel vergleicht Sol mit Opus 5.5, und Astras Preisklasse liegt nicht auf derselben Stufe.
Q7: Gibt es weitere Modelle in derselben Preisklasse zum Vergleichen?
Einen Blick wert ist Gemini 4 Carbon. APIYI hat `gemini-4-carbon` bereits im Angebot; auf der Plattform-Seite steht als Einführungspreis: Eingabe $2, Cache-Lesen $0,1, Ausgabe $10. Beachten Sie: Die offiziellen Google-Preise ändern sich ab dem 1. Dezember 2026 auf Eingabe $4, Ausgabe $20 und Cache-Lesen $0,20. Diese Preisanpassung ist auf der Plattform-Seite bislang nicht vermerkt – prüfen Sie daher nach dem 1. Dezember bitte die Modellliste auf APIYI (apiyi.com).
Q8: Welche bekannten Einschränkungen gibt es bei GPT-6.2 Sol?
Die offizielle Modellseite weist ausdrücklich darauf hin, dass Audio- und Videoeingaben nicht unterstützt werden – ebenso wenig wie Realtime, Assistants, Fine-Tuning, Bilderzeugung und Sprachausgabe. Die API akzeptiert zudem keine Inferenzstärke von none. Daten von Drittanbietern zeigen, dass GPT-6.2 Sol bei SWE-Atlas-QnA-AA 14 Punkte hinter GPT-6.1 Sol zurückliegt und wichtige Fakten häufiger übersieht. Auch die offiziellen Alignment-Bewertungen erwähnen, dass die 6.2-Serie in zwei Tests seltener auf blockierende Probleme hinweist – etwa fehlende Dateien oder nicht verfügbare Suchwerkzeuge.
GPT-6.2 Sol und Claude Opus 5.5: Die wichtigsten Punkte (Key Takeaways)
- Gesamtwertung: In der höchsten Inferenzstufe der Drittanbieter-Benchmarks erreicht Sol (Max) 57 Punkte, Opus 5.5 erzielt 59 – ein Abstand von 2 Punkten.
- Offizielle Preise: Sol kostet $2 pro Eingabe, $10 pro Ausgabe und $0.10 für Cache-Lesezugriffe; Opus $4, $20 und $0.20.
- Langes Kontextfenster: Liegt die Eingabe bei Sol in einer einzelnen Anfrage über 272K, steigt der Gesamtpreis – Eingabe und Cache werden doppelt berechnet, die Ausgabe das 1,5-Fache.
- Kennzahlen nicht vermischen: Die offiziellen Selbstangaben und die Drittanbieter-Bewertungen basieren auf unterschiedlichen Aufgaben und Inferenzstufen – sie lassen sich nicht zu einer gemeinsamen Schlussfolgerung zusammenführen.
- Aktuelle Verfügbarkeit: Opus 5.5 ist bereits bei APIYI gelistet; Sol ist noch nicht im Angebot – maßgeblich ist die Modellliste der Plattform.
- Auswahlhilfe: Wer das Claude-Protokoll und sofortige Verfügbarkeit braucht, greift zu Opus; bei kostenempfindlichen Alltagsaufgaben lohnt sich zunächst ein Test von Sol.
Fazit
Die Wahl zwischen GPT-6.2 Sol und Claude Opus 5.5 lässt sich auf drei Punkte zusammenfassen:
- Score und Preis immer gemeinsam betrachten: Sol liegt beim unabhängigen Gesamtscore 2 Punkte niedriger, und der offizielle Listenpreis im Kurzkontext-Bereich beträgt etwa die Hälfte von Opus – keine der beiden Angaben reicht für sich allein als Entscheidungsgrundlage.
- Je nach Aufgabe und Protokoll wählen: Aufgaben, die vom Claude-Protokoll abhängen und sofort live gehen müssen, laufen am besten mit Opus 5.5; bei kostenempfindlichen Alltagsaufgaben, deren Anfragen meist unter 272K bleiben, lohnt sich eine erste Evaluierung mit Sol.
- Mit den eigenen Aufgaben rechnen: Die unabhängigen Single-Task-Kosten gelten nur für genau dieses Evaluierungs-Setup – die realen Kosten hängen von deinem Token-Verbrauch, den Cache-Treffern und der Reasoning-Intensität ab.
Der pragmatischste Weg im Moment: Zuerst mit Opus 5.5 den Evaluierungs-Workflow aufsetzen und, sobald Sol verfügbar ist, mit denselben Anfragen eine Vergleichsrunde nachziehen. Empfehlenswert ist APIYI (apiyi.com), wo du mehrere Modelle mit einem einzigen API-Schlüssel parallel verwalten kannst – das kostenlose Kontingent reicht für die erste Validierungsrunde aus.
📚 Referenzen
-
OpenAI-Ankündigung: Release Notes und offiziell selbst berichtete Evaluierungen zu GPT-6.2 Astra und Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Inhalt: Preisübersicht, Verfügbarkeit und die einzelnen offiziell selbst berichteten Vergleiche
- Link:
-
OpenAI-Modellseite gpt-6.2-sol: Spezifikationen, Endpunkte und die vollständigen Abrechnungsregeln
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Inhalt: Cache-Schreibpreis, die 272K-Regel für Gesamtanfragen sowie die Preisfaktoren für Batch / Fast / Ultrafast
- Link:
-
OpenAI-Systemkarte: Sicherheits- und Alignment-Bewertungen
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Inhalt: Einstufungen nach dem Preparedness-Framework und die Ergebnisse der Alignment-Tests
- Link:
-
Unabhängiger Evaluierungsartikel von Artificial Analysis: Ergebnisse des Intelligence Index v5.0.1
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Inhalt: Gesamtscores je Reasoning-Stufe, Teilindizes und der Vergleich mit der höchsten Stufe von Opus 5.5
- Link:
-
Artificial-Analysis-Modellseite GPT-6.2 Sol: Kennzahlen wie die Single-Task-Kosten
- Link:
artificialanalysis.ai/models/gpt-6-2-sol - Inhalt: Single-Task-Kosten im Gesamtindex von $1.01 (Max-Stufe)
- Link:
-
Claude-Modelldokumentation: Opus-5.5-Spezifikationen und ein Vergleich der offiziellen Listenpreise
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Inhalt: Ein- und Ausgabepreise von Opus 5.5, Kontextgröße und Standard-Reasoning-Intensität
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Du kannst uns gerne über die Startseite von APIYI kontaktieren – die neuesten Angaben zu Modellen und Preisen findest du in der Modell-Gesamtübersicht im Dokumentationszentrum unter docs.apiyi.com