Direkte Antwort: GPT-6.2 Astra kann Webseiten „vielleicht besser aussehen lassen“. Die offiziellen Veröffentlichungsmaterialien und Demo-Beispiele liefern positive Signale, ersetzen aber noch keine Abnahme im eigenen Projekt. OpenAI hat GPT-6.2 Astra/Sol am 2026-11-17 veröffentlicht. Auf der Release-Seite heißt es, das Modell gehe bei Layout und Bildauswahl zielgerichteter vor. Das offizielle Beispiel Paris Atlas zeigt außerdem, wie sich ein Blender-Wahrzeichen in eine interaktive Three.js-Szene verwandeln lässt. All das sind Hinweise auf bessere visuelle und interaktive Fähigkeiten. Offizielle Demos bedeuten jedoch nicht, dass das Modell bei gleichen Anforderungen zwangsläufig das Vorgängermodell schlägt, und sie heißen auch nicht, dass eine einzige Eingabeaufforderung schon eine auslieferbare Webseite ergibt. Zur Klarstellung: Dieser Artikel basiert nicht auf unseren eigenen Tests; er enthält keine Benchmark-, Laufzeit- oder Bewertungsdaten unseres Teams.
Das nehmen Sie aus diesem Artikel mit:
- Was die Release-Seite zu GPT-6.2 Astra und die offizielle Paris-Atlas-Demo jeweils aussagen – und welche Aussagen offizielle Werbung sind.
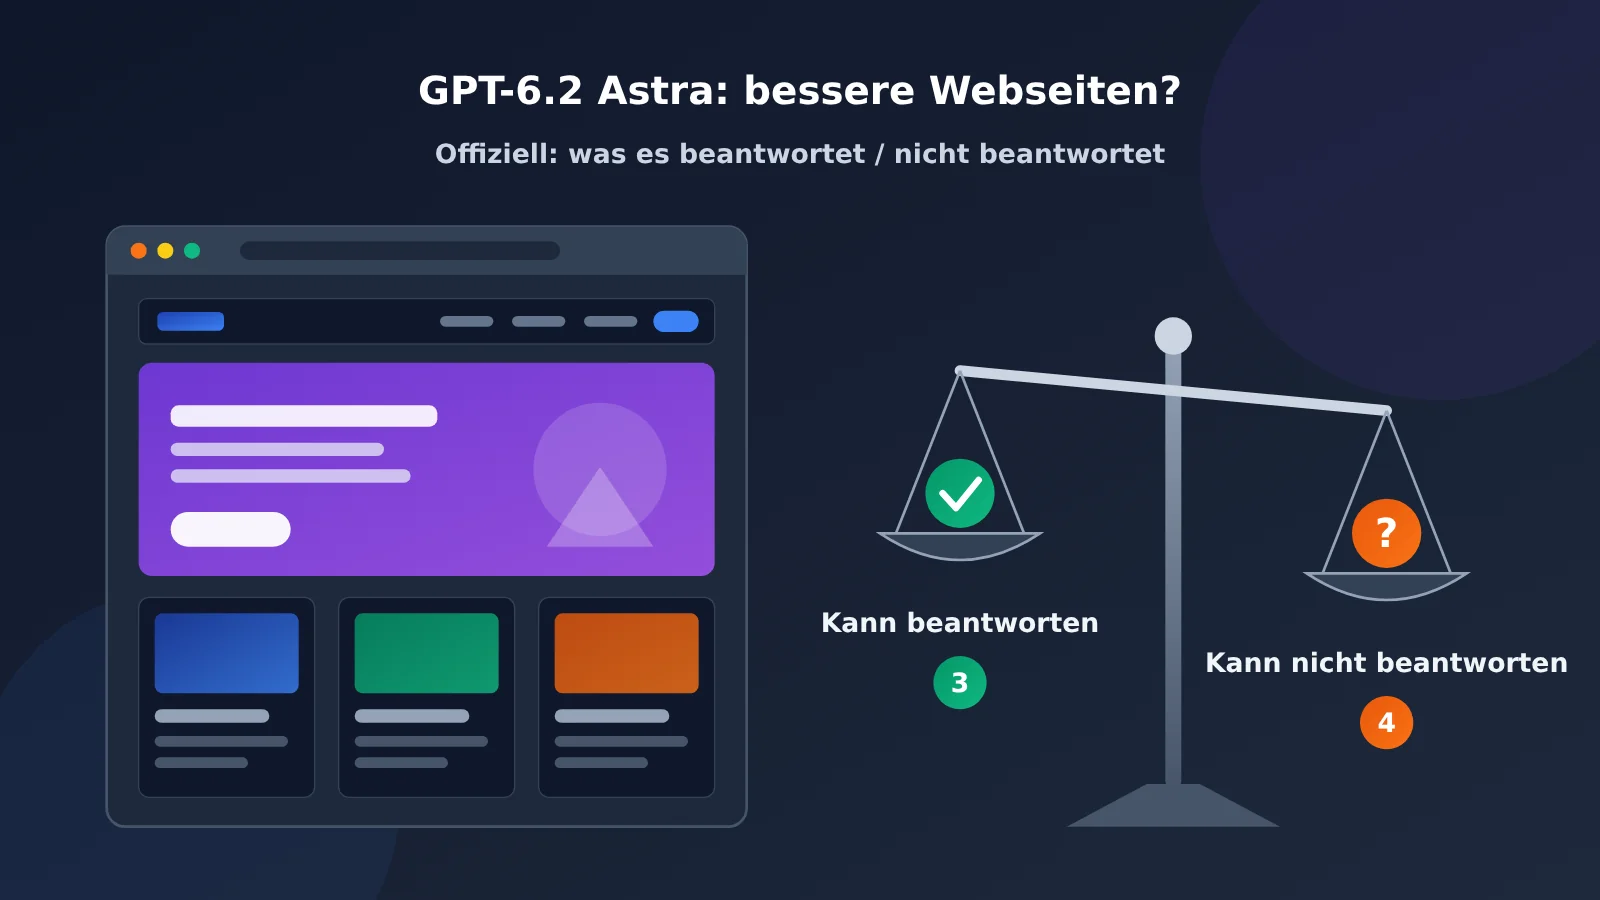
- Die 3 Fragen, die offizielle Demos beantworten können, und die 4 Fragen, die sie nicht beantworten können.
- Wie Sie „die Webseite sieht besser aus“ aus vier Blickwinkeln einordnen: Informationshierarchie, visuelle Konsistenz, Responsivität und funktionale Geschlossenheit.
- Ein direkt anwendbares Vergleichsprotokoll für Webseiten mit altem und neuem Modell sowie eine Vorlage für Eingabeaufforderungen nach dem Prinzip „zuerst Informationsarchitektur, dann Umsetzung“.
Gliederung: Teil 1 sammelt die objektiven Fakten: Release-Informationen, Ein- und Ausgabeformate des Modells und Inhalte der Paris-Atlas-Demo. Teil 2 ist die redaktionelle Einschätzung: Zuerst wird Punkt für Punkt geklärt, was die offiziellen Demos belegen können und was nicht. Danach wird die Qualität der Webseite anhand von vier Dimensionen analysiert. Anschließend folgen ein Vergleichsprotokoll unter gleichen Bedingungen und eine Dokumentationsvorlage, mit denen Sie beurteilen können, ob die Ergebnisse für die tatsächliche Auslieferung taugen. Wenn Sie nur selbst testen möchten, springen Sie direkt zu 2.4.
GPT-6.2 Astra: Wichtige Begriffe im Überblick
| Begriff | Kurze Erklärung |
|---|---|
| GPT-6.2 Astra / Sol | Name der Modelle, die OpenAI am 17.11.2026 veröffentlicht hat. Dieser Artikel konzentriert sich auf die Leistungssignale von Astra im Web-Kontext. |
| Showcase (offizielle Präsentation) | Vom Hersteller ausgewählte und veröffentlichte Beispiele, um ausgewählte Ergebnisse zu präsentieren. Das ist nicht mit einer unabhängigen Evaluierung gleichzusetzen. |
| Paris Atlas | Offizielles Showcase-Beispiel auf der OpenAI-Entwicklerseite: Blender-Wahrzeichen werden in Three.js umgewandelt, um ein Paris-Erlebnis zum Gehen und Fahren zu schaffen. |
| Blender | Open-Source-Software für 3D-Modellierung, häufig zur Erstellung von Modell-Assets verwendet. |
| Three.js | JavaScript-Bibliothek für 3D-Rendering im Browser, basierend auf WebGL. |
| Informationsarchitektur (IA) | Die Art und Weise, wie Website-Inhalte organisiert sind: welche Seiten, Module, Ebenen und Navigationspfade es gibt. |
| Responsiv | Seiten lassen sich auf unterschiedlichen Breiten – Smartphone, Tablet, Desktop – ordentlich darstellen und bedienen. |
| Funktionale Geschlossenheit | Buttons, Formulare, Weiterleitungen, Tastaturbedienung und ähnliche Interaktionen sind tatsächlich nutzbar und nicht nur „scheinbar funktionsfähig“. |
| Blindbewertung | Prüfende bewerten Ergebnisse, ohne die Quelle zu kennen, um Markenverzerrung zu reduzieren. |
GPT-6.2 Astra: Auswirkungen im Überblick
- Frontend-Entwickler: Die offiziellen Signale sind beachtenswert, aber für die Entscheidung, ob das Standardmodell gewechselt wird, sollte man zunächst einen Vergleich unter gleichen Bedingungen mit den eigenen Projektanforderungen durchführen.
- Webdesigner: Wenn die Verbesserungen bei Layout und Bildauswahl tatsächlich zutreffen, könnte die Qualität des Erstentwurfs näher an der Designabsicht liegen – die Markenkonsistenz muss jedoch weiterhin manuell überprüft werden.
- Technische Leiter / Einkaufsentscheider: Dieser Artikel hat keine unabhängige Reproduktion abgeschlossen; es ist nicht ratsam, allein aufgrund ausgewählter Fallbeispiele den Team-Workflow oder das Budget zu ändern.
- Normale Chat-Nutzer: Die Referenzmaterialien deuten darauf hin, dass zwischen Nutzungsumgebungen wie Work, Codex, API und normalem Chat unterschieden werden muss. Die Workflows aus offiziellen Demos sind nicht gleichbedeutend damit, im Dialogfeld mit einem einzigen Satz eine Website zu erstellen.
1. GPT-6.2 Astra – die objektiven Fakten: Was wurde offiziell veröffentlicht?
1.1 GPT-6.2 Astra – Kerninformationen auf einen Blick
| Information | Details | Art der Information |
|---|---|---|
| Veröffentlichungsdatum | 2026-11-17 | Offizielle Veröffentlichung |
| Herausgeber | OpenAI | Offizielle Veröffentlichung |
| Veröffentlichter Inhalt | GPT-6.2 Astra und GPT-6.2 Sol | Offizielle Veröffentlichung |
| Beschreibung der Webseite | Zielgerichtetere Layouts und Bildauswahl | Offizielle Werbeaussage |
| Ein- und Ausgabe | Text-/Bildeingabe, Textausgabe; kann Code ausgeben, Tools zum Ausführen und Verifizieren | Offizielle Information |
| Nutzungsumgebung | In dieser Runde in Work, Codex und API eingeführt, nicht im normalen Chat enthalten | Offizielle Information |
| Repräsentatives Beispiel | Paris Atlas (Showcase auf der Entwicklerseite) | Offizielle Demonstration |
| Prüfdatum dieses Artikels | 2026-11-18 | Redaktionelle Prüfung |
Die beiden Informationsarten „offizielle Werbeaussage“ und „offizielle Demonstration“ in der obigen Tabelle verdienen besondere Beachtung. Sie stammen von OpenAI selbst und spiegeln die Fähigkeitsrichtungen wider, die der Hersteller betonen möchte – nicht Schlussfolgerungen, die Dritte unter einheitlichen Bedingungen gezogen haben.
Die offizielle Veröffentlichungsseite berichtet außerdem von einem Blindtest der AA-3D-Interaktionserfahrung: Astra erreicht 1318 Elo, Sol 1259 Elo. Das liefert ein Bewertungssignal, das über einen einzelnen Showcase-Fall hinausgeht, ist aber keine Garantie für die Qualität einer Unternehmenswebseite, die Erfolgsquote bei der einmaligen Generierung oder die Zuverlässigkeit im Produktivbetrieb. Dieser Artikel zitiert den offiziellen Bericht, ohne die Bewertung selbst zu reproduzieren. Quelle: OpenAI-Veröffentlichungshinweis
1.2 Eingabe- und Ausgabewege von GPT-6.2 Astra
Laut offiziellen Informationen nimmt GPT-6.2 Astra Text- und Bildeingaben entgegen und gibt Text aus. Webseitencode ist im Kern ebenfalls Text; er wird über eine Tool-Kette in Dateien geschrieben, ausgeführt und in der Vorschau dargestellt. Das bedeutet: Das vollständige Erlebnis „Modell erstellt eine Webseite“ hängt davon ab, ob die Umgebung Tools für Dateizugriff, Codeausführung und Vorschau bereitstellt.
Für das Verständnis der offiziellen Demo ist dieser Punkt entscheidend. In einer Umgebung mit Work, Codex oder API samt Tools kann das Modell ein Projekt in mehreren Schritten erzeugen, überarbeiten und zusammenbauen; der aktuelle Release umfasst jedoch nicht den normalen Chat, weshalb sich daraus nicht ableiten lässt, dass normale Konversationen bereits über dasselbe Modell verfügen. Wer also darüber spricht, „wie schön die erstellten Webseiten aussehen“, muss zuerst klären, in welcher Umgebung diese Schlussfolgerung gezogen wurde.
1.3 Was die offizielle Paris-Atlas-Demo zeigt
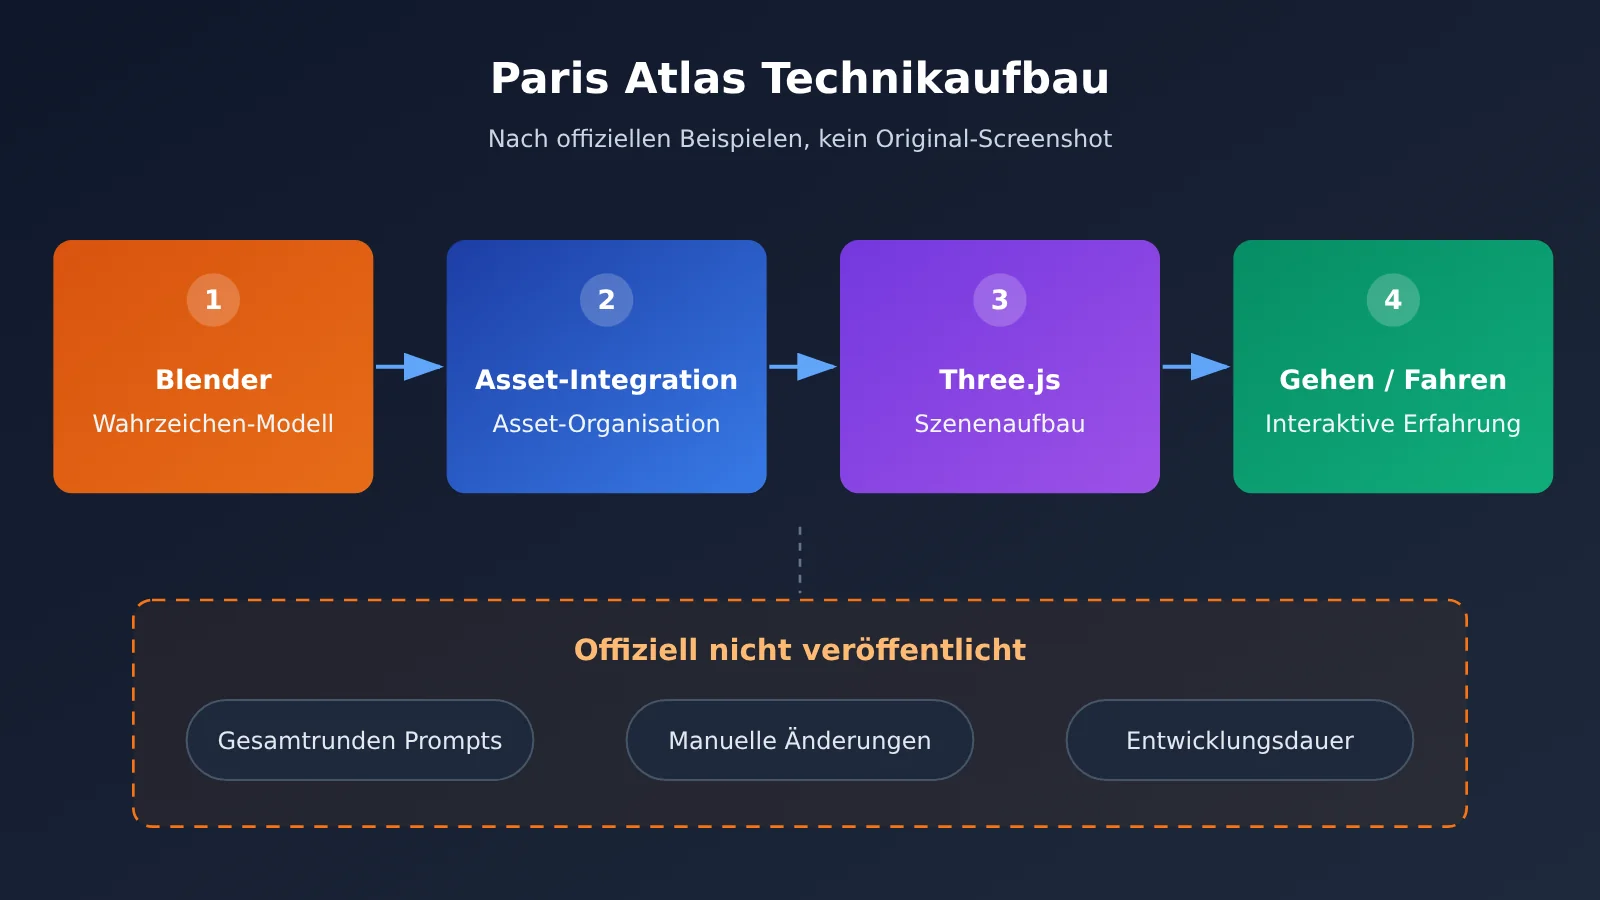
Paris Atlas ist ein offizielles Showcase-Beispiel auf der OpenAI-Entwicklerseite. Laut offizieller Beschreibung wandelt es ein in Blender erstelltes Modell der Pariser Wahrzeichen in eine Three.js-Szene um und baut ein interaktives Erlebnis auf, in dem man durch Paris gehen und fahren kann.
Technisch betrachtet umfasst dieses Beispiel die Konvertierung von 3D-Asset-Formaten, das Rendering im Browser, die Kamerasteuerung und die Interaktionslogik – die Komplexität liegt damit deutlich über einer gewöhnlichen Präsentationswebseite. Es zeigt, dass das Modell unter geeigneten Tools und Prozessen an der Umsetzung solcher visuellen Interaktionsprojekte beteiligt werden kann. Das offizielle Paris-Atlas-Beispiel listet mehrere Bauphasen von der ersten Stadtversion bis zu Korrekturen an Wahrzeichen und Ladenfronten auf, was belegt, dass es sich um einen iterativen Prozess handelt; die Seite nennt weder die Gesamtzahl der Prompt-Runden noch den Umfang manueller Änderungen oder die Gesamtdauer, und dieser Artikel erfindet solche Daten nicht hinzu.
II. Analyse und Einschätzung: Der Wert der offiziellen Präsentation von GPT-6.2 Astra und wie man sie überprüft
Im Folgenden kommen wir zum redaktionellen Teil der Einschätzung. Jede Einschätzung stützt sich auf die oben genannten Fakten; was über die Fakten hinausgeht, wird ausdrücklich kenntlich gemacht.
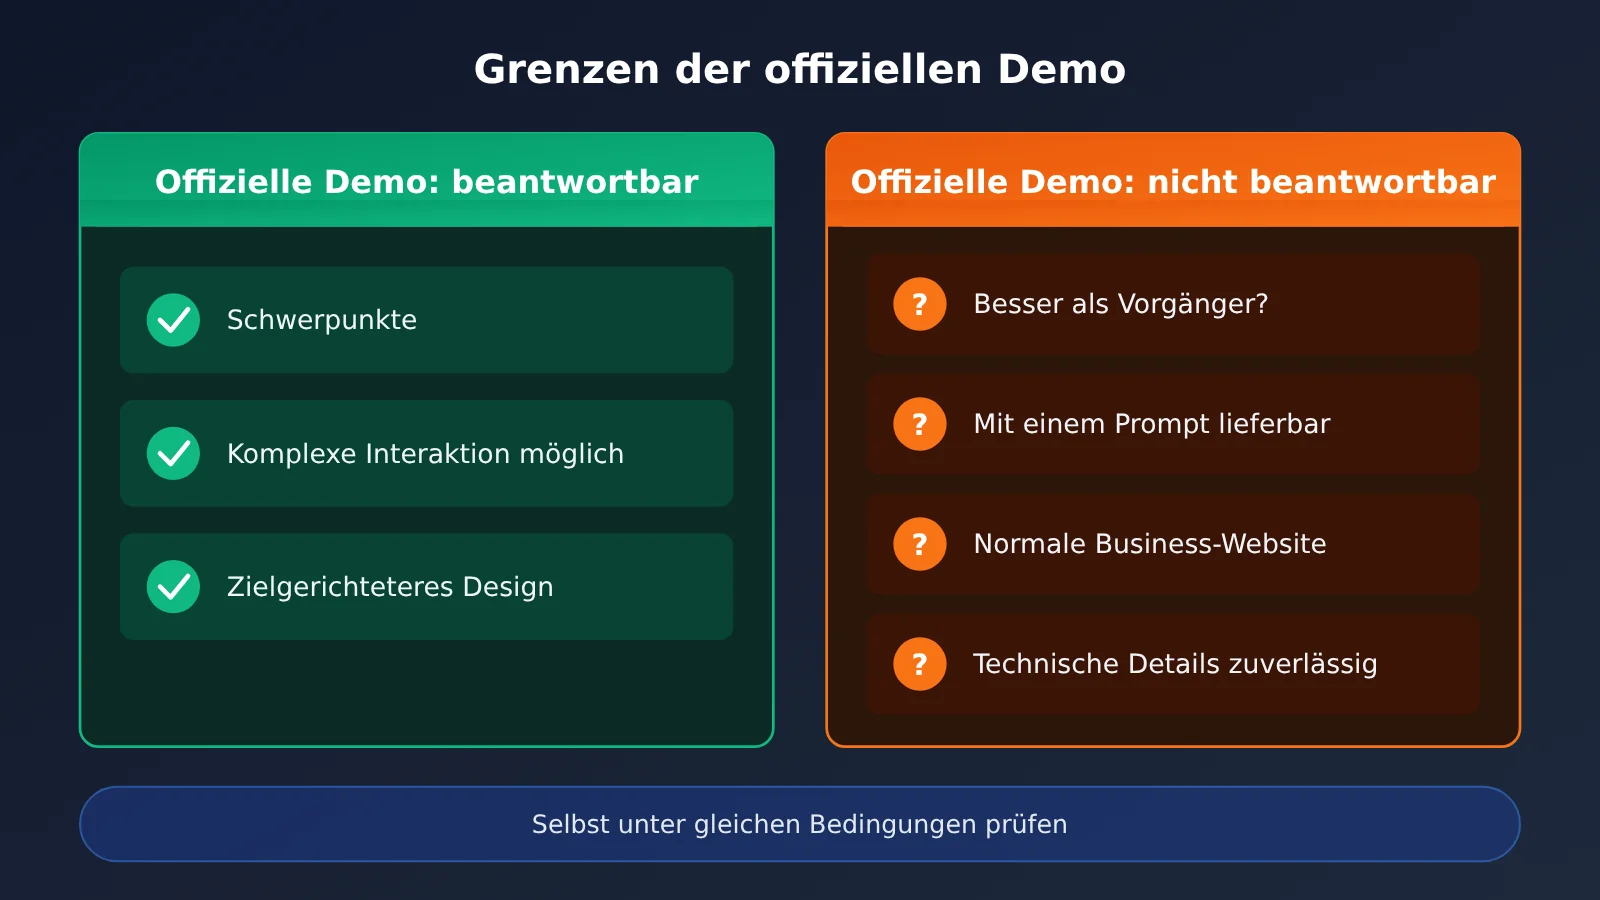
2.1 3 Dinge, die die offizielle Präsentation beantworten kann
- OpenAI betrachtet die visuelle Gestaltung und Interaktion von Webseiten als Schwerpunkt. Die Ankündigungsseite nennt ausdrücklich Layout und Bildauswahl – ein Zeichen dafür, dass OpenAI dies als einen vorzeigbaren Fortschritt betrachtet.
- Mit Unterstützung der Toolchain kann das Modell an komplexen 3D-Interaktions-Webprojekten mitwirken. Paris Atlas umfasst die Konvertierung von Blender nach Three.js sowie den Aufbau der Interaktion und liefert damit bereits einen konkreten fertigen Anwendungsfall.
- „Bewusstere Designentscheidungen“ ist die von offizieller Seite genannte Verbesserungsrichtung. Sie macht deutlich, dass wir bei der Bewertung nicht nur auf die Farbgebung achten dürfen, sondern auch darauf, ob Layout und Bebilderung den inhaltlichen Zielen dienen.
2.2 Vier Dinge, die die offizielle Demo nicht beantworten kann
| Frage | Kann die offizielle Demo sie beantworten? | Grund |
|---|---|---|
| Gewinnt Astra bei identischer Anforderung sicher gegen das ältere Modell? | Nein | Der ausgewählte Fall enthält keinen kontrollierten Vergleich zwischen neuem und altem Modell bei gleicher Anforderung |
| Erhält man mit einer einzigen Eingabeaufforderung eine lieferbare Website? | Nein | Es wird eine mehrstufige Iteration gezeigt, aber weder die Gesamtzahl der Prompt-Runden noch der Umfang der manuellen Eingriffe genannt |
| Sind gewöhnliche Unternehmensseiten und Onlineshops ebenfalls besser? | Nein | Die 3D-Interaktions-Demo unterscheidet sich stark von den Anforderungen einer gewöhnlichen Business-Website |
| Sind Responsive Design, Barrierefreiheit, Formulare usw. zuverlässig? | Nein | Die Demo legt den Schwerpunkt auf das visuelle Erlebnis und zeigt keine Validierung solcher Engineering-Details |
Genau diese vier Fragen sind der Teil, der bei der tatsächlichen Auslieferung am meisten interessiert. Die offizielle Demo ist ein „gefiltertes Ergebnisbeispiel“, während wir in Projekten mit „Durchschnittsleistung und Ausfallquote“ konfrontiert sind – zwischen beidem liegt ein unabhängiger Vergleich.
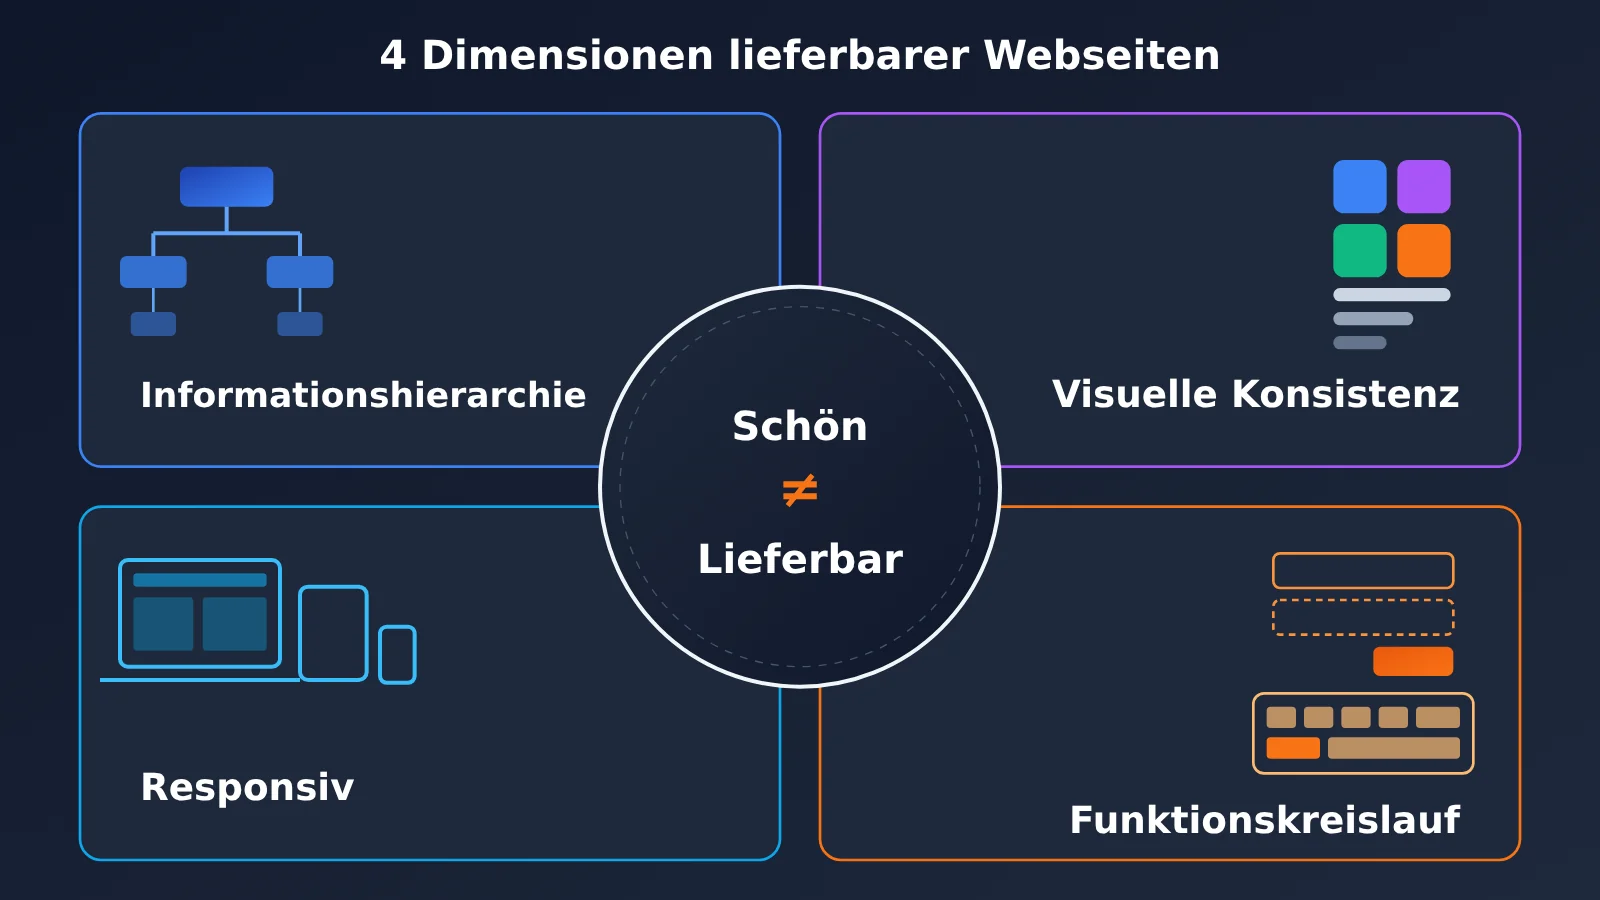
2.3 Vier Analysedimensionen für die Webqualität von GPT-6.2 Astra
„Schön“ ist ein vages Wort. Damit sich das Urteil überprüfen lässt, zerlegen wir es in vier Dimensionen. Diese Dimensionen bilden den in diesem Artikel vorgeschlagenen Analyse-Rahmen – es sind keine offiziellen Kennzahlen.
2.3.1 Informationshierarchie: Ist der Inhalt zuerst einmal gut organisiert?
Eine schön gestaltete Webseite ist zuallererst eine gut lesbare Webseite. Ob Nutzerinnen und Nutzer innerhalb von Sekunden erkennen, worum es geht, was sie tun können und wo sie als Nächstes klicken müssen, hängt vom hierarchischen Verhältnis zwischen Überschrift, Fließtext und Call-to-Action-Button ab. Das offiziell erwähnte „zielgerichtetere Layout“ sollte sich – wenn es denn zutrifft – genau hier zeigen.
Paris Atlas ist als immersives 3D-Erlebnis mit anderen Anforderungen an die Informationshierarchie konfrontiert als eine gewöhnliche Website. Es kann die visuelle Ausdrucksstärke demonstrieren, macht aber kaum deutlich, wie das Modell auf inhaltsdichten Seiten die Hierarchie organisiert.
2.3.2 Visuelle Konsistenz: Sehen mehrere Seiten aus wie eine Marke?
Eine einzelne Seite zu beeindrucken ist nicht schwer. Schwierig ist, dass mehrere Seiten bei Schriftgröße, Abständen, Farben und Komponenten-Stilen konsistent bleiben. In echten Projekten wirkt sich die Stabilität des Designsystems oft stärker auf die Lieferqualität aus als der Effekt eines einzelnen Screens. Bei der Bewertung sollte man mindestens zwei bis drei zusammenhängende Seiten generieren und prüfen, ob sie dieselben Regeln befolgen.
2.3.3 Responsivität: Bleibt die Seite auf schmalen Bildschirmen nutzbar?
Viele generierte Webseiten sehen in Desktop-Breite gut aus, doch auf dem Smartphone kommt es dann zu Textüberläufen, überlappenden Buttons oder horizontalem Scrollen. Die in diesem Artikel herangezogene Build-Beschreibung von Paris Atlas reicht nicht aus, um die Eignung für deine Zielgeräte zu belegen – das musst du selbst prüfen. Empfehlenswert ist, mindestens drei Breiten abzudecken: Smartphone, Tablet und Desktop.
2.3.4 Funktionskette: Sieht aus, als würde es funktionieren – aber funktioniert es wirklich?
Löst ein Button tatsächlich eine Aktion aus? Hat das Formular Validierung und Fehlermeldungen? Lässt sich mit der Tab-Taste in der richtigen Reihenfolge durch die Felder springen, und ist der Fokus-Zustand sichtbar? All das gehört zur Funktionskette – und genau das kann ein Screenshot nie belegen. Für Teams, die Websites bauen, entscheidet diese Dimension oft darüber, wie viel Nacharbeit später anfällt.
| Dimension | Prüfschwerpunkte | Geeignete Prüfmethode | Abdeckung in der offiziellen Präsentation |
|---|---|---|---|
| Informationshierarchie | Priorisierung von Überschrift, Fließtext und Call-to-Action-Button | Screenshots blind bewerten + Fünf-Sekunden-Verständnistest | Indirekt (Textbeschreibung auf der Release-Seite) |
| Visuelle Konsistenz | Schriftgrößen, Abstände und Komponenten über mehrere Seiten hinweg | Mehrere Seiten nebeneinander blind bewerten | Nicht direkt gezeigt |
| Responsivität | Layout für Smartphone/Tablet/Desktop | Screenshots in drei Breiten | Nicht direkt gezeigt |
| Funktionskette | Buttons, Formulare, Tastaturbedienung | Manuell Punkt für Punkt durchklicken | Teilweise (3D-Interaktion ist bedienbar) |
2.4 GPT-6.2 Astra Web-Vergleichsprotokoll: Wie Sie selbst verifizieren
Der zuverlässigste Weg festzustellen, ob Ihr eigenes Projekt davon profitiert, ist ein kontrollierter Vergleich mit den eigenen Anforderungen. Das folgende Protokoll ist eine für diesen Artikel eigens zusammengestellte Methode, die Sie direkt übernehmen können. Wir haben damit keine Ergebnisse erzielt – die Datenfelder in der Tabelle müssen Sie selbst ausfüllen.
2.4.1 Die drei Kontrollbedingungen für den GPT-6.2 Astra-Vergleich
- Gleiche Anforderungen, gleiches Material, gleiches Budget. Beide Modelle erhalten exakt dieselben Anforderungsdokumente, Bildmaterialien und Markenrichtlinien; Tool-Berechtigungen, Laufzeitumgebung und eine vergleichbare Inferenzintensität werden vereinheitlicht, und die maximale Zahl an Iterationsrunden bzw. die Kostenobergrenze wird vorab festgelegt. Dieselbe Token-Zahl bedeutet nicht dieselben Kosten.
- Prozesskosten dokumentieren. Wie viele Änderungen jedes Modell von der ersten Version bis zur „ablieferbaren“ Fassung durchlaufen hat und wie viele Minuten ein Mensch eingreifen musste – all das gehört wahrheitsgemäß ins Protokoll.
- Blindbewertung plus Praxistest. Die Screenshots werden ohne Modellkennzeichnung an das Bewertungsteam gegeben; parallel werden Buttons, Formulare und Tastaturbedienung Punkt für Punkt manuell getestet.
Keine dieser drei Bedingungen ist verzichtbar. Wer nur die Screenshots des ersten Bildschirms vergleicht, überschätzt Versionen, die optisch gut aussehen, aber funktionale Lücken haben; wer nur die Zahl der Änderungen vergleicht, übersieht wiederum den Unterschied im Endergebnis.
2.4.2 Erst Informationsarchitektur, dann Umsetzung: die Vorlage für die Eingabeaufforderung
Für einen faireren Vergleich empfiehlt es sich, die Eingabeaufforderung in zwei Phasen aufzuteilen. In der ersten Phase soll das Modell ausschließlich die Informationsarchitektur ausgeben, in der zweiten Phase wird dann auf Basis der bestätigten Architektur der Code geschrieben. So lässt sich beobachten, ob das Modell die Inhalte wirklich zielgerichtet organisiert, statt einfach nur hübsche Komponenten aneinanderzustapeln.
【Phase 1: Informationsarchitektur】
Sie sind Informationsarchitekt für Websites. Bitte geben Sie auf Grundlage der folgenden Anforderungen ausschließlich die Informationsarchitektur aus, schreiben Sie keinen Code:
1. Seitenliste und Ziel jeder Seite
2. Modulreihenfolge und Informationshierarchie pro Seite (H1/H2/Fließtext/Aktionsbutton)
3. Navigationspfade und zentrale Interaktionen
4. Inhalte, die gebraucht werden, aber im Material fehlen, mit 【Bereitzustellen】 markieren; keine Daten, Bewertungen oder Kundenreferenzen erfinden

Anforderungen: {Anforderungsdokument einfügen}
Material: {Bilder und Texte auflisten}

【Phase 2: Umsetzung】
Erzeugen Sie auf Basis der bestätigten Informationsarchitektur den Webseitencode, Anforderungen:
- Einheitliche Designregeln (Schriftgrößen, Abstände, Farbvariablen)
- Unterstützung für drei Breiten: 375px / 768px / 1440px
- Alle Buttons und Formulare bedienbar, Formulare mit Validierung und Fehlermeldungen, Tastatur-Tab-Navigation unterstützt
- Fehlende Inhalte als 【Bereitzustellen】-Platzhalter belassen, keine erfundenen Ergebnisse eintragen
Die Zeile „keine Daten, Bewertungen oder Kundenreferenzen erfinden“ ist in der Vorlage entscheidend. Beim Generieren von Webseiten neigt das Modell dazu, fiktive Nutzerbewertungen oder Umsatzzahlen zu ergänzen – sobald das live geht, sind das schlichtweg Tatsachenfehler.
2.4.3 Alte und neue Modelle über eine einheitliche Schnittstelle aufrufen
Beim Vergleich reduziert derselbe Code für beide Modelle die Zahl der Variablen. Unten ein minimales Aufrufbeispiel; die Modellnamen richten sich nach der tatsächlichen Liste in der Konsole der jeweiligen Plattform. Dieser Artikel geht nicht davon aus, dass irgendein Modell bereits auf einer bestimmten Plattform verfügbar ist.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI einheitliche Schnittstelle, OpenAI-kompatibel
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # maßgeblich ist die Modellliste in der Konsole
    messages=[{"role": "user", "content": "按阶段一输出信息架构:……"}]
)
print(resp.choices[0].message.content)
Vollständiges Vergleichsskript anzeigen (zweistufig + Ergebnisarchivierung)
import json, time, pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # über APIYI mit demselben Code das Modell wechseln
)

MODELS = ["OLD_MODEL_ID", "NEW_MODEL_ID"]  # maßgeblich sind die tatsächlich in der Konsole verfügbaren Namen
STAGE1 = open("prompt_stage1.txt", encoding="utf-8").read()
STAGE2 = open("prompt_stage2.txt", encoding="utf-8").read()
OUT = pathlib.Path("compare_runs")
OUT.mkdir(exist_ok=True)

def ask(model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    return r.choices[0].message.content

for i, model in enumerate(MODELS):
    tag = f"sample_{chr(65 + i)}"  # A/B-Codenamen verwenden, das erleichtert die Blindbewertung
    msgs = [{"role": "user", "content": STAGE1}]
    ia = ask(model, msgs)
    msgs += [{"role": "assistant", "content": ia},
             {"role": "user", "content": STAGE2}]
    code = ask(model, msgs)
    (OUT / f"{tag}_ia.md").write_text(ia, encoding="utf-8")
    (OUT / f"{tag}_code.md").write_text(code, encoding="utf-8")
    # nur Metadaten erfassen; Anzahl der Änderungen und manuelle Zeit ergänzen die Tester von Hand
    meta = {"tag": tag, "model": model, "time": time.strftime("%F %T"),
            "revisions": None, "manual_minutes": None}
    (OUT / f"{tag}_meta.json").write_text(json.dumps(meta, ensure_ascii=False))
Das Skript lässt revisions und manual_minutes bewusst leer – diese Felder füllen die Tester erst nach den tatsächlichen Überarbeitungen aus. Statt der Modellnamen werden A/B-Codenamen verwendet, und auch in Screenshots sollte die Herkunft nicht erkennbar sein. Nur so ergibt eine Blindbewertung überhaupt Sinn.
Hinweis zum Test: Der obige Code dient nur als Ablaufreferenz und wurde in diesem Artikel nicht tatsächlich ausgeführt. Er legt weder die Reasoning-Intensität fest noch implementiert er eine Abnahme im Browser – als vollständiges Evaluierungswerkzeug taugt er also nicht direkt. Vor dem Test müssen Modellverfügbarkeit, Parameterkompatibilität und die tatsächliche Preisgestaltung des Anbieters geprüft werden; selbst die Nutzung desselben Kanals beseitigt nicht automatisch Unterschiede bei Tools, Konfiguration oder Routing.
2.4.4 Vorlage für das Vergleichsprotokoll zu GPT-6.2 Astra
| Erfassungspunkt | Probe A | Probe B | Ausfüllhinweis |
|---|---|---|---|
| Aufrufkanal | Offizielle API / APIYI apiyi.com | Wie links, muss identisch sein | Beide Proben nutzen denselben Kanal |
| Anzahl der Überarbeitungen | auszufüllen | auszufüllen | Zahl der Zusatzanweisungen von der ersten Version bis zur lieferbaren Version |
| Manuelle Zeit (Minuten) | auszufüllen | auszufüllen | Zeit für manuelles Ändern von Code und Anpassen des Stylings |
| Blindbewertung (vier Dimensionen) | auszufüllen | auszufüllen | mindestens 3 Bewerter, Median verwenden |
| Buttons/Formulare/Tastatur | auszufüllen | auszufüllen | Punkt für Punkt als bestanden oder fehlgeschlagen erfassen |
| Verhalten bei drei Breiten | auszufüllen | auszufüllen | Screenshots bei 375 / 768 / 1440 px |
Erst wenn diese Tabelle vollständig ausgefüllt ist, lässt sich für das eigene Projekt eine Aussage darüber treffen, ob „GPT-6.2 Astra für Webseiten schöner und besser nutzbar ist“.
Verwandeln Sie eine echte Anforderung in ein überprüfbares Ergebnis und entscheiden Sie dann, ob Sie das Standardmodell wechseln. Die Vergleichstabelle in diesem Artikel ist nach wie vor eine leere Vorlage und keine bereits abgeschlossene Bewertung.
Was man aus Büchern lernt, ist immer oberflächlich; um eine Sache wirklich zu verstehen, muss man sie selbst tun. — Lu You, „Beim Lesen in einer Winternacht – Ermahnung an meinen Sohn Ziyu“
📚 Referenzen
-
Offizielle OpenAI-Ankündigungsseite: Introducing GPT-6.2 Astra & Sol
- Link: Offizielle Ankündigung
- Beschreibung: Offizielle Informationsquelle zu dieser Veröffentlichung, einschließlich Beschreibungen zu Layout und Bildauswahl
-
OpenAI Developer Showcase: Paris Atlas
- Link: Der Aufbau von Paris Atlas
- Beschreibung: Offizielles Showcase-Beispiel, das eine Pariser Geh-/Fahrerfahrung vorstellt, bei der Blender-Wahrzeichen in Three.js umgewandelt werden
-
Dokumentation zum Modell GPT-6.2 Astra: Ein- und Ausgabefähigkeiten.
- Offizielle Hinweise zu ChatGPT Work und Codex: Verfügbarkeit.
- OpenAI API Changelog: Veröffentlichungseintrag vom 2026-11-17.
Autor: APIYI Technikteam
Technischer Austausch: Sie können uns gerne über die Startseite der Website APIYI apiyi.com kontaktieren; weitere Integrationsmaterialien finden Sie im Dokumentationszentrum docs.apiyi.com