直接回答:GPT-6.2 Astra 做網頁“可能更好看了”,官方發佈材料和展示案例提供了積極信號,但尚不能替代你自己項目上的驗收。 OpenAI 於 2026-11-17 發佈 GPT-6.2 Astra/Sol。發佈頁稱它在佈局和圖像選擇上更有目的性,官方案例 Paris Atlas 也展示了把 Blender 地標轉成 Three.js 交互場景的能力。這些都是視覺與交互能力提升的信號。不過,官方展示不等於同需求下必然勝過舊款,也不代表一次提示就能做出可交付的網站。需要說明的是,本文不是我們的自行實測,文中沒有任何本團隊跑分、耗時或評分數據。
您讀完此文能瞭解到什麼?
- GPT-6.2 Astra 發佈頁和 Paris Atlas 官方展示分別說了什麼,哪些屬於官方宣傳。
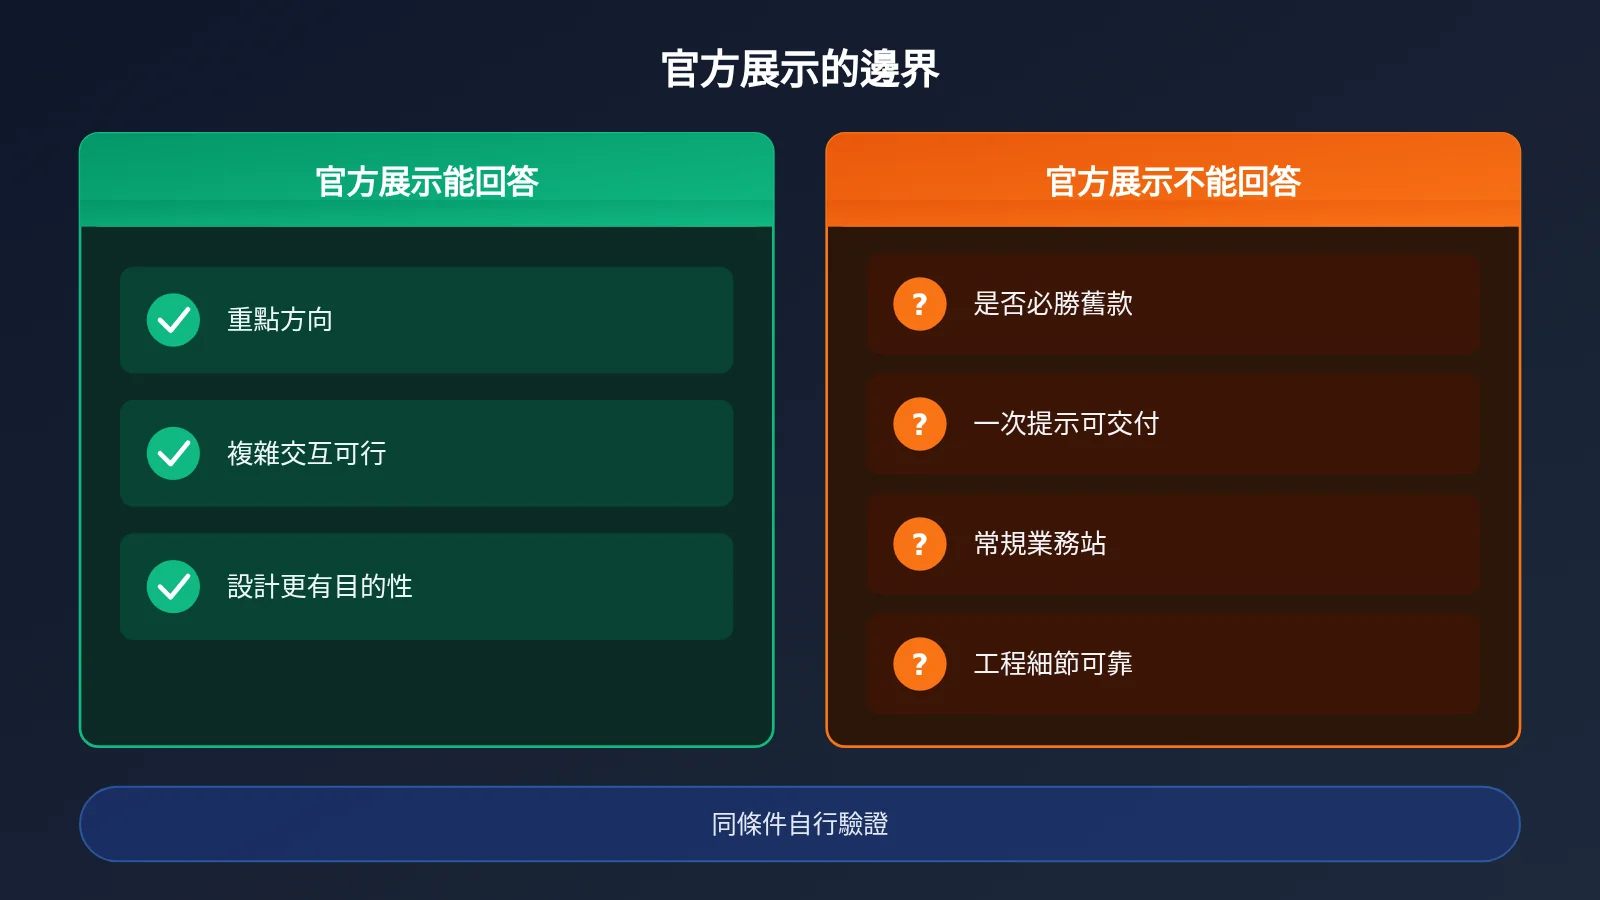
- 官方展示能回答的 3 件事,以及不能回答的 4 件事。
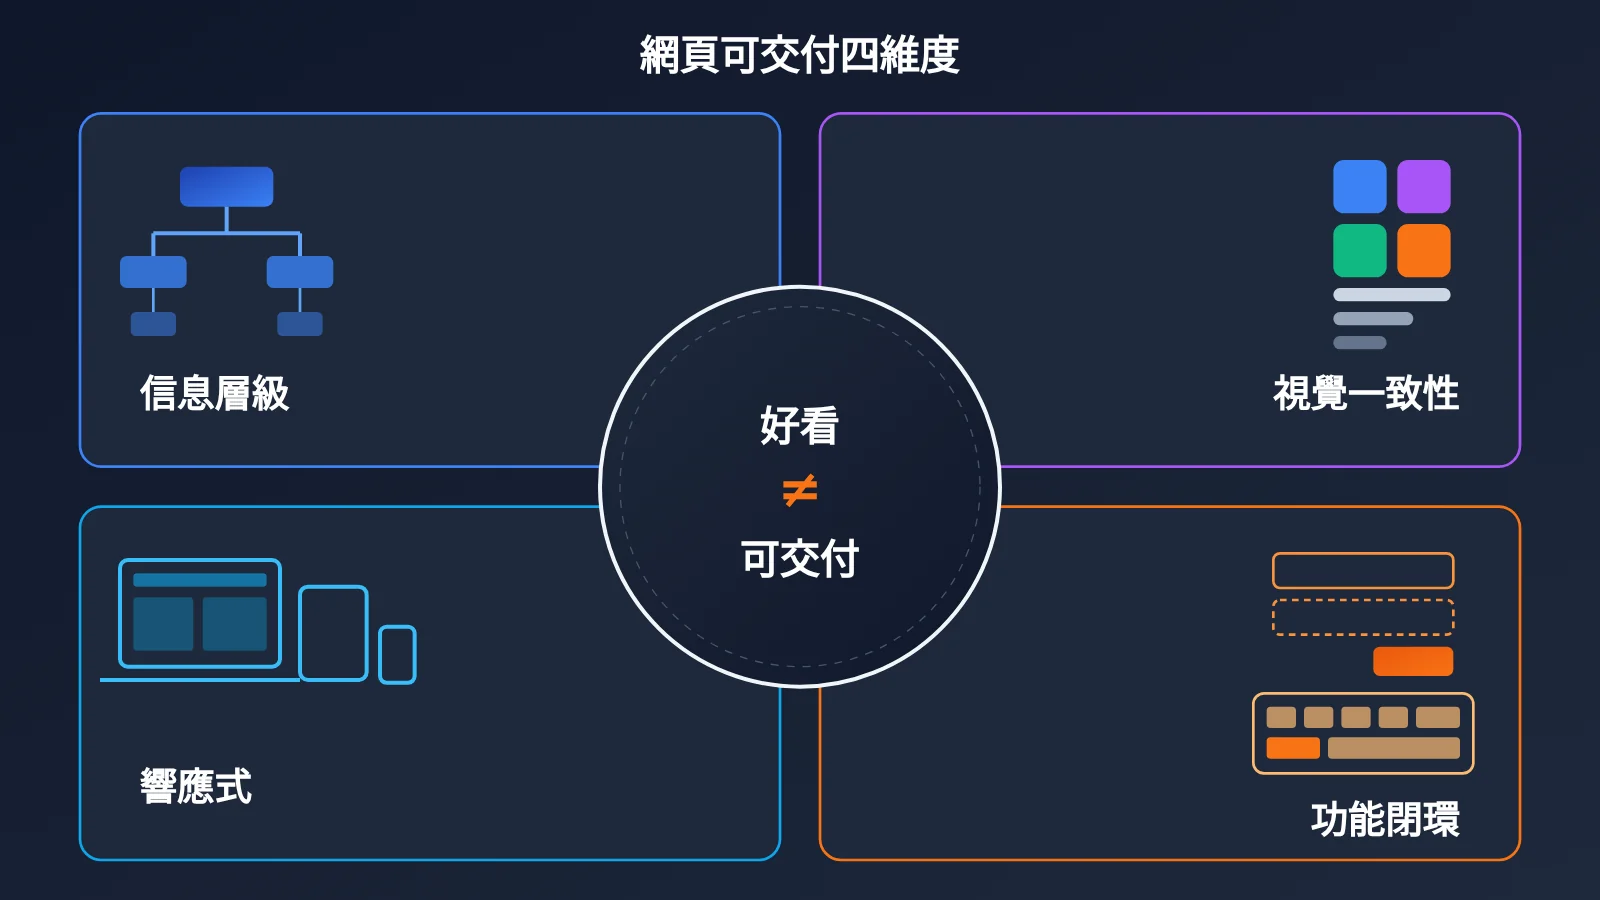
- 從信息層級、視覺一致性、響應式、功能閉環四個維度看待“網頁更好看”這件事。
- 一套可以直接照做的新舊模型網頁對比協議,以及“先信息架構、後實現”的提示詞模板。
索引: 第一部分整理客觀事實,包括髮布信息、模型輸入輸出方式和 Paris Atlas 演示內容。第二部分是編輯判斷,先逐條拆解官方展示的證明邊界,再用四個維度分析網頁質量,再給出同條件對比協議和記錄模板,幫助判斷結果能否用於實際交付。只想動手驗證,可以直接跳到 2.4。
GPT-6.2 Astra 相關概念 To Know
| 概念 | 簡要解釋 |
|---|---|
| GPT-6.2 Astra / Sol | OpenAI 於 2026-11-17 發佈的模型名稱,本文聚焦 Astra 在網頁場景中的表現信號 |
| Showcase(官方展示) | 廠商挑選併發布的案例,用於展示選定成果,不等同於獨立評測 |
| Paris Atlas | OpenAI 開發者站點的官方展示案例,把 Blender 地標轉爲 Three.js,構建巴黎步行/駕駛體驗 |
| Blender | 開源 3D 建模軟件,常用於製作模型資產 |
| Three.js | 瀏覽器端 3D 渲染的 JavaScript 庫,基於 WebGL |
| 信息架構(IA) | 網站內容的組織方式:有哪些頁面、模塊、層級和導航路徑 |
| 響應式 | 頁面在手機、平板、桌面等不同寬度下都能正常排版和操作 |
| 功能閉環 | 按鈕、表單、跳轉、鍵盤操作等交互真正可用,而不只是“看起來像能用” |
| 盲評 | 評審者在不知道來源的情況下對結果打分,用來降低品牌偏見 |
GPT-6.2 Astra 影響速覽
- 前端開發者:官方信號值得關注,但要用自己的項目需求做同條件對比,再決定是否切換默認模型。
- 網頁設計者:佈局和配圖選擇的提升如果成立,初稿質量可能更接近設計意圖,但品牌一致性仍需人工把關。
- 技術負責人/採購決策者:本文未完成獨立復現;不宜僅憑精選案例改變團隊工作流或預算。
- 普通 Chat 用戶:參考資料提示需要區分 Work、Codex、API 與普通 Chat 等使用環境,官方演示中的工作流不能直接等同於在對話框裏一句話出網站。
一、GPT-6.2 Astra 客觀事實:官方發佈了什麼
1.1 GPT-6.2 Astra 核心信息速覽
| 信息項 | 詳情 | 信息性質 |
|---|---|---|
| 發佈時間 | 2026-11-17 | 官方發佈 |
| 發佈方 | OpenAI | 官方發佈 |
| 發佈內容 | GPT-6.2 Astra 與 GPT-6.2 Sol | 官方發佈 |
| 網頁相關描述 | 更有目的性的佈局和圖像選擇 | 官方宣傳表述 |
| 輸入輸出 | 文字/圖片輸入,文字輸出;可輸出代碼,工具用於運行和驗證 | 官方信息 |
| 使用環境 | 本輪在 Work、Codex、API 推出,不包含普通 Chat | 官方信息 |
| 代表案例 | Paris Atlas(開發者站點 Showcase) | 官方展示 |
| 本文覈查日期 | 2026-11-18 | 編輯覈查 |
上表中“官方宣傳表述”和“官方展示”兩類信息需要特別注意。它們來自 OpenAI 自身,反映的是廠商希望強調的能力方向,而不是第三方在統一條件下得出的結論。
官方發佈頁還報告了 AA-3D 交互體驗盲評:Astra 爲 1318 Elo,Sol 爲 1259 Elo。它提供了超出單個展示案例的評測信號,但不等於對企業官網質量、一次生成成功率或生產可靠性的保證。本文引用官方報告,未復現該評測。來源:OpenAI 發佈說明
1.2 GPT-6.2 Astra 的輸入輸出方式
按照官方信息,GPT-6.2 Astra 接收文字和圖片輸入,輸出的是文字。網頁代碼本質上也是文字,它通過工具鏈被寫入文件、運行和預覽。這意味着“模型做網頁”的完整體驗,依賴於所處的環境是否提供了文件讀寫、代碼執行和預覽等工具。
這一點對理解官方演示很關鍵。在 Work、Codex 或 API 搭配工具的環境裏,模型可以多步產出、修改並組裝項目;本輪上線不包括普通 Chat,不能據此推斷普通對話已擁有同一模型。所以討論“做網頁好不好看”時,必須先說明是在哪種環境下得出的結論。
1.3 Paris Atlas 官方演示展示了什麼
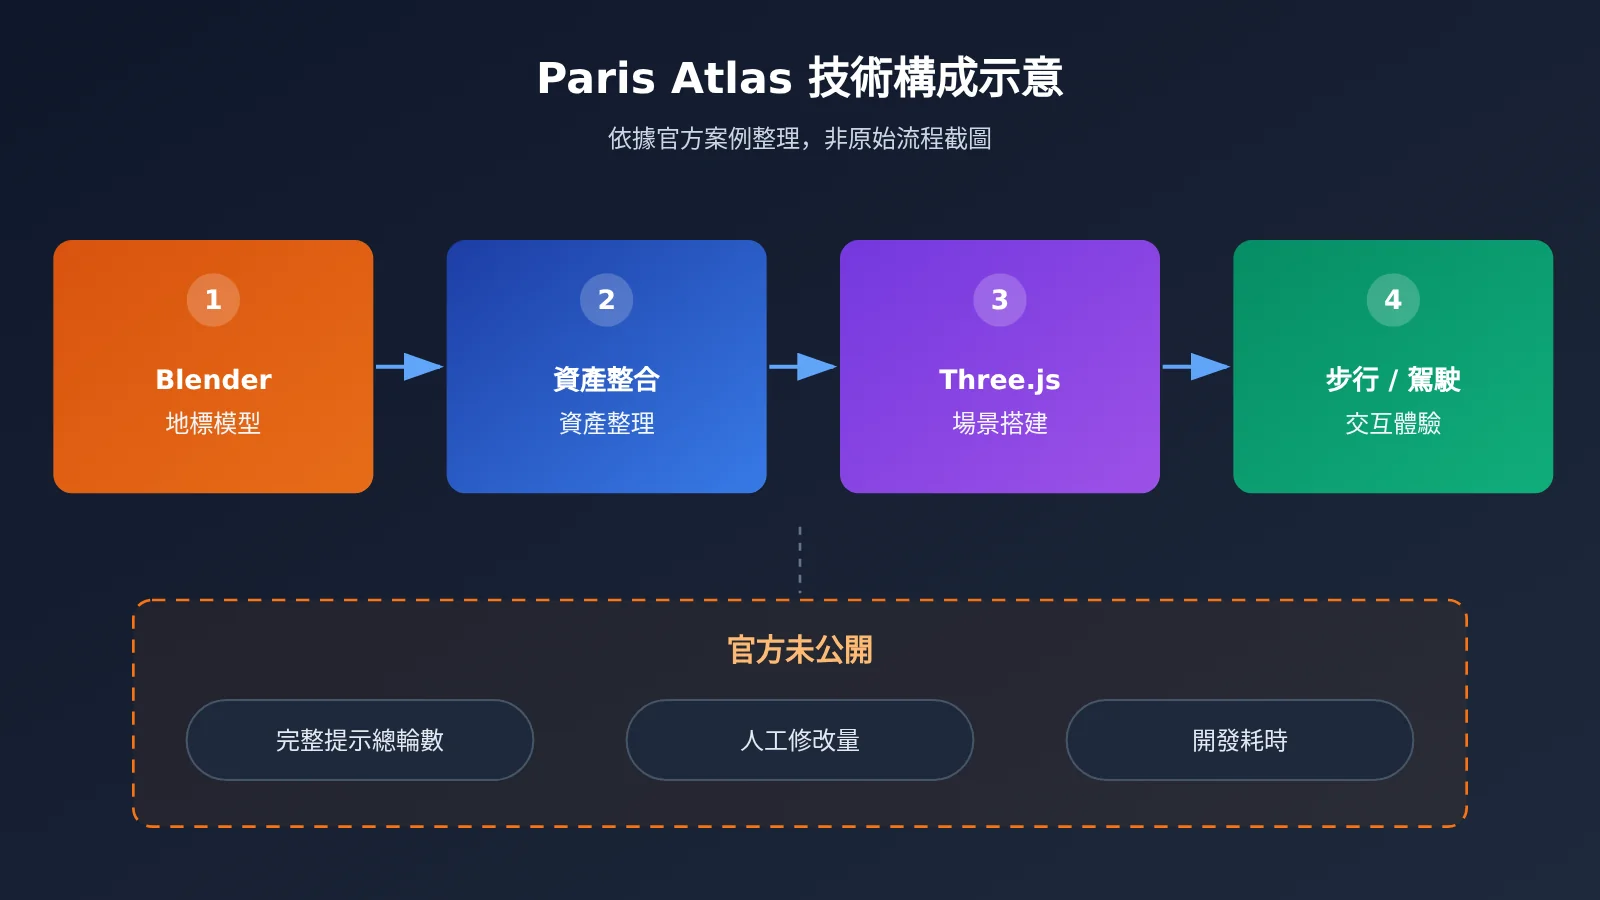
Paris Atlas 是 OpenAI 開發者站點上的官方展示案例。根據官方描述,它把 Blender 製作的巴黎地標模型轉換爲 Three.js 場景,並構建了可以在巴黎步行和駕駛的交互體驗。
從技術構成看,這個案例涉及 3D 資產格式轉換、瀏覽器端渲染、相機控制和交互邏輯,複雜度明顯高於常規的展示型網頁。它說明在合適的工具和流程下,模型參與完成這類視覺交互項目是可行的。Paris Atlas 官方案例列出了從初版城市到地標、店面修正的多個構建階段,說明它是迭代過程;頁面未給出完整提示總輪數、人工修改總量和總耗時,本文不補造這些數據。
二、分析判斷:GPT-6.2 Astra 官方展示的價值與驗證方法
以下進入編輯判斷部分。每一條判斷都對應上文的事實,超出事實的部分會明確標出。
2.1 官方展示能回答的 3 件事
- OpenAI 把網頁視覺與交互列爲重點方向。 發佈頁專門提到佈局和圖像選擇,說明官方認爲這是值得宣傳的進步點。
- 在工具鏈支持下,模型可以參與複雜的 3D 交互網頁項目。 Paris Atlas 涉及 Blender 到 Three.js 的轉換和交互構建,已提供具體的成品案例。
- “更有目的性的設計選擇”是官方給出的改進方向。 它提示我們評估時不能只看配色,要看佈局和配圖是否服務於內容目標。
2.2 官方展示不能回答的 4 件事
| 問題 | 官方展示能否回答 | 原因 |
|---|---|---|
| 同一需求下 Astra 是否必勝舊款 | 不能 | 該精選案例沒有同需求的新舊模型受控對比 |
| 一次提示能否得到可交付網站 | 不能 | 展示了多階段迭代,但未交代完整提示總輪數和人工介入總量 |
| 普通企業站、電商站是否同樣更好 | 不能 | 3D 交互演示與常規業務網站的需求差異很大 |
| 響應式、可訪問性、表單等是否可靠 | 不能 | 演示重在視覺體驗,未展示這類工程細節的驗證 |
這四個問題恰恰是實際交付時最關心的部分。官方展示是“經過篩選的成果樣本”,而我們做項目時面對的是“平均表現和失敗率”,兩者之間隔着一次獨立對比。
2.3 GPT-6.2 Astra 網頁質量的四個分析維度
“好看”是一個模糊的詞。爲了讓判斷可以被檢驗,我們把它拆成四個維度。這些維度是本文提出的分析框架,不是官方指標。
2.3.1 信息層級:先看內容有沒有被組織好
好看的網頁首先是“好讀”的網頁。用戶能否在幾秒內知道這是什麼、能做什麼、下一步點哪裏,取決於標題、正文、行動按鈕之間的層級關係。官方提到的“更有目的性的佈局”,如果成立,最應該體現在這裏。
Paris Atlas 作爲沉浸式 3D 體驗,信息層級的要求與常規網站不同。它能展示視覺表現力,卻很難說明模型在內容密集型頁面上如何安排層級。
2.3.2 視覺一致性:多個頁面是否像同一個品牌
單頁驚豔不難,難的是多個頁面在字號、間距、色彩、組件樣式上保持一致。實際項目裏,設計系統的穩定性往往比單屏效果更影響交付質量。評估時應該至少生成兩到三個相互關聯的頁面,觀察它們是否共用同一套規則。
2.3.3 響應式:窄屏下是否依然可用
很多生成網頁在桌面寬度下效果不錯,一到手機就出現文字溢出、按鈕重疊或橫向滾動。本文查閱的 Paris Atlas 構建說明不足以驗證你的目標設備適配,仍需自行檢查。建議至少覆蓋手機、平板、桌面三種寬度。
2.3.4 功能閉環:看起來能用和真正能用
按鈕是否真的觸發動作,表單是否有校驗和錯誤提示,鍵盤 Tab 能否按順序聚焦,焦點狀態是否可見。這些屬於功能閉環,也是截圖永遠無法證明的部分。對於做網站的團隊來說,這一維度往往決定了後續返工量。
| 維度 | 檢查重點 | 適合的檢驗方式 | 官方展示的覆蓋程度 |
|---|---|---|---|
| 信息層級 | 標題、正文、行動按鈕的主次 | 盲評截圖 + 五秒理解測試 | 間接(發佈頁文字描述) |
| 視覺一致性 | 跨頁面的字號、間距、組件 | 多頁面並排盲評 | 未直接展示 |
| 響應式 | 手機/平板/桌面佈局 | 三種寬度截圖 | 未直接展示 |
| 功能閉環 | 按鈕、表單、鍵盤操作 | 人工逐項點測 | 部分(3D 交互可操作) |
2.4 GPT-6.2 Astra 網頁對比協議:如何自己驗證
要判斷自己的項目是否受益,最可靠的辦法是在自己的需求上做一次受控對比。下面這套協議是本文原創整理的方法,你可以直接複用。我們沒有用它跑出任何結果,表格中的數據欄需要你自己填寫。
2.4.1 GPT-6.2 Astra 對比的三條控制條件
- 同需求、同素材、同預算。 兩個模型拿到完全相同的需求文檔、圖片素材和品牌規範,統一工具權限、運行環境與可比的推理強度,提前約定最大迭代輪數或費用上限。相同 token 數不等於相同費用。
- 記錄過程成本。 每個模型從首版到“可交付”經歷了多少次修改,人工介入了多少分鐘,都要如實記錄。
- 盲評加實測。 截圖去掉模型標識後交給評審打分;同時人工逐項測試按鈕、表單和鍵盤操作。
這三條缺一不可。只比首屏截圖,會高估視覺好看但功能缺失的版本;只比修改次數,又會忽略最終效果的差距。
2.4.2 先信息架構、後實現的提示詞模板
爲了讓對比更公平,建議把提示拆成兩個階段。第一階段只讓模型輸出信息架構,第二階段再基於確認後的架構寫代碼。這樣能觀察模型是否真的“有目的”地組織內容,而不是直接堆砌漂亮組件。
【階段一:信息架構】
你是網站信息架構師。請根據下面的需求,只輸出信息架構,不要寫代碼:
1. 頁面清單及每頁目標
2. 每頁模塊順序與信息層級(H1/H2/正文/行動按鈕)
3. 導航路徑與關鍵交互
4. 需要但素材中缺失的內容,用【待提供】標註,不要編造數據、評價或客戶案例

需求:{粘貼需求文檔}
素材:{列出圖片與文案}

【階段二:實現】
基於已確認的信息架構生成網頁代碼,要求:
- 統一設計規則(字號、間距、顏色變量)
- 支持 375px / 768px / 1440px 三種寬度
- 所有按鈕和表單可操作,表單含校驗與錯誤提示,支持鍵盤 Tab 導航
- 缺失內容保留【待提供】佔位,不填僞造結果
模板中“不要編造數據、評價或客戶案例”這一條很重要。生成網頁時,模型容易補出虛構的用戶評價或業績數字,一旦上線就是事實錯誤。
2.4.3 用統一接口調用新舊模型
做對比時,用同一套代碼調用兩個模型可以減少變量。下面是最簡調用示例,模型名請以所用平臺控制檯的實際列表爲準,本文不假定任何模型已在某個平臺上線。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,OpenAI 兼容
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # 以控制檯模型列表爲準
    messages=[{"role": "user", "content": "按階段一輸出信息架構:……"}]
)
print(resp.choices[0].message.content)
查看完整對比腳本(兩階段 + 結果留檔)
import json, time, pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通過 API易 用同一套代碼切換模型
)

MODELS = ["OLD_MODEL_ID", "NEW_MODEL_ID"]  # 以控制檯實際可用名稱爲準
STAGE1 = open("prompt_stage1.txt", encoding="utf-8").read()
STAGE2 = open("prompt_stage2.txt", encoding="utf-8").read()
OUT = pathlib.Path("compare_runs")
OUT.mkdir(exist_ok=True)

def ask(model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    return r.choices[0].message.content

for i, model in enumerate(MODELS):
    tag = f"sample_{chr(65 + i)}"  # 用 A/B 代號,方便盲評
    msgs = [{"role": "user", "content": STAGE1}]
    ia = ask(model, msgs)
    msgs += [{"role": "assistant", "content": ia},
             {"role": "user", "content": STAGE2}]
    code = ask(model, msgs)
    (OUT / f"{tag}_ia.md").write_text(ia, encoding="utf-8")
    (OUT / f"{tag}_code.md").write_text(code, encoding="utf-8")
    # 只記錄元數據,修改次數和人工耗時由測試人員手動補充
    meta = {"tag": tag, "model": model, "time": time.strftime("%F %T"),
            "revisions": None, "manual_minutes": None}
    (OUT / f"{tag}_meta.json").write_text(json.dumps(meta, ensure_ascii=False))
腳本刻意把 revisions 和 manual_minutes 留空,由測試人員在真實修改後填寫。模型代號用 A/B 而不是模型名,截圖時也不要露出來源,這樣盲評纔有意義。
測試說明:上述代碼僅供流程參考,本文未實際運行。代碼未固定推理強度或實現瀏覽器驗收,不能直接當作完整評測工具。測試前需確認模型可用性、參數兼容性與實際服務商計價;使用同一渠道也不能自動消除工具、配置或路由差異。
2.4.4 GPT-6.2 Astra 對比記錄模板
| 記錄項 | 樣本 A | 樣本 B | 填寫說明 |
|---|---|---|---|
| 調用渠道 | 官方 API / API易 apiyi.com | 同左,必須一致 | 兩個樣本使用相同渠道 |
| 修改次數 | 待填寫 | 待填寫 | 從首版到可交付的追加指令數 |
| 人工耗時(分鐘) | 待填寫 | 待填寫 | 人工改代碼、調樣式的時間 |
| 盲評得分(四維度) | 待填寫 | 待填寫 | 至少 3 名評審,取中位數 |
| 按鈕/表單/鍵盤 | 待填寫 | 待填寫 | 逐項記錄通過或失敗 |
| 三種寬度表現 | 待填寫 | 待填寫 | 375 / 768 / 1440px 截圖 |
只有填完這張表,才能對“GPT-6.2 Astra 做網頁是否更好看、更好用”給出屬於你自己項目的結論。
把一個真實需求轉成可檢查的結果,再決定是否更換默認模型。本文的對比表仍是空白模板,並非已經完成的測評。
紙上得來終覺淺,絕知此事要躬行。——陸游《冬夜讀書示子聿》
📚 參考資料
-
OpenAI 官方發佈頁:Introducing GPT-6.2 Astra & Sol
- 鏈接: 官方發佈說明
- 說明: 本次發佈的官方信息來源,包含佈局與圖像選擇相關描述
-
OpenAI 開發者 Showcase:Paris Atlas
- 鏈接: Paris Atlas 構建過程
- 說明: 官方展示案例,介紹 Blender 地標轉 Three.js 的巴黎步行/駕駛體驗
-
GPT-6.2 Astra 模型文檔:輸入輸出能力。
- ChatGPT Work 與 Codex 官方說明:上線範圍。
- OpenAI API 更新日誌:2026-11-17 發佈記錄。
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心