Zusammenfassung: Dieser Artikel wertet öffentlich zugängliche Testberichte Dritter aus und analysiert, wie sich Qwen4-Max-Preview bei Aufgaben wie dem Greifautomaten, der Reparatur eines Python-Dienstes und der Suche in 1.600 Tickets geschlagen hat. Außerdem zeigt er die Grenzen des Modells auf, was Laufzeit und wissenschaftliche Einschätzungen angeht.
Fazit zuerst: Die Kernaussage zur Programmierfähigkeit von Qwen4-Max-Preview
Öffentliche Testberichte zeigen: Qwen4-Max-Preview kann mehrstufige Entwicklung vorantreiben, Tests ergänzen und überprüfbare Projekte abliefern. Der stärkste Beleg stammt aus einer Code-Reparaturaufgabe: Das Modell reproduziert zuerst den Fehler, ergänzt dann neue Tests, schickt echte HTTP-Anfragen und prüft die Datenintegrität – am Ende laufen alle 57 Tests durch. Die Schwachstellen liegen ebenso klar auf der Hand: Bei komplexen Aufgaben dauert es lange, die Greifautomat-Aufgabe brauchte rund 75 Minuten. In einer Forschungsaufgabe ging die Deutung der Rechenergebnisse über das hinaus, was die Belege hergaben. Deshalb brauchen sowohl komplexe Liefergegenstände als auch wissenschaftliche Schlussfolgerungen eine Prüfung durch Entwickler.
Im Folgenden geht es zuerst um die Greifautomat-Aufgabe, danach um einen Bericht über 12 Aufgaben, wobei der Schwerpunkt auf zwei überprüfbaren Belegen liegt: der Code-Reparatur und der Ticket-Suche. Anschließend zeigt ein Fall zur nichtnegativen Matrixfaktorisierung die Grenzen der Schlussfolgerungen des Modells. Danach diskutieren wir Effizienzfragen anhand eines Werkzeugvergleichs derselben Greifautomat-Herausforderung und sagen zum Schluss, welche Arten von Aufgaben sich für das Modell eignen. Dieser Artikel ist eine Auswertung öffentlicher Berichte – wir haben die Projekte der Autoren nicht selbst erneut ausgeführt; alle Zahlen sind mit Quelle und Testbedingungen versehen.
To Know: Die 9 Begriffe zum Verständnis der Qwen4-Max-Preview-Bewertung
| Begriff | Erklärung |
|---|---|
| Agent | Arbeitsweise, bei der das Modell die Schritte selbst plant, Tools aufruft und die Aufgabe schrittweise vorantreibt. |
| Zustandsautomat | Steuert das Programmverhalten über eine Menge von Zuständen und Übergangsregeln, zum Beispiel beim Greifautomaten „Bewegen – Greifen – Anheben – Abrechnen“. |
| Regressionstest | Nach einer Codeänderung werden bestehende Funktionen erneut geprüft, um sicherzustellen, dass das bisherige Verhalten nicht beeinträchtigt wurde. |
| HTTP-Anfrage | Eine vom Client an den Server gesendete Anfrage, mit der geprüft wird, welche Ergebnisse die Schnittstelle im echten Betrieb liefert. |
| Hash-Prüfung | Berechnet einen Digest-Wert des Dateiinhalts; durch den Vergleich lässt sich feststellen, ob die Originaldaten oder Testdateien verändert wurden. |
| Token-Durchsatz | Anzahl der Token, die pro Zeiteinheit verarbeitet oder erzeugt werden; der Wert hängt von Tools, Netzwerk und Laufzeitumgebung ab. |
| Kontextabruf | In den vielen mit einer Anfrage übermittelten Materialien die Zielinformationen lokalisieren und miteinander in Beziehung setzen. |
| Nichtnegative Matrixfaktorisierung | Algorithmus, der eine nichtnegative Datenmatrix näherungsweise in zwei nichtnegative Faktormatrizen zerlegt, die miteinander multipliziert werden. |
| Lokales Optimum | Eine Lösung, die sich im unmittelbaren Umfeld nicht weiter verbessern lässt; ob eine Lösung lokal optimal ist, erfordert zusätzliche mathematische Bedingungen oder Analysen. |
1 75 Minuten für ein Greifautomaten-Spiel: eine komplexe Programmieraufgabe mit Qwen4-Max-Preview
1.1 Was die Greifautomaten-Aufgabe prüft
Am 12. November 2026 veröffentlichte die Plattform 人人都是产品经理 einen Praxistest zu Qwen4-Max-Preview auf Basis von Qoder. Eine der komplexesten Aufgaben darin war ein interaktives Greifautomaten-System. Die Aufgabe bündelte mehrere Programmierhürden in einem Projekt: mechanische Interaktion und Kraftrückkopplung, das Schwingen des an einem Seil hängenden Greifers, Kollisionen zwischen den Plüschtieren, eine Zustandsmaschine für den Steuerungsablauf und schließlich die Punkte-Logik.
Solche Aufgaben sind kaum mit einer One-Shot-Generierung zu bewältigen. Die Physik, die Zustandswechsel und die Punkteregeln hängen voneinander ab. Das Modell muss wiederholt schreiben, ausführen, beobachten und korrigieren. Damit wird geprüft, wie gut es eine Aufgabe in mehreren Schritten wie ein Agent voranbringt.
1.2 Aufzeichnung von Dauer, Geschwindigkeit und Verbrauch durch den Autor
| Kennzahl | Aufzeichnung des Autors | Testbedingungen und Hinweise |
|---|---|---|
| Gesamtdauer | ca. 75 Minuten | Qoder-Umgebung, eine einzelne Aufgabe |
| Ausgabegeschwindigkeit | ca. 33 Tokens/s | in dieser Aufgabe beobachtete Geschwindigkeit |
| Credits-Verbrauch | ca. 65 | Schätzung des Autors, Abrechnung über den Token Plan |
| Ergebnisqualität | recht solide | subjektive Einschätzung des Autors; insgesamt auf Augenhöhe mit Kimi K3.1 |
Diese Zahlen gelten nur für diese Aufgabe. Credits sind die Abrechnungseinheit des Token-Plan-Abos. Der tatsächliche Verbrauch hängt vom Input, von Cache-Treffern, vom Output, von den Reasoning-Tokens und von Tool-Aufrufen ab. 65 Credits sagen daher nur etwas über die Größenordnung der Kosten dieser Aufgabe aus. Auch die 33 Tokens/s sind ein Wert, der unter bestimmten Bedingungen beobachtet wurde.
Derselbe Bericht hält noch mehrere andere Aufgaben fest. Bei einer Tuschmalerei-Aufgabe, für die nur NumPy und PIL zum Einsatz kamen, erzeugte das Modell über 1.000 Zeilen Code und rund 4.019 Pinselstriche. Zur Selbstprüfung nutzte es Statistiken zur Pixelhelligkeit und einen ASCII-Konturscan. Als es bemerkte, dass eine Schwalbe einen schwarzen Fensterblock überlappte, passte es die Koordinaten von sich aus an. Der Autor hält die Codeorganisation und die Selbstprüfung für recht stark, bei der ästhetischen Umsetzung sieht er jedoch noch Luft nach oben.
2 Was die zwölf realen Aufgaben von Qwen4-Max-Preview abdecken
2.1 Ein umfassenderer Testbericht
Am 16. November veröffentlichte die Plattform „人人都是产品经理“ (wörtlich: „Jeder ist Produktmanager“) einen Testbericht von Z Finance. Der Autor gibt an, 12 Aufgaben abgeschlossen und die zentralen Ergebnisse stichprobenartig überprüft und nachvalidiert zu haben. Die folgende Tabelle fasst die im Bericht abgedeckten Aufgaben zusammen:
| Kategorie | Testaufgabe | Hauptsächlich geprüfte Fähigkeiten |
|---|---|---|
| Visuelle Generierung | Pelikan auf dem Fahrrad als SVG | Visuelles Verständnis, Codegenerierung |
| Finanzanalyse | Gemeinsame Analyse von drei Geschäftsberichten | Verständnis langer Dokumente, Bilanzierungslogik |
| Diagrammerkennung | Balkendiagramm der Apple-Produktumsätze | Diagramme lesen, Zahlenwerte schätzen |
| Bürokooperation | Drei Überarbeitungsrunden eines Sitzungsprotokolls | Kontextbewahrung, Konsistenz bei Änderungen |
| Datenverarbeitung | Bereinigung von 44 Zeilen Verkaufsdaten | Deduplizierung, Einheitenumrechnung, Formeln |
| Präsentation | PPT zum Börsengang von 平头哥 (T-Head) | Echtzeit-Recherche, Dateierzeugung |
| Recherche in langen Texten | 1.600 Support-Tickets | Verknüpfung über Datensätze hinweg, Filterung nach Bedingungen |
| Codewartung | Reparatur eines Python-Ticketdienstes | Fehlerlokalisierung, Tests und Regression |
| Wissenschaftliche Reproduktion | Nicht-negative Matrixfaktorisierung | Algorithmusimplementierung, numerische Validierung |
| Webentwicklung | Präsentationsseite für Prospektmaterialien | HTML, Offline-Auslieferung, Interaktivität |
| Simulationssystem | Regengarten-Simulation | Interaktionsdesign, numerische Berechnung |
| Spieleentwicklung | Kleines 3D-Spiel zum Thema vier Jahreszeiten | 3D-Szenen, Zustandsverwaltung, Interaktion |
2.2 Fünf bemerkenswerte Fälle
Von diesen 12 Aufgaben zeigen die folgenden fünf am deutlichsten, wie gut das Modell „brauchbare Ergebnisse“ liefern kann:
- Geschäftsberichtsanalyse: Als Eingabe dienten die Jahresberichte FY2026 von Apple und Costco sowie die zweite Fassung des Prospekts von Anthropic; die Aufgabe war in etwa 8 Minuten erledigt. Alle 6 stichprobenartig geprüften Kennzahlen waren korrekt. Das Modell unterschied Betriebsverlust von Nettoverlust, wies auf den Einfluss von Änderungen des beizulegenden Zeitwerts von Wandelanleihen auf den Nettoverlust hin und erfand keine nicht veröffentlichten Zukunftsprognosen.
- Excel-Bereinigung: In den 44 Zeilen Verkaufsdetails steckten doppelte Datensätze, Duplikate, die sich nur durch Leerzeichen unterschieden, zwei Einheiten (Yuan und Zehntausend Yuan), drei Datumsformate und 5 fehlende Bestellungen. Nach der Bereinigung blieben 35 Zeilen übrig, die vier Regionen ergaben zusammen 215.700 Yuan, und alle 5 Summenzellen nutzten echte Formeln – nach einer Änderung an den Details aktualisierten sich die Summenwerte automatisch.
- PPT-Erzeugung: Das Modell erkannte per Echtzeit-Recherche die Informationen aus der Ausgliederungsanzeige, erzeugte eine editierbare PPT und unterschied Bewertungsprognosen von der Emissionspreisfindung; nachdem in einer zweiten Runde die Zielgruppe angepasst worden war, blieben alle 20 ursprünglichen Kennzahlen, Daten und Namen unverändert. Der Autor wies allerdings auch auf fehlende Produktlinien hin.
- Ticket-Recherche und Python-Reparatur: Diese beiden Punkte liefern die konkretesten Belege und werden in Abschnitt 4 bzw. Abschnitt 3 ausführlich behandelt.
Gemeinsam ist all diesen Aufgaben, dass sich das Ergebnis überprüfen lässt: Verknüpfen sich die Formeln, stimmen die Zahlen mit dem Original überein, laufen die Tests durch. Solche Belege überzeugen mehr als „da wurde ein Stück Code generiert, das richtig aussieht“.
3 57 Tests bestanden: der überzeugendste technische Nachweis für Qwen4-Max-Preview
3.1 Der Reparaturablauf im Detail
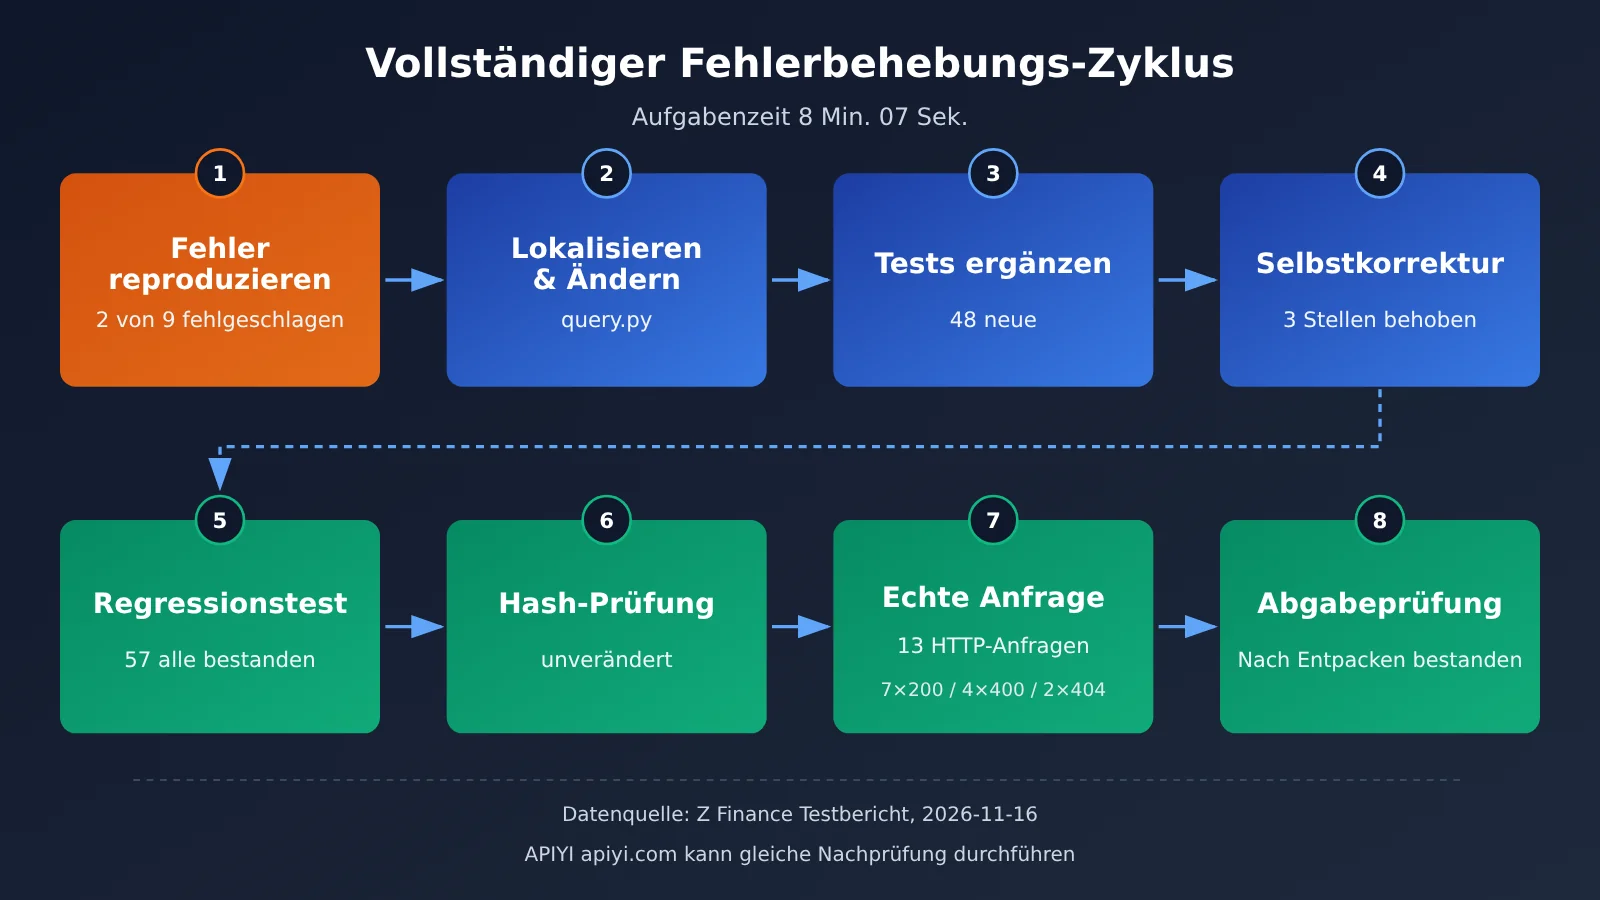
Gegenstand des Tests ist ein Ticket-Abfragedienst, geschrieben mit der Python-Standardbibliothek. Die Fehler betreffen kombinierte Filterung, Sortierung, Paginierung und Parameterprüfung. Die Aufgabe verlangte, die Fehler zu beheben und dabei die Schnittstelle, die Originaldaten und die vorhandenen Tests unverändert zu lassen. Der Bericht dokumentiert für diese Aufgabe eine Laufzeit von 8 Minuten 07 Sekunden. Der Ablauf im Einzelnen:
| Schritt | Aktion des Modells | Technische Bedeutung |
|---|---|---|
| Fehler reproduzieren | Zuerst die 9 vorhandenen Tests ausführen, dabei schlagen 2 fehl | Erst bestätigen, dass das Problem existiert, dann eingreifen |
| Änderung lokalisieren | Die Änderungen konzentrieren sich im Wesentlichen auf query.py | Enger Änderungsbereich, weniger Nebenwirkungen |
| Tests ergänzen | 48 neue Tests hinzugefügt | Deckt Randfälle ab, die die ursprünglichen Tests nicht erfasst haben |
| Selbstkorrektur | 3 Probleme in den selbst geschriebenen Tests behoben | Fehlerhafte Tests erkannt und umgehend korrigiert |
| Regression | Am Ende laufen alle 57 Tests durch | 9 ursprüngliche plus 48 neue Tests |
| Vollständigkeitsprüfung | Hash-Prüfung über Originaldaten und ursprüngliche Tests, Hashes unverändert | Belegt, dass nicht durch Manipulation von Daten oder Tests „bestanden“ wurde |
| Echte Anfragen | Lokalen Dienst gestartet, 13 HTTP-Anfragen gesendet: 7×200, 4×400, 2×404 | Prüft Normalantworten und Fehlerbehandlung der Schnittstelle im laufenden Betrieb |
| Abnahme des Lieferpakets | Finales Paket entpackt und erneut ausgeführt, Tests laufen durch | Bestätigt, dass das gelieferte Artefakt eigenständig lauffähig ist |
3.2 Warum das mehr aussagt als generierter Code
Beim KI-gestützten Programmieren gibt es zwei typische Fehlermuster: Erstens werden Tests oder Daten so verändert, dass die Tests „grün“ werden. Zweitens besteht der Code zwar die Tests, scheitert aber im echten Betrieb. Die Hash-Prüfung dieser Aufgabe adressiert das erste Risiko, die echten HTTP-Anfragen und die erneute Prüfung des Lieferpakets das zweite. Die 4 Antworten mit Status 400 und die 2 mit 404 zeigen, dass das Modell auch die Fehlerpfade geprüft hat: Parametervalidierung und die Behandlung nicht existierender Ressourcen wurden tatsächlich getestet.
Dieser Ablauf entspricht dem Vorgehen erfahrener Entwickler beim Bugfixing: reproduzieren, beheben, Tests ergänzen, Regression, Auslieferung. Er belegt, dass Qwen4-Max-Preview in einem Dienst mit klaren Regeln und überschaubarem Umfang einen vollständigen Wartungszyklus beherrscht. Es bleibt dennoch die Dokumentation einer einzelnen Aufgabe und lässt sich nicht in eine allgemeine Erfolgsquote bei der Code-Reparatur umrechnen.
Der praktische Wert eines 4-Millionen-Kontexts: eine Spur, die in 1.600 Tickets 741 Zeilen auseinanderliegt
4.1 Testdesign und Ergebnisse
Das offiziell angegebene Kontextfenster von Qwen4-Max-Preview beträgt 1.000.000 Tokens. Die Fenstergröße ist nur die Obergrenze der Kapazität – ob sie praktisch etwas bringt, hängt davon ab, ob das Modell in einer großen Menge Material die richtigen Zusammenhänge herstellen kann. Der Ticket-Test im Bericht von Z Finance beantwortet genau diese Frage.
Die Testdaten bestanden aus 1.600 Kundensupport-Tickets mit rund 500.000 Byte Umfang. Die entscheidenden Hinweise verteilten sich auf zwei Datensätze, die 741 Zeilen auseinanderlagen, und es wurden insgesamt 5 Fragen gestellt. Laut Bericht wurden alle 5 Fragen korrekt beantwortet. Die konkreten Leistungen im Einzelnen:
- Zwei verstreute Tickets wurden miteinander verknüpft und der Erstattungsbetrag von 1.386 Yuan samt dem Bearbeiter ermittelt.
- Anhand des Genehmigungsdatums wurde beurteilt, ob die neue Regelung für Entschädigungsgutscheine auf diesen Fall anwendbar ist.
- Es wurden 62 Tickets gezählt, die die vorgegebenen Bedingungen erfüllen – übereinstimmend mit dem Ergebnis der Skript-Auszählung.
- Zwei Gruppen doppelter Bestellnummern wurden gefunden und unterschieden, welche Gruppe einen normalen Ablauf und welche einen Konflikt bei den Kundeninformationen darstellt.
4.2 Byte und Token sind zwei verschiedene Einheiten
Rund 500.000 Byte sind die Dateigröße; die Token-Anzahl hängt von der Tokenisierung und dem Verhältnis von Chinesisch zu Englisch ab. Beides muss getrennt berechnet werden. Dieser Test belegt „bereichsübergreifende Verknüpfung und bedingte Filterung in mittelgroßen Datenbeständen“. Sein Umfang liegt weit unter der Obergrenze von 1.000.000 Tokens und taugt deshalb nicht als Stresstest für die Maximalkapazität.
Der Wert des dritten Ergebnisses liegt darin, dass es überprüfbar ist: Die 62 stimmen mit der Skript-Auszählung überein, was zeigt, dass sich die Zählung des Modells durch ein deterministisches Programm nachprüfen lässt. In der Praxis empfiehlt es sich, genauso vorzugehen: die vom Modell gelieferten statistischen Ergebnisse per Skript gegenprüfen und das Modell dann für die Teile einsetzen, die ein Skript kaum leisten kann – also Verknüpfung und Interpretation.
5 Eine nicht zu unterschätzende Schwäche: Überzogene Schlussfolgerungen von Qwen4-Max-Preview bei wissenschaftlicher Argumentation
5.1 Die Berechnung stimmt, die Interpretation geht über die Belege hinaus
Die Aufgabe zur wissenschaftlichen Reproduktion verlangte, den multiplikativen Update-Algorithmus der nichtnegativen Matrixfaktorisierung gemäß einer vorgegebenen Arbeit zu implementieren. Die Eingabematrix hatte die Dimension 48×36, es wurden drei verschiedene Startwerte verwendet, jeweils mit 500 Iterationen. Der Bericht hält fest, dass das Modell 10 Minuten und 06 Sekunden benötigte und Code, numerische Ergebnisse, Diagramme und Logs lieferte; die drei Ergebnisgruppen umfassten jeweils 52 Prüfpunkte, die Schlüsselprüfpunkte der Gruppe A stimmten mit den öffentlich verfügbaren Referenzergebnissen überein, zusätzlich gab es 63 Selbstprüfungsprotokolle.
Das Problem liegt im Schlussfolgerungsteil. Nur weil die Zielfunktion kontinuierlich sank, interpretierte das Modell das Ergebnis als Konvergenz zu einem lokalen Optimum. Die Autoren weisen darauf hin, dass dies eine Überinterpretation ist.
5.2 Drei Begriffe, die getrennt beurteilt werden müssen
Dieser Fall betrifft drei Ebenen der Beurteilung, wobei die jeweils spätere stärkere Belege erfordert als die vorherige:
- Sinken der Zielfunktion: eine Konstruktionseigenschaft der multiplikativen Update-Regel, die sich direkt aus Logs und Diagrammen beobachten lässt.
- Numerische Iterationskonvergenz: erfordert die Prüfung, ob sich die Änderungen der Iterationsgrößen stabilisieren, sowie ein klar definiertes Abbruchkriterium.
- Konvergenz zu einem lokalen Optimum: erfordert die Überprüfung der Optimalitätsbedingungen, etwa der KKT-Bedingungen; allein aus einem sinkenden Funktionswert lässt sich das nicht ableiten.
Das zeigt, dass die Ausführungsfähigkeit und die argumentative Strenge des Modells getrennt bewertet werden müssen. Numerische Berechnungen lassen sich anhand von Prüfpunkten verifizieren, wissenschaftliche Schlussfolgerungen hingegen müssen von Personen mit entsprechendem Hintergrund geprüft werden. In Szenarien wie Forschung, der Reproduktion von Papers oder technischen Berichten sollte der „Schlussfolgerungsabschnitt“ der Modellausgabe als Entwurf behandelt werden.
6 Qwen4-Max-Preview im Aufgabenvergleich mit anderen Programmierwerkzeugen
6.1 Vergleichsdaten zur Greifautomaten-Herausforderung
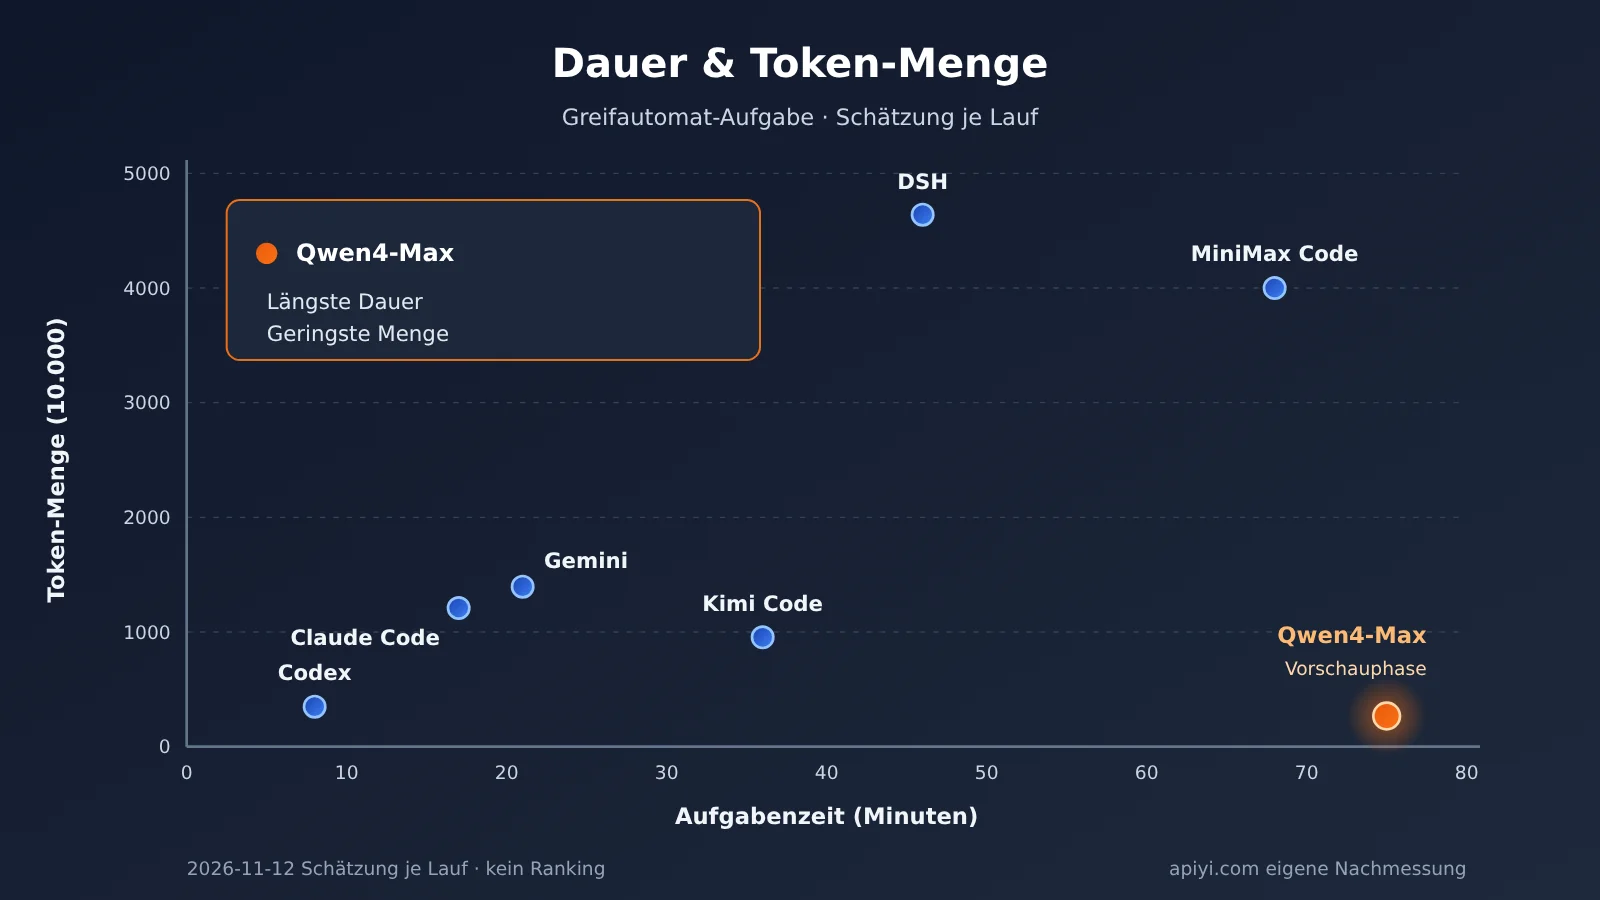
Der Bericht vom 12. November enthält außerdem die Ergebnisse derselben Greifautomaten-Herausforderung für verschiedene Werkzeuge. In der Originaltabelle ist die Qwen-Zeile als Qwen4-Max gekennzeichnet, mit einem Testzeitpunkt am 12. November – also vor dem offiziellen Start am 16. November – was dem Modell aus der Vorschauphase entspricht.
| Werkzeug/Modell | Dauer | Gesamt verarbeitete Tokens (geschätzt) | Ausgabe-Tokens | Einstieg zum Nachtest |
|---|---|---|---|---|
| Codex | 8 Minuten | 3,5 Mio. | 28 Tsd. | Entsprechendes offizielles Werkzeug |
| Claude Code | 17 Minuten | 12,15 Mio. | 130 Tsd. | Offizielles Werkzeug; Claude-Modelle über APIYI apiyi.com aufrufbar |
| Gemini | 21 Minuten | 13,94 Mio. | 81 Tsd. | Offizielles Werkzeug; Gemini-Modelle über APIYI aufrufbar |
| Kimi Code | 36 Minuten | 9,5 Mio. | 59 Tsd. | Entsprechendes offizielles Werkzeug |
| DSH | 46 Minuten | 46,44 Mio. | 281 Tsd. | Entsprechendes offizielles Werkzeug |
| MiniMax Code | 68 Minuten | 40 Mio. | 198 Tsd. | Entsprechendes offizielles Werkzeug |
| Qwen4-Max (Vorschauphase) | 75 Minuten | 2,69 Mio. | 55 Tsd. | Token Plan (Qoder) |
6.2 Wie diese Daten zu lesen sind
Die Daten zeigen einen deutlichen Kontrast: Qwen4-Max-Preview hat bei dieser Aufgabe die geringste Gesamt-Tokenmenge verarbeitet, rund 2,69 Mio., brauchte dafür aber am längsten, etwa 75 Minuten. Zusammen mit der beobachteten Geschwindigkeit von rund 33 Tokens/s wird klar, dass der Engpass dieser Aufgabe in der Generierungsgeschwindigkeit lag – die verbrauchte Tokenmenge selbst war nicht besonders groß.
Diese Daten eignen sich aus drei Gründen nicht für eine Rangliste: Die Token-Gesamtzahlen sind Schätzungen des Autors; der Anteil an Kontext-Caching, die Aufrufstrategien und die Ausführungsart unterscheiden sich zwischen den Werkzeugen; und die konkreten Versionen der Modelle in der Tabelle sind nicht einheitlich dokumentiert. Eine niedrige Token-Verarbeitungsmenge kann aus weniger wiederholtem Einlesen resultieren oder aus unterschiedlichen Caching-Strategien auf Werkzeugebene – das lässt sich mit den vorliegenden Materialien nicht auseinanderhalten. Belegen lässt sich damit lediglich: In dieser Werkzeugumgebung eignet sich Qwen4-Max-Preview für Aufgaben, bei denen Wartezeit keine große Rolle spielt und es eher auf vollständige Ablieferung ankommt.
7 Für welche Entwickler sich Qwen4-Max-Preview lohnt
7.1 Geeignete und mit Vorsicht zu nutzende Szenarien
Über beide Berichte hinweg zeigt Qwen4-Max-Preview bei den folgenden Aufgaben ein relativ stabiles Verhalten:
- Code-Pflege mit klaren Regeln: Reparatur- und Nachtest-Aufgaben, bei denen bereits Tests existieren und die Problemgrenzen klar sind.
- Suche und Verknüpfung in langen Dokumenten: dokumentübergreifendes Auffinden in Tickets, Logs, Verträgen und Finanzberichten, kombiniert mit einer Skriptprüfung der statistischen Ergebnisse.
- Büroautomatisierung: Datenbereinigung, Excel mit Formeln, bearbeitbare PPT und mehrstufige Überarbeitungen.
- Interaktive Prototypenentwicklung: einseitige Webseiten, simulierte Systeme und Spiele-Prototypen, zum Beispiel die im Bericht erwähnte Offline-Demoseite mit etwa 46 KB und ohne externe Abhängigkeiten.
Vorsicht ist bei drei Aufgabentypen geboten: bei interaktiver Entwicklung, die empfindlich auf Antwortzeiten reagiert (eine einzelne Aufgabe kann über eine Stunde dauern), bei Ergebnisausgaben, die eine strenge mathematische oder wissenschaftliche Begründung erfordern, sowie bei Produktionsänderungen mit hohen Zuverlässigkeitsanforderungen. Die Zusammenfassung der Berichtsautoren umfasst auch „bei Aufgaben mit breiterem Umfang gehen teilweise Informationen verloren“ und „das finale Lieferergebnis muss weiterhin manuell geprüft werden“.
Vor der Nutzung sind außerdem die offiziellen Einschränkungen zu beachten: Die Preview ist nur über den Alibaba-Cloud-Token-Plan in Werkzeugen wie Claude Code, Cursor und Qoder interaktiv nutzbar, eine nutzungsabhängige Abrechnung wird nicht unterstützt, und die Vorschauphase endet am 25. November 2026 um 24:00 Uhr (Peking-Zeit), danach wird sie abgeschaltet. Die offizielle Version Qwen4-Max ist bereits am 16. November online gegangen, und offiziell wird die Migration auf die finale Version empfohlen. Die Parameter beider Versionen unterscheiden sich: Die maximale Ausgabe im Denkmodus der offiziellen Version beträgt 262.144 Tokens, die der Preview 393.216 Tokens – beim Migrieren muss das Ausgabebudget neu gesetzt werden.
7.2 Mit den eigenen Aufgaben einen vergleichbaren Nachtest durchführen
Berichte aus zweiter Hand können höchstens belegen, dass „dieses Modell es schaffen kann“. Um zu entscheiden, ob es für dein Team geeignet ist, ist der direkteste Weg, den eigenen echten Code und die eigenen Tests als Vergleich heranzuziehen. Das folgende Beispiel sendet über eine OpenAI-kompatible Schnittstelle eine Code-Reparaturaufgabe und protokolliert die Laufzeit sowie den Token-Verbrauch. Verwende für den Modellnamen bitte den tatsächlichen Namen aus der Modellliste der Plattform.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle, OpenAI-kompatibel
)

resp = client.chat.completions.create(
    model="qwen4-max",  # Den tatsächlichen Namen aus der APIYI-Modellliste verwenden
    messages=[{"role": "user", "content": "Lies den folgenden Code und den fehlgeschlagenen Test und liefere einen minimalen Reparatur-Patch: ..."}]
)
print(resp.choices[0].message.content)
Skript für den Vergleichstest mit mehreren Modellen anzeigen
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Ein Key für den Aufruf mehrerer Modelle
)

# Durch die tatsächlichen Namen aus der Modellliste der Plattform ersetzen
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """Du erhältst den Quellcode eines Python-Dienstes und die Testergebnisse.
Anforderungen: 1) Erkläre zuerst die reproduzierte Ursache des Fehlers; 2) Ändere nur die notwendigen Dateien;
3) Ergänze Tests, die Grenzfälle abdecken; 4) Die Originaldaten und bestehenden Tests dürfen nicht verändert werden.
--- Quellcode und Testausgabe ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # Die Denk-Token von Reasoning-Modellen zählen ebenfalls zum Ausgabebudget, daher Platz einplanen
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # Den Patch in ein isoliertes Verzeichnis anwenden, Tests ausführen, die Originaldaten per Hash prüfen und erst danach bewerten
Das Skript sammelt nur Lösungsvorschläge und Verbrauchsdaten. Der Bewertungsschritt sollte die Vorgehensweise aus dem Bericht übernehmen: Den Patch in einem isolierten Verzeichnis anwenden, die bestehenden Tests und die neu hinzugefügten Tests ausführen und per Hashwert bestätigen, dass die Daten und alten Tests unverändert geblieben sind. Nur so sind die Ergebnisse für deine Codebasis aussagekräftig.
🚀 Schnellstart: Wenn du mehrere Modelle auf derselben Aufgabengruppe vergleichen möchtest, kannst du über APIYI apiyi.com ein kostenloses Testkontingent erhalten. Die Plattform bietet eine OpenAI-kompatible Schnittstelle; mit einem einzigen API-Schlüssel lassen sich gängige Modelle wie OpenAI, Claude und Gemini wechseln, sodass sich das Nachtest-Skript in derselben Evaluierungs-Pipeline ausführen lässt.
8 Häufige Fragen zum Qwen4-Max-Preview-Test
Frage 1: 75 Minuten, um einen Greifautomaten fertigzustellen – heißt das, dass es langsam ist?
In dieser Qoder-Aufgabe war die Dauer des Modells die längste in der Vergleichstabelle; die beobachtete Ausgabegeschwindigkeit lag bei etwa 33 Tokens/s. Das ist nur ein Messwert aus einer einzelnen Umgebung – Tool-Scheduling und Netzwerkbedingungen können das Ergebnis beeinflussen. Wenn Ihr Szenario empfindlich auf Wartezeiten reagiert, testen Sie es am besten mit einer eigenen Aufgabe.
Frage 2: Sagen 57 bestandene Tests etwas über die Erfolgsquote bei der Code-Reparatur aus?
Sie stehen für einen vollständigen, nachprüfbaren Reparaturvorgang und lassen sich nicht in eine Erfolgsquote umrechnen. Um die Leistung in Ihrem eigenen Projekt zu bewerten, können Sie über APIYI apiyi.com mehrere Modelle mit demselben Satz von Fehlerbeispielen vergleichen und sie anhand der Testergebnisse und der Hash-Prüfungsergebnisse bewerten.
Frage 3: Hat der Ticket-Test das 1-Million-Token-Kontextfenster validiert?
Nein. Dieser Test umfasst etwa 500.000 Bytes; die Token-Anzahl hängt von der Tokenisierung ab und liegt weit unter der Obergrenze des Fensters. Validiert wurden die Fähigkeit zur Verknüpfung über Datensätze hinweg und zur bedingten Filterung.
Frage 4: Was sollte man nach dem Ende der Preview tun?
Die offizielle Release-Version Qwen4-Max ist verfügbar, und es wird empfohlen, diese zu verwenden. Die Release-Version unterstützt eine API mit nutzungsbasierter Abrechnung; im Thinking-Modus beträgt die maximale Ausgabe 262.144 Tokens. Bei der Migration müssen Sie das Ausgabebudget anpassen. Die Verfügbarkeit und die Preise auf Drittanbieterplattformen ändern sich schnell. Prüfen Sie daher in der Modellliste von APIYI apiyi.com die aktuell verfügbaren Modellnamen, bevor Sie die Integration vornehmen.
Frage 5: Kann man den Schlüssel des Token Plans in das Backend einer eigenen Anwendung einbauen?
Nein. Laut offiziellen Vorgaben darf Token Plan nur interaktiv in den zugelassenen Programmierwerkzeugen und Agenten-Tools verwendet werden. Automatisierte Batch-Aufrufe per Skript und Backends selbst entwickelter Anwendungen fallen nicht in den zulässigen Bereich. Ein Verstoß kann zur Aussetzung des Abonnements oder zur Sperrung des Schlüssels führen. Für selbst entwickelte Anwendungen sollten Sie ein API-Produkt wählen, das dem vorgesehenen Nutzungsumfang entspricht.
9 Qwen4-Max-Preview im Test: Die wichtigsten Erkenntnisse
- Geschlossener Lieferzyklus: Die Code-Reparaturaufgaben decken Reproduktion, Fehlerbehebung, ergänzende Tests, Hash-Prüfung, echte Anfragen und abschließende Lieferprüfung ab; 57 Tests bestanden.
- Verknüpfung langer Texte: In 1.600 Tickets wurden über 741 Zeilen hinweg zusammenhängende Hinweise gefunden, alle 5 Fragen richtig beantwortet, 62 statistische Werte stimmen mit dem Skript überein.
- Büro-Lieferung: Excel-Formeln lassen sich verknüpfen, nach mehreren Überarbeitungsrunden der PPT bleiben 20 zentrale Fakten unverändert.
- Geschwindigkeit als Schwachpunkt: Die Greifautomat-Aufgabe dauerte etwa 75 Minuten, geringer Token-Durchsatz und lange Laufzeit.
- Grenzen der Schlussfolgerung: Die Berechnungen der wissenschaftlichen Reproduktion stimmen mit den Referenzergebnissen überein, die Schlussfolgerungen enthalten jedoch Überinterpretationen und erfordern eine manuelle Prüfung.
- Charakter der Belege: Alles oben Genannte sind Praxistests einer einzelnen Person an Aufgaben und stellen kein standardisiertes Ranking dar.
- Einstieg: Mit eigenem Code und eigenen Tests lässt sich gegenprüfen; über den API-Proxy-Dienst von APIYI apiyi.com kann man innerhalb einer einzigen Schnittstelle mehrere Modelle wechseln.
10 Fazit: Wo Entwickler Qwen4-Max-Preview einsetzen sollten
Der öffentliche Bericht zeichnet ein ziemlich klares Bild. Qwen4-Max-Preview eignet sich für Arbeiten mit klaren Regeln und überprüfbaren Ergebnissen: Codewartung mit Tests, Suche über mehrere Datensätze hinweg in umfangreichen Materialien, Datenverarbeitung mit Formeln und bearbeitbare Office-Dateien sowie interaktive Prototypenentwicklung. In diesen Aufgaben kann es selbst Tests ergänzen, Fehler selbst finden und überprüfbare Ergebnisse liefern.
Auch die Grenzen sind konkret: Komplexe Aufgaben dauern lange und eignen sich für den Hintergrundbetrieb; wissenschaftliche Schlussfolgerungen gehen leicht über die Belege hinaus und benötigen fachliche Prüfung; die Preview ist nur über den Token Plan in ausgewählten Tools interaktiv nutzbar und wird am 25. November eingestellt, für den langfristigen Einsatz sollte man auf die offizielle Version umsteigen.
Am pragmatischsten ist es, das Modell als einen Engineering-Assistenten zu behandeln, der den Wartungszyklus selbstständig abschließen kann, während der Entwickler die Schlussfolgerungen prüft und die endgültige Zusammenführung verantwortet. Vor dem Produktiveinsatz empfiehlt sich ein eigener Mehr-Modell-Vergleich mit echten Aufgaben; über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich Test und Vergleich im selben Ablauf durchführen.
📚 Referenzen
-
人人都是产品经理: Die Qwen4-Max-Vorschauversion ist da! Praxistest und Eindrücke: Praxistest des Qoder-Greifautomaten und Vergleich über Tools hinweg, 12.11.2026
- Link:
woshipm.com/ai/6492544.html - Hinweis: Quelle für die 75 Minuten Laufzeit, 33 Tokens/s, 65 Credits und die Vergleichstabelle
- Link:
-
人人都是产品经理: Praxistest von Qwen4-Max-Preview (Testbericht von Z Finance): Umfassender Test mit 12 Aufgaben, 16.11.2026
- Link:
woshipm.com/evaluating/6494229.html - Hinweis: Datenquelle für Code-Fixes, Ticket-Suche, wissenschaftliche Reproduktion und Office-Aufgaben
- Link:
-
Alibaba Cloud Model Studio: Qwen4-Max-Preview-Dokumentation: Offizielle Spezifikationen und Nutzungshinweise
- Link:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Hinweis: Kontextfenster, maximale Ausgabe, Vorschauzeitraum und Anbindungswege
- Link:
-
Alibaba Cloud Model Studio: Qwen4-Max-Dokumentation: Parameter und Abrechnung der offiziellen Version
- Link:
help.aliyun.com/zh/model-studio/qwen4-max - Hinweis: Ausgabebudget und Informationen zur nutzungsbasierten Abrechnung der offiziellen Version
- Link:
-
Alibaba Cloud: Token Plan – Berechtigungen und Nutzungsregeln: Einschränkungen des Nutzungsumfangs
- Link:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Hinweis: Anforderungen an die interaktive Nutzung und verbotene Szenarien
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI unter apiyi.com. Weitere Integrationsinformationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.