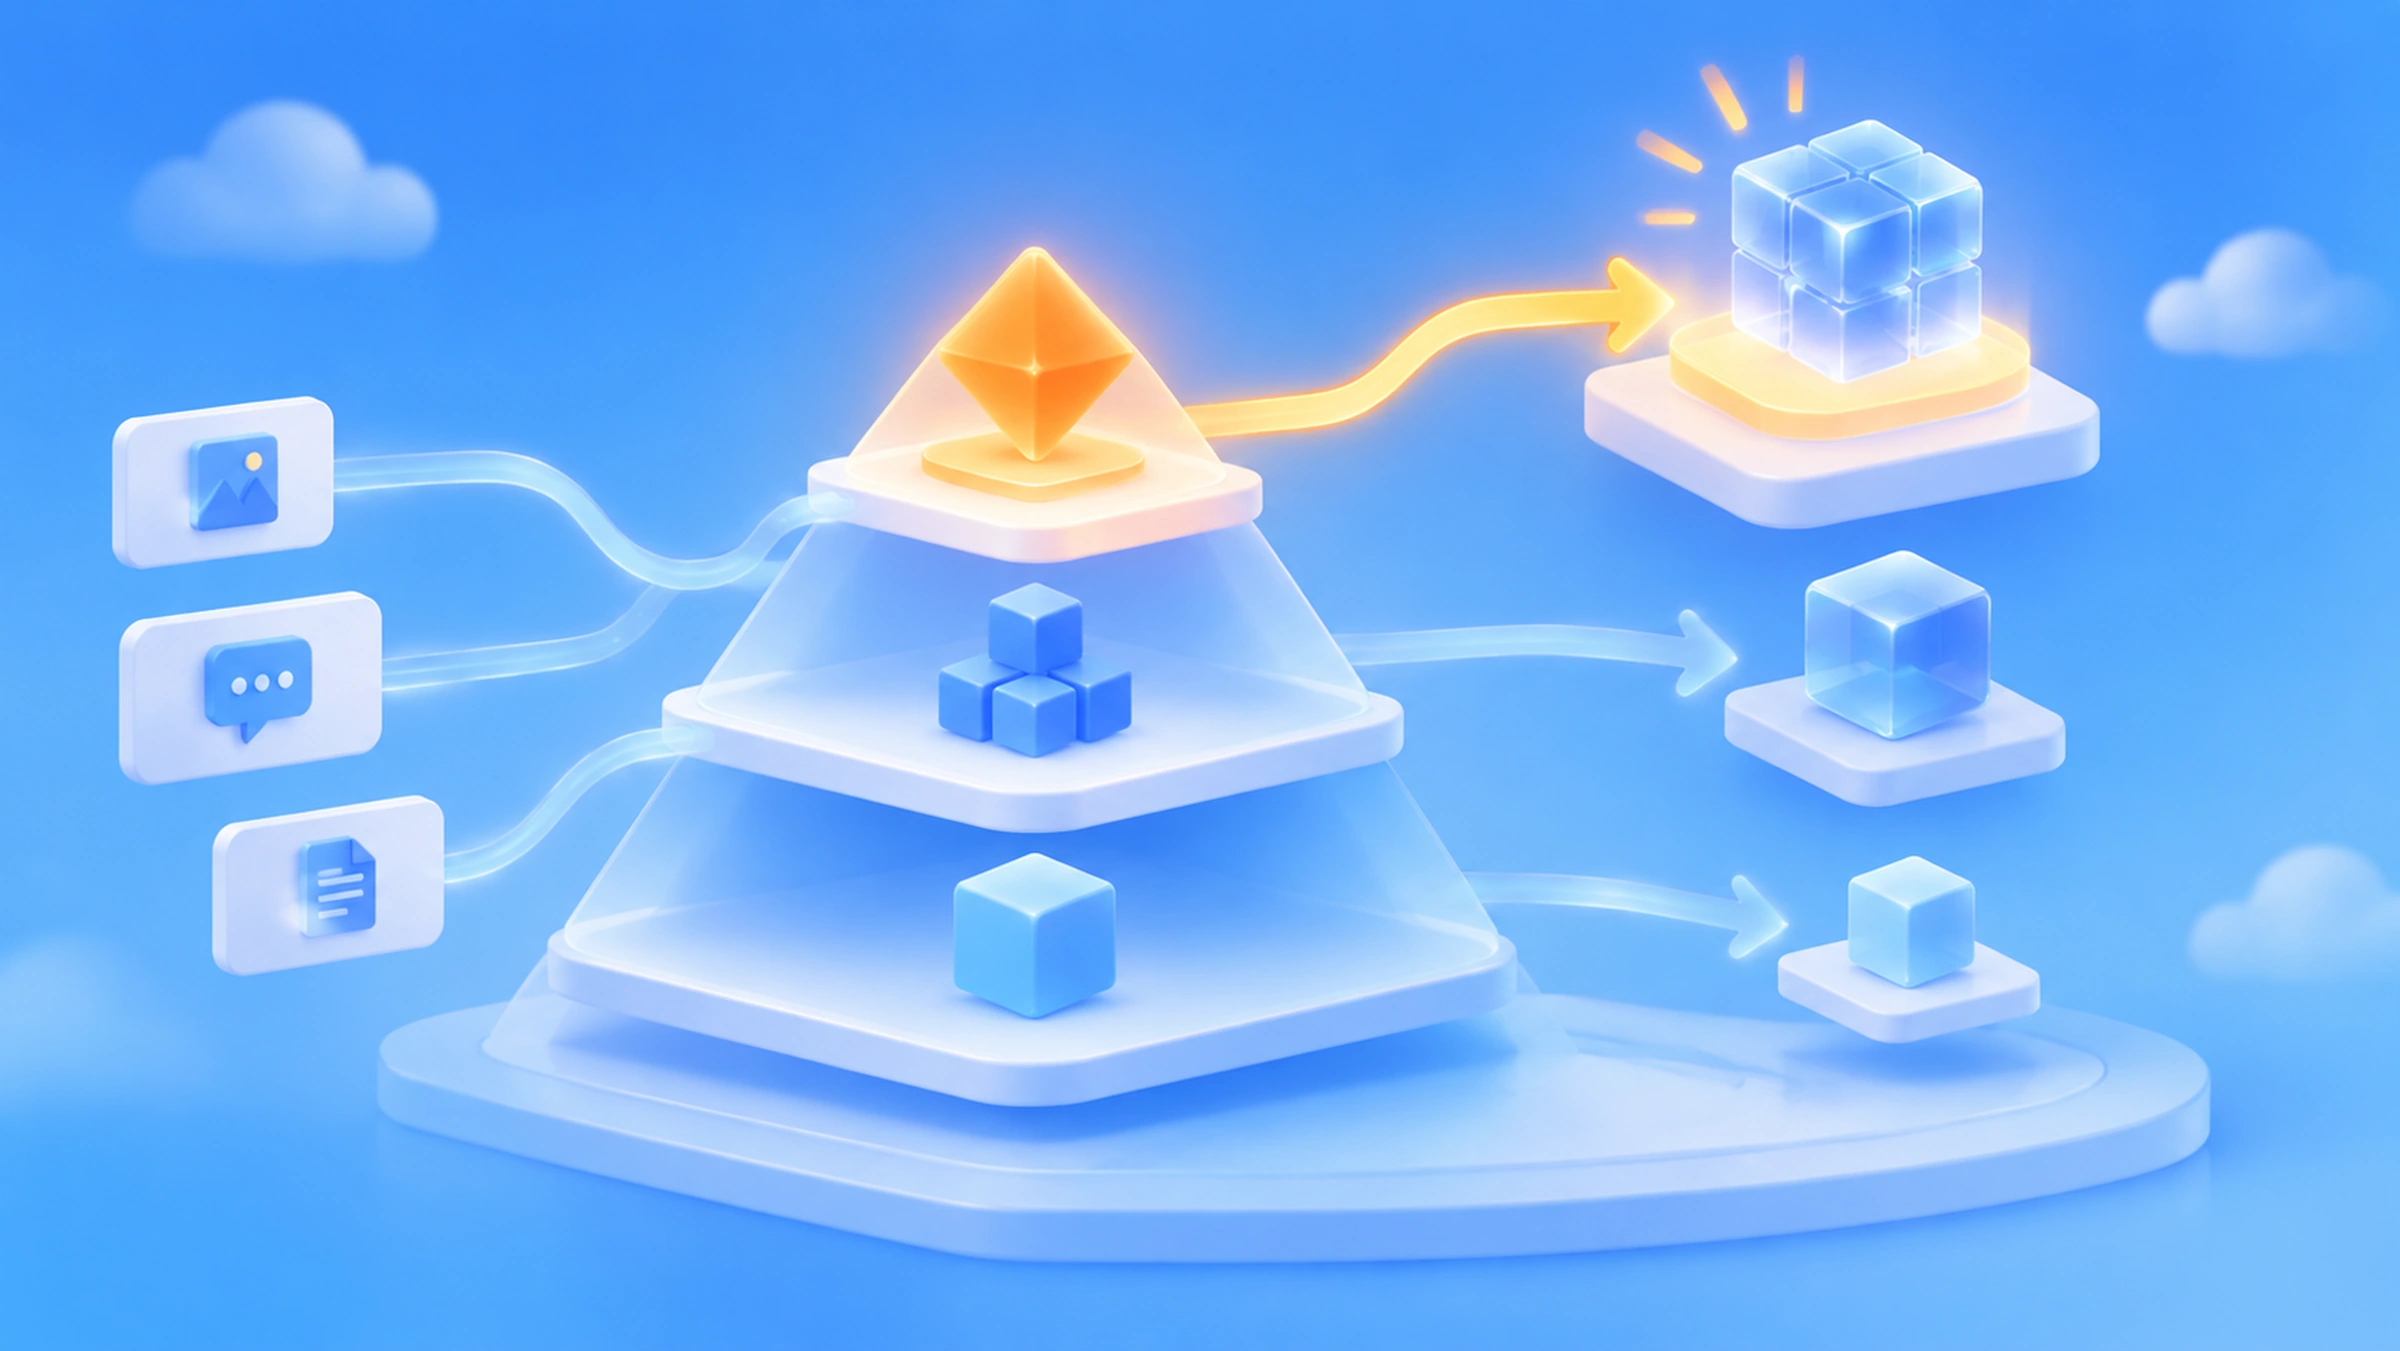
ملاحظة المؤلف: توضح هذه المقالة، من خلال ثلاثة أبعاد هي صعوبة المهمة وتكلفة الخطأ وحجم السياق، كيفية توجيه نماذج اللغة الكبيرة حسب طبقات المهام، مع إبقاء النموذج الرائد للطلبات التي تحتاجه فعلاً.
تتمثل الخطوة الأولى لدى كثير من الفرق عند اعتماد نماذج اللغة الكبيرة في إرسال جميع الطلبات إلى أقوى نموذج رائد متاح في الوقت الحالي. لا مشكلة في ذلك خلال مرحلة النماذج الأولية، لكن بمجرد أن يزداد حجم الطلبات ستنمو الفاتورة بسرعة، في حين أن معظم هذه الطلبات يمكن إنجازها فعلاً بواسطة نماذج صغيرة ومتوسطة. تقدم هذه المقالة منهجية تطبيقية لـ توجيه نماذج اللغة الكبيرة حسب طبقات المهام، تساعدك على تحديد الطلبات التي تستحق فعلاً استخدام النموذج الرائد.
ليست هذه مقالة ترويجية من نوع “النماذج الرخيصة تؤدي الغرض بالجودة نفسها”. فالنموذج الرائد لا يزال يتمتع بمزايا واضحة في الاستدلال المعقد، وتعديلات الشيفرة متعددة الخطوات، والمخرجات عالية المخاطر. وما يحاول التوجيه الطبقي حله هو “إسناد الطلب المناسب إلى النموذج المناسب”، وليس خفض التكلفة بأي ثمن.
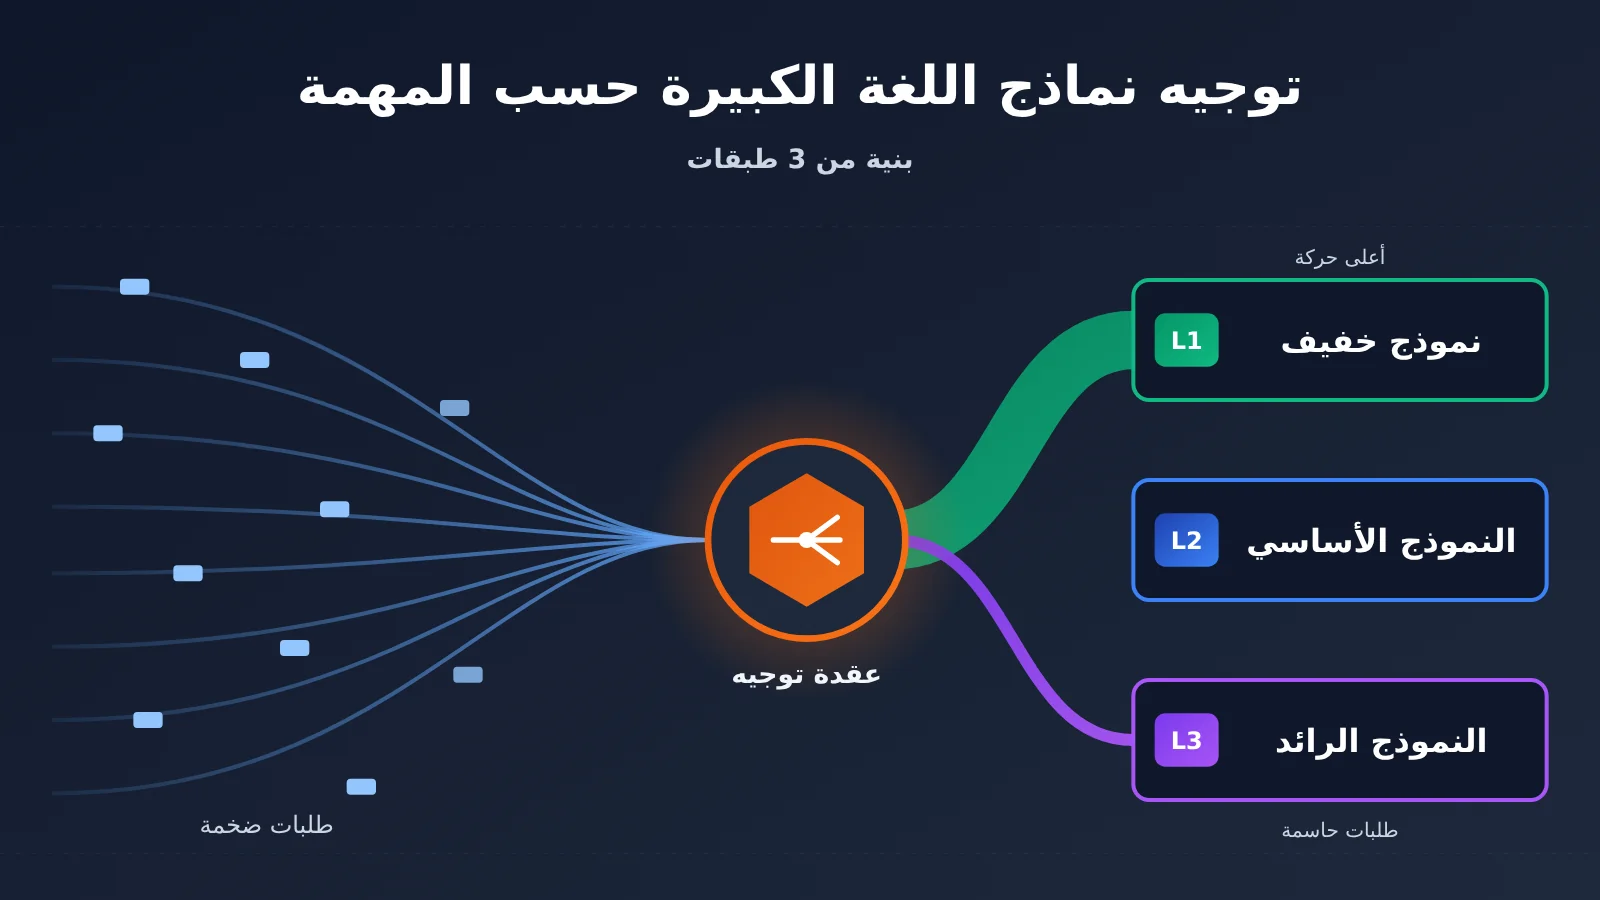
القيمة الأساسية: بعد قراءة هذه المقالة، ستكون لديك مجموعة معايير من 3 طبقات لتصنيف المهام، وقائمة إعدادات لقواعد التوجيه، وطريقة لمعايرة استراتيجية التوجيه بالبيانات بعد الإطلاق.
النقاط الأساسية لتوجيه النماذج اللغوية الكبيرة حسب طبقات المهام
قبل الخوض في الإعدادات المحددة، دعنا نعرض أولاً بعض المعايير الأساسية للحكم على توجيه الطبقات. فهي تحدد الطبقة التي ينبغي أن يقع فيها الطلب، وتحدد أيضًا ما إذا كانت استراتيجية التوجيه قابلة للصيانة على المدى الطويل.
| النقطة | الوصف | القيمة |
|---|---|---|
| التقسيم حسب المهمة لا حسب المستخدم | تختلف صعوبة الطلبات المختلفة من المستخدم نفسه اختلافًا كبيرًا، لذا ينبغي استخدام خصائص المهمة الواحدة كأساس للتوجيه | تجنب الهدر الناتج عن “توجيه جميع مستخدمي VIP إلى النموذج الرائد” |
| تكلفة الخطأ تتقدم على صعوبة المهمة | قد تحتاج المهام البسيطة لكن عواقب الخطأ فيها خطيرة إلى نموذج رائد أو تحقق ثانوي | التحكم في مخاطر الحوادث في بيئة الإنتاج |
| التوجيه الافتراضي إلى الطبقة الوسطى، والترقية أو التخفيض حسب الإشارات | يتولى النموذج الأساسي، كخيار احتياطي، تغطية معظم حركة المرور، ثم يُرقّى أو يُخفّض عند استيفاء شروط محددة | قواعد أقل، وصيانة أسهل، وتراجع أسهل |
| يمكن ترقية الفشل | عندما لا تجتاز مخرجات النموذج في الطبقة الأدنى التحقق، تُعاد المحاولة تلقائيًا إلى طبقة أعلى | مقايضة تكلفة إعادة محاولة صغيرة بجودة إجمالية أفضل |
| المعايرة بالبيانات | تسجيل معدل النجاح ومعدل إعادة المحاولة وتكلفة المهمة الواحدة لكل طبقة، وتعديل العتبات بانتظام | تظل استراتيجية التوجيه فعّالة مع استمرار تكرار النماذج وتحديثها |
شرح تفصيلي للتوجيه الطبقي: لماذا لا يمكن استخدام النماذج الرائدة في كل المهام؟
أصبح التوجيه الطبقي أكثر ضرورة في مشهد النماذج عام 2026. ووفقًا للمعلومات العلنية الواردة في المواد المرجعية، أصدرت OpenAI في 24 أبريل 2026 نموذج GPT-5.5 الذي يوفر سياقًا بسعة مليون رمز. وفي اليوم نفسه، أصدرت DeepSeek سلسلة V4 بنسختين، Pro وFlash، تدعمان أيضًا سياقًا بسعة 1M وتأتيان بأوزان مفتوحة بموجب ترخيص Apache 2.0. وفي الوقت ذاته، تواصل نماذج مثل سلسلة Claude Opus وGemini 3.1 Pro وKimi K2.6 تضييق الفجوة في مهام البرمجة والاستدلال.
عندما تقترب درجات النماذج الأعلى تصنيفًا في المعايير الشائعة، تصبح «تكلفة المهمة الواحدة» مقياسًا حاسمًا للتمييز بين النماذج. وقد أشارت مقالة تقييم من طرف ثالث إلى أن درجات عدة نماذج في معايير البرمجة أصبحت متقاربة جدًا، وأن الفارق الحقيقي يكمن في التكلفة المطلوبة لإنجاز كل مهمة. كما حللت مقالة أخرى أنه في سيناريوهات وكلاء البرمجة مثل Claude Code، لا يحتاج معظم استهلاك الرموز (tokens) إلى المعالجة بأفضل نموذج على الإطلاق. هذه آراء طرف ثالث، والنسب الدقيقة تختلف حسب طبيعة العمل، لكن الاتجاه واضح: استخدام النماذج الرائدة في المواضع الحرجة أكثر جدوى من استخدامها في كل شيء.
هناك نقطة أخرى يسهل إغفالها، وهي زمن الاستجابة. فالنماذج الرائدة عادة تفكر بعمق أكبر وتنتج مخرجات أطول، لذلك في المهام الفورية مثل التصنيف والاستخراج وإعادة الصياغة، يزداد وقت انتظار المستخدم بدلًا من أن ينخفض. وتشير المواد المرجعية إلى أنه بعد أن أصبح GPT-5.5 Instant النموذج الافتراضي في ChatGPT، انخفض طول الإجابات بوضوح وتراجع معدل الهلوسة، ما يدل على أن النسخ الأخف الموجهة إلى «الأسئلة والأجوبة السريعة» هي بحد ذاتها اتجاه منتج تتبناه الشركات المصنعة.
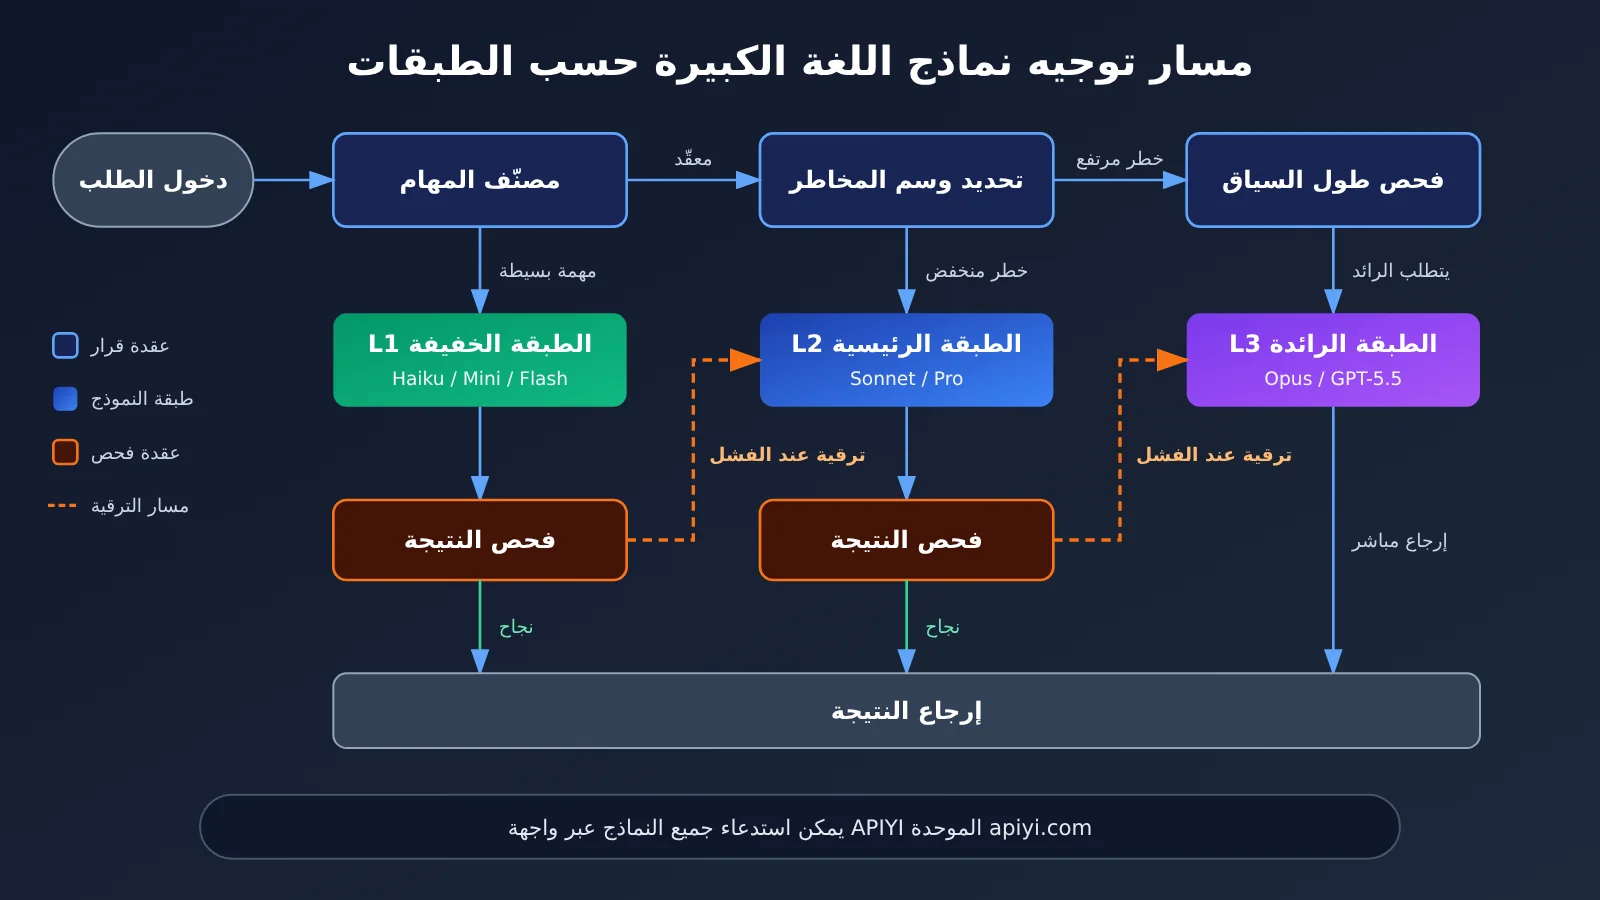
كيف نقسّم المستويات الثلاثة لمهام التوجيه الطبقي لنماذج اللغة الكبيرة
جوهر التقسيم الطبقي هو إيجاد النموذج «الكافي تمامًا» لكل نوع من المهام. والجدول التالي هو طريقة تقسيم عامة استخلصناها من عدة مشاريع، ويمكنك الإضافة أو الحذف حسب طبيعة أعمالك.
| المستوى | المهام النموذجية | إشارات الحكم | نوع النموذج الموصى به |
|---|---|---|---|
| L1 الطبقة الخفيفة | تصنيف النوايا، استخراج الكلمات المفتاحية، تحويل الصيغ، إعادة صياغة النصوص القصيرة، أسئلة وأجوبة بسيطة | المدخل قصير، والمخرج ذو بنية ثابتة، وتوجد قواعد تحقق واضحة | نماذج من فئة Haiku وMini وFlash |
| L2 الطبقة الرئيسية | المحادثات العادية، تلخيص المستندات، توليد أكواد بمتوسط التعقيد، أسئلة وأجوبة RAG | تحتاج إلى قدرة فهم وتنظيم معينة، لكن يمكن اكتشاف الأخطاء وتصحيحها | نماذج من فئة Sonnet، ونماذج مفتوحة المصدر كبيرة المعاملات، ونماذج عامة من فئة Pro |
| L3 الطبقة الرائدة | الاستدلال متعدد الخطوات، إعادة هيكلة الأكواد عبر ملفات متعددة، تصميم البنية المعمارية، المخرجات عالية المخاطر مثل القانونية أو المالية | اعتماد متعدد الخطوات، وأخطاء خفية وعالية التكلفة، وتحليل شامل لسياق فائق الطول | نماذج رائدة مثل فئة Opus وفئة GPT-5.5 |
طريقة تحديد مهام الطبقة الخفيفة L1
السمة الأساسية لطبقة L1 هي أن «المخرجات قابلة للتحقق منها برمجيًا». فتصنيف النوايا مثلاً لا يمكن أن يختار إلا تسمية واحدة من قائمة ثابتة، واستخراج JSON يمكن التحقق منه عبر schema، وتحويل الصيغ يمكن مقارنته بمدى اكتمال الحقول. وطالما كُتبت قواعد التحقق بدقة كافية، فإن الأخطاء الناتجة عن النماذج الخفيفة يمكن اعتراضها تلقائيًا وإعادة توجيهها لمستوى أعلى.
تشير مقالات المقارنة في المصادر المرجعية إلى أن النماذج الصغيرة مثل Claude Haiku 4.5 وGPT-5.4 Mini لكل منها تركيزها الخاص؛ فالأول أفضل في جودة الشفرة، والثاني يتفوق في السرعة. هذه النماذج مناسبة لاستيعاب الحركة عالية التكرار ومنخفضة التعقيد، وهي المصدر الرئيسي لتوفير التكلفة في التوجيه متعدد الطبقات.
طريقة تحديد مهام الطبقة الأساسية L2
تتحمل طبقة L2 معظم الطلبات التي «تحتاج إلى تفكير لكنها ليست صعبة»، وهي أيضًا هدف التوجيه الافتراضي الموصى به. وضبط القيمة الافتراضية على الطبقة الوسطى له فائدتان: الأولى تجنّب إساءة تصنيف المصنّف التي قد تؤدي إلى خفض أعداد كبيرة من الطلبات المعقدة إلى الطبقة الخفيفة، والثانية إبقاء قواعد الترقية والتخفيض بسيطة.
تستحق النماذج مفتوحة المصدر اهتمامًا خاصًا في هذه الطبقة. فقد رأت تقييمات طرف ثالث في المصادر المرجعية أن DeepSeek V4 Flash لا يبتعد كثيرًا عن V4 Pro في مهام البرمجة ذات الحدود الواضحة، وأن الفارق بين Kimi K2.6 وClaude Opus 4.6 على معايير البرمجة السائدة لا يتجاوز بضع نقاط فقط. وهذا يعني أن كثيرًا من مهام البرمجة التي كانت تُسلَّم افتراضيًا إلى النماذج الرائدة يمكن تجربتها أولاً في الطبقة الأساسية.
طريقة تحديد مهام الطبقة الرائدة L3
الطلبات التي تستحق فعلاً استخدام النماذج الرائدة هي التي تستوفي في العادة شرطين على الأقل من الشروط التالية:
- سلسلة الاستدلال طويلة: تحتاج إلى تخطيط متعدد الخطوات والتحقق المتكرر من النتائج الوسيطة، مثل تحديد موقع الأخطاء المعقدة، أو الإثباتات الرياضية، أو الجدولة متعددة القيود.
- الأخطاء خفية ومكلفة: تبدو المخرجات معقولة لكن من الصعب اكتشاف الأخطاء في التفاصيل، مثل تحليل بنود العقود، أو حساب المعايير المالية، أو الشيفرة البرمجية المتعلقة بالأمان.
- صعوبة تجميع السياق عالية: تحتاج إلى ربط المعلومات عبر الفقرات في مواد تبلغ مئات الآلاف من الرموز (tokens)، وليس مجرد استرجاع جزء معين.
- فشل الطبقات الأدنى: لم تجتز مخرجات طبقة L2 عملية التحقق، أو أبلغ المستخدم صراحةً أن النتائج غير قابلة للاستخدام.
🎯 نصيحة تقنية: يتطلب التوجيه الهرمي الاتصال بعدة نماذج في آنٍ واحد، وإذا كان كل نموذج يتطلب تعاقداً منفصلاً وتكييفاً منفصلاً مع SDK، فإن تكلفة الصيانة ستلتهم الفوائد التي يجلبها التوجيه. توفر APIYI (apiyi.com) استدعاءات API لسلسلة النماذج المذكورة في هذا المقال مثل GPT وClaude وGemini وDeepSeek، وهي متوافقة في الوقت نفسه مع صيغتي واجهة OpenAI وAnthropic، وعند تبديل النماذج لا تحتاج عادةً سوى تغيير معامل اسم النموذج.
البدء السريع مع التوجيه الهرمي لنماذج اللغة الكبيرة
في ما يلي نوضح، بأسلوب قائمة إعدادات، حلاً بسيطًا وقابلاً للاستخدام للتوجيه الهرمي. لا تحتوي هذه المقالة على مقاطع شيفرة برمجية، بل تُشرح جميع عناصر الإعداد الأساسية داخل جداول، لتتمكن من تطبيقها باستخدام الإطار الذي تعمل به.
الخطوة الأولى: طبقة وصول موحّدة
الشرط الأساسي للتوجيه الهرمي هو «تغيير النموذج دون تغيير الشيفرة». من المستحسن أن تمر جميع طلبات النماذج عبر دالة استدعاء موحّدة، لا تستقبل سوى نوع المهمة ومحتوى الرسالة ومعامل اختياري لتجاوز المستوى، ثم تقرر داخليًا — وفقًا لقواعد التوجيه — النموذج الذي سيتم استدعاؤه فعليًا.
أما من ناحية طريقة الوصول: إذا كان مشروعك يستخدم OpenAI SDK بالفعل، فيمكنك الاستمرار مباشرةً في استخدام واجهات بأسلوب chat completions؛ وإذا كنت تستخدم Anthropic SDK، فيمكنك أيضًا الاستمرار في الواجهات بأسلوب messages. يدعم APIYI هاتين الصيغتين في الوقت نفسه، ولمعرفة عنوان الوصول الدقيق وطريقة المصادقة وقائمة أسماء النماذج، يُرجى الاعتماد على ما ورد في مركز توثيق APIYI على docs.apiyi.com.
الخطوة الثانية: تعريف إعدادات قواعد التوجيه
يسرد الجدول التالي إعدادات قواعد التوجيه الأكثر استخدامًا في مجموعة قواعد التوجيه، ويُفضّل وضعها في ملف إعدادات مستقل، لتسهيل تعديلها دون إعادة تشغيل الخدمة.
| بند الإعداد | المعنى | منطق القيمة المقترحة |
|---|---|---|
task_type |
وسم نوع المهمة، مثل classify، extract، summarize، code، reason | يُوسم مباشرة من مدخل الأعمال، وهو أكثر استقرارًا من تصنيف النموذج |
default_tier |
الطبقة المستخدمة عند عدم مطابقة أي قاعدة | يُنصح بضبطها على L2، الطبقة الرئيسية |
risk_level |
وسم مخاطر الأعمال، ويقسم إلى low، medium، high | high يُوجّه مباشرة إلى L3 أو تُضاف خطوة تحقق |
context_threshold |
عتبة عدد tokens في الإدخال التي تؤدي إلى الترقية | تُضبط بالاستناد إلى نافذة السياق وأداء النصوص الطويلة لكل نموذج |
validator |
طريقة التحقق من المخرجات، مثل JSON schema، والتعبير النمطي، واختبارات الوحدة، ومراجعة نموذج ثانٍ | يجب ضبطها في الطبقة L1، ويُوصى بضبطها في الطبقة L2 |
max_escalation |
الحد الأقصى لعدد مرات الترقية بعد فشل التحقق | عادةً من 1 إلى 2 مرات، لمنع إعادة المحاولة اللانهائية |
tier_model_map |
اسم النموذج واسم النموذج الاحتياطي المقابلان لكل طبقة | تُعتمد أسماء النماذج من قائمة النماذج في وثائق APIYI |
الخطوة الثالثة: تكوين منطق الترقية والتخفيض
يُنصح بتقييم قواعد التوجيه وفق الترتيب التالي، فكلما كانت القاعدة أقرب إلى الأعلى كانت أولويتها أعلى:
- إذا حدّد الطرف المستدعي صراحةً معامل تجاوز المستوى، يُستخدم المستوى المحدد مباشرةً، لتسهيل التصحيح والتدخل اليدوي.
- إذا كانت قيمة
risk_levelهي high، يُوجّه الطلب إلى المستوى L3 الرائد. - إذا تجاوز طول الإدخال
context_threshold، يُوجّه الطلب إلى L2 على الأقل، ويُحدد حسب نوع المهمة ما إذا كان سيُرقّى إلى L3. - بالرجوع إلى جدول
task_type، تُوجّه مهام التصنيف والاستخراج وتحويل التنسيق إلى L1. - إذا لم تنطبق أي من القواعد أعلاه، يُستخدم
default_tier. - إذا لم يجتز الإخراج تحقق
validator، تتم الترقية بمستوى واحد وإعادة المحاولة، حتى الوصول إلى الحد الأقصىmax_escalation.
الخطوة الرابعة: تسجيل المؤشرات الرئيسية لكل مستوى
بعد تشغيل التوجيه، يجب على الأقل تسجيل المستوى واسم النموذج وعدد رموز الإدخال والإخراج لكل طلب، وما إذا كان قد أصاب ذاكرة التخزين المؤقت، وما إذا تمت الترقية وإعادة المحاولة، وما إذا نجح التحقق. هذه البيانات هي المرجع الوحيد لضبط الحدود لاحقًا؛ فاستراتيجية التوجيه التي لا تعتمد على السجلات لا يمكن ضبطها إلا بالحدس.
🚀 بداية سريعة: يُنصح أولًا بتشغيل الدفعة نفسها من الطلبات الحقيقية في بيئة الاختبار على المستويات الثلاثة L1 وL2 وL3، ومقارنة معدل النجاح وتكلفة المهمة الواحدة. عبر APIYI apiyi.com يمكن استخدام مجموعة واجهات واحدة للتبديل بين عدة نماذج، مما يسهّل إنجاز هذا النوع من تجارب المقارنة بسرعة.
مقارنة بين النماذج الرائدة والنماذج الأساسية في التوجيه الهرمي
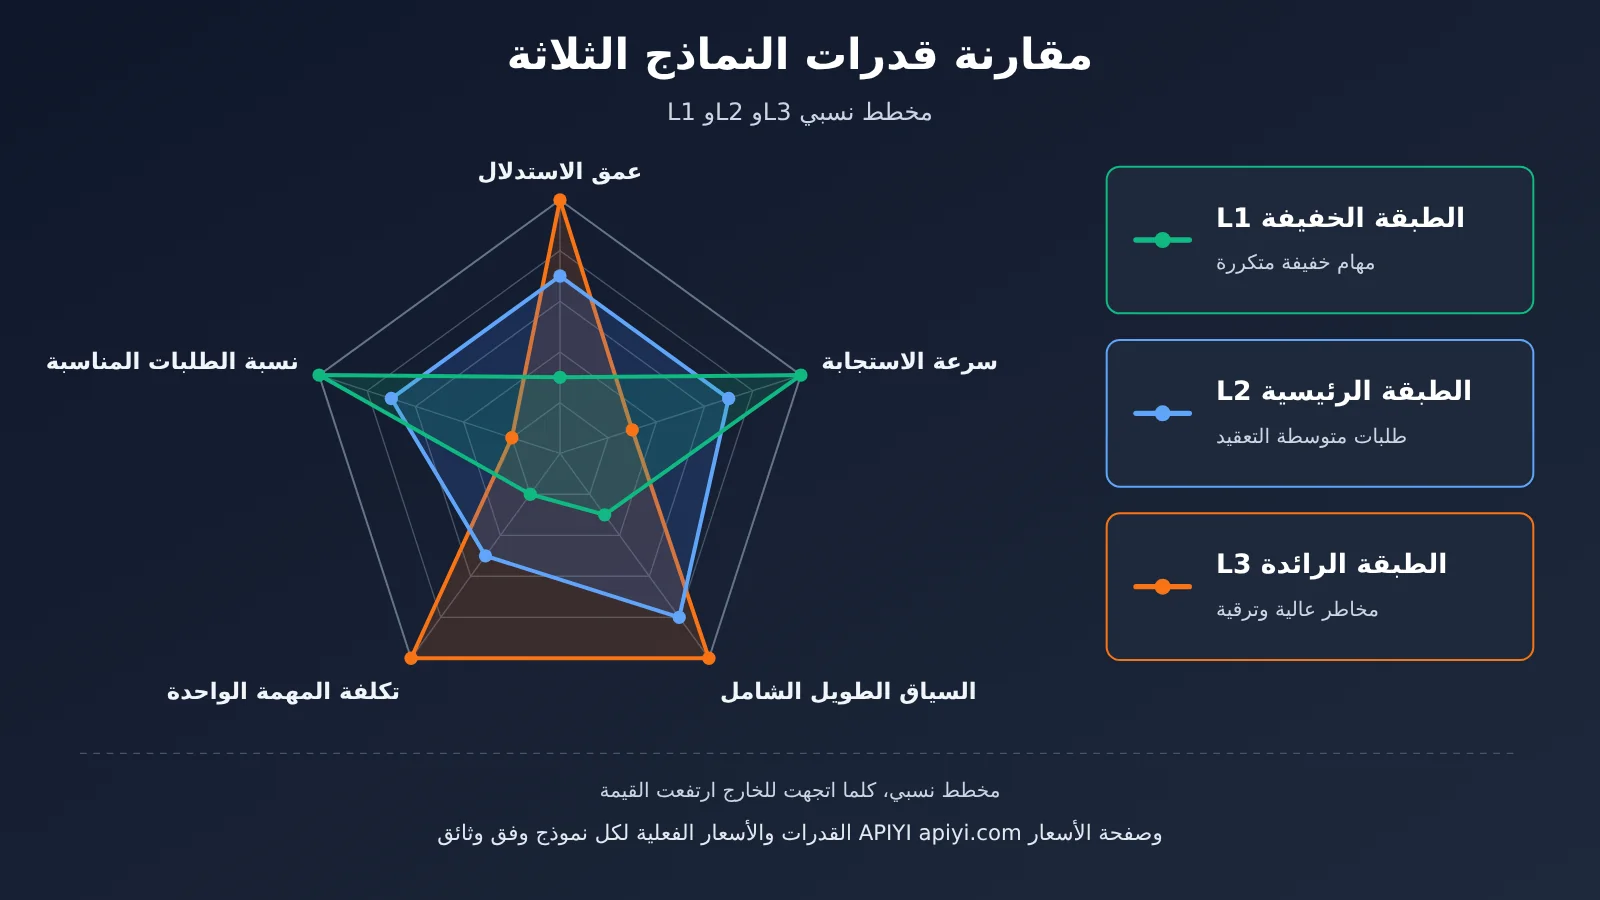
يصنّف الجدول التالي النماذج السائدة المذكورة في المراجع حسب الطبقات، لمساعدتك في اختيار النماذج المرشحة لكل طبقة. تعتمد التصنيفات الواردة في الجدول على مصادر عامة وتقييمات طرف ثالث، وقد يتغير الأداء الفعلي مع تحديث الإصدارات، لذا يُنصح بإعادة الاختبار باستخدام بيانات عملك الخاصة.
| النموذج | التصنيف الشائع | الطبقة المناسبة | المنصة المتاحة |
|---|---|---|---|
| Claude Opus 4.7 / 4.6 | برمجة معقدة واستدلال متعدد الخطوات | طبقة L3 الرائدة | APIYI apiyi.com، واجهة API الرسمية |
| GPT-5.5 | نموذج رائد عام، سياق 1M | طبقة L3 الرائدة | APIYI apiyi.com، واجهة API الرسمية |
| Gemini 3.1 Pro | استدلال وسياق طويل، بقيمة عالية مقابل التكلفة | من L2 إلى L3 | APIYI apiyi.com، واجهة API الرسمية |
| DeepSeek V4 Pro | مفتوح المصدر بمعاملات كبيرة، سياق 1M | طبقة L2 الأساسية | APIYI apiyi.com، واجهة API الرسمية |
| Kimi K2.6 | قدرة برمجية قريبة من النماذج الرائدة | طبقة L2 الأساسية | APIYI apiyi.com، واجهة API الرسمية |
| DeepSeek V4 Flash | تكلفة منخفضة، مناسب للمهام ذات الحدود الواضحة | من L1 إلى L2 | APIYI apiyi.com، واجهة API الرسمية |
| Claude Haiku 4.5 / GPT-5.4 Mini | مهام خفيفة عالية التكرار | طبقة L1 الخفيفة | APIYI apiyi.com، واجهة API الرسمية |
تحليل المقارنة بين النماذج الرائدة والنماذج الأساسية
تحليل مقارنة النماذج الرائدة: تحافظ النماذج الرائدة مثل Claude Opus وGPT-5.5 على تفوقها في الاستدلال متعدد الخطوات، وتعديل الشفرة عبر الملفات، واكتشاف الأخطاء الخفية. لكن سعرها لكل وحدة وزمن استجابتها أعلى بوضوح، واستخدامها لمهام بسيطة مثل التصنيف وإعادة الصياغة يُعد سوء تخصيص واضح للموارد. وبالمقابل، الأنسب وضع النماذج الرائدة في الطبقة L3، بحيث تتعامل فقط مع المخاطر العالية وطلبات الترقية بعد فشل الطبقات الأدنى.
تحليل مقارنة النماذج الأساسية مفتوحة المصدر: يقدم DeepSeek V4 وKimi K2.6 أداءً ممتازًا في البرمجة الروتينية ومعالجة المستندات، وتُظهر تقييمات طرف ثالث أن الفجوة بينها وبين النماذج الرائدة أصبحت صغيرة في كثير من المهام. لكن الفجوة لا تزال قائمة في المهام التي تتطلب استدلالًا طويل السلسلة وتحتوي على قيود ضمنية كثيرة. وبالنسبة لمعظم الطلبات متوسطة التعقيد، يظل نموذج الطبقة الأساسية الخيار الافتراضي الأكثر أمانًا واقتصادًا.
💡 توصية الاختيار: يعتمد اختيار النموذج في كل طبقة بشكل أساسي على توزيع مهامك ومتطلبات الجودة لديك. نوصي بإجراء اختبار مقارن أفقي للنماذج المرشحة باستخدام نفس مجموعة العينات عبر APIYI apiyi.com، ثم تحديد النموذج الأساسي والنموذج الاحتياطي لكل طبقة.
منهجية حساب تكلفة التوجيه الهرمي
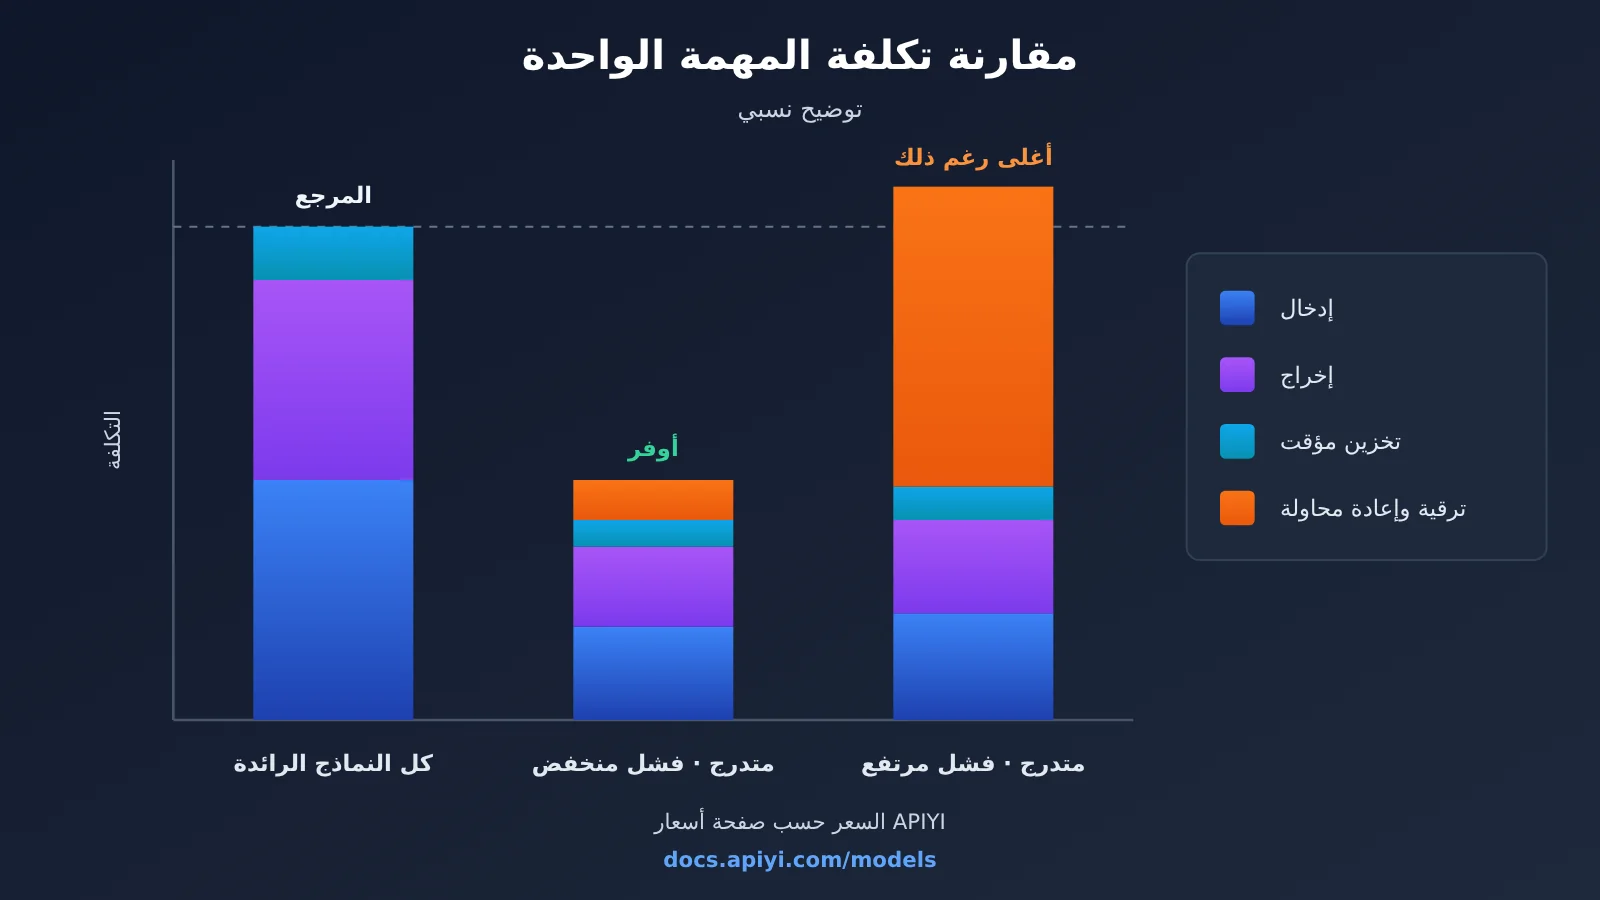
هل يقلل التوجيه الهرمي التكلفة؟ لا يمكن الحكم على ذلك بالنظر إلى سعر الوحدة فقط، بل يجب النظر إلى «التكلفة الإجمالية للمهمة الواحدة». وتتكون التكلفة الإجمالية للمهمة عادةً من عدة بنود فوترة، وأي خطأ في أحدها يجعل النتيجة مضللة.
| بند الفوترة | الوصف | مرجع السعر |
|---|---|---|
| رموز الإدخال | إجمالي الموجه والسياق والرسائل السابقة | وفق البيانات الفعلية في صفحة أسعار APIYI: docs.apiyi.com/models |
| رموز الإخراج | المحتوى الذي يولّده النموذج، وقد تتضمن النماذج الاستدلالية رموز التفكير | وفق البيانات الفعلية في صفحة أسعار APIYI: docs.apiyi.com/models |
| قراءة ذاكرة الموجه المؤقتة | الجزء من الإدخال المقروء من ذاكرة الموجه المؤقتة | وفق البيانات الفعلية في صفحة أسعار APIYI: docs.apiyi.com/models |
| كتابة ذاكرة الموجه المؤقتة | الجزء من الإدخال الذي يُكتب في ذاكرة الموجه المؤقتة لأول مرة، وتحتسب بعض النماذج تكلفته بشكل منفصل | وفق البيانات الفعلية في صفحة أسعار APIYI: docs.apiyi.com/models |
| إعادة المحاولة بعد الترقية | التكلفة الكاملة الناتجة عن إعادة تنفيذ المهمة في مستوى أعلى بعد فشلها في المستوى الأدنى | تُحتسب تراكميًا وفق مستوى الاستدعاء الفعلي |
الأخطاء الشائعة عند حساب تكلفة المهمة الواحدة في التوجيه الهرمي
الخطأ الأول هو حساب رموز ذاكرة الموجه المؤقتة مرتين. إذ تذكّر مقالة في المواد المرجعية بضرورة فصل القراءة والكتابة والإدخال العادي والإخراج وإعادة المحاولة عند حساب تكلفة الذاكرة المؤقتة، وإلا فمن السهل حساب الدفعة نفسها من الرموز مرتين. الخطأ الثاني هو تجاهل تكلفة إعادة المحاولة بعد الترقية؛ فإذا كان معدل فشل التحقق في الطبقة L1 مرتفعًا، فقد يصبح «تجربة النموذج الرخيص أولًا» أغلى من استخدام النموذج الرئيسي مباشرة.
لذلك يُنصح باستخدام معادلة بسيطة لتقييم مدى ملاءمة نوع معين من المهام للمستوى الأدنى: تكلفة الاستدعاء الواحد في المستوى الأدنى + (معدل الفشل × تكلفة الاستدعاء الواحد في المستوى الأعلى). إذا كانت هذه القيمة أقل بوضوح من تكلفة استخدام المستوى الأعلى مباشرة، وكانت الجودة النهائية مقبولة، فإن هذا النوع من المهام يكون مناسبًا للنقل إلى مستوى أدنى. أما سعر الوحدة لكل نموذج، وسعر الذاكرة المؤقتة، ومعايير الفوترة، فيُرجى الاعتماد فيها جميعًا على البيانات المحدثة في صفحة أسعار APIYI: docs.apiyi.com/models. ولا تورد هذه المقالة أرقامًا سعرية محددة.
💰 تحسين التكلفة: عند إجراء تقدير التكلفة، يُنصح بقراءة أسعار الإدخال والإخراج والذاكرة المؤقتة لكل نموذج مباشرةً من صفحة أسعار APIYI، ثم حساب التكلفة الإجمالية للمهمة الواحدة بالاعتماد على بيانات السجلات لديك. فعلى المنصة نفسها تكون معايير الفوترة متسقة، ما يقلل من احتمال الخطأ عند المقارنة بين النماذج.
الأسئلة الشائعة FAQ
س1: ما المقصود بالتوجيه الطبقي لنماذج اللغة الكبيرة حسب المهمة؟
هو توزيع كل طلب على نموذج ينتمي إلى طبقة مختلفة من حيث القدرة والتكلفة، وذلك بناءً على نوع المهمة ومستوى المخاطر وحجم السياق. تُسلَّم المهام البسيطة إلى نماذج خفيفة، والمهام الاعتيادية إلى النماذج الرئيسية، ولا تُسلَّم إلا المهام المعقدة أو عالية المخاطر إلى النماذج الرائدة.
س2: ما الفرق بين التوجيه الطبقي و«التخفيض إلى نموذج أرخص» ببساطة؟
التخفيض البسيط هو عادةً استبدال شامل، فتتراجع الجودة إجمالًا. أما التوجيه الطبقي فيتعامل مع كل نوع مهمة على حدة، ويأتي مع آليات تحقق وترقية تلقائية؛ فالطلبات التي تفشل في الطبقة الدنيا يُعاد تنفيذها على نموذج أقوى، وبذلك نحافظ على الحد الأدنى للجودة مع ضبط التكلفة.
س3: بعد إصدار نماذج جديدة في 2026، هل نحتاج إلى إعادة ضبط استراتيجية التوجيه؟
نعم. في النصف الأول من 2026 صدرت نماذج كثيفة مثل GPT-5.5 وDeepSeek V4 وإصدارات جديدة من Claude Opus، وتتغير حدود القدرات بين الطبقات بسرعة. يُنصح بعد كل تحديث كبير لنموذج بإعادة تشغيل مجموعة اختبارات ثابتة على كل طبقة لقياس معدل النجاح، ثم تحديد ما إذا كان يلزم تعديل ربط الطبقات.
س4: أي الطلبات تستحق أكثر من غيرها استخدام النموذج الرائد؟
تشمل أساسًا الفئات التالية:
– **إعادة هيكلة الكود عبر ملفات متعددة وتحديد الأخطاء المعقدة**: يتطلب فهم العلاقات التبادلية بين كم كبير من السياق.
– **المخرجات في المجالات عالية المخاطر**: مثل مراجعة العقود ومطابقة البنود المالية وتوليد سياسات الأمان.
– **مهام الاستدلال متعددة القيود**: مثل الجدولة المعقدة والموازنة بين الحلول والاستنتاج الرياضي.
– **الطلبات التي فشلت على النماذج الدنيا**: كشبكة أمان للترقية.
س5: كيف نبني بسرعة بيئة اختبار للتوجيه الطبقي عبر API؟
يُنصح باستخدام منصة تجميع واجهات API تدعم عدة نماذج:
1. زُر APIYI على apiyi.com وسجّل حسابًا واحصل على مفتاح API.
2. اطّلع على عنوان الوصول وأسماء النماذج المتاحة في مركز توثيق APIYI على docs.apiyi.com.
3. وفق قائمة الإعداد في هذا المقال، اختر نموذجًا لكل من L1 وL2 وL3، وقارن معدلات النجاح على نفس دفعة العينات.
APIYI متوافق مع تنسيقات واجهات OpenAI وAnthropic، لذا لا تحتاج المشاريع الحالية عادةً إلى تعديلات كبيرة للاتصال.
س6: هل يزيد تصنيف المهام بواسطة النموذج نفسه من التكلفة؟
ستكون هناك تكلفة إضافية صغيرة، لذا يُفضّل أولًا وضع العلامات مباشرة عند نقطة دخول العمل، فمثلًا «مدخل أسئلة خدمة العملاء» يُفترض افتراضيًا أنه نوع مهمة معين. فقط عندما يتعذر على المدخل التمييز، استخدم نموذج L1 الخفيف للتصنيف؛ وهذه التكلفة عادةً أقل بكثير من الهدر الناتج عن سوء استخدام النموذج الرائد.
س7: ما هي القيود المعروفة للتوجيه الطبقي؟
هناك ثلاث نقاط أساسية: أولاً، تحتاج القواعد إلى صيانة مستمرة، فقد تفقد العتبات صلاحيتها بعد تحديث النماذج؛ ثانياً، إعادة المحاولة عند الترقية تزيد من زمن استجابة بعض الطلبات، وهو ما يستلزم موازنة في السيناريوهات التي تتطلب زمن استجابة فائقاً في الوقت الفعلي؛ ثالثاً، أنماط مخرجات النماذج المختلفة غير متسقة، وقد تحتاج المنتجات الموجّهة للمستخدمين إلى معالجة لاحقة موحّدة. عند ظهور هذه المشكلات، يمكن رفع المستوى الافتراضي أو تقليل عدد المستويات بشكل مناسب.
س8: من أين يجب الرجوع إليه في أسعار التوجيه الهرمي؟
جميع أسعار الوحدات للمدخلات والمخرجات والتخزين المؤقت لكل النماذج، وكذلك أساس الفوترة، يجب الاعتماد فيها على البيانات الفعلية في صفحة أسعار APIYI على docs.apiyi.com/models. قد تختلف الأسعار الواردة في مقالات الطرف الثالث عن القناة التي تستخدمها فعلياً، لذا لا يُنصح باستخدامها مباشرة لإعداد الميزانية.
النقاط الأساسية لتوجيه النماذج الكبيرة وفقاً لتقسيم المهام
- أساس التقسيم هو المهمة لا المستخدم: الفروق في صعوبة طلبات المستخدم نفسه كبيرة، لذا يجب الحكم على كل طلب على حدة.
- تكلفة الخطأ أهم من الصعوبة: المهام البسيطة لكن عالية المخاطر تستحق أيضاً النموذج الرائد.
- السير على المستوى الرئيسي افتراضياً هو الخيار الأكثر أماناً: المستوى المتوسط يغطي الحالات الحرجة، والترقية والتخفيض حسب الإشارات، قواعد بسيطة وسهلة الصيانة.
- المستوى الأدنى يجب أن يُرفق بالتحقق: المخرجات التي يمكن للبرنامج التحقق منها فقط هي التي تصلح لتسليمها إلى نموذج خفيف.
- التكلفة تُقاس بإجمالي المهمة الواحدة: يجب حساب المدخلات والمخرجات والتخزين المؤقت وإعادة المحاولة كلٌّ على حدة.
- تحديث النماذج يستلزم إعادة الاختبار: في عام 2026 تتسارع دورات تحديث النماذج، ويحتاج ربط المستويات إلى معايرة دورية.
- الواجهة الموحّدة تقلل تكلفة التبديل: عبر APIYI على apiyi.com يمكن استدعاء نماذج متعددة من عدة شركات باستخدام مجموعة واجهات واحدة.
الخلاصة
النقاط الأساسية لتوجيه نماذج اللغة الكبيرة عبر طبقات حسب نوع المهمة:
- تقسيم ثلاثي الطبقات: تتولى الطبقة L1 المهام الخفيفة القابلة للتحقق، وتتحمل الطبقة L2 حركة المرور الافتراضية، بينما تستقبل الطبقة L3 فقط الطلبات المعقدة وعالية المخاطر وطلبات الترقية.
- أولوية القواعد: يُجرى التقييم بالترتيب التالي: التجاوز اليدوي، ثم وسوم المخاطر، ثم طول السياق، ثم نوع المهمة، ثم الطبقة الافتراضية، مع ترقية تلقائية عند الفشل.
- الاعتماد على البيانات: سجّل معدل النجاح لكل طبقة ومعدل إعادة المحاولة وتكلفة المهمة الواحدة، واضبط العتبات بناءً على بيانات حقيقية لا بناءً على الانطباع.
لا يهدف التوجيه الطبقي إلى “استخدام أرخص نموذج في كل شيء”، بل إلى توجيه قدرات النماذج الرائدة إلى المواضع التي تحتاجها فعلاً. يُنصح بالبدء بمهمة أو مهمتين عاليتي التكرار، وإتمام السلسلة الكاملة “التصنيف، الاستدعاء، التحقق، الترقية، التسجيل”، ثم التوسع تدريجياً إلى مزيد من الأعمال.
نوصي بالتحقق السريع من الحل الطبقي عبر APIYI على apiyi.com، إذ توفر المنصة واجهة موحدة لعدة نماذج، وتجد تعليمات الوصول في docs.apiyi.com، بينما تُعتمد الأسعار وفقاً لما هو منشور في docs.apiyi.com/models.
📚 المراجع
- قائمة مقالات مدونة Ofox.ai (أبريل–مايو 2026): تغطي إصدارات ومقارنات نماذج GPT-5.5 وDeepSeek V4 وClaude Opus وغيرها
- الرابط:
ofox.ai/blog/page/35 -
الوصف: تضم تحليلات خارجية حول التوجيه بين النماذج المختلطة وحساب تكاليف التخزين المؤقت، وقد اقتصر هذا المقال على نقل المعلومات الوقائعية منها فقط
-
قائمة مقالات مدونة Ofox.ai (إصدارات النماذج وتقييمها): تغطي GPT-5.5 Instant ومعايير النماذج السائدة ومقارنة تكلفة المهمة الواحدة
- الرابط:
ofox.ai/blog/page/36 -
الوصف: مناسبة لفهم التصنيفات المعلنة للنماذج السائدة في 2026
-
قائمة مقالات مدونة Ofox.ai (النماذج الصغيرة والمفتوحة المصدر): تغطي Claude Haiku وGPT-5.4 Mini وLlama 4 وغيرها من النماذج الخفيفة والمفتوحة المصدر
- الرابط:
ofox.ai/blog/page/37 -
الوصف: مناسبة كمرجع عند اختيار نماذج مرشحة للطبقتين L1 وL2
-
مركز وثائق APIYI: عناوين الوصول وصيغة الواجهة وأسماء النماذج
- الرابط:
docs.apiyi.com -
الوصف: يُرجى مراجعته قبل الاتصال بواجهة متوافقة مع OpenAI أو Anthropic
-
صفحة أسعار نماذج APIYI: بيانات تسعير المدخلات والمخرجات والتخزين المؤقت لكل نموذج
- الرابط:
docs.apiyi.com/models - الوصف: جميع حسابات التكلفة في هذا المقال تعتمد على البيانات الفعلية في هذه الصفحة
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ولمزيد من مواد الوصول يمكنكم زيارة مركز الوثائق docs.apiyi.com