ملاحظة المؤلف: يعتمد هذا المقال على مشاركة عامة من YC Paper Club Harness Night، ويقدّم مجموعة قابلة للتطبيق من طرق تقييم النماذج، لمساعدة الفرق على تحديد ما إذا كان فارق الدرجات ناتجًا عن النموذج نفسه أم عن Harness.
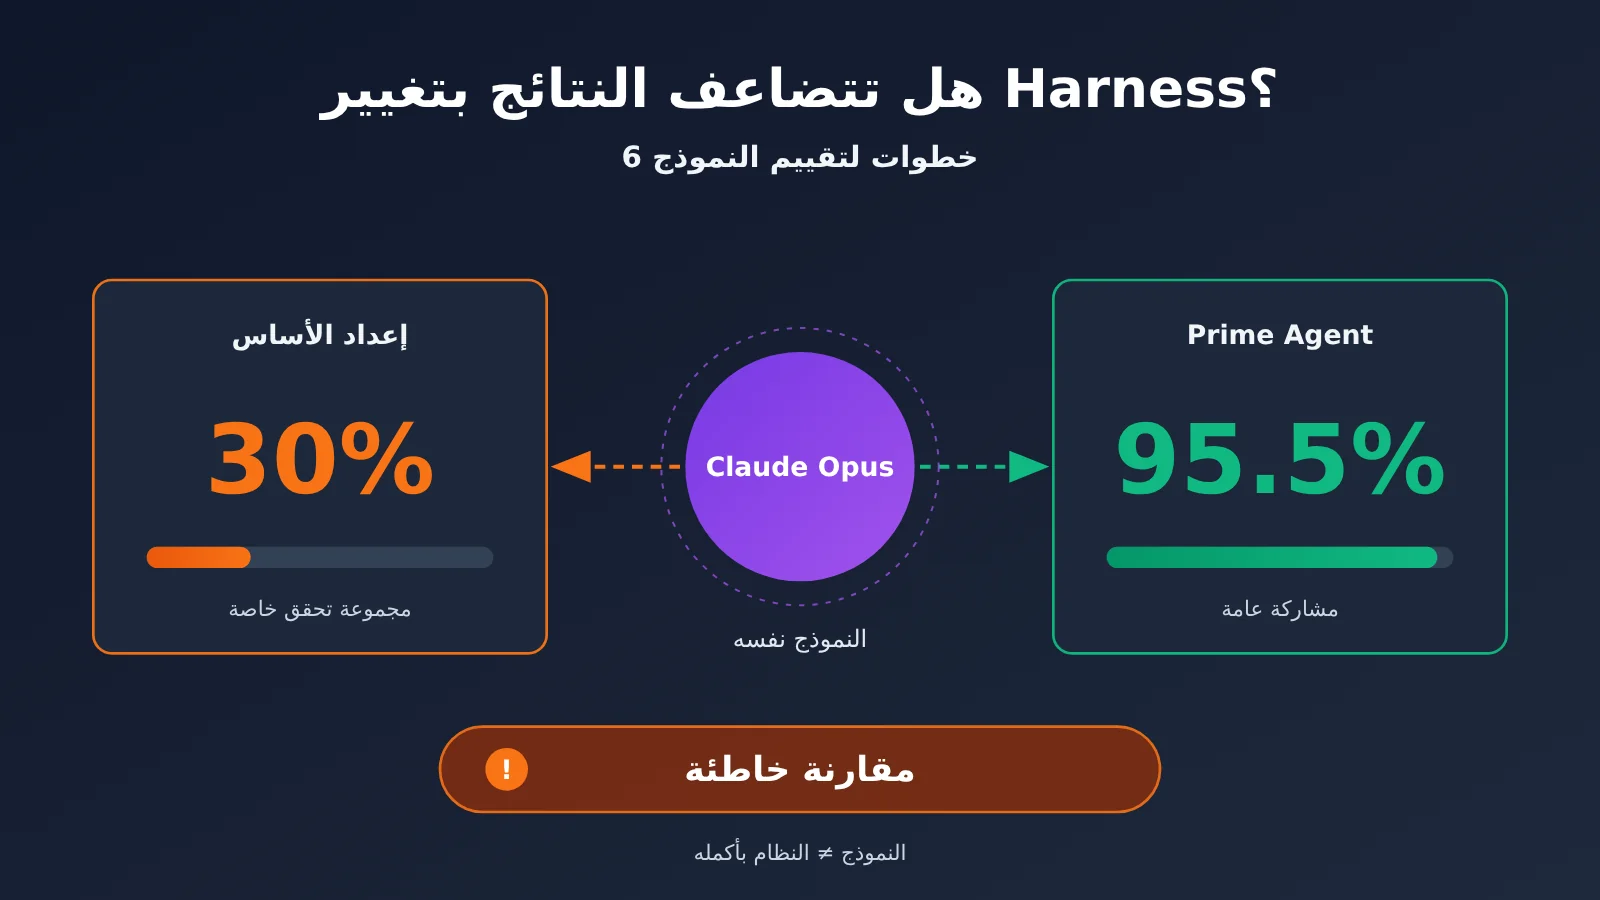
نفس Claude Opus، أفضل نتيجة له على مجموعة تحقق خاصة محتجزة هي 30%؛ وبعد إدخاله في Prime Agent، كانت النتيجة المذكورة في المشاركة العامة 95.5%. إذا نظرت إلى لوحة الصدارة فقط، فقد تظن أن النموذج تغيّر جوهريًا، لكن هذه الأرقام تذكّرنا أولًا بأن: تقييم النماذج غالبًا ما يقارن المنظومة كاملة، لا النموذج وحده.
هذا ليس مقالًا يحثّك على التخلي عن لوحات الصدارة، ولا يزعم أن Harness يمكنه رفع نتيجة أي نموذج بلا حد. لم نُجرِ إعادة اختبار مستقلة؛ وجميع النتائج المذكورة مأخوذة من محتوى المحاضرة الذي جمّعه InfoQ، والتركيز هنا على تحويل تلك الخبرات إلى عملية تقييم قابلة للتنفيذ.
القيمة الأساسية: بعد قراءة هذا المقال، ستتعلم تصميم تجربة مقارنة بين النموذج وHarness عبر 6 خطوات، وتحديد مصدر فارق الدرجات، والوصول إلى استنتاجات أكثر موثوقية عند اختيار النموذج.
تغيير Harness يضاعف النتائج: النقاط الأساسية لتقييم النماذج
Harness هو طبقة نظامية بين LLM والعالم الخارجي، تتولى توفير الحالة الدائمة والأدوات وقدرات الحوسبة. استخدم Seth Karten تشبيهًا: نموذج LLM المجرد يشبه آلة تورينغ، بينما Harness يشبه حاسوب فون نويمان القادر على القراءة والكتابة في ذاكرة خارجية. عند تقييم Agent، تؤثر قدرة النموذج على الاستدلال وقدرة هذه الطبقة النظامية على التعبير في النتيجة معًا.
يسرد الجدول أدناه بعض البيانات العامة المتعلقة بـ ARC-AGI من المشاركة. تأتي هذه النتائج من نماذج أو Harness أو إعدادات تقييم مختلفة، ولا يمكن استخدامها مباشرة كترتيب للنماذج.
| الإعداد | النتيجة المعلنة | ما يجب الانتباه إليه عند القراءة |
|---|---|---|
| Claude Opus، التحقق على مجموعة محجوزة خاصة | أفضل نتيجة 30% | هذه هي خط الأساس في المشاركة، ولا تمثل جميع ظروف التشغيل |
| Prime Agent + Opus | 95.5% | لم تفصح المواد عن كل الفروق بينه وبين خط الأساس بندًا بندًا، لذا لا ينبغي إرجاعه إلى متغير واحد فقط |
| Prime Agent + GPT-5.6 Sol | 78% | هذه نتيجة بعد إكمال عزل الصندوق الرملي |
| Prime Agent + GPT-5.6 Terra | 25.7% | تحت Harness نفسه، يظل الفرق بين النماذج واضحًا |
| Nvidia AVO | 100% | تقدم المشاركة النتيجة فقط، وقبل المقارنة يلزم التحقق من الإعدادات المحددة |
العلاقة بين Harness وتقييم النماذج
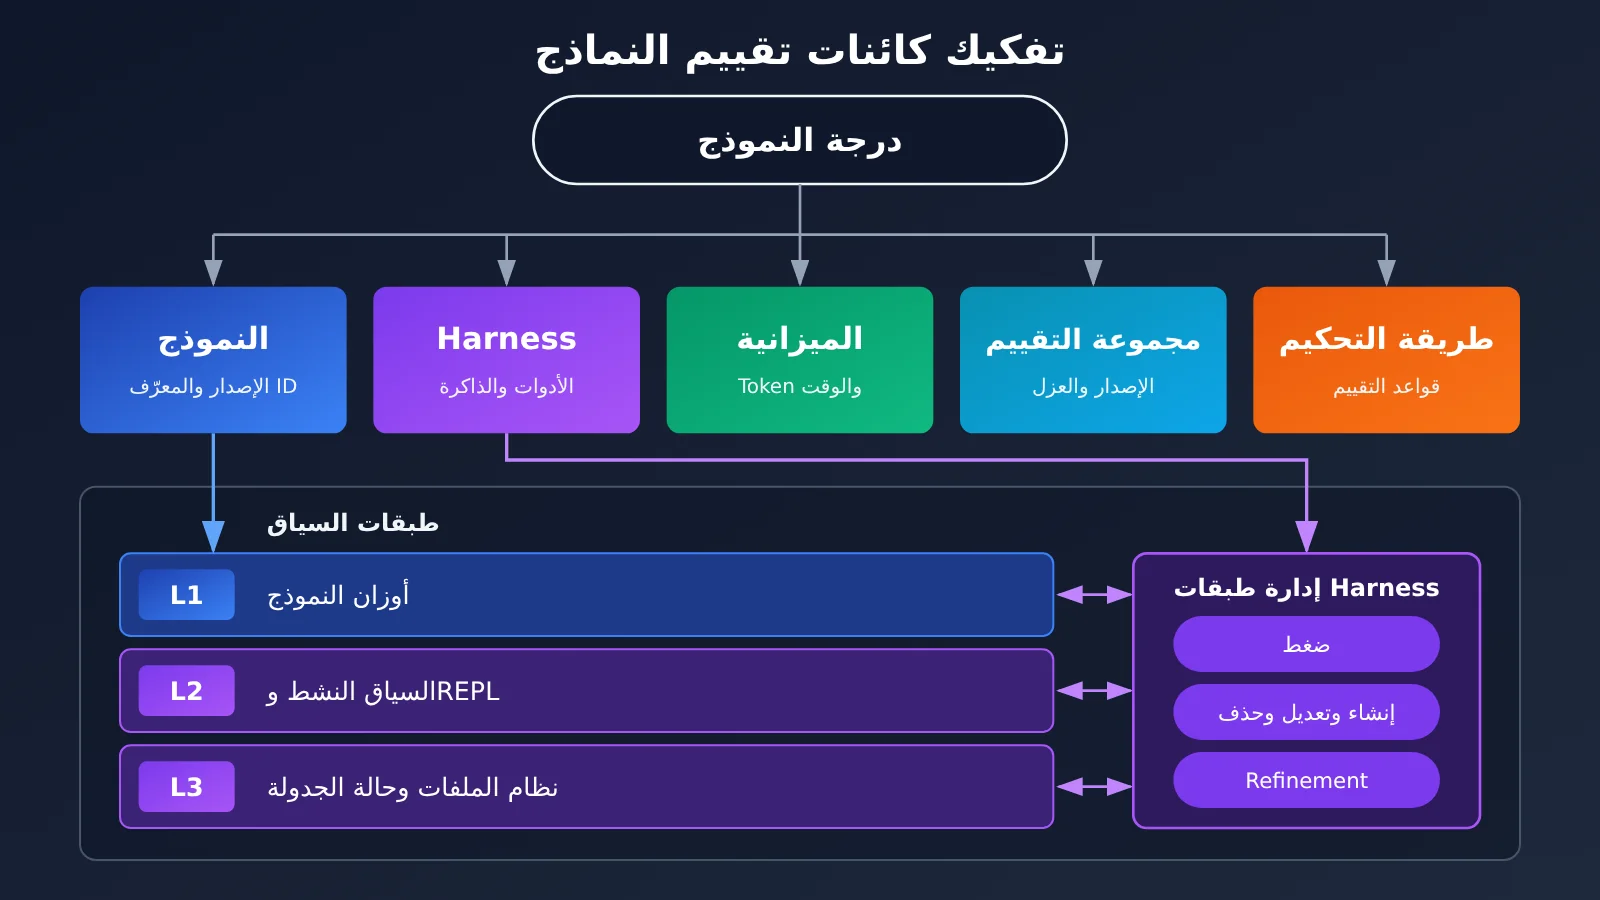
يقسّم Prime Agent السياق إلى ثلاث طبقات: الطبقة L1 هي أوزان النموذج، والطبقة L2 هي السياق النشط وREPL، والطبقة L3 هي حالة الجدولة مثل نظام الملفات. ويعمل Harness بين الطبقات على الضغط والإضافة والحذف والتعديل والاستعلام والتنقيح (refinement)، بما يشبه ذاكرة التخزين المؤقت مع جامع القمامة. وهذا يعني أن النموذج نفسه إذا غيّرت طقم Harness الخاص به، فقد تتغير الذاكرة والقدرة الحسابية المتاحة له.
لكن هذا لا يعني أن النموذج غير مهم. فقد برز Prime Agent في ARC-AGI، لكن أداءه في التقييمات طويلة الدورة مثل Oolong وEmulator Bench كان متعادلًا أو أفضل قليلًا في الأساس، وفي مهام نوى GPU كان متعادلًا تقريبًا أيضًا. نوع المهمة هو ما يحدد مقدار الفجوة التي يستطيع Harness تضخيمها، لذلك لا يمكن تعميم نتيجة بند واحد على جميع السيناريوهات.
المتغيرات الخمسة الأكثر عرضة للخطأ في المقارنة عند تقييم النماذج
| المتغير | المقارنة الخاطئة الشائعة | ما ينبغي تسجيله |
|---|---|---|
| النموذج | كتابة اسم السلسلة فقط دون الإصدار المحدد | معرّف النموذج، وسجل الاستدعاء الفعلي، وحالات التراجع أو التبديل |
| Harness | اعتبار الإعداد الافتراضي قدرةً للنموذج | الأدوات، والموجه النظامي، والوكلاء الفرعيون، وآلية الذاكرة والضغط |
| الميزانية | وصول A إلى مرحلة الاستقرار بينما يتوقف B مبكرًا | عدد Token، والوقت الفعلي، والتكلفة، وشروط التوقف المبكر |
| مجموعة التقييم | مقارنة نتائج مجموعة عامة بنتائج مجموعة خاصة | إصدار مجموعة البيانات، وطريقة العزل، ووجود تسريب للمعلومات من عدمه |
| أسلوب التحكيم | الاكتفاء بجعل LLM يحكم على نجاح الإصلاح أو الإجابة | قواعد التقييم، ونسبة العينة البشرية، والعينات المتنازع عليها |
توصية عملية: إذا أردت مقارنة عدة نماذج ضمن مسار تقييم واحد، يمكنك استدعاء النماذج المذكورة في هذا المقال عبر APIYI على apiyi.com لتقليل فروق التكامل. يتوافق APIYI مع صيغ واجهات OpenAI وAnthropic، وللاطلاع على أسماء النماذج الدقيقة وطريقة الوصول راجع وثائق docs.apiyi.com.
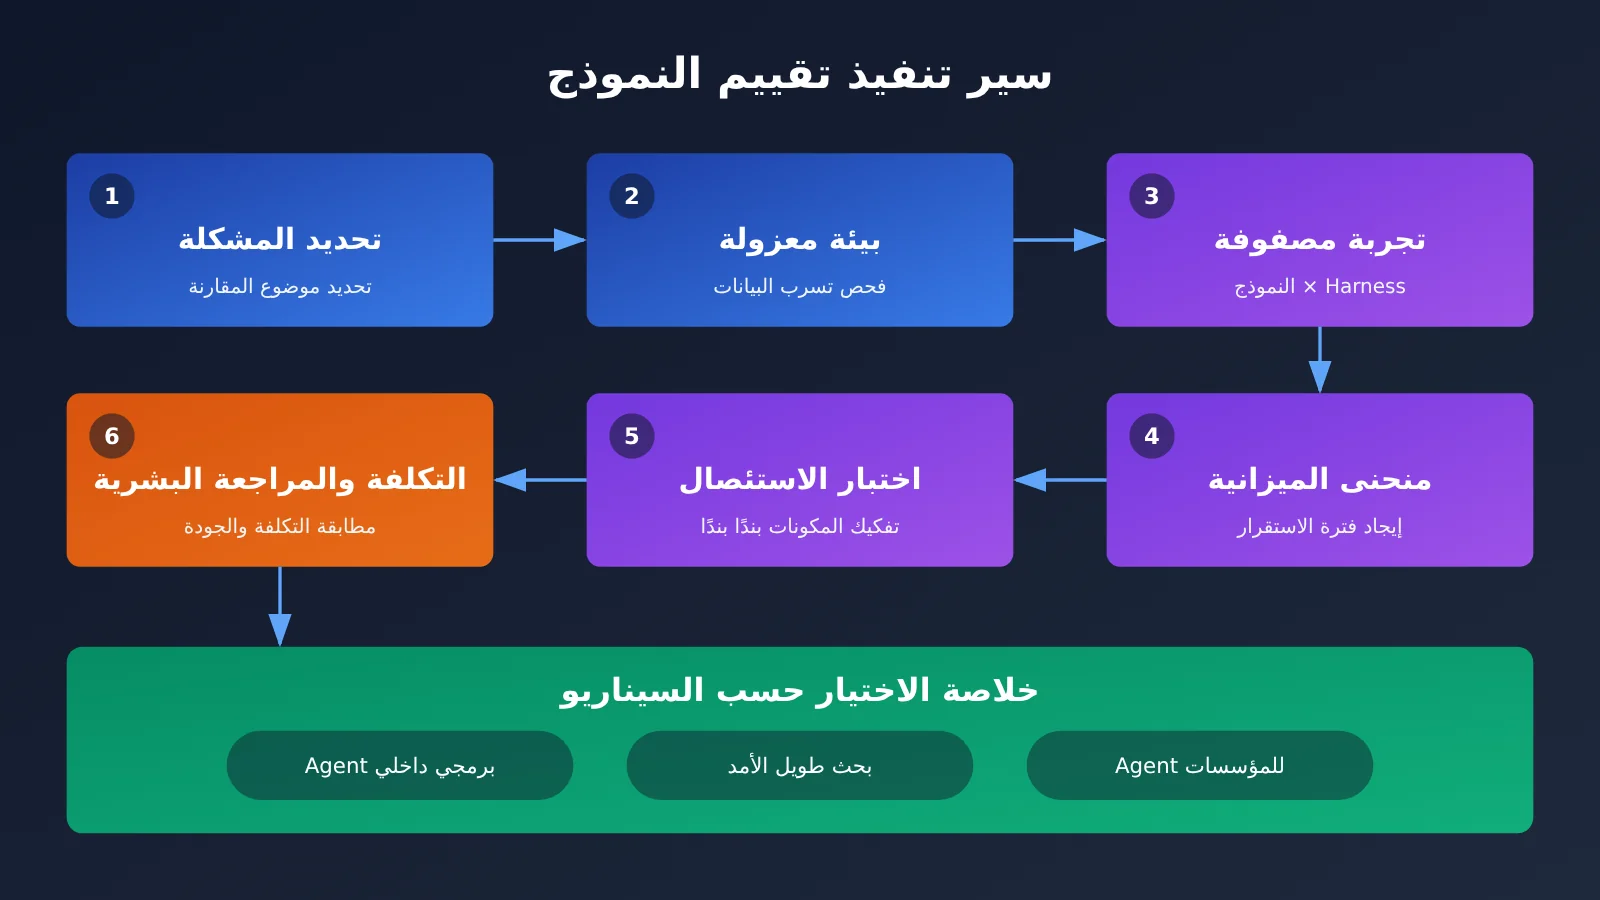
البدء السريع في تقييم النماذج باستخدام Harness: 6 خطوات
تناسب العملية التالية اختيار النماذج وترقية الوكلاء وإجراء اختبارات مرجعية داخلية. لا تحتاج إلى بناء منصة تقييم ضخمة من البداية؛ ابدأ بتسجيل المتغيرات بشكل كامل، ثم أضف المهام والنماذج تدريجيًا.
الخطوة 1: حدّد بوضوح ما الذي تقارنه عند تقييم النموذج
ابدأ بتعريف سؤال التجربة في جملة واحدة، مثل: «ضمن نفس Harness ونفس الميزانية، قارن قدرة نموذجين على إنجاز مهام برمجية داخلية». إذا صغت السؤال على شكل «أي Agent أفضل؟»، فإن ما تقارنه هو مزيج النموذج وHarness، ولا يصح أن تكون النتيجة «أي نموذج أقوى».
يجب أن تثبّت مواصفات التقييم كحد أدنى model، وموجه النظام، وقائمة الأدوات، وmax_tokens، والحد الأقصى لعدد الجولات، والميزانية الإجمالية. وإذا كان Harness يسمح للوكيل باختيار بيئة التشغيل بنفسه، فسجّل أيضًا النموذج المستخدم فعليًا في كل خطوة. يسمح تصميم QM للوكيل بالانتقال إلى نموذج آخر عند مواجهة رفض؛ وفي هذه الحالة لم تعد الدرجة النهائية تخص نموذجًا واحدًا.
الخطوة 2: عزل بيئة تقييم Harness وبياناتها
وضع Seth موجه النظام الخاص بلوحة الصدارة المجتمعية داخل Prime Agent، فحصل في أول تشغيل على 99.9%. وعندما فحص السجلات أدرك أنه كان يغش، فأمضى يومًا كاملًا في بناء عزل عبر صندوق رملي، فانخفضت نتيجة GPT-5.6 Sol إلى 78%. النتيجة المرتفعة ليست بالضرورة خاطئة، لكن أي نتيجة مرتفعة بشكل غير طبيعي يجب فحص سجلاتها أولًا.
عند الفحص ركّز على ثلاثة أمور: هل يستطيع الوكيل قراءة الإجابات أو النتائج التاريخية، وهل يتضمن الموجه معلومات خاصة بمجموعة التقييم، وهل تجاوزت استدعاءات الأدوات الصلاحيات المحددة. وبالنسبة للمهام الخارجة عن المعايير العامة، خصّص أيضًا مجموعة من العينات المحجوزة لا تشارك في الضبط، لمنع الإفراط في التوفيق بين الموجه وHarness.
الخطوة 3: المقارنة باستخدام مصفوفة «النموذج × Harness»
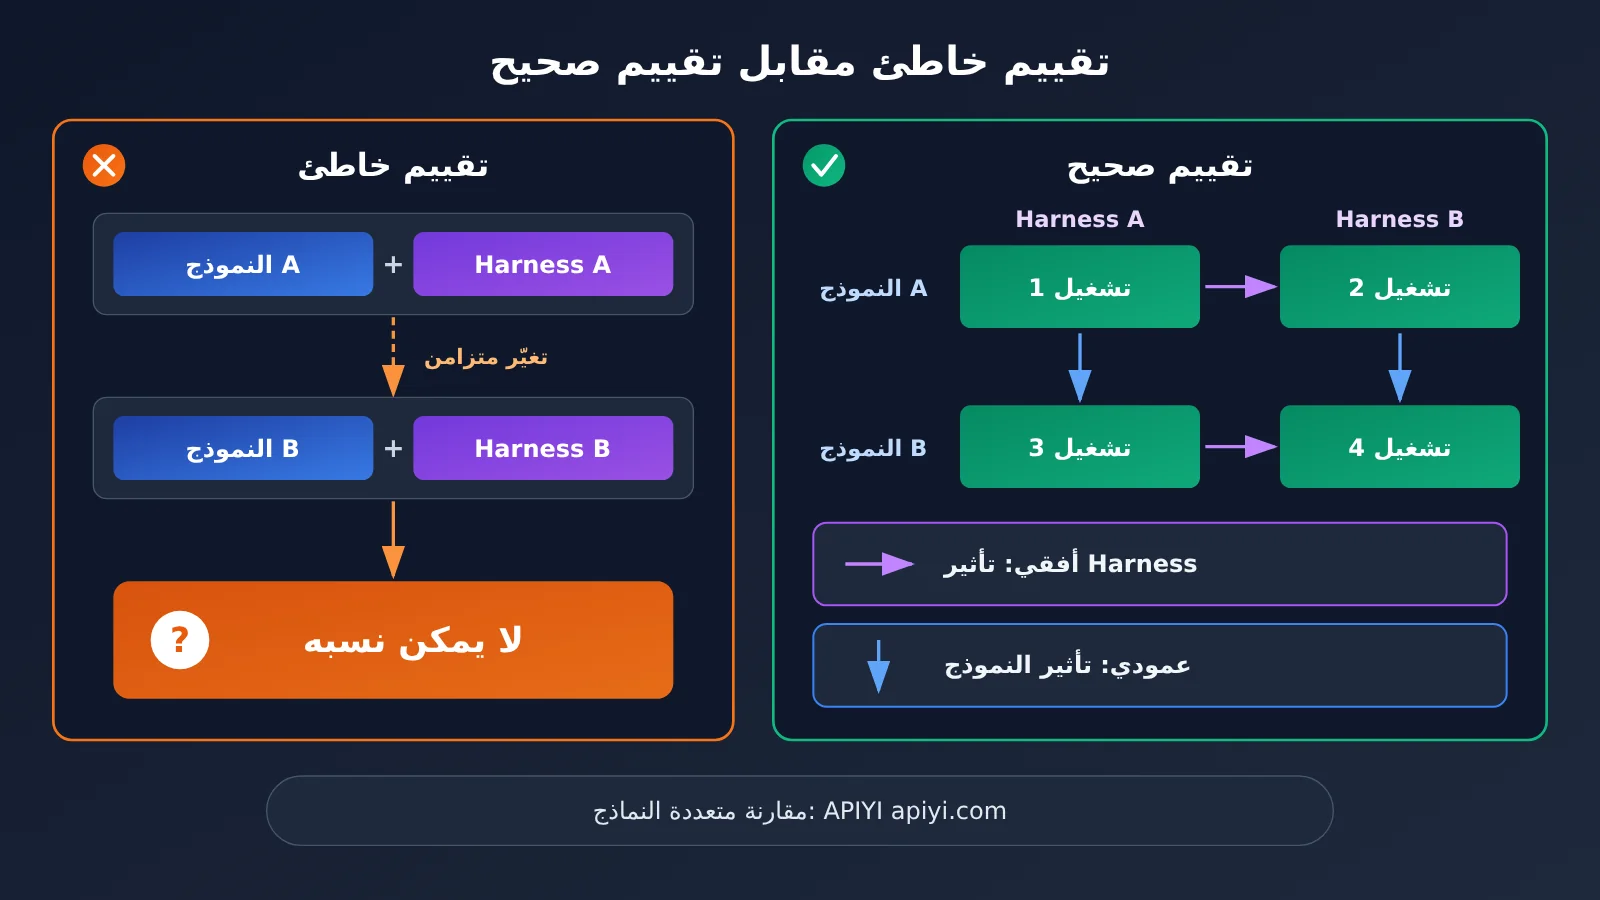
لا تكتفِ بتشغيل «النموذج A + Harness A» و«النموذج B + Harness B»، لأن تغيير متغيرين في الوقت نفسه يجعل نسبة الأثر إلى أي منهما مستحيلة. الحل الأدنى هو مصفوفة 2 × 2: يُشغَّل النموذجان في مجموعتَي Harness، مع الحفاظ على مجموعة المهام والميزانية نفسها.
| نتيجة المصفوفة | التفسير الأرجح | الإجراء التالي |
|---|---|---|
| تغيّر واضح عند تبديل النموذج، وتغيّر ضئيل عند تبديل Harness | المهمة الحالية تعتمد أكثر على قدرة النموذج | أعطِ الأولوية لاختيار النموذج |
| تغيّر واضح عند تبديل Harness، وتغيّر ضئيل عند تبديل النموذج | قدرة النظام هي عنق الزجاجة الأساسي | حسّن الأدوات وإدارة السياق أولًا |
| تأثير متبادل واضح بين الاثنين | توجد علاقة توافق بين النموذج وHarness | اختر حسب التركيبة، ولا تنشر ترتيبًا أحاديًا |
| لا تغيّر واضح في أي منهما | المهمة بسيطة جدًا أو صعبة جدًا أو التقييم غير حساس | أعد تصميم مجموعة التقييم والمؤشرات |
اقتراح للتجارب الضابطة: تتطلب تجارب المصفوفة تبديل النماذج بشكل متكرر. يمكنك عبر APIYI apiyi.com استخدام حساب موحد وإعدادات واجهة موحدة لاستدعاء نماذج مختلفة، مع الاحتفاظ بمعرّف النموذج في سجل التجربة، لتسهيل التتبع لاحقًا.
الخطوة 4: مواءمة الميزانية ومراقبة مرحلة ثبات أداء النموذج
أشار Seth في مشاركته إلى أنه إذا لم يعمل أحد النموذجين مدة كافية، أو توقف بعد نفاد الميزانية بينما واصل الآخر العمل، فأنت لم تقارن بينهما بناءً على الإنفاق نفسه فحسب، بل أخفيت الأداء الحقيقي أيضًا. والأسلوب الأكثر منطقية هو تحديد عدة نقاط ميزانية، ثم مراقبة منحنى تطور الدرجات مع زيادة الرموز أو الوقت.
وتوضح تجربة فريق QM أهمية الميزانية أيضًا. فقد لاحظوا أن الوكيل كثيرًا ما يستسلم مبكرًا، فجرّبوا «شحذ الأدوات»: تحديد ميزانية للهدف، ومنع الاستسلام قبل استهلاك الوقت الفعلي أو الرموز المطلوبة، فتحسنت مخرجات البحث نتيجة لذلك. لذلك لا ينبغي أن تتضمن مواصفات التقييم الحد الأعلى للميزانية فحسب، بل يجب أيضًا أن توضح ما إذا كان هناك حد أدنى للاستثمار المطلوب.
الخطوة 5: إجراء اختبار إسقاط (Ablation) على Harness
بعد ملاحظة التحسين الذي يجلبه Harness، تأتي الخطوة التالية وهي معرفة أي قدرة تحديدًا يقف خلف هذا التحسين. يشدّد Prime Agent على القدرة التعبيرية، ويرى أنه لا ينبغي إزالة الضغط، أو Python REPL، أو الوكلاء الفرعيين البرمجيين، أو الوصول إلى الحالة، أو آليات التغذية الراجعة بسهولة. لكن في مهمتك، لا تزال المساهمة الفعلية لكل قدرة بحاجة إلى اختبار.
والطريقة هي تعطيل قدرة واحدة في كل مرة، مثل تعطيل REPL، أو تعطيل الوكيل الفرعي، أو تعطيل الذاكرة طويلة المدى، مع إبقاء بقية الإعدادات دون تغيير. وإذا بقيت الدرجات دون تغيير تقريبًا بعد التعطيل بينما انخفضت التكلفة بشكل واضح، فقد لا تستحق هذه القدرة الاحتفاظ بها في الوقت الحالي. أما المهام عالية التباين مثل البحث الآلي، فيجب تشغيلها لعدة جولات متكررة، لأن Seth ذكر أيضًا أن مثل هذه المهام يصعب نسبتها مباشرة إلى Harness أو إلى النموذج.
الخطوة 6: حساب التكلفة وإضافة المراجعة البشرية
ذكر سيث أيضًا أنه عند تشغيل التقييم باستخدام Hermes Agent، أنفق 5,000 دولار بسرعة دون رؤية تحسن ملموس، فاضطر إلى الإيقاف. هذا لا يعني أن قدرات Hermes Agent وصلت إلى حدها الأقصى، لكنه كافٍ لبيان أن نسبة التكلفة إلى الأداء يجب أن تكون جزءًا من استنتاجات التقييم. وقد أوصى التقرير النهائي بإدراج معدل النجاح ووقت الإنجاز واستهلاك الرموز (Token) وتكلفة النجاح الواحد معًا.
عند حساب التكلفة، لا تُثبّت الأسعار كتابةً داخل تعليمات سكربت التقييم. بالنسبة إلى سعر الوحدة للإدخال والإخراج للنموذج، وسعر التخزين المؤقت، وأساس الفوترة، يُرجى الاعتماد على البيانات الفعلية في صفحة أسعار APIYI https://docs.apiyi.com/models، مع تدوين تاريخ الاستعلام في التقرير.
كذلك يجب الحفاظ على أخذ عينات بشرية في مرحلة التقييم. فقد اكتشف فريق QM أنه عند إسناد الحكم على نتائج الإصلاح إلى LLM تظهر “متلازمة الشخصية الرئيسية”: فهو يرى جزءًا من الفيل فقط، ولا يرى النظام بأكمله. وعندما يتعلق الأمر بعمليات الأعمال، يجب أيضًا اختبار حدود الصلاحيات، لأن فهم الوكيل للمواقف الاجتماعية ضعيف، وقد تتسرب المعلومات ذات الامتيازات إلى سياقات لا ينبغي أن تظهر فيها.
كيفية تطبيق مصفوفة تقييم النماذج عمليًا عبر API
عند التنفيذ الفعلي، يُنصح بتقسيم التقييم إلى ثلاثة أجزاء: مجموعة المهام، وإعدادات التشغيل، وسجل النتائج. بهذه الطريقة، عند تغيير النموذج أو Harness، تحتاج فقط إلى تعديل بند إعداد واحد بدل إعادة كتابة العملية بأكملها.
| بند الإعداد | المحتوى المقترح تسجيله | ملاحظات |
|---|---|---|
| تنسيق الواجهة | متوافق مع OpenAI أو تنسيق Anthropic | قد تختلف بنية استدعاء الأدوات والرسائل بين التنسيقين، ويلزم التحقق من كل منهما على حدة |
| عنوان الاتصال والمفتاح | base_url، اسم متغير البيئة |
يُعتمد عنوان docs.apiyi.com كمرجع، ولا تكتب المفتاح في تقرير التقييم |
| معاملات التشغيل | model، max_tokens، الحد الأقصى للجولات، عدد التكرارات |
تأكد من إمكانية إعادة إنتاج كل تجربة |
| أساس حساب التكلفة | المدخلات والمخرجات والتخزين المؤقت وتاريخ الاستعلام | اعتمد البيانات الفعلية من صفحة أسعار APIYI على docs.apiyi.com/models |
| نتائج التشغيل | الدرجات وأسباب الفشل وToken والمدة وسجل الاستدعاءات | تُستخدم لتحليل مرحلة الثبات ونسبة التكلفة إلى الأداء |
إذا كان Harness لديك يدعم واجهتين في الوقت نفسه، يُنصح أولًا بإجراء مقارنة تنسيقية باستخدام النموذج نفسه. يساعد ذلك في التأكد من أن تحويل الرسائل وتعريف الأدوات والاستجابة المتدفقة لم تؤثر في النتائج، وتجنب تفسير مشكلات الاتصال خطأً على أنها فروق في قدرات النموذج.
ملاحظة حول الاتصال: يوفر APIYI استدعاءات API للنماذج الواردة في هذا المقال، وهو متوافق مع تنسيقي OpenAI وAnthropic. قبل بدء التجربة، تحقق من النماذج المتاحة حاليًا وطريقة الاستدعاء على docs.apiyi.com، ثم اكتب معرّف النموذج في مواصفات التقييم.
الأسئلة الشائعة
س1: ما هو Harness في تقييم النماذج؟
Harness هو طبقة النظام التي تربط النموذج بالعالم الخارجي، ويشمل عادةً التحكم في الحلقة وإدارة السياق والأدوات والوكلاء الفرعيين والذاكرة والوصول إلى الحالة. وهو يحدد ما يستطيع النموذج رؤيته، وما يستطيع استدعاءه، وكم من الوقت يمكنه العمل.
س2: هل ارتفاع درجة Harness يعني أن النموذج أصبح أقوى؟
لا. فعندما تبقى الأوزان كما هي، يكون تحسّن الدرجة أقرب إلى أن يعكس قدرة النظام على إطلاق مزيد من الإمكانات، أو أن الإعداد أنسب لهذه المهمة. وإذا تغيّرت عناصر Harness والميزانية والنموذج في الوقت نفسه، فلا يمكن نسب التحسّن إلى عامل واحد، وقد يكون ناتجًا أيضًا عن تسرّب في بيئة التقييم.
س3: متى نحتاج إلى إعادة تقييم النموذج؟
ينبغي إعادة التقييم عند تغيّر إصدار النموذج أو موجه النظام أو صلاحيات الأدوات أو استراتيجية الضغط أو مهام العمل. فمجال Harness يتطور بسرعة، وبيانات هذا المقال مأخوذة من محتوى منظّم نشرته InfoQ في نوفمبر 2026، وقد تتغير النتائج لاحقًا.
س4: ما السيناريوهات التي تناسبها منهجية تقييم النماذج هذه؟
تناسب بشكل أساسي السيناريوهات التالية:
– **اختيار وكيل برمجي داخلي**: مقارنة معدل إنجاز المهام بين تركيبات مختلفة من النماذج وHarness.
– **مهام بحثية طويلة الأمد**: ملاحظة مرحلة الثبات وتباين النتائج بعد زيادة الميزانية.
– **التحقق قبل إطلاق وكيل في المؤسسة**: اختبار الجودة والتكلفة وحدود الصلاحيات في الوقت نفسه.
س5: كيف يمكن الوصول بسرعة إلى عدة نماذج لإجراء مقارنة Harness؟
يمكن أولاً تحديد مهام التقييم وقائمة النماذج، ثم الاتصال بها عبر APIYI apiyi.com. توفر المنصة واجهات API للنماذج المذكورة في هذا المقال، وهي متوافقة مع صيغ واجهات OpenAI وAnthropic. للحصول على معرّفات النماذج وطرق الإعداد تحديدًا، راجع وثائق docs.apiyi.com، واحتفظ بثبات المتغيرات الأخرى أثناء التجربة.
س6: كيف ينبغي كتابة أسعار النماذج في تقرير التقييم؟
يُنصح بالاقتباس فقط لبيانات أسعار تم التحقق منها، مع كتابة تاريخ الاستعلام. أما أسعار الإدخال والإخراج للوحدة، وأسعار التخزين المؤقت، وأساس الفوترة، فيجب الاعتماد فيها على البيانات الفعلية في صفحة أسعار APIYI https://docs.apiyi.com/models، وعدم استخدام جداول قديمة أو قيم تقديرية.
س7: ما القيود التي تتسم بها منهجية تقييم Harness هذه؟
تضيف تجارب المصفوفة والتشغيل المتكرر والمراجعة اليدوية وقتًا وتكلفة. كما قد يكون تباين المهام طويلة الأمد مرتفعًا، وحتى مع التحكم في المتغيرات الرئيسية يظل النسب الدقيق صعبًا. لذلك فهي أنسب لدعم القرار، ولا ينبغي اعتبار نتيجة واحدة تصنيفًا مطلقًا.
النقاط الجوهرية في تقييم النماذج باستخدام Harness
- حدِّد موضوع المقارنة أولاً: اعرف بوضوح هل تقارن بين النماذج وحدها، أم بين النموذج والـ Harness معًا كحزمة واحدة.
- راجع السجلات عند ظهور درجات مرتفعة غير طبيعية: تُظهر 99.9% من الحالات أن عزل بيئة التقييم شرط أساسي لصلاحية النتائج.
- افصل المتغيرات باستخدام مصفوفة: صِل عدة نماذج عبر APIYI، ثم أجرِ مقارنة على مستوى النموذج × الـ Harness.
- طابِق الميزانية بدقة: راقب منحنى الأداء عند عدة نقاط ميزانية لتحديد مرحلة الاستقرار الحقيقية.
- استخدم اختبارات الاجتزاء (Ablation) لتحديد مصدر التحسين: عطِّل القدرات واحدة تلو الأخرى في كل مرة لتتأكد من أين جاء التحسين فعلًا.
- تحقق من بيانات التكلفة: اعتمد الأسعار وطريقة الفوترة المعتمدة على صفحة أسعار APIYI.
- لا تتخلَّ عن الحكم البشري: قد يكون تقييم نموذج لغة كبير متحيّزًا أو ناقصًا، كما أن مخاطر الأذونات تحتاج إلى اختبار مستقل.
الملخص
فكرة “مضاعفة النتائج بمجرد تغيير Harness” جديرة بالاهتمام، لكنها لا تعني بأي حال أن “النموذج غير مهم”. فالبيانات الواردة في المشاركة تُظهر التأثير المضاعف للـ Harness، وفي الوقت نفسه تؤكد وجود فروق واضحة بين النماذج والمهام المختلفة. ولذلك، لا يمكن بناء أي استنتاج موثوق خارج إطار تجارب مضبوطة.
عند التطبيق العملي، من المفيد تذكّر ثلاث نقاط أساسية:
- وضِّح موضوع التقييم بدقة: سجِّل النموذج، والـ Harness، والميزانية، ومجموعة التقييم، وطريقة الحكم على النتائج.
- صمِّم التجربة بحيث تسمح بإرجاع النتائج إلى أسبابها: استخدم تجارب المصفوفة واختبارات الاجتزاء لفصل المتغيرات، مع عزل بيئة التقييم.
- اجعل الاستنتاجات مرتبطة بالسياق العملي: انظر في الوقت نفسه إلى مرحلة الاستقرار، ونسبة الأداء إلى التكلفة، ونتائج المراجعة البشرية، ومخاطر الأذونات.
إذا كنت تستعد للتحقق من توليفة النماذج التي تستخدمها، يمكنك الوصول إلى النماذج المذكورة في هذا المقال عبر APIYI على apiyi.com، ثم إكمال الإعداد وفقًا لوثائق docs.apiyi.com. وعند حساب التكاليف، يُرجى الرجوع إلى https://docs.apiyi.com/models للحصول على بيانات الأسعار الحالية.
📚 المراجع
- InfoQ: النموذج نفسه ينتقل من 30 نقطة إلى 95 نقطة — الفارق ليس النموذج، بل الـ Harness
- الرابط:
infoq.cn/article/C1C1DThg8z1Dy0rZAmLB -
الوصف: النتائج والحالات ووجهات النظر التصميمية الواردة في هذا المقال مأخوذة جميعها من هذه المقالة المجمّعة.
-
فيديو محاضرات YC Paper Club Harness Night
- الرابط:
youtube.com/watch?v=n9xKblqyQ28 -
الوصف: يمكنك الاطلاع على السياق الكامل للعروض الثلاثة: Prime Agent وOpenJarvis وQM.
-
مركز توثيق APIYI
- الرابط:
docs.apiyi.com -
الوصف: يُستخدم للتحقق من النماذج المتاحة وصيغ الواجهات وإعدادات الاتصال.
-
صفحة أسعار النماذج في APIYI
- الرابط:
docs.apiyi.com/models - الوصف: أسعار النماذج الفردية وأسعار التخزين المؤقت ومعايير الفوترة تعتمد جميعها على البيانات الفعلية في هذه الصفحة.
المؤلف: فريق APIYI التقني
التواصل التقني: إذا كنت ترغب في معرفة طرق استدعاء النماذج، يسعدنا أن تزور الموقع الرسمي لـ APIYI على apiyi.com، ويمكنك الاطلاع على مزيد من المواد في مركز توثيق docs.apiyi.com.