ملاحظة المؤلف: باستخدام Meta Muse كدراسة حالة، نوضح ما الذي يجب صقله تحديدًا في وكيل الذكاء الاصطناعي، مع التركيز على ضبط السلوك وظهور الحالة، ونقدّم خطوات يمكن اتباعها حرفيًا.
كثير من الفرق التي تبني وكلاء ذكاء اصطناعي تصطدم بالسيناريو نفسه: قدرات النموذج أصبحت كافية، والعرض التجريبي يسير بسلاسة، لكن المستخدمين يغادرون بعد أيام قليلة من الاستخدام الفعلي. المشكلة عادةً لا تكون في النموذج نفسه، بل في أن طبقتي ضبط السلوك وظهور الحالة لم تُصقلا على النحو الكافي. في هذا المقال نتّخذ Muse من Meta دراسة حالة، ونفكّك ما الذي نصلقه فعليًا في وكيل الذكاء الاصطناعي.
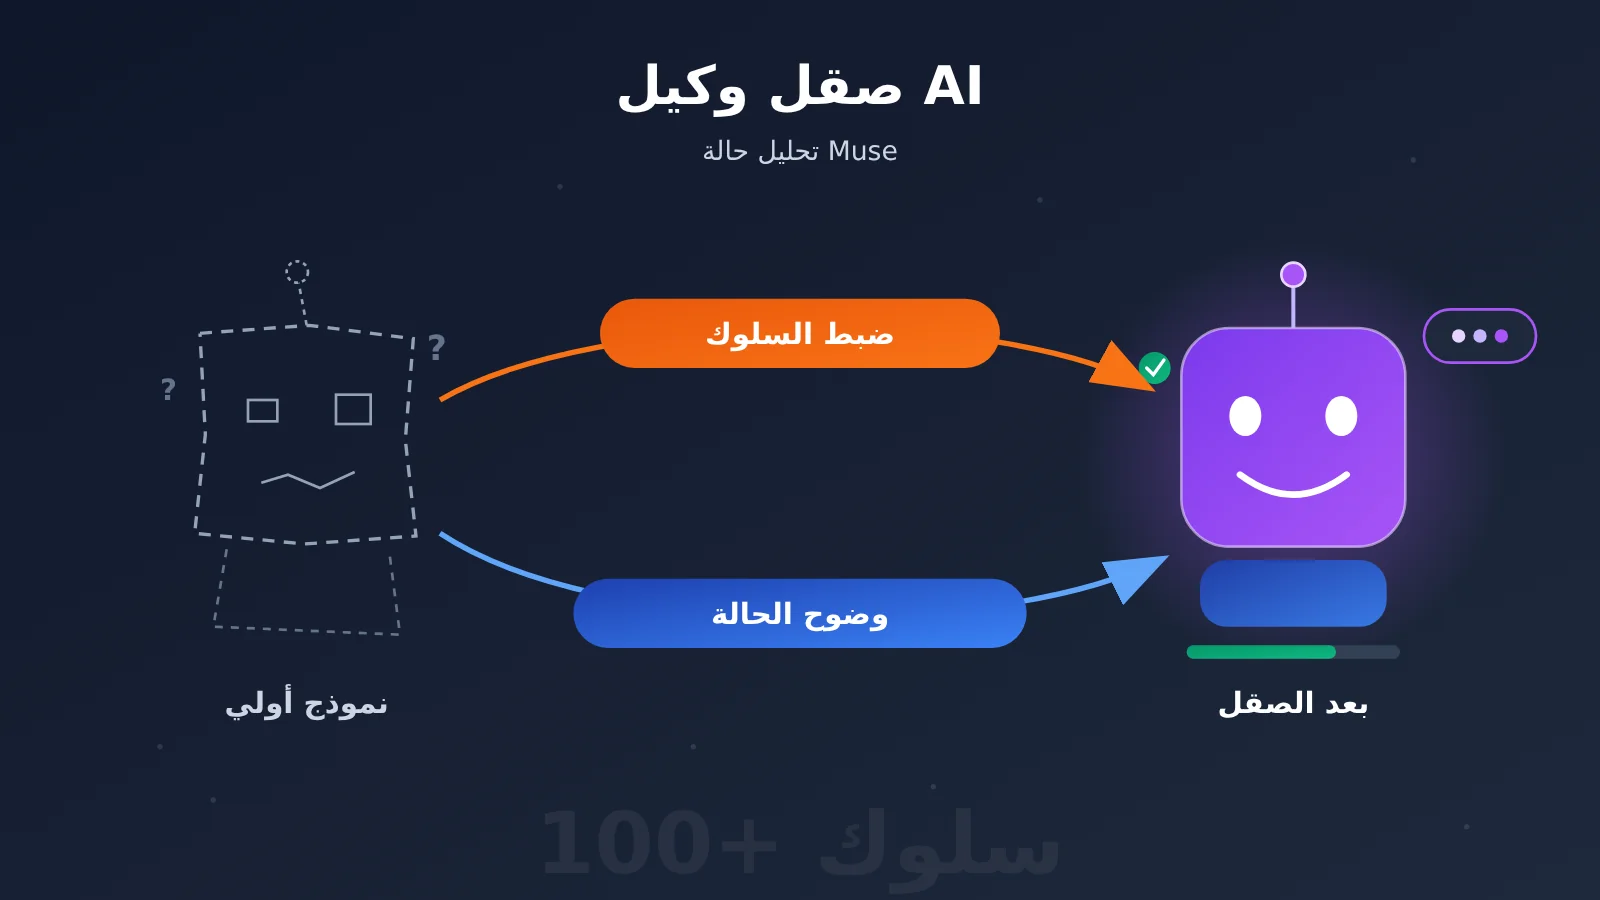
هذا ليس مقالًا آخر من نوع «التفاصيل الصغيرة تحدد النجاح». وفقًا لتقارير منشورة، اختبر فريق Muse وعدّل أكثر من مئة سلوك محدّد للنموذج قبل الإطلاق، وجعل الصورة الرمزية تُظهر بتعبيرات الوجه والحركات ما يفعله الوكيل في اللحظة نفسها. وكلتا الخطوتين يمكن تفكيكهما إلى مهام هندسية ملموسة.
القيمة الأساسية: بعد قراءة هذا المقال، ستكون قادرًا على تحويل «الصقل» إلى قائمة سلوكيات، وجدول إشارات حالة، ومنهجية اختبار، وتطبيقها مباشرة على منتج الوكيل الخاص بك.
خلفية صقل وكيل الذكاء الاصطناعي: لماذا يستحق Muse التحليل
نبدأ بخلفية الحالة. وفقًا للتقارير، خسر قسم Reality Labs المسؤول عن الواقع الافتراضي والواقع المعزز في Meta نحو 19.2 مليار دولار في عام 2025 وحده، وأصبح مسار الميتافيرس في نظر كثيرين بمثابة فشل باهظ التكلفة. بعد ذلك لم يتراجع زوكربيرغ إلى نشاطه الإعلاني الأساسي، بل واصل الاستثمار في اتجاه وكلاء الذكاء الاصطناعي. وبعد نحو ستة أسابيع من إطلاق Muse، تشير التقارير إلى أن عدد مستخدميه بلغ 10 ملايين.
في هذا المشروع تفصيلان مرتبطان مباشرة بـ”الصقل”. الأول أن الفريق يقوده Alexander Wang وNat Friedman القادمان من Scale AI، وكما يصف Wang نفسه، يضم مسارا النموذج والمنتج معًا أقل من 200 شخص. صِغَر الفريق أمر مقصود، والهدف منه تجنّب التنازلات وعدم اتساق التجربة التي تنتج عندما تتخذ الفرق الكبيرة قراراتها بالتوافق العام. الثاني أن Muse لم يُوضَع في موقع “أذكى نموذج في السوق”، بل تكمن ميزته في تقليص الفجوة بين “ما يستطيع النموذج تحقيقه تقنيًا” و”كيف يبدو استخدامه فعليًا للمستخدم العادي”، مثل المهام اليومية كإلغاء الاشتراكات وتتبّع الفواتير.
بالنسبة للمطورين، لا تحمل إيرادات Muse وحجمه قيمة مرجعية كبيرة. أما ما يستحق النظر إليه فهو فهمه لمعنى “الصقل”: فالصقل مجموعة من السلوكيات المحددة القابلة للاختبار، وليس عبارة تسويقية.
المحاور الأساسية في صقل وكيل AI
إذا جرّدنا ما فعله Muse من تفاصيل، يمكن تصنيف صقل وكيل AI في الاتجاهات التالية:
| المحور | الشرح | الفائدة للمستخدم |
|---|---|---|
| ضبط السلوك | اختبار وتعديل سلوك النموذج المحدد بندًا بندًا قبل الإطلاق (أكثر من مئة بند في Muse) | تصبح استجابات الوكيل متوقعة، ولا تتفاوت بين جيدة وسيئة |
| حدود القرار | تحديد الحالات التي ينفّذ فيها الوكيل بنفسه، والحالات التي يسأل المستخدم فيها أولاً | تدخّل أقل، مع عدم تجاوز الصلاحيات |
| وضوح الحالة | إظهار ما يفعله الوكيل عبر إشارات مرئية أو نصية | لا يحتاج المستخدم إلى التخمين: هل فهم قصدي؟ هل يعمل فعلاً؟ |
| اتساق التجربة | الحفاظ على سلوك متسق عبر المداخل والصفحات المختلفة | لا تتراكم الاحتكاكات الصغيرة لتصبح تكلفة استخدام واضحة |
| الحالات الطرفية | التعامل بجدية مع الأخطاء والانقطاعات وعلامة التبويب الثانية والثالثة | يبقى الاستخدام اليومي المتكرر سلسًا |
المحور الأول في صقل وكيل AI: ضبط السلوك لا يعني أن «النموذج أذكى»
«النموذج ذكي جدًا» و«الوكيل سهل الاستخدام» أمران مختلفان. فالنموذج فائق القدرة، إن لم يعرف متى يتوقف ليؤكد، ومتى يستطيع التصرف مباشرة، وكيف يبلّغ عن التقدم، سيظل مزعجًا في الاستخدام. والسلوكيات التي ضبطها فريق Muse، وتجاوزت المئة، تدور غالبًا حول هذه النقاط.
موضوع ضبط السلوك هو طريقة الاستجابة في سياق محدد، لا معاملات النموذج. مثلاً إذا قال المستخدم «ساعدني في إلغاء ذلك الاشتراك»، فهل على الوكيل أن يعرض أولاً الاشتراكات التي وجدها ويطلب التأكيد، أم ينفّذ مباشرة؟ وعند الوصول إلى صفحة الدفع، هل يؤكد مرة أخرى؟ كل نقطة قرار كهذه سلوك يحتاج إلى اختبار وتثبيت.
المحور الثاني في صقل وكيل AI: وضوح الحالة عمل تصميمي
تعرض صورة Muse الرمزية بحركات صغيرة أنها «تعمل الآن» على المهمة الحالية، فلا يحتاج المستخدم إلى قراءة رسائل حالة تقنية. هذا يجيب عن السؤال الذي يخطر لكل من يسلّم مهمة إلى AI: هل فهم مقصدي؟ هل يعمل حقًا؟
إزالة هذا الإحساس بالغموض عمل تصميمي، ويجب أن يغطي كل زاوية في المنتج، لا أن يقتصر على مسار العرض التجريبي. ووفق التقارير، طوّرت Meta قبل إطلاق تطبيق الهاتف تقنية لتوليد تعبيرات الوجه والحركات المتزامنة مع الصوت، استعدادًا لتجربة صوتية فورية وأجهزة قابلة للارتداء مستقبلًا. معظم الشركات تؤجل هذه الطبقة إلى ما بعد «التحقق من الفكرة الأساسية»، بينما بادرت Muse إلى تنفيذها مبكرًا.
بدء سريع في صقل وكيل الذكاء الاصطناعي: 6 خطوات عملية
في ما يلي، نعيد صياغة فكرة Muse في إجراءات يمكن للفرق الصغيرة والمتوسطة تنفيذها أيضًا. لا تحتاج إلى مئات الأشخاص، ولا إلى ميزانية بمئات المليارات، بل تحتاج إلى الصبر لمواصلة المراجعة مرة ثانية وثالثة.
الخطوة 1: إنشاء قائمة سلوكيات وكيل الذكاء الاصطناعي
ابدأ أولًا بتدوين نقاط القرار التي سيواجهها الوكيل في المهام الحقيقية، واكتب لكل بند بوضوح «شرط التفعيل، والسلوك المتوقع، والمثال المضاد». يكفي أن تبدأ بـ30 إلى 50 بندًا، ثم تضيف المزيد باستمرار بناءً على ملاحظات الاختبار. فيما يلي مرجع للتصنيف:
| فئة السلوك | نقاط القرار النموذجية | معيار الصقل |
|---|---|---|
| تأكيد النية | التعليمات غامضة، مثل «ألغِ ذلك الاشتراك» | عند وجود عدة مرشحين، اعرضهم ليختار المستخدم، ولا تخمّن بنفسك |
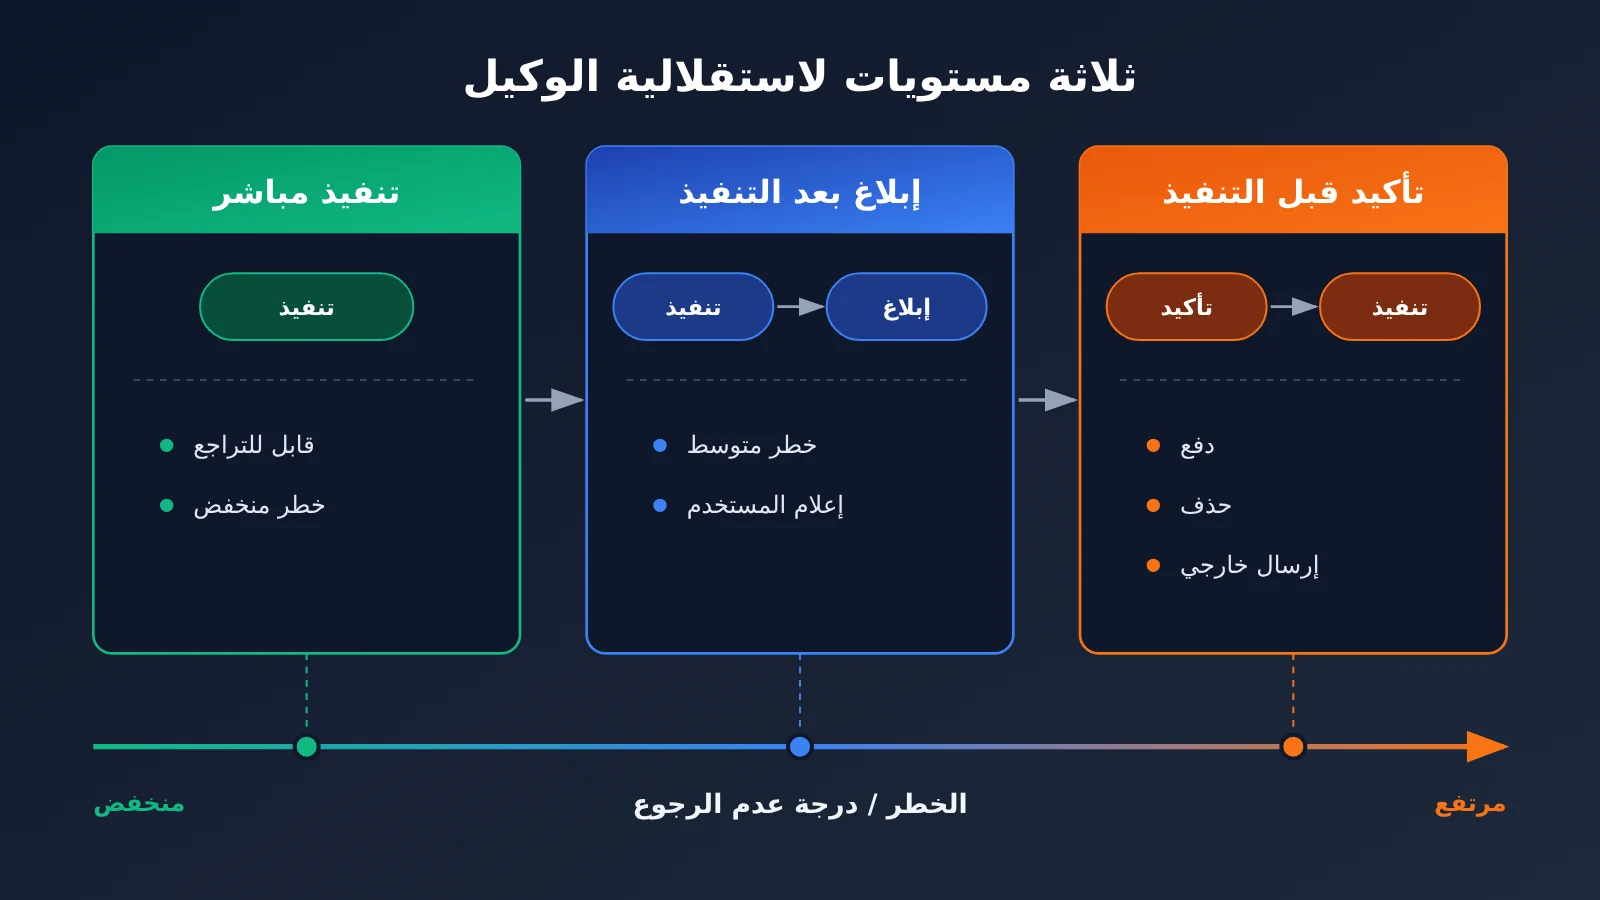
| التنفيذ الذاتي | عمليات منخفضة المخاطر وقابلة للتراجع | نفّذها مباشرة، ثم قدّم تقريرًا موجزًا بعد الانتهاء |
| الاعتراض عالي المخاطر | يتعلق بالدفع أو الحذف أو الإرسال الخارجي | يجب تأكيد ثانٍ، مع توضيح العواقب |
| تقرير التقدم | مهام متعددة الخطوات وتستغرق وقتًا طويلًا | قدّم تغذية راجعة مرئية عند كل خطوة رئيسية |
| معالجة الفشل | تعذّر فتح الموقع، أو الصلاحيات غير كافية | اشرح السبب واقترح الخطوة التالية، ولا تفشل بصمت |
| إنهاء المهمة | اكتمال المهمة | أعطِ إشارة واضحة «تم» وملخصًا للنتائج |
الخطوة 2: تحديد حدود استقلالية وكيل الذكاء الاصطناعي والتأكيد
بعد إعداد القائمة، حدّد لكل نوع من العمليات “درجة استقلالية”. التقسيم الشائع هو ثلاث درجات: تنفيذ مباشر، تنفيذ ثم إبلاغ، وتأكيد قبل التنفيذ. يعتمد القرار أساسًا على أمرين: هل يمكن التراجع عن العملية، وما حجم تكلفة الفشل.
هذه الخطوة هي الأكثر عرضة لاختلاف الآراء داخل الفريق. ولهذا يعتمد Muse على فريق صغير: فمسائل الحدود تحتاج إلى شخص واحد يتحمل مسؤولية التجربة الكاملة ويتخذ القرار النهائي، ولا يمكن ترك كل وحدة تقرر بطريقتها “المعقولة محليًا”. وإلا فقد تتطلب العملية نفسها تأكيدًا في صفحة A، بينما تُنفّذ مباشرة في صفحة B.
الخطوة 3: تحويل الحالة الداخلية لوكيل الذكاء الاصطناعي إلى إشارات مرئية للمستخدم
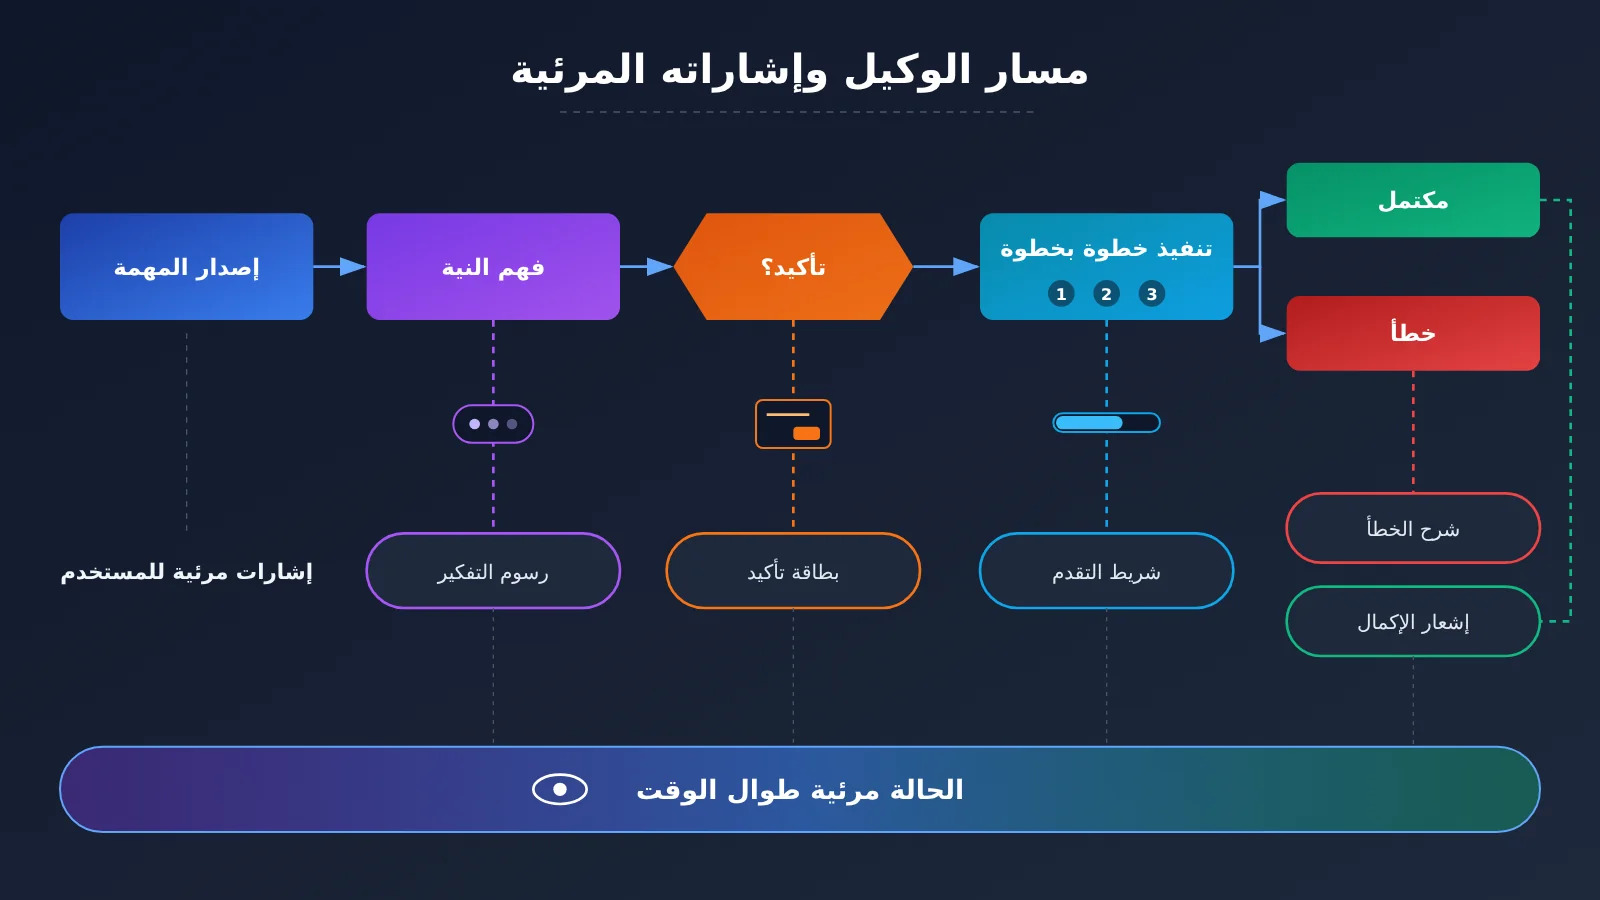
يمتلك الوكيل حالات داخلية كثيرة، لكن المستخدم يهتم بعدد قليل منها فقط. الطريقة العملية هي دمج الحالات الداخلية في 5 إلى 6 حالات يفهمها المستخدم، ثم تصميم إشارة ثابتة لكل حالة:
| الحالة الداخلية للوكيل | الإشارة المرئية للمستخدم | مثال مضاد شائع |
|---|---|---|
| تحليل النية / التخطيط | رسم متحرك للتفكير أو “أفهم طلبك الآن” | شاشة بيضاء لثوانٍ، يظن المستخدم أن النظام توقف |
| استدعاء أداة / الوصول إلى خدمة خارجية | عرض اسم الخطوة الحالية، مثل “جارٍ فتح صفحة الاشتراك” | عرض اسم الأداة الخام أو JSON مباشرة |
| انتظار تأكيد المستخدم | إبراز بطاقة التأكيد مع توضيح العواقب | إخفاء سؤال التأكيد داخل رد طويل |
| قيد التنفيذ (متعدد الخطوات) | تقدم خطوة بخطوة مع تمييز المكتمل والجارٍ | أيقونة دوران واحدة فقط |
| مكتمل | علامة إكمال واضحة وملخص للنتيجة | انتهى الرد دون توضيح هل نجحت المهمة |
| خطأ / انقطاع | شرح السبب بلغة بسيطة والخيارات المتاحة | رسالة خطأ تقنية، أو غياب أي تغذية راجعة |
من الناحية الهندسية، يمكن الاستفادة من الإخراج المتدفق لواجهة النموذج لقيادة هذه الإشارات. عند تفعيل stream في الصيغة المتوافقة مع OpenAI، تُعاد المحتويات واستدعاءات الأدوات على شكل مقاطع متتالية؛ كما تميّز أحداث التدفق في صيغة Anthropic Messages بين كتل النص وكتل tool_use. تكتفي الواجهة الأمامية بالاستماع إلى هذه الأحداث والتبديل إلى الحالة المرئية المقابلة، دون انتظار انتهاء الرد بالكامل.
الخطوة 4: تصميم مجموعة اختبارات سلوك وكيل AI
يجب أن يكون لكل سلوك حالة اختبار مقابلة، تغطي على الأقل ثلاث حالات: «المدخلات الطبيعية، والمدخلات الغامضة، والبيئة غير الطبيعية». عند الاختبار، لا تكتفِ بالتحقق من صحة الإجابة، بل انظر أيضًا إلى:
- هل تم التأكيد في المواضع التي تحتاج إلى تأكيد، وهل تجنّب الوكيل طرح أسئلة مزعجة في المواضع التي لا تحتاج إلى تدخل؟
- هل ظهرت إشارات الحالة في كل مرحلة في وقتها؟
- عند بدء المهمة نفسها من نقاط دخول مختلفة، هل كان السلوك متسقًا؟
- بعد حدوث خطأ، هل يستطيع المستخدم فهم المشكلة ومعرفة الخطوة التالية؟
يُنصح بتثبيت مجموعة الاختبارات، وتشغيلها بالكامل بعد كل تعديل للموجه أو تغيير للنموذج أو ضبط للأدوات، لتجنب إصلاح عنصر واحد وإفساد ثلاثة عناصر.
الخطوة 5: إجراء مقارنة على نماذج أساس مختلفة لوكيل AI
توضح Muse نقطة مهمة: قيمة طبقة الصقل لا تعتمد على «أقوى نموذج». قد تختلف نتائج قائمة السلوك نفسها عند تشغيلها على نماذج مختلفة، لذلك تحتاج إلى مقارنة أفقية للعثور على المزيج الذي يلبي معايير السلوك وبكلفة مناسبة.
| مرحلة الصقل | المتطلبات الأساسية من النموذج | منهجية الاختيار | المنصات المتاحة |
|---|---|---|---|
| تحليل النية والتخطيط | استدلال مستقر والتزام بالتعليمات | تفضيل النماذج الرائدة أو نماذج الاستدلال | APIYI apiyi.com، واجهات API الرسمية |
| تنفيذ استدعاء الأدوات | ثبات صيغة استدعاء الدوال | اختيار نموذج موثوق في استدعاء الأدوات | APIYI apiyi.com، واجهات API الرسمية |
| نصوص التقدم / بث الحالة | استجابة سريعة وتكلفة منخفضة | اختيار نموذج خفيف وسريع | APIYI apiyi.com، واجهات API الرسمية |
| التقييم الدفعي لمجموعة الاختبارات | حجم كبير وقابلية للتكرار | اختيار نموذج عالي القيمة مقابل التكلفة لأداء المراجعة | APIYI apiyi.com، واجهات API الرسمية |
🎯 نصيحة تقنية: عند إجراء مقارنة بين عدة نماذج، يمكنك استخدام APIYI apiyi.com كواجهة موحدة للاستدعاء. يوفر APIYI واجهات API لنماذج اللغة الكبيرة السائدة التي يتناولها هذا المقال، وهو متوافق مع صيغتي واجهة OpenAI وAnthropic. يمكنك باستخدام مجموعة واحدة من شفرة الوكيل تبديل المعامل
modelفقط لإجراء المقارنة، دون الحاجة إلى كتابة طبقة تكييف منفصلة لكل مزود. لمعرفة طريقة الوصول وعنوان الواجهة، ارجع إلى مركز توثيق APIYI على docs.apiyi.com.
الخطوة 6: مواصلة تحسين تجربة وكيل AI عبر “المرور الثاني والثالث”
تضم المواد المرجعية تشبيهًا لطيفًا: تجديد واجهة المطعم وحدها لا تكفي، بل يجب أيضًا تنظيف دورة المياه. أدوات AI الحالية قادرة على إنتاج نسخة أولى أنيقة بسرعة، لكن هذا يدفعنا في الواقع إلى إنتاج نسخ أولى جديدة باستمرار، بدلًا من إصلاح الأجزاء “التي تعمل لكنها غير مريحة” في المنتج الحالي.
نقترح أن تختار أسبوعيًا من سجلات الاستخدام الحقيقية مقاطع يظهر فيها تردد المستخدم أو تكراره للسؤال أو تخليه عن المهمة في منتصف الطريق، ثم تعود إلى الخطوة 1 لتحديث قائمة السلوكيات. فالمنتجات التي يداوم الناس على استخدامها تُصنع بالضبط في هذه المرات الثانية والثالثة التي لا يلاحظها أحد.
💰 ملاحظة عن التكلفة: تحتاج مجموعة اختبارات السلوك إلى تشغيل متكرر، وحجم استدعاء النماذج ليس صغيرًا. أما بخصوص سعر الإدخال والإخراج لكل نموذج وآلية حساب التخزين المؤقت، فيُرجى الاعتماد على البيانات الفعلية في صفحة أسعار APIYI https://docs.apiyi.com/models، فهذه المقالة لا تذكر أسعارًا محددة.
مقارنة بين خطط صقل وكيل AI
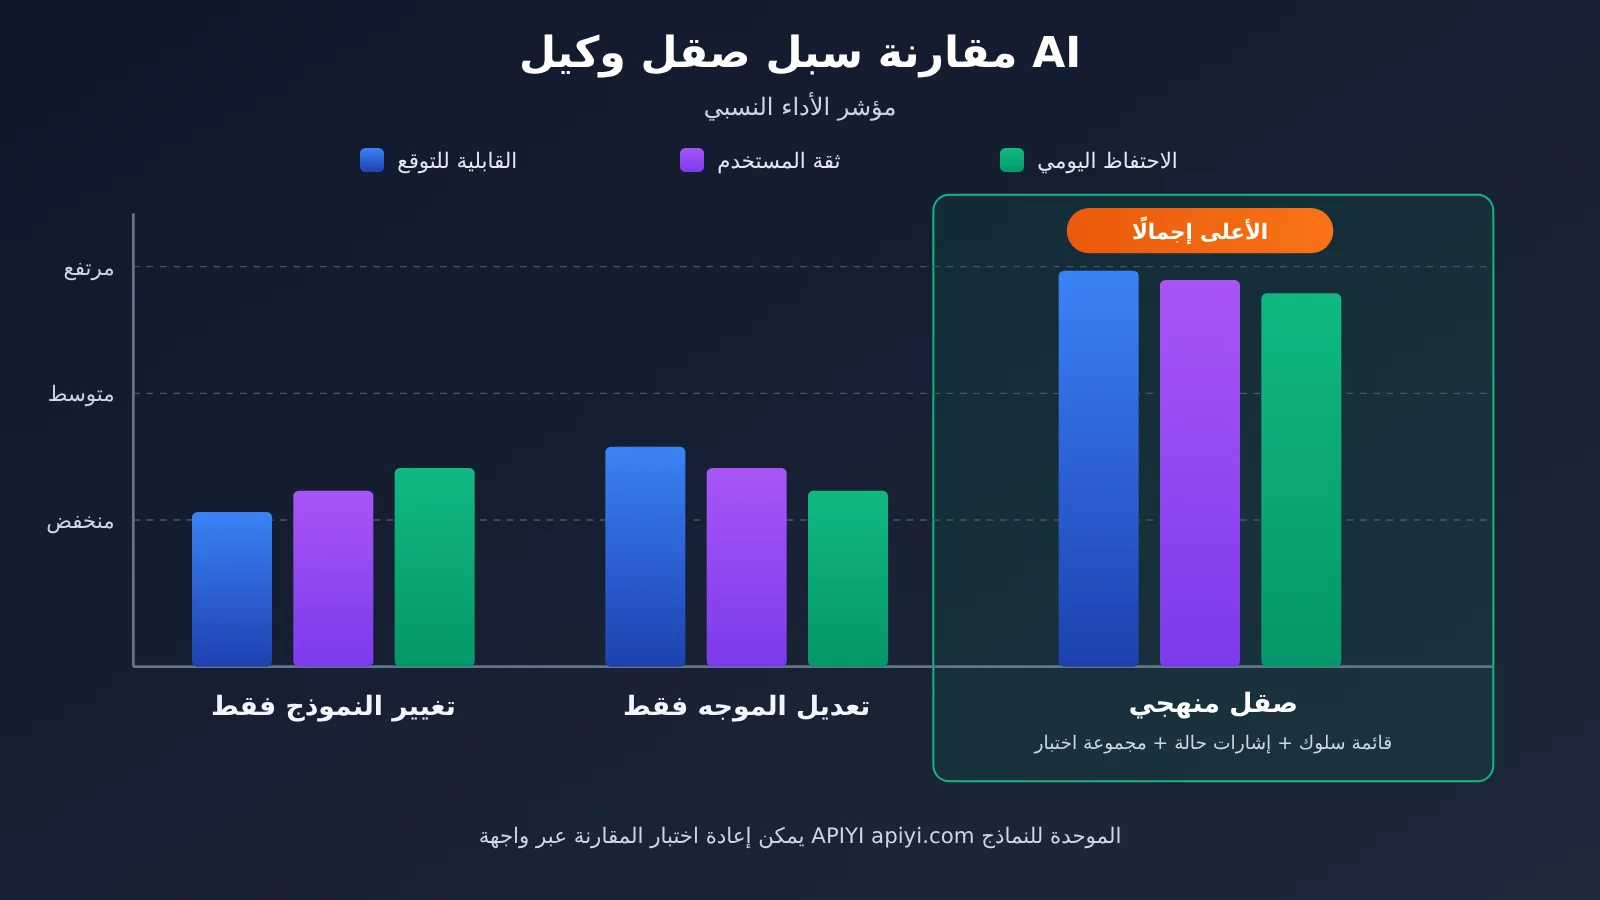
| النهج | الممارسة الأساسية | الحالات المناسبة | القيود الرئيسية |
|---|---|---|---|
| استبدال النموذج بنموذج أقوى فقط | ترقية النموذج الأساسي، مع توقع أن تتحسن التجربة تلقائيًا | النماذج الأولية المبكرة التي تفتقر بوضوح إلى القدرات | ارتفاع التكلفة، وبقاء مشكلات سلوكية مثل طلب التأكيد والإبلاغ |
| تعديل الموجه فقط | تكديس القواعد في موجه النظام | إصلاحات صغيرة لمشكلات فردية | كلما تراكمت القواعد زاد الارتباك، ويسهل تعارضها عند غياب الاختبارات |
| الصقل المنهجي | قائمة سلوكيات + حدود الاستقلالية + إشارات الحالة + مجموعة اختبارات | وكيل مهام يومية موجه للمستخدمين الحقيقيين | يتطلب استثمارًا كبيرًا في البداية، ويحتاج إلى شخص مسؤول عن التجربة الكاملة |
تحليل مقارن لخطط صقل وكيل AI
تحليل مقارن لاستبدال النموذج فقط: النماذج الأقوى تتقدم بالفعل في الاستدلال المعقد، لكنها لا تعرف من تلقاء نفسها أي عمليات في منتجك تحتاج إلى تأكيد مسبق، وكيف ينبغي عرض التقدم. في المقابل، يتعامل الصقل المنهجي مباشرة مع الاحتكاك الذي يشعر به المستخدم؛ وقد حقق Muse نموًا مبكرًا جيدًا دون الاعتماد على أقوى نموذج، وهذا مثال على ذلك.
تحليل مقارن لتعديل الموجه فقط: تعديل الموجه سريع النتائج، ويناسب معالجة المشكلات المحددة. لكن من دون قائمة سلوكيات ومجموعة اختبارات، يسهل تعارض القواعد، فإصلاح بند يؤثر على بند آخر. وبالنسبة إلى وكيل يُدار على المدى الطويل، يكون الصقل المنهجي أكثر استقرارًا.
💡 ملاحظة مقارنة: يُنصح بالتحقق من الفروق بين النهج أعلاه على بيانات عملك الخاصة. يمكنك عبر APIYI apiyi.com تشغيل نفس مجموعة الاختبارات على عدة نماذج ومقارنة النتائج، ثم تقييم العائد على الاستثمار بالاستعانة ببيانات صفحة الأسعار.
الأسئلة الشائعة حول صقل وكلاء الذكاء الاصطناعي
س1: ماذا يعني صقل وكيل الذكاء الاصطناعي تحديدًا؟
يقصد به اختبار سلوك الوكيل في المهام الواقعية بندًا ببند، ثم ضبطه وتثبيته، بما يشمل متى يطلب التأكيد، ومتى ينفّذ بشكل مستقل، وكيف يبلّغ عن التقدم، وكيف يشرح ما حدث عند وقوع خطأ، مع إتاحة رؤية حالة الوكيل الحالية للمستخدم في أي وقت. إنه عمل هندسي قابل للاختبار، وليس مجرد “تحسين التجربة” بصورة عامة.
س2: ما الفرق بين ضبط السلوك وهندسة الموجهات؟
هندسة الموجهات هي إحدى الوسائل، أما ضبط السلوك فهو الهدف والمنهجية. يبدأ ضبط السلوك بتعريف “قائمة السلوكيات المتوقعة” ومجموعة اختبارات، ثم يستخدم الموجهات وتصميم الأدوات وتفاعل الواجهة الأمامية وغيرها من الوسائل لتحقيقها، مع التحقق الانحداري المستمر. مجرد تعديل الموجهات دون بناء مجموعة اختبارات يجعل ضمان الاتساق أمرًا صعبًا.
س3: ما حجم مستخدمي Muse وحجم الفريق؟
وفقًا للتقارير، بلغ عدد مستخدمي Muse نحو 10 ملايين بعد حوالي ستة أسابيع من الإطلاق. وبحسب Alexander Wang، يبلغ مجموع فريقي النماذج والمنتجات أقل من 200 شخص. وبالنسبة لمستوى المليارات من المستخدمين الذي اعتادت عليه Meta، فهذا مجرد إنجاز مبكر، وسيلزم لاحقًا خفض تكلفة الخدمة وتوسيع النطاق.
س4: ما سيناريوهات الوكيل التي تناسبها رؤية الحالة أكثر من غيرها؟
تناسب بشكل أساسي السيناريوهات التالية:
– **المهام التوكيلية**: عمليات متعددة الخطوات مثل إلغاء الاشتراكات وتتبع الفواتير وملء النماذج؛
– **المهام المستغرقة للوقت**: التي تتطلب زيارة مواقع متعددة أو استدعاء أدوات متعددة، ويطول وقت تنفيذها؛
– **العمليات عالية المخاطر**: التي تشمل الدفع أو الحذف أو الإرسال الخارجي، وتتطلب تأكيدًا صريحًا من المستخدم.
س5: كيف تُنشئ بسرعة بيئة اختبار لصقل الوكلاء متعددة النماذج؟
يمكن اتباع الخطوات التالية:
1. سجّل في APIYI على apiyi.com واحصل على مفتاح API؛
2. راجع مركز التوثيق docs.apiyi.com، وادمج وفق الصيغة المتوافقة مع OpenAI أو Anthropic؛
3. باستخدام مجموعة اختبارات السلوك نفسها، بدّل معامل `model` بالترتيب لإجراء المقارنات؛
4. بالاستعانة ببيانات الفوترة الفعلية في صفحة الأسعار https://docs.apiyi.com/models، اختر مزيج النماذج المناسب.
س6: ما تكاليف الصقل المنهجي وحدوده؟
– **الاستثمار المسبق**: يتطلب بناء قائمة السلوكيات ومجموعة الاختبارات وقتًا، ولن تظهر “ميزة جديدة” على المدى القصير؛
– **تكلفة الاستدعاء**: تكرر اختبارات الانحدار استدعاء النموذج، وتُحتسب التكلفة وفق صفحة أسعار المنصة المستخدمة؛
– **المتطلبات التنظيمية**: يلزم وجود من يتخذ القرار بشأن التجربة الشاملة، وإلا ستختلف قواعد الحدود بسبب التنازلات من مختلف الأطراف؛
– **الحدود**: لا يمكن للصقل أن يسد الفجوات الصلبة في قدرات النموذج، وعندما تكون القدرات غير كافية بوضوح يبقى تغيير النموذج ضروريًا.
أهم النقاط في صقل AI agent
- الصقل قابل للاختبار: قبل إطلاق Muse، جرى تعديل أكثر من مئة سلوك محدّد للنموذج.
- سهولة الاستخدام لا تعني الأذكى: ميزة Muse أنها تقلّل الاحتكاك في الاستخدام، لا أن قدرات النموذج هي الأقوى.
- الحدود تحتاج إلى جهة تقرر: قواعد التنفيذ الذاتي والتأكيد المسبق يجب أن تكون موحّدة، ولا يقرّرها كل مكوّن على حدة.
- الحالة يجب أن تكون مرئية: استخدم إشارات تجيب المستخدم عن أسئلة مثل: هل فهم؟ هل يعمل؟ هل انتهى؟
- الحالات الطرفية مهمة أيضًا: تعامل مع الأخطاء والانقطاع وتبويب المتصفح الثاني ومسار العرض بالدرجة نفسها.
- المقارنة بين نماذج متعددة أكثر ثباتًا: يمكنك عبر الواجهة الموحّدة من APIYI مقارنة نماذج مختلفة باستخدام مجموعة الاختبار نفسها.
الخلاصة
النقاط الأساسية في صقل AI agent:
- ضبط السلوك: رتّب نقاط القرار في قائمة، واكتب لكل بند شرط التفعيل والسلوك المتوقع والمثال المضاد، ثم واصل الاختبار التراجعي بمجموعة اختبار؛
- إظهار الحالة: اجمع الحالات الداخلية في إشارات قليلة يفهمها المستخدم، ترافقه خلال الفهم والتنفيذ والتأكيد والإنجاز والخطأ؛
- التحسين المستمر: ابحث عن نقاط الاحتكاك في سجلات الاستخدام الحقيقية، وواصل العمل على النسخة الثانية والثالثة بدل إعادة بناء النسخة الأولى مرارًا.
تجربة Muse تنطبق أيضًا على الفرق الصغيرة والمتوسطة: يتولى الفريق الصغير القرارات الرئيسية، ويأخذ التفاصيل المملّة على محمل الجد، وبعد الفشل يغيّر ما يهم فعلًا ثم يحاول مرة أخرى. كل هذا لا يتطلب خسارة أكثر من عشرة مليارات أولاً.
إذا كنت تستعد لبناء مجموعة اختبار سلوك لـ AI agent الخاص بك، يمكنك عبر APIYI apiyi.com إجراء مقارنات سريعة على نماذج متعددة. المنصة متوافقة مع صيغ واجهات OpenAI وAnthropic، وتجد تعليمات الربط في docs.apiyi.com، أما الفوترة فوفقًا لصفحة الأسعار https://docs.apiyi.com/models.
📚 المراجع
- MindStudio – دراسة حالة Muse من Meta: خلفية Muse وفريقها وتفاصيل تحسينها
- الرابط:
mindstudio.ai/blog/meta-muse-ai-companion-lessons -
الوصف: المصدر الرئيسي لوقائع دراسة الحالة في هذا المقال، نُشر في 4 نوفمبر 2026
-
مركز توثيق APIYI: إرشادات الوصول الموحّد إلى نماذج متعددة
- الرابط:
docs.apiyi.com -
الوصف: طرق التكامل بالصيغ المتوافقة مع OpenAI وAnthropic
-
صفحة أسعار نماذج APIYI: أساسيات احتساب التكلفة وسعر الوحدة لكل نموذج
- الرابط:
docs.apiyi.com/models - الوصف: تعتمد أسعار الإدخال والإخراج وأسعار التخزين المؤقت على البيانات الفعلية في هذه الصفحة
المؤلف: فريق APIYI التقني
تواصل تقني: يسعدنا تواصلكم معنا عبر الموقع الرسمي لـ APIYI على apiyi.com لتبادل الخبرات حول تحسين تطبيقات الوكيل (agent)، ولمزيد من المواد يمكنكم زيارة مركز التوثيق docs.apiyi.com