ملاحظة الكاتب: قد تُرفع درجات قوائم التقييم العامة عبر تحسينات تستهدف اختباراتها تحديدًا. يشرح هذا المقال أسباب ظاهرة benchmaxing، ويقدم 5 فحوص للتحقق من الموثوقية، و4 خطوات لبناء مجموعة اختبارات خاصة من مهامك الفعلية.
الخلاصة أولًا: يمكن استخدام درجات قوائم التقييم كنقطة بداية للبحث، لكن لا ينبغي الاعتماد عليها مباشرةً لاتخاذ قرار اختيار النموذج. غالبًا ما تفصل بين النماذج المتصدرة في القوائم الشاملة بضع درجات فقط، وقد تكفي هذه الدرجات لتغيير صاحب المركز الأول. وعندما يكون الفارق ضئيلًا إلى هذا الحد، يصبح تحسين الأداء خصيصًا لأسئلة الاختبار قادرًا على تغيير الترتيب. وتُعرف هذه الظاهرة باسم benchmaxing.
ما يحسم الاختيار فعلًا هو أداء النماذج المرشحة في مهام عملك. لا يرتّب هذا المقال النماذج، ولا يحكم على أي جهة بأنها «تغش». وينقسم إلى ثلاثة أجزاء: كيف تتعرف على الدرجات المتضخمة، وكيف تبني مجموعة اختبارات خاصة صغيرة باستخدام تذاكر عمل حقيقية، وفي أي الحالات لا تغطي قوائم التقييم أصلًا المقاييس التي تهمك.
ما هو benchmaxing؟ ثلاثة أسباب لتضخّم نتائج الاختبارات المعيارية
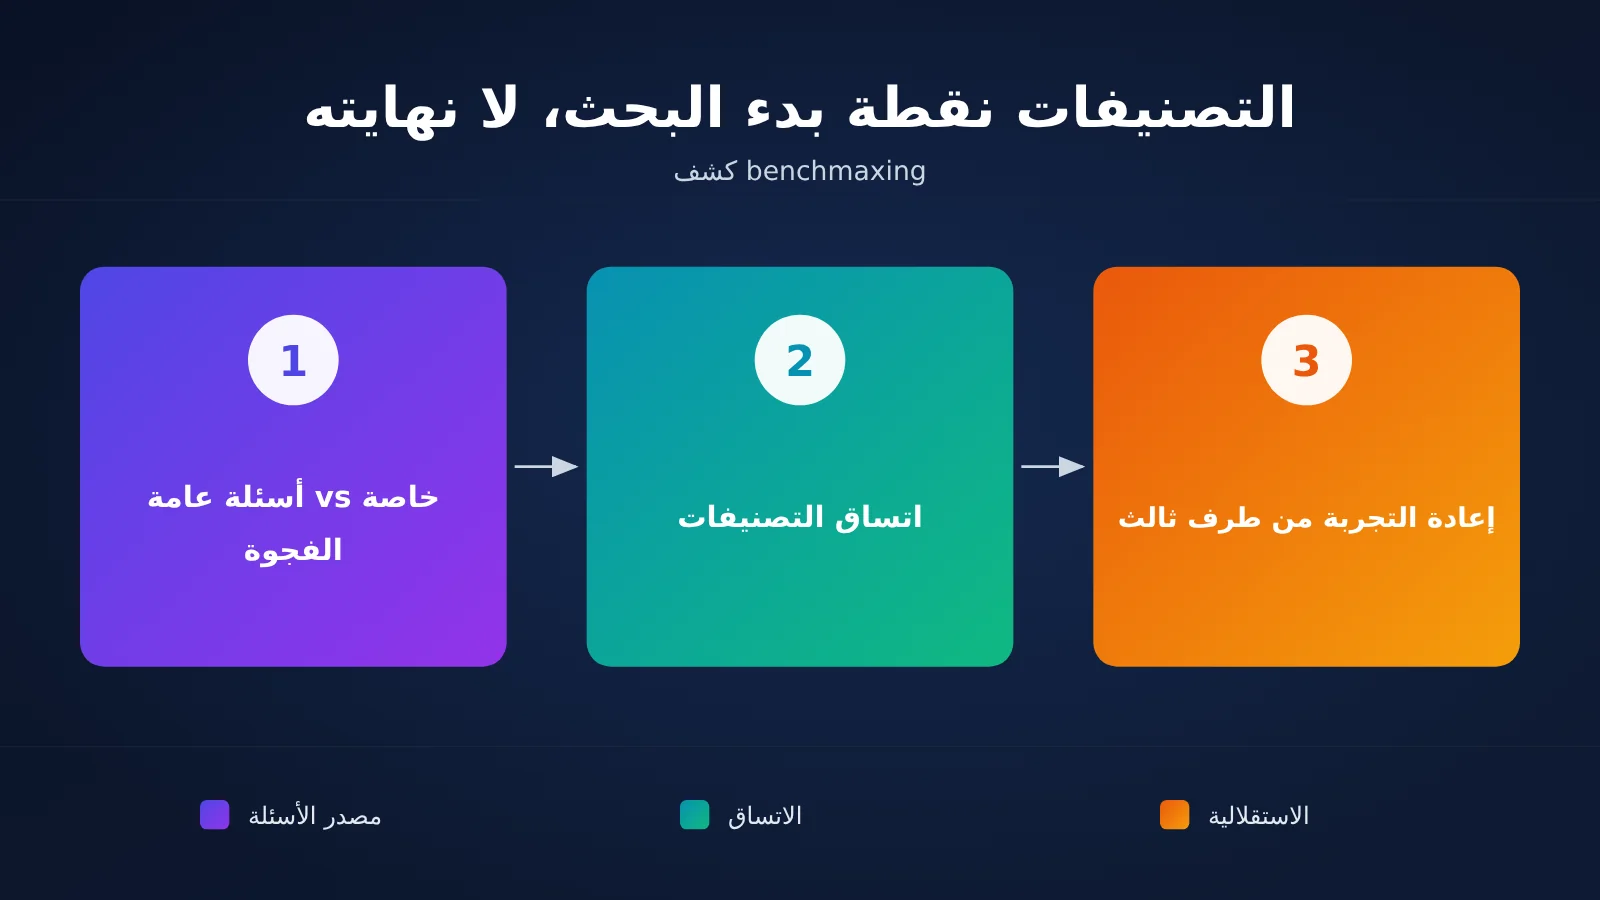
وفقًا لمقال نشرته MindStudio بتاريخ 2026-11-01، يشير مصطلح benchmaxing إلى تدريب النموذج أو ضبطه بهدف تحقيق درجات مرتفعة في اختبارات معيارية معروفة، بدلًا من تحسين قدراته العامة. وتظهر علامته النموذجية عندما يحقق النموذج نتائج لافتة في قوائم التصنيف، لكن أداءه يتراجع بوضوح عند مواجهة أسئلة جديدة تقيس القدرة نفسها.
| السبب | كيف يحدث | علامات تساعد على اكتشافه |
|---|---|---|
| تسرّب الأسئلة إلى بيانات التدريب | تختلط أسئلة الاختبار أو صيغ شديدة الشبه بها ببيانات التدريب، عمدًا أو دون قصد | ارتفاع الدرجة في الأسئلة الأصلية وانخفاضها بعد إعادة صياغتها |
| الضبط الدقيق بحسب نوع الأسئلة | يُحسَّن النموذج خصيصًا للصيغ وأنماط الاستدلال التي يفضلها اختبار معياري معين | يبرز في قائمة تصنيف واحدة فقط، بينما يكون أداؤه متوسطًا في القوائم الأخرى |
| تداول الأسئلة المنشورة لفترة طويلة | تُناقش الأسئلة في المنتديات والمدونات، ثم تصل في النهاية إلى البيانات المجمّعة من صفحات الويب | كلما كان الاختبار المعياري المنشور أقدم، اقتربت درجاته من الحد الأقصى |
لا ينطوي benchmaxing بالضرورة على نية سيئة
يشير المقال الأصلي إلى أن الحالات الثلاث لا تتطلب وجود نية سيئة. فقد يعتقد المختبر فعلًا أنه يحسّن قدرات الاستدلال العامة، بينما يكون النموذج في الواقع قد أفرط في التكيّف مع عدد قليل من أنواع الأسئلة المعروفة. وكلما طالت فترة نشر الاختبار المعياري، قلّت قيمته في قياس القدرات، وأصبح أشبه باختبار تجريبي سبق للنموذج أن حلّه.
لذلك، عند التقييم، انظر إلى الأدلة لا إلى النوايا. ما يهم هو ما إذا كان الأداء نفسه ينتقل إلى أسئلة جديدة، لا التكهن بما إذا كان أحدهم قد فعل ذلك عن قصد.
لماذا ظهر benchmaxing: وتيرة الإصدارات والمقارنات بين النماذج
الدرجات هي أسهل وسيلة للمختبرات لإثبات التقدم للمستثمرين والمطورين والجمهور، من دون الحاجة إلى الخضوع لتدقيق مستقل وشامل. فمن السهل إدراج رقم مثل «59 نقطة في المؤشر الشامل» في بيان صحفي، ومقارنته برقم آخر حققه منافس. وكلما كان الرقم أبسط، زاد الضغط لتحسين الأداء وفقًا له.
ويأتي الدافع الثاني من وتيرة الإصدارات. فبحسب المقال نفسه من MindStudio، حصل أحد نماذج Google Gemini على 50 نقطة في مؤشر Artificial Analysis، وبعد نحو شهر حصل نموذج لاحق من الشركة نفسها على 59 نقطة وتصدر الترتيب. هذه البيانات واردة في مصدر واحد فقط، ولم يجرِ هذا المقال تحققًا مستقلًا منها. والمقصود في المقال الأصلي هو أن التطور يُقاس بالأسابيع، والفوارق بين النماذج المتصدرة ببضع نقاط، ما يجعل أي وسيلة لتوسيع الفارق جذابة.
صنّف الحقائق قبل قراءة الترتيب
عند الاستشهاد بدرجة، تحقّق أولًا من الفئة التي تنتمي إليها. يوضح الجدول التالي ذلك باستخدام أمثلة من هذا المقال:
| نوع المعلومة | مثال من المقال | كيفية التعامل مع موثوقيتها |
|---|---|---|
| تصريح رسمي / توقع شفهي | قال ماسك إن Grok 5 قد يحقق نتيجة «قريبة من الدرجة الكاملة» في Humanity’s Last Exam؛ وقال إن Grok 4 حقق نحو 52% في الجزء النصي من الاختبار | هذه توقعات وتصريحات ذاتية، وليست نتائج اختبار مستقل |
| اختبار مستقل من طرف ثالث | يجمع مؤشر Artificial Analysis اختبارات في الاستدلال والبرمجة والعلوم والرياضيات وغيرها | يمكن الاستئناس به، مع ذكر تاريخ الاستشهاد |
| تقرير إعلامي من مصدر واحد | درجة Grok 4.7 في المؤشر ونتيجته في Terminal-Bench، وتغير درجة Gemini من 50 إلى 59 | المصدر الوحيد هو MindStudio، ولم تُتحقق هذه البيانات بشكل مستقل |
| مجهول | التوقيت الدقيق لانتقال Artificial Analysis إلى أسئلة غير معلنة ونطاق هذا الانتقال | يُرجع إلى توضيحها الرسمي، ولا يقدم هذا المقال استنتاجات بشأنه |
بحسب MindStudio، جاء Grok 4.7 خلف النماذج المتصدرة في كل من المؤشر الشامل المستقل وTerminal-Bench. وقد تعامل المقال الأصلي مع هذه «الفجوة بين التوقعات المعلنة والاختبارات المستقلة» بوصفها إشارة تستحق النظر، وأوضح أنها لا تعني أن لدى xAI مشكلات أكثر من الشركات الأخرى. ويستخدمها هذا المقال بالطريقة نفسها، من دون استخلاص أي استنتاج.
5 مؤشرات لتقييم موثوقية درجات قوائم الترتيب
يلجأ القائمون على التقييمات المستقلة إلى حل مباشر: عدم نشر الأسئلة. فإذا لم تُنشر الأسئلة أصلًا، فلن يستطيع أي طرف تدريب نموذجه عليها تحديدًا. وبحسب MindStudio، انتقلت مؤسسات مثل Artificial Analysis بالفعل إلى استخدام أسئلة خاصة. ويُعدّ الفارق بين درجات الأسئلة المنشورة ودرجات الأسئلة الخاصة الجديدة، ضمن فئة القدرة نفسها، من أوضح مؤشرات رصد benchmaxing، أي تحسين أداء النموذج خصيصًا للاختبارات المعيارية.
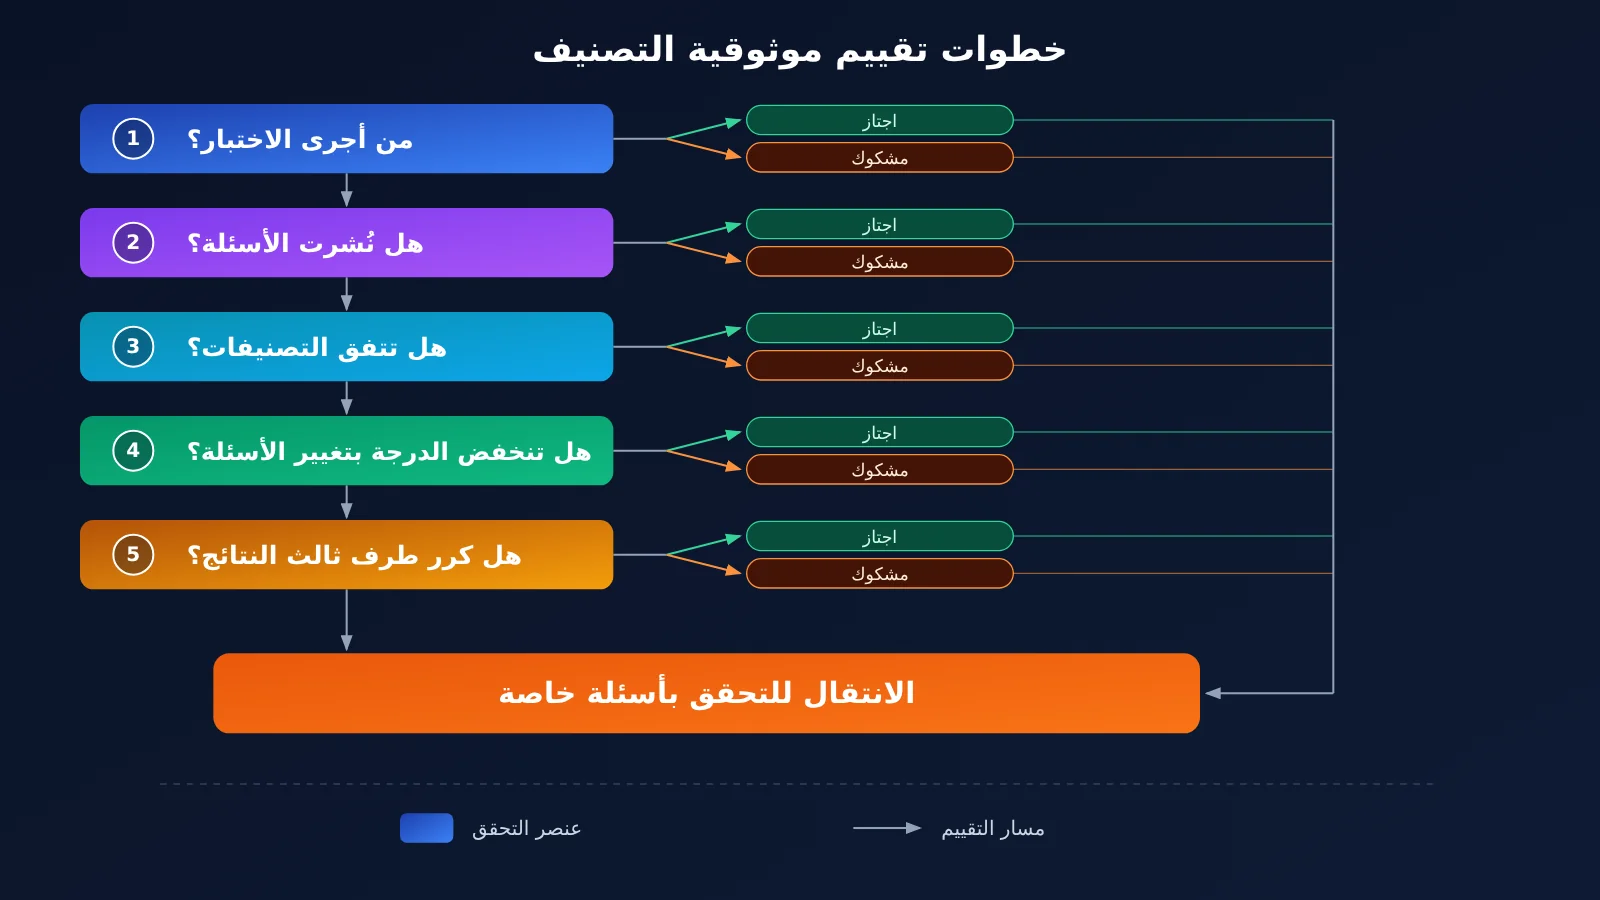
وبالاستناد إلى توصيات المقال الأصلي، يمكن تلخيص طريقة التحقق في قائمة الفحص التالية:
| الرقم | عنصر التحقق | كيف تتحقق؟ | إشارة مطمئنة | إشارة تستدعي الحذر |
|---|---|---|---|---|
| 1 | من أجرى الاختبار؟ | تحقق مما إذا كانت النتيجة واردة في تقرير تقني للشركة أم في صفحة تقييم لطرف ثالث | تشغيل مستقل بواسطة طرف ثالث | نتائج تعلنها الشركة بنفسها فقط |
| 2 | هل نُشرت الأسئلة من قبل؟ | تحقق مما إذا كان تاريخ نشر المعيار يسبق تاريخ انتهاء تدريب النموذج | أسئلة خاصة أو جديدة ظهرت بعد التدريب | أسئلة قديمة منشورة منذ سنوات |
| 3 | هل النتائج متسقة عبر قوائم متعددة؟ | قارن بين معايير متعددة، مثل الاستدلال والبرمجة والرياضيات | ترتيب متقارب في مختلف القوائم | تميّز في قائمة واحدة فقط |
| 4 | هل تنخفض الدرجة عند تغيير أسئلة القدرة نفسها؟ | قارن بين المجموعات المنشورة والخاصة، وبين الأسئلة الأصلية والمعاد صياغتها | فرق بسيط بعد تغيير الأسئلة | انخفاض واضح بعد تغيير الأسئلة |
| 5 | هل أعاد طرف ثالث إنتاج النتائج؟ | ابحث عن تقارير مستقلة لإعادة إنتاج النتائج وتحقق من إعدادات التقييم | إعادة الإنتاج من جهات متعددة مع شفافية الإعدادات | تعذّر إعادة الإنتاج أو عدم الإفصاح عن الإعدادات |
لماذا يصعب التلاعب بالمؤشر المركّب؟
يرى المقال الأصلي أن قيمة Artificial Analysis Index تكمن في جمعه أنواعًا متعددة من الاختبارات في درجة واحدة. قد يكون من الممكن الإفراط في مواءمة النموذج مع اختبار واحد، لكن مواءمته في الوقت نفسه مع اختبارات الاستدلال والبرمجة والعلوم والرياضيات أصعب بكثير، خصوصًا أن بعض أسئلتها غير منشور. لذلك، يمكن إعطاء وزن أكبر للبند الثالث: «اتساق النتائج عبر قوائم متعددة».
بناء مجموعة اختبارات خاصة من مهامك: عملية من 4 خطوات
مهما كانت لوحة المتصدرين موثوقة، فهي تقيس أداء النماذج على اختبارات غيرك. أما الاختيار النهائي فيحتاج إلى مجموعة اختبارات خاصة بك، وميزتها أن أياً من مختبرات النماذج لم يطّلع عليها.
| الخطوة | الإجراء | الطريقة | الناتج |
|---|---|---|---|
| ① أخذ العينات | اختيار مهام من العمل الفعلي | استخدم تذاكر الدعم الفعلية، وحالات الفشل في سجلات الإنتاج، ومحادثات شكاوى المستخدمين؛ صنّفها حسب نوع المهمة، وابدأ بـ 20–50 حالة لكل نوع | مجموعة اختبارات أولية مُصنّفة |
| ② تحديد معايير القبول | تحديد ما يُعدّ «كافياً» مسبقاً | أعطِ الأولوية للمخرجات القابلة للتحقق، مثل حقول JSON، وتصنيفات الفئات، ونجاح اختبارات الوحدة؛ واستخدم معايير تقييم واضحة للإجابات المفتوحة، مع مراجعة عينة بشرية بنسبة ثابتة | سكربت تقييم + معايير تقييم |
| ③ تشغيل عدة نماذج | ضبط المتغيرات لإجراء مقارنة عادلة | استخدم الموجه نفسه، والمعلمات نفسها، والمقيّم أو قواعد التقييم نفسها؛ وسجّل الدرجات وزمن الاستجابة واستهلاك الرموز | جدول مقارنة النتائج |
| ④ التحديث الدوري | منع تحوّل المجموعة إلى اختبار تدريبي آخر | أضف حالات فشل جديدة شهرياً، واستبعد الحالات التي تحقق فيها جميع النماذج الدرجة الكاملة؛ واحتفظ بجزء منفصل لا يُستخدم في ضبط المعلمات | مجموعة اختبارات بإصدارات محددة |
اختيار عينات مجموعة الاختبار الخاصة ومعايير القبول
عند اختيار العينات، تكون حالات الفشل أكثر قيمة من حالات النجاح. فالمحادثات التي أعاد فيها المستخدم طرح سؤاله، أو تطلبت تدخلًا بشريًا، أو حصلت على تقييم سلبي، تكشف الفروق بين النماذج بوضوح أكبر. ويجب تحديد معايير القبول قبل تشغيل النماذج، حتى لا تُصاغ المعايير على مقاس النتائج لاحقًا.
يجب أن يكون تعريف «جيد بما يكفي» قابلًا للقياس بالأرقام، مثل «بلوغ دقة استخراج الحقول المنظمة حدًا معينًا»، أو «خلو إجابات خدمة العملاء من الأخطاء الواقعية عند فحص عينة منها بشريًا». وتُحدد نسبة العينات المفحوصة بحسب المخاطر: يمكن زيادة الفحص في الأعمال عالية المخاطر، والاعتماد أساسًا على التقييم الآلي في المهام منخفضة المخاطر.
كيف تضبط المتغيرات عند مقارنة نماذج متعددة؟
أكثر مشكلات المقارنة شيوعًا هي عدم ضبط المتغيرات: فقد يُستخدم مع النموذج A موجه مُحسّن بعناية، بينما يُستخدم مع النموذج B موجه بصيغته الافتراضية. والطريقة الصحيحة هي استخدام الشفرة نفسها ومجموعة الاختبار نفسها، مع تغيير اسم النموذج فقط.
إذا كانت النماذج المرشحة من مزودين مختلفين، فقد تكون صيانة حزم SDK متعددة أمرًا مرهقًا. يتوافق APIYI مع تنسيق OpenAI، ويتيح استدعاء نماذج من مزودين مختلفين باستخدام رمز وصول واحد. وعند التبديل بينها، لا تحتاج إلا إلى تغيير المعامل model، ما يجعله مناسبًا لتشغيل مجموعة الاختبار نفسها ضمن سكربت التقييم نفسه. إليك الإعدادات:
- حزمة Python SDK الرسمية من OpenAI: عند تهيئة العميل، اضبط
base_urlعلىhttps://api.apiyi.com/v1وأدخل رمز وصول المنصة فيapi_key - تبديل النماذج في حلقة التقييم: غيّر حقل
modelفقط، واعتمد أسماء النماذج الواردة في قائمة APIYI على apiyi.com - تثبيت معاملات أخذ العينات: اضبط
temperature=0وقيمةmax_tokensنفسها لجميع النماذج، للحد من أثر العشوائية - تسجيل الاستخدام: اقرأ حقل
usageفي الاستجابة، واجمع استهلاك كل نموذج من الرموز المميزة عبر مجموعة الاختبار
🚀 للبدء سريعًا: اختر أولًا 3–4 نماذج من المراكز المتقدمة في قوائم الترتيب، تكون قد اجتازت الفحوصات الخمسة المذكورة أعلاه. ثم استدعها بالتتابع باستخدام رمز الوصول نفسه عبر APIYI على apiyi.com، وستحصل خلال فترة ما بعد الظهر على نسخة أولى من نتائج المقارنة باستخدام 50 تذكرة دعم حقيقية.
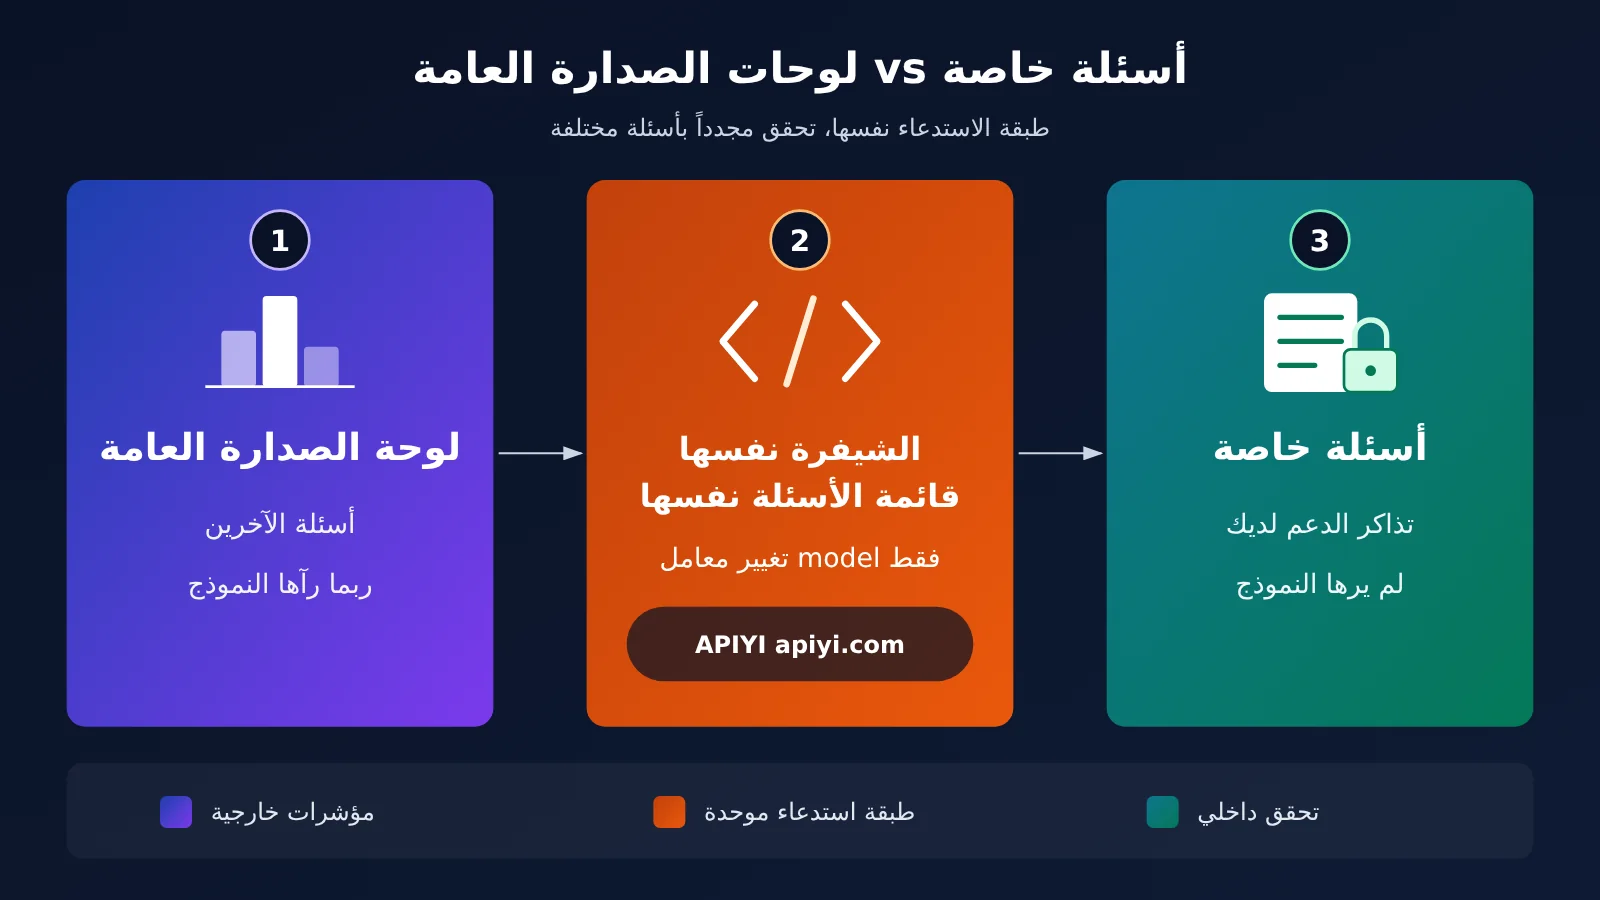
تجنّب ضبط النموذج على مجموعة الاختبار نفسها
قد تقع أنت أيضًا في فخ تحسين الأداء على مجموعة الاختبار فقط، أو ما يُعرف بـ benchmaxing. فتكرار تعديل الموجه حتى يحصل نموذج معيّن على الدرجة الكاملة في هذه الأسئلة الخمسين لا يختلف عمليًا عن سعي الشركات المصنّعة لتصدّر قوائم التقييم. ويمكنك تجنّب ذلك بهذه الخطوات:
- افصل مجموعة اختبار محجوبة: احتفظ بنحو 30% من الأسئلة جانبًا، واستخدم مجموعة التطوير فقط لضبط الإعدادات، ثم استند إلى المجموعة المحجوبة في القرار النهائي
- ثبّت الموجه: عند بدء المقارنة الرسمية، ثبّت نسخة الموجه برقم إصدار، وأعد اختبار جميع النماذج عند إجراء أي تغيير
- أضف أسئلة جديدة بانتظام: عند تحديث مجموعة الاختبار، أضف حالات فشل حديثة لتواكب المجموعة تغيّرات احتياجات العمل
متى لا تكفي درجات قوائم التقييم وحدها؟
حتى لو كانت درجات قوائم التقييم موثوقة تمامًا، فقد لا تقيس ما يهمك. في الحالات التالية، لا تصلح هذه القوائم إلا كمرجع عام:
| الحالة | لماذا لا تغطيها قوائم التقييم؟ | التقييم الإضافي المطلوب |
|---|---|---|
| المهام المتخصصة النادرة | نادرًا ما تظهر المصطلحات القطاعية والتنسيقات الداخلية واللغات الأقل شيوعًا في الاختبارات العامة | مجموعة اختبار خاصة تتكون من بيانات العمل الأصلية |
| استدعاء الأدوات ووكلاء الذكاء الاصطناعي | لا يمكن قياس استقرار الاستدعاءات متعددة الخطوات أو صحة تنسيق المعلمات من خلال سؤال وجواب في جولة واحدة | معدل نجاح المهام من البداية إلى النهاية، ومعدل أخطاء تنسيق استدعاء الدوال |
| التكلفة وزمن الاستجابة | ترتّب القوائم النماذج بحسب قدراتها فقط، دون احتساب تكلفة كل طلب أو زمن ظهور أول حرف | تسجيل استهلاك الرموز ومدة الاستجابة أثناء تشغيل مجموعة الاختبار |
| الاستقرار | لا تعكس نتيجة اختبار واحد التقلبات أثناء التشغيل الفعلي | تشغيل السؤال نفسه عدة مرات ومقارنة اتساق النتائج |
القاعدة العملية هي: بعد بلوغ مستوى القدرة المطلوب، تصبح المقارنة على أساس القيمة مقابل التكلفة والاستقرار. فقد يفي النموذجان الأول والثالث في قائمة التقييم بمتطلبات مجموعة الاختبار الخاصة بك، وعندها يكون النموذج الأقل زمنًا في الاستجابة والأسهل ضبطًا من حيث التكلفة هو الأنسب غالبًا. وعبر الوصول الموحّد إلى النماذج من خلال APIYI apiyi.com، يمكنك مقارنة القدرات والوقت والاستهلاك جنبًا إلى جنب في جدول نتائج واحد.
الأسئلة الشائعة FAQ
س1: هل يعني benchmaxing أن النموذج يغش؟
ليس بالضرورة. فقد تصل أسئلة الاختبار إلى بيانات التدريب دون قصد عبر أدوات جمع البيانات، وقد يعتقد الفريق فعلًا أن تحسين النموذج لأنواع معينة من الأسئلة يعزز قدرته على الاستدلال. عند التقييم، انظر فقط إلى ما إذا كانت النتائج تظل مستقرة بعد تغيير الأسئلة، دون افتراض النوايا.
س2: متى تظل درجات لوحات الصدارة موثوقة؟
تظل الدرجات مؤشرًا مفيدًا عندما تكون الأسئلة خاصة أو ظهرت بعد تاريخ انتهاء جمع بيانات التدريب، ويُجري الاختبار طرف ثالث مستقل، وتتفق نتائج عدة لوحات صدارة، ويتمكن آخرون من إعادة إنتاج النتائج. كما يصعب رفع مؤشر يجمع أنواعًا متعددة من الاختبارات بشكل مصطنع مقارنةً بمعيار واحد.
س3: كم سؤالًا تحتاج إليه مجموعة اختبار خاصة كحد أدنى؟
لا يوجد معيار موحد. عمليًا، يمكنك البدء بـ 20–50 عينة حقيقية لكل نوع من المهام، وهو عدد يكفي لرصد الفروق الواضحة. إذا لم تكن الفروق واضحة، أضف مزيدًا من الأسئلة مع الاحتفاظ بمجموعة منفصلة للتحقق.
س4: كيف أقارن نماذج من عدة مزودين باستخدام الشفرة نفسها؟
أسهل طريقة هي استخدام واجهة متوافقة مع OpenAI. بعد الحصول على رمز وصول عبر APIYI على apiyi.com، اضبط `base_url` على عنوان المنصة، ثم غيّر قيمة `model` فقط داخل الحلقة. هكذا يمكنك مقارنة النماذج باستخدام مجموعة الأسئلة نفسها. راجع قائمة النماذج على المنصة لمعرفة المتاح منها.
س5: هل حقق Grok 5 درجة شبه كاملة في Humanity’s Last Exam؟
حتى تاريخ كتابة هذا المقال، هذا توقع أعلنه ماسك، وليس نتيجة اختبار. وإذا تحققت هذه الدرجة مستقبلًا، فمن الأفضل مراجعتها باستخدام قائمة التحقق ذات البنود الخمسة، ولا سيما أداء القدرة نفسها على أسئلة جديدة وخاصة. ثم استخدم مجموعة أسئلتك عبر APIYI على apiyi.com للتحقق من مدى ملاءمة النموذج لاحتياجات عملك.
أبرز النقاط حول benchmaxing وتقييم المهام الخاصة
- التعريف: يشير benchmaxing إلى تحسين النموذج استنادًا إلى أسئلة اختبار معروفة، ما يؤدي إلى درجات في لوحات الترتيب أعلى من قدراته الفعلية.
- الأسباب: دخول الأسئلة ضمن بيانات التدريب، والضبط الدقيق بحسب نوع الأسئلة، وتداول الأسئلة العامة لفترات طويلة. ولا يتطلب أيّ من هذه الأسباب وجود نية سيئة.
- الإشارة الأساسية: تراجع الأداء عند اختبار القدرة نفسها بأسئلة جديدة هو أوضح علامة تحذيرية.
- 5 نقاط للتحقق: من أجرى الاختبار؟ هل سبق نشر الأسئلة؟ هل تتسق النتائج عبر عدة لوحات ترتيب؟ هل تنخفض الدرجات عند تغيير الأسئلة؟ وهل أعادت جهة مستقلة إنتاج النتائج؟
- إعداد مجموعة اختبار في 4 خطوات: اختيار العينات، وتحديد معايير القبول، وتشغيل عدة نماذج، وتحديث المجموعة دوريًا، مع الاحتفاظ بمجموعة محجوبة لتجنب الإفراط في التكيّف مع الاختبار.
- واجهة استدعاء موحّدة: باستخدام واجهة APIYI على apiyi.com المتوافقة مع OpenAI، يكفي تعديل المعامل
modelللتبديل بين النماذج.
الخلاصة: لوحات الترتيب نقطة بداية للبحث، وليست نتيجة نهائية
يمكنك البدء اليوم بثلاث خطوات. أولًا، راجع درجات لوحات الترتيب التي تتابعها باستخدام قائمة التحقق ذات النقاط الخمس، وسجّل نوع المعلومة وتاريخ الاستشهاد بها. ثانيًا، اختر 50 حالة فشل من سجلات الشهر الماضي، واكتب معايير القبول قبل تشغيل النماذج. ثالثًا، اختبر 3–4 نماذج مرشحة باستخدام الشفرة نفسها ومجموعة المعاملات نفسها، مع تسجيل الدرجات وزمن الاستجابة والاستخدام.
يُنصح باستخدام APIYI على apiyi.com لإجراء مقارنة بين عدة نماذج برمز وصول واحد، ثم تحديث مجموعة الاختبار شهريًا. يجب أن يستند قرار اختيار النموذج إلى مجموعة اختباراتك الخاصة، لا إلى اختبارات الآخرين.
📚 المراجع
- MindStudio: ما هو Benchmaxing؟ ولماذا تخفي مختبرات الذكاء الاصطناعي أسئلة الاختبار؟ (2026-11-01)
- الرابط:
mindstudio.ai/blog/ai-benchmark-maxing-private-tests -
التوضيح: يشرح مفهوم benchmaxing وأسبابه والتوجه نحو إبقاء أسئلة الاختبار سرية، وهو المصدر الوحيد لبيانات Gemini وGrok الواردة في المقال.
-
الموقع الرسمي لـ Artificial Analysis: تقييمات مستقلة للنماذج ومؤشر شامل
- الرابط:
artificialanalysis.ai - التوضيح: يُرجى الرجوع إلى البيان الرسمي لمعرفة موعد التحول إلى أسئلة الاختبار السرية ونطاقه.
الكاتب: فريق APIYI التقني
للتواصل التقني: يمكنكم التواصل معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، والاطلاع على مزيد من موارد التكامل في مركز التوثيق docs.apiyi.com.