يستخدم هذا المقال حالات الترحيل وخدمة العملاء والبرمجة مع GPT-6.1 Sol وGPT-6.2 Sol لتوضيح كيفية تثبيت شروط القبول في العمل أولاً، ثم اختيار مستوى الاستدلال (effort) القادر على تحقيقها بثبات، وحساب تكلفة كل مهمة ناجحة.
الخلاصة أولاً: عند ضبط المستوى، ينبغي أن تكون المقارنة على أساس «كم تكلّف المهمة الناجحة وكم تستغرق من الوقت»، أما سعر الاستدعاء الواحد فليس إلا بندًا واحدًا ضمن هذه المعادلة. في الاختبارات الصغيرة المنشورة، حقّق مستوى low في GPT-6.2 Sol العدد نفسه من النجاحات الذي حقّقه medium في أسئلة سياسات خدمة العملاء وفي مجموعة من مسائل البرمجة، وكان أسرع في الوقت نفسه. وفي مسائل البرمجة، تبلغ التكلفة المحسوبة من سعر low نحو سبعين بالمئة من تكلفة medium. ولكي يصح هذا الاستنتاج يلزم شرطان: أن تكون مهامك مشابهة بدرجة كافية لمهام الاختبار، وأن يتجاوز معيار القبول معدل النجاح وحده ليشمل فحص الروابط المختلقة وحقول المبالغ وإعادة العمل. أما المهام التي تنطوي على تعارض بين مصادر متعددة، أو اعتماد معقد على الأدوات، أو سهولة في تفويت القيود، فلا بد من التحقق منها بشكل منفصل عند مستوى medium وما فوقه.
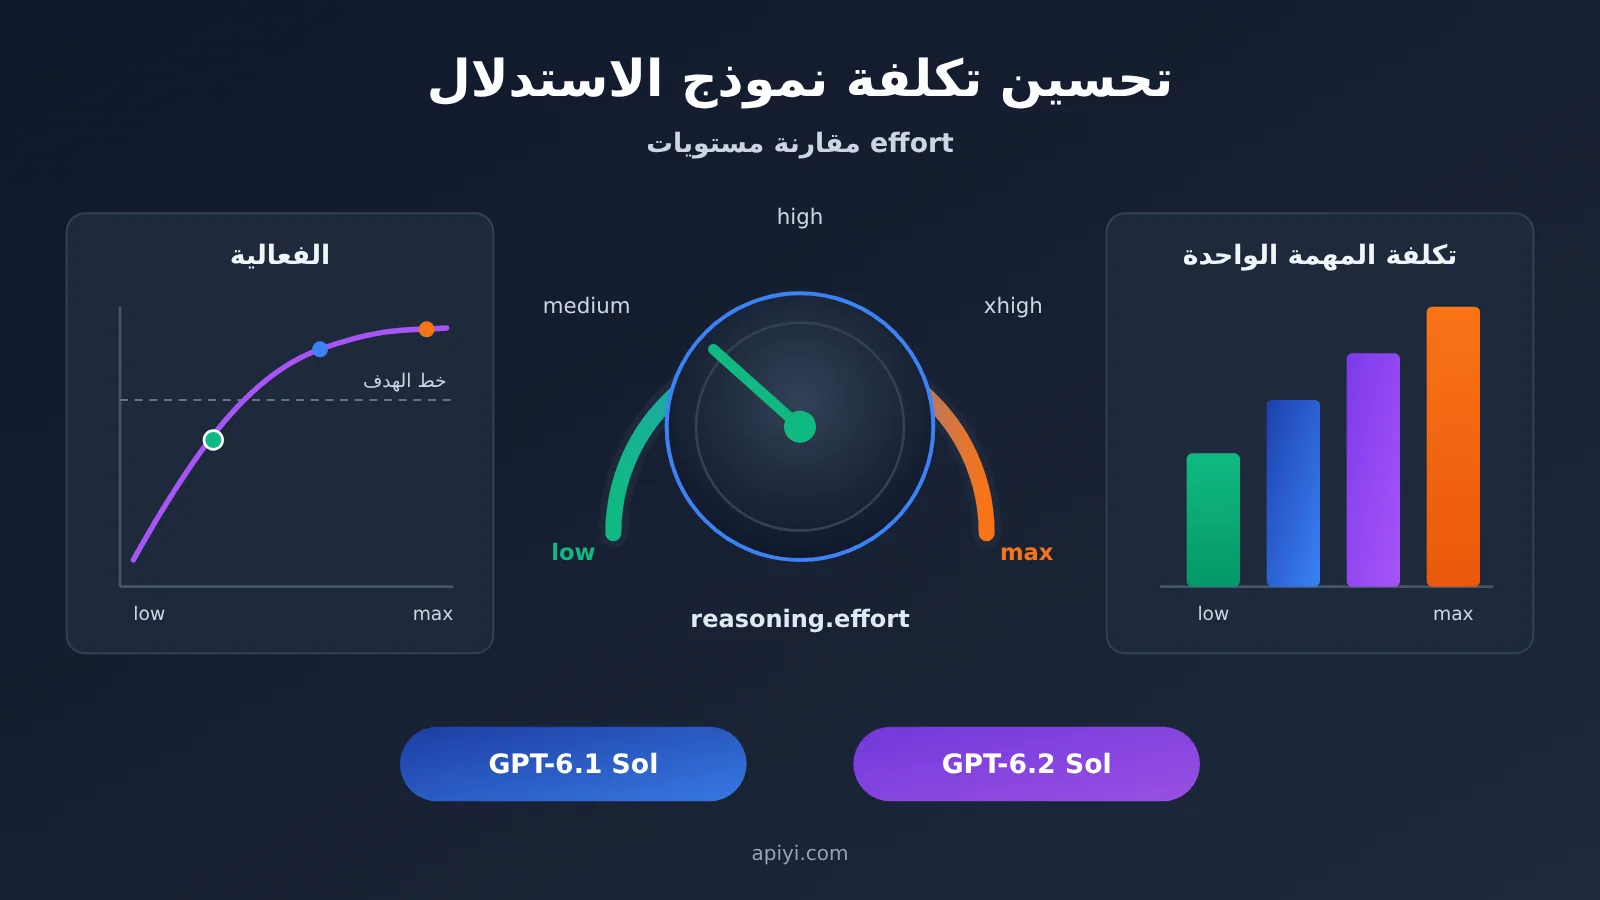
نظرة سريعة على مقارنة مستويات effort في نماذج الاستدلال
يجمع الجدول التالي مجموعات الأدلة التي سنستخدمها في هذا المقال، مع توضيح المصدر وطريقة القياس في كل صف. ولا يمكن جمع أرقام المصادر المختلفة أو خلطها معًا بشكل مباشر.
| بُعد المقارنة | GPT-6.1 Sol | GPT-6.2 Sol | ماذا يعني الاختلاف |
|---|---|---|---|
| المستويات المتاحة (وثائق OpenAI) | low, medium, high, xhigh, max | المستويات الخمسة نفسها، مع رفض none |
عند الانتقال من طراز يسمح بضبط none/minimal، ستحتاج إلى تغيير المستوى الابتدائي |
| أسعار APIYI للسياق القصير (الجدول الإجمالي بتاريخ 2026-11-20، دولار/مليون Token) | الإدخال $2، قراءة الذاكرة المؤقتة $0.10، الإخراج $10 | كما في العمود الأيسر | في السياق القصير يتطابق سعر الجيلين، وفرق التكلفة يأتي أساسًا من حجم الاستخدام |
| سعر الإدخال لما يتجاوز 272,000 Token إدخال | كل من APIYI وOpenAI Standard يذكر $4 | APIYI يذكر $3، وOpenAI Standard يذكر $4 | في سيناريوهات الإدخال الطويل تظهر فروق سعرية بين القنوات |
| eesel: 15 تذكرة دعم (low / medium) | 15/15، 3.8 ثانية؛ 15/15، 3.8 ثانية | 15/15، 3.2 ثانية؛ 15/15، 3.6 ثانية | نسبة النجاح متطابقة، والفرق في التكلفة بين المستويات طفيف |
| VulcanBench: 23 مسألة برمجية (low / medium) | 20/23؛ 22/23 (دفعة تاريخية) | 23/23؛ 23/23 | 6.2 Sol حقق الهدف عند المستوى المنخفض، والأرقام عبر الإصدارات تأتي من دفعات مختلفة |
| مؤشر Artificial Analysis (نقلًا عن OrcaRouter، low / medium) | 35؛ 46 | 41؛ 53 | مؤشر تجميعي من طرف ثالث، وتسميات المستويات يحددها التقييم نفسه |
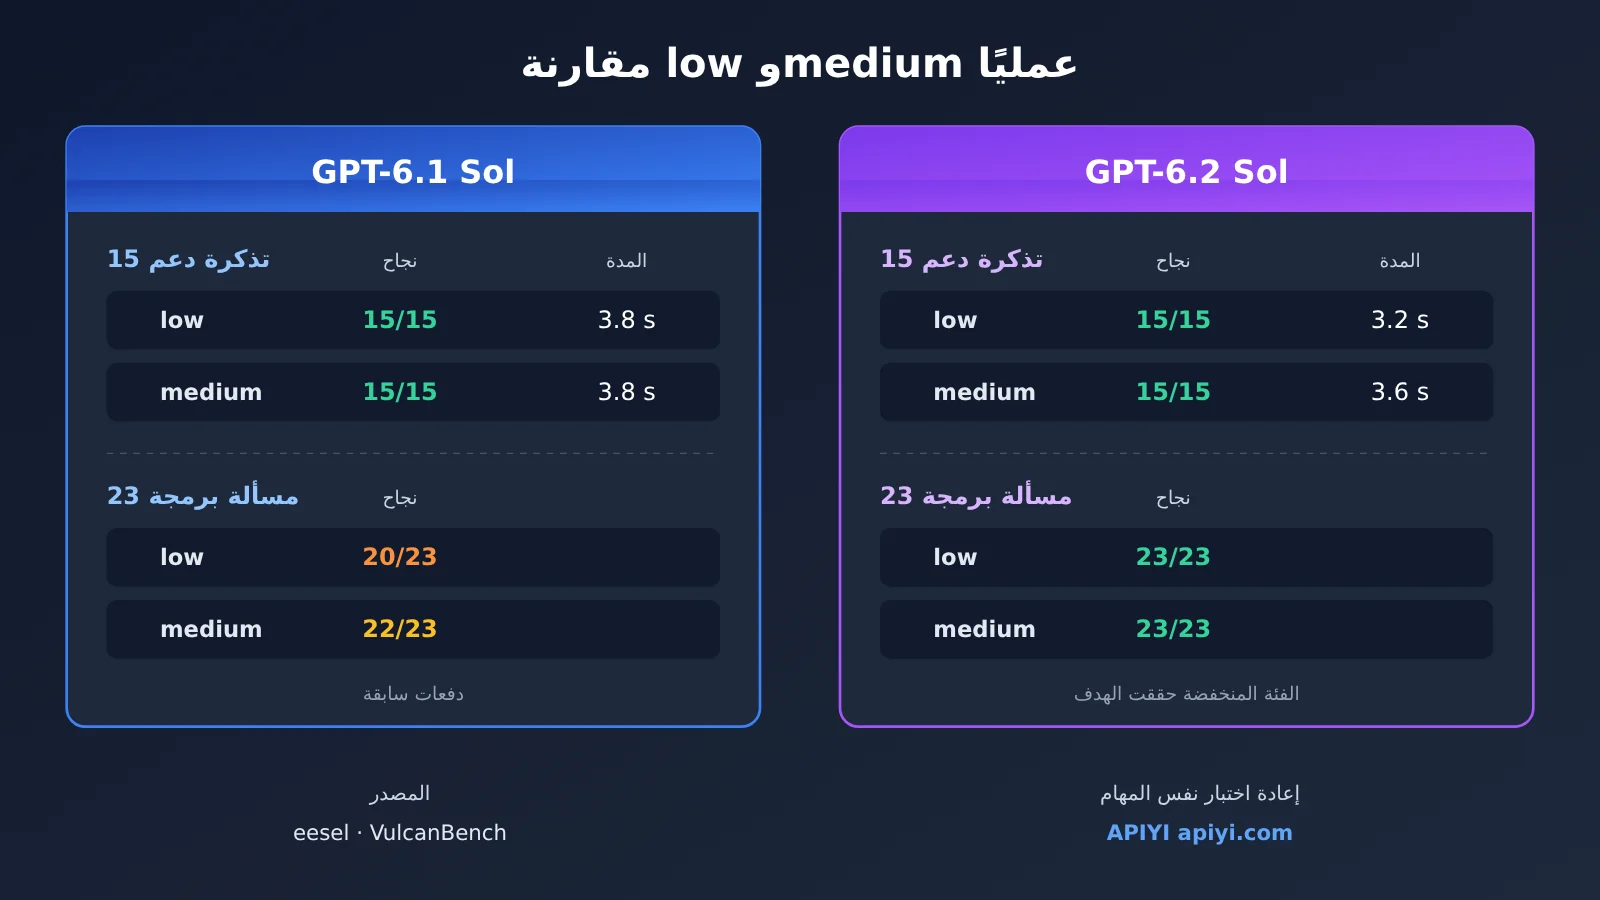
يسير المقال على الترتيب التالي: يتحقق القسم 1 من إمكانية الاتصال وكيفية حساب التكلفة، ويعرض القسم 2 نتائج القياس الفعلية على المهام نفسها، ويقدم القسم 3 خطوات الانتقال والتحقق، ويعالج القسم 4 مسألة تغيير المستوى في منتصف المحادثات متعددة الأدوار. وإذا كنت قد تحققت بالفعل من توجيه النموذج والأسعار، فيمكنك البدء بالقراءة من القسم 2 مباشرة.
مصطلحات مرتبطة بمستويات جهد الاستدلال: ما يجب معرفته
| المصطلح | الشرح |
|---|---|
reasoning.effort |
الحقل المستخدم في Responses API لتحديد شدة تفكير النموذج |
| رموز الاستدلال | مقدار الاستدلال الذي يستهلكه النموذج للوصول إلى الإجابة. وهو مشمول ضمن output_tokens التي تُحتسب عليها الفاتورة، ويلزم تمييزه عن المخرجات التي يراها المستخدم |
low / medium |
مستويان لجهد الاستدلال. وعند الانتقال إلى إصدار جديد عند المستوى نفسه، تبقى إعادة القبول والتحقق مطلوبة |
| سعر قراءة الذاكرة المؤقتة | ينطبق فقط على الجزء من المدخلات الذي يطابق مقدمة قابلة لإعادة الاستخدام، ولا يمكن حسابه مباشرة من إجمالي عدد الرموز |
| مقدمة الطلب | السياق الموجود قبل الرسالة الحالية. وتعديل التاريخ المبكر يؤثر على إعادة استخدام الذاكرة المؤقتة وعناصر الاستدلال |
configuration_update |
عنصر إدخال يُستخدم في جلسات Responses التي تدعم هذه الميزة لضبط الإعدادات اللاحقة |
| حد القبول | الحد الأدنى المقبول المحدد لصحة السياسات أو اجتياز الوظائف أو مستوى إعادة العمل |
| تكلفة كل مهمة مطابقة | إجمالي تكاليف الاستدعاء وإعادة المحاولة والأدوات وإعادة العمل البشرية في التجربة بأكملها، مقسومة على عدد المهام التي حققت المعايير |
1. قبل تحسين تكلفة نماذج الاستدلال: متى يستحق ضبط مستوى effort؟
1.1 حالة الوصول إلى الجيلين من Sol عبر APIYI
وفقًا لتحديثات منصة APIYI، أُطلِق GPT-6.1 Sol في 2026-09-30، وأُعلِن إطلاق GPT-6.2 Astra وSol في 2026-11-18. ويُظهر جدول الأسعار الشامل بتاريخ 2026-11-20 أن كلا إصداري Sol يوفران في الوقت نفسه مساري responses وchat، وتشمل المجموعات المعنية CodexResponses وCodex_Reverse وDefault وSVIP. أما القدرات التي يمكن للحساب استدعاؤها فعليًا، فتحددها المجموعة التي ينتمي إليها الرمز (token).
وفقًا لوثائق OpenAI، يدعم كلا الجيلين من Sol واجهتي Chat Completions وResponses، لكن استدعاء الأدوات يجب أن يمر عبر Responses، ويُضبط المستوى عبر reasoning.effort. لذلك، متى ما تضمنت الأعمال خطوات أدوات مثل الاستعلام عن الطلبات أو تنفيذ الشيفرة، ينبغي توحيد استخدام مسار Responses في التقييم والنشر، حتى لا تتسرب فروق السلوك بين المسارين إلى نتائج المقارنة.
1.2 نظامان للتسعير: السعر المعلن من APIYI والسعر القياسي للمزوّد الأعلى
| معرّف النموذج (الجدول الرئيسي لـ APIYI، 2026-11-20) | الإدخال العادي | قراءة الذاكرة المؤقتة | الإخراج | المنصات المتاحة |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | APIYI apiyi.com، منصة OpenAI الرسمية |
gpt-6.1-sol |
$2 | $0.10 | $10 | APIYI apiyi.com، منصة OpenAI الرسمية |
gpt-6-sol |
$2 | $0.20 | $10 | APIYI |
gpt-6.2-astra |
$8 | $0.40 | $40 | APIYI |
يمثّل الجدول أعلاه السعر الافتراضي للسياق القصير، بوحدة الدولار الأمريكي لكل مليون Token. وتسرد بطاقة الأسعار الخاصة بالمزوّد الأعلى، التي أعدّها OrcaRouter، السعر نفسه للإدخال وقراءة الذاكرة المؤقتة والإخراج لكلا جيلي Sol، وتضيف سعرًا منفصلًا لكتابة الذاكرة المؤقتة قدره $2.50. أما السياق الطويل فيحتاج إلى تحقّق منفصل: فعندما يتجاوز الإدخال في gpt-6.2-sol حدّ 272,000 Token، يسرد APIYI حاليًا $3، بينما يسرد OpenAI الرسمي ضمن Standard مبلغ $4؛ أما gpt-6.1-sol فيبلغ $4 لدى الطرفين. وأسعار الذاكرة المؤقتة والإخراج في الفئة الطويلة، فارجع فيها إلى قواعد الفوترة المحدّثة لحظيًا لكل قناة.
1.3 قراءة التكلفة من الاستجابة الفعلية والفاتورة
الأسعار المعلنة تصلح للتقدير فقط. نستخدم فيما يلي مثالًا افتراضيًا لتوضيح كيفية تفكيك التكلفة. لنفترض أن كل جولة تُدخل 12,000 Token، دون كتابة ذاكرة تخزين مؤقت ودون رسوم أدوات:
- الإبقاء على البادئة: قراءة من الذاكرة المؤقتة 9,000، وإجمالي المخرجات 1,000، والتقدير نحو $0.0169.
- تعديل البادئة: تنخفض القراءة من الذاكرة المؤقتة إلى 3,000، ويرتفع إجمالي المخرجات إلى 1,600، والتقدير نحو $0.0343.
من الفرق بين الحالتين، يأتي نحو $0.0114 من تحوّل 6,000 Token مُدخلة من سعر الذاكرة المؤقتة إلى السعر العادي، ونحو $0.0060 من 600 Token إضافية في المخرجات. هذه بيانات افتراضية، والفرق الفعلي يُحتسب وفق usage. وإذا وُجدت كتابة ذاكرة مؤقتة منفصلة، فينبغي حساب الإدخال العادي وقراءة الذاكرة المؤقتة وكتابة الذاكرة المؤقتة كثلاث فئات متمايزة.
طريقة التحقق من الخصم الفعلي: اربط x-request-id الموجود في رؤوس الاستجابة بسجل الاستهلاك في APIYI الذي يحمل type=2، ثم حوّل quota ÷ 500,000 إلى قيمة الخصم الفعلية بالدولار، وسجّل في الوقت نفسه النموذج ومجموعة الرموز ونافذة وقت الاستدعاء واستخدام الإدخال والإخراج وعدد المحاولات.
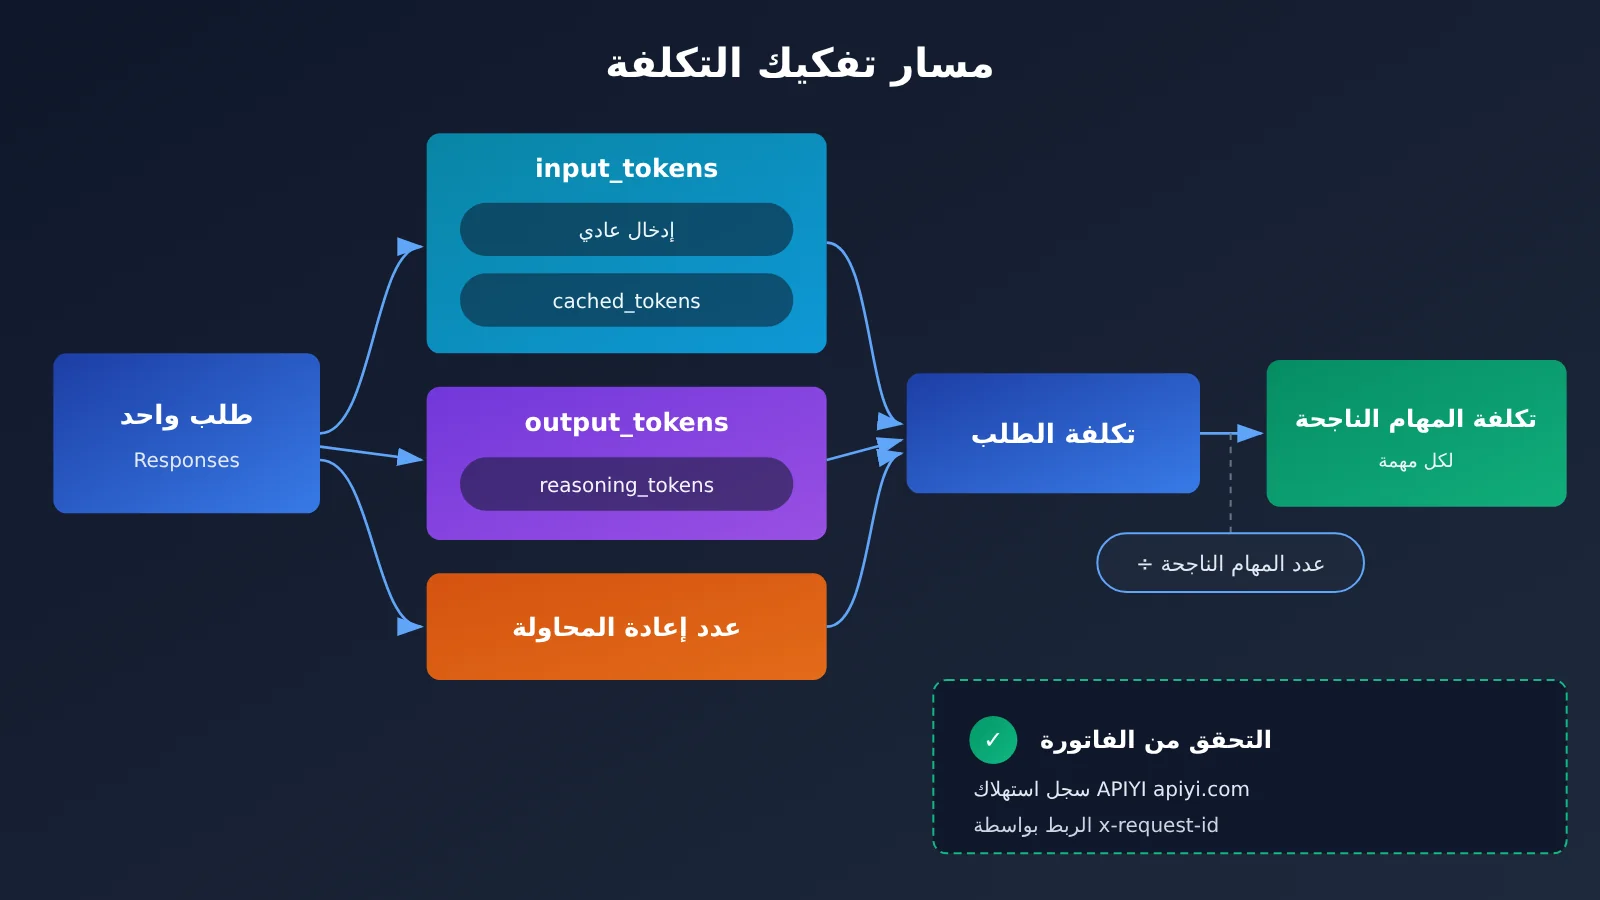
فيما يلي أبسط مثال على استدعاء، مع قراءة حقول الاستخدام اللازمة للتشخيص:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("输入:", u.input_tokens, "缓存命中:", u.input_tokens_details.cached_tokens)
print("总输出:", u.output_tokens, "其中推理:", u.output_tokens_details.reasoning_tokens)
🚀 بداية سريعة: ننصح بتشغيل المثال أعلاه أولًا على APIYI apiyi.com باستخدام حصة التجربة المجانية للمستخدمين الجدد، والتأكد من أن المجموعة المستهدفة تُرجع
cached_tokensوreasoning_tokensبشكل طبيعي، ثم البدء في التقييم بالدفعات.
2. مقارنة على المهمة نفسها: النتائج الفعلية لدرجتي low و medium
2.1 تذاكر الدعم الفني: الفائدة من الدرجة المنخفضة ضئيلة
في 2026-11-18، اختبر فريق الاختبار في eesel، عبر Responses API، الدرجتين low و medium لكلٍّ من جيلَي Sol، بإجمالي 60 استدعاءً. غطّت كل تهيئة التذاكر الـ15 نفسها، وتضمّن محتواها طلبات استرداد واستعلامات عن حالة الشحن وفشل أدوات الطلبات، وصُنّفت يدويًا وفق سياسة SaaS افتراضية.
| التهيئة (eesel، 15 تذكرة) | النجاح | متوسط الزمن | السعر المحتسب لكل ألف |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3.8 ثانية | $1.32 |
| GPT-6.1 Sol medium | 15/15 | 3.8 ثانية | $1.35 |
| GPT-6.2 Sol low | 15/15 | 3.2 ثانية | $1.41 |
| GPT-6.2 Sol medium | 15/15 | 3.6 ثانية | $1.42 |
في هذه البيانات، لا يفصل بين low و medium سوى بضعة سنتات لكل ألف تذكرة، لذا فإن أساس اختيار الدرجة هو زمن الاستجابة أكثر من التكلفة. ومن جهة أخرى، وبناءً على الاستخدام المقاس فعليًا، تبيّن أن GPT-6.2 Sol أغلى قليلًا من 6.1 Sol في هذه المجموعة من أسئلة الدعم الفني. والأهم من ذلك أن المؤلفين لاحظوا، رغم أن نسب النجاح في التهيئات الأربع كلها كاملة، أن 6.2 Sol يُخرج روابط شحن لا وجود لها في استجابات الأدوات. وهذا يعني أن قبول مخرجات الدعم الفني إذا اكتفى بـ«الإجابة الصحيحة وفق السياسة» فسوف يغفل هذا النوع من المشكلات، فلا بد من فحص مصدر الروابط والحقول بشكل منفصل. وهذه الأدلة تنطبق فقط على هذه التذاكر وهذا المعيار للتقييم وبيئة اختبار OpenAI.
2.2 مهام البرمجة: التكلفة لكل سؤال في الفئة المنخفضة تستحق القياس الفعلي
شغّل VulcanBench في 2026-11-19 أداة Codex على GPT-6.2 Sol عبر الفئات المختلفة على نفس مجموعة الاختبار المكوّنة من 23 سؤالًا، في 115 تشغيلًا. والمبالغ الواردة في الجدول أدناه محوّلة من إيصالات التشغيل وفق أسعار API المعلنة، وليست التسوية الفعلية لحساب APIYI.
| الإعداد (VulcanBench، 23 سؤالًا) | النجاح | متوسط المدة | السعر المعلن المحوّل/سؤال | الدرجة الإجمالية |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2.8 دقيقة | $0.23 | 88.44 |
| GPT-6.2 Sol medium | 23/23 | 4.4 دقيقة | $0.33 | 88.94 |
| GPT-6.2 Sol max | — | 11.3 دقيقة | $0.55 | 88.74 |
| GPT-6.1 Sol low (دفعة تاريخية) | 20/23 | 6.9 دقيقة | $0.31 | — |
| GPT-6.1 Sol medium (دفعة تاريخية) | 22/23 | 10.6 دقيقة | $0.40 | — |
وبالنظر إلى مجموعة GPT-6.2 Sol وحدها: الفئتان low وmedium لهما العدد نفسه من النجاح، لكن التكلفة لكل سؤال أقل بنحو الثلث، والمدة أقصر أيضًا؛ أما max فدرجته الإجمالية لم تتجاوز medium. والمقارنة بين الإصدارات تحتاج إلى حذر: فبيانات 6.1 Sol مأخوذة من تقييم تاريخي على المجموعة نفسها، وهي بذلك تنتمي إلى دفعة اختبار مختلفة. والدرجة الإجمالية هي تقييم لجودة الشفرة، وهي ومعدل نجاح الاختبارات مؤشران مختلفان لا يغني أحدهما عن الآخر.
وقدّم مؤشر Artificial Analysis Index v5.0.1 الذي نقله OrcaRouter (قُرِئ في 2026-11-20) زاوية أخرى: في الفئة low حصل 6.2 Sol على 41 نقطة بتكلفة $0.18 لكل مهمة، وحصل 6.1 Sol على 35 نقطة بتكلفة $0.16؛ وفي الفئة medium كانت القيم على التوالي 53 نقطة و$0.41، و46 نقطة و$0.36. وتسميات الفئات في هذا التصنيف الإجمالي تعكس طريقة التعيين الخاصة بالجهة المقيّمة، وقد لا يستخدم الإطار الذي تعمل عليه التعيين نفسه.
💡 توصية للاختيار: يوضح هذان القياسان الفعليان أن حد النجاح ومعدل إعادة المحاولة والعمل اليدوي الإضافي قد تغيّر جميعها “الفئة الأكثر اقتصادية”، لكنها ليست فاتورة عملك أنت. نوصي بإعادة القياس على APIYI apiyi.com باستخدام المجموعة نفسها ونفس العينة من البيانات، ثم اتخاذ القرار.
3. ترتيب الانتقال لتقليل تكلفة نماذج الاستدلال وعتبات القبول
3.1 حافظ على خط الأساس أولاً، ثم اضبط المستوى
وفقًا لما ورد في مستند OpenAI بعنوان “Using GPT-6.2″، غيّر متغيرًا واحدًا فقط في كل مرة عند الانتقال:
- إذا كنت تستخدم حاليًا 6.1 Sol
low: بدّل أولاً إلى 6.2 Sollowللمقارنة، ثم اختبرmediumبشكل منفصل. - إذا كنت تستخدم حاليًا 6.1 Sol
medium: بدّل النموذج أولاً مع الإبقاء علىmedium، وبعد اجتياز القبول قارنlowباستخدام نفس مجموعة المهام. - للتكامل الجديد: ابدأ من
medium. - عند الانتقال من نموذج يدعم
noneأوminimal: ابدأ اختبار GPT-6.2 Sol منlow.
بالنسبة للمهام البسيطة ذات القيود الواضحة، يمكن البدء من low للتحقق؛ وبالنسبة للمهام المركبة، ارفع المستوى تدريجيًا بناءً على النتائج. خلال فترة التقييم، ثبّت الموجهات وتعريفات الأدوات والتجميع وعينات الاختبار. كذلك نظّف المعاملات التي لم تعد مناسبة وفق التعليمات الرسمية، مثل إزالة temperature وtop_p وtop_logprobs من طلبات Responses.
3.2 حدّد عتبات القبول حسب السيناريو
| السيناريو | عتبة القبول | متى نفكر في رفع المستوى |
|---|---|---|
| خدمة العملاء العادية | التوافق مع السياسات، صحة حقول المبالغ، شروط التصعيد إلى موظف بشري؛ يجب أن تأتي الروابط وأرقام الطلبات من نتيجة الأداة | عند تداخل سياسات متعددة أو تسلسل عدة أدوات |
| تعديل الكود | نجاح الاختبارات، اكتمال الوظائف الأساسية، حجم إعادة العمل في مراجعة الكود | عندما تنخفض نسبة النجاح في المستوى المنخفض أو تزداد إعادة العمل بوضوح |
| المحتوى القصير | الالتزام بالقيود، صحة الحقول الحقائقية، مدة التعديل البشري | عند ظهور قيود مفقودة أو أخطاء في الحقائق |
تُحسب تكلفة كل مهمة مستوفية للشروط بجمع تكاليف الاستدعاء وإعادة المحاولة والأدوات وإعادة العمل البشري، ثم قسمة الناتج على عدد المهام المستوفية. إذا حقق low العتبة المتفق عليها، فيمكن اختياره؛ أما إذا احتاج low إلى إعادات محاولة متعددة أو تدخل بشري، فقد يلغي ذلك ميزة السعر المنخفض الظاهرة على الورق.
💰 تحسين التكلفة: عند إجراء مقارنة المستويات، يمكنك إنشاء رمز API منفصل للتقييم على APIYI apiyi.com، وبذلك تُصفّى السجلات مباشرة حسب الرمز والنموذج، ما يسهل حساب التكلفة الفعلية لدفعة التجارب كاملة.
4. تعديل مستوى الجهد في منتصف المحادثة متعددة الأدوار
4.1 ضبط المستوى باستخدام configuration_update مع الحفاظ على البادئة
في جلسة وكيل واحد عبر OpenAI HTTP Responses تدعم هذه الميزة، يبقى reasoning.effort على مستوى الطلب عند قيمته الأولية دون تغيير، وتوضع العبارة التالية قبل رسالة المستخدم التالية:
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
يظل هذا الإعداد ساريًا حتى التحديث التالي. وتكمن ميزة ذلك في عدم الحاجة إلى إعادة كتابة التاريخ المبكر، فيبقى بادئة الطلب دون تغيير. ووفقًا لوثائق OpenAI، بدءًا من GPT-6.2، قد يؤدي تحرير التاريخ المبكر إلى تفعيل prefix_mismatch، ما يؤدي إلى إزالة عناصر الاستدلال الموجودة؛ كما أن الانتقال إلى عائلة نماذج أخرى أو الانخفاض إلى طراز أقل قدرة قد يزيل عناصر الاستدلال أيضًا. ولإعادة كتابة البادئة تكلفتان: قد تقل قراءات ذاكرة التخزين المؤقت، وقد ينشأ ناتج استدلال جديد بعد فقدان عناصر الاستدلال القابلة للاستخدام. ووفقًا للتوثيق الرسمي، فإن حذف العناصر كاملةً مع إبقاء بقية العناصر دون تغيير، أو إلحاق عناصر جديدة بعد عناصر الاستدلال، لا يفعّل هذه الإزالة، لكن حجم إصابات ذاكرة التخزين المؤقت قد يتغير مع ذلك. بالإضافة إلى ذلك، تُلحق instructions العلوية في GPT-6.2 بعد input، وتُحتسب ضمن المدخلات غير المخزنة مؤقتًا.
4.2 اعتبارات ضغط السياق وتوجيه APIYI
عند استخدام context_management من جانب الخادم، يمكن أن يستمر الإعداد المحدّث. وإذا سُلّم التاريخ الذي يحتوي على configuration_update القديم مباشرةً إلى نقطة النهاية المستقلة /responses/compact، فسيُرفض الطلب؛ والطريقة الصحيحة هي فصل عناصر الإعداد أولاً وفقًا للتوثيق الرسمي، ثم إلحاق أحدث إعداد بعد اكتمال الضغط.
على APIYI، الطريقة الآمنة حاليًا هي إدارة تاريخ input بنفسك دون الاعتماد على previous_response_id. والسبب أن دليل الاستدعاء الأصلي لدى APIYI غير متسق في هذه النقطة: يذكر النص الأساسي أن الاستمرار المتسلسل لا يعمل، بينما يسجل قسم الأسئلة الشائعة أن الاختبار الفعلي في 2026-09-02 أثبت أنه يعمل. كما لا تسرد وثائق APIYI حاليًا نتائج التحقق من configuration_update في المجموعات المختلفة. لذلك، ينبغي التحقق أولاً من هذا النوع من الإعدادات الخاصة، وإعادة إرسال عناصر الاستدلال المشفرة، وحقول تشخيص ذاكرة التخزين المؤقت، بشكل منفصل عبر جلسات قصيرة على القناة المستهدفة، ثم إدماجها في سير العمل الرسمي بعد التأكد من أنها تعمل.
🎯 توصية تقنية: يمكن أولاً تشغيل مجموعة من الجلسات القصيرة المكوّنة من دورين على مسار Responses في APIYI apiyi.com، ومقارنة
cached_tokensوreasoning_tokensوالزمن المستغرق بين نموذجي “الإلحاق فقط” و”إعادة كتابة البادئة”، ثم تحديد طريقة تنفيذ تعديل المستوى في منتصف المحادثة بعد تأكيد السلوك.
الجملة الأخيرة: ينبغي أن يكون أساس اختيار المستوى هو تكلفة كل مهمة مستوفية للمعايير ضمن عتبة قبول ثابتة. وإجراء مقارنة على APIYI apiyi.com باستخدام عيناتك وفاتورتك هو أكثر تعبيرًا عن الحقيقة من أي قائمة تصنيفات.
المراجع
- OpenAI《Using GPT-6.2》: توصيات الترحيل وإعدادات مستوى البداية
- الرابط:
developers.openai.com/api/docs/guides/latest-model
- الرابط:
- OpenAI《Reasoning models》:
configuration_updateوإعادة استخدام عناصر الاستدلال- الرابط:
developers.openai.com/api/docs/guides/reasoning
- الرابط:
- OpenAI《Compaction》: قواعد ضغط السياق
- الرابط:
developers.openai.com/api/docs/guides/compaction
- الرابط:
- OpenAI《Keep the prefix unchanged》: تشخيص البادئة والتخزين المؤقت
- الرابط:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- الرابط:
- eesel AI《GPT-6.2 Sol: what’s new, pricing, benchmarks》: اختبار فعلي على تذاكر دعم العملاء، 2026-11-18
- الرابط:
eesel.ai/blog/gpt-6-2-sol
- الرابط:
- VulcanBench《GPT-6.2 Sol across effort levels》: تقييم مسائل البرمجة مستوى بمستوى، 2026-11-19
- الرابط:
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- الرابط:
- OrcaRouter《GPT-6.2 vs GPT-6.1 Sol》: نقل جدول الأسعار والمؤشر المركب، 2026-11-20
- الرابط:
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- الرابط:
- APIYI《الجدول الكامل لأسعار النماذج》: بيانات محدثة في 2026-11-20
- الرابط:
docs.apiyi.com/models
- الرابط:
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com، ولمزيد من إرشادات التكامل يمكنكم مراجعة مركز الوثائق docs.apiyi.com