一台笔记本电脑亮起,屏幕上出现的不是 Windows,也不是某个 Linux 发行版,而是一套 AI 从空文件夹开始搭出来的系统。2026 年 11 月 9 日,Anthropic 在发布 Claude Fable 5.2 时披露了这项内部实验:Fable 5.2 协调超过 1000 个子 Agent,连续工作 8 天,做出了一套能在真实笔记本电脑上启动的操作系统原型。
核心价值:本文以操作系统实验为主线,说明 Claude Fable 5.2 的真正突破在哪里,这 1000 个 AI Agent 应该怎样理解,以及这套原型离成熟产品还有多远。最后从开发者角度,讨论长周期 Agent 工作流对 API 基础设施提出了哪些要求。
Claude Fable 5.2 操作系统实验核心信息
先看官方明确披露的事实。下表只收录 Anthropic 公告中已经确认的内容。
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026 年 11 月 9 日,随 Claude Fable 5.2 发布一同披露 |
| 发布方 | Anthropic(内部工程实验) |
| 任务起点 | 一名工程师给出任务:从空文件夹开始,设计并实现一个原型操作系统 |
| 执行规模 | 超过 1000 个子 Agent,连续 8 天全天候运行 |
| 主要活动 | 编写代码、测试组件、审查代码、修改问题 |
| 最终功能 | 内核、磁盘 / 键盘 / 网络驱动、永久文件存储、窗口系统、登录界面、安装程序、内置 Claude 功能 |
| 关键验证 | 能在一台真实笔记本电脑上启动(Boot) |
| 尚未公开 | 源代码与构建流程、架构文档、代码行数、Agent 通信架构、Token 用量、实验成本、多硬件兼容性测试、第三方安全审计 |
1000 个 AI Agent 造出的操作系统包含哪些模块
几个关键模块的作用如下。内核是管理硬件和系统资源的核心软件,负责调度进程、分配内存、处理中断。驱动程序让操作系统能和磁盘、键盘、网卡这些硬件通信,没有驱动,内核就”看不见”外设。
永久文件存储意味着数据在重启后仍能保留,系统需要具备真正的文件系统,而不是只在内存里跑一遍演示。
窗口系统、登录界面和安装程序则属于用户可见的部分。安装程序这一项值得注意:它说明这套系统至少走通了”写入磁盘、再从磁盘启动”的完整链路。
把这些模块放在一起,才能理解为什么”能在笔记本上启动”是一个有分量的结果。它要求多个子系统真正联通,而不是各自写出几段看起来正确的代码。
这就引出了本文的核心问题:超过 1000 个 Agent,究竟是怎样协作完成一个完整工程的?
Claude Fable 5.2 的突破:AI 开始组织工程
Fable 5.2 在编程基准上确实进步明显。Anthropic 公布的 FrontierCode 2.0 成绩为 49.1%,前代 Fable 5.1 为 32.4%;FrontierSWE v2 成绩为 69.9%,前代为 56.3%。
不过这些是通用编程基准,不是操作系统实验本身的测试成绩。这次实验更值得关注的地方,不在代码写得多好,而在工程的组织方式变了。
传统 AI 编程助手与长周期 Agent 工程的区别
传统 AI 编程助手是一种”一问一答”的协作模式:用户提出需求,AI 写一段代码,用户检查后再提修改,循环往复。在这个模式里,任务拆解、进度管理和整体集成都由人来完成,AI 只是一个效率很高的执行者。
长周期 Agent 工程则把更多职责交给模型。下表对比了两种模式的差异:
| 维度 | 传统 AI 编程助手 | 长周期 Agent 工程 |
|---|---|---|
| 任务粒度 | 单个函数、文件或功能点 | 完整项目,需要自行拆分子任务 |
| 运行时长 | 一次对话,几分钟到几小时 | 连续数小时到数天 |
| 执行方式 | 单线程,等待人类反馈 | 多个子 Agent 并行处理不同模块 |
| 质量保障 | 主要靠人工检查 | 自动测试、交叉审查、发现问题后安排修复 |
| 集成工作 | 由人完成 | 由协调者汇总成果、检查模块兼容性 |
| 人的角色 | 逐步指挥 | 设定目标、监督过程、最终验收 |
对操作系统这样的项目来说,右侧这一列才是难点。内核、驱动和文件系统之间有大量接口约定,一个模块的改动可能让另一个模块的测试失败。
能持续 8 天发现问题、安排修复、推进未完成部分,体现的是”项目管理”能力,而不只是”写代码”能力。
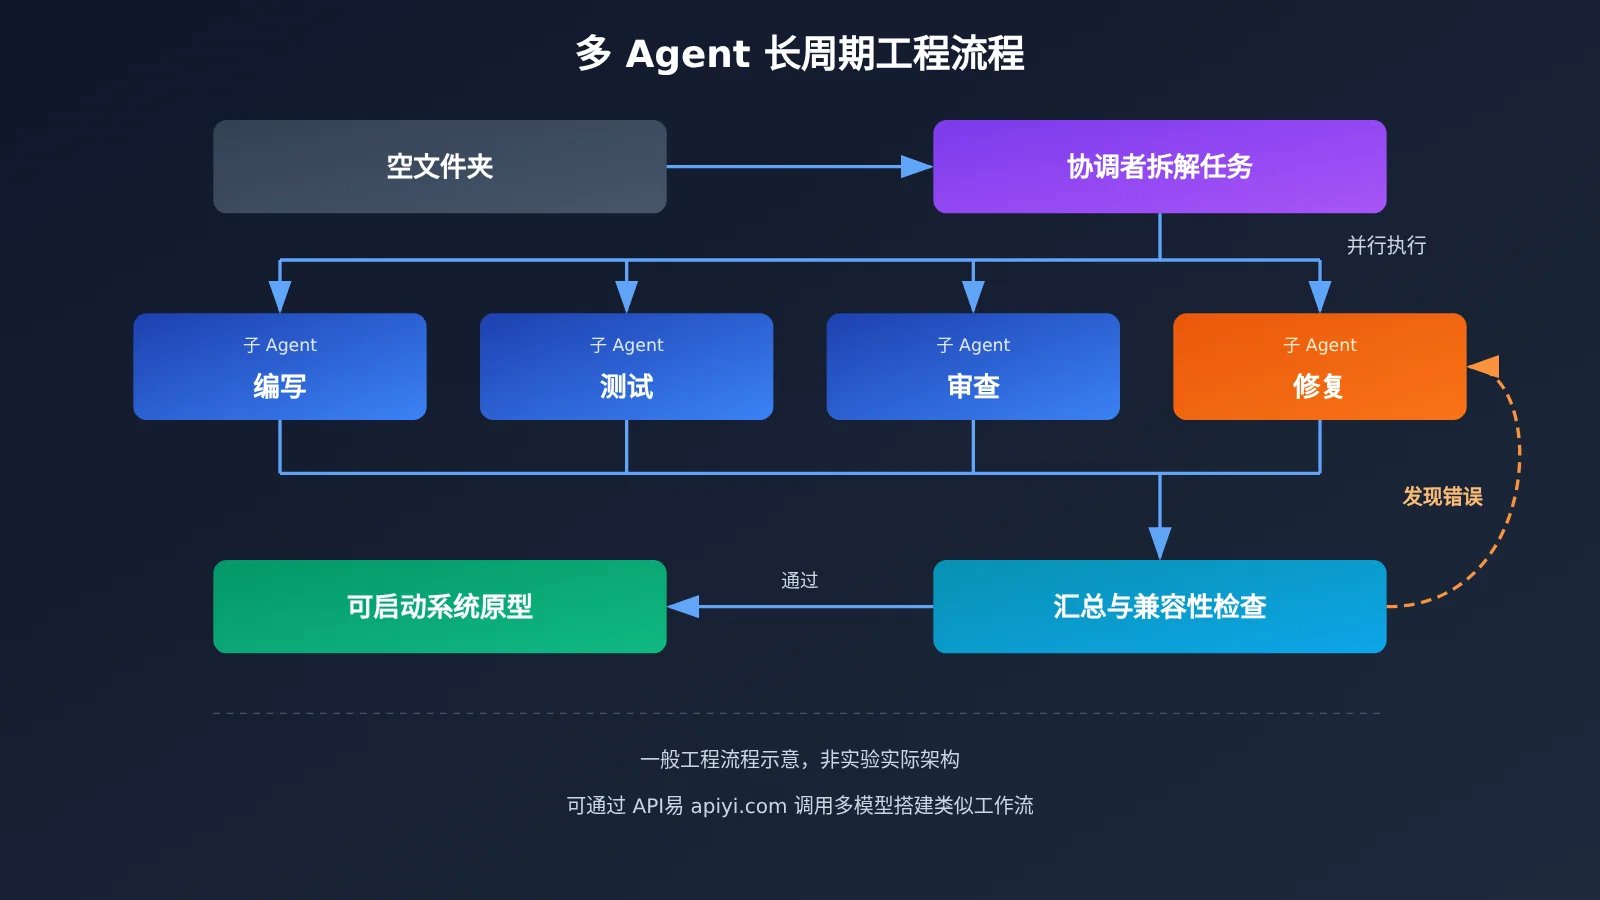
需要说明,上图是对大型工程一般流程的分析。Anthropic 没有公开操作系统实验的具体分工结构、Harness、通信协议或编程语言。
同期另一个费马大定理实验披露过”1 名 Lead + 999 名 Helper”等架构细节,但那是独立实验,不能直接套用到操作系统项目上。
企业早期测试者看到的”协调者”角色
Anthropic 在发布时公布了几家早期测试合作伙伴的反馈。这些属于企业工程师的实际体验,不是独立盲测,但它们指向同一个趋势:模型开始承担规划和协调工作。
- Vercel:Joe Haddad(Member of Technical Staff)表示,此前用其他模型要推进数周的项目,用 Fable 5.2 后在数天内完成并通过团队审核,代码审查者需要提的修改意见也更少。
- Shopify:Tom Pritchard(Staff Engineer)认为,模型能接收比较宽泛的想法,经过几轮沟通形成方案并自主完成后续工作,体验接近与另一位 Staff 级工程师合作。
- Datadog:Matt Lee(Senior Staff Engineer)把它比作事故指挥官(Incident Commander):面对陌生系统时,它会调用更快的模型收集信息,再协调不同任务,减轻人工操作员的协调负担。
- Uber:Andrew Mager(Staff Engineer, Agentic Systems)披露了一次连续运行 10—12 小时的安全审计,模型派发了约 170 个审查 Agent,最终交付审计报告、修复用的 Pull Requests 和一份政策建议。他特别强调,模型会持续执行到任务真正完成,而不是拿到一个看似合理的阶段性结果就停下。
Uber 的案例和操作系统实验在形式上最接近,都是由一个模型派发大量子 Agent 完成长任务,但两者是完全独立的项目。
Claude Fable 5.2 已进入真实生产环境
如果只有操作系统实验,人们可能会把它当作一场精心准备的演示。Anthropic 同时披露的两组内部数据,说明这类工程能力已经用于日常软件生产。
第一组是代码生产比例。Anthropic 表示,其核心代码库中超过 90% 最终合并的代码修改由 Claude 编写,但有人类指导。这个数字指的是合并修改中由 Claude 写的比例,不代表 90% 的开发工作无人参与,也不代表这些代码都出自 Fable 5.2。
第二组是生产服务迁移。一个使用早期 Fable 5.2 的 Agent 团队,把一项关键生产服务从 Python 迁移到 Rust。迁移后服务效率和可靠性都有改善,启动速度提高约 26 倍。语言迁移是很典型的”长周期、需要反复验证”的工作,要保证行为一致,测试和修复的分量往往超过翻译本身。
这几类案例的性质并不相同,下表做了区分:
| 案例 | 性质 | 证据来源 | 能说明什么 | 不能说明什么 |
|---|---|---|---|---|
| 操作系统原型 | Anthropic 内部实验 | 官方公告与演示 | 模型可以组织大规模、多模块的长周期工程 | 已达到商业操作系统水平;已被第三方复现 |
| 90% 合并代码由 Claude 编写 | 内部生产数据 | 官方公告 | AI 已深度参与日常代码生产 | 代码无需人工审查 |
| Python → Rust 迁移 | 内部生产案例 | 官方公告 | Agent 工程可用于真实基础设施优化 | 与操作系统实验采用同一套方法 |
| Vercel / Shopify / Datadog / Uber 反馈 | 早期测试者体验 | 官方公告引述 | 企业工程师在实际工作中感受到协调能力 | 可替代独立 Benchmark |
把这些放在一起看,它们共同展示的是”工程执行能力的扩展”。这不意味着每项工程都可以无人监督。
1000 个 AI Agent 究竟意味着什么
“1000 个 Agent”是这次实验最抓眼球的数字,也是最容易被误读的数字。
Agent 总数不等于同时运行的数量
首先,Anthropic 披露的是”超过 1000 个子 Agent 参与”,没有说明它们是否同时运行。在 8 天的周期里,子 Agent 很可能是分批创建、完成任务后结束,再由新的 Agent 接手。
其次,1000 个 Agent 也不等于 1000 个能力相同、完全独立的工程师。实际效率会受到任务可并行程度、协调开销、共享状态、代码冲突、测试覆盖率和调用成本的共同影响。
一个直观的例子:内核的内存管理没定型之前,文件系统和驱动很难真正推进。这类依赖关系决定了大型工程不可能被无限拆成并行任务。
公开 Managed Agents 的两种编排模式
Anthropic 面向开发者的 Managed Agents 文档,提供了观察产品化多 Agent 系统的窗口。它包含两种编排模式。
Subagent 模式:主 Agent 可以创建子 Agent,每个子 Agent 有独立的 Session Thread 和上下文历史,主 Agent 可以继续向它们发送后续任务。单个 Session 最多同时存在 25 个直接子线程,直接委派只支持一层。
Dynamic Workflow 模式:面向更大规模的任务。主 Agent 先编写一个工作流程序,由工作流创建多个 Agent 并行运行,汇总各阶段结果,再根据上一阶段的结果决定下一步。失败的 Agent 通常会由服务器在新线程上重试一次。官方文档给出的限制如下:
| 指标 | 官方限制 |
|---|---|
| 单个工作流同时运行的线程 | 64(产品上限配置,官方不保证一定达到) |
| 一个工作流生命周期内启动的 Agent | 1000 |
| 默认工作流生命周期 | 24 小时 |
| 单个 Session 默认同时开放的工作流 | 10 |
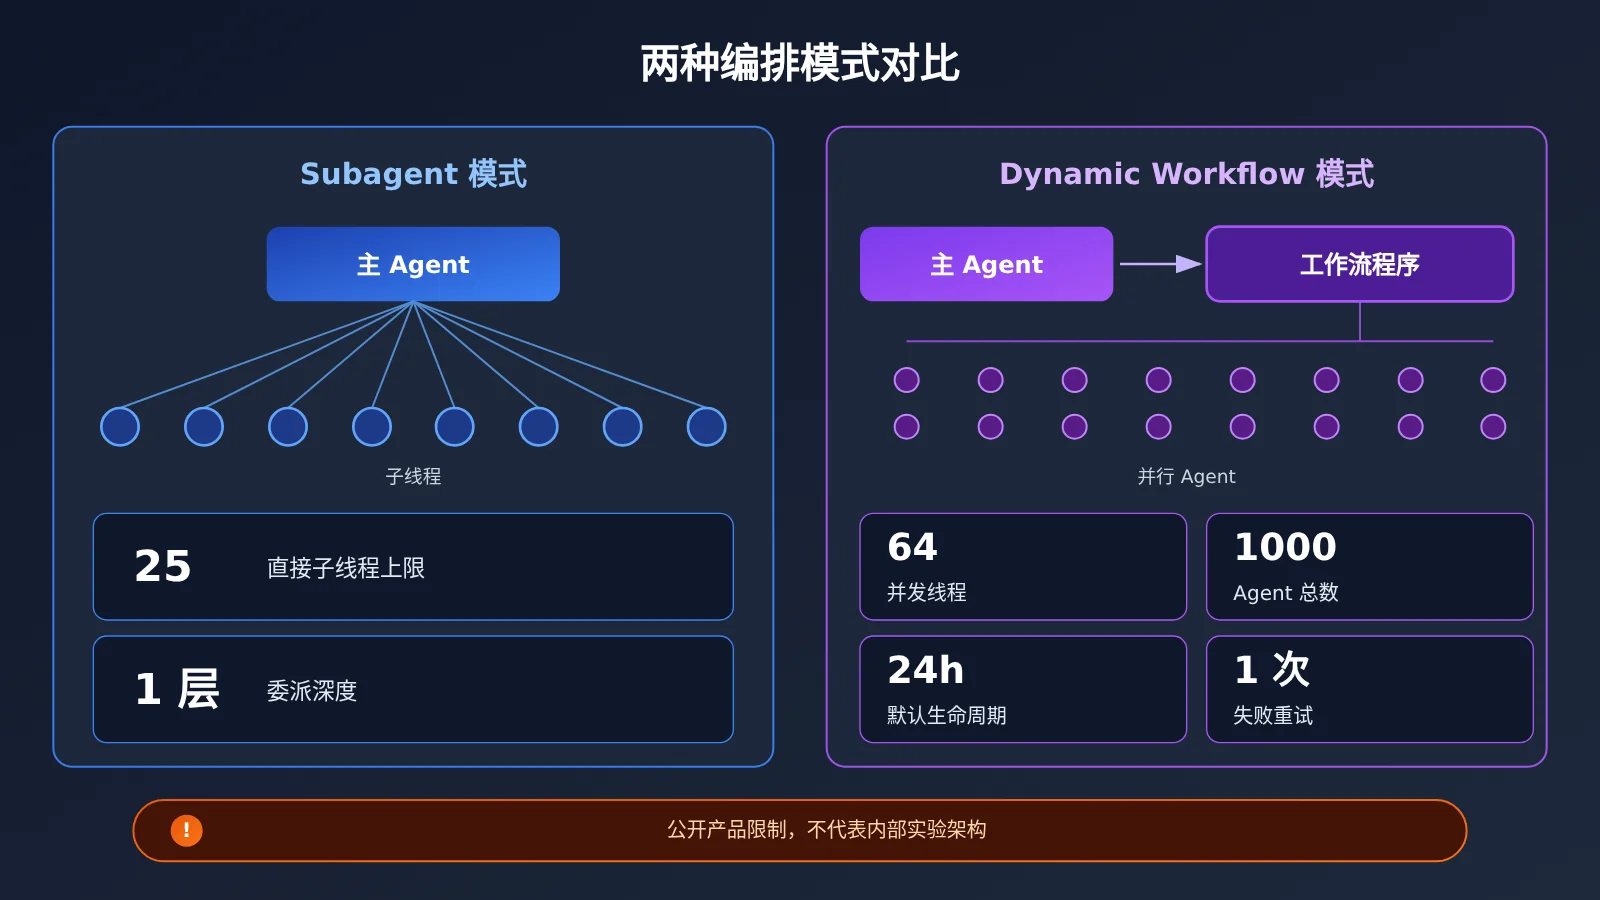
必须强调:操作系统实验是 Anthropic 的内部工程实验,公开 Managed Agents 是产品化服务。不能据此断言实验是通过 Managed Agents 完成的,也不能把 64 线程的并发上限套用到实验上。不过这组数字能说明一件事:大规模 Agent 编排不只依赖模型本身,还需要调度器、任务状态管理、并发控制、重试机制和预算系统。在”1000″这个数字背后,基础设施承担的工作和模型同样重要。
Claude Fable 5.2 操作系统原型的边界
“能启动”是一个有分量的里程碑,但它和”能用于生产”之间还有很长的距离。Windows、Linux、macOS 这类成熟系统,背后是数十年的硬件适配、安全加固和社区维护。
| 工程要求 | 可启动原型(目前已披露) | 成熟商业操作系统 |
|---|---|---|
| 硬件兼容性 | 在一台真实笔记本电脑上启动 | 覆盖大量芯片、外设和固件组合 |
| 安全性 | 未见独立第三方安全审计 | 持续的漏洞响应、权限隔离、补丁机制 |
| 长期可靠性 | 未披露长时间运行测试 | 经过海量用户、长期运行检验 |
| 系统维护 | 未公开源代码和构建流程 | 有版本管理、发布周期和长期支持 |
| 代码审计 | 未公开代码行数与架构文档 | 代码可审查,架构文档完善 |
| 可复现性 | 尚无第三方独立复现 | 构建流程公开、可重复 |
这张表不是为了贬低实验,而是为了说清楚它证明了什么。实验证明的是:模型可以在较长周期内组织一个多模块软件工程,并交付一个各子系统真正联通的结果。它没有证明 AI 写出的操作系统可以直接替代现有产品。
人类工程师在这类工程里依然关键。目标设定、架构取舍、安全边界、最终验收,这些环节的责任仍然要由人承担。Anthropic 自己的表述也很克制:90% 的合并代码由 Claude 编写,但”有人类指导”。
比较稳妥的结论是:AI 已经展示出组织复杂软件工程的能力,但这不意味着成熟软件工程团队可以不再需要人。
Claude Fable 5.2 对开发者的影响
从单次调用转向长周期 Agent 工作流
对多数开发者来说,短期内不会去造一个操作系统。但这次实验揭示的工作方式,会逐步进入日常项目,比如批量代码审查、仓库级重构、语言迁移和安全审计。
这时,开发者关注的重点会从”这次调用的回答好不好”转向几件更工程化的事:
- 任务管理:如何拆分任务、记录每个子任务的状态,失败后能否断点续跑。
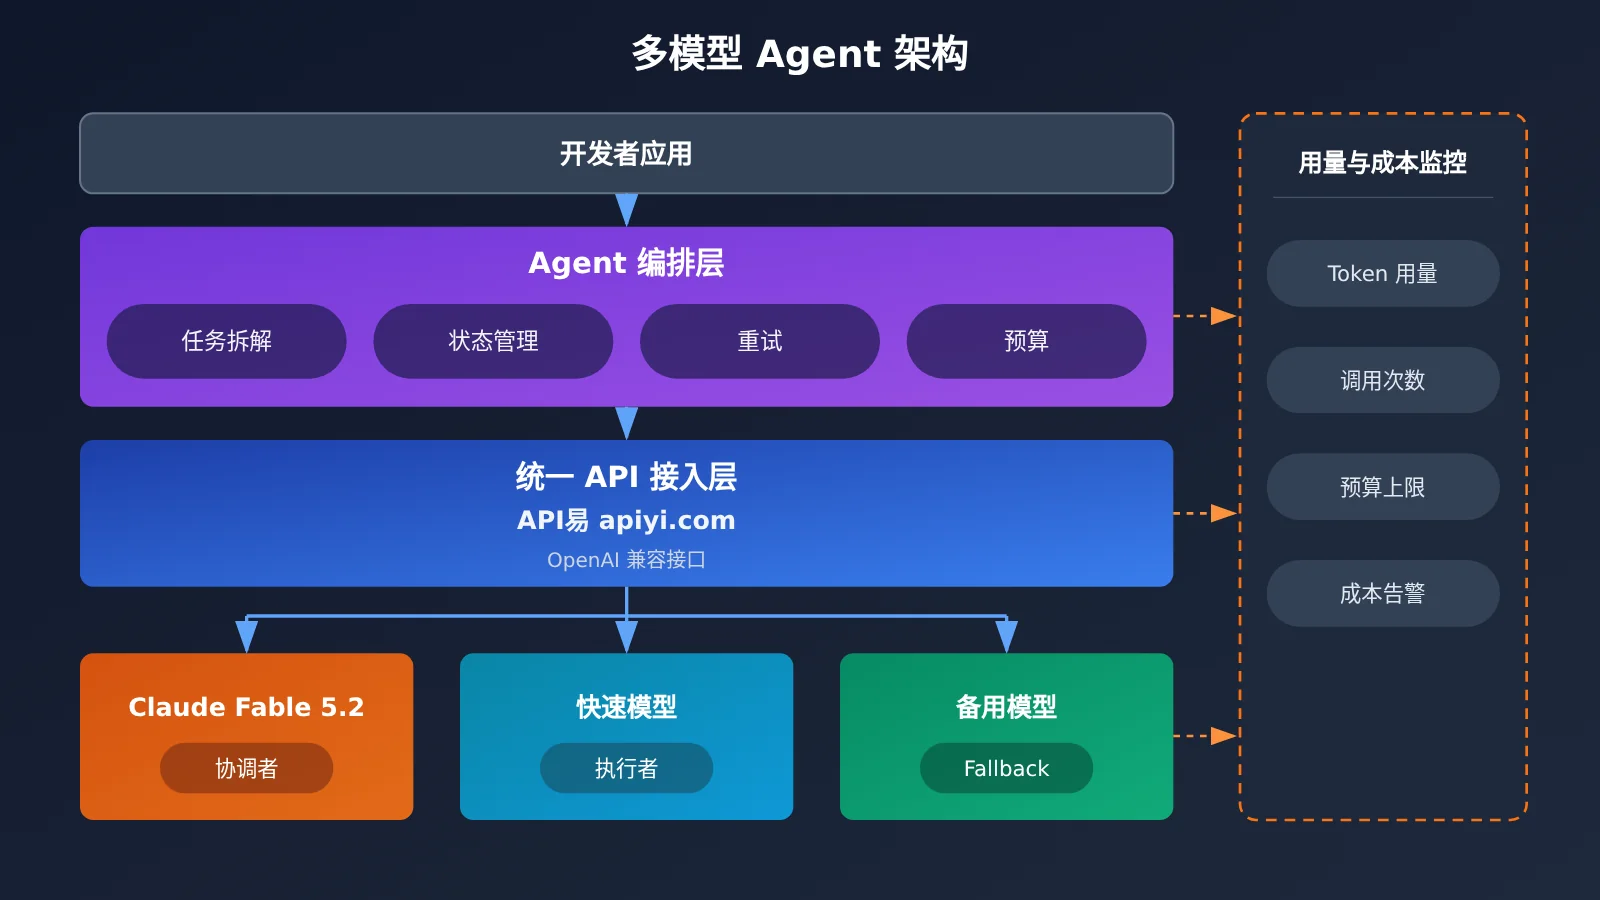
- 多模型分工:Datadog 案例中,Fable 5.2 会调用”更快的模型”收集信息。协调者用强模型,执行者用快模型或便宜模型,是常见的成本结构。
- 调用稳定性:一个工作流可能包含成百上千次调用,单次失败率再低,累积起来也会导致频繁中断,因此需要重试和故障切换。
- 预算控制:Fable 5.2 的公开 API 标价为输入 8 美元 / 百万 Token、输出 40 美元 / 百万 Token,Fast Mode 价格翻倍。Anthropic 没有公布操作系统实验的实际花费,但可以想见,长周期多 Agent 任务的成本必须被持续监控。
- 任务监控:需要知道每个 Agent 在做什么、消耗了多少、卡在哪里。
Vercel 在同一天宣布 AI Gateway 接入 Fable 5.2,提供供应商故障切换、Fallback 模型、用量与成本统计、预算和重试规则。这从侧面说明,复杂 Agent 应用的模型调用基础设施正在成形。
如何用 OpenAI 兼容接口调用 Claude Fable 5.2
Fable 5.2 的官方 API Model ID 是 claude-fable-5-2,支持 1M Token 上下文和最大 128K Token 输出。通过 OpenAI 兼容接口调用时,最简写法如下(模型名称以平台控制台的模型列表为准):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "把这个 Python 模块的迁移计划拆成可并行的子任务"}]
)
print(resp.choices[0].message.content)
查看完整示例:协调者 + 并行执行者 + 重试与预算控制
下面是一个简化的”协调者拆任务、执行者并行处理”的示意实现,包含失败重试和粗略的 Token 预算控制。它只用于说明一般工程思路,并不是 Anthropic 操作系统实验的实际实现。
import json
import openai
from concurrent.futures import ThreadPoolExecutor, as_completed

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口,可切换多家模型
)

PLANNER_MODEL = "claude-fable-5-2"   # 协调者:负责拆解与汇总
WORKER_MODEL = "gpt-4o-mini"         # 执行者:替换为你实际使用的快速模型
TOKEN_BUDGET = 200_000               # 整个工作流的 Token 预算
MAX_WORKERS = 8                      # 并发上限,按需调整
used_tokens = 0


def chat(model, prompt, max_tokens=2000):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,停止派发新任务")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    used_tokens += resp.usage.total_tokens
    return resp.choices[0].message.content


def plan(goal):
    prompt = (
        f"目标:{goal}\n"
        "请拆成 3-6 个可以独立完成的子任务,"
        '只输出 JSON 数组,格式为 [{"id": 1, "task": "..."}]'
    )
    return json.loads(chat(PLANNER_MODEL, prompt))


def run_task(item, retries=1):
    for attempt in range(retries + 1):
        try:
            return item["id"], chat(WORKER_MODEL, item["task"])
        except Exception as e:
            if attempt == retries:
                return item["id"], f"失败:{e}"


def workflow(goal):
    tasks = plan(goal)
    results = {}
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_task, t) for t in tasks]
        for f in as_completed(futures):
            tid, out = f.result()
            results[tid] = out
    summary_prompt = "汇总以下子任务结果,检查相互之间是否冲突:\n" + json.dumps(
        results, ensure_ascii=False
    )
    return chat(PLANNER_MODEL, summary_prompt, max_tokens=4000)


if __name__ == "__main__":
    print(workflow("为一个小型 Web 服务设计从 Python 迁移到 Rust 的方案"))
    print(f"累计消耗 Token:{used_tokens}")
🚀 快速上手建议:搭建多模型 Agent 工作流时,协调者和执行者往往来自不同厂商。通过 API易 apiyi.com 可以用同一个 API Key 调用 Claude、OpenAI、Gemini 等主流模型,按量计费,新用户有免费测试额度,适合先用小规模任务验证编排逻辑和成本。
常见问题 FAQ
Q1:Claude Fable 5.2 的操作系统实验到底做成了什么?
根据 Anthropic 披露,Fable 5.2 从空文件夹开始,协调超过 1000 个子 Agent 连续工作 8 天,做出一套能在真实笔记本电脑上启动的操作系统原型。它包含内核、磁盘 / 键盘 / 网络驱动、永久文件存储、窗口系统、登录界面、安装程序和内置 Claude 功能。
Q2:1000 个 AI Agent 是同时运行的吗?
官方没有披露。”超过 1000 个子 Agent 参与”不等于 1000 个 Agent 全程同时运行,更不等于 1000 个独立工程师。公开 Managed Agents 的单个工作流并发上限是 64 线程、生命周期内最多启动 1000 个 Agent,但这是产品限制,不能套用到内部实验。
Q3:这套 AI 造的操作系统能替代 Windows 或 Linux 吗?
不能。官方定位是”能工作的原型”。目前没有公开源代码、架构文档、多硬件兼容性测试和第三方安全审计,也没有独立复现。它证明的是 AI 组织复杂工程的能力,而不是产品成熟度。
Q4:Claude Fable 5.2 的 API 价格和规格是多少?
公开标价为输入 8 美元 / 百万 Token、输出 40 美元 / 百万 Token,比 Fable 5.1 普通模式降低 20%;Fast Mode 价格翻倍,输出速度最高可达普通模式的 2.5 倍。上下文窗口 1M Token,最大输出 128K Token,Batch API 输入输出均可享 50% 折扣。以上是公开标价,不是操作系统实验的实际账单。
Q5:开发者如何快速调用 Claude Fable 5.2 做 Agent 实验?
可以先用小规模任务验证编排逻辑:
1. 在 API易 apiyi.com 注册并获取 API Key 和免费测试额度;
2. 把本文示例中的 base_url 设为 `https://api.apiyi.com/v1`,模型名以控制台列表为准;
3. 先跑通”拆任务 → 并行执行 → 汇总”的最小闭环,再逐步加入重试和预算控制。
Q6:长周期多 Agent 工作流最容易在哪里出问题?
常见问题集中在三处:一是成本失控,调用次数随 Agent 数量放大,必须设置预算上限;二是累积失败,单次调用的偶发错误在长链路中会被放大,需要重试和备用模型;三是协调开销,任务依赖关系没理清时,并行反而带来代码冲突。用 API易 apiyi.com 统一接入多家模型,可以更方便地配置备用模型并集中查看用量。
Claude Fable 5.2 与 1000 个 AI Agent 核心要点 Key Takeaways
- 实验事实:超过 1000 个子 Agent、8 天、从空文件夹到可启动的操作系统原型。
- 真正突破:模型开始承担任务拆解、并行执行、持续修复和结果整合。
- 生产信号:Anthropic 超过 90% 合并代码由 Claude 编写,Rust 迁移带来约 26 倍启动提速。
- 数字边界:1000 个 Agent 不等于 1000 个全程并行的独立工程师。
- 原型边界:未经第三方审计和复现,离成熟商业操作系统还有很长距离。
- 开发者重点:调度、重试、预算和监控与模型能力同样重要,可借助 API易 apiyi.com 统一接入多模型。
总结
1000 个 AI Agent、8 天造出一个操作系统,这条新闻最值得记住的不是数字本身,而是三点:
- 能力形态变了:Claude Fable 5.2 展示的是组织工程的能力,而不只是生成代码的能力。
- 证据要分层看:操作系统实验、内部生产数据和企业早期反馈是不同性质的证据,应分别评估。
- 人仍是最后一环:原型能启动,但架构取舍、安全和验收仍需要人类工程师负责。
对开发者来说,下一步是把思路从”单次调用”升级到”长周期工作流”,提前想清楚多模型分工、调用稳定性和成本控制。推荐通过 API易 apiyi.com 用一个 API Key 接入多家主流模型,先从小规模的 Agent 任务开始验证。
📚 参考资料
- Anthropic 官方发布公告:Claude Fable 5.2 and Mythos 5.2(2026-11-09)
- 链接:
anthropic.com/claude-fable-and-mythos-5-2 -
说明:操作系统实验、内部生产数据和企业反馈的一手来源
-
Claude Platform 模型规格文档:Fable 5.2 Overview
- 链接:
platform.claude.com/docs/en/models/fable-5-2/overview -
说明:上下文窗口、最大输出、Model ID 等规格参数
-
Managed Agents 多 Agent 编排文档:Subagent 与 Dynamic Workflow
- 链接:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
说明:公开产品的并发线程、Agent 数量与生命周期限制
-
Vercel AI Gateway 接入公告:Claude Fable 5.2 now available on AI Gateway
- 链接:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway -
说明:第三方 API 网关的故障切换、预算与重试能力
-
The Verge 报道:Anthropic launches new Claude Fable and Mythos 5.2 models
- 链接:
theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2 - 说明:第三方媒体对本次发布的同步报道
作者: APIYI 技术团队
技术交流: 欢迎在 API易 官网首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心