作者注:同一批中国开源模型,在门罗风投支出榜和 OpenRouter 请求榜中排名相反。本文拆解两份榜单的统计口径,并给出一套可以直接执行的 5 步选型方法。
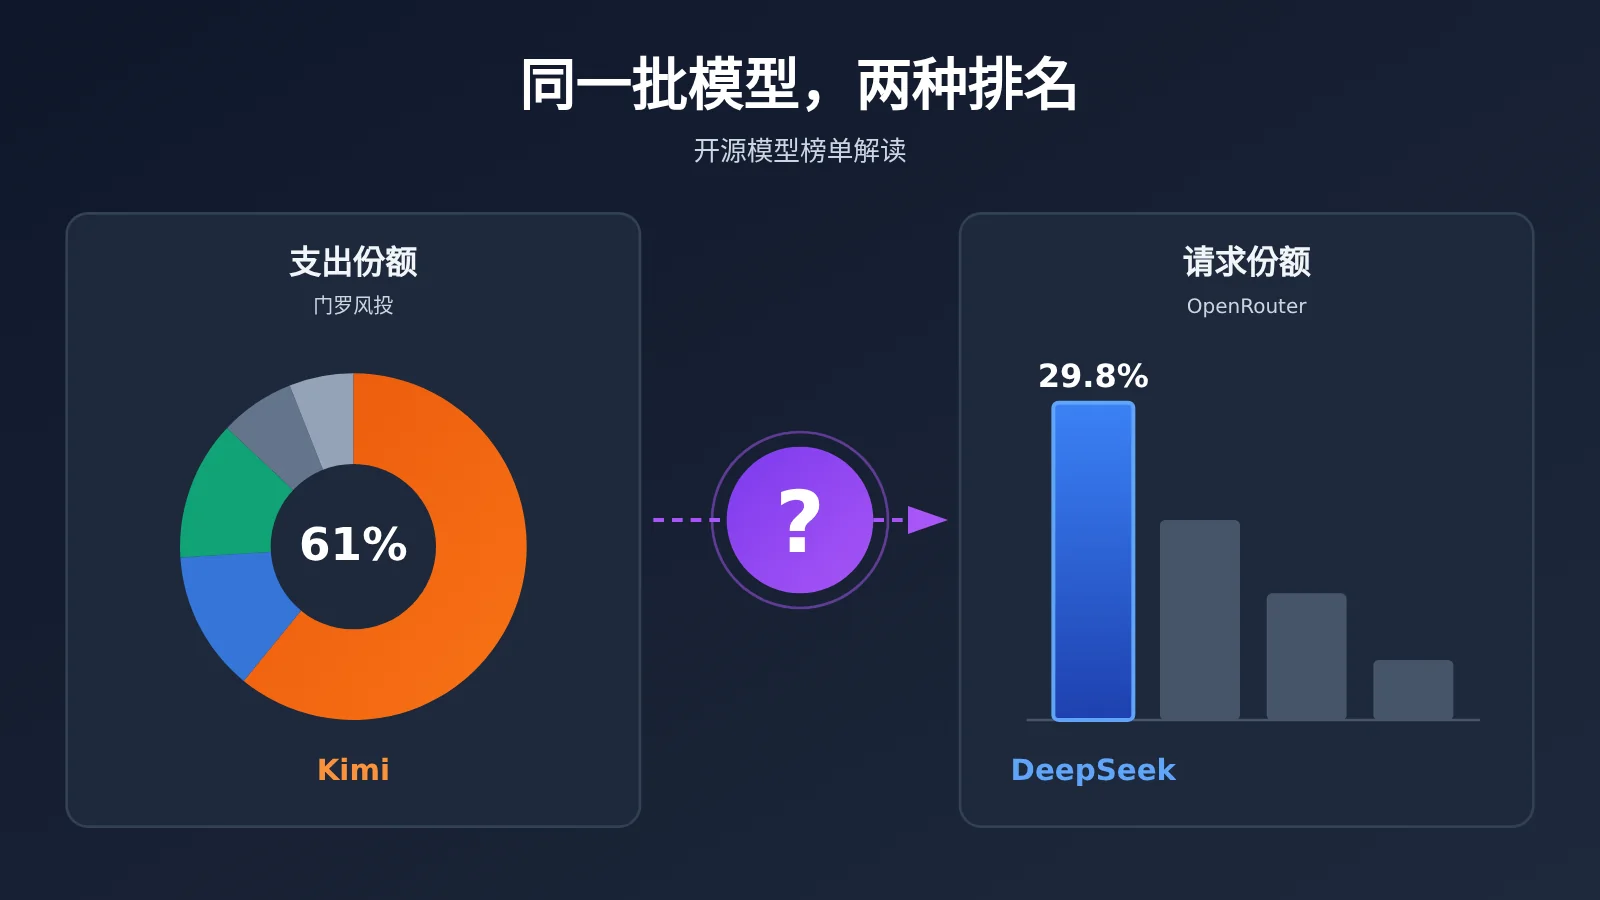
11 月初出了两份数据。门罗风投报告显示,Kimi 拿走美国企业开源模型支出的 61%。OpenRouter 周榜显示,DeepSeek 拿走平台 29.8% 的文本请求。两边的第一名不是同一家,排名几乎反过来。很多技术负责人第一反应是:到底该信哪一份?
结论是两份榜单并不矛盾,它们衡量的是两件事。支出榜看的是“企业把钱付给了谁”,请求榜看的是“开发者在某个平台上调用了谁”。选型时不能挑一份榜单照抄,要按自己的任务类型和成本口径来判断。榜单只能缩小候选范围,不能替你完成选型。
这不是又一篇排名复述。本文会说明每份榜单的样本、时间窗口和适用边界,再讲清楚“单价降、用量涨”对成本结构有什么影响,最后给出一份 5 步选型清单。
开源模型榜单核心信息速览:Kimi 与 DeepSeek 为什么各拿一个第一
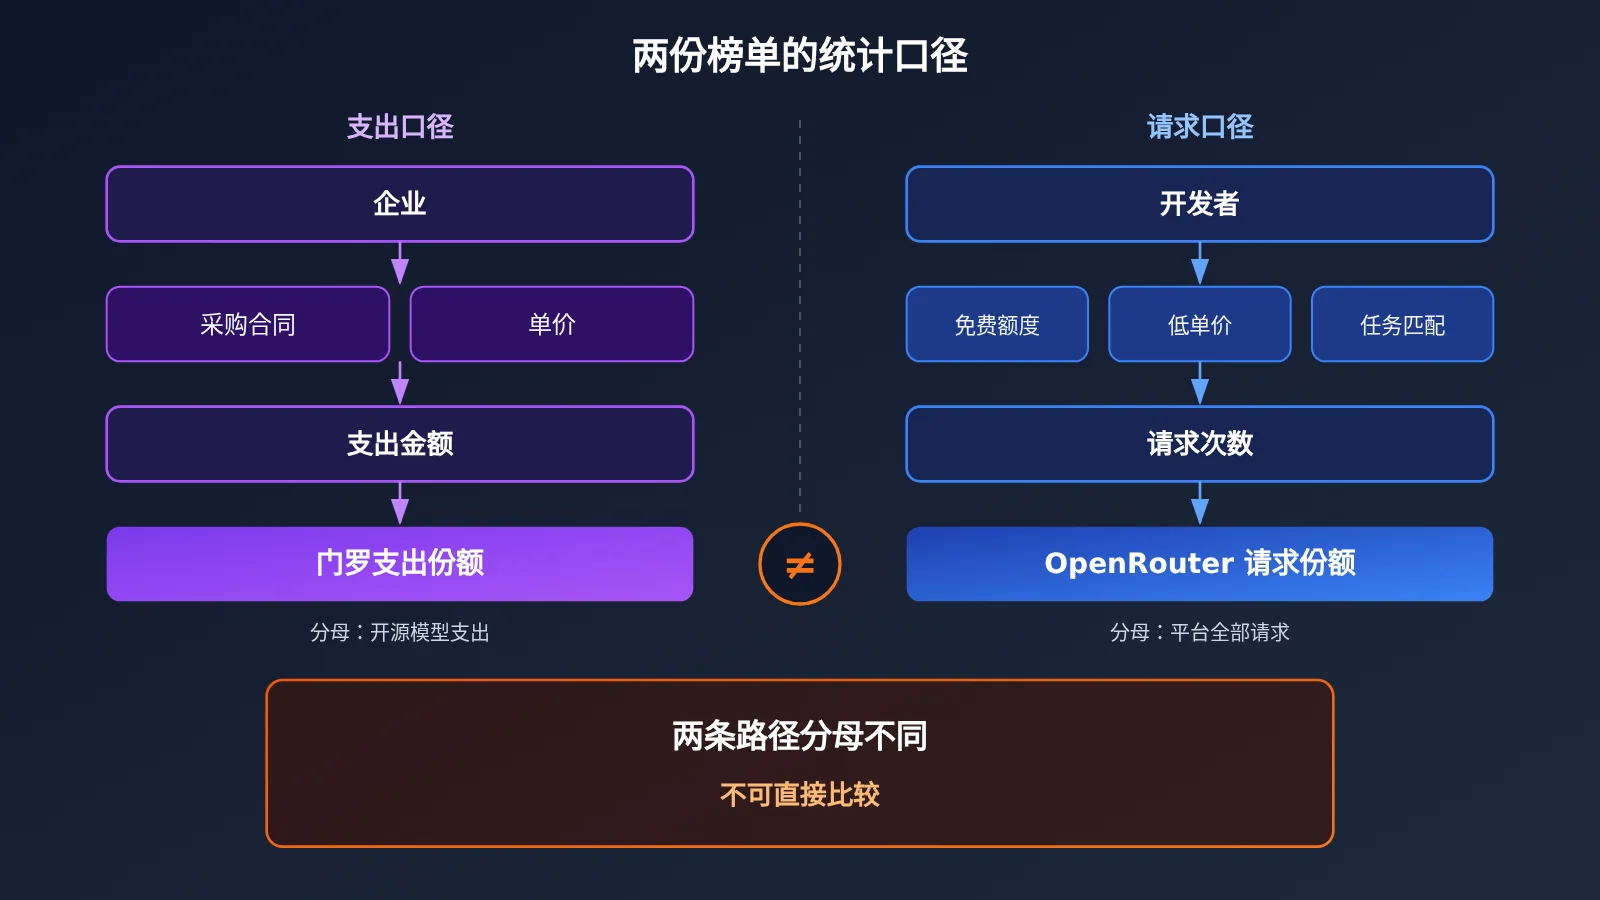
结论先行:门罗风投量的是企业支出,OpenRouter 量的是平台请求,两者的样本、时间和统计对象都不同。
这两份数据经常被放在一起讨论,可它们的“分母”完全不同。门罗风投的数据来自对美国企业 AI 决策者的问卷调查,属于调查估算,不是审计账单。OpenRouter 的数据来自它自己平台上的请求统计,只能反映这个平台的用户行为,不能代表全市场。
| 榜单 | 衡量对象 | 样本/时间 | 关键排名 | 适合用来判断什么 |
|---|---|---|---|---|
| 门罗风投 2026 企业 AI 现状报告 | 美国企业开源模型支出份额 | 近 400 名美国企业 AI 决策者,2026 年 9 月 8-26 日调研,11 月 3 日发布 | Kimi 61%、DeepSeek 15%、GLM 11%、Meta Llama 7%、Qwen 3% | 企业采购偏好、预算流向、哪些模型进入了正式合同 |
| OpenRouter 周榜 | 平台文本请求份额 | OpenRouter 平台,10 月 26 日-11 月 1 日 | DeepSeek 29.8%、OpenAI 18.8%、Z.ai 11.9%、Qwen 5.6%(第六) | 开发者活跃度、价格敏感型调用、社区热度 |
看表就能发现,两份榜单连“参赛选手”都不一样。门罗只统计开源模型,OpenRouter 则把 OpenAI、Google 这样的闭源厂商也算进去。直接拿两个百分比对比,本身就是口径错位。
门罗风投支出榜怎么读:Kimi 拿走 61% 开源模型支出
结论先行:门罗风投的数据说明中国开源模型已经进入美国企业预算,但它是调查估算,不是能力排名。
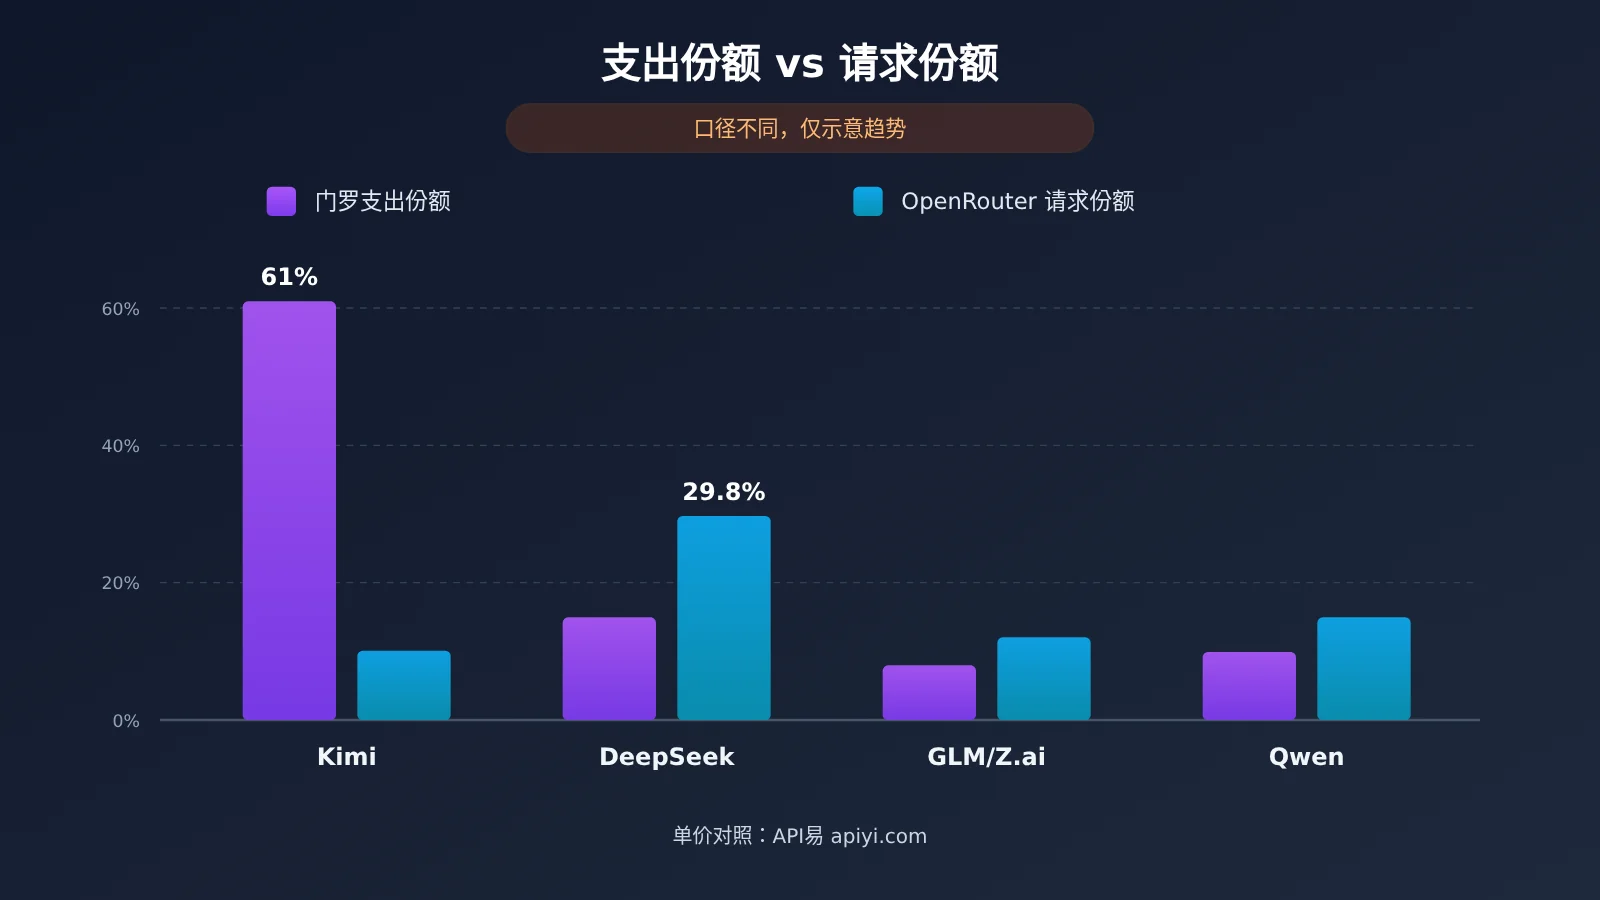
报告最受关注的数字是:中国模型占美国企业开源模型支出的 89%。其中 Kimi 一家就占 61%,DeepSeek 15%,GLM 11%,Qwen 3%。非中国模型里,Meta Llama 占 7%。
| 模型 | 美国企业开源模型支出份额 | 阅读要点 |
|---|---|---|
| Kimi | 61% | 份额最高,可能与企业采购渠道和单价有关 |
| DeepSeek | 15% | 支出排第二,但调用侧更活跃 |
| GLM | 11% | 稳定进入企业预算 |
| Meta Llama | 7% | 非中国开源模型中份额最高 |
| Qwen | 3% | 支出份额较小,调用侧有一定存在感 |
把这些数字放回全局会更清楚。报告估算全球企业 AI 部署支出年化约 1768 亿美元,三年增长超过 100 倍。前沿实验室占部署支出的 69%,开源模型在整体模型支出中只占 4%。所以“Kimi 拿 61%”说的是开源这一小块里的 61%,不是整个企业 AI 市场的 61%。
另外,问卷数据依赖受访者对自家预算的估计,近 400 个样本也只覆盖美国企业。合理的读法是:这份数据说明了企业采购的方向性趋势,具体比例属于调查估算,有待更多数据验证。
OpenRouter 请求榜怎么读:DeepSeek 拿走 29.8% 请求
结论先行:OpenRouter 周榜反映的是这个平台上开发者的调用热度,可以看趋势,但不能代表全市场份额。
10 月 26 日至 11 月 1 日这一周,DeepSeek 以 29.8% 的文本请求份额排第一,环比增长 7%。OpenAI 以 18.8% 排第二,Google 的份额从 14.4% 下滑,Z.ai 以 11.9% 排第四,Qwen 以 5.6% 排第六。
| 排名信息 | 厂商 | 请求份额 | 变化 |
|---|---|---|---|
| 第 1 | DeepSeek | 29.8% | 环比 +7% |
| 第 2 | OpenAI | 18.8% | — |
| 下滑 | 从 14.4% 下降 | 份额回落 | |
| 第 4 | Z.ai | 11.9% | — |
| 第 6 | Qwen | 5.6% | — |
还有两条趋势值得注意。中国模型的 token 调用量已经连续 27 周超过美国模型,单模型周调用量前五里,中国模型占了四席。同期 DeepSeek 把模型升级到 DeepSeek V4.1-Flash-1017,API 调用方式和价格都没有变化,这对已经接入的开发者来说迁移成本很低。
稳定性方面也要留意。11 月 3 日,DeepSeek 的网页端和 API 出现过约 1 小时的部分中断。调用量大不代表永远可用,这正是后面要讲的“留备用模型”的理由。新版本上线后,具体模型 ID 和计费以 API易 apiyi.com 控制台的模型列表为准。
为什么开源模型支出榜和请求榜排名相反
结论先行:排名相反主要由单价、采购方式、免费额度、任务匹配和平台口径五个因素造成,不说明哪一份榜单“错了”。
支出份额大致等于“调用量 × 单价”,再叠加合同和采购因素。请求份额只数调用次数,不管每次花多少钱。如果一个模型单价更高、企业愿意签采购合同,它在支出榜上就会靠前。如果一个模型单价低、开发者用得多,它在请求榜上就会靠前。
| 影响因素 | 对支出份额的作用 | 对请求份额的作用 |
|---|---|---|
| 单价 | 单价高,同样用量花费更多,支出份额被放大 | 单价低吸引更多试用,请求量上升 |
| 企业采购 | 合同、私有化部署、服务协议计入支出 | 不一定经过 OpenRouter,平台上看不到 |
| 免费额度 | 免费调用不产生支出 | 免费调用会计入请求量 |
| 任务匹配 | 长文档、Agent 等高 token 任务推高花费 | 短对话、批量小任务推高次数 |
| 平台口径 | 只覆盖受访的美国企业 | 只覆盖 OpenRouter 用户 |
按这个框架看,Kimi 可能在企业采购渠道和单价上更有优势,所以支出份额高。DeepSeek 单价更低、开发者社区活跃,所以请求量大。这是基于口径的合理推测,两份报告本身没有给出逐项拆分。
还有一个经常被忽略的细节:同一个模型的不同版本、不同接入渠道、不同缓存命中率,都会让支出和调用数字出现偏差。一个团队如果大量命中缓存,请求次数照样计入,但实际支出会低很多。
开源模型价格与用量:单价降约 7 成、用量涨 22.5 倍意味着什么
结论先行:单价下降不等于总成本下降,按“完成一个任务的成本”比较,比按每百万 token 单价比较更可靠。
门罗报告里有一组关键数字:平均 token 价格从 0.45 美元/百万 token 降到 0.13 美元/百万 token,降幅约 7 成,同期用量增长了 22.5 倍。按这两个数字粗略推算,总花费不降反升,大约是原来的 6.5 倍。这只是基于报告平均值的示意计算,各团队的实际情况会有差异。
开源模型的情况更典型。开源模型占企业 token 用量的 19%,却只占模型支出的 4%。也就是说,大量 token 跑在便宜的开源模型上,但钱主要还是付给了前沿闭源模型。
对开发者来说,单价下降会刺激更多调用,Agent 和批量任务尤其明显。真实成本还要考虑下面几个变量:
- 缓存命中:重复的系统提示词和长上下文能否命中缓存,直接决定实际单价。
- 上下文长度:长文档任务的输入 token 往往远多于输出。
- 重试次数:输出不稳定、格式出错导致的重试,会让成本成倍增加。
- 工具调用轮次:Agent 任务一次可能来回十几轮,单价低但轮次多。
比较价格时,建议先在 API易 apiyi.com 控制台查看候选模型的列表价格和计费方式,确认输入、输出、缓存分别怎么算。然后用自己的任务跑一小批样本,把“完成一个任务花了多少钱”算出来,这个数字比列表单价更有参考价值。
开源模型选型方法:用榜单缩小范围,用任务做决定
结论先行:榜单负责给出候选名单,最终决策要靠任务匹配、成本、稳定性和小样本验证。
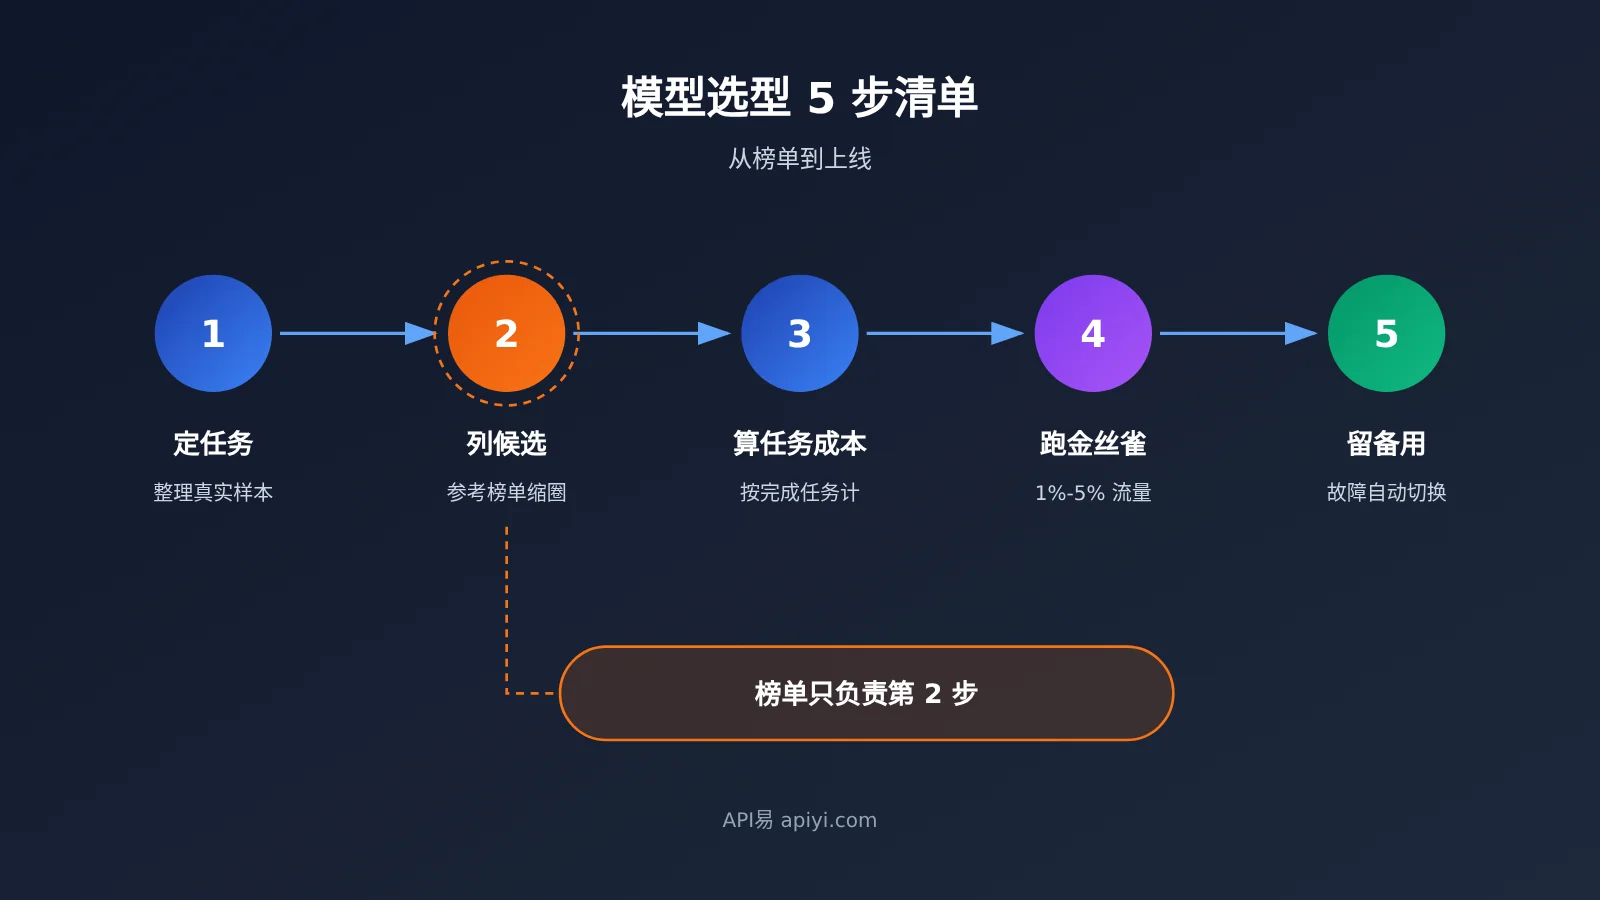
选型可以按“任务 → 成本 → 稳定性 → 验证 → 备用”的顺序推进。下表列出了每个维度要问的问题和验证方法。
| 维度 | 要问的问题 | 怎么验证 | 对成本的影响 |
|---|---|---|---|
| 任务匹配 | 主要是编程、长文档、多模态,还是 Agent 工具调用? | 准备 30-100 条真实任务样本,人工评估输出 | 匹配度低会增加重试和人工修改 |
| 单价与缓存 | 输入、输出、缓存命中分别多少钱? | 查控制台模型列表与计费说明,统计缓存命中率 | 决定每百万 token 的实际单价 |
| 上下文 | 最长输入多长?超长后效果是否下降? | 用最长的真实文档测试截断和召回 | 长上下文直接推高输入 token |
| 限流 | 并发和每分钟请求上限够不够? | 按峰值流量做压测 | 被限流时需要排队或切换,影响时延 |
| 地区可用性 | 部署地区能否稳定访问? | 在生产所在地区实际调用 | 不可用就要另找渠道 |
| 稳定性 | 近期有没有中断?恢复要多久? | 查故障历史,观察错误率日志 | 中断会造成重试成本和业务损失 |
多模型对比是这一步最耗时的地方。如果每个候选模型都要单独注册、单独对接 SDK,光是接入就要花好几天。通过 API易 apiyi.com,一个 API Key 就能调用 OpenAI、Claude、Gemini 以及 DeepSeek、Kimi 等多家模型。接口兼容 OpenAI 格式,把 base_url 设为 https://api.apiyi.com/v1,在请求里改 model 参数就能切换模型,同一批样本可以很快跑完横向对比。
稳定性这一项不能只看厂商公告。DeepSeek 11 月 3 日的中断提醒我们,任何单一模型都可能临时不可用。在 API易 apiyi.com 控制台可以按模型查看用量和调用日志,错误率、时延、token 消耗都有记录,适合在金丝雀阶段观察候选模型的真实表现。平台采用多节点部署和智能路由,并提供自动降级。业务侧再配置一个备用模型,主模型出错时切到备用模型,就能把单点故障的影响控制在较小范围。
金丝雀发布建议从 1%-5% 的真实流量开始,持续观察几天的错误率、时延和单任务成本。数据稳定后再逐步放量,不要看完榜单就一次性全量切换。
开源模型榜单常见问题 FAQ
结论先行:下面 5 个问题覆盖了读开源模型榜单时最常见的误区。
Q1:Kimi 支出份额 61%,是不是说明 Kimi 模型更好?
不是。支出份额反映的是钱流向了谁,会受单价、企业采购合同和渠道影响,和模型能力没有直接对应关系。而且门罗数据是调查估算,口径只覆盖美国企业的开源模型支出。“支出第一”不等于“能力第一”,能力要用你自己的任务来评估。
Q2:OpenRouter 请求排名能代表企业采购吗?
不能。OpenRouter 统计的是自己平台上的请求份额,用户以开发者和中小团队为主。企业的直签合同、私有化部署和其他渠道都不在统计范围内。它适合观察开发者热度和价格敏感型调用的趋势,不适合推断企业预算分布。
Q3:单价低的模型,总成本一定低吗?
不一定。如果单价低的模型需要更多重试、更长的提示词或更多工具调用轮次,总 token 消耗可能反而更高。建议按“完成一个任务”来算成本:在 API易 apiyi.com 控制台查看每次调用的 token 用量和费用日志,对比不同模型完成同一批任务的总花费。
Q4:开源模型能完全替代闭源模型吗?
要看具体任务。门罗数据显示开源模型承担了企业 19% 的 token,但只占 4% 的支出,说明很多团队把批量、常规任务交给开源模型,复杂任务仍留给前沿闭源模型。比较稳妥的做法是混合使用:通过 API易 apiyi.com 用同一个 Key 同时接入开源和闭源模型,再按任务难度分流。
Q5:开源模型榜单多久看一次比较合适?
周榜可以每月浏览一次,看趋势而不是追单周波动。年度或季度调查报告发布时细读一次,关注口径和样本有没有变化。真正影响你决策的,是自家业务指标的持续监控,比如错误率、单任务成本和用户反馈,这些建议按周复盘。
开源模型榜单解读总结:5 步选型清单
结论先行:两份榜单量的是两件事,读榜单的正确姿势是先问口径、再看样本、最后用自己的任务验证。
核心要点回顾:
- 支出 ≠ 调用:门罗量企业支出,OpenRouter 量平台请求,分母不同,不能直接比较。
- 调查 ≠ 审计:门罗数据是近 400 名美国企业决策者的调查估算,OpenRouter 只代表自己的平台。
- 便宜 ≠ 省钱:单价降约 7 成、用量涨 22.5 倍,总花费反而上升,要按任务成本来算。
- 热门 ≠ 稳定:调用量第一的模型同样会中断,备用方案必须提前准备。
- 榜单只能缩小候选范围,不能替你完成选型。
下面这份清单可以直接用于下一次模型选型:
- 定任务:写清楚主要任务类型(编程、长文档、多模态、Agent),整理 30-100 条真实样本和评估标准。
- 列候选:参考支出榜和请求榜各取 2-3 个模型,再加 1 个闭源模型作为基准,候选控制在 3-5 个。
- 算任务成本:用同一批样本跑所有候选,记录 token 用量、缓存命中、重试次数,算出单任务成本和质量得分。
- 跑金丝雀:选出的模型先承接 1%-5% 的真实流量,观察几天的错误率、时延和成本,达标后再放量。
- 留备用:至少配置一个不同厂商的备用模型,写好切换规则,并定期演练。
如果想把第 3 步到第 5 步放在同一个入口完成,可以通过 API易 apiyi.com 用一个 Key 接入候选模型,在控制台对照价格、用量与日志,再结合平台的自动降级能力设置备用切换。新用户有免费测试额度,适合先跑小样本验证。
本文数据来源
- 门罗风投 2026 企业 AI 现状报告:2026 年 11 月 3 日发布
- 链接:
menlovc.com -
说明: 企业 AI 支出、开源模型支出份额与 token 价格变化,属于调查估算
-
OpenRouter 模型排行榜:2026 年 10 月 26 日-11 月 1 日周榜
- 链接:
openrouter.ai/rankings - 说明: 平台文本请求份额与 token 调用趋势,仅代表该平台
作者: APIYI 技术团队
技术交流: 模型选型中遇到价格、限流或切换方面的问题,欢迎在 API易 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心