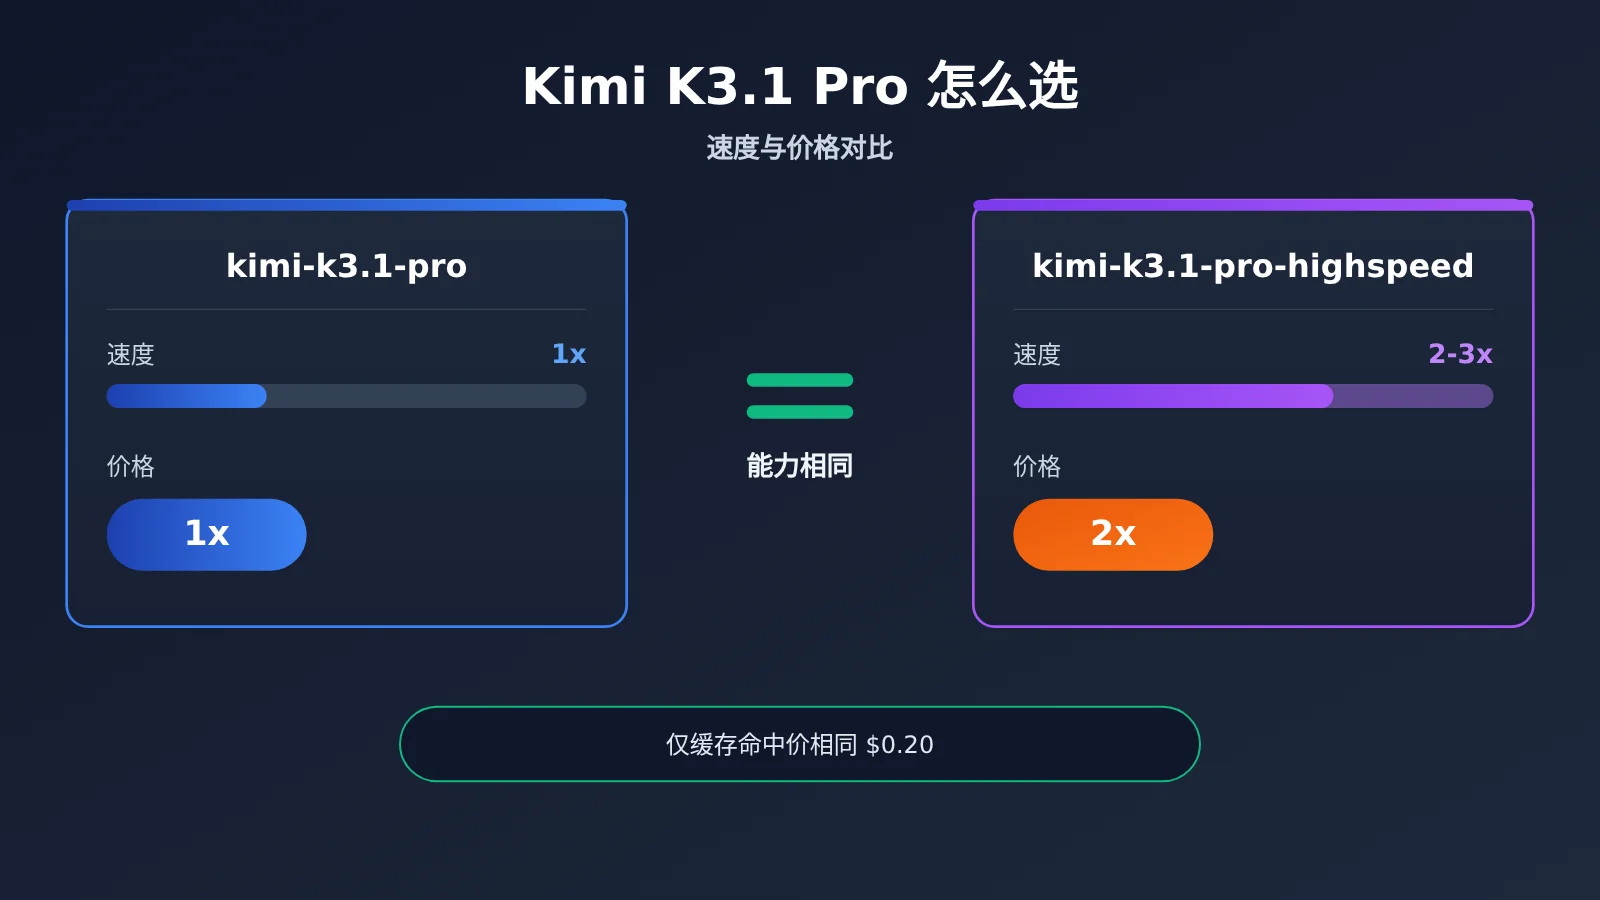
Kimi K3.1 Pro 和 Highspeed 版的模型能力相同,Highspeed 多出来的只有速度,官方说法是快 2-3 倍。代价是价格基本全线翻倍,只有缓存命中价没涨,两者都是 $0.20。所以有人盯着屏幕等结果的场景选 Highspeed,批量在后台跑的场景选标准版。
上面的结论有三个依据:Moonshot 官方博客写明两个型号“same capabilities”,官方定价页列出了五档单价,Kimi Code 官方文档写明 Highspeed 约消耗 2 倍配额。下文按“官方自报 / 第三方 / 未核实”三档标注每一条事实的来源,没有数据的地方直接写没有,不做估算冒充实测。
这篇不比谁更聪明。 两个版本能力一样,要回答的只是一个账本问题:为了更快拿到同样质量的结果,多付一倍钱值不值。
读完你能得到什么:一张五档价目表、一个把等待时间换算成钱的判断方法、两笔可以自己复核的算账,以及一张按六类场景直接给结论的选择表。
1. Kimi K3.1 Pro 与 Highspeed 核心差异:能力相同,只差速度和价格
先看全貌。下表把两个型号能对比的维度都列出来,最后一列标明信息来源属于哪一档。上下文指模型一次能“看到”的文字总量,用 tokens 计数。token 是模型计费和计算的基本单位,粗略理解成“字词碎片”即可。
| 对比维度 | kimi-k3.1-pro(标准版) | kimi-k3.1-pro-highspeed | 来源分级 |
|---|---|---|---|
| 模型能力 | 基准 | 与标准版相同 | 官方自报 |
| 上下文长度 | 1,048,576 tokens | 1,048,576 tokens | 官方自报 |
| 生成速度 | 基准 | 官方称快 2-3 倍 | 官方自报,无细数据 |
| 单价 | 基准 | 除缓存命中外均为 2 倍 | 官方定价 |
| Kimi Code 使用门槛 | Plus 及以上会员(1M 上下文需 Pro 及以上) | Pro 及以上会员 | 官方文档 |
| Kimi Code 配额消耗 | 基准 | 约 2 倍 | 官方文档 |
| 官方可用渠道 | kimi.ai、Kimi Work、Kimi Code、Kimi API | 同左 | 官方博客 |
这张表能说明的事情很简单:除了速度、价格和会员门槛,两个型号没有其他差别。选错了也不会损失“效果”,只会损失钱或时间。
1.1 Kimi K3.1 Pro 与 Highspeed 价目对比(五档全列)
以下价格为 2026-10-24 抓取,美元/百万 tokens,不含税,来源为官方定价。先解释几个计费项。“输入”是你发给模型的内容,“输出”是模型写回来的内容。“缓存”是指同一段前缀内容(比如反复带上的项目代码)被平台暂存,下次请求里出现相同前缀时直接复用,这叫“命中”,按低价计费。第一次把内容放进缓存要付“写入”费,写入分 5 分钟和 1 小时两种保留时长。
| 计费项 | kimi-k3.1-pro | kimi-k3.1-pro-highspeed | 倍数 |
|---|---|---|---|
| 输入(未命中缓存) | $2.00 | $4.00 | 2 倍 |
| 输出 | $10.00 | $20.00 | 2 倍 |
| 缓存命中输入 | $0.20 | $0.20 | 相同,唯一没涨价 |
| 缓存写入(5 分钟) | $2.00 | $4.00 | 2 倍 |
| 缓存写入(1 小时) | $4.00 | $8.00 | 2 倍 |
第三方开发者 Simon Willison 的公开记录也确认了这一点:Highspeed 价格翻倍,但缓存命中的输入价和标准版一样。这个细节会影响后面的算账。如果你的请求里大部分输入都能命中缓存,Highspeed 的实际总价会低于“整整两倍”,因为最大的那一块输入没有加价。
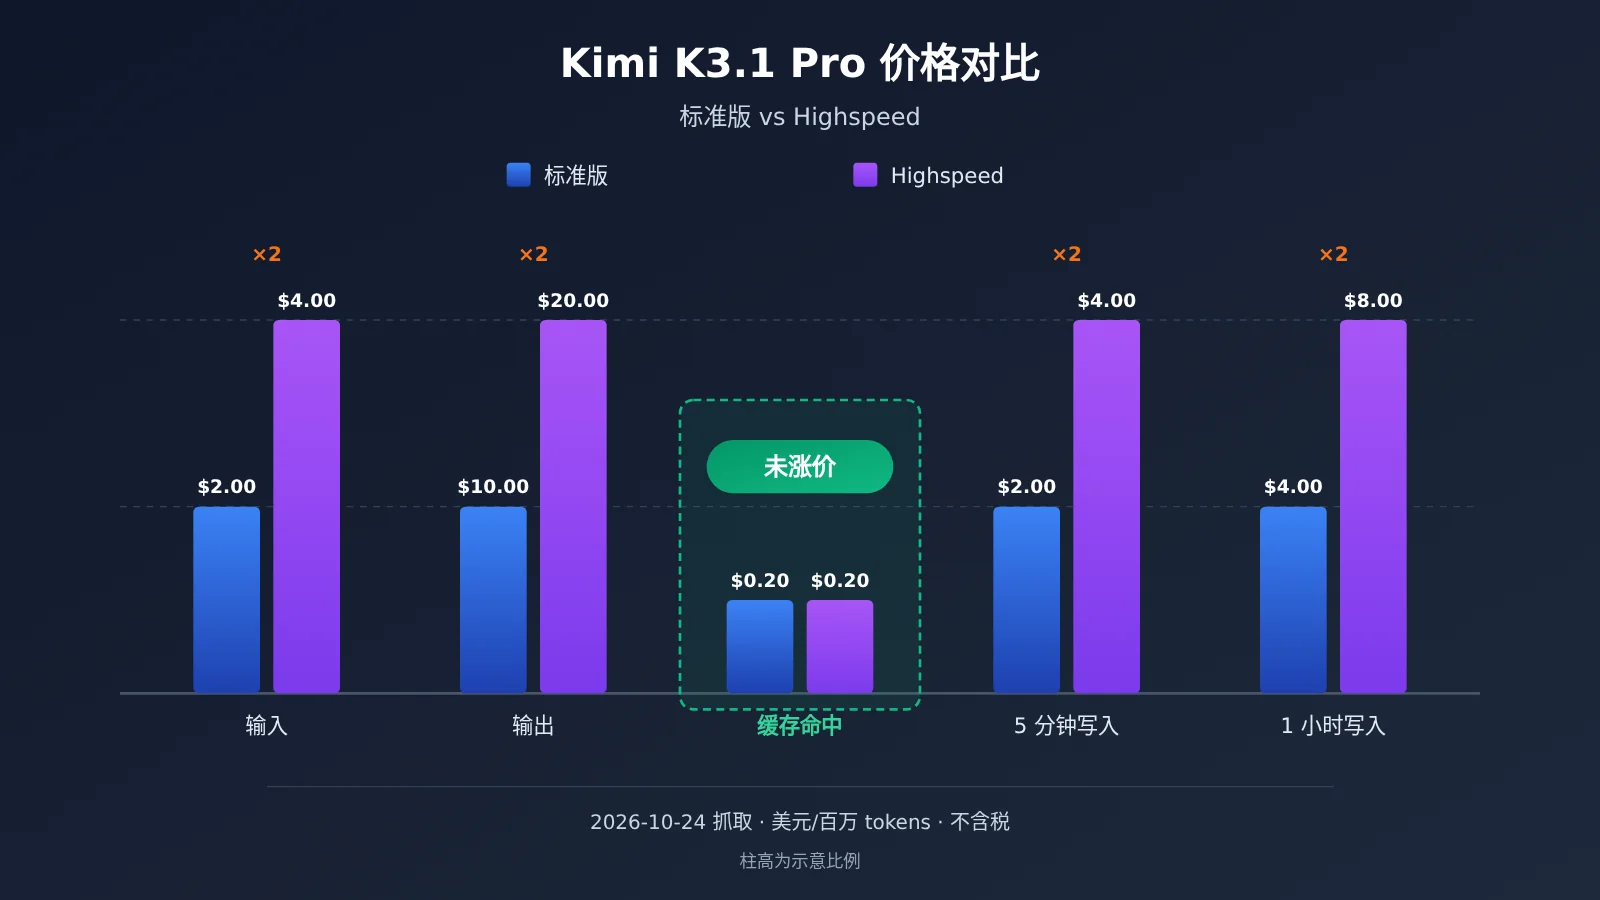
价格说明:上图与上表均为官方定价。如果你通过 API易 apiyi.com 调用,两个型号在平台上的型号名与价格以平台型号列表为准;这两个型号目前还在接入中,我们会尽快推出此模型。
2. Kimi K3.1 Pro Highspeed 速度差到底多大
这一节要说实话:目前能找到的速度数据非常少。官方只给了一个倍数区间,第三方只测了标准版,没有任何公开基准测过 Highspeed 的具体 tokens/秒。tokens/秒指模型每秒能吐出多少个 token,数值越大,你看到回答出完的时间越短。
| 数据项 | 数值 | 来源分级 | 说明 |
|---|---|---|---|
| Highspeed 相对速度 | 标准版的 2-3 倍 | 官方自报 | 未公布测试条件和细分数据 |
| 标准版输出速度 | 80.7 tokens/秒 | 第三方(Artificial Analysis) | 四档评分里属于 2 档 |
| Highspeed 输出速度 | 无 | 未核实 | 第三方尚未单独测量 |
| 标准版单任务平均输出量 | 约 55K tokens | 第三方(Artificial Analysis) | 指其 Intelligence Index 测试任务 |
| 标准版单任务成本 | 约 $1.98(模型页显示 $2.11) | 第三方(Artificial Analysis) | 同上 |
所以“Highspeed 每秒多少 tokens”这个问题,现阶段没有可靠答案。任何给出具体数字的文章,要么是自己的手测(需要看测试条件),要么是用 80.7 乘以 2 或 3 推出来的。我们不提供这样的数字,而是给一个不依赖基准数据的判断方法。
2.1 Kimi K3.1 Pro 选型方法:把人等的时间折算成钱
速度本身不值钱,值钱的是“有人因此少等了多久”。如果没人在等,快多少都没有意义。判断方法分四步:
- 估算单次等待时间:输出 tokens ÷ 速度。以标准版 80.7 tokens/秒、输出 1,500 tokens 为例,可见内容大约要 19 秒。注意两个型号都始终开启思考,思考过程也要时间,实际等待会更长,具体多长取决于你的任务。
- 估算 Highspeed 能省多少:按官方 2-3 倍推算,同样的输出大约等 6-10 秒,每次省下约 10 秒左右。这是推算,不是实测,你需要用自己的请求验证。
- 乘以次数和时薪:一天交互 100 次、每次省 10 秒,就是约 17 分钟。把这 17 分钟乘以你或团队的时间成本。
- 和多付的钱比:用第 3 节的方法算出 Highspeed 一天多花多少。省下的时间成本大于多花的钱,就值得。
这里有一个常见误区要避开:速度快 3 倍,不等于工作效率提升 3 倍。模型输出只是工作流程里的一段,你读代码、思考、修改、跑测试的时间不会因此变短。省下来的只是“等模型那几秒”,所以第 3 步一定要用真实的等待时间,而不是用倍数直接放大产出。
3. Kimi K3.1 Pro 与 Highspeed 两笔算账
下面两笔账都按官方单价折算,算式写全,你可以换成自己的 token 数重新算一遍。
3.1 场景 A:交互式改代码 20 次
设定:每次请求输入 30,000 tokens,其中 25,000 tokens 是反复带上的仓库上下文,5,000 tokens 是新内容;每次输出 1,500 tokens;连续请求 20 次,每次间隔不到 5 分钟,所以缓存一直有效。
标准版:
- 首次请求:输入
30000 × $2 / 100万 = $0.06,其中 25,000 tokens 写入缓存,写入部分按25000 × $2 / 100万 = $0.05计 - 之后每次缓存命中:
25000 × $0.2 / 100万 = $0.005 - 每次新内容:
5000 × $2 / 100万 = $0.01 - 每次输出:
1500 × $10 / 100万 = $0.015 - 单次合计:
$0.005 + $0.01 + $0.015 = $0.03
Highspeed:
- 缓存命中价不变,仍是
$0.005 - 新内容翻倍:
5000 × $4 / 100万 = $0.02 - 输出翻倍:
1500 × $20 / 100万 = $0.03 - 单次合计:
$0.005 + $0.02 + $0.03 = $0.055,约 $0.06
加上首轮写缓存的一次性开销,20 次总计标准版约 $0.66,Highspeed 约 $1.26。严格看单次费用,Highspeed 是标准版的约 1.8 倍,不到整 2 倍,原因就是缓存命中那一块没涨价。结论:贵一倍左右,但等待时间按官方倍数能省一半以上。 多出的约 $0.6 买的是 20 次等待里省下的几分钟,对多数开发者来说划算。
3.2 场景 B:批量离线处理 1,000 次
设定:每次输入 8,000 tokens、输出 600 tokens,跑 1,000 次,各次之间没有可复用的前缀,缓存用不上。
- 标准版单次:
(8000 × $2 + 600 × $10) / 100万 = $0.016 + $0.006 = $0.022,1,000 次$22 - Highspeed 单次:
(8000 × $4 + 600 × $20) / 100万 = $0.032 + $0.012 = $0.044,1,000 次$44
结论:纯亏。 没有人在等每一条结果,任务跑完的总时长通常由并发数和排队决定,多付的 $22 换不来任何可感知的收益。
| 算账项 | 场景 A 交互式改代码 | 场景 B 批量离线处理 |
|---|---|---|
| 请求次数 | 20 次 | 1,000 次 |
| 能否命中缓存 | 能,25,000 tokens 复用 | 不能 |
| 标准版总价 | 约 $0.66 | $22 |
| Highspeed 总价 | 约 $1.26 | $44 |
| 实际价格倍数 | 约 1.8-1.9 倍 | 2 倍 |
| 是否有人等待 | 有 | 没有 |
| 结论 | 贵一倍,省一半以上等待,值得 | 纯亏,选标准版 |
4. 按场景选 Kimi K3.1 Pro 还是 Highspeed
把上面的判断方法套到常见场景上,可以直接得出下面这张表。判断依据只有两条:有没有人在等,能不能用上缓存。
| 场景 | 建议 | 理由 |
|---|---|---|
| 交互式编程 | Highspeed | 人盯着屏幕等改动,仓库上下文能命中缓存,实际加价不到 2 倍 |
| 对话式 Agent | Highspeed | 多轮短请求加工具调用链,每一轮的等待会累积成明显的体感差 |
| 演示、直播 | Highspeed | 观众在看,回答出得慢会直接影响现场效果,几十次调用的成本差可以忽略 |
| 批量数据清洗 | 标准版 | 没人等单条结果,速度不产生额外价值,翻倍价格全是成本 |
| 离线评测 | 标准版 | 评测只关心结果质量,两版能力相同,评分不会因速度改变 |
| 定时任务 | 标准版 | 夜间或后台运行,早几分钟跑完没有区别,成本敏感 |
如果一个产品两类场景都有,也可以混用:前台用户直接交互的请求走 kimi-k3.1-pro-highspeed,后台总结、归档、批处理走 kimi-k3.1-pro。两个型号能力相同,切换型号名不需要改提示词。
5. Kimi K3.1 Pro 提速的第三个变量:reasoning_effort 与 Kimi Code 配额
在决定加钱之前,还有一个免费的提速选项值得先试。两个型号都是“始终思考”的模型,也就是回答前会先在内部推理一段。推理时间长短由 reasoning_effort 参数控制,可以理解为“让模型想多深”,档位越低,想得越短、出结果越快。以下均为官方文档说明:
reasoning_effort:支持low/high/max三档,默认max- 想更快,可以先把标准版降到
low试一试;如果速度够用、质量也能接受,就不必为 Highspeed 付双倍价 - 降档会影响复杂任务的推理深度,这是用质量换速度;Highspeed 则是用钱换速度、不动质量,两者的代价不同
- 两者也可以叠加:Highspeed 配合
low,适合对延迟最敏感、任务又不太复杂的场景
另一个容易忽略的点在 Kimi Code 里。Kimi Code 是 Moonshot 的编程工具,按会员配额计量用量。根据官方 Kimi Code 文档:
k3.1-pro需要 Plus 及以上会员,使用 1M 上下文需要 Pro 及以上会员k3.1-pro-highspeed需要 Pro 及以上会员- Highspeed 版约消耗 2 倍配额,同样的会员额度,用 Highspeed 能干的活大约只有一半
调用 API 时还要注意几个固定参数,官方要求在请求里直接省略,不要手动传:
temperature固定为1.0top_p固定为0.95n固定为1presence_penalty与frequency_penalty固定为0max_completion_tokens默认131072,最大1048576
6. 除了官方,怎么更方便地用 Kimi K3.1 Pro:通过 API易 接入
官方 API 同时兼容 OpenAI 与 Anthropic 两种格式,包括 Chat Completions、Responses 和 Messages 接口。“OpenAI 兼容”的意思是:你现有的 OpenAI SDK 代码基本不用改,换掉地址和密钥、改个型号名就能调用。
国内开发者可以通过 API易 apiyi.com 用一个 API Key 统一调用多家模型,按量计费,新用户有免费测试额度。接入方式如下:
- OpenAI 格式:
base_url设为https://api.apiyi.com/v1 - Anthropic 格式:base 地址设为
https://api.apiyi.com model填平台型号列表里对应的型号名
需要说明的是,截至 2026-10-24 核对,API易 型号列表中的 Kimi 系列已有 kimi-k2.5、kimi-k2.6、kimi-k2.7-code、kimi-k3 等型号,kimi-k3.1-pro 与 kimi-k3.1-pro-highspeed 暂未上架。这两个型号在平台上的型号名与价格以平台型号列表为准,我们会尽快推出此模型。在此之前,可以先用现有 Kimi 型号把调用链路和缓存策略跑通,上架后只需改型号名。
7. Kimi K3.1 Pro 与 Highspeed 决策建议
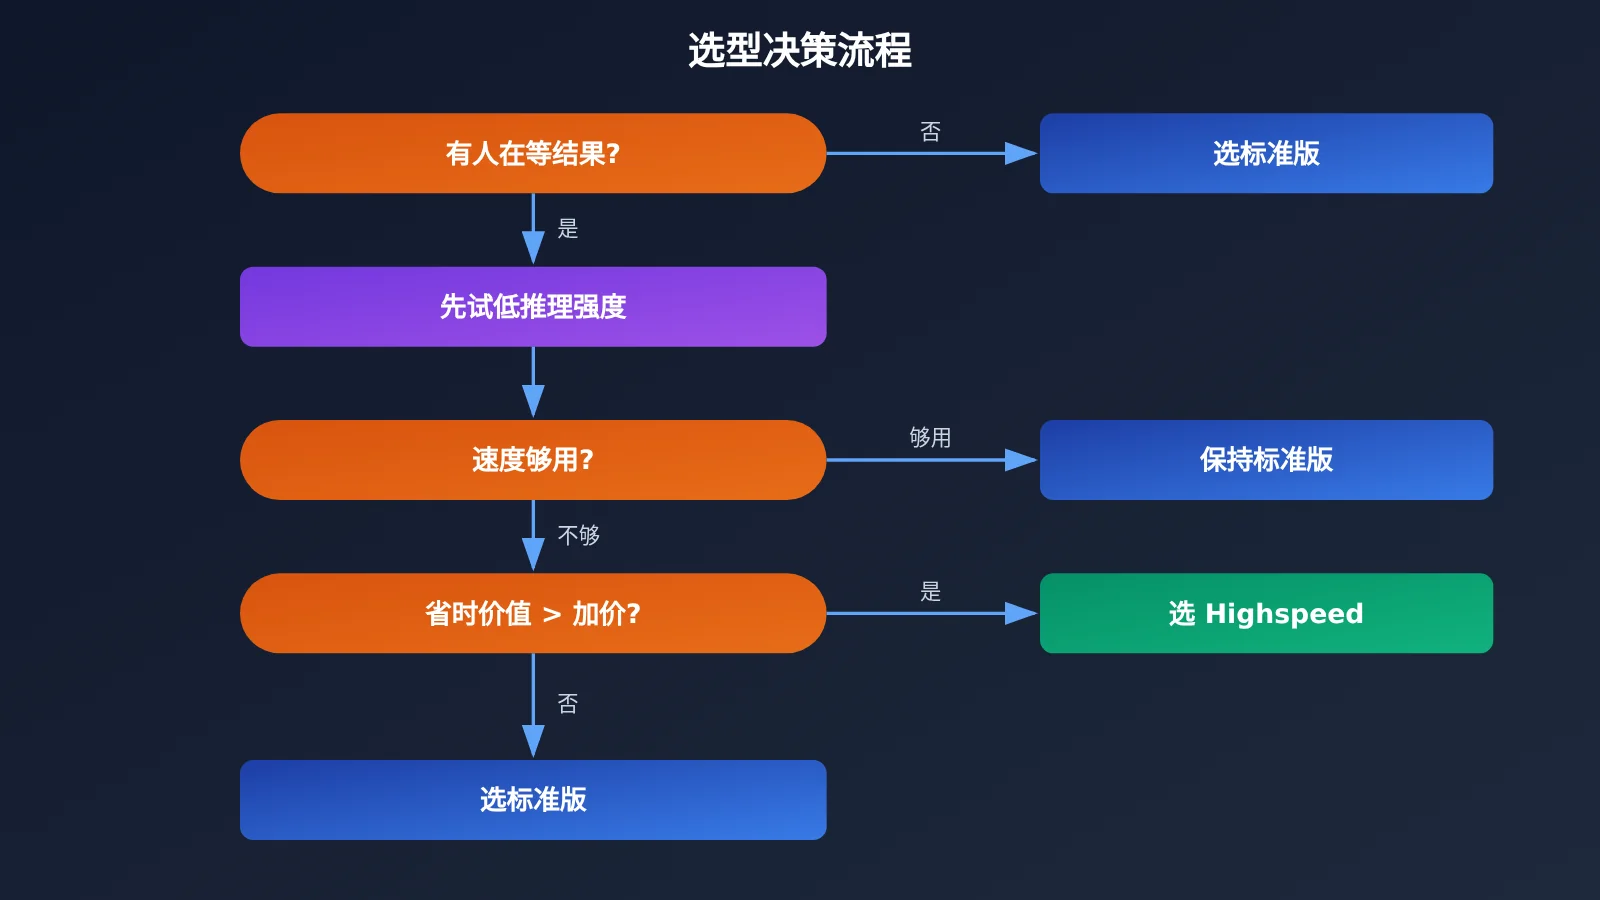
选择建议:先问“有没有人在等”。没人等,选标准版;有人等,先把
reasoning_effort降到low试一次,仍嫌慢再换 Highspeed。最终是否值得,用第 2 节的方法把省下的等待时间折算成钱,再和第 3 节算出的差价比较。建议用你自己的真实请求在 API易 apiyi.com 上做小规模对比,K3.1 Pro 系列上架后的型号与价格以平台型号列表为准,我们会尽快推出此模型。
几条可以直接执行的原则:
- 默认用标准版,把 Highspeed 当成按需开启的选项,而不是默认配置
- 复用前缀越多,Highspeed 越划算,因为缓存命中价没有翻倍
- 团队混用时按入口分流,前台交互走 Highspeed,后台任务走标准版
- 在 Kimi Code 里用 Highspeed 要算配额,它消耗约 2 倍额度
常见问题 FAQ
Q1:Kimi K3.1 Pro Highspeed 是什么?
它是 Moonshot 与 Kimi K3.1 Pro 同时发布的高速版本,型号名 `kimi-k3.1-pro-highspeed`。官方称其速度是 K3.1 Pro 的 2-3 倍,模型能力相同,上下文同为 1,048,576 tokens。
Q2:Highspeed 版效果会不会比标准版差,或者更好?
按官方表述,两者能力相同,所以不存在“快了就变笨”或“贵了就更聪明”。真正影响回答质量的是 `reasoning_effort` 档位,而不是选哪个版本。
Q3:Highspeed 版到底快多少?有没有具体 tokens/秒?
官方只给了“2-3 倍”这个区间,没有公布细数据。第三方 Artificial Analysis 测得标准版输出速度为 80.7 tokens/秒,但没有单独测 Highspeed。Highspeed 的具体数值目前属于未核实信息,建议用自己的请求实测。
Q4:为什么说 Highspeed 实际不一定贵整整 2 倍?
因为缓存命中输入价两者都是 $0.20/百万 tokens。如果请求里大量输入是重复前缀并能命中缓存,这部分不加价,总价倍数会低于 2。本文场景 A 的单次费用约为标准版的 1.8 倍。
Q5:国内怎么调用 Kimi K3.1 Pro 和 Highspeed?
可以使用官方 Kimi API,也可以通过 API易 apiyi.com 的 OpenAI 兼容接口调用,`base_url` 换成 `https://api.apiyi.com/v1`。两个型号在 API易 的型号名与价格以平台型号列表为准,目前还在接入,我们会尽快推出此模型。
Q6:Kimi K3.1 Pro 系列有哪些已知限制?
– 两个型号始终开启思考,无法完全关闭推理,只能用 `reasoning_effort` 调档
– `temperature`、`top_p` 等参数固定,请求中需省略,没法靠调采样参数控制风格
– Kimi Code 中 Highspeed 需要 Pro 及以上会员,且约消耗 2 倍配额
– 官方表示将在 2026-11-04 前放出完整权重,目前尚未发布
Kimi K3.1 Pro 与 Highspeed 选择 Key Takeaways
- 能力相同:Highspeed 只买速度,不买更好的回答质量
- 价格翻倍:输入、输出、两档缓存写入均为 2 倍,只有缓存命中价同为 $0.20
- 速度数据稀缺:官方仅称快 2-3 倍,第三方只测了标准版的 80.7 tokens/秒
- 判断看等待:把人等的时间折算成钱,再和差价比,不要把速度倍数当效率倍数
- 交互选高速:交互式编程、对话 Agent、演示直播适合 Highspeed
- 批量选标准:批量清洗、离线评测、定时任务用 Highspeed 纯亏
- 先降档再加钱:
reasoning_effort降到low是免费的提速选项
总结
Kimi K3.1 Pro 与 Highspeed 怎么选,核心要点有三条:
- 两版能力相同:选哪个都不影响回答质量,差别只在速度、价格和会员门槛
- 加价有例外:五档价格里四档翻倍,缓存命中价不变,复用前缀越多,Highspeed 实际加价越少
- 有人等才值得:交互场景用 Highspeed 是用约一倍的钱换一半以上的等待;批量场景用它只是多付钱
实际操作时,建议先用标准版加 reasoning_effort=low 测一轮,速度仍不满足再切 Highspeed,并用自己的 token 数套用第 3 节的算式复核成本。通过 API易 apiyi.com 接入时,K3.1 Pro 系列的型号与价格以平台型号列表为准,我们会尽快推出此模型。
参考资料
- Kimi 官方入口与博客:K3.1 Pro 与 Highspeed 发布说明、能力与渠道描述
- 链接:
kimi.ai -
说明: “速度 2-3 倍、能力相同”的官方表述来源
-
Artificial Analysis:第三方模型速度与成本测量
- 链接:
artificialanalysis.ai -
说明: 标准版 80.7 tokens/秒、单任务输出量与成本数据来源
-
Simon Willison 博客:开发者公开记录
- 链接:
simonwillison.net -
说明: 确认 Highspeed 价格翻倍、缓存命中价与标准版相同
-
API易 模型列表:平台可用型号与价格
- 链接:
docs.apiyi.com/models - 说明: 2026-10-24 核对 Kimi 系列在平台的上架情况
作者:API易 技术团队
技术交流:更多接入资料可访问 docs.apiyi.com 文档中心;Kimi K3.1 Pro 系列的上架型号与价格以平台型号列表为准,我们会尽快推出此模型。