2026 年 10 月 20 日,Google Cloud 伦敦一个可用区停电近 8 小时;五天前,DeepSeek 也掉线了大半个上午。不少开发者在问,自己的 AI 应用下次会不会也跟着停。
上游说不定哪天会掉。只调模型 API 的人不必搬机房,但不能把业务只挂在一家模型上。
核心价值:读完这篇,你能分清哪些情况要动手、哪些不用,并且知道怎么给模型留好后路。
这周两次中断,各自掉了什么
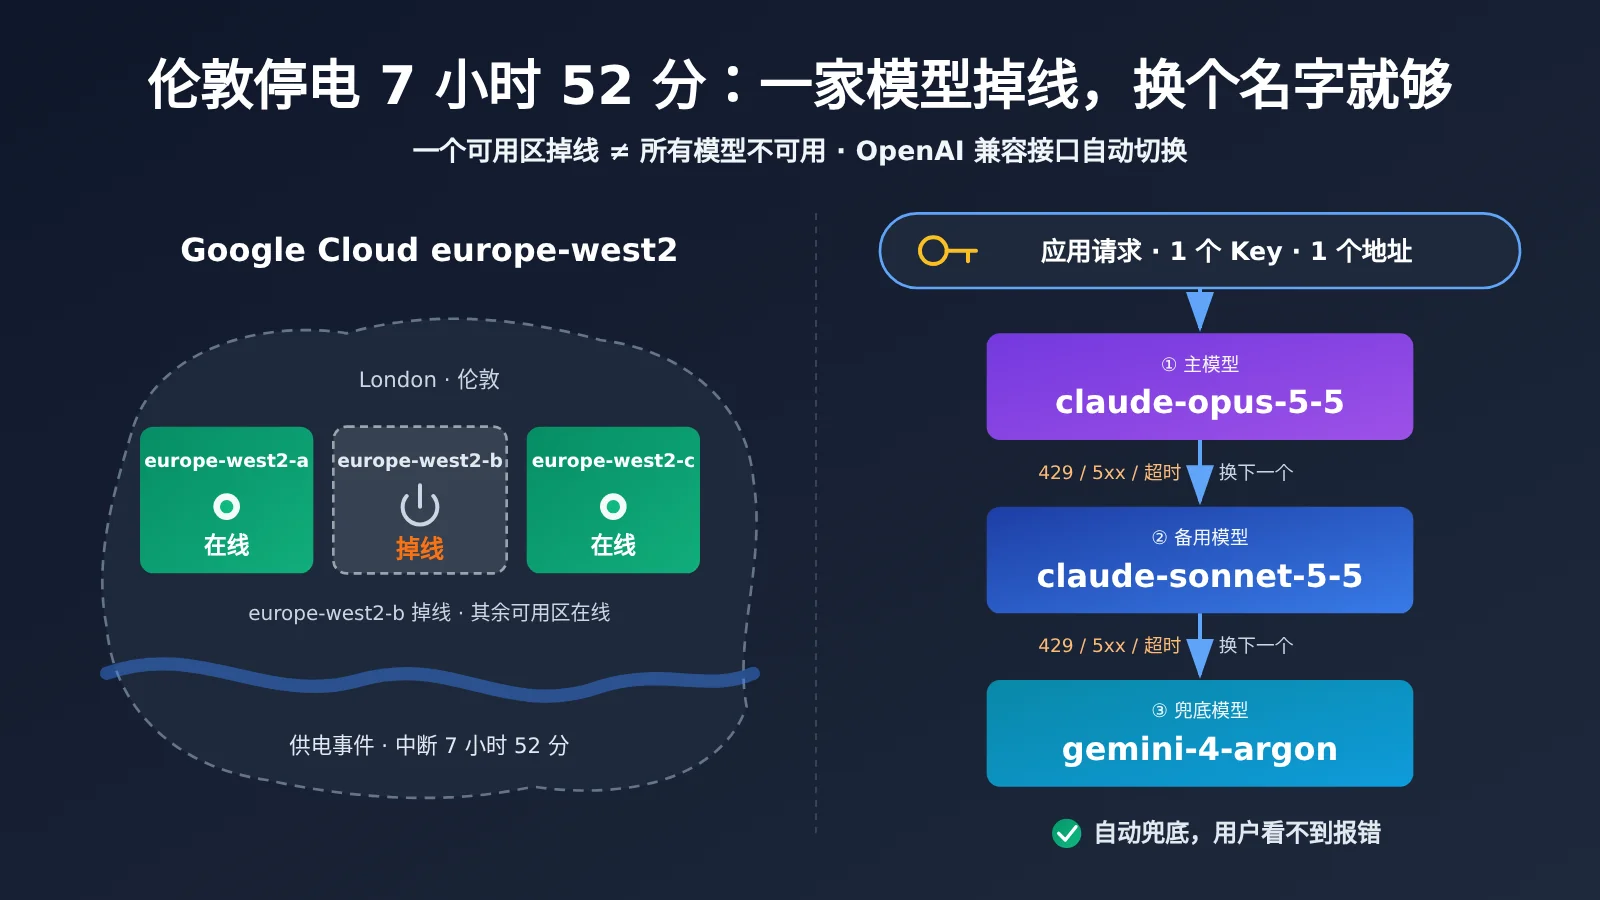
先说 Google Cloud。2026-10-20 北京时间 14:08 到 22:00,伦敦 europe-west2-b 这一个可用区因供电事件中断,一共 7 小时 52 分。受影响的是部署在这个可用区里的计算、存储、数据库和网络;只远程调用模型 API 的人,不在这次的直接影响范围内。可如果你的服务恰好跑在这个区,那一下午,后台任务、数据库连接、对外接口都得停在那里等,谁也没法替它们提前把活干完。
再说 DeepSeek。2026-10-15 北京时间 08:11 开始,网页、对话和 V4 Pro、V4.1 Flash 的 API 部分中断。官方状态页记录持续 4 小时 52 分,当天 13:04 恢复。财新、南华早报说「将近 5 小时」,那是媒体说法,时长以官方记录为准。DeepSeek 后来把 10 月 8 日到 14 日的消耗退成了额度。原因官方没有公布,这里不做猜测。对用户来说,那个上午能不能用,取决于手上有没有第二条路,而不是原因是什么。
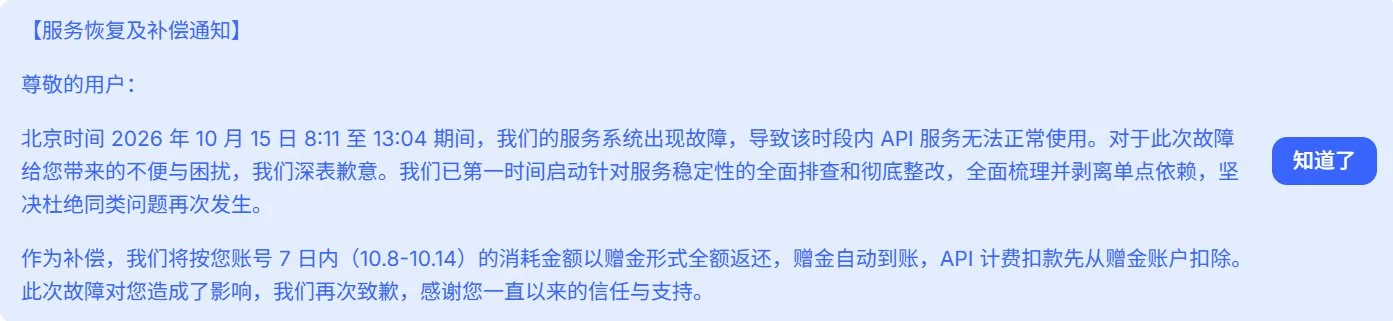
图:DeepSeek 发给用户的服务恢复及补偿通知。北京时间 10 月 15 日 8:11 至 13:04 API 服务无法正常使用,按账号 10 月 8 日到 14 日的消耗金额以赠金形式全额返还,自动到账,API 扣费先从赠金账户扣除。
两件事疼的地方一样:模型是当天工作流里的一环,接口一断,写代码、查资料、跑批处理都会停在那里。等上游修好,半天就过去了。退额度补的是账单,补不回停掉的工作。一个团队如果当天本来要交一批翻译、跑一轮评测、赶一个上线,这些都不会因为事后的补偿自己完成,只会往后顺延,连带挤占第二天的排期。
| 项目 | Google Cloud 事故已核实的情况 |
|---|---|
| 事故编号 | Xs2XTHzAVC9YnafnPyzj |
| 影响范围 | europe-west2 区域内的 europe-west2-b 可用区 |
| 原因 | 供电事件,官方没有更多细节 |
| 开始时间 | 北京时间 2026-10-20 14:08 |
| 结束时间 | 北京时间 2026-10-20 22:00,持续 7 小时 52 分 |
| 不受影响 | Looker Studio |
可用区和区域,差在哪
很多人看到「伦敦停电」,第一反应是整个伦敦的 Google Cloud 都挂了,其实不是。区域(europe-west2)可以理解成 Google 在伦敦的一整片机房,可用区(europe-west2-a、b、c)是这片机房里互相隔开的几栋楼,设计上各自供电、各自联网,就是为了一栋出事时另外几栋还能顶上。这次是三栋里黑了一栋,另外两栋照常在线。
所以真正受伤的,是把服务只放在 b 区的团队。服务本来就分散在 a、c 区的,流量能被切到还亮着的那几栋,影响会小很多。只远程调用模型 API 的人,几乎感觉不到这次停电。
两次中断放在一起看
| 对比项 | Google Cloud 伦敦 | DeepSeek |
|---|---|---|
| 时间(北京时间) | 2026-10-20 14:08 到 22:00 | 2026-10-15 08:11 到 13:04 |
| 持续时长 | 7 小时 52 分 | 4 小时 52 分 |
| 掉了什么 | europe-west2-b 里的计算、存储、数据库和网络 | 网页、对话,以及 V4 Pro、V4.1 Flash 的 API |
| 原因 | 供电事件,没有更多细节 | 官方没有公布 |
| 事后处理 | 官方建议如可行,迁到其他可用区或区域 | 10 月 8 日到 14 日的消耗退成额度 |
| 只调模型 API 的人 | 不在直接影响范围内 | 正中靶心,没有备用就只能干等 |
两次放在一起看,差别就清楚了:Google 那次,疼的是把机器放在 b 区的人,解法是跨可用区部署;DeepSeek 那次,疼的是只接了一家模型的人,解法是提前排好备用模型。前一种是机房的事,后一种是调用的事,下面讲的都是后一种。
这次故障该吸取的教训
一家会掉,所以要提前有第二条、第三条路,而且这几条路最好不是同一家。在同一家里换个便宜档不算后路,整家出问题时,两档会一起倒。
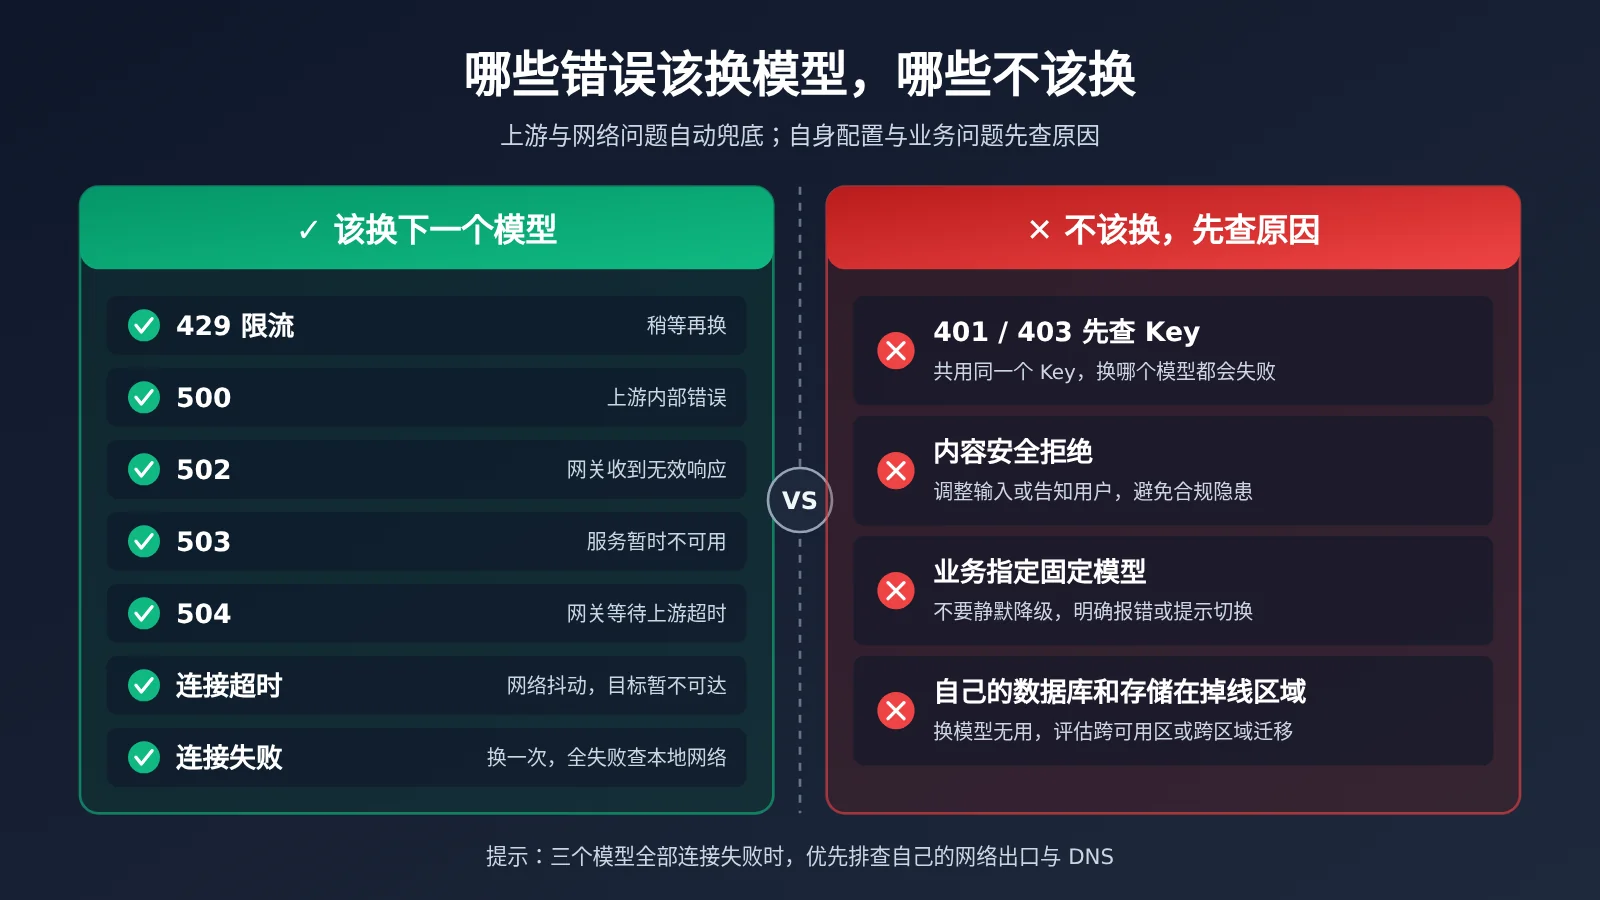
什么时候换也有讲究:只有 429、500、502、503、504 和超时才换模型,这些是对方暂时扛不住,换个名字有机会成功。401、403 和内容安全拒绝不要换,那是 Key 或内容本身的问题,换十个模型也一样被拒。还有一点要分清,自己部署在掉线可用区里的数据库和存储,换模型救不了,那得评估跨可用区部署,模型兜底和机房容灾是两件事,别混着做。
兜底做好之后,也别在故障结束后拆掉。它平时不产生额外请求,主模型一次成功就用不上,但下一次出事时会自动生效,不用半夜起来改代码。动手之前,先给每个模型单独发一条最简单的请求,确认名字没写错、能正常返回,再去想怎么把它们串起来。不同模型的回答风格会有差别,如果业务对输出格式要求高,可以在 system 提示词里把格式写死,减小换模型后的落差。
兜底链路的几个设置怎么定
光知道「失败就换」还不够,换得太急、太慢都会出问题。下面这几项是最常被问到的,没有标准答案,按自己的业务往里套就行。
| 设置 | 建议 | 为什么 |
|---|---|---|
| 同一个模型重试几次 | 最多 1 次,再失败就换下一个 | 上游在出事时,连续重试同一个模型往往只是多排一轮队 |
| 单次请求等多久 | 对话类短一些,长文生成类长一些 | 等得太久,用户还没等到切换就先关页面了 |
| 遇到 429 怎么办 | 稍等一两秒再换 | 限流有时只是瞬间高峰,过一下就好 |
| 整条链路最多等多久 | 三档加起来,不超过用户能接受的等待 | 防止三档都慢的时候请求一直挂着 |
| 记什么日志 | 每次是哪一档成功、哪一档失败、错误码是多少 | 事后能看出是哪家在掉,要不要调整顺序 |
| 什么时候提醒人 | 备用档被用上的比例突然升高时 | 兜底生效后用户无感,团队也可能无感,总得有人知道主模型在出问题 |
最后一项最容易被忽略。兜底做得越好,主模型出问题时越安静,如果没人看日志,可能主模型已经掉了一整天,大家还以为一切正常,账单上却多了一堆备用模型的调用。
换模型不必换一把 Key
兜底最怕改造太重。每个模型都要单独申请账号、换地址、改请求格式,多数团队会拖到下次出事才动手。
APIYI 的做法是同一个地址 https://api.apiyi.com/v1/chat/completions,同一把 Key,请求体里只改 model。主模型用 claude-opus-5-5,失败后换 claude-sonnet-5-5,再失败换 gemini-4-argon。前两档同属一家,第三档换到另一家,某一家整体出问题时还有路可走。这样改造的量很小:业务代码里只多一个按顺序尝试的模型名列表,请求格式、鉴权方式和返回结构都不用动,测试起来也简单。
| 顺序 | 模型名 | 输入价格 | 输出价格 | 角色 |
|---|---|---|---|---|
| 1 | claude-opus-5-5 | 4 | 20 | 主模型 |
| 2 | claude-sonnet-5-5 | 2 | 10 | 第一备用,同家便宜档 |
| 3 | gemini-4-argon | 2 | 10 | 第二备用,另一家供应商 |
| 可替换 | gpt-6-astra | 10 | 50 | 更贵的备用,只走 OpenAI 接口 |
| 可替换 | deepseek-v4.1-flash | 0.30 | 1.20 | 便宜备用 |
上表单位为美元 / 百万 tokens,按 2026-10-21 价格页、倍率 1 整理,价格可能调整,以 api.apiyi.com 价格页为准。
三步接上兜底
第一步,拿 Key。 在 api.apiyi.com 注册并创建一把 Key,按量计费,国内可以直连,不用绑海外信用卡。这一把 Key 就能调上表里所有模型。
第二步,逐个跑通。 接口地址填 https://api.apiyi.com/v1,它和 OpenAI 的接口格式兼容,原来用 OpenAI 官方库写的代码,换个地址和 Key 就能用。用同一段提示词,把 claude-opus-5-5、claude-sonnet-5-5、gemini-4-argon 各跑一遍,确认都能正常返回、格式符合预期。
第三步,排好顺序再演练一次。 把三个模型名按顺序写进配置,按上一节的规则决定什么时候换。接好之后别急着上线,先把主模型的等待时间临时调得很短,故意让它超时,看请求是不是落到了第二档,日志里有没有记下来。演练通过了,这条后路才算真的留好。具体参数可以查 docs.apiyi.com 的接入文档。
不同业务怎么排顺序
本文默认的顺序是质量优先,不是唯一答案。业务不同,打头的模型也可以不同。
| 业务类型 | 参考顺序 | 理由 |
|---|---|---|
| 写代码、复杂推理 | claude-opus-5-5 → claude-sonnet-5-5 → gemini-4-argon | 质量优先,就是本文的默认顺序 |
| 客服、日常对话 | claude-sonnet-5-5 → gemini-4-argon → deepseek-v4.1-flash | 调用量大、单价敏感,主模型不必上最贵的 |
| 批量翻译、摘要 | deepseek-v4.1-flash → gemini-4-argon → claude-sonnet-5-5 | 跑得多,便宜档打头,失败再往上走 |
| 对格式要求严的输出 | 同一家的两档在前,另一家放最后 | 同一家的模型风格通常更接近,换了落差小 |
排顺序的原则就两条:最后一档尽量换一家;单价跟这件事值多少钱匹配。像批量翻译这一行,正好也能看出兜底的价值,10 月 15 日那天如果打头的 DeepSeek 掉了,请求会自动落到后面两家,任务照样跑完。
要说清楚的是,换模型解决的是「调用模型这一步不断」,修不好机房停电。
上游会掉,提前留一条别的路
已公开的例子是 2026-10-15 的 DeepSeek 官方中断:当时 APIYI 切到了火山引擎满血版通道,模型名不用改,生产环境当时恢复正常。出处见 docs.apiyi.com 实时动态。
上游会掉,这不是谁的错。提前留一条别的路,比干等半天有用。这件事平时几乎不花钱,也不占人力,只要在出事之前做完;出事之后再做,就只能一边着急一边改。
出事那天,先看哪几个地方
请求突然大面积失败时,先别急着改代码,花两分钟看三个地方:一是 Google Cloud Service Health,看是不是机房层面出了事;二是对应模型厂商的官方状态页,比如这次的 DeepSeek 状态页;三是 docs.apiyi.com 的实时动态,APIYI 这边上游路线有变动,会在这里写明。
三个地方都显示正常,再回头查自己:Key 有没有过期、余额够不够、网络出口和 DNS 有没有问题。顺序反过来,很容易在自己代码里找半天,最后发现是上游的事。
今天就能做完的四件事
- 列出业务里所有调用模型的地方,看哪些只接了一家。
- 给每个只接了一家的地方,补上至少一个另一家的备用模型。
- 按上文的规则,只在 429、5xx 和超时时切换,并把每次切换记进日志。
- 故意让主模型超时一次,确认请求真的落到了备用档。
做完这四件事,下一次不管是机房停电还是模型厂商掉线,你的应用最多慢几秒,而不是停半天。
常见问题
Q1:Google Cloud 伦敦停电后,要不要马上迁出伦敦?
不一定。官方建议带的是「如可行」,不是要求所有人立刻搬。工作负载在 europe-west2-b 的团队,可以评估迁到别的可用区或区域;只调用模型 API 的团队不用迁,先把模型兜底排好。
Q2:换模型会不会更贵?
按上面的顺序反而更便宜。主模型 claude-opus-5-5 是输入 4、输出 20,两个备用都是输入 2、输出 10。只有把 gpt-6-astra 这种输入 10、输出 50 的模型放进备用列表,成本才会上去。
Q3:一把 Key 能不能同时调这几家的模型?
可以。这几个模型都走同一个 OpenAI 兼容地址,同一把 Key,只改 `model`。其中 gpt-6-astra 只走 OpenAI 接口,用的时候留意一下。
Q4:换到备用模型,回答质量会不会变差?
有可能会有差别,尤其是从最强的一档换到便宜档时。但对多数业务来说,慢一点、稍微差一点的回答,好过直接报错。对格式要求高的场景,可以在 system 提示词里把输出格式写死,再用第二步的方法提前对比几个模型的输出,心里有数再上线。
Q5:平时不出事,留着备用模型要多花钱吗?
不用。按量计费只为实际发出去的请求付钱,主模型一次成功,备用模型就不会被调用,也不产生费用。真正要花的只是接入时的那一点时间,以及演练时跑的几次测试请求。
核心要点 Key Takeaways
- 两次中断:Google Cloud europe-west2-b 停电 7 小时 52 分;DeepSeek 官方记录中断 4 小时 52 分。
- 事实边界:不是整个欧洲宕机,模型本身没有因此下线;DeepSeek 的原因官方没公布。
- 何时换:只有 429、500、502、503、504 和超时才换,401、403 和内容安全拒绝不换。
- 做法:备用最好不是同一家;同一个地址、同一把 Key,只改
model。 - 验收:接好后故意让主模型超时一次,看请求是否落到备用档,日志里有没有记录。
退额度补得了账单,补不回停掉的工作。把模型顺序提前排好,下次上游出问题,用户最多感觉慢了几秒。
参考资料
- Google Cloud Service Health:europe-west2 多项服务事故(Xs2XTHzAVC9YnafnPyzj),2026-10-20
- Google Cloud Service Health:Google SecOps europe-west2 安全产品事故(单独记录),2026-10-20
- BBC:英国银行与公共服务受 Google Cloud 故障影响的报道,2026-10-20
- DeepSeek 官方状态页:2026-10-15 服务中断记录
- 官方文档:docs.apiyi.com 实时动态
作者:APIYI 技术团队
技术交流:如果你在做模型兜底时遇到问题,欢迎在评论区留言讨论。