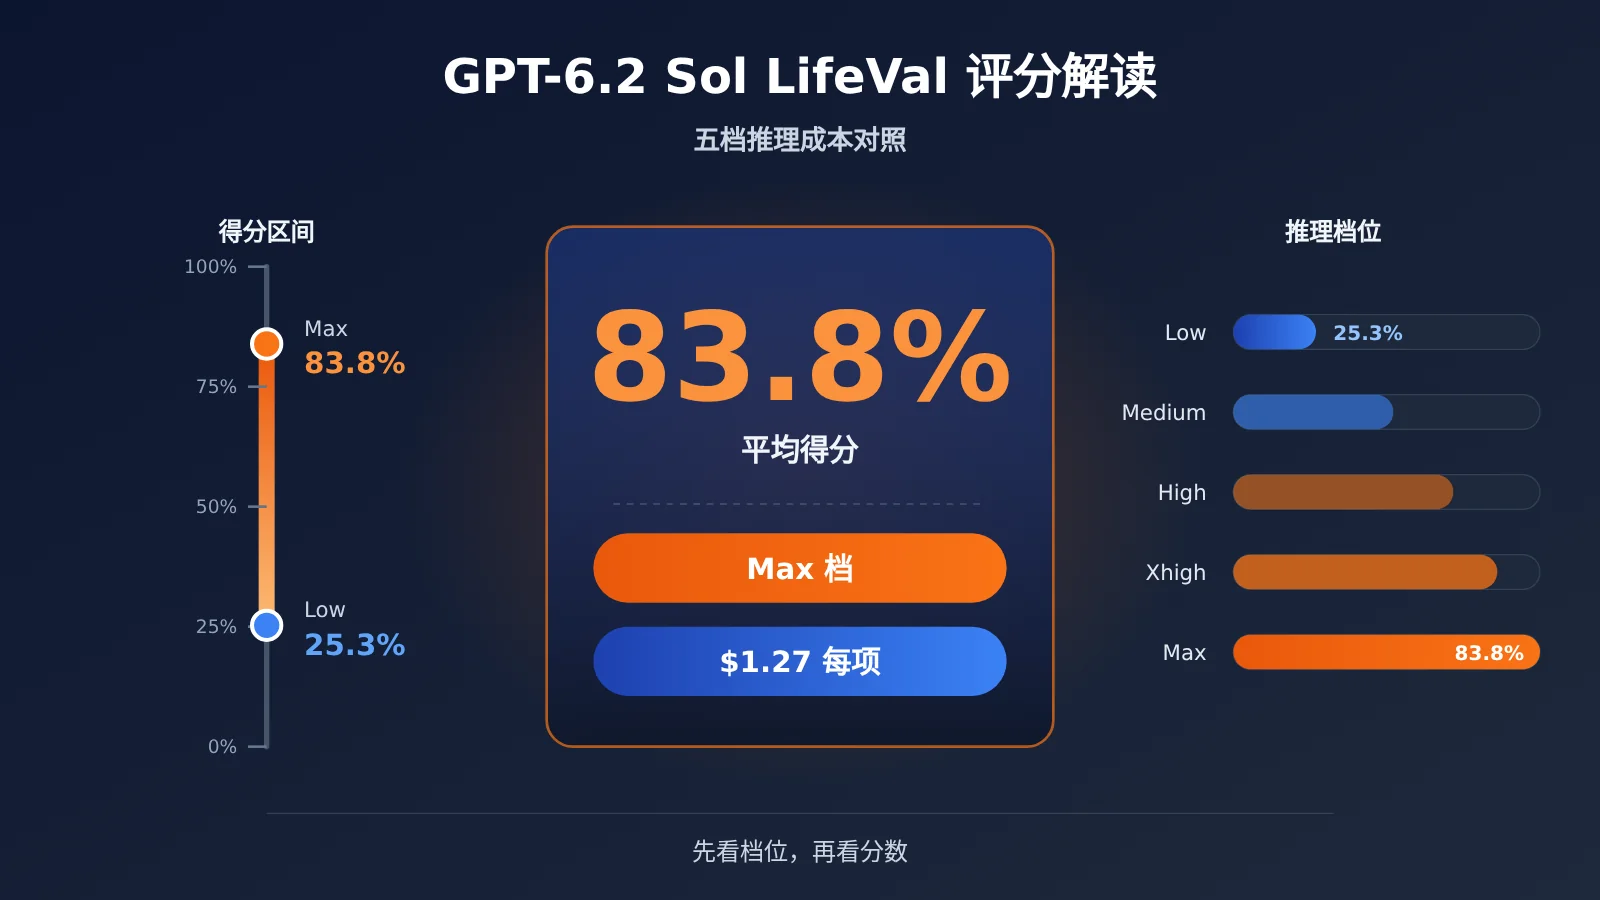
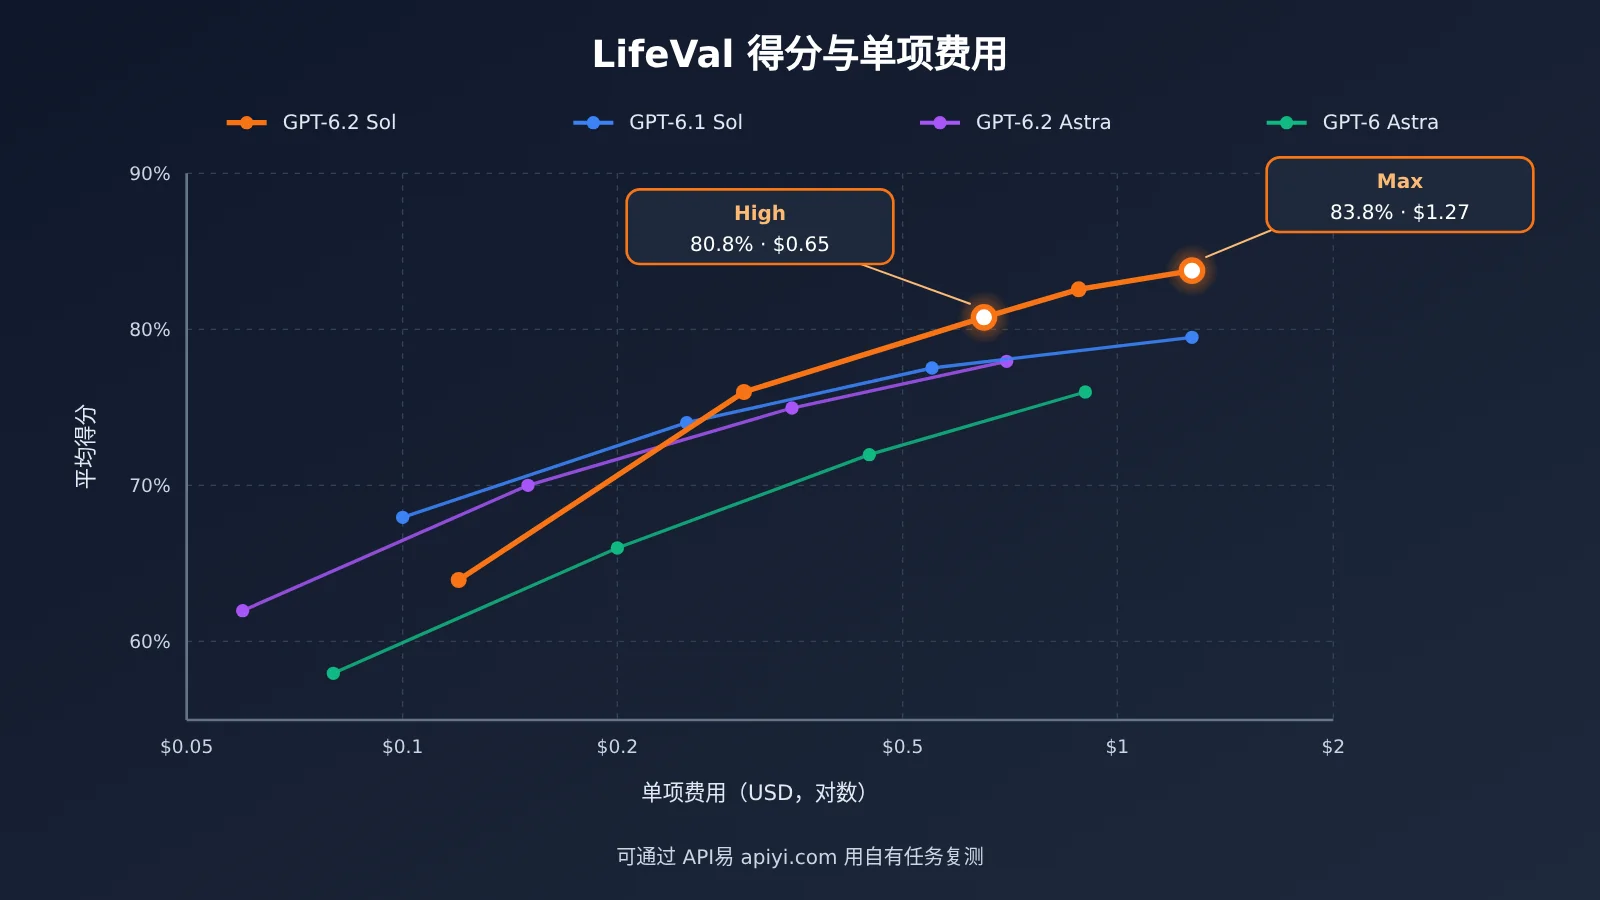
83.8% 不是“83.8% 的任务全部完成”,而是 GPT-6.2 Sol 在 Max 推理档下的 LifeVal 平均得分。 这一分数按每项任务的评分细则逐项给分后汇总,对应的平均单项费用为 $1.27。同一个模型换到 Low 档,平均得分只有 25.3%;换到 High 档,平均得分为 80.8%,单项费用为 $0.65。所以讨论 GPT-6.2 Sol 的 LifeVal 表现时,必须先说清是哪一档。
结论是:官方榜单给出的是“特定任务与特定环境下的分数和成本组合”,不是一个可以直接搬到你产品里的总排名。在 LifeVal 这组数据中,High 档是值得优先测试的起点。最终用哪一档,仍要用你自己的任务、按产物和真实状态来验收。
您读完此文能了解到什么?
- LifeVal 测的是什么任务,83.8% 应该怎样正确表述。
- GPT-6.2 Sol 五个推理档位的得分与费用,以及和 GPT-6.1 Sol、GPT-6 Astra、GPT-6.2 Astra 的同档对照。
- 官方所说“成本约七分之一”与“Low 档大幅下滑”为什么能同时成立。
- 如何借鉴 LifeVal 的验收方法,为自己的日常助理设计可复测的评估任务。
索引:To Know 表格先解释后文需要用到的评测术语,影响速览则分别说明普通用户和开发者各自应关注什么。客观事实部分依次交代 LifeVal 的任务来源与计分方式,以及 11 月 17 日发布图中的分档数据。分析判断部分先拆解几组比较的分母,再给出一个可直接改写的路线与日程助理验收样例,并说明迁移边界。
To Know:理解 GPT-6.2 Sol LifeVal 评分的关键概念
| 概念 | 简要解释 |
|---|---|
| LifeVal | OpenAI 用于衡量 AI 助理完成个性化日常数字任务表现的基准 |
| 个性化上下文 | 用户偏好、历史资料、任务特定条件等会改变“合格答案”的信息 |
| 评分细则 | 把一项任务的完成度拆成若干可逐项验收的要求 |
| 受控环境 | 预先设置好应用、数据和起始状态的评测环境,便于核对动作结果 |
| 后端状态差异 | 测试前后记录的应用状态变化,用来确认工具操作是否真的生效 |
| 平均奖励值 | 各任务按评分细则得分后的汇总指标,发布图中的百分比即此类“平均得分” |
| 推理强度 | 控制模型推理投入的档位,本文对照 Low、Medium、High、Xhigh、Max |
| 单项成本 | 评测图中平均每项任务的费用,随模型用量与费率变化 |
GPT-6.2 Sol LifeVal 影响速览
- 普通用户:看到“83.8%”时,把它理解为“在一组美国英语用户日常任务上的平均得分”,而不是成功率。另外要注意,同一个模型在不同推理档下差距很大,产品体验取决于应用方选了哪一档。
- 产品经理:Low 档的价格最低,但这次在 LifeVal 中得分大幅落后于上一代 Sol 的 Low 档。沿用旧版本的档位配置做升级,可能出现“换了新模型反而变差”的情况。
- API 开发者:值得借鉴的是 LifeVal 的验收设计,即对交付物、环境状态和回答分别评分。用同一批自有任务横向比较 Low、Medium、High 档,比直接引用榜单数字更可靠。
客观事实:GPT-6.2 Sol LifeVal 用什么任务测模型
LifeVal 的来源与发布时间线
LifeVal 是 OpenAI 用于测量个性化日常代理任务的评测。OpenAI 研究页日期为 2026 年 11 月 2 日,配套论文日期为 11 月 3 日。11 月 17 日,OpenAI 发布 GPT-6.2 Astra 和 GPT-6.2 Sol,并在发布页中附上了包含新模型分档成绩的 LifeVal 图表(图表标识 lifeval-v2)。
论文的任务分布来自美国及多国的时间使用研究,并参考了一项面向美国人群的付费意愿调查,最终把日常活动整理为 148 类。论文实验使用 169 项任务。需要注意的是,论文本身评测的模型截止到 GPT-6 Astra,GPT-6.2 系列的分档数字只出现在后来的官方发布图里。
按官方定位,Sol 面向高频日常工作、常规编程和可规模化的多步骤 Agent,Astra 面向更困难的推理和专业交付。这一定位与 LifeVal 测量的“日常助理任务”是对得上的。
LifeVal 的任务设计:同一需求,因人而异的合格答案
LifeVal 的特点是“个性化”。以搬家后比较学校为例,有孩子年龄、通勤路线、学区偏好不同的用户,合格答案就不一样。再如在预算和通勤时间之间权衡找房,预算上限和可接受通勤时长会直接决定哪些房源算是合格结果。
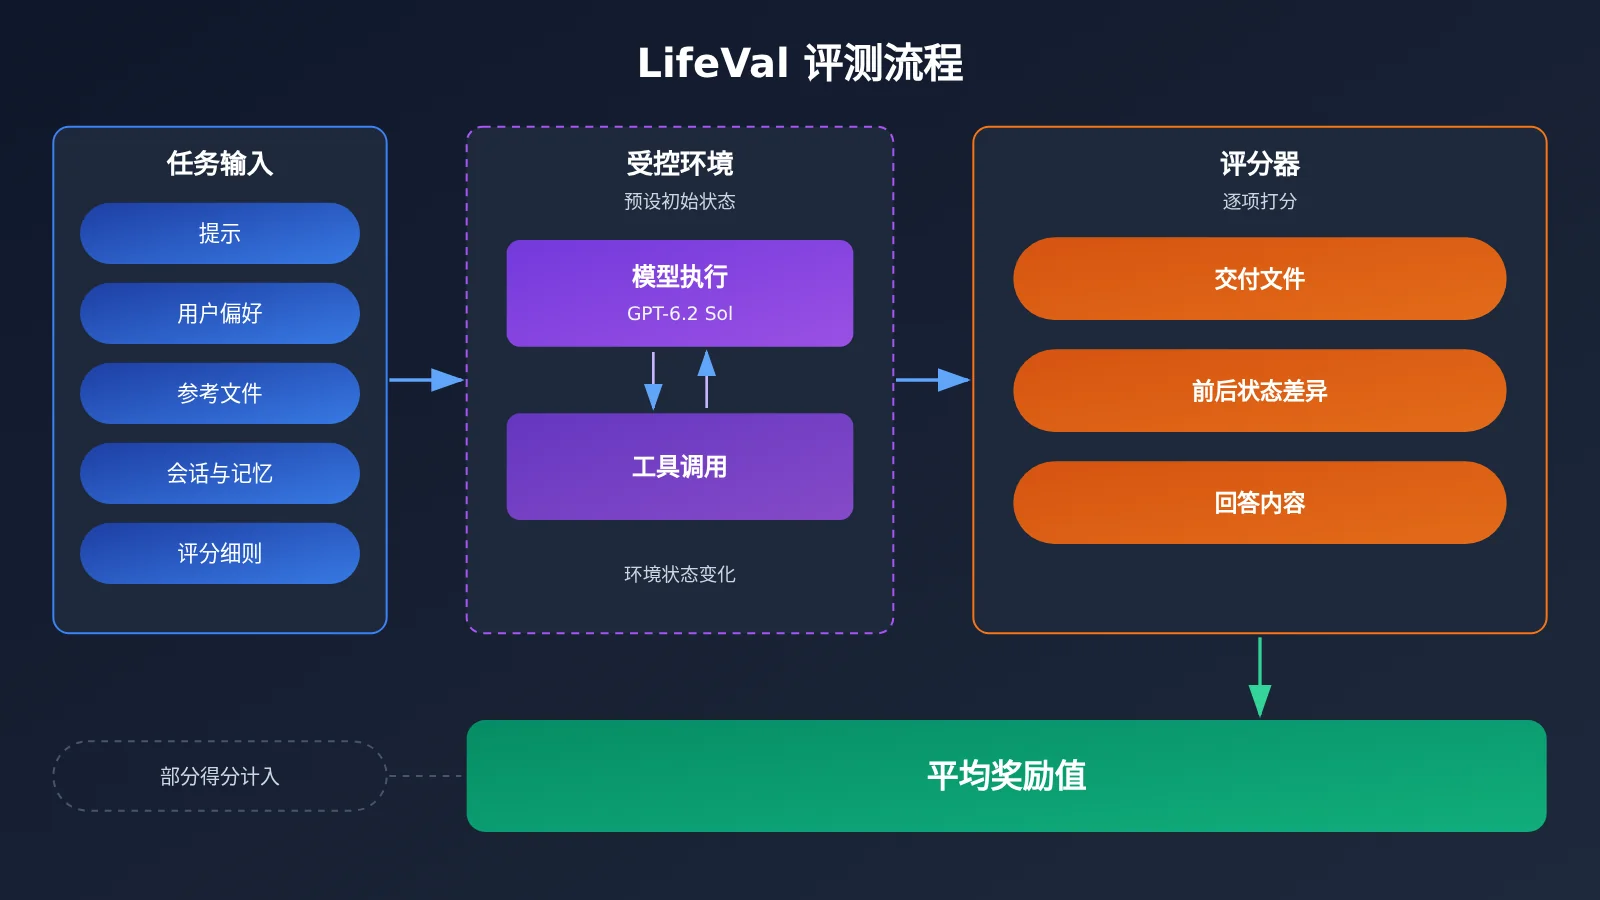
按论文口径,每项任务都带有提示、用户偏好、参考文件、相关会话与记忆、评分细则,以及一个预先设置状态的受控环境。执行结束后,评分器可以核对三类东西:模型交付的文件、工具所操作环境的前后状态,以及模型的回答,然后按任务的各项要求分别给分。
为什么 83.8% 只能说“平均得分”
论文结果图的纵轴是平均奖励值。因此,83.8% 应表述为“平均得分”,不能写成“83.8% 的任务被完整执行成功”。一项任务即使只满足了部分评分项,也会贡献部分分数。
论文还交代了几项限制:离线环境和缓存网页中仍有部分会随时间变化的信息,样本人群以面向美国、使用英语的用户为主。这意味着分数不能直接推广到其他地区、其他语言或其他应用生态。
GPT-6.2 Sol LifeVal 发布图:五档得分与单项费用
下表读取自 2026 年 11 月 17 日 OpenAI 发布页中的 LifeVal 交互图公开数据。每格为“平均得分 / 平均每项任务费用(USD)”,属于 OpenAI 自报的公开评测数据,并非独立机构实测。
| 模型 | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25.3% / $0.089 | 70.3% / $0.38 | 80.8% / $0.65 | 82.6% / $0.88 | 83.8% / $1.27 |
| GPT-6.1 Sol | 66.8% / $0.52 | 75.5% / $0.73 | 77.1% / $0.88 | 77.8% / $0.96 | 79.5% / $1.27 |
| GPT-6.2 Astra | 46.3% / $0.59 | 78.9% / $1.56 | 83.1% / $2.41 | 83.7% / $2.94 | 86.1% / $4.23 |
| GPT-6 Astra | 67.5% / $3.51 | 74.3% / $5.30 | 76.0% / $6.52 | 77.5% / $6.94 | 79.8% / $9.04 |
发布公告正文的说法是:在 LifeVal 中,Sol 得分高于 GPT-6 Astra,成本约为后者的七分之一。这里的比较对象是上一代旗舰 GPT-6 Astra,不是同期的 GPT-6.2 Astra。公告中另一组 FrontierCode 2.0 的比较才使用 GPT-6.2 Astra,阅读时不要把两组结论混在一起。
📌 数据口径提示:表中“单项费用”是官方评测图的平均值,受该评测的输入长度、输出长度和工具使用影响。你自己的任务成本需要用真实请求复测,可以通过 API易 apiyi.com 用同一个 Key 依次跑 Sol 的不同档位,直接对比账单。
GPT-6.2 Sol 的 API 接入信息
API 模型 ID 为 gpt-6.2-sol,可通过 Responses 和 Chat Completions 调用,函数调用与内置工具走 Responses 路径,两个端点都不接受 none 推理档位。官方短上下文 Standard 标价为输入 $2.00、输出 $10.00(USD / 百万 token,输出已包含推理 token),与 GPT-6.1 Sol 相同。
截至 2026 年 11 月 20 日,API易公开模型总表与定价接口均已列出 gpt-6.2-sol,标注 responses 与 chat 入口。短档计价与官方一致,实际可用分组、参数范围和出账以 API易 apiyi.com 当前配置及账单为准。
分析判断:GPT-6.2 Sol LifeVal 中“七分之一成本”与 Low 下滑怎样同时成立
先把比较对象和分母对齐
同一张图能读出“大幅进步”和“明显退步”两种印象,根本原因是比较对象和档位不同。下表的差值与比例均根据官方公示值计算。
| 比较组 | 双方数值 | 得分差 | 费用关系 |
|---|---|---|---|
| 6.2 Sol Max vs 上一代旗舰 GPT-6 Astra Max | 83.8%/$1.27 vs 79.8%/$9.04 | +4.0 个百分点 | 约 14.0%,即“约七分之一” |
| 6.2 Sol Max vs 6.1 Sol Max | 83.8%/$1.27 vs 79.5%/$1.27 | +4.3 个百分点 | 费用相同 |
| 6.2 Sol Low vs 6.1 Sol Low | 25.3%/$0.089 vs 66.8%/$0.52 | −41.5 个百分点 | 费用更低,但得分大幅下滑 |
| 6.2 Sol Medium vs 6.1 Sol Medium | 70.3%/$0.38 vs 75.5%/$0.73 | −5.2 个百分点 | 费用约为一半 |
| 6.2 Sol High vs 6.1 Sol Max | 80.8%/$0.65 vs 79.5%/$1.27 | +1.3 个百分点 | 约为一半 |
| 6.2 Sol Max vs 6.2 Astra Max | 83.8%/$1.27 vs 86.1%/$4.23 | −2.3 个百分点 | 约 30% |
这些数字中,“百分点”描述的是平均得分之差,“费用比例”描述的是平均单项费用之比,两者不能互相换算。“七分之一”只在“6.2 Sol Max 对 GPT-6 Astra Max”这一组里成立。如果换成同期的 GPT-6.2 Astra,Sol 在 Max 档反而低 2.3 个百分点。
💡 选型提示:同一模型、不同档位的差距可能大于不同模型之间的差距。建议先在 API易 apiyi.com 上用固定任务集跑一轮分档对比,再决定默认档位,不要直接沿用旧模型的档位配置。
Low 档的信号:升级不能“无脑替换”
6.2 Sol 的 Low 档在 LifeVal 中只有 25.3%,比 6.1 Sol Low 低 41.5 个百分点。官方发布资料提到 Sol 在若干任务上消耗的输出 token 更少,Low 档的平均单项费用也只有 $0.089。一个合理的推测是:在个性化多步骤任务上,低推理投入不足以覆盖偏好约束和工具操作。这只是推测,官方没有对 Low 档下滑给出解释。
对产品团队来说,影响很直接。如果你的应用此前在 6.1 Sol 上为了省钱使用 Low 档,直接切换模型 ID 而不调整档位,复杂日常任务的质量可能明显下降。相反,Max 档在相同单项费用下比上一代 Sol 高出 4.3 个百分点,说明新模型的上限确实提升了。
为什么 High 是本评测里值得优先测试的档
6.2 Sol 从 High 到 Xhigh 再到 Max,相邻提升分别只有 1.8 和 1.2 个百分点,平均单项费用却依次上涨 $0.23 和 $0.39。High 档以 $0.65 拿到 80.8%,已经高于 6.1 Sol 的 Max 档和 GPT-6 Astra 的 Max 档。仅就 LifeVal 而言,High 是“质量与成本较平衡”的起点。
不过,这一判断有三个前提:任务分布接近 LifeVal,语言与应用环境接近美国英语用户场景,成本结构接近该评测的输入输出比例。任何一点不满足,结论都可能改变。实践中更稳妥的做法是从 High 起步,再根据自有任务的达标率,决定是否下探到 Medium 或上调到 Xhigh、Max。
分析判断:用 LifeVal 思路验收你自己的 GPT-6.2 Sol 助理
构造一个低风险的家庭行程任务
LifeVal 最值得借鉴的不是分数本身,而是“按产物和状态验收”的方法。下面是一个家庭行程样例:预先给助理三条硬约束,分别是出发与目的地点、无障碍出行条件、预算上限,要求它交付带可核实路线的候选方案,以及一份可编辑的日程草稿。
| 评分项 | 核对方式 | 可否自动化 |
|---|---|---|
| 地点约束是否满足 | 方案中的起终点与输入一致 | 可自动核对 |
| 无障碍条件是否满足 | 路线说明明确覆盖无障碍要求 | 部分自动,需人工抽查 |
| 预算是否不超限 | 解析方案中的金额并与上限比较 | 可自动核对 |
| 链接能否支撑信息 | 链接可访问且内容与方案一致 | 需人工查看 |
| 日程草稿文件是否存在 | 检查输出文件或日历条目的前后状态 | 可自动核对 |
| 关键信息缺失时是否询问 | 故意省略日期等信息,看是否主动追问 | 需人工判断 |
这套评分项对应 LifeVal 的三路验收:交付物(日程草稿)、状态变化(文件或条目是否真的写入),以及回答质量(约束满足与主动追问)。用同一批任务分别跑 Low、Medium、High,再结合达标率和费用决定初始档位。
极简示例:调用 GPT-6.2 Sol 并记录推理用量
下面的示例通过 Responses 接口调用 gpt-6.2-sol,同时读取输出 token 与其中的推理 token,方便后续核算单项成本。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
查看分档对比脚本(Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 即可对比多个档位
)

# 短上下文 Standard 标价,USD / 百万 token(输出已含推理 token)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # 故意缺少日期,检验是否主动追问
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """按评分细则逐项打分,返回 0~1 的得分"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
脚本中的自动检查只覆盖“可机器核对”的评分项,链接真实性和追问质量仍需人工抽查。推理档位的参数取值(尤其是 Xhigh、Max 对应的字符串)请以官方当前文档和所用渠道的参数说明为准。
🚀 快速开始:通过 API易 apiyi.com 注册即可获得免费测试额度。平台提供 OpenAI 兼容接口,上面的脚本只需替换 Key 就能跑通,适合在正式选档前先做一轮小样本验收。
GPT-6.2 Sol LifeVal 结论的迁移边界
把 LifeVal 的结论迁到自己的产品,至少要考虑三处差异。第一是语言与地区:论文样本以美国英语用户为主,中文场景下的地图、支付、日历应用生态完全不同。第二是环境:LifeVal 在受控环境和缓存网页里运行,真实产品会遇到网络波动、工具授权失败和账户状态差异。第三是成本结构:官方单项费用对应的是该评测的输入输出比例,长上下文请求超过 272K 输入后会整体切到更高费率,单项成本可能与图表差距很大。
因此,比较合理的使用方式是:把官方图表当作“缩小候选范围”的依据,把自有任务集当作“最终决策”的依据。对于复杂日常助理,可以先用 High 档建立基线,再分别测试 Medium 是否能守住关键硬约束、Xhigh 或 Max 能否明显减少人工返工,用实际达标率和账单说话。
当你的任务集、评分细则和环境检查都准备好之后,模型升级就不再是“看榜单换模型”,而是每次都能复测的工程流程。需要在多个模型和档位之间反复对比时,可以借助 API易 apiyi.com 的统一接口,把 GPT-6.2 Sol、GPT-6.2 Astra 等放进同一套验收脚本里运行。
参考资料
-
OpenAI GPT-6.2 Astra 与 Sol 发布公告(含 LifeVal 分档图表)
- 链接:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - 说明: 2026-11-17 发布,本文分档数据来源
- 链接:
-
LifeVal 研究页与论文
- 链接:
openai.com/index/lifeval、cdn.openai.com/pdf/lifeval.pdf - 说明: 任务来源、评分方式与限制说明(论文 §3–§5)
- 链接:
-
GPT-6.2 Sol 模型卡与官方定价
- 链接:
developers.openai.com/api/docs/models/gpt-6.2-sol - 说明: 上下文规格、长短上下文计费规则与限额
- 链接:
-
API易 模型总表
- 链接:
docs.apiyi.com/models.md - 说明: 公开挂牌模型、入口与计价信息
- 链接:
作者: API易 技术团队
技术交流: 欢迎在 API易 官网 apiyi.com 联系我们,更多接入资料可访问 docs.apiyi.com 文档中心