作者注:以客服质检请求为例,拆解 GPT-6.2 Sol 在 Responses API 中的输出验收、会话状态保持和后台结果回收。
结论先行:把 GPT-6.2 Sol 接进生产系统,需要把同一个业务任务拆成四种行为,并分别定义验收标准。这四种行为是界面即时反馈、机器可入库结果、跨轮上下文和最终状态。流式事件只负责显示,入库前必须拿到完整响应并通过 Schema 和业务校验。跨轮信息要先确定由谁持有状态。后台任务只认响应 ID 和终态,通知可能重复,写入必须幂等。
做到这四点的前提有两个。第一,需要内置或自定义工具时,按 GPT-6.2 迁移说明走 Responses API,本文也只讨论 Responses 的运行行为。第二,如果经由聚合平台调用,后台模式、Webhook 等能力是否开放,以平台当前配置为准。在 API易 apiyi.com 上,gpt-6.2-sol 已公开挂牌 responses 与 chat 两个入口。
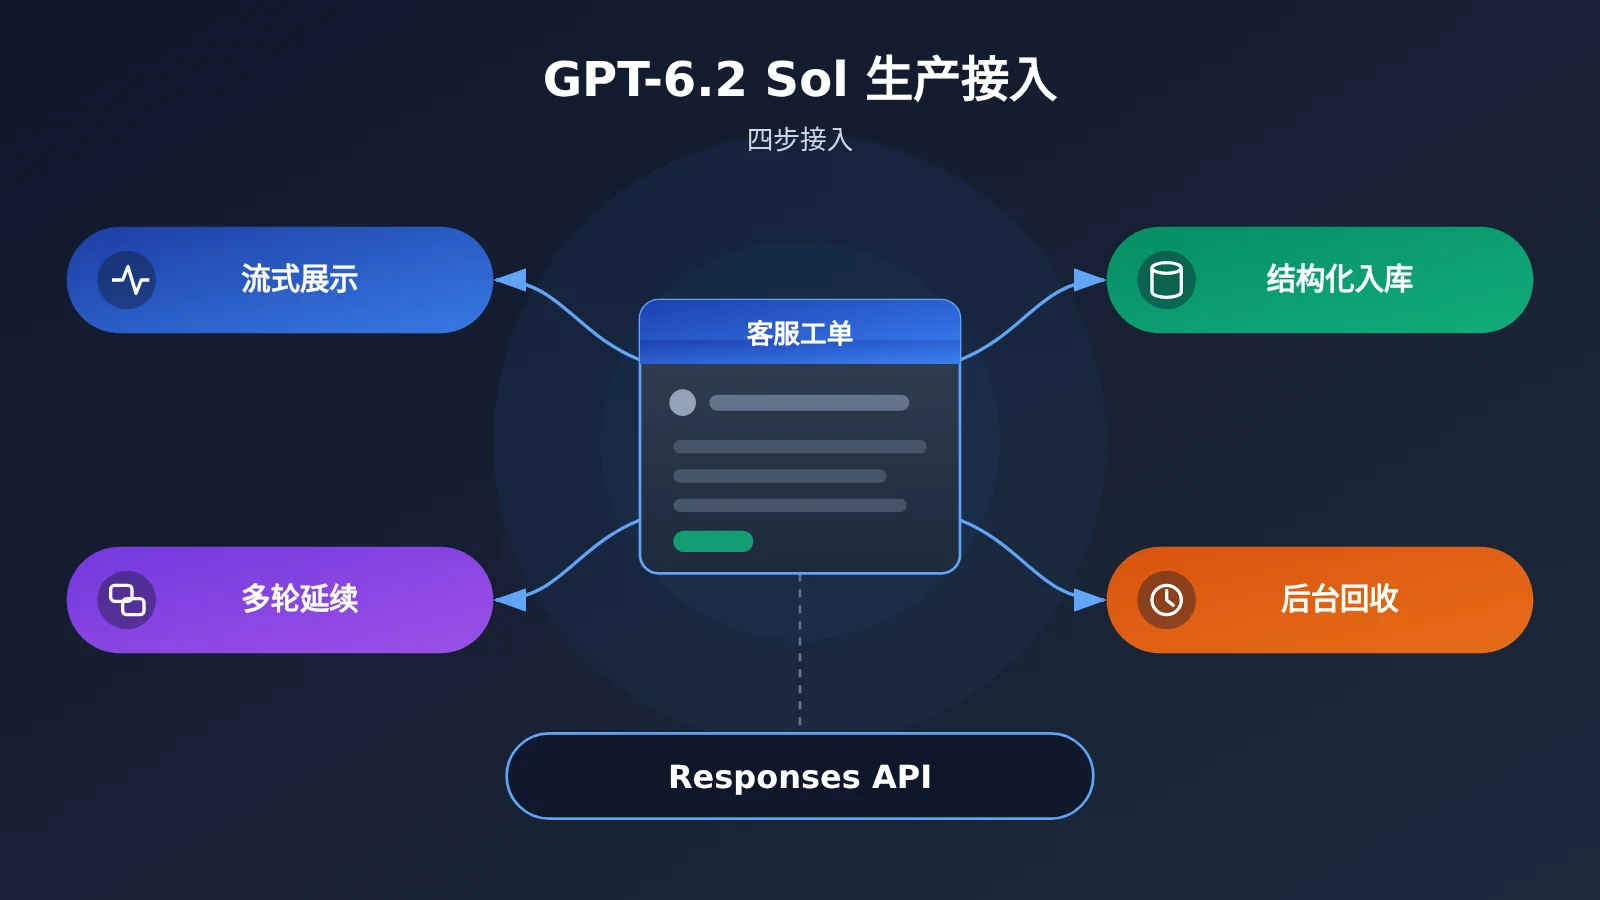
GPT-6.2 Sol 生产接入知识地图
整篇文章围绕一条流程展开:发起请求 → 展示 → 延续 → 回读 → 验收。下面的流程图标注了每一步的产物和对应的正文编号。
发起请求(model=gpt-6.2-sol,Responses API)
  │
  ├─▶ 展示【第 1 节】
  │     增量事件 → 页面实时显示质检意见
  │     终态事件 → 结束加载;完整响应 → Schema + 业务校验 → 入库 / 人工复核
  │
  ├─▶ 延续【第 2 节】
  │     自管历史 / previous_response_id / Conversation
  │     常驻规则(developer) 与 当轮指令(instructions) 分离
  │
  ├─▶ 回读【第 3 节】
  │     background 提交 → 保存响应 ID → Webhook 验签去重 → 按 ID 回读 → 保存终态
  │
  └─▶ 验收【第 4 节】
        成功 / 不完整 / 重复通知 / 客户端掉线 / Schema 变更
GPT-6.2 Sol 接入索引
| 章节 | 回答的问题 | 为后文提供什么 | 读完能做到 |
|---|---|---|---|
| 1. 流式与结构化 | 页面怎么看流,机器怎么收结果 | 定义“完成”和“可入库”的判定 | 区分显示路径与入库路径 |
| 2. 多轮状态 | 下一轮请求如何接上上一轮 | 确定状态持有方和留存条件 | 只改当轮焦点,不破坏前缀 |
| 3. 后台任务 | 用户离开页面后结果怎么落库 | 响应 ID、任务 ID 与终态的对应关系 | 实现验签、去重、幂等写入 |
| 4. 上线验收 | 哪些行为必须提前验证 | 汇总前三节的判定条件 | 产出可追溯的回归记录 |
第 1 到 3 节分别对应一条运行路径。如果你只做其中一条,可以按需查阅。第 4 节依赖前三节定义的状态,适合最后阅读。
GPT-6.2 Sol 相关术语 To Know
| 术语 | 解释 |
|---|---|
| SSE | 服务端通过一条 HTTP 连接,按顺序向客户端推送事件的协议。 |
| Structured Outputs | 要求成功返回的结构化内容符合受支持 JSON Schema 的 API 功能。 |
| 拒绝响应 | 模型明确拒绝完成任务时返回的内容项,需要走单独流程。 |
| 会话状态 | 为后续请求保留的消息、工具结果等上下文。 |
| 加密推理项 | 用来延续推理状态的加密响应项,可以随上下文回传。 |
| 前缀 | 当前请求开头部分中,与上一轮完全相同的上下文序列。 |
| 完成窗口 | 服务接受后台请求后,为这次响应设定的目标完成时间范围。 |
| Webhook | 服务端向应用指定 URL 主动发送的带签名通知。 |
| 终态 | 任务已完成、失败、不完整或被取消之后的最终状态。 |
| 幂等 | 同一个回调或任务被重复处理,只产生一次业务效果。 |
1. GPT-6.2 Sol 流式输出与结构化验收
1.1 GPT-6.2 Sol 的两条输出路径
先看一个客服质检场景。值班坐席打开一条工单,页面需要立刻显示模型给出的督查意见。同一次分析的结果还要写进质检库,供日终统计使用。这两个需求对“完成”的定义不同,所以要分成两条路径处理。
| 路径 | 消费者 | 依赖的信号 | 判定“完成”的条件 | 失败时去向 |
|---|---|---|---|---|
| 展示路径 | 坐席页面 | response.output_text.delta 增量事件 |
收到 response.completed 或失败类终态事件 |
页面提示,保留已显示内容 |
| 入库路径 | 质检数据库 | 完整响应对象 | Schema 校验和业务校验都通过 | 拒绝、不完整、格式错误分别进入人工复核 |
流式请求设置 stream=true 后,服务端会通过 HTTP SSE 依次推送事件。页面只需要把 response.output_text.delta 中的文字追加显示。加载状态则要等终态事件来结束,文字停止输出并不代表任务完成。
1.2 GPT-6.2 Sol 流式显示示例
下面的示例只负责展示。它把增量文字交给前端,并在终态时结束等待:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容入口
)

stream = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "你是客服质检督查员,只依据工单原文给出意见。"},
        {"role": "user", "content": "工单 #A1024:客户三次催单未获回复……"},
    ],
    stream=True,
)

for event in stream:
    if event.type == "response.output_text.delta":
        push_to_page(event.delta)          # 页面实时追加
    elif event.type == "response.completed":
        finish_loading(event.response.id)  # 以终态结束加载
    elif event.type in ("response.failed", "response.incomplete"):
        show_error(event.type)             # 失败与不完整分开提示
push_to_page、finish_loading 等是业务侧函数。终态事件的完整列表,以官方流式响应文档为准。
1.3 GPT-6.2 Sol 结构化输出的验收顺序
在 Responses API 中,结构化输出在 text.format 里声明,不放在消息里。入库路径拿到完整响应后,按下面的顺序判定:
- 检查响应状态。不完整响应(
status为 incomplete)直接进入人工复核,不尝试解析半截 JSON。 - 检查内容项。如果出现拒绝类型的内容项,走拒绝流程,不当作格式错误处理。
- 解析 JSON 并做 Schema 校验。
- 做业务校验:原工单存在,缺项要明确可见,不能被静默补齐。
查看 GPT-6.2 Sol 结构化入库完整代码
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

QA_SCHEMA = {
    "type": "object",
    "properties": {
        "ticket_id": {"type": "string"},
        "verdict": {"type": "string", "enum": ["合格", "需整改", "信息不足"]},
        "issues": {"type": "array", "items": {"type": "string"}},
        "missing_fields": {"type": "array", "items": {"type": "string"}},
    },
    "required": ["ticket_id", "verdict", "issues", "missing_fields"],
    "additionalProperties": False,
}

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[{"role": "user", "content": "请质检工单 #A1024:……"}],
    text={"format": {"type": "json_schema", "name": "qa_result",
                     "schema": QA_SCHEMA, "strict": True}},
)

def route(resp):
    if resp.status == "incomplete":
        return ("manual_review", "incomplete", resp.incomplete_details)
    for item in resp.output:
        for part in getattr(item, "content", []) or []:
            if part.type == "refusal":
                return ("manual_review", "refusal", part.refusal)
    try:
        data = json.loads(resp.output_text)
    except json.JSONDecodeError:
        return ("manual_review", "bad_json", None)
    if not ticket_exists(data["ticket_id"]):
        return ("manual_review", "unknown_ticket", data)
    return ("save", "ok", data)

print(route(resp), resp.id)
注意,Schema 校验通过只说明结构正确,不说明内容正确。工单号是否存在、缺项是否如实标出,这些检查都要放在业务层完成。
🎯 技术建议:在测试环境中,可以通过 API易 apiyi.com 同时发起流式和非流式两种请求,比较同一工单在两条路径上的终态与入库结果。这样能提前确认前端加载逻辑和入库分支互不干扰。
2. GPT-6.2 Sol 多轮会话状态延续
2.1 GPT-6.2 Sol 三条状态路径对比
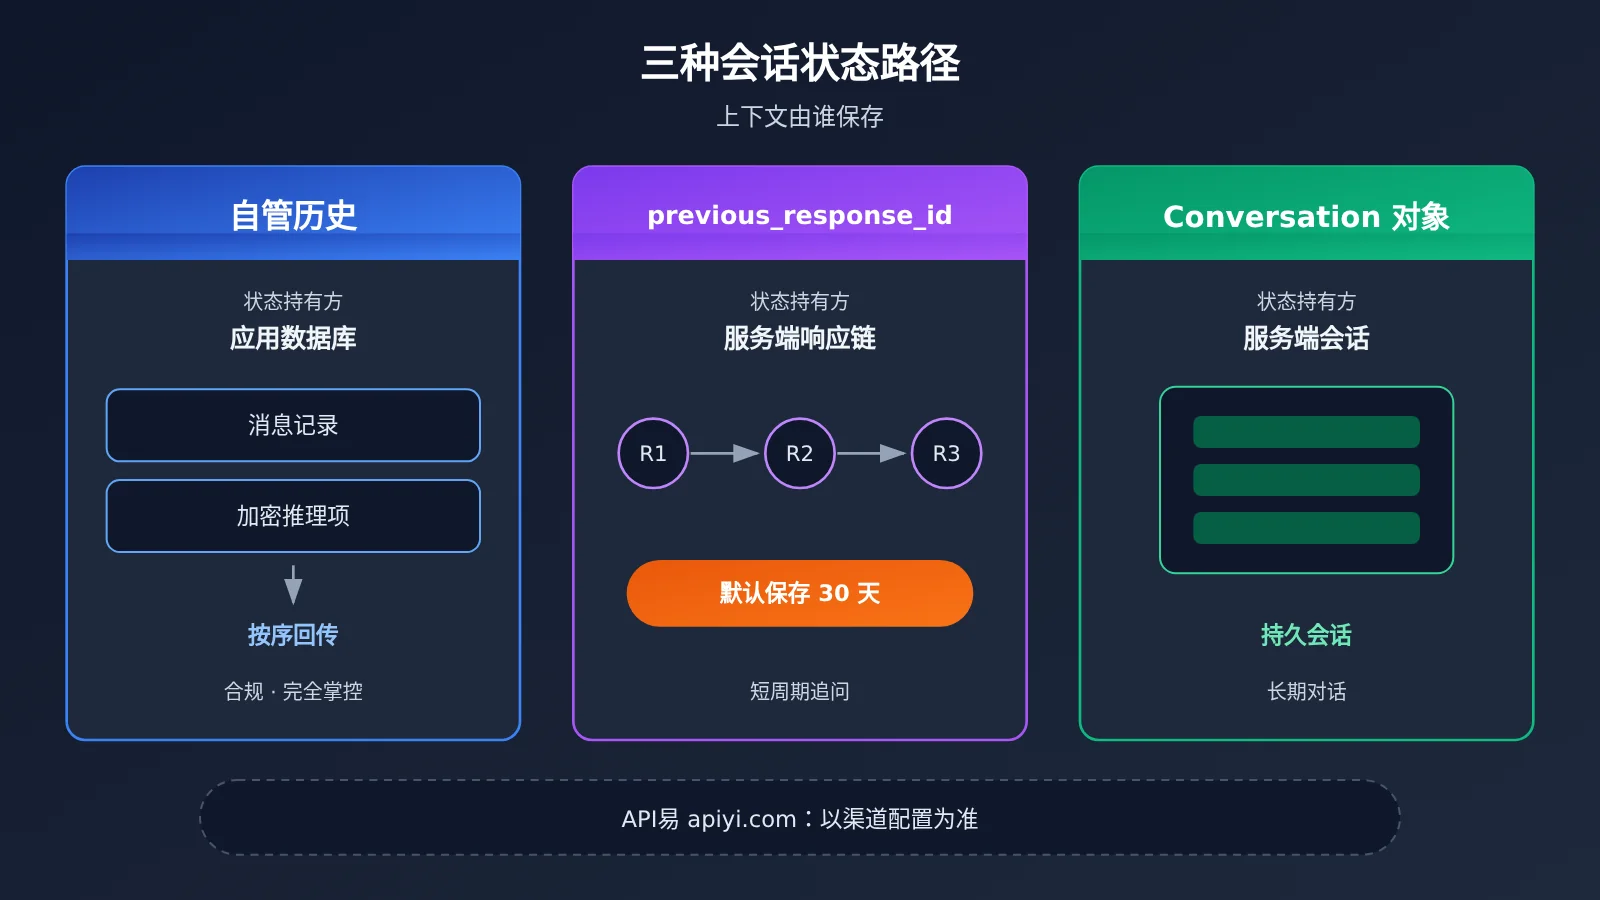
坐席在同一条工单上补充了新事实,希望模型接着上一轮继续分析。这时首先要回答的问题是:上下文由谁保存。
| 路径 | 状态持有方 | 留存条件 | 适合场景 | 可用平台 |
|---|---|---|---|---|
| 自管历史 | 应用自己 | 由应用决定;需按原顺序回传消息及必要的响应项 | 有合规要求,或需要完全掌控上下文 | 官方 API、API易 apiyi.com |
previous_response_id |
服务端响应链 | 响应仍可用时才能续接;响应对象默认保存 30 天 | 短周期的连续追问 | 以当前渠道配置为准 |
| Conversation 对象 | 服务端会话对象 | 附在 Conversation 上的条目按该对象的留存规则处理 | 需要更持久保存的对话 | 以当前渠道配置为准 |
如果选择自管历史,同时又希望推理能够连续,就不能只回传文字。必要的响应项都要保留并按顺序回放,其中包括加密推理项。
2.2 GPT-6.2 Sol 只改审核焦点的写法
假设第二轮只想把审核焦点从“响应时效”改为“话术合规”。正确做法是:通用质检规则放在链上第一条 developer 消息里,本轮专用的焦点写在顶层 instructions 中。instructions 只对提供它的那次请求生效,不会污染后续轮次。
first = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "通用质检规则:依据工单原文;缺项必须列出……"},
        {"role": "user", "content": "质检工单 #A1024,关注响应时效。"},
    ],
)

second = client.responses.create(
    model="gpt-6.2-sol",
    previous_response_id=first.id,
    instructions="本轮只审查话术合规,不重复时效结论。",  # 仅作用于本次请求
    input=[{"role": "user", "content": "补充:坐席第二次回复使用了模板话术。"}],
)
这样写还有一个好处:首条规则保持不变,前缀也保持稳定。
2.3 GPT-6.2 Sol 的前缀变更风险
GPT-6.2 在几种情况下可能清除相关推理项:改写旧历史、做部分模型切换(例如降级),以及切换用户或组织。对于需要延续的 Standard 单代理会话,如果要调整推理档或输出 Schema,应追加一条适用的 configuration_update 项,而不是回头修改旧配置。该项的具体字段,以 GPT-6.2 迁移指南为准。
长期规则需要更新时,在上下文末尾追加一条新的 developer 消息,不去编辑旧规则,也不改动先前的工具和 Schema 配置。即使前缀保持稳定,缓存能否命中仍取决于具体请求和处理条件,不能把它当作必然结果。
3. GPT-6.2 Sol 后台任务落库
3.1 GPT-6.2 Sol 后台提交与完成窗口
日终待审的工单摘要可能耗时较长,坐席也不会一直守在页面上。这类任务用 background: true 提交。提交后立即持久保存返回的响应 ID,并把它和业务任务 ID 一一对应起来。
完成窗口按可接受的等待时间来选,默认值是 soonest。2h 和 8h 是 Standard 下的折扣窗口,目前属于公开测试功能,而且提交时不能启用流式。完成窗口的参数名和存储要求,以后台模式文档为准。
| 完成窗口 | 定位 | 流式 | 适合的质检任务 |
|---|---|---|---|
soonest(默认) |
尽快完成 | 按后台模式文档 | 当班需要回看的复核 |
2h |
Standard 折扣窗口,公开测试 | 不启用 | 班后汇总 |
8h |
Standard 折扣窗口,公开测试 | 不启用 | 日终批量摘要 |
3.2 GPT-6.2 Sol Webhook 验签、去重与回读
任务处于排队或进行中时,持续查询同一个 ID 即可。如果收到完成事件,按下面的顺序处理:
- 验证签名。验签失败直接丢弃。
- 用
webhook-id去重。同一通知可能会被重投。 - 按
event.data.id回读完整响应。通知本身不作为结果使用。 - 按任务 ID 幂等写入终态和结果。
查看 GPT-6.2 Sol 后台任务回收代码
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 提交
job = client.responses.create(
    model="gpt-6.2-sol",
    background=True,
    input=[{"role": "user", "content": "汇总今日待审工单摘要:……"}],
)
db.save_task(task_id="QA-20261120-01", response_id=job.id, status=job.status)

# Webhook 处理
def on_webhook(headers, raw_body):
    event = verify_and_parse(headers, raw_body)        # 验签,失败则抛出
    if db.seen_webhook(headers["webhook-id"]):         # 去重
        return 200
    db.mark_webhook(headers["webhook-id"])
    resp = client.responses.retrieve(event.data.id)    # 回读完整响应
    task_id = db.task_by_response(resp.id)
    db.upsert_result(task_id, status=resp.status,      # 按任务 ID 幂等写入
                     body=resp.output_text if resp.status == "completed" else None)
    return 200
用户关闭页面后再回来时,前端只需要拿业务任务 ID 查询本地库。如果状态还没到终态,就由服务端用已保存的响应 ID 继续查询。
需要特别注意数据留存。后台模式为了支持回读,会暂存响应数据。即使设置了 store: false,或者组织启用了 ZDR,这一点也不变,所以要对照数据控制文档确认是否可以接受。
💡 接入建议:Webhook 回调地址和后台模式需要渠道端支持。通过 API易 apiyi.com 接入前,建议先确认当前账户分组是否开放后台模式和回调能力。如果暂未开放,可以先用响应 ID 轮询的方式跑通状态机。
4. GPT-6.2 Sol 上线验收清单
4.1 GPT-6.2 Sol 合成验收表
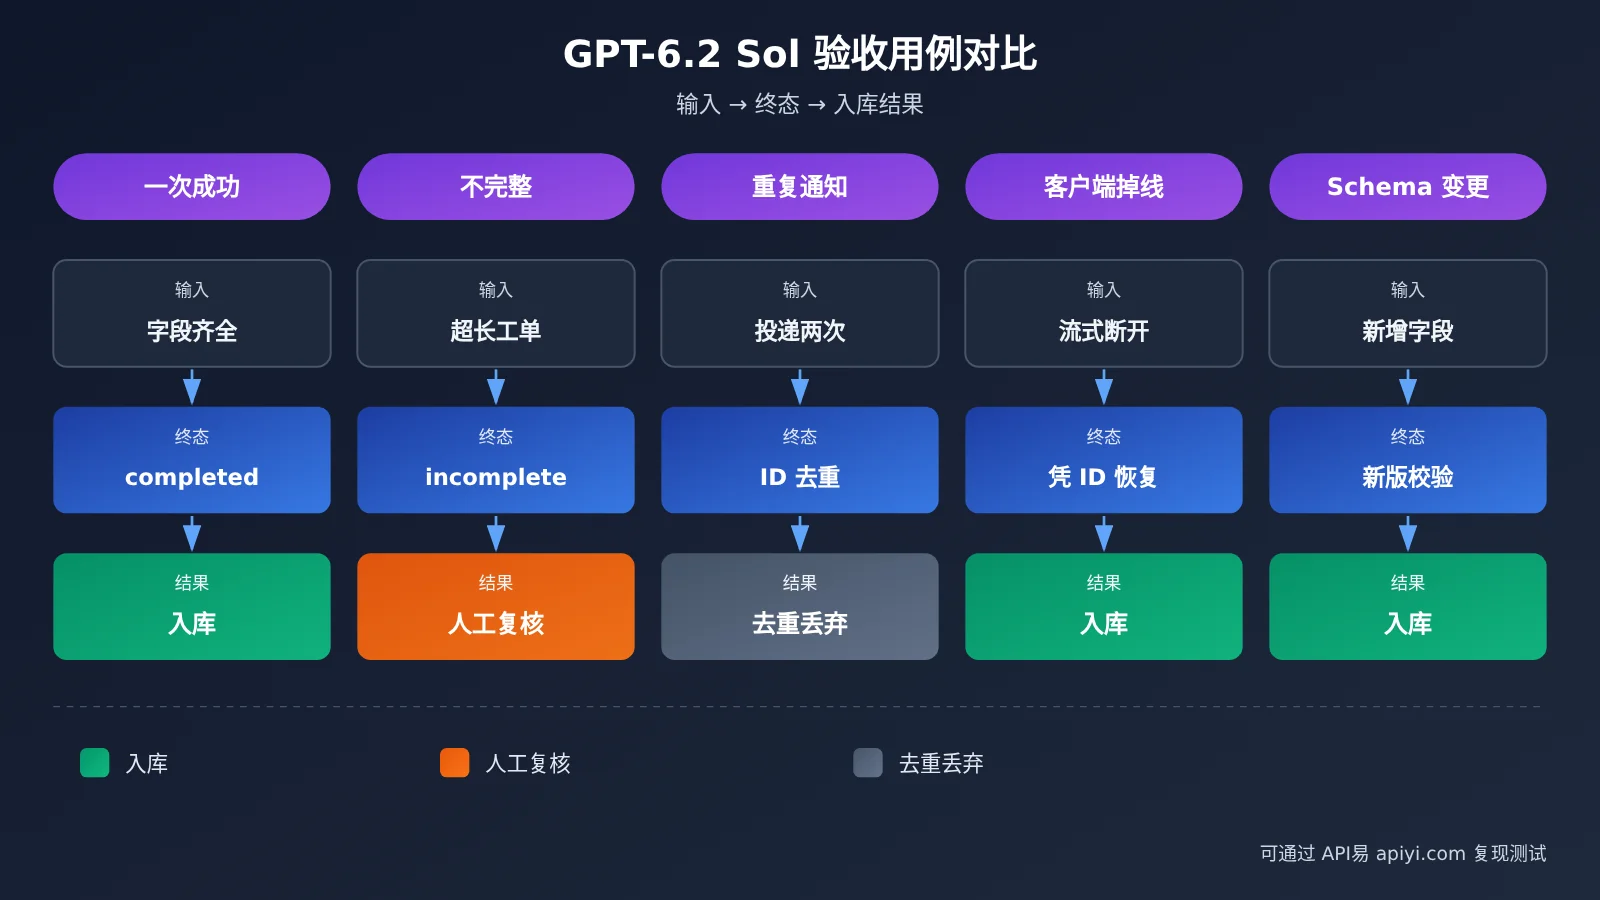
下面的验收表沿用客服质检这一合成案例,把前三节的判定条件逐条落实为可执行用例。
| 用例 | 输入条件 | 预期状态或结果 |
|---|---|---|
| 一次成功 | 真实存在的工单,字段齐全 | 终态 completed;Schema 和业务校验通过;按任务 ID 写入一条结果 |
| 一次不完整响应 | 人为压低输出上限,或使用超长工单 | 状态 incomplete;不解析 JSON;进入人工复核并记录原因 |
| 一次重复通知 | 同一 webhook-id 投递两次 |
第二次被去重;结果表只有一条记录 |
| 一次客户端掉线 | 流式过程中断开浏览器连接 | 通过已存的响应 ID 恢复状态;入库结果不受页面影响 |
| 一次更改 Schema | 会话中途新增一个必填字段 | 通过追加配置更新完成调整,不改写旧配置;新结果按新 Schema 校验 |
每条用例都要保存四项信息:调用的模型 ID(gpt-6.2-sol)、运行参数、响应 ID,以及应用侧配置版本。出现问题时,可以凭这四项定位到具体的哪一次请求。
4.2 GPT-6.2 Sol 回归时的口径
| 项目 | 记录内容 | 说明 |
|---|---|---|
| 模型 | gpt-6.2-sol |
引用模型卡公开 ID |
| 端点 | Responses | 函数调用与内置工具走此路径 |
| 推理档 | 实际使用的档位 | Responses 与 Chat Completions 都不接受 none |
| 用量 | usage.output_tokens 和其中的推理 token 子项 |
输出计费已包含推理 token |
| 计费切档 | 单次请求输入是否超过 272K | API易公开定价接口以 272,000 输入 token 切档,实际出账以账单为准 |
迁移旧系统时,端点、请求参数、多轮输入、推理上下文和缓存这几项要分别核对。核对完成后,用同一批用例同时回归示例请求和生产请求。
🚀 验收建议:五类用例可以写进 CI,每次修改 Schema 或切换渠道时自动跑一遍。借助 API易 apiyi.com 的统一 Key,可以在同一套用例上对比不同分组的行为差异。
验收表中的五条用例全部通过、每条都能凭响应 ID 回溯,就说明这条质检链路已经具备上线条件。
参考资料
- GPT-6.2 Sol 模型卡:模型 ID、上下文与计费规则
- 链接:
developers.openai.com/api/docs/models/gpt-6.2-sol
- 链接:
- GPT-6.2 迁移指南:端点选择、前缀变更与配置更新
- 链接:
developers.openai.com/api/docs/guides/latest-model
- 链接:
- 流式响应与结构化输出:SSE 事件与
text.format- 链接:
developers.openai.com/api/docs/guides/streaming-responses
- 链接:
- 会话状态:
previous_response_id与 Conversations- 链接:
developers.openai.com/api/docs/guides/conversation-state
- 链接:
- 后台模式与 Webhook:完成窗口、验签与去重
- 链接:
developers.openai.com/api/docs/guides/background
- 链接:
作者:API易 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心