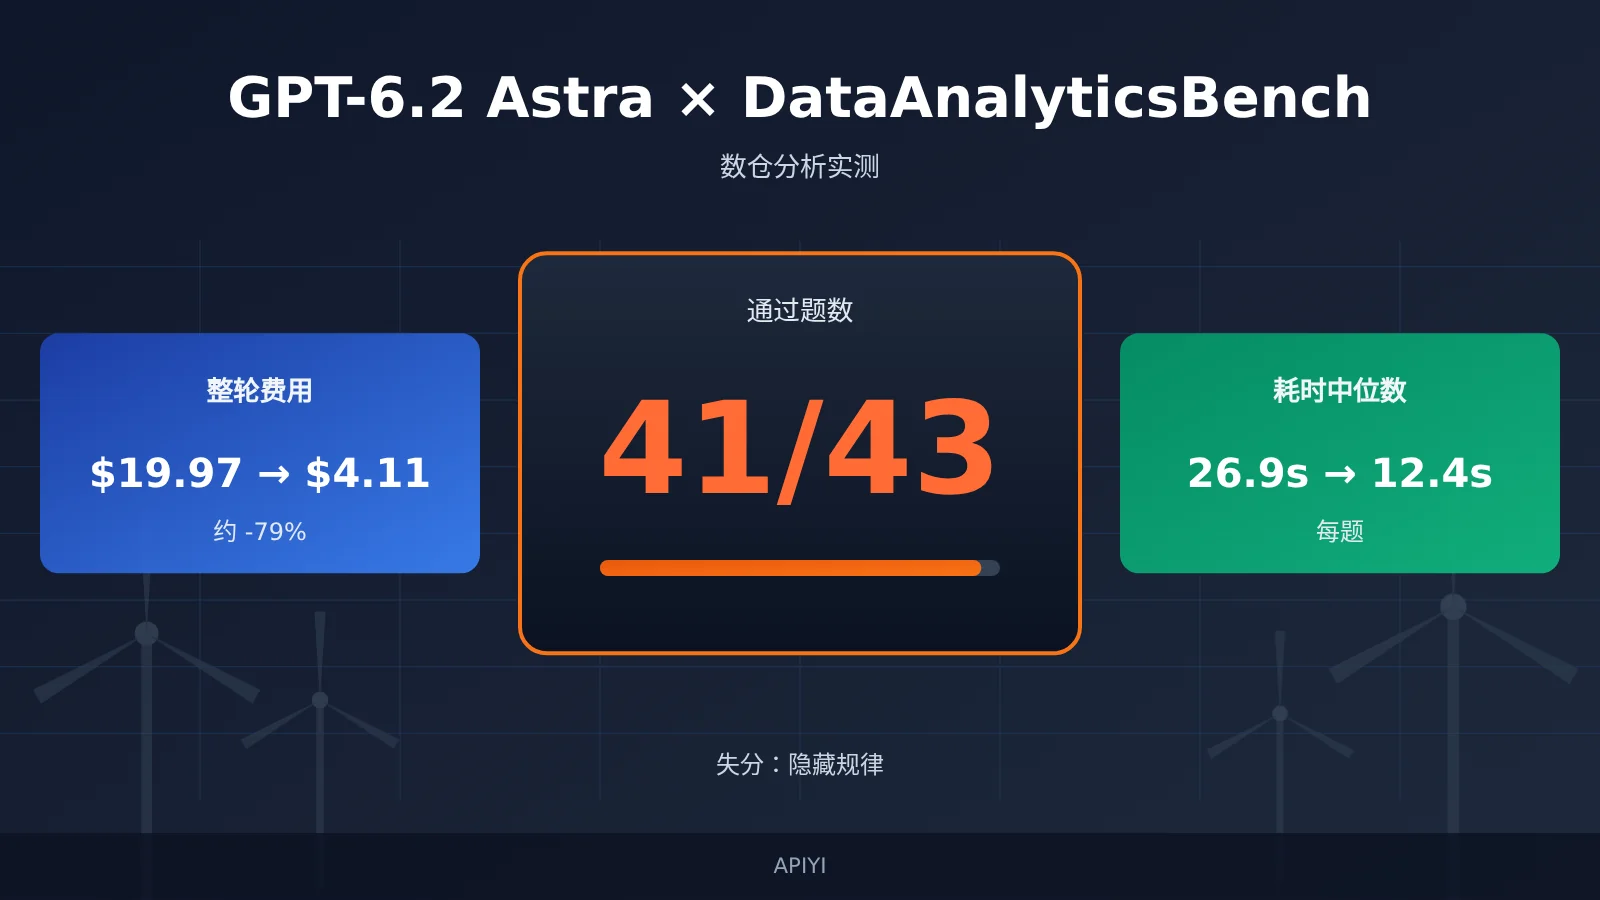
核心结论:在 Plotly 的 DataAnalyticsBench 实测中,GPT-6.2 Astra 的 43 道数据分析题通过 41 道。前代 GPT-6 Astra 的成绩是 43/43。两道失分都出在“隐藏规律”这一类题,其余五类题全部通过。与此同时,整轮费用从 $19.97 降到 $4.11,每题耗时中位数从 26.9 秒缩短到 12.4 秒。新一代 Astra 用两道题的代价换来了不到前代四分之一的花费和不到一半的等待时间,但它在主动追查异常方面是否真的退步,目前只有一轮数据,还需要用自己的数据复测。
您读完此文能了解到什么?
- DataAnalyticsBench 测什么、怎么判分,41/43 这个分数的边界在哪里。
- 六类题的逐项得分,以及两道失分题分别是怎么失败的。
- 费用下降约 79% 的两个来源:费率下调和工作量减少,各自贡献多少。
- GPT-6.2 Astra 与 GPT-6 Astra、GPT-6.1 Sol、GPT-6.2 Sol 在得分、费用、延迟上的取舍。
- 一套可直接改造的复测方法和 Python 代码,用来在自己的数仓上验证结论。
索引:To Know 表格解释评测里的专有概念,影响速览按人群概括这条新闻的意义。“客观事实”部分依次交代测试环境与判分规则、六类题得分、费用与耗时数据,以及 OpenAI 官方的模型身份和价格口径。“分析判断”部分解读 41/43 的含义,提出隐藏规律题失分的解释假设,拆解费用下降的来源,并给出选型建议和复测代码。
GPT-6.2 Astra DataAnalyticsBench 需要先知道的概念
| 概念 | 简要解释 |
|---|---|
| DataAnalyticsBench | Plotly 与 Mila 研究者设计的 43 道数仓分析题,在模拟风电运营数据上考查模型的分析能力 |
| 测试运行环境 | 为每个模型提供相同数仓,以及查询、画图、展示表格等只读工具的测评系统 |
| 评分规则 | 逐题规定什么样的回答算充分满足题意,只判通过或不通过,不给部分分 |
| 数据质量问题 | 缺失、重复、异常记录等会影响分析结论的输入问题,题中有刻意植入 |
| 统计陷阱 | 直观算法或汇总方式可能把人引向错误结论的题目 |
| 隐藏规律 | 题干没有点明、需要模型主动追查的异常模式或原因 |
| 每题耗时中位数 | 把 43 道题的实际经过时间排序后取中间值,本榜包含工具查询耗时 |
| 整轮费用 | 同一模型完成全部 43 道题的累计调用费用 |
| 缓存命中 | 重复的输入前缀被服务端缓存后,以更低单价计费的那部分输入 token |
GPT-6.2 Astra DataAnalyticsBench 评分对不同人群的影响速览
- API 选型者:GPT-6.2 Astra 的单位成本和响应速度明显改善,常规报表、口径澄清这类任务可以优先考虑。异常排查类任务暂时不宜直接照搬榜单结论。
- 数据产品开发者:做“自然语言问数”、BI 助手这类产品时,延迟中位数减半对交互体验影响很大。不过要单独评估模型在多轮探索上的“耐心”,必要时在提示词或工作流里强制追加检查步骤。
- 分析团队:可以把模型当成更快的初稿分析员,但根因调查类结论仍需要人工复核。用 API易 apiyi.com 这类 OpenAI 兼容的聚合接口,可以在同一套代码里切换四个模型做对照测试。
GPT-6.2 Astra DataAnalyticsBench 客观事实
GPT-6.2 Astra 测试场景与判分规则
DataAnalyticsBench 由 Plotly 与 Mila 研究者设计,使用一个模拟的风电运营数仓。数仓包含 44 张表、约 1,990 万行和 554 列,涵盖设备遥测、告警、工单、检查和天气等数据。每道题在 Plotly Studio Embedded 中运行,经 OpenRouter 调用模型。模型能用的工具只有四种只读工具:列出数据集、执行 SQL、画图、展示表格。
模型自行决定查询路径和作答时机,测试方不会替它规划步骤。这意味着评测考的不只是写 SQL,还包括“查到哪一步才够”的判断。
判分方面,评测逐题按答案键和评分规则判定是否通过,没有部分分。裁判模型为 Claude Sonnet 5,温度设为 0。主办方用 SQL、pandas 和 Polars 三种方式独立生成答案并交叉校验,人工审核失败轨迹,也审查满分结果。两类特殊题有明确的过关条件:
- 歧义题:模型通过澄清,或者交代假设并给出替代解法,即可过关。
- 数据不可回答的题:准确指出现有数据的限制即可过关。
题库也有明确边界:单一业务域(风电运营)、英文、同一测试环境,每个模型只跑一轮。题目、数据和答案键由主办方保留,不对外公开。
来源:Plotly,Introducing DataAnalyticsBench,2026-10-14 发布,2026-11-19 更新,plotly.com/blog/introducing-dataanalyticsbench/
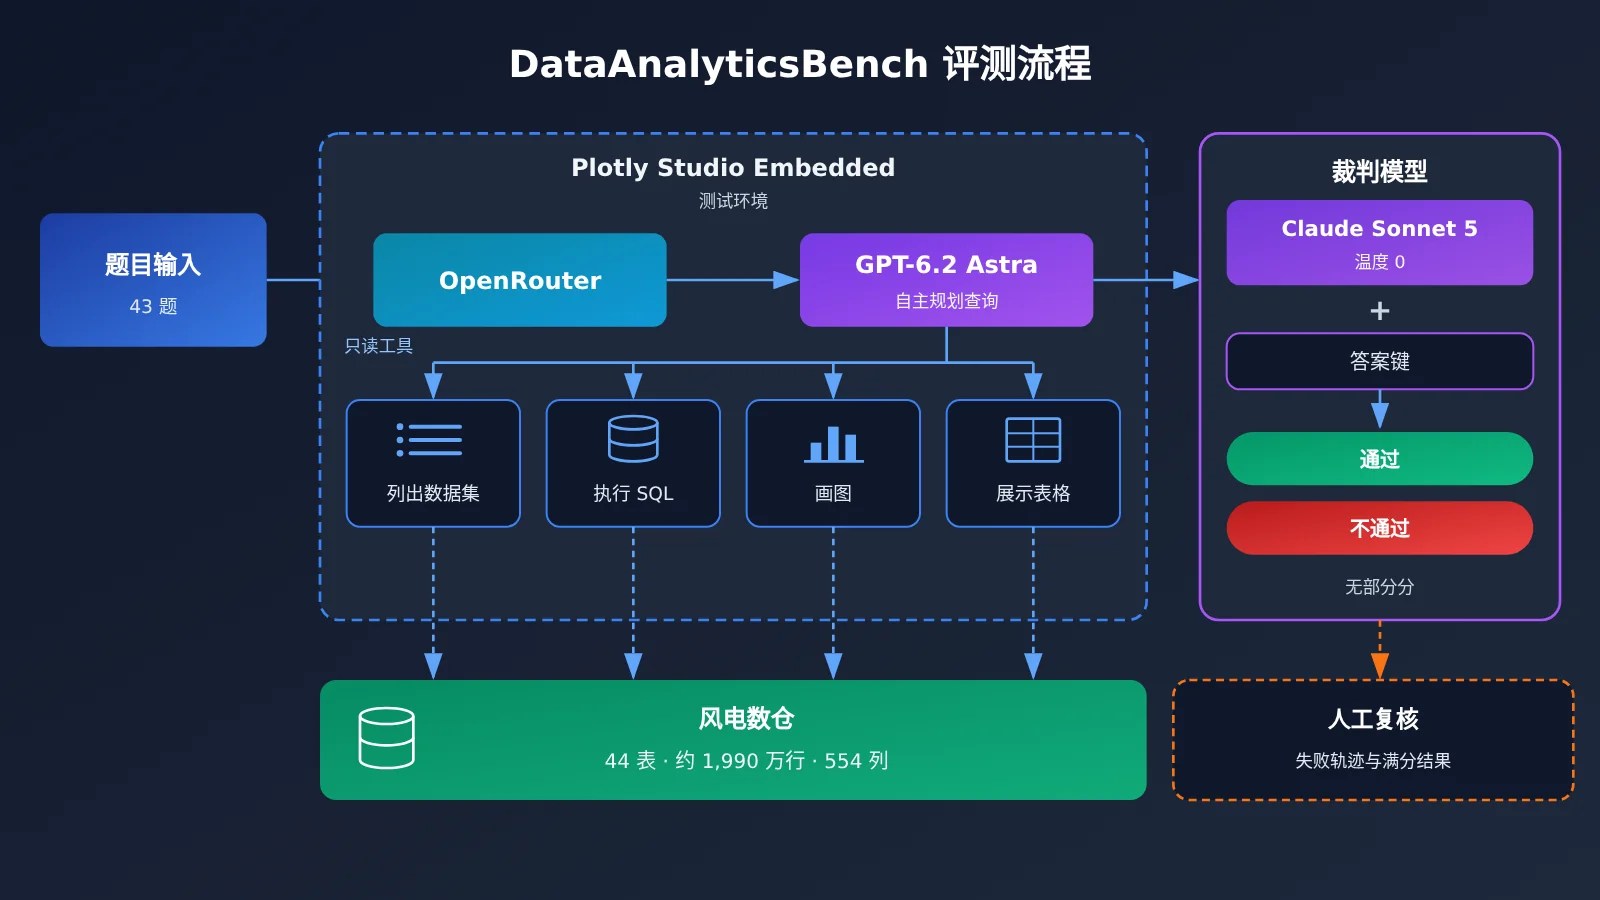
图示说明:这套“模型自主规划查询 + 只读工具 + 逐题判通过”的结构,可以在自己的环境里用 API易 apiyi.com 的 OpenAI 兼容接口近似复现,做内部对照测试。
GPT-6.2 Astra 六类题得分:失分集中在隐藏规律
Plotly 在 2026 年 11 月 17 日发布的 Astra 专项报告给出了分类得分:
| 题类 | GPT-6.2 Astra | GPT-6 Astra | 考查点 |
|---|---|---|---|
| 常规分析 | 20/20 | 20/20 | 多步 SQL、表连接和时间区间 |
| 歧义判断 | 5/5 | 5/5 | 澄清口径或说明合理假设 |
| 数据不可回答 | 5/5 | 5/5 | 依据现有数据识别不可回答的问题 |
| 数据质量 | 3/3 | 3/3 | 识别植入的质量问题 |
| 统计陷阱 | 5/5 | 5/5 | 识别直观算法可能造成的误导 |
| 隐藏规律 | 3/5 | 5/5 | 主动追查没有点明的异常规律 |
| 总计 | 41/43 | 43/43 | 各题等权,逐题判通过 |
前五类题合计 38/38,两代表现完全一致。差距全部来自隐藏规律题:新一代 3/5,前代 5/5。
两道失分题都经过 Plotly 人工复核,失败方式不同:
- 一道题中,模型始终没有定位到植入的规律。
- 另一道题中,模型找到了应该调查的位置,却把真正的原因排除了。
报告还给出一个过程数据:在隐藏规律题上,GPT-6.2 Astra 平均每题执行约 9 次数据库查询,GPT-6 Astra 约 15 次。
来源:Plotly,GPT-6.2 Astra Benchmark Results for Data Analysis,2026-11-17,plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
GPT-6.2 Astra 费用与耗时:两代与同厂对照
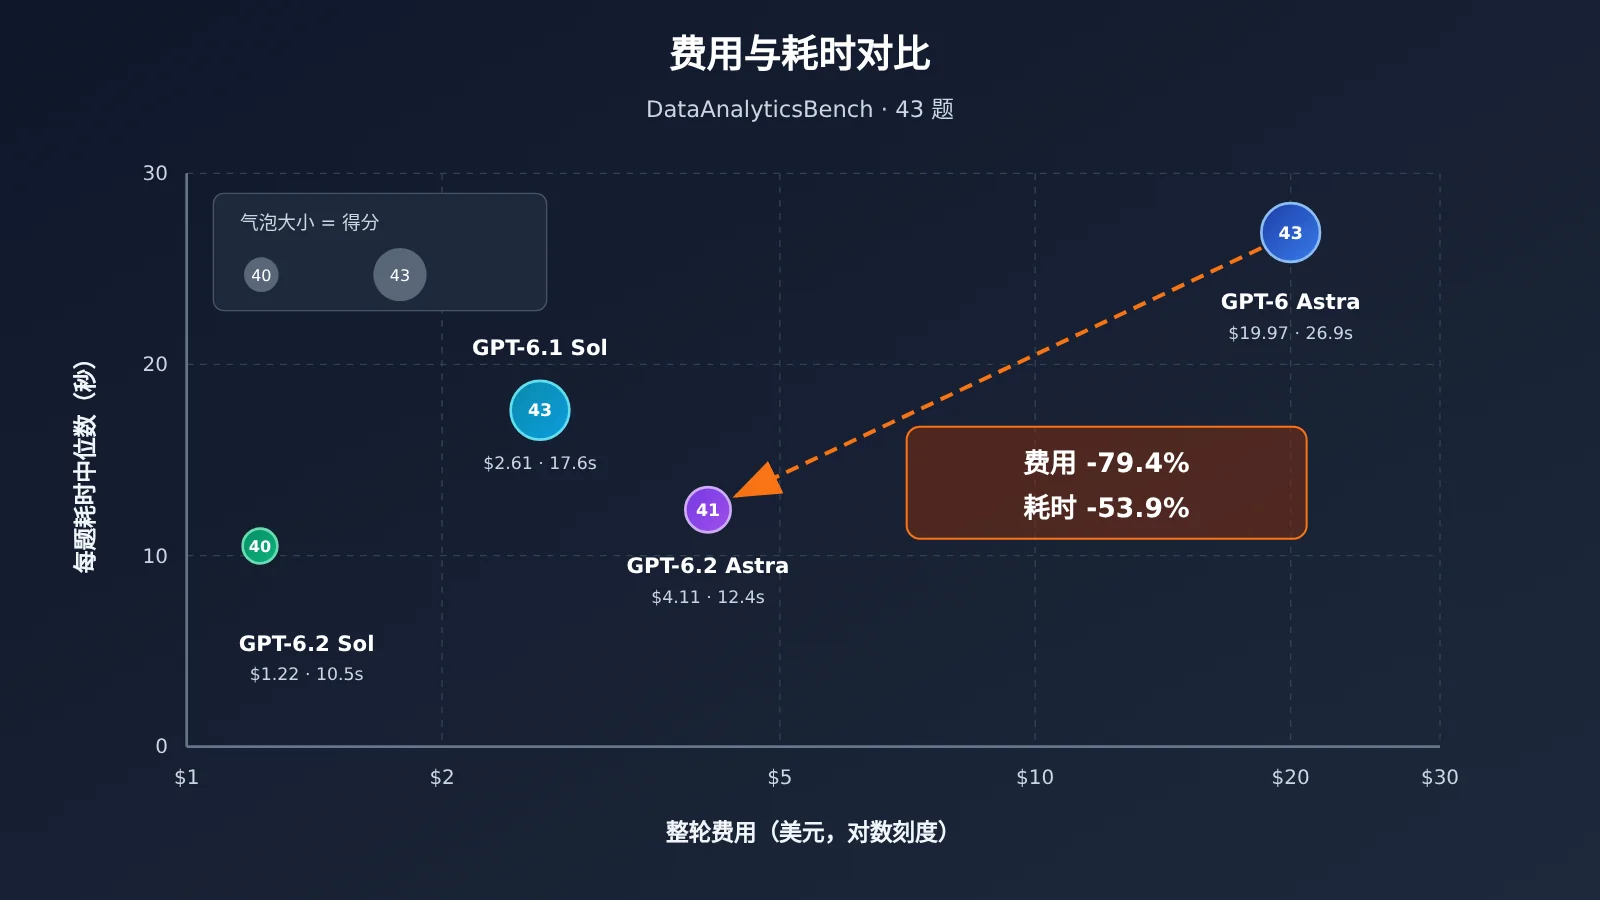
| 模型 | 得分 | 整轮费用 | 每题耗时中位数 |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4 秒 |
| GPT-6 Astra | 43/43 | $19.97 | 26.9 秒 |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6 秒 |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5 秒 |
按原表计算,GPT-6.2 Astra 相比前代整轮费用下降约 79.4%,每题耗时中位数缩短约 53.9%。作者实测中,6.2 Astra 整轮约 13 分钟,前代约 32 分钟。这里的耗时是包含工具查询在内的实际经过时间,不是纯模型推理时间。
单题费用有两种口径,需要分开看:$4.11 ÷ 43 得到每题均摊约 $0.096;更新后的总榜则把 $0.066 标为本轮单题费用的中位数。均摊值高于中位数,说明少数题目花费明显偏高,拉高了平均值。
Plotly 还提供了两代原轮的工作量明细:
| 工作量指标 | GPT-6 Astra(前代) | GPT-6.2 Astra |
|---|---|---|
| 工具调用次数 | 266 次 | 148 次 |
| 模型调用次数 | 249 次 | 171 次 |
| 输入 token | 约 910 万 | 约 440 万 |
| 输出 token | 约 7.8 万 | 约 3.4 万 |
| 输入缓存命中占比 | 93% | 98% |
Plotly 按新费率重算前代原样的用量,估算约为 $11。需要注意,这些费用来自 Plotly 测试当时的 OpenRouter 价格,不是 OpenAI 官方价目表的直接换算。
来源:Plotly Astra 专项报告 plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/;Plotly 总榜 plotly.com/blog/introducing-dataanalyticsbench/#full-results
GPT-6.2 Astra 模型身份与官方价格口径
OpenAI 于 2026 年 11 月 17 日发布 GPT-6.2 Astra 和 GPT-6.2 Sol。Astra 面向复杂推理、编码和专业工作,API 模型 ID 为 gpt-6.2-astra。OpenAI 发布公告中的评测属于厂商口径,Plotly 的 DataAnalyticsBench 是另一套第三方评测,两者不能混在一起比较。
按模型卡,Astra 接受文本和图像输入、输出文本,上下文为 1,050,000 token,最大输入 922,000 token,最大输出 128,000 token。它同时支持 Responses API 和 Chat Completions API,内置工具、Multi-agent 和后台完成窗口等能力以 Responses API 为准。模型卡还说明,reasoning.effort 设为 none 的请求会被拒绝。
OpenAI 标准短上下文纯文本价格(每百万 token)为:普通输入 $8,缓存命中输入 $0.40,输出 $40。官方称,相比前代,普通输入和输出单价降低 20%,缓存命中输入单价降低 60%。
来源:OpenAI 发布公告 openai.com/index/introducing-gpt-6-2-astra-sol/;模型卡 developers.openai.com/api/docs/models/gpt-6.2-astra;API 更新日志 developers.openai.com/api/docs/changelog;价格表 developers.openai.com/api/docs/pricing
GPT-6.2 Astra DataAnalyticsBench 分析判断
41/43 该怎么读:不是“整体变弱”
把 41/43 拆开看,GPT-6.2 Astra 在常规分析、歧义、不可回答、数据质量和统计陷阱五类题上没有丢分。这五类题覆盖了日常报表和口径核对的大部分场景。如果业务主要是这类问题,从这轮数据看,新一代 Astra 的质量与前代相当,成本和速度却明显更好。
两题差距还需要放到波动范围里看。Plotly 报告称,对其他模型复跑时曾出现最多三题的波动。因此,41 对 43 更适合当作“这一轮的观察值”,而不是稳定的能力差。比较准确的说法是:隐藏规律这一类出现了值得追踪的信号,但单轮数据还不足以确认存在退化。
隐藏规律题为何值得复测:探索深度的解释假设
以下是基于报告数据的解释假设,并非 Plotly 的结论。隐藏规律题上,新一代平均每题约 9 次查询,前代约 15 次;两道失分题的表现,一个是“没找到”,一个是“找到了位置但排除了真因”。两者都像是“查得不够深就收手”:前者探索范围不够,后者在验证阶段过早下了否定结论。
这和费用、延迟下降可能来自同一种行为变化,即模型更倾向于少查几次就作答。在常规题上,这种倾向直接转化为效率;在需要反复假设、验证的根因题上,则可能变成风险。要验证这个假设,需要在自己的数据上对照查询次数与通过率的关系,而不是只看总分。
GPT-6.2 Astra 费用与速度为何同步下降
$19.97 到 $4.11 的下降可以拆成两段,基于 Plotly 的重算数据:
- 费率因素:前代原样的用量按新费率重算约 $11,即单靠降价,费用大约从 $19.97 降到 $11,降幅约 45%。官方的缓存输入单价降低 60%,在缓存命中率高达 93% 至 98% 的场景下,这部分作用尤其明显。
- 工作量因素:从约 $11 到 $4.11,靠的是工作量减少。工具调用从 266 次降到 148 次,输入 token 从约 910 万减少到约 440 万,输出 token 减少一半以上,缓存命中占比从 93% 提高到 98%。
用官方单价粗算新一代的用量,结果也与 $4.11 处在同一量级:约 440 万输入中 98% 走缓存价,其余按普通输入价,再加上约 3.4 万输出 token。这说明在数据分析这类长上下文、多轮工具调用的场景中,缓存命中率和调用轮数对成本的影响可能比单价本身更大。速度提升同理:查询更少、模型调用更少,经过时间自然缩短。
💰 成本建议:评估这类 Agent 型任务的费用时,要记录缓存命中 token 和工具调用轮数,不能只看单价表。通过 API易 apiyi.com 按量调用时,可以对照账单与日志中的 usage 字段,核实缓存是否生效。
GPT-6.2 Astra 与 GPT-6.1 Sol、GPT-6.2 Sol 的取舍
四个模型的位置各不相同:
- GPT-6.1 Sol:在这套设置下以 $2.61 取得 43/43,是本轮“满分里最便宜”的选项,代价是耗时中位数 17.6 秒,慢于 6.2 Astra。
- GPT-6.2 Astra:41/43、$4.11、12.4 秒,优势出现在得分和速度一起比较时。如果只看成本和得分,它并不占优。
- GPT-6.2 Sol:$1.22、10.5 秒,最便宜也最快,但得分 40/43 最低。
- GPT-6 Astra:满分,但费用和延迟都明显偏高,在这组对照中已很难找到首选理由。
几者之间的分差都在 Plotly 提到的最多三题波动范围内。这意味着单看总分难以排出可靠的先后顺序,真正可靠的区分维度是费用和延迟。实际选择时,交互式问数产品对延迟敏感,可以优先比较 6.2 Astra 和 6.2 Sol;离线批量分析对延迟不敏感,6.1 Sol 的性价比更值得关注。
如何用自己的数据复测 GPT-6.2 Astra
以下复测方法属于编辑建议。DataAnalyticsBench 只覆盖风电运营、英文、单一环境,与多数团队的真实数仓差异很大。比较稳妥的做法是用自有数据做一个小型题集,固定数据、工具和提示词,多跑几轮,分别统计不同类型任务的表现。
| 子集 | 建议题量 | 重点记录 | 判断用途 |
|---|---|---|---|
| 常规报表 | 15-20 题 | 通过率、中位延迟 | 日常问数能否放心交给模型 |
| 歧义口径 | 5 题左右 | 是否主动澄清或说明假设 | 防止“默默选一个口径” |
| 统计偏差 | 5 题左右 | 是否识别辛普森悖论等陷阱 | 结论可信度 |
| 异常根因 | 5-8 题 | 通过率、查询次数、P90 延迟 | 验证隐藏规律题的失分信号 |
| 全部题目 | — | 每轮总费用、缓存命中率 | 成本预算 |
每个模型建议至少跑 3 轮,记录均值和波动。尾部延迟(P90)要单独记录:中位数好看不代表最慢的那几题能接受。
下面是最简调用示例,模型 ID 采用 OpenAI 公布的 gpt-6.2-astra,可用模型以平台列表为准:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # 模型卡说明 effort 为 none 的请求会被拒绝
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
查看完整复测脚本:按子集统计通过率、费用与 P50/P90 延迟
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# 自建题集:category 对应复测表中的子集,checker 由你按答案键实现
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# 官方直连单价(美元/百万 token),仅用于粗估;实际以平台账单为准
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
这段脚本只做单轮问答。如果要贴近 DataAnalyticsBench 的设置,还需要接入只读 SQL 工具,让模型自主多轮查询,并额外记录每题的工具调用次数,用来检验前文“查询次数与失分”的假设。
🎯 复测建议:四个模型都走 OpenAI 兼容协议,通过 API易 apiyi.com 用同一个 API Key 即可切换,新用户的免费测试额度足够先跑一轮小题集,再决定是否扩大规模。
榜单给出的是方向,具体到自己的数仓、自己的异常类型,答案只能自己跑出来。陆游在《冬夜读书示子聿》中写道:“纸上得来终觉浅,绝知此事要躬行。”
作者:APIYI 技术团队
技术交流:欢迎通过 API易 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心