摘要:DeepSeek 全家桶 API 把模型 Token 和工具调用分开计费。完整成本要按搜索次数、文件页数、语音处理量和缓存命中率逐项计算。
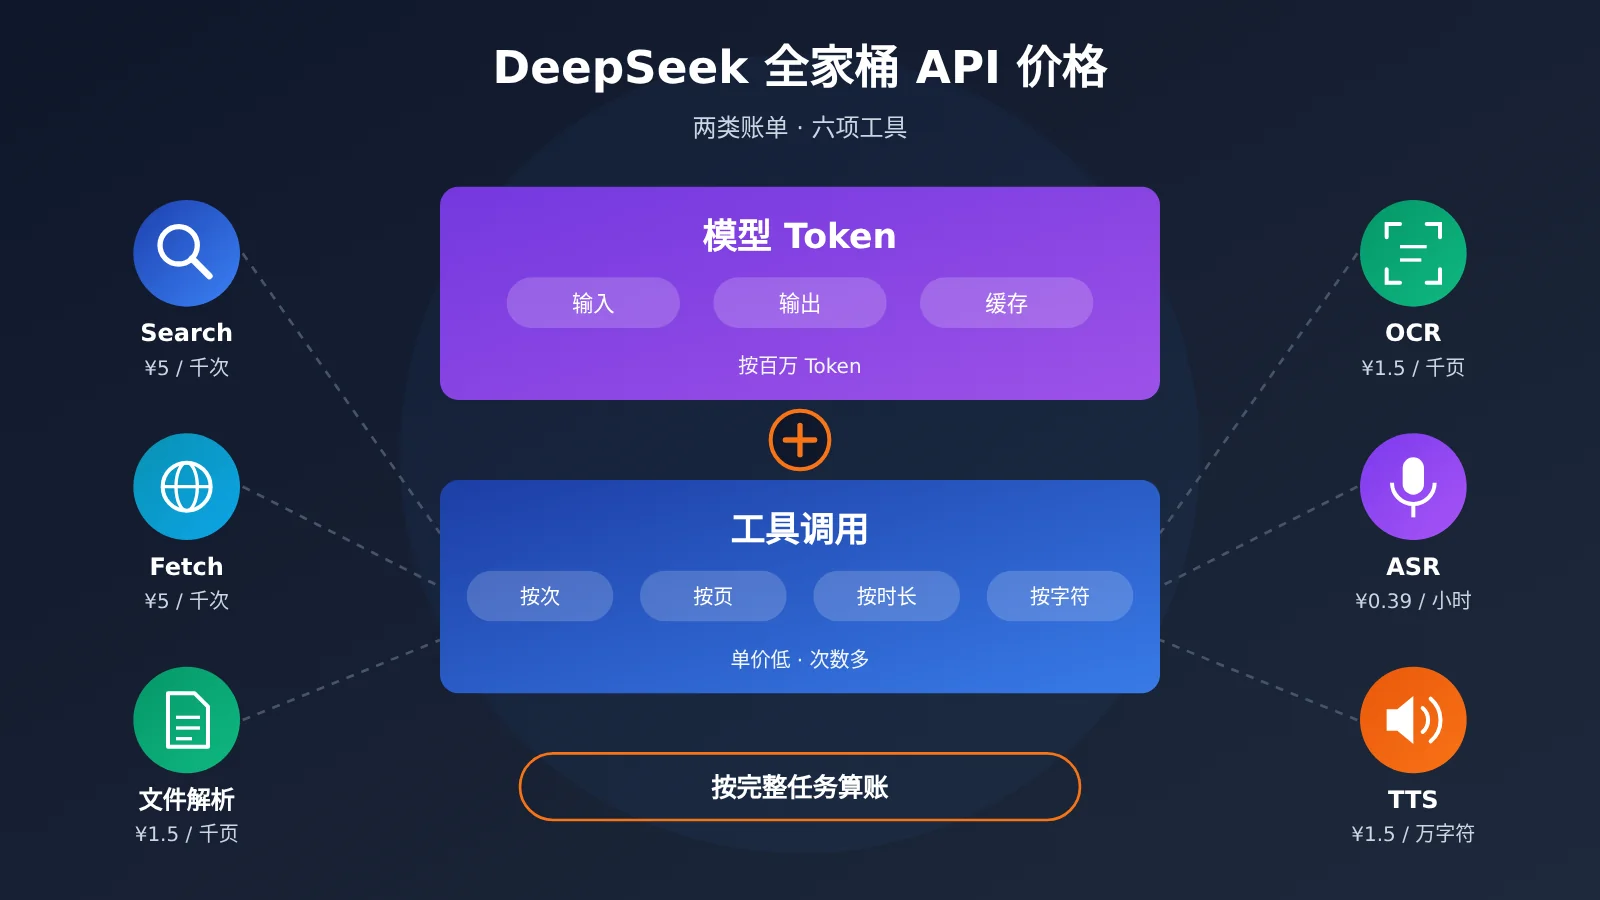
结论先行:按 2026 年 11 月 15 日的 DeepSeek 官方中文价格文档,Search 和 Fetch 都是每 1000 次成功请求 ¥5,文件解析和 OCR 都是每 1000 页 ¥1.5,ASR 限时价为每小时 ¥0.39,TTS 限时价为每 10000 计费字符 ¥1.5。工具单价很低,但一个联网 Agent 任务的账单通常由模型 Token 主导。以“2 次搜索、3 次抓取、2 万输入 Token、3000 输出 Token”的研究任务测算,1000 次任务在空闲时段约 ¥57,高峰时段约 ¥89;输入缓存命中 80% 时,空闲时段可降到约 ¥41.32。因此做预算时,应以“完整任务”为单位计算,单次 API 请求的价格只是其中一项。
下文先拆开模型费用和工具费用的计费结构,再逐项列出 Search、Fetch、文件解析、OCR、ASR、TTS 的单价和计费单位。随后用 4 个固定假设的场景演示完整算法,说明深度搜索、长上下文和速率限制如何影响账单。最后给出一套可直接复用的成本日志代码,并对比模型内置搜索与独立 Search / Fetch 接口的选择方法。
To Know:DeepSeek 全家桶 API 计费术语
| 术语 | 解释 |
|---|---|
| Token | 模型处理文本时使用的计量单位,模型费用按百万 Token 计价 |
| 输入 Token | 进入模型上下文、参与推理的全部内容,包括提示词、文件内容、搜索结果 |
| 输出 Token | 模型生成的内容,思考模式下的推理过程也计入输出 |
| Context Cache | 复用之前处理过的上下文,降低重复输入的费用 |
| Cache Hit | 输入内容成功复用缓存,按更低的“缓存命中”单价计费 |
| 高峰 / 空闲时段 | DeepSeek 按北京时间区分的两档价格,空闲价为高峰价的一半 |
| Search API | 按关键词查询网页,返回结构化搜索结果 |
| Fetch API | 抓取指定网页,返回正文内容 |
| 模型内置搜索 | 在对话请求中声明搜索工具,由模型自主决定搜索,服务端代为执行 |
| QPS | 每秒允许处理的请求数量 |
| OCR | 从图片或文档中识别文字 |
| ASR | 把语音识别成文字 |
| TTS | 把文字合成为语音 |
| 计费字符 | TTS 的计量单位,中文汉字按 2 个计费字符算 |
| Tool Usage | 模型或程序实际调用外部工具产生的计费用量 |
1 DeepSeek 全家桶 API 到底怎么收费
1.1 DeepSeek 全家桶 API 的两类账单:模型费用与工具费用
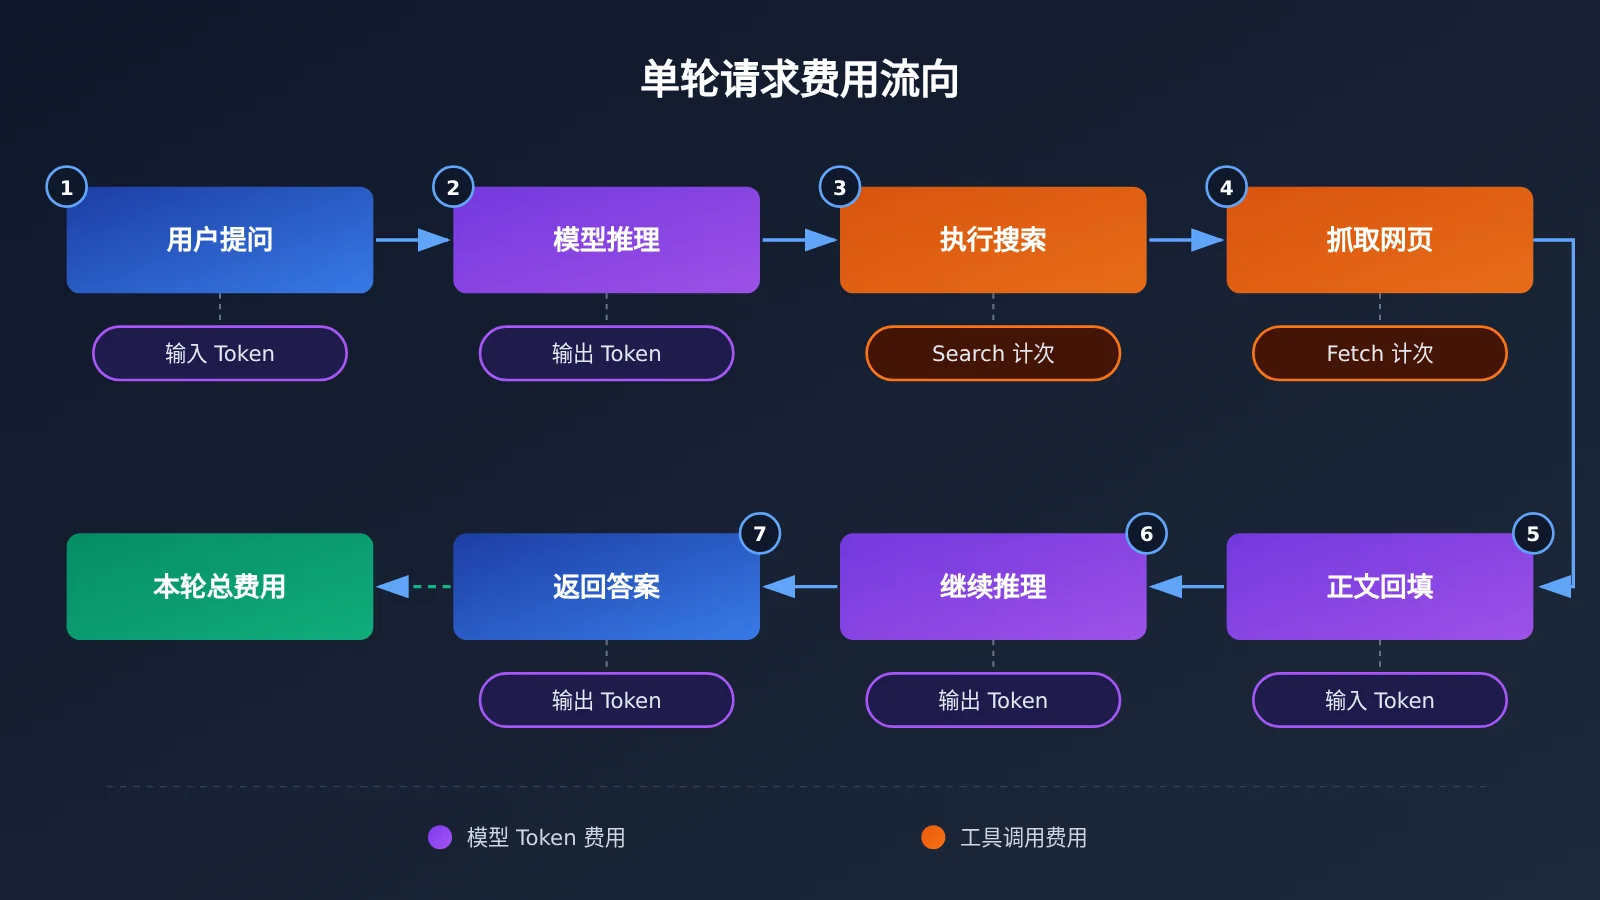
2026 年 11 月 13 日,DeepSeek 把 App 背后的联网搜索、深度思考搜索、阅读链接、文件输入、OCR、ASR、TTS、安全校验等能力开放为 API。计费上,这些能力和模型推理各算各的。可以用一个公式概括:
总费用 = 模型输入费用(缓存命中 + 缓存未命中)
       + 模型输出费用(含思考 Token)
       + 工具调用费用(Search / Fetch / 图片搜索)
       + 文件及语音处理费用(解析页数 / OCR 页数 / 音频时长 / TTS 字符)
同一轮问答可能同时产生上述每一项费用。例如在对话中开启深度思考搜索后,模型会多次生成搜索词、打开多个网页,再把网页内容拼入上下文继续推理。这一轮请求既产生搜索和抓取费用,也因为网页正文进入上下文而产生大量输入 Token,思考过程还会计入输出 Token。
1.2 DeepSeek Flash 与 Pro 的模型价格
以下为 DeepSeek 官方价格文档在 2026 年 11 月 15 日公布的价格,币种为人民币,单位为每百万 Token。
| 模型 | 缓存命中(空闲 / 高峰) | 缓存未命中(空闲 / 高峰) | 输出(空闲 / 高峰) | 并发限制 |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | ¥0.02 / ¥0.04 | ¥1 / ¥2 | ¥4 / ¥8 | 2500 |
| DeepSeek-V4-Pro | ¥0.15 / ¥0.30 | ¥4.5 / ¥9 | ¥13.5 / ¥27 | 500 |
高峰时段是北京时间周一至周五的 09:00—12:00 和 14:00—18:00,不含中国法定节假日;其余时间(含周末和法定节假日全天)都是空闲时段。两个模型的上下文长度均为 1M,最大输出长度均为 384K;Flash 支持图像理解,Pro 不支持。
模型选择还影响工具可用性。本次公告中,对话级的完整工具集成(联网搜索、深度思考搜索、阅读链接、文件解析、图像理解、安全校验)由 deepseek-flash(DeepSeek-V4.1-Flash)承载。规划需要内置工具的应用时,应以 Flash 为基准建立成本模型。
2 DeepSeek 全家桶 API 中 Search、Fetch、OCR、ASR、TTS 分别多少钱
下表为 DeepSeek 官方工具价格(2026 年 11 月 15 日,人民币)。“刊例价”和“限时优惠”分开列出,限时优惠结束后需按刊例价重新预算。
| 能力 | 计费单位 | 刊例价 | 限时优惠 | 换算到单次 / 单位 |
|---|---|---|---|---|
| Search 搜索 | 1000 次成功请求 | ¥5 | ¥5 | ¥0.005 / 次 |
| Fetch 网页抓取 | 1000 次成功请求 | ¥5 | ¥5 | ¥0.005 / 次 |
| 文件解析 | 1000 页 | ¥1.5 | ¥1.5 | ¥0.0015 / 页 |
| OCR | 1000 页 | ¥1.5 | ¥1.5 | ¥0.0015 / 页 |
| ASR | 1 小时音频 | ¥0.78 | ¥0.39 | 不足 1 秒按 1 秒计 |
| TTS | 10000 计费字符 | ¥3 | ¥1.5 | 汉字计 2 字符 |
2.1 DeepSeek Search 与 Fetch 的计费方式
独立 Search 按成功请求计费:HTTP 200 且 results 数组非空才算成功。单次请求可返回 1—50 条结果(count 默认 10),返回 1 条和 50 条价格相同,因此一次多取结果比多次少量请求更省。独立 Fetch 要求 HTTP 200 且成功返回网页正文;失败、超时、无结果都不收费。
模型内置搜索的统计口径不同。内置文字搜索按实际执行的查询词条数计费,一次工具调用带 3 个查询词就计 3 次;内置图片搜索按返回图片数和框选区域数计费;内置网页抓取按成功抓取的网页数计费。所以在对话里开启搜索,一轮问答产生多次搜索费用属于正常情况。
2.2 DeepSeek 文件解析与 OCR 的按页计费
文件解析通过 Files API 完成:上传文件、服务端解析、返回 file_id,对话中引用 file_id 即可。解析按成功解析的页数计费,每 1000 页 ¥1.5。之后在对话里再次引用同一个已解析文件,不再收解析费,但文件内容每次进入上下文都会按输入 Token 计费。
解析模式也影响 Token 用量。text_recognition 只给模型纯文本,rich_layout_recognition 会把图表裁切成图片随文字一起交给模型,适合财报、PPT,但会增加图像 Token。XLSX、CSV、TXT、MD、JSON、EPUB 等文件可作为 user_data 上传并转为 Markdown,这类上传不收解析费。
OCR 是独立接口(/v1/tools/ocr),同样每 1000 页 ¥1.5,按成功识别页数计费,失败和超时不计费。两者定位不同:OCR 只负责提取文字和位置信息,文件解析则把结果直接送进模型上下文供模型理解。
2.3 DeepSeek ASR 与 TTS 的语音计费
ASR(/v1/tools/asr)刊例价每小时音频 ¥0.78,当前限时五折为 ¥0.39,不足 1 秒按 1 秒计费。它采用完整文件上传、非流式识别,单个音频最长 120 秒、最大 8 MiB,支持 16-bit PCM WAV 和 Ogg Opus,单账号并发 50 个。长录音需要先切片,每段尾部的不足 1 秒会各自进位,切片越碎,进位累计越多。
TTS(/v1/tools/tts,也支持 WebSocket 流式合成)刊例价每 10000 计费字符 ¥3,限时价 ¥1.5。中文汉字按 2 个计费字符、英文字母数字空格按 1 个计算,单次最多输入 10000 计费字符。换算下来,10 万计费字符约等于 5 万个汉字,中文内容的预算要先乘 2。
3 DeepSeek 全家桶 API 四种场景的费用估算
以下 4 个案例都基于公开单价和固定假设计算,调用次数和 Token 用量是假设值,属于情景测算,代表的是计算方法,实际账单以服务端返回的计费字段为准。
3.1 场景一:1000 次联网研究任务(空闲 ¥57 / 高峰 ¥89)
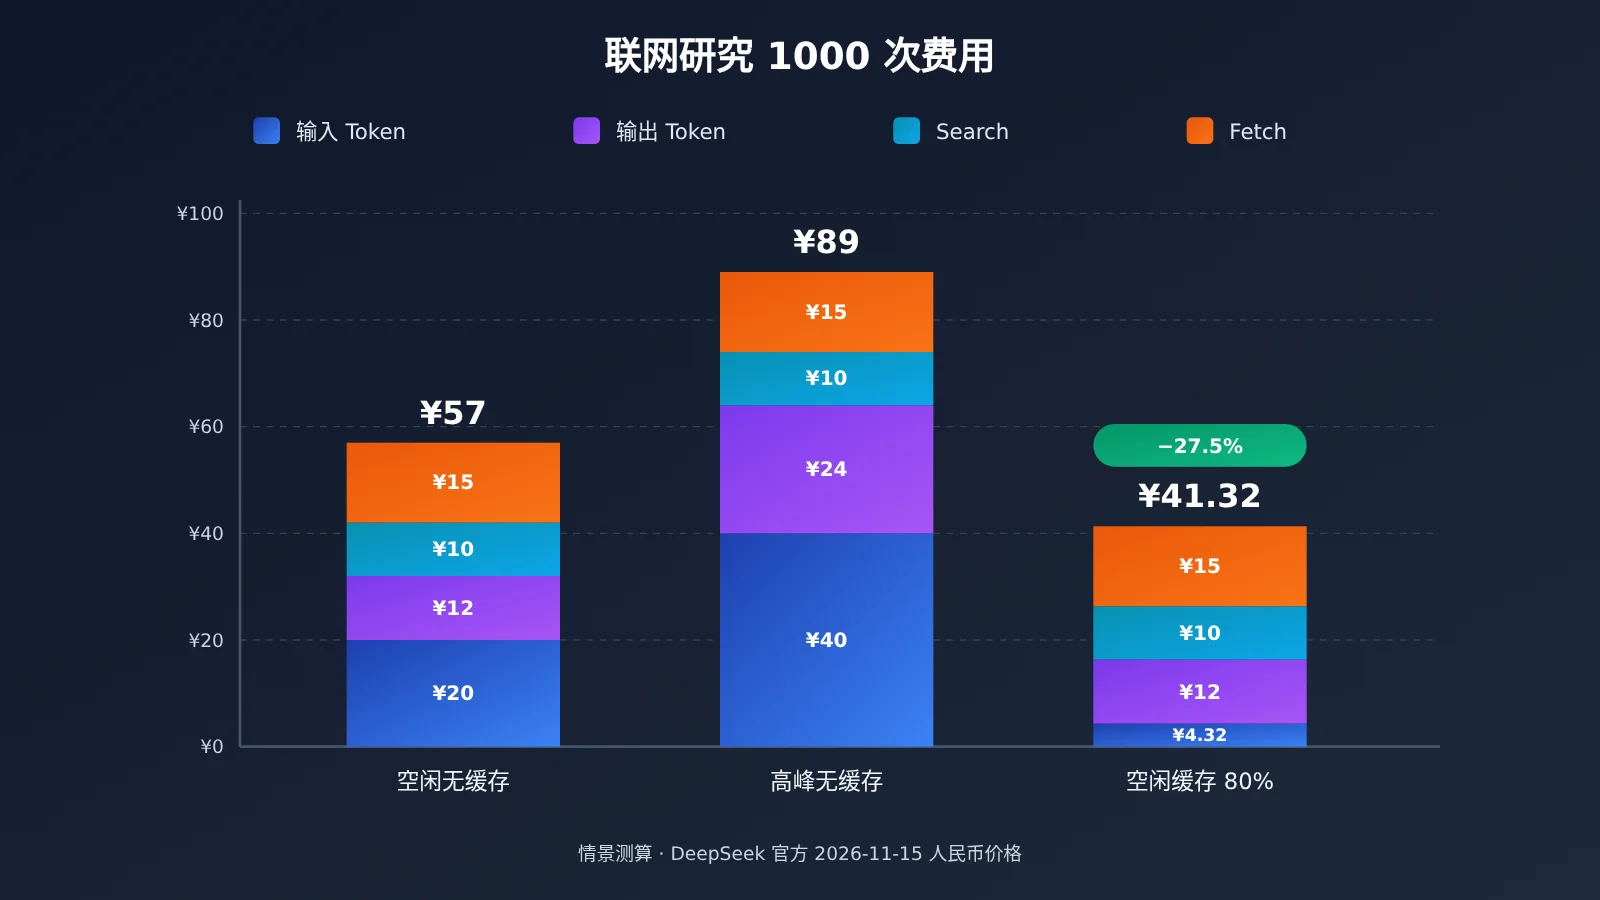
假设:使用 DeepSeek-V4.1-Flash;每次任务 2 个成功搜索查询词、3 个成功抓取网页、20000 个缓存未命中输入 Token、3000 个输出 Token。
| 项目 | 计算公式 | 空闲时段(¥/次) | 高峰时段(¥/次) |
|---|---|---|---|
| 输入 Token | 20000 ÷ 1000000 × 单价 | 0.020 | 0.040 |
| 输出 Token | 3000 ÷ 1000000 × 单价 | 0.012 | 0.024 |
| Search | 2 × ¥0.005 | 0.010 | 0.010 |
| Fetch | 3 × ¥0.005 | 0.015 | 0.015 |
| 单次合计 | — | 0.057 | 0.089 |
| 1000 次合计 | 单次 × 1000 | ¥57 | ¥89 |
高峰时段模型 Token 费用翻倍,Search 和 Fetch 价格不变,所以总账单从 ¥57 涨到 ¥89,涨幅约 56%。这个任务里模型费用占空闲账单的约 56%(¥32 / ¥57),说明联网 Agent 的大头仍在 Token。能延后执行的批量任务放到空闲时段,是最直接的降本手段。
3.2 场景二:输入缓存命中 80% 能节省多少
假设:条件同场景一(空闲时段),但 20000 个输入 Token 中 16000 个命中缓存、4000 个未命中。
- 缓存命中输入:16000 ÷ 1000000 × ¥0.02 = ¥0.00032
- 缓存未命中输入:4000 ÷ 1000000 × ¥1 = ¥0.004
- 输出:3000 ÷ 1000000 × ¥4 = ¥0.012
- 搜索 + 抓取:¥0.010 + ¥0.015 = ¥0.025
- 单次合计 ¥0.04132,1000 次合计 ¥41.32
和场景一的 ¥57 相比节省 ¥15.68,约 27.5%。缓存只作用于输入费用:输入从 ¥0.020 降到约 ¥0.0043,输出和工具费用完全不变。缓存命中率越高,账单越接近“输出 + 工具”的下限,此时继续降本就要靠减少搜索次数和控制输出长度。
3.3 场景三:批量处理 5000 页企业文档
假设:Flash 空闲时段;5000 页文档只解析一次;后续分析累计 1000 万缓存未命中输入 Token、100 万输出 Token。
- 文件解析:5000 ÷ 1000 × ¥1.5 = ¥7.50
- 模型输入:10000000 ÷ 1000000 × ¥1 = ¥10.00
- 模型输出:1000000 ÷ 1000000 × ¥4 = ¥4.00
- 合计 ¥21.50
解析费只占约 35%。如果同一批文件在多轮对话里反复整体塞进上下文,输入 Token 会成倍增加,解析费却不再增长。大文档场景的关键是控制“文件内容进入上下文的次数”。
3.4 场景四:10 小时语音识别 + 10 万计费字符 TTS
假设:使用当前限时五折价格;ASR 10 小时音频,TTS 100000 计费字符。
- ASR:10 × ¥0.39 = ¥3.90
- TTS:100000 ÷ 10000 × ¥1.5 = ¥15.00
- 合计 ¥18.90
这笔费用只包含语音服务,转写文本交给对话模型做总结、问答时,模型 Token 另行计费。按刊例价计算,同样的用量为 10 × ¥0.78 + 10 × ¥3 = ¥37.80,优惠结束后语音预算会翻倍。另外 10 小时音频按 120 秒上限至少切成 300 段,需要配合 50 并发做调度。
4 哪些因素让 DeepSeek 全家桶 API 账单上涨
4.1 深度思考搜索一次执行多个查询词
深度思考搜索最多可调用约 20 次工具后作答,计费按实际动作累加。官方计费细则中几条关键规则:
- 一次 Search 含 3 个查询词且都有结果,计 3 次搜索
- 图片搜索返回 3 张图计 3 次,模型再框选图中 2 个区域,额外计 2 次
- 成功打开 1 个需联网抓取的网页计 1 次 Fetch,再次打开同一网页不重复计费
- 对已打开网页执行
find_in_page不单独计费,Search 无结果不计费 - 开启模型内容安全时,部分网页即使显示为
url_not_allowed或unavailable,底层已成功抓取的仍可能计费
统计时要使用计费字段 server_tool_use.tool_search、tool_fetch、tool_image_search。web_search_requests 和 web_fetch_requests 只是展示返回块数量,可能包含失败请求,按它算会高估费用。
4.2 长上下文和重复文件输入
搜索结果、网页正文、已解析文件都会进入上下文。阅读链接工具最多考虑最后一条用户消息里的 10 个不同 URL,多网页同时读取时每页可用上下文会缩小,但总输入量仍然可观。长会话每一轮都带着历史内容,输入 Token 随轮次累积增长。
降本方法有三种:在应用层保存摘要和关键事实,后续轮次引用摘要;把系统提示词、公共资料、工作流规则放在上下文前部并保持稳定,提高缓存命中机会;只在需要看图表时使用 rich_layout_recognition。
4.3 批量任务的请求速率限制
独立 Search 的账号级限制为 100 QPS,Fetch 为 25 QPS,这是整个账号的额度,多个 API Key 共享。Fetch 还受目标域名级别的 QPS 限制,集中抓取同一网站更容易触发 429。错误处理建议:
- 408、429、5xx:指数退避后重试,同域名请求打散
- 402:余额不足,先处理账户余额
- 其他 4xx(如参数错误):修正请求后再发,重试无效
失败请求不计费,所以重试本身不增加工具费用,但会拉长任务时长。大批量任务应按 25 QPS 的 Fetch 上限反推完成时间。
5 如何为 DeepSeek Agent 设计合理的成本预算
5.1 DeepSeek 全家桶 API 成本日志:快速上手
生产环境至少要分别记录:缓存命中输入、缓存未命中输入、输出 Token、Search 次数、Fetch 次数、图片搜索次数、文档解析页数、音频时长、TTS 计费字符。下面的函数直接读取 usage 字段算出单次费用,可以接在每次请求之后写日志。
# DeepSeek 全家桶成本估算(人民币,2026-11-15 官方价格)
FLASH = {"cache_hit": 0.02, "cache_miss": 1.0, "output": 4.0}  # 空闲时段 ¥/百万Token
TOOL = {"search": 0.005, "fetch": 0.005, "image_search": 0.005}  # ¥/次

def estimate_cost(usage: dict, peak: bool = False) -> dict:
    k = 2 if peak else 1  # 高峰价为空闲价两倍,工具价不变
    stu = usage.get("server_tool_use", {})
    model = (usage.get("cache_read_input_tokens", 0) * FLASH["cache_hit"]
             + usage.get("input_tokens", 0) * FLASH["cache_miss"]
             + usage.get("output_tokens", 0) * FLASH["output"]) / 1e6 * k
    tools = (stu.get("tool_search", 0) * TOOL["search"]
             + stu.get("tool_fetch", 0) * TOOL["fetch"]
             + stu.get("tool_image_search", 0) * TOOL["image_search"])
    return {"model": round(model, 5), "tools": round(tools, 5),
            "total": round(model + tools, 5)}

# 复现场景二:16000 命中 + 4000 未命中 + 3000 输出 + 2 搜索 + 3 抓取
print(estimate_cost({"cache_read_input_tokens": 16000, "input_tokens": 4000,
                     "output_tokens": 3000,
                     "server_tool_use": {"tool_search": 2, "tool_fetch": 3}}))
# {'model': 0.01632, 'tools': 0.025, 'total': 0.04132}
图片搜索的单价这里按 Search 单价处理,上线前请对照官方文档确认。预算维度上,问答产品适合“按用户请求”记账,多步骤 Agent、Deep Research、批量自动化更适合“按任务生命周期”记账,把一个任务内的所有模型调用和工具调用汇总到同一个 task_id 下。
5.2 何时选 DeepSeek 内置搜索,何时选独立 Search / Fetch 接口
| 维度 | 模型内置搜索(deepseek_web_search / read_url) | 独立 Search / Fetch API |
|---|---|---|
| 开发复杂度 | 低,服务端完成搜索、抓取和上下文拼接 | 较高,需自己编排工具循环 |
| 流程控制 | 由模型决定搜几次、读哪些页 | 开发者精确控制每一次调用 |
| 计费口径 | 按查询词条数、图片数、成功抓取页数 | 按成功 HTTP 请求次数 |
| 费用可预测性 | 波动较大,深度搜索最多约 20 次工具调用 | 高,调用次数由代码决定 |
| 适合场景 | 对话助手、快速复刻 App 体验 | RAG、批量采集、固定流程的 Agent |
需要快速上线对话产品时,内置搜索省去大量工程工作;需要把单任务成本卡在固定区间、或者要先筛选再抓取时,独立接口更合适。两者也可以组合:对话主流程用内置工具,后台批量补数据用独立接口。
5.3 API易 上的 DeepSeek Search / Fetch 接入与价格
API易 已于 2026 年 10 月 21 日上线 DeepSeek 独立工具接口 deepseek-search 和 deepseek-fetch,接口为 POST /v1/tools/search 和 POST /v1/tools/fetch。它们不消耗模型 Token,按成功调用次数计费,default 和 svip 分组可用,ClaudeCode 分组的令牌无法直接调用。对于 DeepSeek Harness、Claude Code 等客户端调用的模型内置搜索,API易 的兼容工作仍在后续规划中,当前可用的是独立 Search / Fetch。
以下为 API易 文档公布的价格,币种为美元:
| 项目 | 文档标注官方价 | API易 站内价 | 20% 加赠后等效 | 10% 加赠后等效 |
|---|---|---|---|---|
| Search / 1000 次 | $0.75 | $0.90 | $0.75 | 约 $0.82 |
| Fetch / 1000 次 | $0.75 | $0.90 | $0.75 | 约 $0.82 |
按场景一的工具量(1000 次 Search + 3000 次 Fetch)计算:站内计费 (1000 + 3000) ÷ 1000 × $0.90 = $3.60;20% 加赠适用于全部消费时等效 $3.60 ÷ 1.20 = $3.00;10% 加赠时约 $3.27。DeepSeek 官方以人民币计价,比较实际成本时需统一币种、汇率和充值优惠条件,最终以账户控制台显示的价格为准。
极简调用示例(请求字段以 API易 文档为准):
import requests

BASE_URL = "https://api.apiyi.com/v1"  # API易 统一接口
headers = {"Authorization": "Bearer YOUR_API_KEY"}

resp = requests.post(f"{BASE_URL}/tools/search", headers=headers,
                     json={"model": "deepseek-search",
                           "query": "DeepSeek API 价格", "count": 10})
print(resp.json())
查看完整实现:先搜索后抓取,含 429 退避重试与计数
import time
import requests

BASE_URL = "https://api.apiyi.com/v1"  # API易 OpenAI 兼容入口
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}
RETRY_CODES = {408, 429, 500, 502, 503, 504}

def call_tool(path: str, payload: dict, max_retry: int = 4) -> dict | None:
    """调用工具接口;可重试错误指数退避,失败请求不计费"""
    for i in range(max_retry):
        r = requests.post(f"{BASE_URL}{path}", headers=HEADERS,
                          json=payload, timeout=60)
        if r.status_code == 200:
            return r.json()
        if r.status_code == 402:
            raise RuntimeError("余额不足,请先充值")
        if r.status_code in RETRY_CODES:
            time.sleep(2 ** i)  # 1s, 2s, 4s, 8s
            continue
        raise ValueError(f"请求参数错误: {r.status_code} {r.text}")
    return None

def research(query: str, fetch_top: int = 3) -> dict:
    stats = {"search": 0, "fetch": 0}
    result = call_tool("/tools/search",
                       {"model": "deepseek-search", "query": query, "count": 10})
    items = (result or {}).get("results", [])
    if items:
        stats["search"] += 1  # 非空结果才计费
    pages = []
    for item in items[:fetch_top]:  # 只抓真正需要读原文的页面
        page = call_tool("/tools/fetch",
                         {"model": "deepseek-fetch", "url": item.get("url")})
        if page:
            stats["fetch"] += 1
            pages.append(page)
        time.sleep(0.05)  # 控制节奏,避开 Fetch 25 QPS 与域名级限流
    return {"pages": pages, "billing": stats}

if __name__ == "__main__":
    out = research("DeepSeek 全家桶 API 计费规则")
    print(out["billing"])  # 例如 {'search': 1, 'fetch': 3}
🚀 快速开始:通过 API易 apiyi.com 注册即可获取测试额度,先用小批量请求跑通 Search / Fetch,再按日志里的实际调用次数推算正式预算。
常见问题 FAQ
Q1:DeepSeek 全家桶 API 包含哪些收费项目?
包含模型 Token(缓存命中输入、缓存未命中输入、输出)和工具费用(Search、Fetch、图片搜索、文件解析、OCR、ASR、TTS)。安全校验和页内查找 `find_in_page` 在公开价格表中没有单独列价。
Q2:独立 Search API 和模型内置搜索的计费有什么区别?
独立 Search 按成功 HTTP 请求计 1 次,返回 50 条也只算 1 次;模型内置搜索按实际查询词条数计费,一次调用带 3 个查询词计 3 次。内置方式开发更省事,独立方式费用更可控。
Q3:这些价格是什么时候的,限时优惠会变吗?
本文价格取自 DeepSeek 官方中文价格文档,时点为 2026 年 11 月 15 日。ASR 和 TTS 当前是限时五折,结束后分别回到每小时 ¥0.78 和每 10000 计费字符 ¥3,长期预算建议按刊例价留出余量。
Q4:高峰时段账单会直接翻倍吗?
只有模型 Token 部分翻倍,工具价格不分时段。场景一中总账单从 ¥57 升到 ¥89,涨幅约 56%。工具费用占比越高的任务,高峰时段的涨幅越小。
Q5:如何通过 API 快速调用 DeepSeek Search 和 Fetch?
1. 在 API易 apiyi.com 注册并创建 default 或 svip 分组的令牌
2. 把 base_url 设为 `https://api.apiyi.com/v1`
3. 用本文代码请求 `/tools/search` 和 `/tools/fetch`,模型名分别为 `deepseek-search`、`deepseek-fetch`
同一个 API Key 还可以调用平台上的其他主流模型,方便把搜索结果交给不同模型对比效果。
Q6:文件解析后反复提问会重复收费吗?
解析费只收一次,再次引用同一个 `file_id` 不再收解析费。但文件内容每次进入上下文都按输入 Token 计费,大文件多轮提问的主要成本来自输入 Token。
Q7:DeepSeek 全家桶 API 有哪些已知限制?
– 完整对话级工具集成目前针对 `deepseek-flash`
– 独立 Search 账号级 100 QPS,Fetch 25 QPS,并受目标域名限流
– ASR 单段最长 120 秒、非流式;TTS 单次最多 10000 计费字符,暂不支持调节语速
– 文件解析单文件最大 100 MiB、1000 页,单请求最多引用 20 个文件
Q8:API易 能调用 DeepSeek 新发布的全部内置工具吗?
当前 API易 已上线独立的 `deepseek-search` 和 `deepseek-fetch`,可在 Agent、RAG 中自行编排。模型内置搜索在 Harness、Claude Code 等客户端中的兼容工作还在规划中,进展以 API易 apiyi.com 的官方文档为准。
DeepSeek 全家桶 API 价格 Key Takeaways
- 计费结构:模型 Token 与工具调用分开计费,一个任务会同时产生多项费用
- 工具单价:Search、Fetch 各 ¥5 / 1000 次,文件解析与 OCR 各 ¥1.5 / 1000 页
- 语音价格:ASR 限时 ¥0.39 / 小时,TTS 限时 ¥1.5 / 万计费字符,汉字计 2 字符
- 账单大头:联网研究任务中模型 Token 通常占一半以上,空闲时段和缓存最有效
- 缓存效果:输入命中 80% 时,场景一账单从 ¥57 降至 ¥41.32,节省约 27.5%
- 统计口径:以
server_tool_use计费字段记账,展示字段可能包含失败请求 - 上手方式:独立 Search / Fetch 可在 API易 apiyi.com 用统一 Key 调用测试
总结
DeepSeek 全家桶 API 价格的核心要点:
- 按任务算账:一个 Agent 任务的成本 = 输入 + 输出 + 工具 + 文件语音,单次请求价格只反映其中一项
- Token 主导账单:工具单价低,长上下文、重复文件和思考输出才是费用增长的主因
- 口径决定可控性:内置搜索按查询词计费、便于开发,独立接口按请求计费、预算稳定
实际落地时,先用本文的成本函数在小样本上跑出真实的计费字段,再乘以业务量得到预算,并为限时优惠到期预留余量。需要自行编排搜索与抓取流程的团队,可以通过 API易 apiyi.com 调用独立的 DeepSeek Search / Fetch 接口,结合控制台实际价格完成同币种比较。
📚 参考资料
- DeepSeek 模型与价格:官方实时价格文档
- 链接:
api-docs.deepseek.com/zh-cn/quick_start/pricing -
说明:模型 Token 单价、高峰与空闲时段、工具价格
-
DeepSeek 联网工具:内置搜索与阅读链接技术文档
- 链接:
api-docs.deepseek.com/zh-cn/guides/web_tools -
说明:深度搜索计费细则、
server_tool_use计费字段 -
DeepSeek 网页搜索与抓取:独立 Search / Fetch 文档
- 链接:
api-docs.deepseek.com/zh-cn/guides/search -
说明:成功请求定义、QPS 限制、错误码处理
-
DeepSeek 文件解析 / OCR / ASR / TTS:各工具技术文档
- 链接:
api-docs.deepseek.com/zh-cn/guides/document_parsing -
说明:同目录下可查 ocr、asr、tts 的限制与计费单位
-
DeepSeek 全家桶应用 API 公告:2026 年 11 月 13 日发布
- 链接:
api-docs.deepseek.com/zh-cn/news/news261113 - 说明:本次开放能力清单与模型支持范围
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,DeepSeek Search / Fetch 的接口参数与最新价格可在 API易 文档中心查阅