作者注:LongCat 2.5 新品解讀。本文梳理參數和架構、官方 8 個演示案例、25 項官方自測跑分的位置、限時折扣價的賬單,以及在 Claude Code、Cline 裏的接入方式。
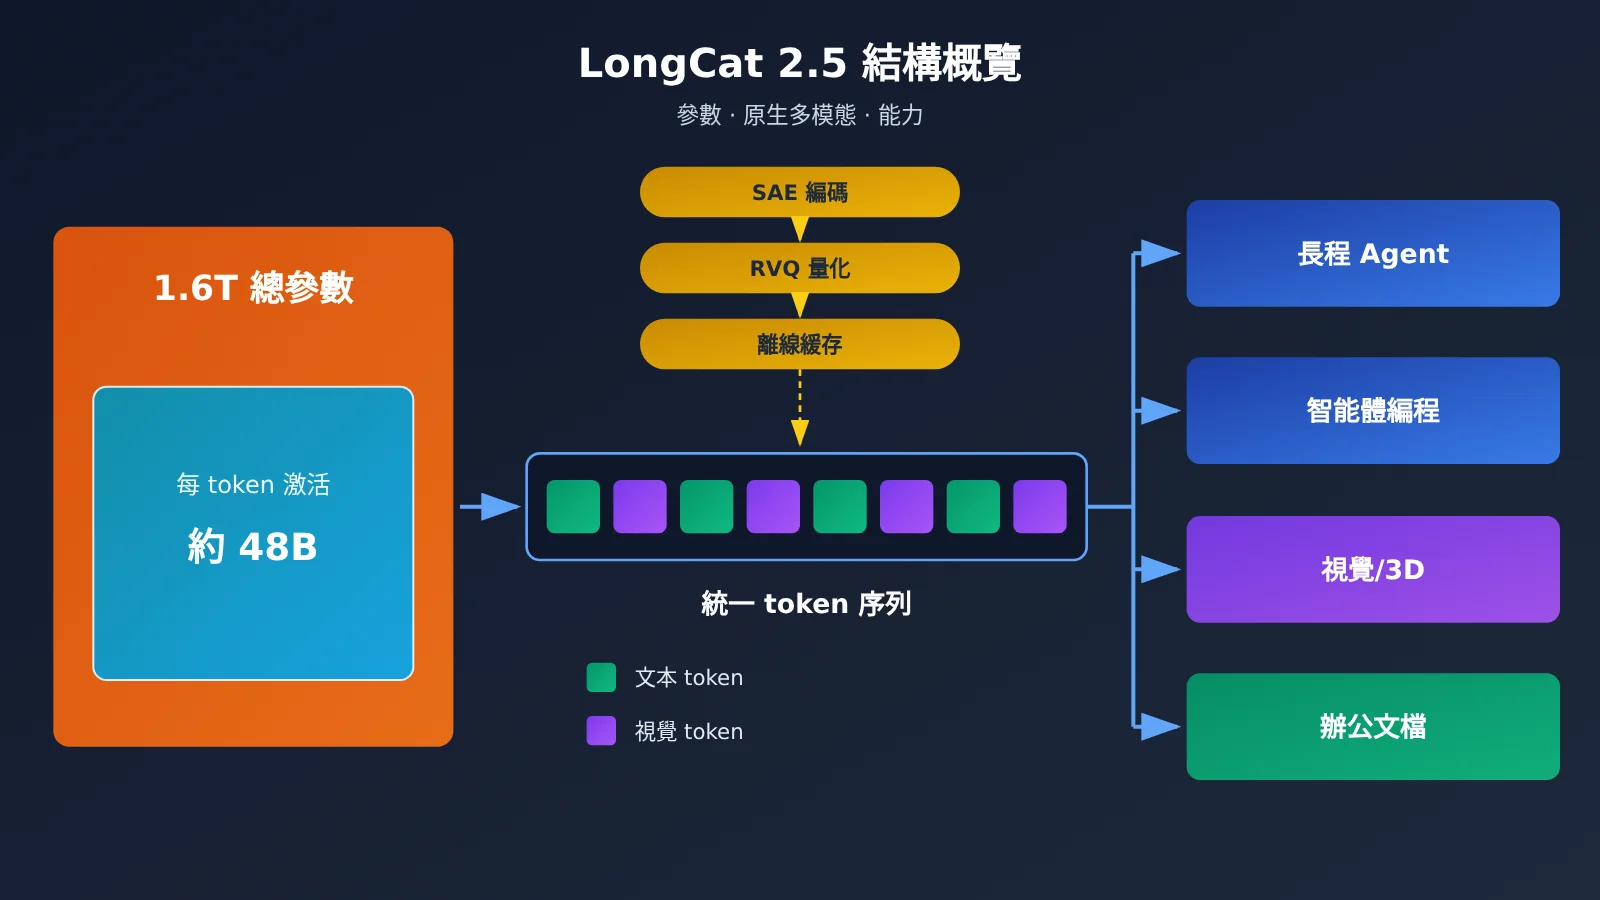
美團 LongCat 團隊(社區通用叫法)11 月 1 日發佈了 LongCat-2.5。它的總參數爲 1.6T,每個 token 激活約 48B,是一款原生多模態模型,面向長程智能體任務。和 2.0 相比,這次主要升級了原生視覺理解和智能體編程兩塊。價格是限時折扣:輸出 $1.20/百萬 tokens,未命中緩存的輸入 $0.30,命中緩存的輸入 $0.006。
這不是一篇選型對決。下面只講三件事:它是什麼,它擅長什麼活,用起來要花多少錢。跑分只作橫向參照,不下誰替代誰的結論。
核心價值:讀完你會有三樣東西。一張能力地圖,一筆能算清的賬,一條最短的上手路徑。
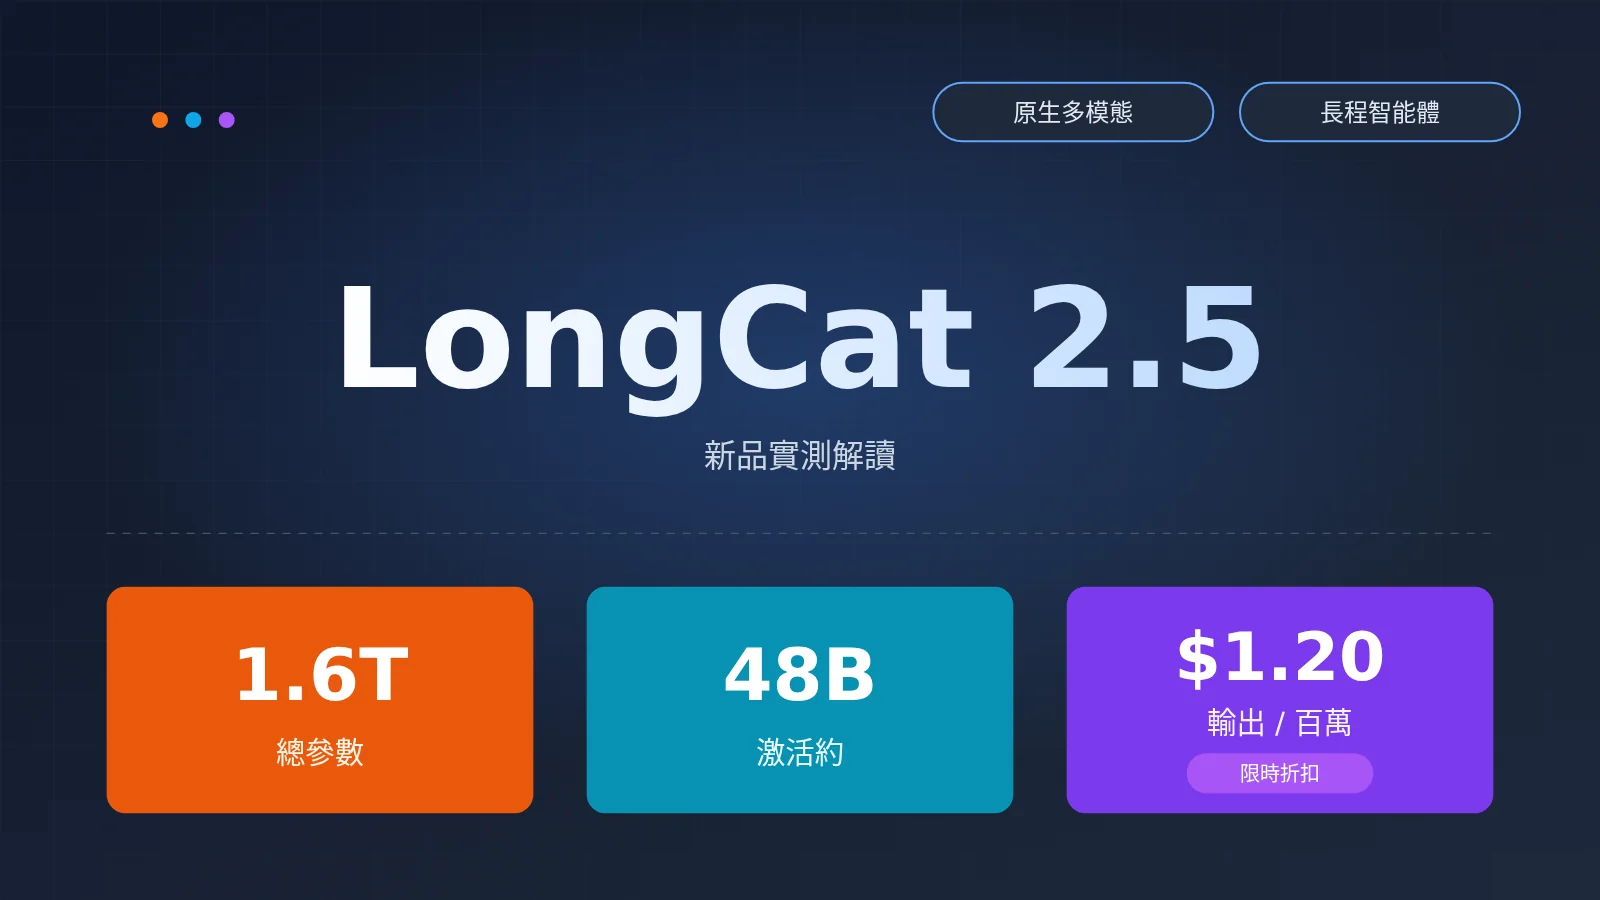
LongCat 2.5 核心信息速覽
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026-11-01(官方博客) |
| 定位 | 面向長程智能體任務的原生多模態模型 |
| 規模 | 總參數 1.6T,每個 token 激活約 48B |
| 相比 2.0 的升級 | 原生視覺理解、智能體編程 |
| 上下文 / 最大輸出 | 1M tokens / 128K tokens |
| 接口 | OpenAI 格式與 Anthropic 格式雙協議 |
| 價格(限時折扣) | 輸入 $0.30(未命中)/ $0.006(命中緩存),輸出 $1.20,單位爲每百萬 tokens |
| 權重 | GitHub 與 HuggingFace 均標「敬請期待」,尚未放出 |
激活參數有個容易混的地方。發佈當天,有社區帖把激活參數寫成了 440B,官方博客的口徑是每個 token 激活約 480 億,也就是 48B。本文一律按 48B 寫。
LongCat 2.5 是什麼:參數、架構與原生多模態
LongCat 2.5 的規模與訓練路線
總參數 1.6T、激活約 48B,說明它是稀疏激活的大模型:總量大,單次推理只調動其中一小部分。這樣的結構讓它在知識容量和推理成本之間留出了空間,也是後面價格能壓低的前提之一。
訓練路線上,官方點了幾條和「長程任務」直接相關的做法:
- 更多長程軌跡數據:長序列訓練里加入更多長程軌跡,再用大規模長程強化學習,練「複雜代碼庫開發、完整項目構建」這類端到端工程任務。
- 把真實失敗軌跡變成訓練題:數據合成、環境構建、跨 Harness 混合訓練三條線一起擴,把真實 Agent 的失敗軌跡轉成可復現、可驗證的任務。
- 抑制「想太多」和「重複調用」:對重複思考、重複工具調用額外懲罰;對過度思考、長度增長過快的情況,重新分配正樣本 Reward。
第三條對 Agent 場景比較實際。長程任務裏最費錢的往往是模型在同一個工具上反覆打轉,訓練階段壓住這一點,等於直接省 token。
LongCat 2.5 的原生多模態怎麼做
「原生多模態」在這裏有具體含義。視覺信號被表示成多層級的離散 token,主幹模型用統一的 token 形式同時處理視覺和文本,不走「外掛視覺編碼器、再把特徵拼進來」的路線。
官方把它拆成三段:
- 原生分辨率視覺離散化:用語義對齊編碼器(SAE)加殘差向量量化(RVQ),把圖像切成離散 token。
- 離線視覺 token 預處理:tokenizer 固定後,視覺 token ID 可以離線預算並緩存。
- 聯合學習:視覺 embedding 與主幹模型一起訓練。
官方稱這套設計讓模型在 Visual Coding 上表現突出,並能支持創意設計、3D 等任務。後面跑分表裏的 3DCodeBench 和 Vision2Web,測的就是這類能力。
爲什麼 LongCat 2.5 能賣到這個價
官方博客花了不少篇幅講工程效率,這部分能解釋價格。訓練跑在國產算力上,單卡顯存不足 80GB,團隊用雙重分片 FSDP、混合詞表並行、動態專家複製等手段壓顯存。該 FSDP 配置在長序列 SFT 任務上,單卡吞吐比 DDP 基線高 86%。
推理端用 W4A4,專家權重和激活都量化到 4bit。官方線上壓測相對 W8A8 INT8 基線:prefill 吞吐 +43.3%,decode 吞吐 +42.77%,首 token 延遲(TTFT)-15.91%,每 token 延遲(TPOT)-19.72%。吞吐提高四成多,單位 token 的成本自然下降。
LongCat 2.5 這次強在哪:長程智能體與 8 個官方案例
LongCat 2.5 對比 2.0 的跨度
先看自己和自己比。以下數字爲 LongCat 官方自測,帶星號的對比項來自公開榜單,本節只引用 LongCat 自身兩代的分數。
- Terminal Bench v4.0:2.0 爲 3.0,2.5 爲 38.5。
- DeepSWE v1.1:2.0 爲 9.7,2.5 爲 64.6。
- Program Bench Almost Resolved:2.0 爲 2.5,2.5 爲 25.5。
- AutomationBench v1.0.6:2.0 爲 15.8,2.5 爲 51.8。
這幾項都是多步終端操作、倉庫級修復、自動化流程這類長鏈路任務。2.0 在這些項上接近空白,2.5 拉到了能參與橫向比較的區間,說明「智能體編程」這塊的升級是實打實的。官方口徑還註明:LongCat-2.5 的結果都在 thinking 開啓、temperature=1.0、top_p=0.95 下取得。
LongCat 2.5 的 8 個官方演示案例
官方放了 8 個端到端生成的案例,分兩組。需要說明,這些是官方演示,本文沒有逐個復跑。
| 類別 | 案例 | 這類活考驗什麼 |
|---|---|---|
| 軟件開發 | 實時流體模擬 | 物理計算 + 前端實時渲染 |
| 軟件開發 | 3D 文物交互展示 | 3D 場景搭建與交互邏輯 |
| 軟件開發 | 城市沙盤 | 大量對象的佈局與組織 |
| 軟件開發 | 微縮場景資產 | 3D 資產生成的細節控制 |
| 專業辦公 | 商業經營分析 | 數據讀取、指標拆解、結論成文 |
| 專業辦公 | 客戶反饋分析報告 | 非結構化文本歸類與彙總 |
| 專業辦公 | 中國風色彩美學頁 | 視覺審美與網頁排版 |
| 專業辦公 | 活動邀請函生成器 | 表單交互 + 版式設計 |
軟件開發組的四個案例有三個和 3D 直接相關,對應的正是原生視覺和 Visual Coding 這條線。辦公組則偏向「讀材料、出成品」,和跑分裏的 JobBench、GDPVal 類任務方向一致。
LongCat 2.5 跑分處在什麼位置
官方評測表一共 25 項以上,分 Code Agent、General Agent、Visual 三類。下面挑 9 項,橫向列出五個模型。
| Benchmark | LongCat-2.5 | Claude Opus 5 | GPT-5.6-Sol | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 89.1* | 88.8* | 88.2* | 88.3* |
| Terminal Bench v4.0 | 38.5 | 53.9* | 37.3* | 41.8* | 12.6* |
| DeepSWE v1.1 | 64.6 | 68.8* | 72.7* | 66.9* | 67.5* |
| BrowseComp | 91.9 | 90.8* | 90.4* | 81.0 | 91.2* |
| HLE w/tools | 63.1 | 64.7* | 58.0* | 62.5* | 56.0* |
| JobBench | 65.4 | 66.7* | 45.4* | 61.4* | 52.9* |
| MCP Atlas | 83.1 | 85.8* | 81.8* | 84.2* | 84.2* |
| 3DCodeBench Text to 3D | 55.4 | 54.3 | 52.3 | 53.4 | 49.3 |
| Vision2Web | 78.6 | 80.2* | 73.5* | 77.8* | 79.0* |
帶 * 爲官方引用的公開榜單或技術報告,其餘爲 LongCat 自測,僅作橫向參照。
只看事實,可以讀出幾點:
- 檢索類:BrowseComp 91.9,在這五列裏最高。官方用的是自研輕量 harness,只開 search 與 browse_with_goal 兩個工具,最多 1024 輪。
- 3D 生成:3DCodeBench Text to 3D 55.4,五列最高,但這一行五個分數都沒有星號,全是 LongCat 自測口徑。
- 終端任務:Terminal Bench v2.1 五個模型擠在 88.2 到 89.1 之間;到了更難的 v4.0,LongCat-2.5 爲 38.5,Claude Opus 5 爲 53.9,差 15.4 分。
- 倉庫級修復:DeepSWE v1.1 爲 64.6,是這五列裏最低的一個,GPT-5.6-Sol 爲 72.7。
- 工具調用與辦公:MCP Atlas 83.1、JobBench 65.4,和 Opus 5 分別差 2.7 和 1.3 分。
harness 也要注意。Terminal Bench 兩個版本用的是 Claude Code harness,max_seq_length 512K;DeepSWE 用 mini-swe-agent,序列長度 1M。不同 harness 下的分數不宜直接跨項比較。
LongCat 2.5 價格怎麼算:同表對比與 100 萬 token 賬單
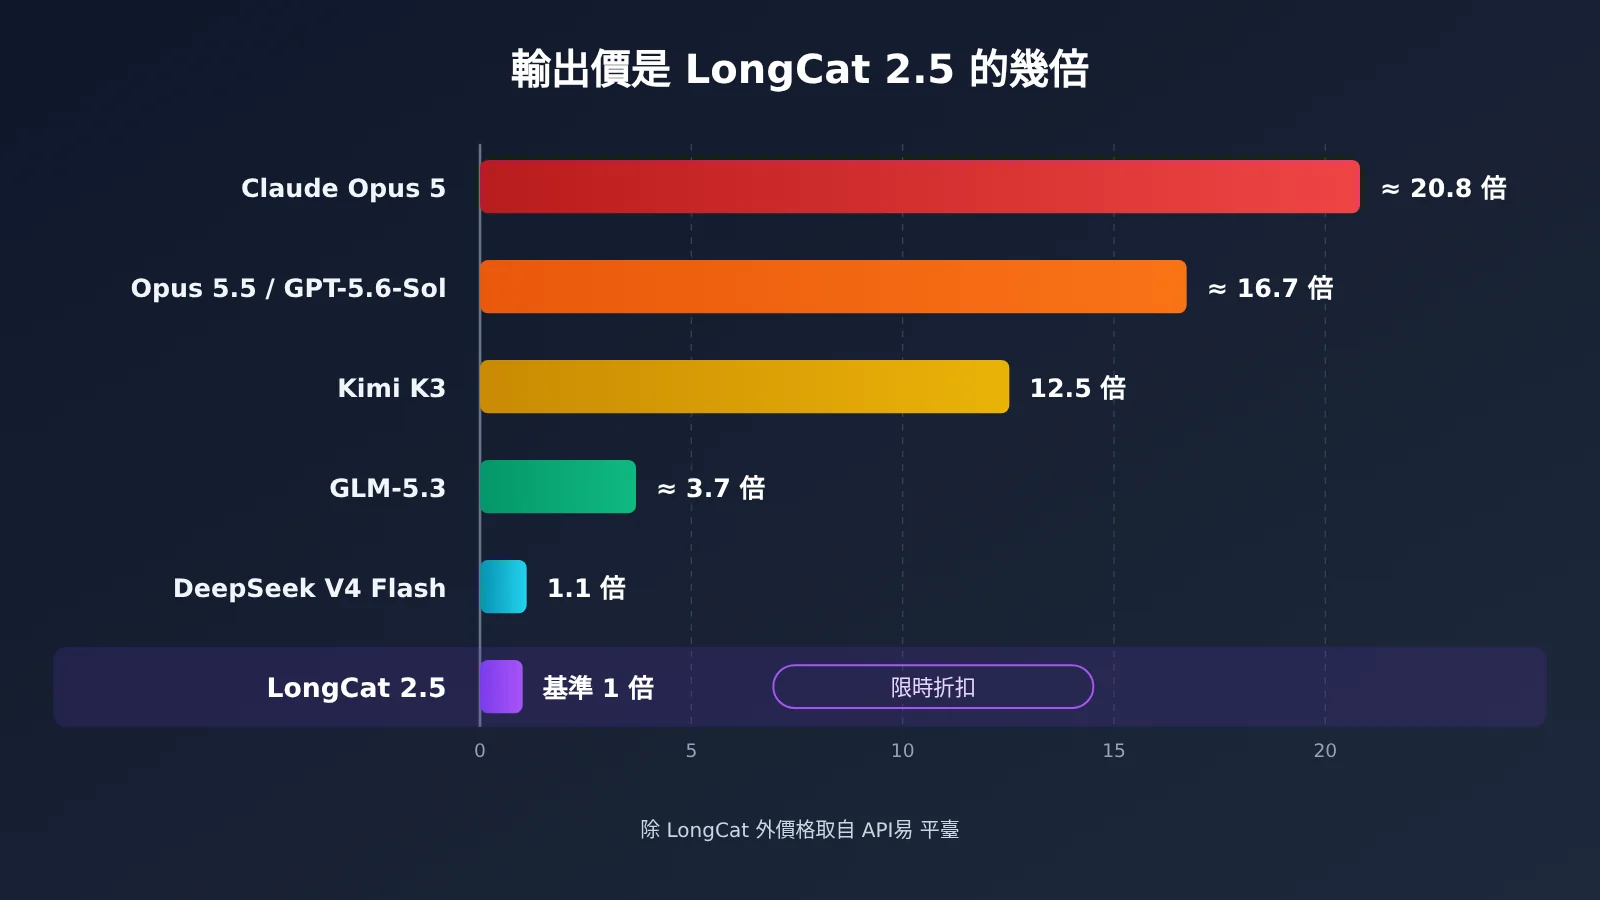
圖注:LongCat-2.5 爲官方 API 平臺的限時折扣價,其餘模型價格查自 API易 apiyi.com 平臺型號列表。
| 模型 | 輸入(每 100 萬 tokens) | 輸出(每 100 萬 tokens) | 輸出價是 LongCat 的倍數 |
|---|---|---|---|
| LongCat-2.5(限時折扣,官方平臺) | $0.30(命中緩存 $0.006) | $1.20 | 1 |
| Claude Opus 5 | $5 | $25 | 約 20.8 |
| Claude Opus 5.5 | $4 | $20 | 約 16.7 |
| GPT-5.6-Sol | $4 | $20 | 約 16.7 |
| Kimi K3 | $3 | $15 | 12.5 |
| GLM-5.3 | $1.4 | $4.396 | 約 3.7 |
| DeepSeek V4 Flash | $0.44 | $1.32 | 約 1.1 |
API易 apiyi.com 價格查於 2026-11-02,以平臺型號列表當天顯示爲準。LongCat-2.5 價格來自 LongCat API 平臺,官方註明價格可能調整。
一筆 100 萬 token 的賬
假設一個批量任務總共 100 萬 tokens:80 萬輸入、20 萬輸出,不考慮緩存。
- LongCat-2.5(限時折扣):0.8 × $0.30 + 0.2 × $1.20 = $0.48
- DeepSeek V4 Flash:$0.352 + $0.264 = $0.616
- GLM-5.3:$1.12 + $0.879 ≈ $2.00
- Kimi K3:$2.40 + $3.00 = $5.40
- GPT-5.6-Sol 或 Claude Opus 5.5:$3.20 + $4.00 = $7.20
- Claude Opus 5:$4.00 + $5.00 = $9.00
同一筆活,Opus 5 是 LongCat-2.5 的約 18.75 倍。如果任務能命中緩存,差距會更大。官方給的例子是 100 萬輸入(40 萬命中、60 萬未命中)加 50 萬輸出,賬單爲 $0.18 + $0.0024 + $0.6 = $0.7824。命中緩存的輸入只要 $0.006,是未命中的 1/50。
還有兩條計費細節值得記:只有返回 HTTP 200 才扣費,401、403、429、500 這類失敗請求不計費;餘額預付、不過期,有贈送額度時先扣贈送額度。
在多個模型之間對比時怎麼省事
一個現實情況是:Agent 項目很少只用一個模型。你可能想拿同一套提示詞,看 LongCat-2.5 和 Claude、GPT、GLM 各自的輸出差異。這時候在 API易 apiyi.com 用一個賬號一把 key 就能切換型號,不用每家單獨開戶、單獨充值。
📌 說明:型號與價格以 API易 apiyi.com 平臺型號列表爲準;API易 目前還沒上架 LongCat-2.5,會盡快推出此模型。
如何上手 LongCat 2.5:官網體驗與 API 接入
第一步:先在網頁端試
官方在線體驗入口是 longcat.ai/chat。按社區發佈帖的說法,發佈期間新用戶贈送 10M Tokens,老用戶贈送 5M Tokens,自動到賬,緩存命中不消耗贈送額度;帖中還提到一個 9.9 元的限時福利包「即將上線」。建議先拿檢索和看圖兩類任務試,這兩類在跑分裏位置靠前。
第二步:走 API,記住四個參數
- OpenAI 格式端點:
https://api.longcat.ai/openai - Anthropic 格式端點:
https://api.longcat.ai/anthropic - model 字段:
LongCat-2.5 - 上下文與輸出:1M 上下文,最大輸出 128K tokens
限流方面,官方只寫了超限返回 HTTP 429、錯誤碼 rate_limit_exceeded、retry_after 爲 60,並建議客戶端做指數退避重試。具體 RPM、TPM 沒有公開。
如果你的代碼已經在用 OpenAI SDK 調別的模型,切換時只改 base_url、api_key、model 三處。比如日常走 API易 時 base_url 是 https://api.apiyi.com/v1,切到 LongCat 官方時換成 https://api.longcat.ai/openai,model 改成 LongCat-2.5 即可。
第三步:接進 Claude Code
- Claude Code,改
~/.claude/settings.json的 env 段:ANTHROPIC_AUTH_TOKEN填 LongCat 的 API Key - 同一文件 env 段:
ANTHROPIC_BASE_URL填https://api.longcat.ai/anthropic - 同一文件 env 段:
ANTHROPIC_MODEL填LongCat-2.5 - 同一文件 env 段:
CLAUDE_CODE_MAX_OUTPUT_TOKENS填131072 - 同一文件 env 段(建議一起改):
ANTHROPIC_SMALL_FAST_MODEL、ANTHROPIC_DEFAULT_SONNET_MODEL、ANTHROPIC_DEFAULT_OPUS_MODEL都指向LongCat-2.5
後三個變量不改的話,Claude Code 內部的子任務可能仍去請求默認型號,導致報錯或走錯計費。
第四步:接進 Cline
- Cline,VS Code 側欄設置面板:API Provider 選擇 OpenAI 兼容類選項
- 同一面板:Base URL 填
https://api.longcat.ai/openai - 同一面板:API Key 填 LongCat 的 Key,Model ID 填
LongCat-2.5
LongCat 官方文檔爲 Cline 單獨提供了接入頁,字段名稱以官方頁面爲準。另外還有 Codex、OpenCode、Kilo Code、Cherry Studio、Chatbox、CC Switch 等十餘個工具的接入頁。
🚀 快速上手建議:先用官方贈送額度把任務跑通,再決定是否長期接入。如果你還需要同時調用 Claude、GPT、Gemini 做對照,可以在 API易 apiyi.com 用一套 OpenAI 兼容接口統一管理,後續 LongCat-2.5 上架後也能直接在同一賬號裏切換。
LongCat 2.5 適合幹哪些活
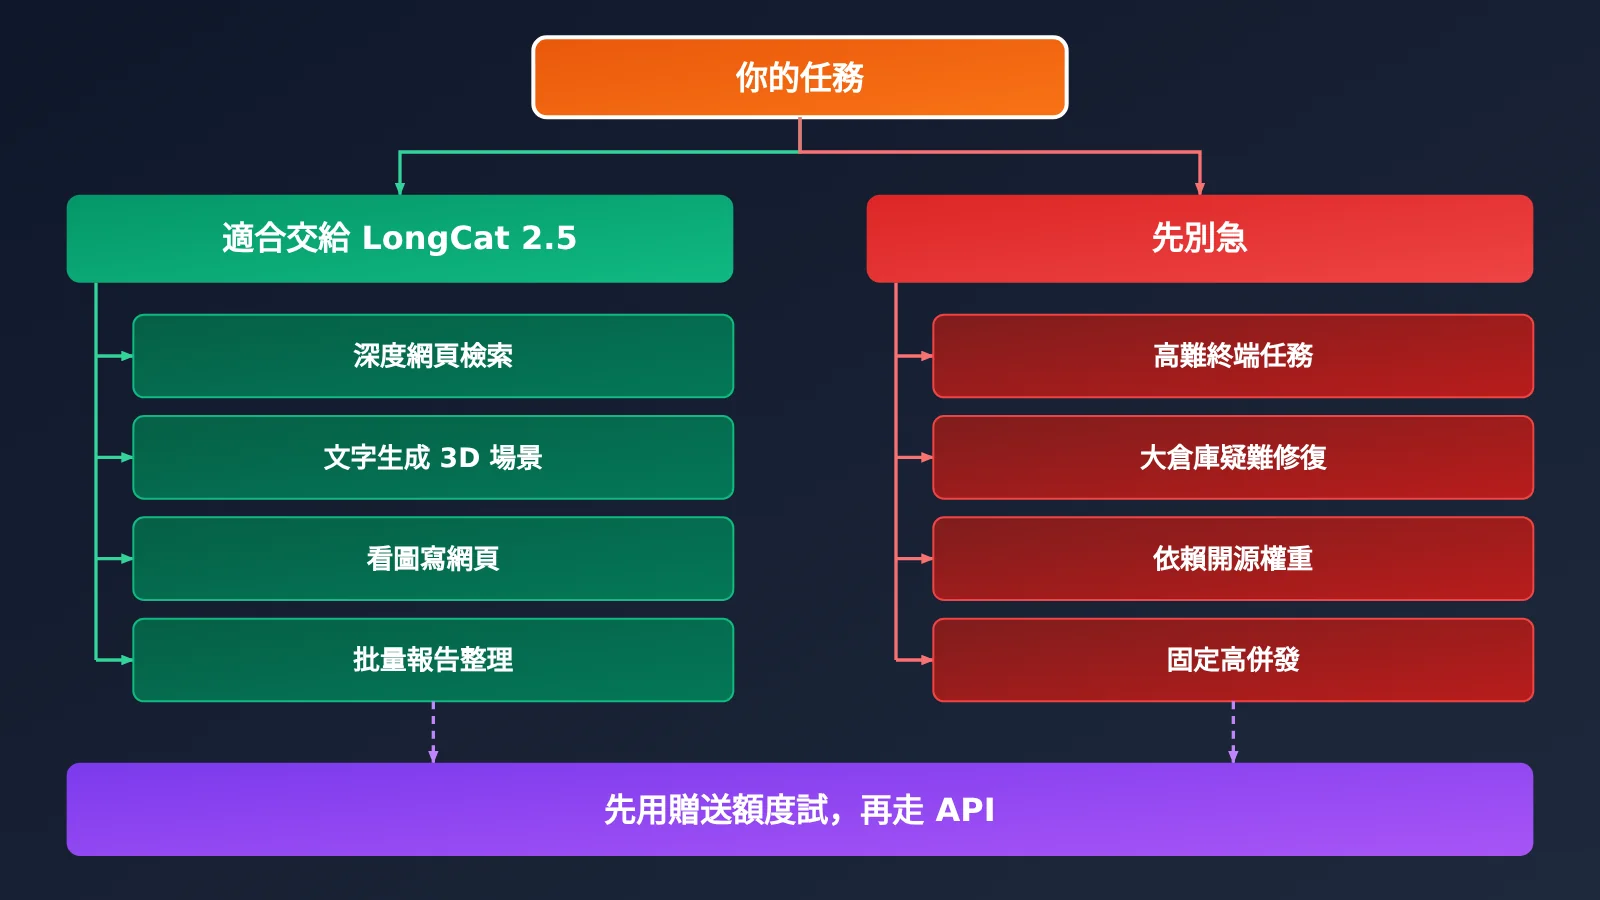
| 適合交給 LongCat 2.5 的活 | 先別急的活 |
|---|---|
| 多輪網頁檢索、彙總資料(BrowseComp 91.9) | 高難度多步終端運維任務(Terminal Bench v4.0 爲 38.5,Opus 5 爲 53.9) |
| 用文字描述生成 Three.js 等 3D 場景(3DCodeBench 55.4) | 大型倉庫的疑難 Bug 修復(DeepSWE v1.1 爲 64.6,五列中最低) |
| 給設計稿或截圖寫出對應網頁(Vision2Web 78.6) | 必須私有化部署、需要本地權重的項目(權重尚未放出) |
| 批量整理客戶反饋、經營數據併成文(JobBench 65.4,輸出限時折扣 $1.20/百萬) | 需要固定高併發配額的生產服務(官方未公開 RPM/TPM) |
左列的共同點是:任務長、token 量大、對單價敏感,LongCat-2.5 的分數和價格都站得住。右列不是說它做不了,而是分數上還有可見差距,或者部署、配額條件還不明確,適合先小規模試。
LongCat 2.5 常見問題 FAQ
Q1:LongCat 2.5 的跑分是第三方測的嗎?
不是。表裏 LongCat-2.5 自身的分數全部來自 LongCat 官方自測,對比模型中帶星號的來自公開報告或官方榜單,不帶星號的也是 LongCat 自測。閱讀時建議當作橫向參照。
Q2:$1.20/百萬 tokens 是長期價格嗎?
不是,官方標註爲限時折扣價,並說明價格可能調整,以 LongCat API 平臺頁面和賬單爲準。做長期預算時,建議同時準備一個備選模型,通過 API易 apiyi.com 這類聚合平臺保留切換餘地。
Q3:LongCat 2.5 開源了嗎?
還沒有。官方博客上的 GitHub 和 HuggingFace 按鈕都標着「敬請期待」,目前可用的只有在線體驗和 API 接入,官方沒有給出開源時間表。
Q4:能在 API易 上調用 LongCat 2.5 嗎?
目前還不能,API易 會盡快推出此模型。現階段可以直接用 LongCat 官方 API;如果要在 Claude、GPT、GLM 之間做對照測試,可以先在 API易 apiyi.com 用一把 key 跑其他模型,型號與價格以平臺型號列表爲準。
Q5:遇到 429 報錯怎麼辦?
這是觸發了限流,返回體會帶 `retry_after` 爲 60。官方建議客戶端做指數退避重試,而且 429 請求不計費,不會額外扣錢。
總結:LongCat 2.5 值不值得接
LongCat 2.5 的核心要點:
- 定位:1.6T 總參數、每 token 激活約 48B 的原生多模態模型,主打長程智能體任務。
- 升級:對比 2.0,Terminal Bench v4.0 從 3.0 到 38.5,DeepSWE v1.1 從 9.7 到 64.6。
- 長項:BrowseComp 91.9、3DCodeBench 55.4,在本文對比的五個模型中最高(官方口徑)。
- 差距:Terminal Bench v4.0 和 DeepSWE v1.1 仍有可見差距。
- 價格:限時折扣輸出 $1.20/百萬,80 萬輸入加 20 萬輸出的賬單約 $0.48。
- 接入:OpenAI、Anthropic 雙協議,Claude Code 改四個變量即可。
能帶走的一句話:先在 longcat.ai/chat 用贈送的 10M 額度試檢索和看圖任務,跑通再走 API;要長期在多個模型之間切換,就放 API易 apiyi.com 一起管。
📚 參考資料
- LongCat 官方博客:LongCat-2.5 發佈文章,含架構、訓練、評測表
- 鏈接:
longcat.ai/blog/longcat-2.5 -
說明:參數規模、8 個演示案例、跑分口徑的一手來源
-
LongCat API 平臺文檔:接口、計費與工具接入
- 鏈接:
longcat.ai/platform/docs -
說明:雙協議端點、限時折扣價、Claude Code 與 Cline 接入頁
-
API易 型號列表:各模型平臺價格
- 鏈接:
docs.apiyi.com/models - 說明:本文對比價格的來源,以當天顯示爲準
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心