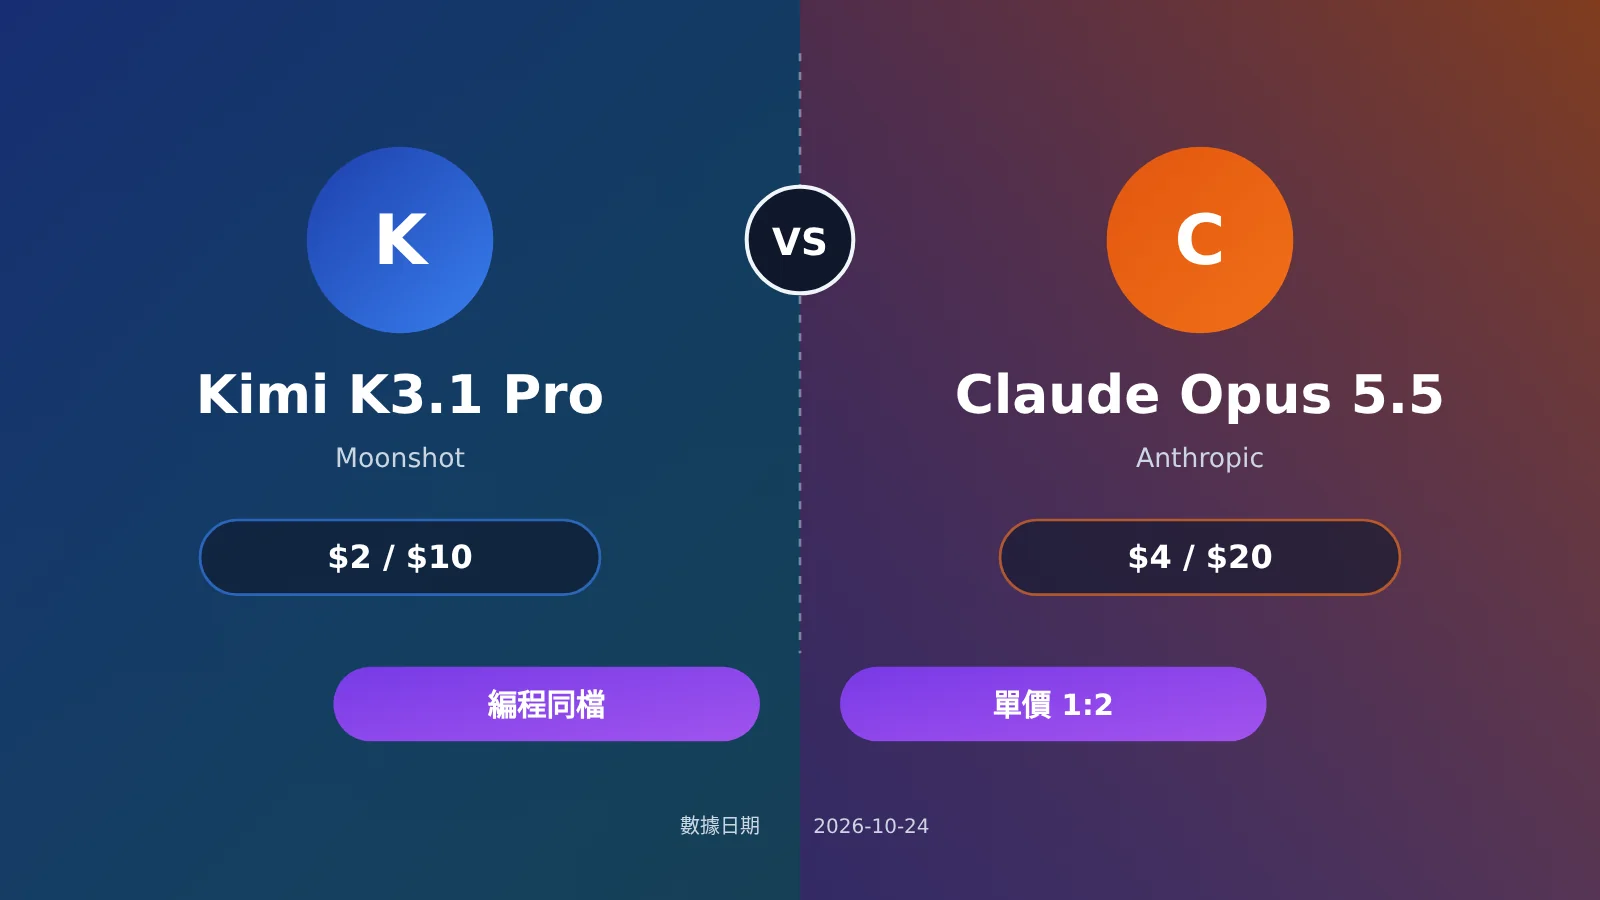
先說結論:Kimi K3.1 Pro 和 Claude Opus 5.5 的編程能力在同一檔。Moonshot 官方自報的 Terminal-Bench 4.0 成績中,K3.1 Pro 爲 65.7%,Opus 5.5 爲 66.4%,前者落後約 0.7 個百分點;第三方 Artificial Analysis 單看 Terminal-Bench 4.0,反而是 K3.1 Pro 最高。價格上,K3.1 Pro 的輸入和輸出單價正好是 Opus 5.5 的一半($2/$10 對 $4/$20),緩存命中價兩者相同。不過 K3.1 Pro 的思考過程更長,按第三方測算,實際單任務成本並沒有便宜到一半。
下文所有數據都標了來源,分三檔:官方自報(Moonshot 博客、Kimi 與 Anthropic 官方文檔)、第三方(Artificial Analysis,下稱 AA)、未覈實(目前沒有公開數據,只能給方向性判斷)。文中的 token 可以理解爲模型計費時的“字數單位”,一個漢字大約對應 1 個多 token,所有價格都按“每百萬 tokens 多少美元”計算。
本文不會寫成“誰吊打誰”。 兩款模型各有長處和短板,我們只按口徑擺數據,再給出不同場景下的選擇建議。
核心價值:讀完本文,你能判斷自己的任務該用 Kimi K3.1 Pro 還是 Claude Opus 5.5,也知道兩者真實的成本差距有多大。
1. Kimi K3.1 Pro vs Claude Opus 5.5 核心差異速覽
先用一張表把最關鍵的差異列出來,後面各節再逐項展開。“來源檔位”一列標明瞭每個數字出自哪裏,方便自行覈對。
| 對比維度 | Kimi K3.1 Pro | Claude Opus 5.5 | 來源檔位 |
|---|---|---|---|
| Terminal-Bench 4.0(官方口徑) | 65.7% | 66.4% | 官方自報(Moonshot 博客) |
| Terminal-Bench 4.0(AA 口徑) | 67%,AA 被測模型中最高 | 參考資料未列出 | 第三方(AA) |
| 輸入 / 輸出單價 | $2 / $10 | $4 / $20 | 官方定價 |
| 緩存命中價 | $0.20 | $0.20 | 官方定價 |
| 上下文長度 | 1,048,576 tokens | 最高 1M(因模型而異) | 官方文檔 |
| 思考能否關閉 | 不能,只能調強度 | 以 Anthropic 文檔爲準 | 官方文檔 / 未覈實 |
| 開放權重 | 承諾 2026-11-04 前放出 | 不開放 | 官方自報 |
“上下文”指模型一次能讀進去的內容總量。兩款模型都在百萬 token 量級,整個中型代碼倉庫基本可以一次放進去,所以這一項不會成爲選擇時的關鍵差異。
2. Kimi K3.1 Pro vs Claude Opus 5.5 價格對比:5 檔單價並列
先解釋兩個計費名詞。緩存命中:你反覆發送同一段開頭內容(比如系統提示詞或代碼倉庫摘要),模型方會把它存起來,再次讀取時按很低的價格計費。緩存寫入:第一次把這段內容存進緩存時收的費用,存 5 分鐘和存 1 小時價格不同。
| 模型 | 輸入 | 輸出 | 緩存命中 | 緩存寫入 5 分鐘 | 緩存寫入 1 小時 |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $5.00 | $8.00 |
| Claude Sonnet 5.5(參照) | $2.00 | $10.00 | $0.10 | $2.50 | $4.00 |
價格說明:2026-10-24 抓取,單位爲美元/百萬 tokens,不含稅。來源爲 Kimi 官方定價與 Anthropic 官方定價。
2.1 價格差幾倍:輸入輸出差 2 倍,緩存命中差 1 倍
輸入和輸出這兩項,Opus 5.5 正好是 K3.1 Pro 的 2 倍。緩存命中價兩家都是 $0.20,沒有差別。緩存寫入這一項 Kimi 更便宜,5 分鐘檔是 $2 對 $5,1 小時檔是 $4 對 $8。
把 Claude Sonnet 5.5 放進來做參照,會發現它的輸入、輸出單價和 K3.1 Pro 完全一樣,緩存命中價還只有一半($0.10)。所以如果你只是想要“便宜一些的旗艦檔”,Kimi 的直接比較對象其實是 Sonnet 5.5,而不只是 Opus 5.5。
2.2 兩款模型各有一個高速檔
兩家都提供速度更快、價格更高的版本,選型時不要拿錯版本比較:
kimi-k3.1-pro-highspeed:$4 / $20,緩存命中 $0.20,5 分鐘寫入 $4,1 小時寫入 $8(官方定價)- Claude Opus 5.5 Fast 模式:$8 / $40,覆蓋全長上下文,包括超過 200k 的部分(官方定價)
可以看到,Kimi 高速版的輸入輸出單價和普通版 Opus 5.5 一樣,但 5 分鐘緩存寫入仍然便宜一些。
3. Kimi K3.1 Pro vs Claude Opus 5.5 編程跑分:2 條口徑分開看
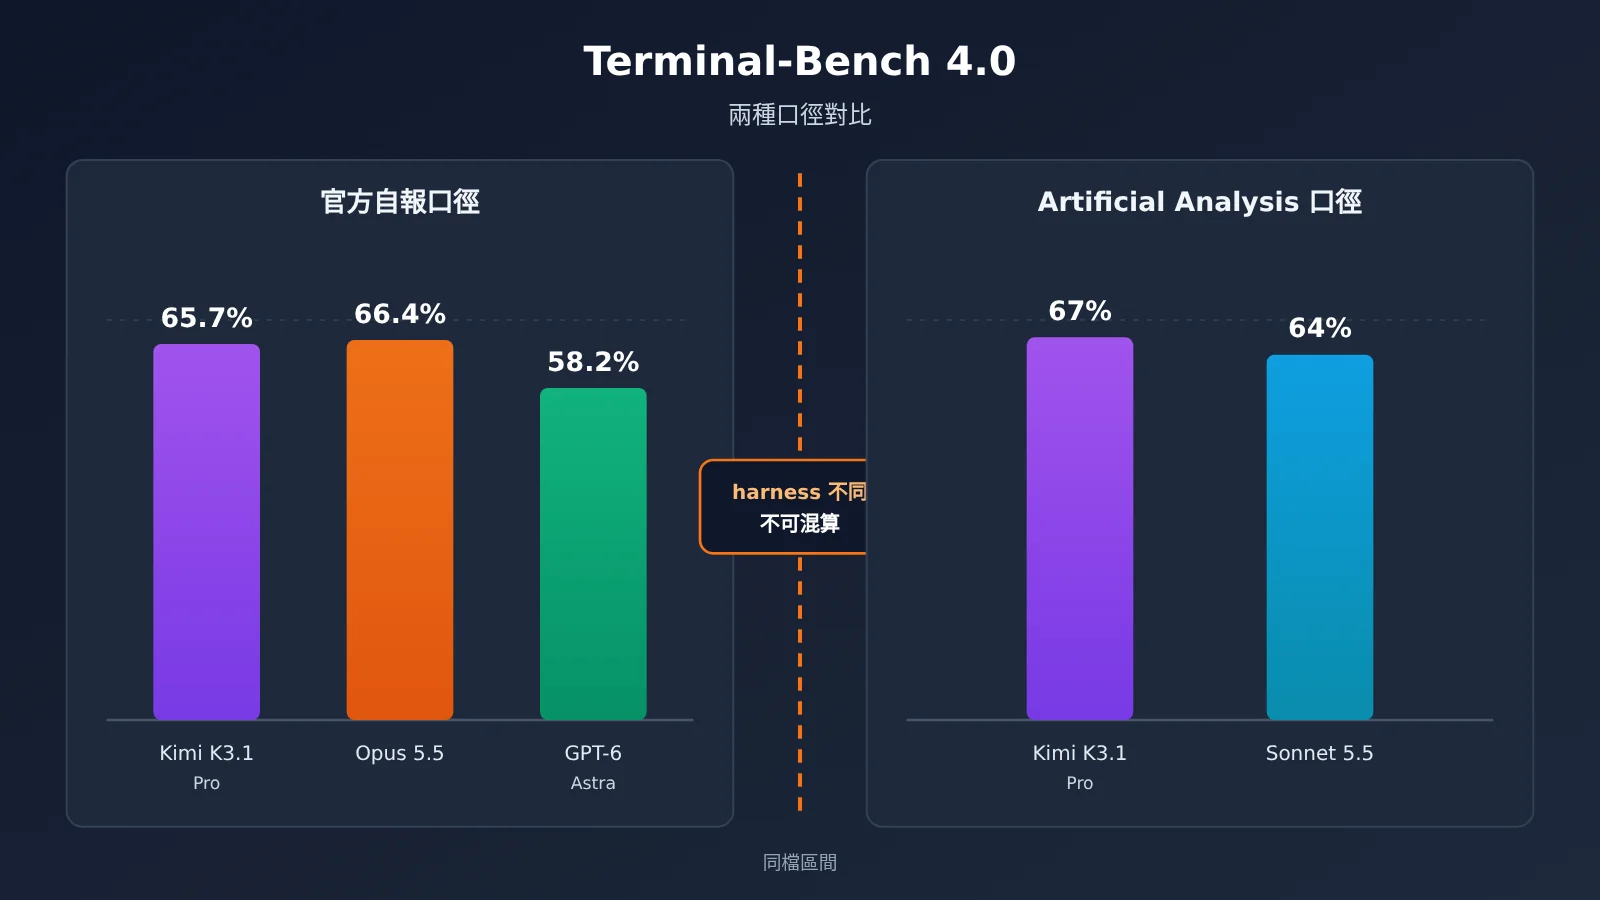
Terminal-Bench 4.0 是一套在終端裏完成真實任務的測試,比如裝依賴、修 bug、跑通腳本,只有最終結果正確纔算通過。下面兩張表分別來自兩個不同的機構,數字不能互相比較。
3.1 官方自報口徑(Moonshot 博客)
| 測試項 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| BenchCAD(多視圖生成 CAD 代碼做 3D 重建) | 92.7%(帶工具) | 96.2% | — |
測試條件爲 reasoning_effort 設爲 max(即思考強度開到最高),K3.1 Pro 使用 Claude Code 的 harness 運行。Moonshot 在博客中自己的說法是“narrowly behind Claude Opus 5.5”,也就是略落後於 Opus 5.5。
3.2 第三方口徑(Artificial Analysis,2026-10-23)
| 測試項 | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index(綜合智能指數) | 55(第 4) | 58 | 56 |
| Terminal-Bench 4.0 | 67%(全場最高) | 參考資料未列出 | 64% |
| GDPval-AA(Elo) | 1846(第 3) | 1866 | — |
| AA-Omniscience(知識可靠性) | 指數 30,幻覺率 44% | 參考資料未列出 | — |
Opus 5.5 的綜合指數測試條件爲“max with fallback”。同榜的 Muse Wonder Full 也是 56 分。Elo 是一種類似棋類積分的算法,由兩兩對比的勝負換算而來,分數越高越好。幻覺率可以簡單理解爲模型在答不上來時編造答案的比例,這一項 K3.1 Pro 的 44% 值得留意。
3.3 爲什麼兩條口徑不能混在一起算
官方的 65.7% 和 AA 的 67% 都是 K3.1 Pro 的 Terminal-Bench 4.0 成績,但測試用的 harness 不同。harness 可以理解爲“帶模型考試的那套外殼程序”,它決定模型能用哪些工具、怎樣讀寫文件、超時多久。外殼換了,同一個模型的分數也會變。
所以不能說“K3.1 Pro 在 AA 拿了 67%,比官方給 Opus 的 66.4% 高”。正確的讀法是:在官方口徑下,K3.1 Pro 略低 0.7 個百分點;在 AA 口徑下,K3.1 Pro 是該機構測過的模型裏最高的。兩個結論各自成立,放在一起只能說明兩款模型處在同一個區間。
3.4 分數差 1 個點在實際開發裏意味着什麼
Terminal-Bench 4.0 按任務嚴格判分,結果只有通過和不通過。1 個百分點大約相當於每一百道題多做對或少做對一道,而且這些差距往往出現在少見的長尾任務上,比如冷門工具鏈或特殊環境配置。日常寫接口、改業務代碼、補單元測試時,這麼小的差距基本感受不到。
真正影響開發體驗的,是兩個“性格”上的差別。第一是思考風格:K3.1 Pro 始終開啓思考,AA 觀測到它每個任務的輸出更長(第三方)。第二是工具調用習慣,比如模型多久調用一次命令、是否傾向於先讀文件再修改,這方面目前沒有可靠的公開對比數據(未覈實),建議用你自己的倉庫跑幾個真實任務來判斷。
4. Kimi K3.1 Pro 與 Claude Opus 5.5 的優缺點
Kimi K3.1 Pro 的優勢(官方文檔):
- 輸入、輸出單價是 Opus 5.5 的一半,緩存寫入也更便宜
- 1,048,576 tokens 上下文,
max_completion_tokens默認 131072,最大可到 1048576 - 同時兼容 OpenAI 和 Anthropic 兩種接口格式,官方推薦用在 Kimi Code、Codex、Claude Code 這類編程 Agent 裏
- 支持結構化輸出、工具調用和
partial續寫;API 客戶可以選擇零數據保留,官方承諾 2026-11-04 前放出完整權重
Kimi K3.1 Pro 的限制(官方文檔 + 第三方):
- 思考關不掉,
reasoning_effort只能設爲low/high/max,默認爲max temperature固定爲 1.0、top_p固定爲 0.95,這些參數不能自行傳入- 圖片輸入不支持公共 URL,只能傳 base64 編碼(把圖片轉成一長串文本)或
ms://file-id - AA 測得幻覺率 44%,單任務輸出偏長
Claude Opus 5.5 的優勢:官方跑分和 AA 綜合指數都排在前面,BenchCAD 領先約 3.5 個百分點,GDPval-AA 也更高;提供 1 小時緩存檔和 Fast 模式,可以根據需要在速度和成本之間調整。它的限制主要是價格,輸入輸出是 K3.1 Pro 的 2 倍,Fast 模式還要再翻一倍。
5. Kimi K3.1 Pro vs Claude Opus 5.5 場景推薦:6 類任務怎麼選
“Agent”指能自己規劃步驟、調用工具、多輪執行任務的模型應用,比如自動改代碼再跑測試的編程助手。
| 任務類型 | 推薦 | 一句話結論 |
|---|---|---|
| 大批量離線任務 | Kimi K3.1 Pro | 單價低一半,緩存寫入也便宜,跑批量任務時省錢效果最明顯 |
| 多輪編程 Agent | 兩者都可以,建議實測 | 跑分在同檔,主要看思考長度和工具調用習慣是否適合你的倉庫 |
| 3D / CAD 代碼生成 | Claude Opus 5.5 | 官方自報 BenchCAD 成績 96.2% 對 92.7%,Opus 5.5 更穩 |
| 圖像理解 | 按接入方式選 | K3.1 Pro 支持圖片,但不能直接傳公共 URL;兩者的圖像能力缺少同口徑數據(未覈實) |
| 對穩定性和合規有要求的企業場景 | 偏向 Claude Opus 5.5;有數據管控需求時可以看 Kimi | Opus 5.5 綜合指數更高;Kimi 提供零數據保留,且即將開放權重 |
| 需要關掉思考的低延遲場景 | Claude 一側 | K3.1 Pro 關不掉思考;Claude 的思考設置以 Anthropic 文檔爲準,也可以考慮 Fast 模式 |
6. Kimi K3.1 Pro vs Claude Opus 5.5 成本算賬:單價減半不等於成本減半
先算一筆簡單的賬:同樣一次請求,輸入 5 萬 tokens、輸出 5 千 tokens。
- Kimi K3.1 Pro:5 萬 × $2 ÷ 100 萬 + 5 千 × $10 ÷ 100 萬 = $0.10 + $0.05 = $0.15
- Claude Opus 5.5:5 萬 × $4 ÷ 100 萬 + 5 千 × $20 ÷ 100 萬 = $0.20 + $0.10 = $0.30
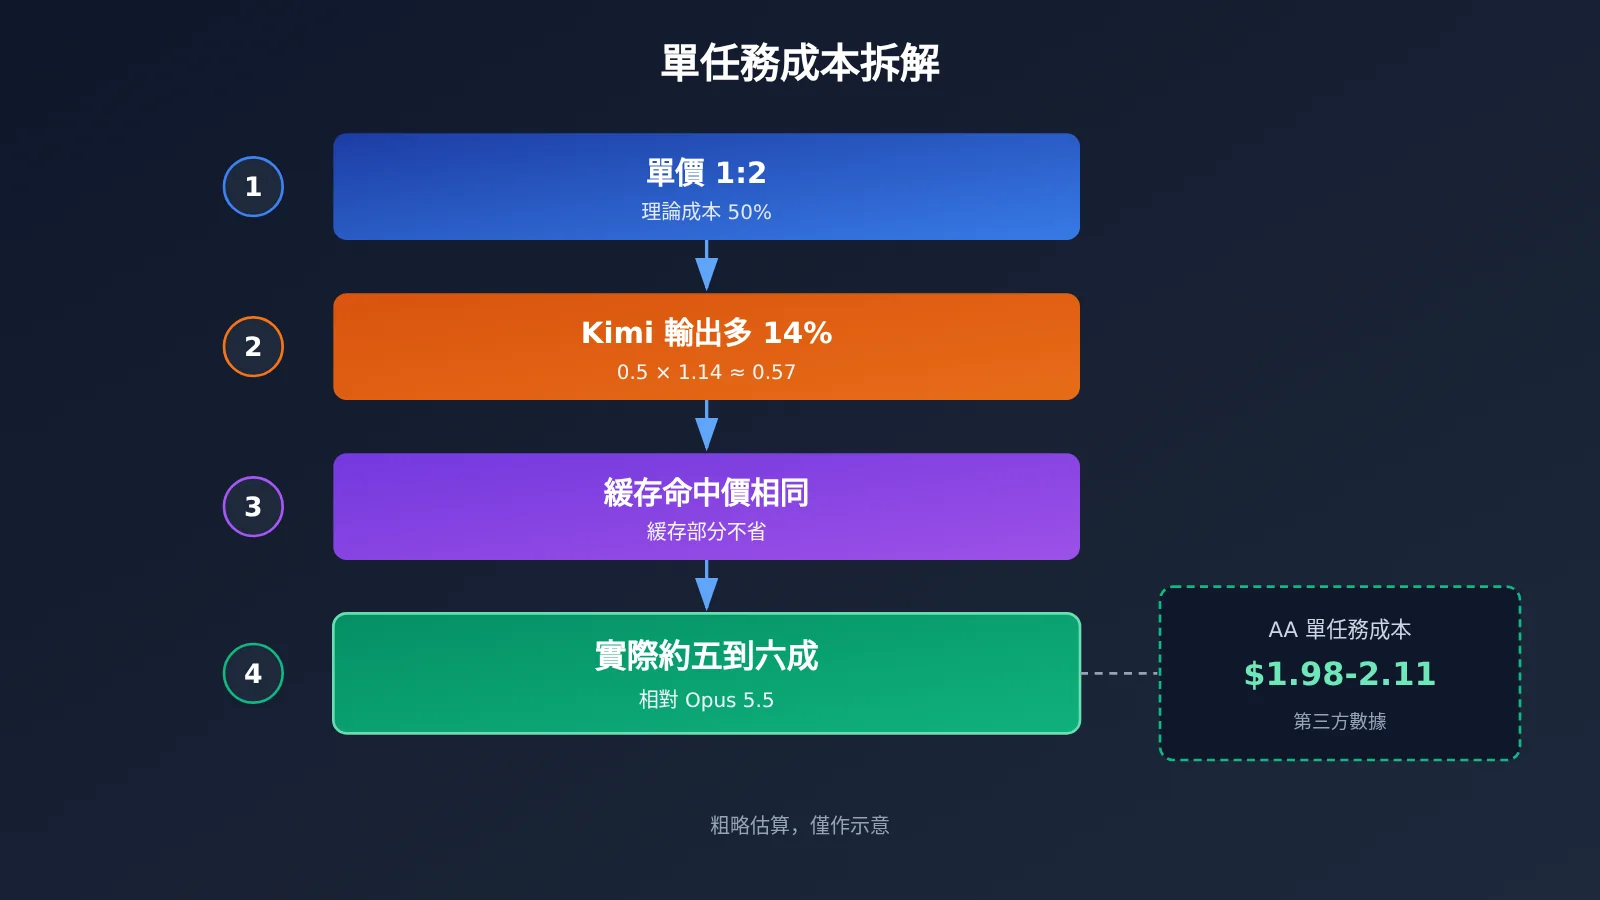
按單價算正好是一半。但這裏有個前提:兩個模型的輸出一樣長。實際情況並非如此。AA 的數據顯示,Kimi 每個任務的輸出 tokens 多出約 14%,平均每任務輸出約 55K tokens,單任務成本約 $1.98(模型頁上顯示爲 $2.11)(第三方)。AA 的結論是:Kimi 的單價雖然只有 Opus 5.5 的一半,但思考過程更囉嗦,實際單任務成本並沒有便宜一半。
做一個粗略估算(未覈實,僅作示意):編程 Agent 任務的成本主要來自輸出,如果 Kimi 的輸出多 14%,那麼輸出部分的花費大約是 Opus 5.5 的 1.14 × 0.5 ≈ 57%,節省幅度在四成多,而不是一半。不過省下四成也很可觀,只是做預算時不要按五成去算。
7. 國內如何調用 Kimi K3.1 Pro 與 Claude Opus 5.5
國內開發者直接對接海外官方接口,常會遇到支付和網絡兩方面的問題。API易(apiyi.com)是一個 API 聚合平臺,用一個 API Key 就能調用多家模型,接口兼容 OpenAI 格式,按量計費。截至 2026-10-24 覈對,平臺上 claude-opus-5-5 的價格爲輸入 $4、輸出 $20、緩存讀取 $0.2,claude-sonnet-5-5 爲 $2 / $10 / $0.1,均與 Anthropic 官方一致。Kimi 系列目前已上線的型號包括:
kimi-k3:$3 / $15,緩存讀取 $0.3kimi-k2.7-code:$0.95 / $3.99kimi-k2.6:$0.6 / $2.4kimi-k2.5:$0.6 / $3.15
kimi-k3.1-pro 當天還不在列表中,它在 API易 的型號名和價格請以平臺型號列表爲準,我們會盡快推出此模型。接入方式如下:
- OpenAI 兼容格式:
base_url填寫https://api.apiyi.com/v1 - Anthropic 格式:base 地址填寫
https://api.apiyi.com - 編程 Agent(如 Claude Code)一般走 Anthropic 格式,普通 SDK 走 OpenAI 格式
快速上手建議:可以先在 API易 apiyi.com 用新用戶免費額度,拿
claude-opus-5-5和claude-sonnet-5-5在你自己的倉庫裏跑幾個真實任務,作爲對比基線。具體型號與價格以平臺型號列表爲準,Kimi K3.1 Pro 我們會盡快推出,上線後切換模型名就能直接對比。
8. Kimi K3.1 Pro vs Claude Opus 5.5 決策建議
如果你的任務量大、預算敏感,並且能接受模型一直開着思考,Kimi K3.1 Pro 的性價比更好。如果你看重綜合穩定性,需要做 3D/CAD 生成,或者需要關閉思考來換取低延遲,Claude 一側(Opus 5.5 或 Sonnet 5.5)更合適。多輪編程 Agent 這一類,兩者跑分同檔,與其看榜單,不如直接拿自己的代碼庫測一週。
還有一個容易忽略的選項:如果你主要是衝着“便宜一半”去看 Kimi,那麼 Claude Sonnet 5.5 的輸入輸出單價和它完全一樣,緩存命中價更低,AA 綜合指數也略高一些,可以一起放進候選名單。
常見問題 FAQ
Q1:Kimi K3.1 Pro 和 Claude Opus 5.5 的編程能力到底差多少?
按 Moonshot 官方自報,Terminal-Bench 4.0 上 K3.1 Pro 落後 0.7 個百分點(65.7% 對 66.4%);按 AA 的第三方測試,K3.1 Pro 在 Terminal-Bench 4.0 上是所有被測模型中最高的。兩者屬於同一檔,差距大致在 1-3 個百分點。
Q2:價格差幾倍?
輸入、輸出單價差 2 倍,緩存命中價相同(都是 $0.20),緩存寫入 Kimi 更便宜。考慮到 Kimi 輸出更長,實際單任務成本大約是 Opus 5.5 的五到六成(估算)。
Q3:官方 65.7% 和 AA 的 67% 爲什麼不一樣?
兩者用的測試外殼(harness)不同,官方使用 Claude Code harness。不同口徑下的分數只能各自比較,不能放在一起比大小。
Q4:Kimi K3.1 Pro 能關掉思考嗎?
不能。只能把 `reasoning_effort` 調低到 `low`,`temperature` 和 `top_p` 也是固定值。對延遲要求很高的場景,建議考慮 Claude 一側的模型。
Q5:國內怎麼同時調用這兩款模型做對比?
可以通過 API易 apiyi.com 用同一個 Key 調用 `claude-opus-5-5`,`base_url` 填 `https://api.apiyi.com/v1` 即可。Kimi K3.1 Pro 的型號名與價格以平臺型號列表爲準,我們會盡快推出此模型,在此之前可以先用 `kimi-k3` 做初步對照。
Q6:新手先選哪個練手比較划算?
建議先用 Claude Sonnet 5.5 建立基線,它的單價和 K3.1 Pro 相同。在 API易 apiyi.com 註冊後有免費測試額度,具體型號與價格以平臺型號列表爲準;K3.1 Pro 我們會盡快推出,上線後可以直接切換模型名進行對比。
Kimi K3.1 Pro vs Claude Opus 5.5 核心要點 Key Takeaways
- 編程同檔:官方口徑 K3.1 Pro 低 0.7 個百分點,AA 口徑 K3.1 Pro 的 Terminal-Bench 4.0 最高
- 單價 1:2:$2/$10 對 $4/$20,緩存命中價同爲 $0.20
- 成本不減半:Kimi 每任務輸出多約 14%,AA 測得單任務成本 $1.98-2.11
- 口徑不混算:官方 65.7% 與 AA 67% 使用的 harness 不同
- Opus 強項:綜合指數、BenchCAD、GDPval-AA 領先
- Kimi 限制:思考關不掉,圖片不能傳公共 URL,幻覺率 44%
- 上手方式:可在 API易 apiyi.com 先測 Claude 系列,K3.1 Pro 的型號與價格以平臺列表爲準,我們會盡快推出
總結
Kimi K3.1 Pro 與 Claude Opus 5.5 的對比,可以歸結爲三點:
- 能力:編程和 Agent 能力在同一檔,分數差距落在測試誤差和口徑差異的範圍內
- 價格:單價正好差 2 倍,但 Kimi 思考更長,實際成本大約省四成多
- 選型:批量任務和預算敏感場景優先考慮 Kimi;3D/CAD、低延遲、綜合穩定性要求高的場景優先考慮 Claude
最可靠的判斷方式,還是用你自己的任務實測。可以先在 API易 apiyi.com 用 Claude 系列跑出基線,型號與價格以平臺型號列表爲準;Kimi K3.1 Pro 我們會盡快推出,上線後切換模型名即可對比。
參考資料
- Moonshot 官方博客與 Kimi API 文檔:K3.1 Pro 跑分、參數限制、定價
- 鏈接:
platform.moonshot.cn/docs -
說明: 官方自報的 Terminal-Bench 4.0、BenchCAD 成績和參數說明
-
Anthropic 官方定價:Claude Opus 5.5 / Sonnet 5.5 五檔價格
- 鏈接:
anthropic.com/pricing -
說明: 含 Fast 模式與 1 小時緩存檔
-
Artificial Analysis:第三方綜合指數與單任務成本
- 鏈接:
artificialanalysis.ai -
說明: 2026-10-23 數據,含 Terminal-Bench 4.0、GDPval-AA、AA-Omniscience
-
API易 型號列表:平臺型號與價格
- 鏈接:
docs.apiyi.com/models - 說明: 2026-10-24 覈對,以實時列表爲準
作者:APIYI 技術團隊
技術交流:更多資料可訪問 docs.apiyi.com 文檔中心,型號與價格以平臺型號列表爲準;Kimi K3.1 Pro 我們會盡快推出此模型。