摘要:Google Decisions API 對固定選項直接打分,不生成文本。本文用公開價格測算它在分類、審覈、路由任務中的成本,並結合官方與第三方數據說明它的適用邊界。
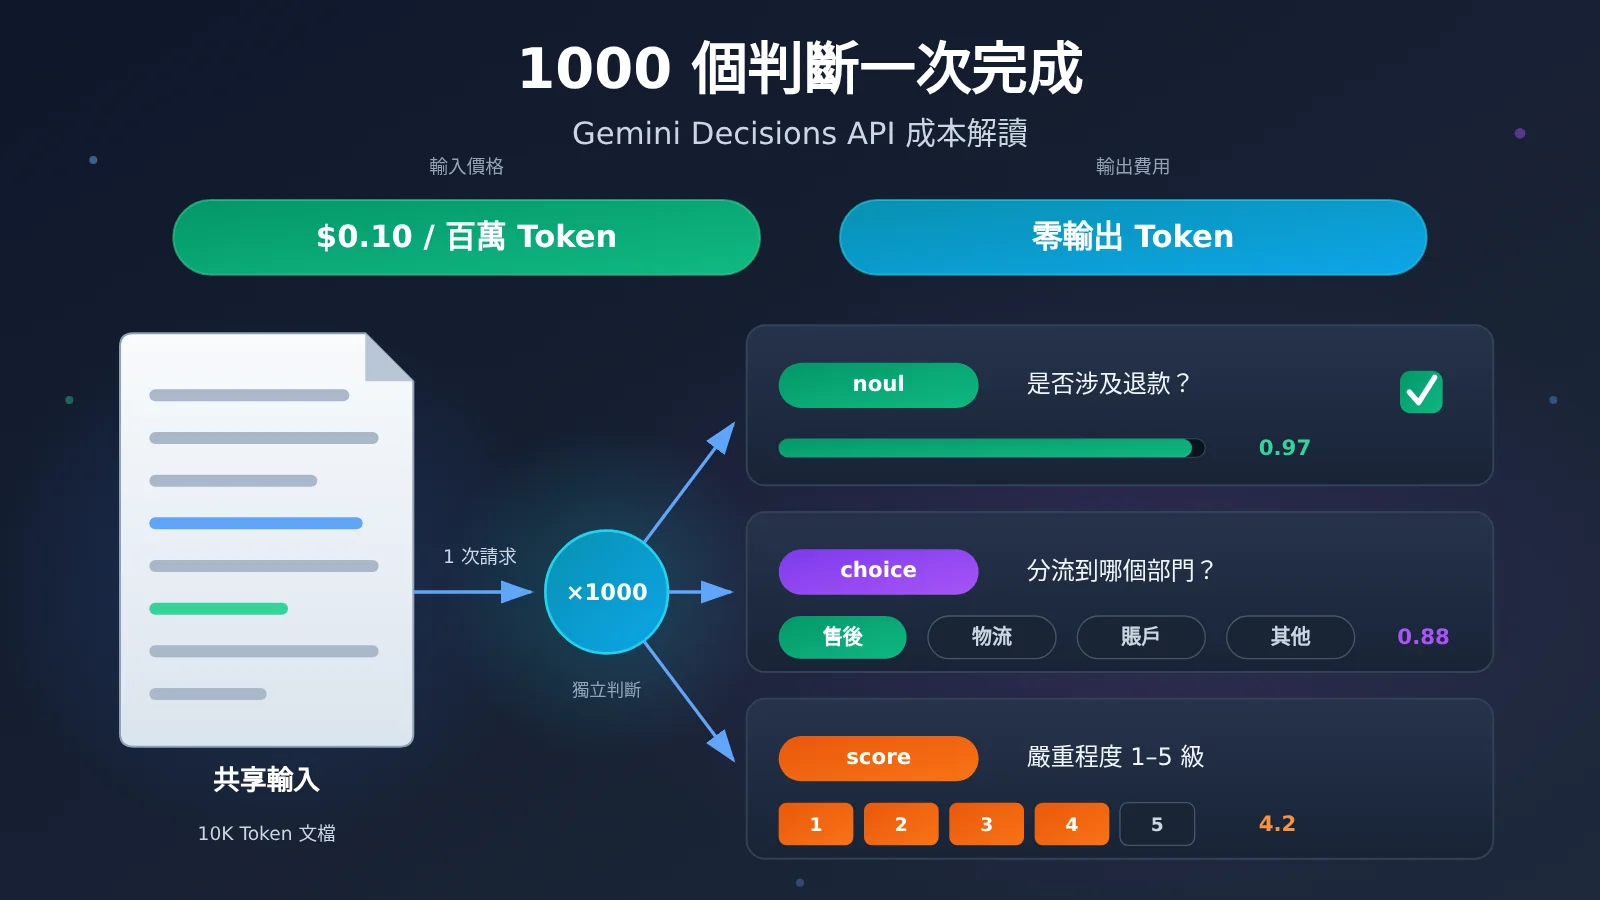
結論先行:Google 於 2026 年 11 月 11 日發佈 Gemini Decisions API(模型 ID gemini-decision-1)。它可以在一次請求中對同一份輸入完成 1 到 1,000 個獨立判斷,輸入價格爲每百萬 Token 0.10 美元,沒有生成式輸出 Token 費用。按公開價格測算,同一份 10K Token 文檔檢查 1,000 條規則時,費用約爲 Gemini 3.5 Flash-Lite 的 1/20,理論節省 94.9%。1,000 條消息各分類一次,理論節省 73.1%。Google 官方測試給出的成本優勢約爲 4.7 倍。第三方單題實測中,這一優勢約爲 1.5 倍。只做分類、審覈、路由,且答案能提前限定在固定選項內的任務,最適合用它降低成本。
後文先說明這個接口的工作機制和三種判斷類型,再用可復算的公式測算三種典型業務的費用,並解釋官方“約 5 倍”和第三方實測之間的差距。之後對照 Google 公佈的速度數據和 Artificial Analysis 的獨立評測,討論準確率是否滿足生產要求。最後給出最小調用示例、選型表和上線前的成本檢查清單。
To Know:術語預備知識
| 術語 | 解釋 |
|---|---|
| Decisions API | Google 推出的判斷接口,直接對固定選項給出結果和概率 |
| Gemini Decision 1 | 支撐該接口的專用模型,模型 ID 爲 gemini-decision-1 |
| Token | 模型處理和計費的基本單位,文本、圖片等都會折算成 Token |
| Shared Input | 一次請求中被所有判斷共用的那份輸入內容 |
| Closed-set Decision | 答案範圍事先限定好的判斷,例如“是/否”或“A/B/C 選一” |
| noul | 二元判斷,返回“Yes”的概率 |
| choice | 從預設的 2–255 個選項中選出一項 |
| score | 按預先定義的有序等級評分,結果爲加權期望值 |
| Confidence | 模型對所選結果正確的概率估計 |
| Single Forward Pass | 模型一次計算就給出各選項分數,無需逐字生成文本 |
| Context Window | 單次請求能容納的內容總量,本模型爲 262,144 Token |
| TPM / RPM | 每分鐘可處理的 Token 數 / 請求數,是吞吐上限 |
1 Google 發佈了什麼:Gemini Decisions API 專門回答判斷題
1.1 Gemini Decision 1 與傳統生成式模型的區別
Gemini Decisions API 於 2026 年 11 月 11 日通過 Gemini Developer API v1beta 開放,REST 端點爲 POST https://generativelanguage.googleapis.com/v1beta/decisions。它的核心功能是對預先定義的選項做概率判斷,返回判斷結果、各選項概率、置信度和 Token 用量。輸入支持文本、圖片、音頻、視頻和 PDF。
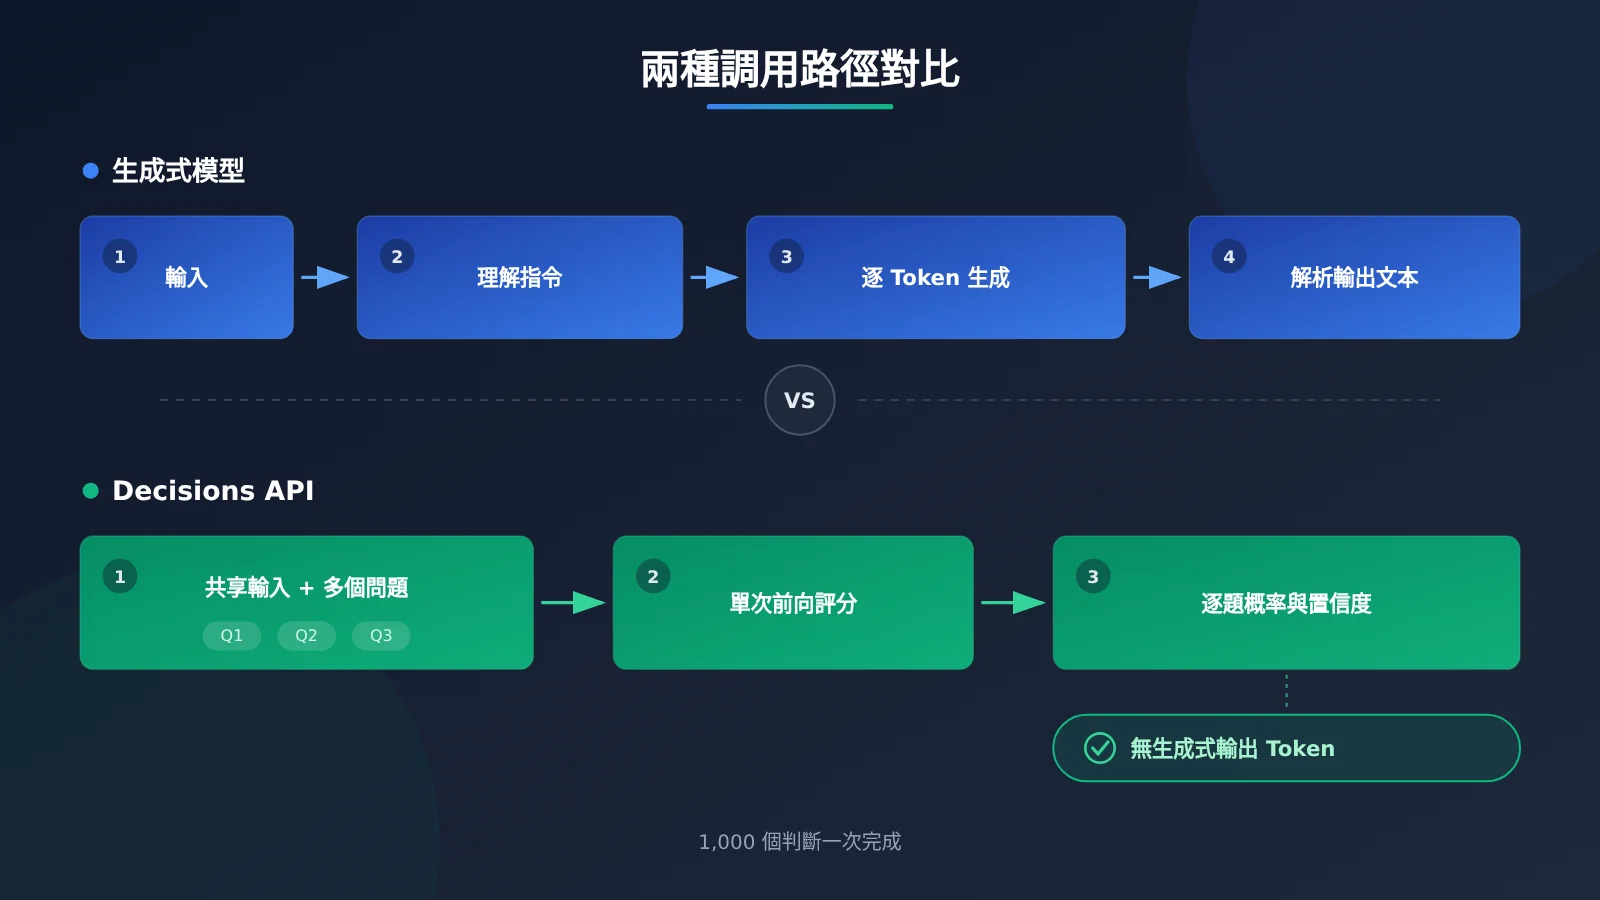
傳統生成式模型處理分類任務的流程是:讀入內容,理解指令,再逐 Token 生成一段回答,開發者還要解析這段回答。Decisions API 把流程改爲讀入共享內容,然後對每個問題的預設選項直接打分。分類、審覈、路由這類任務只需要一個標籤或一個“是/否”,生成長回答既佔用輸出費用,也拖慢響應。省掉這一步,就是它降低成本和延遲的來源。
1.2 Decisions API 三種判斷方式覆蓋哪些任務
以一條客服消息爲例:“我上週買的耳機左耳沒聲音,申請退款三天了還沒人理,再不處理我就投訴到平臺。”針對這一條消息,可以在同一個請求裏同時提出三個彼此獨立的問題。
| 判斷類型 | 示例問題 | 返回內容 | 典型任務 |
|---|---|---|---|
| noul | 這條消息是否涉及退款? | “Yes”的概率,如 0.97 | 是否違規、是否提及價格、是否需升級審覈 |
| choice | 應交給哪個部門:售後 / 物流 / 賬戶 / 其他? | 選中“售後”,並給出各選項概率 | 工單分流、文章分類、Agent 工具選擇 |
| score | 投訴嚴重程度 1–5 級打幾分? | 根據各等級概率計算的加權期望值,如 4.2 | 相關性、嚴重性、線索優先級評分 |
choice 支持 2–255 個選項,score 支持 2–255 個等級。score 返回的是根據各等級概率計算出的期望值,因此可以直接用於排序或設定閾值,無需從一段評價文字中提取分數。
2 Google Decisions API 成本究竟能省多少:三種業務場景算賬
2.1 爲什麼共享輸入可以降低 Token 消耗
Decisions API 的計費結構有三個特點:共享輸入在一次請求中只計費一次,每個問題自身的指令仍按輸入 Token 計費,判斷結果不產生生成式輸出費用。對比對象 Gemini 3.5 Flash-Lite 的官方標準價格爲輸入每百萬 Token 0.30 美元、輸出每百萬 Token 2.50 美元(2026 年 11 月 13 日官方定價)。
設 S 爲一份共享輸入的 Token 數,Q 爲針對這份輸入的獨立問題數,Tq 爲每個問題的平均 Token 數,To 爲生成式模型每個問題的平均輸出 Token 數,N 爲輸入份數。在“兩種接口可計費輸入 Token 相同”的簡化假設下:
Decisions API 成本  C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
Flash-Lite 成本     C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
節省率              = (1 − C_D / C_F) × 100%
這是用於理解機制的計算模型,Google 並沒有給出固定節省率。兩個接口會有各自的指令編碼和格式開銷,實際費用以各自返回的計費 Token 爲準。
2.2 從 1 次判斷到 1,000 次判斷,費用如何變化
下表是按公開價格推導的理論示例,沒有經過實際壓測。場景①中的 1,000 個判斷全部針對同一份文檔,是對一份輸入提出的 1,000 個獨立問題,與“1,000 份文檔各分析一次”是兩種完全不同的負載。
| 業務場景 | 主要假設 | Decisions API | Flash-Lite | 理論節省 |
|---|---|---|---|---|
| ① 一份文檔檢查 1,000 條規則 | 文檔 10K Token,每條規則 20 Token,Flash-Lite 每條輸出 20 Token,兩者都合併爲一次請求 | $0.003 | $0.059 | 94.9% |
| ② 1,000 條消息各分類 1 次 | 每條 300 Token,判斷指令 50 Token,Flash-Lite 輸出 10 Token | $0.035 | $0.130 | 73.1% |
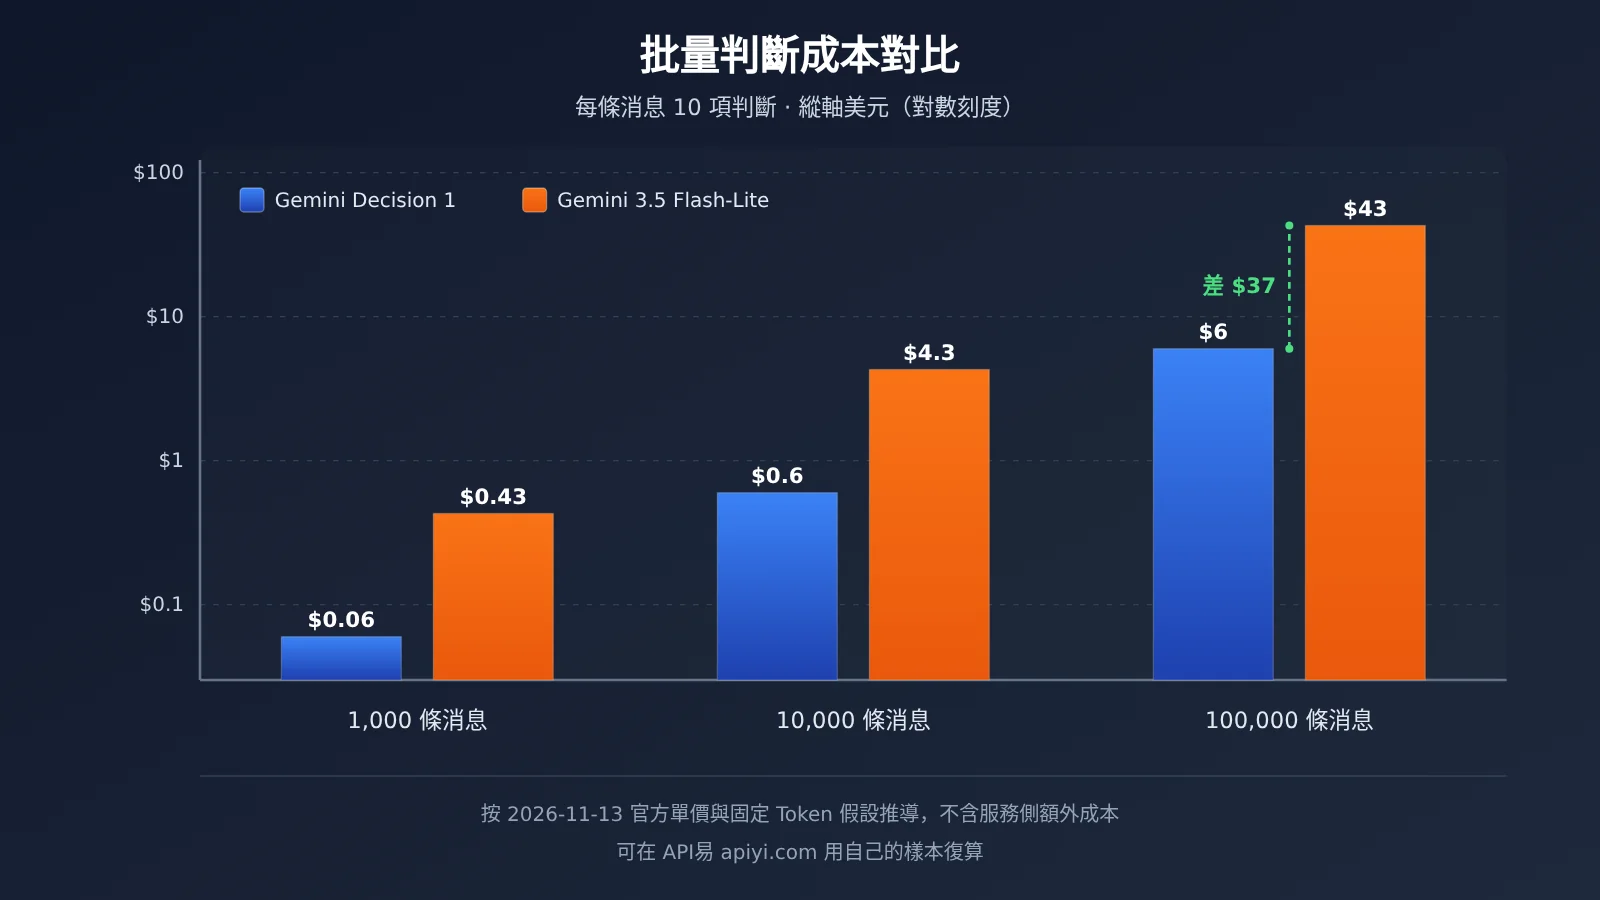
| ③ 1,000 條消息各做 10 項判斷 | 每條 300 Token,每項判斷 30 Token,Flash-Lite 每項輸出 10 Token,每條消息一次請求 | $0.060 | $0.430 | 86.0% |
三個場景說明了兩件事。場景②裏每次請求只有一個問題,仍有 73.1% 的理論節省,來源是輸入單價降爲三分之一、輸出費用歸零。場景①和③的節省更高,是因爲共享輸入被多個問題攤薄,同時 Flash-Lite 需要爲每個問題生成輸出。
沿用場景③的參數擴大規模:處理 10 萬條消息、共 100 萬個判斷時,Decisions API 的模型調用成本爲 6 美元,Flash-Lite 爲 43 美元,相差 37 美元。這一數字只包含模型調用費,未計入重試、誤判後的人工審覈、升級到更強模型、傳輸存儲和工程改造成本。
如果想用自己的業務樣本復算,可以先把同一批數據交給生成式模型跑一遍,記錄實際的輸入、輸出 Token,再代入上面的公式。API易 apiyi.com 用一個 Key 即可調用 Gemini、GPT、Claude 等多款生成式模型,方便快速建立這條成本基線。
2.3 爲什麼 Google 的“約 5 倍”不是通用答案
Google 發佈時公佈,在官方測試中 Decision 1 的成本約爲 Gemini 3.5 Flash-Lite 的 1/4.7。獨立測試者 RanThis 在 2026 年 11 月 12 日用真實 API 調用給出了另一組數字:100 條英文消息、20 條越南語消息,每個請求只做一個二元判斷。
- 準確率:100 條英文判斷中,Decision 1 答對 99 條,Flash-Lite 答對 98 條。
- 成本:每千次英文判斷推算成本分別爲 $0.0113 和 $0.0166,Decision 1 約低 32%,約爲 1.5 倍差距。
- 延遲:單次請求延遲中位數分別爲 0.18 秒和 0.58 秒。
- Token 開銷:Decision 1 每個請求平均計費約 113 個輸入 Token,Flash-Lite 約爲 47 個輸入 Token 加 1 個輸出 Token。
差距的原因很清楚:Decisions 接口自身的指令與格式開銷讓計費輸入 Token 翻了一倍多,抵消了一部分單價優勢。當輸入很短、每次只問一題、生成式模型只需輸出一個 Token 時,節省幅度最小。RanThis 把同一封郵件的 10 個問題合併進一個 Decision 1 請求、與 10 次單獨的 Flash-Lite 請求對比時,差距擴大到約 5.4 倍;這組對照中 Flash-Lite 沒有做同樣的合併,屬於不同請求方式之間的比較。
因此,影響實際節省的變量是:共享輸入的長度、每份輸入的問題數、生成式模型的輸出長度、兩邊是否都做了請求合併,以及接口自身的固定開銷。公式推導、官方基準和第三方實測來自不同條件,選型時應分別看待。
3 一次完成 1,000 個判斷,Decisions API 實際適合什麼工作?
3.1 文檔審覈:一份材料匹配多項規則
最能發揮共享輸入優勢的是“長材料 + 多條規則”。一份合同、招標文件或產品說明書,需要逐條對照合規清單:是否包含違約條款、是否約定數據出境、付款週期是否超過 60 天、是否缺少簽署日期等。材料越長、規則越多,共享輸入被攤薄得越充分,場景①的 94.9% 理論節省就是這種結構的結果。
這類任務的另一個優勢是結果可直接落表。每條規則對應一個 noul 判斷,返回概率和置信度,程序可以按閾值標記“通過 / 不通過 / 待複覈”,審覈人員只看需要複覈的條目。
3.2 Agent 路由與內容分類
Agent 在每一步都要決定下一步動作:是否需要聯網搜索、是否要運行代碼、是否轉交其他工具。這類判斷選項固定、調用頻繁、對延遲敏感,適合用 choice 一次完成。Google 披露的內部用法也集中在這裏:Gemini Notebook 用它根據問題性質選擇模型和思考層級,普通查詢延遲最高降低 40%;Google Search 用它對 MCP 工具做安全檢查,識別對抗性內容;CC 從 200 多個候選 Emoji 中快速選擇反應。這些是 Google 自身的數據,外部開發者的實際效果取決於各自的負載。
內容生產工作流是另一個延伸場景。一條 AI 新聞收集完成後,系統需要判斷它是否爲新事件、是否與開發者相關、是否涉及 API 價格、是否有官方來源、是否適合寫成教程,並給內容價值打分。這六個條件彼此獨立,可以放進一個 Decisions 請求完成篩選,通過篩選的選題再交給生成式模型做研究、寫作和潤色。這是基於接口能力設計的方案示例。後半段的生成環節可以通過 API易 apiyi.com 按需切換不同模型,比較寫作質量與成本。
3.3 1,000 個問題的三個邊界
- 問題必須相互獨立。同一請求內的判斷無法讀取彼此的結果。“先判斷是否投訴,再按投訴類型分級”這類有先後依賴的流程,需要由程序組合結果,必要時再發起下一次請求。
- 1,000 個問題共享 262,144 Token 上下文。共享輸入和全部問題共同佔用這個窗口,每個問題的指令越長,能放下的材料就越短。
- 官方低延遲數據只覆蓋小規模請求。Google 測試中延遲近似平穩的範圍是每次 1–100 個問題、上下文 16K Token 以內。1,000 個問題配合接近滿載的上下文時,延遲需要自行實測。
4 便宜之外,Gemini Decisions API 的準確率和速度能否滿足生產要求?
4.1 Google 公佈的速度與內部應用數據
Google 公佈的模型計算耗時中位數爲 50–100 ms,端到端延遲爲 150–250 ms,測試條件是每次 1–100 個問題、上下文不超過 16K Token。這組數據說明它適合放在實時鏈路中,例如 Agent 每一步的路由或用戶消息的即時分流。RanThis 單題實測的 0.18 秒中位延遲也落在這個區間附近。
4.2 第三方測評告訴我們什麼
Artificial Analysis 的 Decision Index v2.1 發佈初期結果,按原始分數與實際任務混合計算。下表中的費用是該基準測試任務的混合成本,與“每百萬 Token 單價”是兩種口徑。
| 決策模型 | 綜合分數 | 每項任務耗時 | 每百萬任務估算費用 | AA-Paperclip 15 項全對率 |
|---|---|---|---|---|
| Drex Max v1.1 | 72.62 | 283 ms | $103 | 63% |
| TypeSafe Jev 1.14 | 66.23 | 92 ms | $156 | 35.5% |
| Gemini Decision 1 | 65.98 | 211 ms | $345 | 33% |
| GPT-6 Luna (Decisions) | 60.25 | 206 ms | $339 | — |
兩個信息值得注意。其一,Gemini Decision 1 的 Token 單價低,但在這套任務分佈下,每百萬任務的估算費用高於 Drex Max 和 Jev,說明請求方式和任務結構會改變最終的經濟性。其二,在 AA-Paperclip 文檔測試中,Decision 1 一次完成全部 15 項判斷且全部正確的文檔比例爲 33%。多項判斷一次完成節省了費用,每一項的準確率仍需單獨驗證。
4.3 用置信度防止錯誤被自動執行
置信度是模型對自身結果的概率估計,可以用來決定哪些結果自動執行、哪些交給人工。上線時建議配合三條做法:
- 設置置信度閾值:例如退款判斷置信度低於 0.85 時轉人工,高於閾值才自動打標籤或派單。
- 爲 choice 增加 other 選項:所有選項都不合適時,模型仍會選出其中一項,加入“其他 / 無法判斷”能攔住一部分越界輸入,也可以單獨加一個 noul 做範圍檢查。
- 高風險操作保留代碼約束:退款金額、賬戶封禁、合規攔截等動作,除模型判斷外還應有硬編碼規則和人工複覈。
5 開發者應該如何使用與選型 Gemini Decisions API?
5.1 如何發出第一個請求
官方要求 Python google-genai SDK 3.2 或更新版本,同時支持 JavaScript SDK 和 REST,接入需要 Google AI Studio 的 API Key。下面的示例根據官方 SDK 結構整理,對同一條新聞同時做一個二元判斷和一個分類判斷,未在本文中實際調用驗證,字段名請以官方開發者指南爲準。
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # input:所有問題共用的共享輸入,只計費一次
    input="Google released a new AI API with official pricing and developer documentation.",
    # questions:相互獨立的判斷,鍵名即問題 ID
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # 每題的判斷結果、各選項概率與置信度
print(result.usage)    # 計費 Token 用量,成本覈算以此爲準
四個關鍵字段的作用如下:input 放共享內容,questions 放獨立問題(score 類型的等級定義寫法參見官方指南),answers 讀取判斷結果與概率,usage 讀取計費 Token。成本測算時一定要用 usage 的實際值,第 2.3 節已經說明接口固定開銷會顯著影響單題成本。
要做成本對比,還需要一條生成式模型的基線。下面用 OpenAI 兼容接口通過 API易 調用 Flash-Lite 完成同樣的分類,並記錄 Token 用量:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # 以平臺模型列表中的實際名稱爲準
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # 輸入、輸出 Token,用於代入 2.1 節公式
查看批量對比腳本:同一批樣本分別統計兩種接口成本
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # Flash-Lite 官方標準價,美元/百萬 Token
DECISION_IN = 0.10                 # Decision 1 輸入價,輸出不計費

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """把每條樣本的全部問題合併爲一次生成式請求,累計實際計費成本"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """傳入 Decisions API 每次返回的 usage 輸入 Token,計算總成本"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 快速上手建議:先挑 200–500 條真實業務樣本,用生成式模型跑出基線準確率和 Token 用量,再與 Decisions API 的
usage對比。API易 apiyi.com 提供 OpenAI 兼容接口和新用戶免費測試額度,適合快速完成這一步基線測試。
5.2 什麼時候選擇 Decisions API,什麼時候繼續用生成式模型
| 任務類型 | 推薦方案 | 原因 |
|---|---|---|
| 同一份長文檔對照多條規則審覈 | Decisions API | 共享輸入攤薄成本,判斷彼此獨立 |
| Agent 工具路由、模型選擇 | Decisions API | 選項固定,低延遲 |
| 內容安全與違規檢查 | Decisions API | 多個獨立 noul 條件,可用置信度分流 |
| 客服工單分類、電商售後標籤 | Decisions API | 固定標籤集合 |
| 選題篩選、線索優先級評分 | Decisions API | 適合預設量表的 score |
| 摘要、改寫、寫作 | 生成式模型 | 需要輸出自然語言 |
| 複雜研究、論證、提出新觀點 | 生成式模型 | 需要開放式推理 |
| 判斷之間有先後依賴的流程 | 程序編排 + 多次請求,或生成式模型 | 同一請求內問題無法互相引用 |
生成式模型的結構化輸出(JSON Schema)也能把答案約束成固定格式,但它仍然逐 Token 生成內容並按輸出計費,概率需要額外處理才能獲得。Decisions API 直接返回每個選項的概率和置信度,輸出不計費,代價是隻能回答事先限定選項的問題。
5.3 上線前還需計算什麼成本
單價之外,下面幾項會直接影響“每個正確決策的總成本”:
- 實際 Token 開銷:以
usage爲準,短輸入單題場景的固定開銷佔比最高。 - 請求限額:免費層爲 200 RPM、50,000 TPM、10,000 RPD;付費 Tier 1 爲 1,500 RPM、100 萬 TPM、50,000 RPD。長上下文請求往往先觸發 TPM 上限。
- 缺少緩存與批處理:不支持 Context Caching、Batch API、Flex/Priority 推理,重複使用同一長文檔時無法享受緩存摺扣。
- 功能約束:問題指令中不能放媒體內容,也不能直接傳入完整對話歷史、思考或工具調用塊,多輪對話需要先整理成文本輸入。
- 誤判與人工複覈:低置信度轉人工的比例、誤判後的返工費用,需要計入單位成本。
- 數據處理條件:免費層使用數據可能被用於 Google 產品改進,官方定價表顯示付費層不用於此目的。處理客戶文檔前應確認所用層級。
- 工程改造:把生成式提示詞改寫爲 noul / choice / score 問題、建立閾值和回退邏輯,都需要開發投入。
如果計劃通過第三方 API 平臺接入,需要確認平臺是否支持 /v1beta/decisions 這一專用端點,僅支持 Chat Completions 的平臺無法直接調用 Decisions API。在 API易 apiyi.com 使用前,可以先查閱文檔中心的模型與端點列表,或聯繫平臺確認支持情況。
6 結論:分類、審覈、路由任務可以交給 Gemini Decisions API
回到標題的問題,結論有三點:
- 固定選項任務值得優先考慮 Decisions API。按公開價格推導,單題分類理論節省約 73%,同一份長文檔的千條規則審覈理論節省約 95%;第三方單題實測的優勢約爲 32%。
- “一份輸入、多個獨立問題”是成本潛力最大的結構。共享輸入只計費一次,問題越多、輸入越長、生成式模型輸出越長,差距越大。
- 最終衡量標準是生產環境中每個正確決策的總成本。Token 單價和 1,000 題上限是起點,準確率、置信度分流後的人工比例、限額和工程成本共同決定實際收益。
比較穩妥的路徑是:先用真實樣本跑出生成式模型的基線,再在 Decisions API 上對比 usage 和準確率,把判斷層與生成層分開設計。生成層的模型選型與成本對比,可以通過 API易 apiyi.com 用統一接口完成。
📚 參考資料
- Google Gemini Decisions API 開發者指南與定價表:接口能力、限制、限額與官方價格
- 鏈接:
ai.google.dev -
說明: 模型 ID、問題類型、上下文窗口、速率限額與 SDK 用法
-
Google 官方博客發佈文章:發佈日期、延遲數據與內部應用案例
- 鏈接:
blog.google -
說明: 50–100 ms 計算耗時、約 4.7 倍成本優勢、Gemini Notebook 等案例
-
Gemini Decisions API REST 端點
- 鏈接:
generativelanguage.googleapis.com/v1beta/decisions -
說明: REST 方式調用的官方端點
-
Artificial Analysis Decision Index v2.1:第三方決策模型評測
- 鏈接:
artificialanalysis.ai -
說明: 綜合分數、任務耗時、每百萬任務費用與 AA-Paperclip 全對率
-
RanThis 獨立實測(2026-11-12):基於真實調用的小規模測試
- 說明: 單題成本、延遲與 Token 開銷對比,以及多題合併請求的結果
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心