作者注:Qwen4-Max 仍處於預覽階段,還沒有公開跑分、上下文長度和按 token 單價,這三項無法與 Qwen3.8-Max 硬比;現在能按量調用的仍是 qwen3.8-max。
Qwen4-Max 預覽一出來,正在用 Qwen 的開發者最先問的往往是:要不要換?比 Qwen3.8-Max 強多少?貴多少?這些問題現在還給不出 可以對齊的答案,因爲預覽階段缺少做比較必需的三項公開信息。
這不是在唱衰 Qwen4-Max。我們不判斷它的能力強弱,只說明一個事實:截至 2026-11-12,Qwen4-Max 預覽還沒有公開跑分、上下文長度和按 token 單價,而 Qwen3.8-Max 已經發布,可以按量調用。按 2026-11-12 API易 apiyi.com 的型號列表,現在能直接接入的是 qwen3.8-max。
核心價值:3 分鐘弄清 Qwen4-Max 預覽和 Qwen3.8-Max 之間哪些項現在不能比,以及在正式信息公佈之前,手上的項目應該怎麼安排。
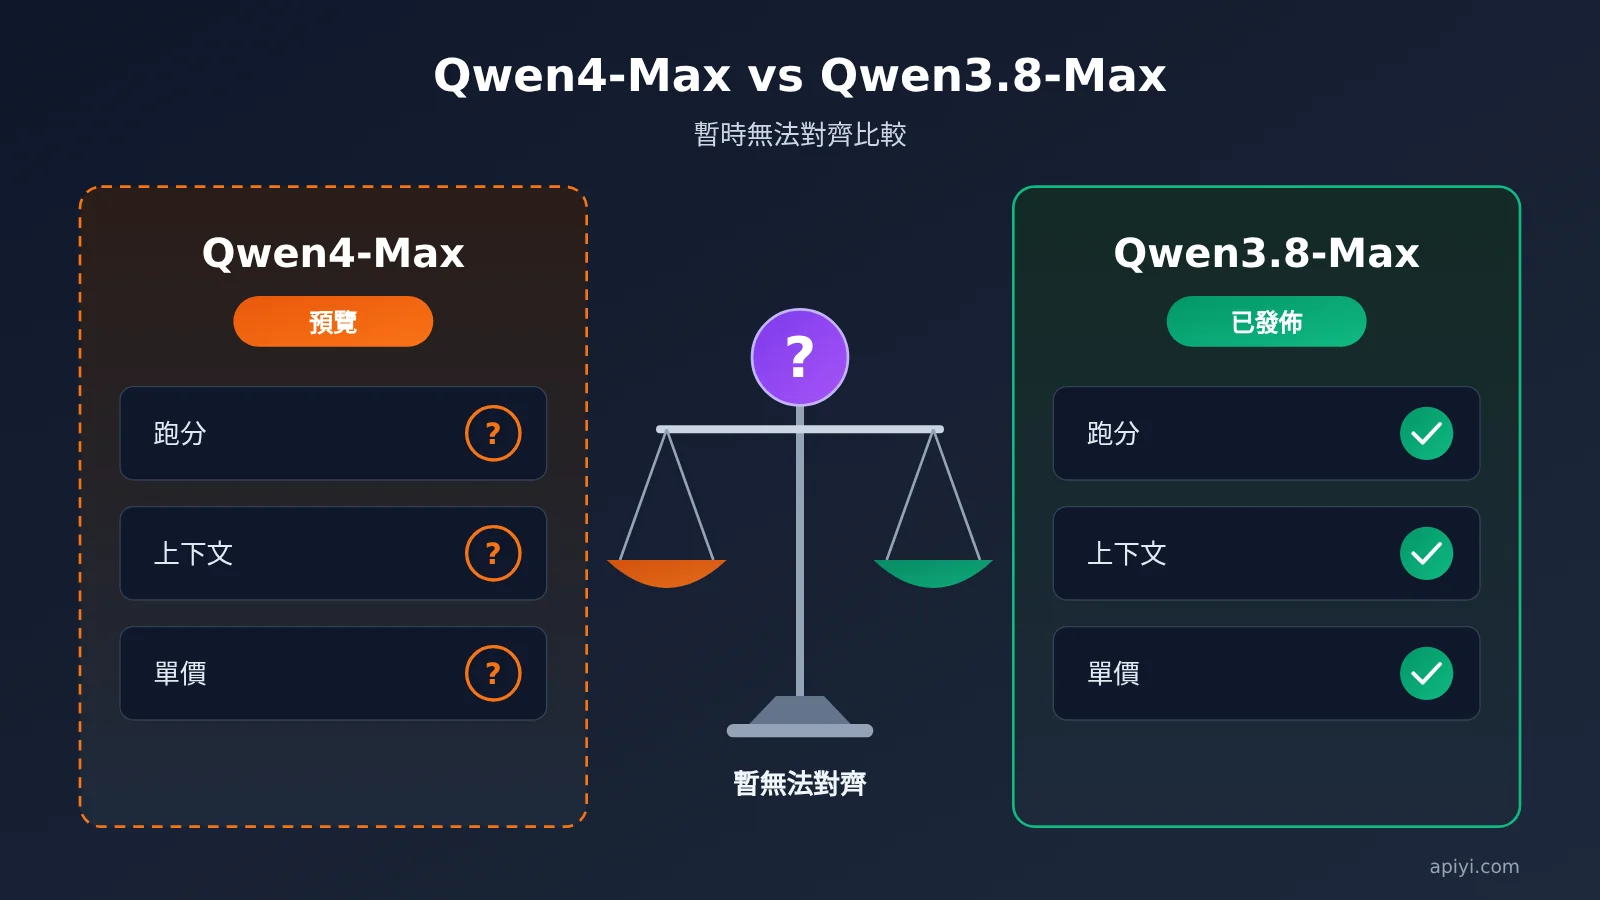
Qwen4-Max 與 Qwen3.8 核心信息速覽
先把兩邊目前能確認的信息放在一起。下表只列參考資料能證實的內容,沒有公開的項目直接標爲“未公開”,不做推測。
| 信息項 | Qwen4-Max(預覽) | Qwen3.8-Max |
|---|---|---|
| 發佈狀態 | 預覽階段 | 已發佈型號 |
| 公開跑分 | 未公開 | 已發佈型號,可查閱正式資料 |
| 上下文長度 | 未公開 | 以官方文檔和型號說明爲準 |
| 按 token 單價 | 未公開 | 輸入 $1.65 / 輸出 $4.95 / 緩存讀 $0.20625(每 1M tokens) |
| 按量調用 | 2026-11-12 的型號列表中暫無 | 可調用,模型 ID qwen3.8-max |
| 可用平臺 | 以官方後續公告爲準 | API易 等平臺 |
表裏“未公開”出現了三次,分別是跑分、上下文和單價。這三項正是模型選型時最常用的比較維度,缺任何一項,橫向對比都會失去依據。此前已有文章介紹過預覽開放的情況,本文只討論這三項爲什麼不能硬比。
Qwen4-Max 預覽缺失的三項信息分別影響什麼
跑分決定能力判斷。沒有官方公開的基準分數,就沒有統一口徑去衡量 Qwen4-Max 在推理、代碼、長文本等任務上相對 Qwen3.8-Max 的進退。零散的社區截圖或個別對話體驗,測試集、提示詞和採樣參數都不一致,不能代替正式跑分。
上下文長度決定架構設計。RAG 的分塊大小、對話歷史的截斷策略、長文檔是一次性輸入還是分段處理,都依賴確定的上下文上限。這個數字未定,就無法評估遷移後能否省去現有的分段邏輯,也無法判斷會不會出現超長報錯。
按 token 單價決定成本模型。預算、定價、限流策略都建立在單價之上。預覽階段即使可以體驗,也不等於已經有可以寫進成本表的價格,拿一個未定的價格和 qwen3.8-max 的現行單價相比,結論沒有意義。
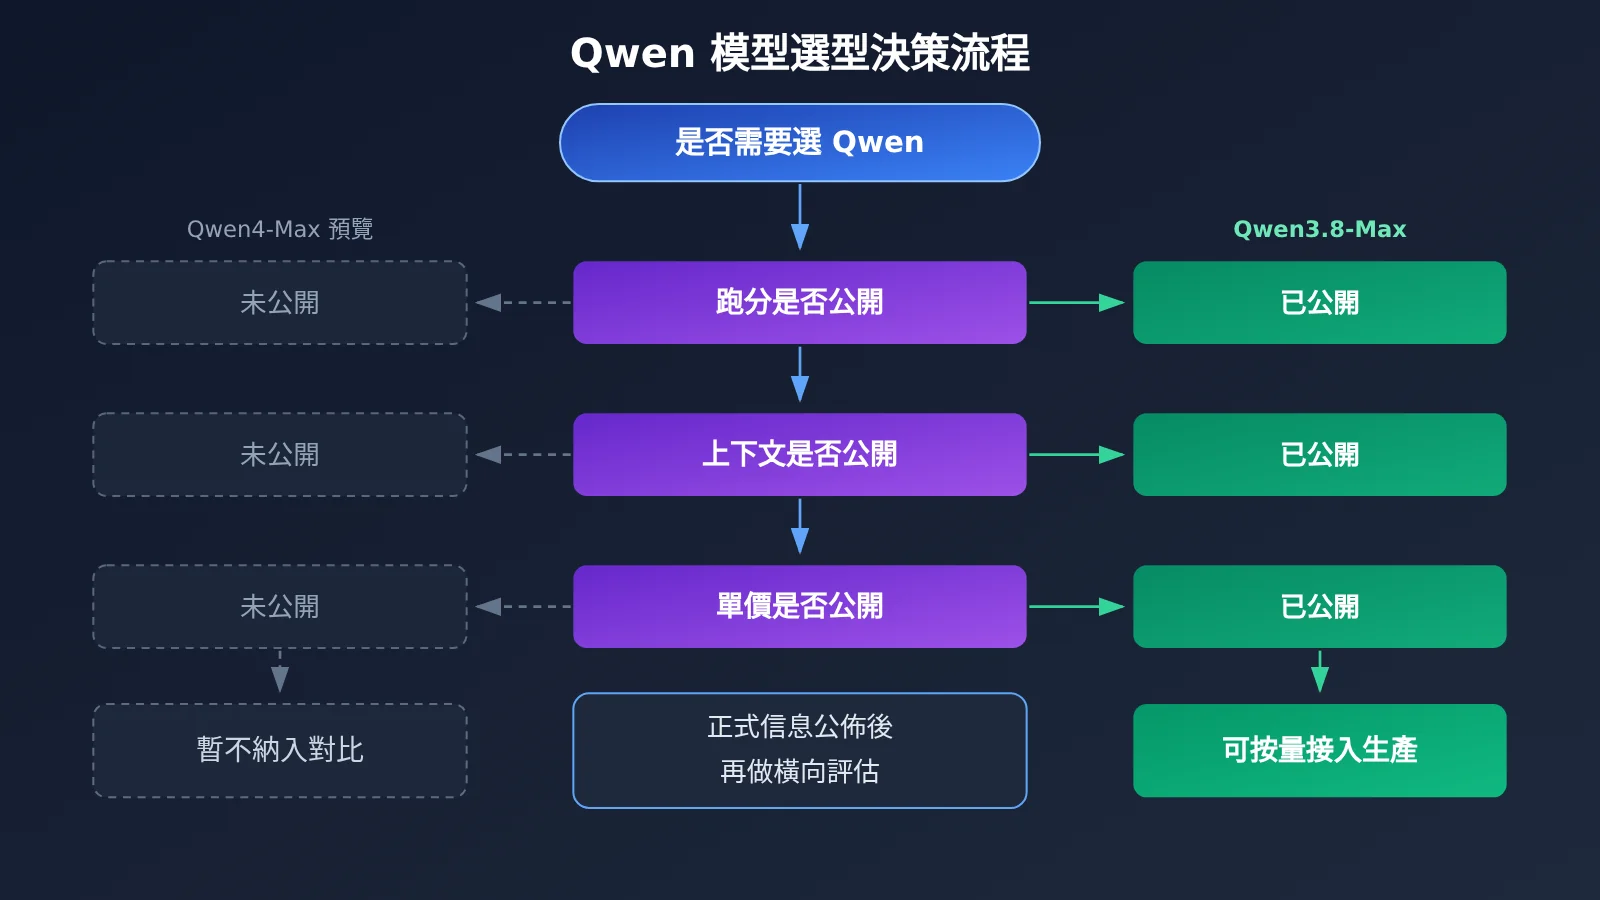
Qwen3.8-Max 現在能按量調用的價格與接入方式
既然比較的條件還不具備,手上的項目就以已發佈的型號爲準。下表是 2026-11-12 型號列表中 qwen3.8-max 的價格,單位爲每 1M tokens。
| 計費項 | 單價(每 1M tokens) | 說明 |
|---|---|---|
| 輸入 | $1.65 | 未命中緩存的提示詞部分 |
| 輸出 | $4.95 | 模型生成內容,單價爲輸入的 3 倍 |
| 緩存讀 | $0.20625 | 命中緩存的輸入部分,單價爲輸入的 1/8 |
從結構上看,輸出單價是輸入的 3 倍,緩存讀只要輸入的 12.5%。因此控制輸出長度、提高緩存命中率,是降低 qwen3.8-max 成本最直接的兩個手段。系統提示詞較長、多輪對話前綴穩定的場景,緩存帶來的收益會更明顯。
Qwen3.8-Max 成本估算示例
按上面的單價,可以算出幾個典型請求的費用。以下數字都由公開單價直接計算,便於套用到自己的業務量中。
| 場景 | 輸入 tokens | 其中緩存命中 | 輸出 tokens | 單次費用 |
|---|---|---|---|---|
| 單次常規請求 | 10,000 | 0 | 2,000 | $0.0264 |
| 同樣請求、前綴緩存命中 | 10,000 | 8,000 | 2,000 | $0.01485 |
| 批量處理 1M 輸入 | 1,000,000 | 0 | 200,000 | $2.64 |
第二行與第一行的輸入、輸出總量相同,只是 8,000 個輸入 tokens 命中了緩存,單次費用就從 $0.0264 降到約 $0.0149,降幅超過四成。這是 Qwen4-Max 預覽目前無法提供的計算條件,因爲它的單價還沒有公佈。
如何接入 qwen3.8-max
API易 提供 OpenAI 兼容接口,用 OpenAI SDK 或任何兼容客戶端都可以直接接入,只需要修改三個參數:
base_url:https://api.apiyi.com/v1(使用 API易 統一接口)api_key:在 API易 控制檯創建的 API Keymodel:qwen3.8-max
調用方式與 Chat Completions 一致,messages 數組按 system、user、assistant 的角色順序組織即可。如果項目原本對接的是 OpenAI 兼容端點,通常只需要替換 base_url 和模型 ID,業務代碼不用改動。
🚀 快速開始:在 API易 apiyi.com 註冊即可獲得免費測試額度,先用
qwen3.8-max跑通自己的業務提示詞,記錄真實的輸入、輸出和緩存命中比例,後續 Qwen4-Max 正式開放時就有現成的對照數據。
Qwen4-Max 預覽對現有 Qwen 項目的影響分析
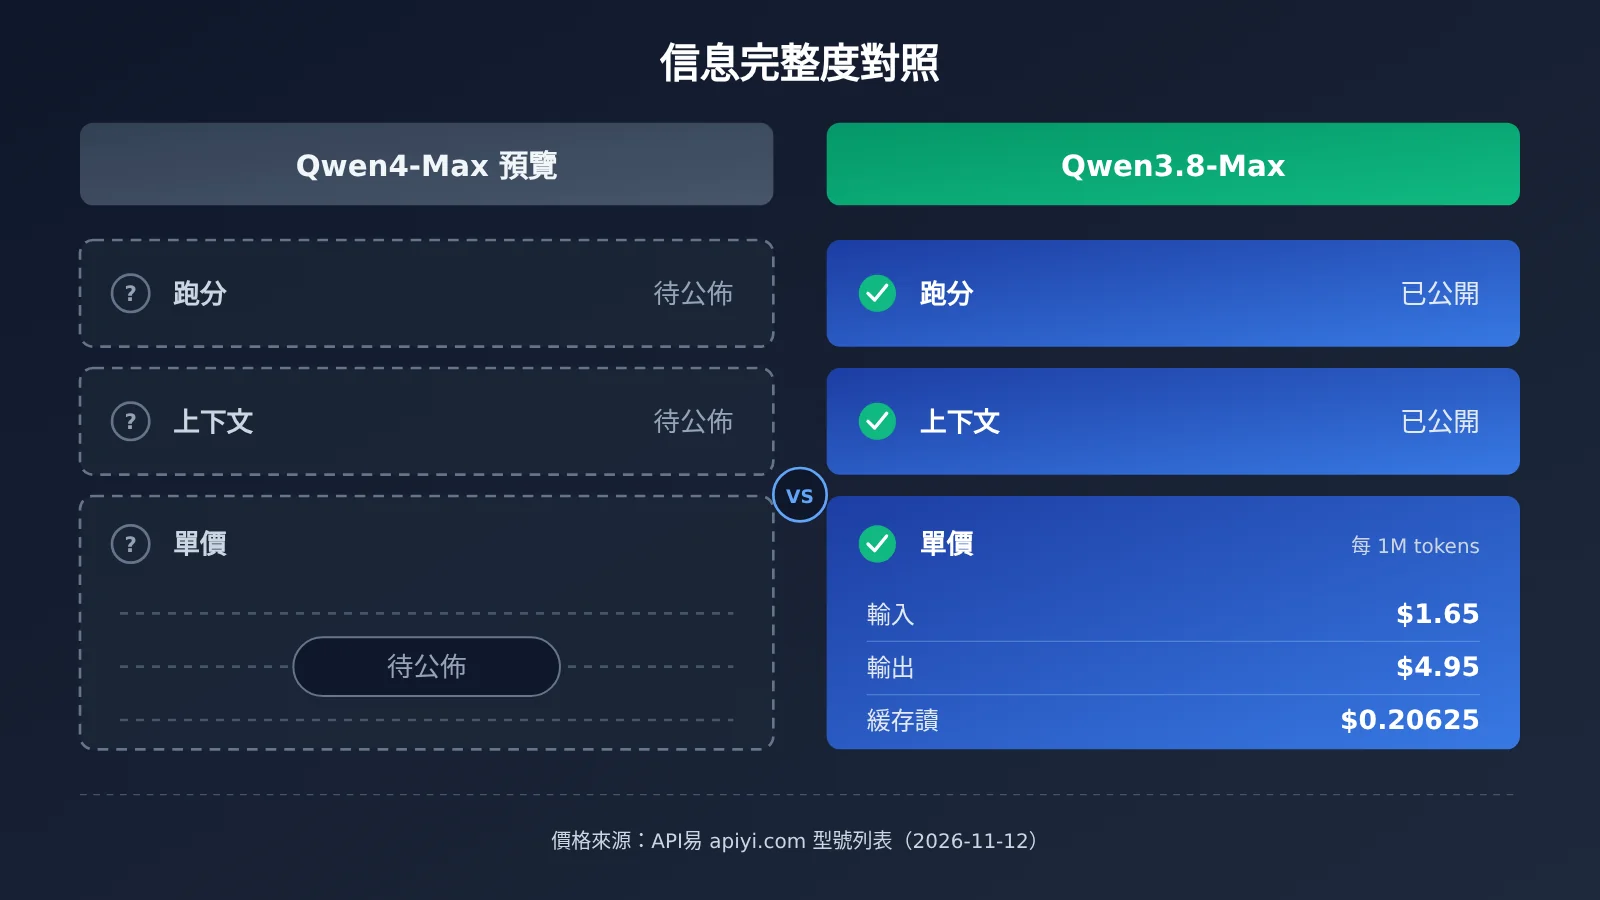
上圖把兩邊的信息完整度放在一起:一邊是三個待公佈的空位,一邊是可以直接查到的數據。在這種狀態下做對比,任何“強多少”“貴多少”的結論都缺少依據。價格數據可以在 API易 apiyi.com 的型號列表中核對。
對正在使用 Qwen 的開發者的影響
- 生產環境不需要動:Qwen4-Max 預覽不改變 qwen3.8-max 的可用性和價格,現有調用照常進行。
- 評估工作可以先做準備:整理一組代表自己業務的評測提示詞和打分標準,正式信息公佈後直接拿來對比兩個型號。
- 成本預算仍按 qwen3.8-max 編制:預覽階段沒有單價,不宜把 Qwen4-Max 寫進下一階段的預算或報價。
- 上下文相關的改造先擱置:在 Qwen4-Max 的上下文長度公佈之前,不建議爲了它調整分塊或截斷邏輯。
不同角色的應對建議
| 角色 | 現在可以做的事 | 等正式信息公佈後再做的事 |
|---|---|---|
| 應用開發者 | 繼續用 qwen3.8-max,沉澱業務評測集 |
用同一評測集對比兩個型號 |
| 架構負責人 | 按 qwen3.8-max 的實際上限設計上下文策略 | 根據 Qwen4-Max 上下文長度評估是否簡化分塊 |
| 成本負責人 | 按輸入 $1.65、輸出 $4.95 每 1M tokens 編制預算 | 拿到 Qwen4-Max 單價後重算遷移成本 |
| 產品經理 | 對外描述仍以已發佈型號能力爲準 | 根據公開跑分決定是否宣傳升級 |
對模型選型流程的啓示
預覽版本最容易引發的問題,是把“看起來更新”當成“已經更好”。規範的選型流程至少需要三類公開依據:能力(跑分)、容量(上下文)和成本(單價)。三者齊備之前,新型號適合放進觀察清單,不適合放進生產方案。
通過統一接口管理模型調用,還有一個好處:將來 Qwen4-Max 正式開放按量調用時,只需要改動 model 參數就能做 A/B 對比,不必重新對接一套 SDK。
💡 選擇建議:在 Qwen4-Max 的三項關鍵信息公佈之前,建議把 qwen3.8-max 作爲生產主力。通過 API易 apiyi.com 的統一接口接入,後續新型號上線後可以在同一套代碼裏快速切換對比。
常見問題 FAQ
Q1:Qwen4-Max 預覽現在能和 Qwen3.8-Max 做對比嗎?
在跑分、上下文長度和按 token 單價這三項上還不能。Qwen4-Max 仍處於預覽階段,這三項都沒有公開,缺少統一口徑。能確定的只有發佈狀態:Qwen3.8-Max 已發佈且可以按量調用,Qwen4-Max 還在預覽。
Q2:Qwen4-Max 是不是已經全面超過 Qwen3.8-Max?
目前沒有公開數據支持這個結論。新一代型號的版本號更大,不代表在所有任務上都更強,也不代表價格更合適。是否超過、在哪些任務上超過,需要等官方公開跑分後再判斷,並且最好結合自己的業務評測集驗證。
Q3:Qwen3.8-Max 現在的調用價格是多少?
按 2026-11-12 的型號列表,qwen3.8-max 每 1M tokens 輸入 $1.65、輸出 $4.95、緩存讀 $0.20625。緩存讀單價只有輸入的 1/8,提示詞前綴穩定的場景可以明顯降低成本。
Q4:如何通過 API 快速調用 Qwen3.8-Max?
推薦使用支持多模型的 API 聚合平臺:
1. 訪問 API易 apiyi.com 註冊賬號,獲取 API Key 和免費測試額度
2. 將 base_url 設爲 `https://api.apiyi.com/v1`
3. 模型 ID 填寫 `qwen3.8-max`,按 OpenAI 兼容的 Chat Completions 格式調用
Q5:Qwen4-Max 正式開放後,遷移成本高嗎?
接口層面的遷移成本取決於接入方式。如果使用 OpenAI 兼容接口統一管理,通常只需更換模型 ID;真正需要評估的是效果和成本差異。建議現在就在 API易 apiyi.com 上用 qwen3.8-max 沉澱評測數據,到時直接對照。
Q6:預覽階段有哪些需要注意的限制?
預覽階段的關鍵參數都可能發生變化。跑分未公開,無法判斷能力邊界;上下文長度未公開,長文本方案無法定型;單價未公開,無法納入預算。因此不建議把預覽型號用於有穩定性和成本要求的生產業務。
Qwen4-Max 與 Qwen3.8 核心要點 Key Takeaways
- 發佈狀態不同:Qwen4-Max 仍是預覽,Qwen3.8-Max 是已發佈、可按量調用的型號。
- 三項無法硬比:Qwen4-Max 的跑分、上下文長度和按 token 單價均未公開。
- 不要提前下結論:沒有公開數據時,不能斷言 Qwen4-Max 全面超過 Qwen3.8-Max。
- 現行價格可查:qwen3.8-max 每 1M tokens 輸入 $1.65、輸出 $4.95、緩存讀 $0.20625。
- 緩存是降本關鍵:緩存讀單價只有輸入的 1/8,前綴穩定的場景收益明顯。
- 生產以 qwen3.8-max 爲準:通過 API易 統一接口接入,後續切換型號只改模型 ID。
總結
Qwen4-Max 預覽與 Qwen3.8-Max 的關係,核心要點如下:
- 比較條件尚不具備:Qwen4-Max 預覽缺少公開跑分、上下文長度和按 token 單價,三項都不能和 Qwen3.8-Max 硬比。
- 現行可用的是 qwen3.8-max:價格明確,輸入 $1.65、輸出 $4.95、緩存讀 $0.20625(每 1M tokens)。
- 現在做準備,正式公佈後再對比:先沉澱業務評測集和成本數據,信息齊備後再做遷移決策。
在 Qwen4-Max 的正式信息公佈之前,穩妥的做法是繼續用 qwen3.8-max 支撐業務,同時把評測和成本基線準備好。推薦通過 API易 apiyi.com 接入 qwen3.8-max,平臺提供 OpenAI 兼容的統一接口和免費測試額度,新型號上線後可以在同一套代碼裏直接對比。
📚 參考資料
- API易 型號與價格列表:2026-11-12 可調用型號覈對
- 鏈接:
api.apiyi.com/api/pricing -
說明:用於確認當前可按量調用的 Qwen 型號
-
API易 模型文檔:qwen3.8-max 計費說明
- 鏈接:
docs.apiyi.com/models - 說明:包含 qwen3.8-max 輸入、輸出與緩存讀的單價
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多模型接入資料可查閱 API易 文檔中心