
作者注:從星塵智能來傑”別打一個螺絲收我一份 token 費”的比喻出發,拆解 AI 工作流裏哪些環節該交給固定程序,哪些環節才需要大模型判斷。
2026 年 11 月 5 日,愛範兒「多樣性公司」欄目發佈了對星塵智能創始人兼 CEO 來傑的專訪。其中一句話被很多做 AI 應用的人反覆轉述:“我希望打螺絲的是固定化程序,每天 24 小時一直轉,別打一個螺絲收我一份 token 費。”
這不是一句段子。來傑在專訪裏談的是機器人分工:具身模型負責物理動作,遇到問題再用自然語言去問基礎大模型。這套思路放到軟件工作流裏,恰好對應一個很實際的問題:一個 AI 應用裏,到底哪些環節不該調用大模型?
核心價值:本文把專訪中的機器人觀點轉譯爲軟件工作流的調用邊界設計,給出 5 類不該調用大模型的環節、一套分層判斷標準,以及一個可直接改造的路由代碼示例。需要先說明的是,機器人和軟件是兩類系統,下文的遷移屬於類比推演,效果需要用你自己的實際用量來驗證。
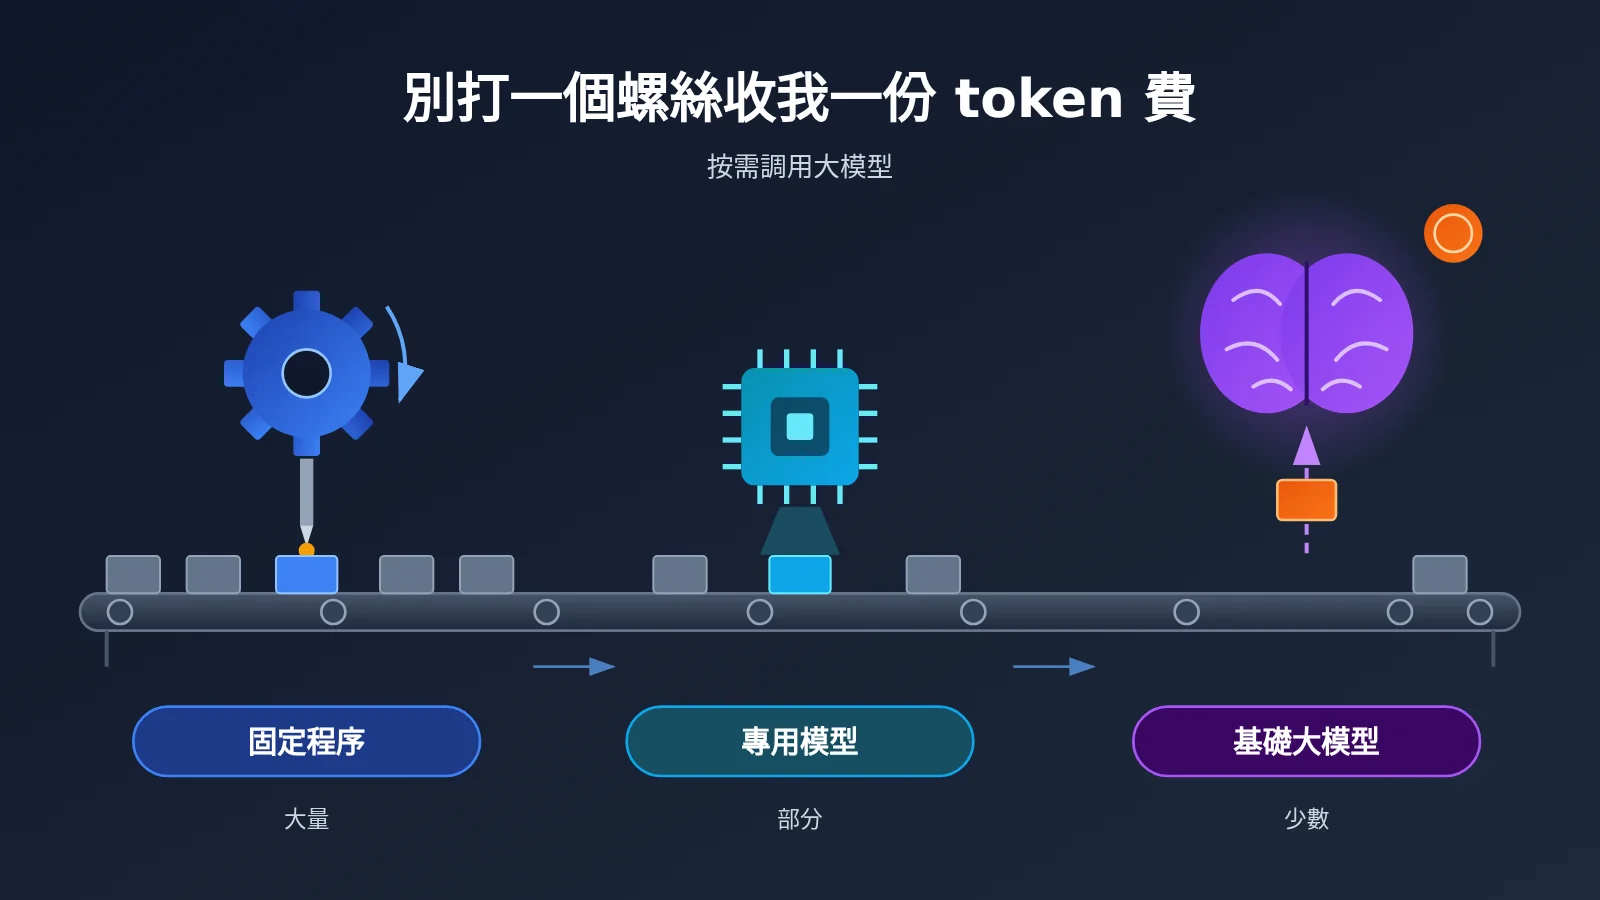
「別打一個螺絲收我一份 token 費」核心信息速覽
這句話出自專訪的最後一個問題。被問到希望機器人幫人類擺脫什麼時,來傑明確表示不希望機器人”進廠打螺絲”。一方面他認爲機器人的價值在於能力的廣泛性,另一方面從成本看,重複勞動不值得爲每一次動作支付 token 費。
| 信息項 | 詳情 |
|---|---|
| 信息來源 | 愛範兒「多樣性公司」欄目第 15 篇專訪 |
| 發佈時間 | 2026 年 11 月 5 日 |
| 受訪者 | 星塵智能創始人兼 CEO 來傑,曾爲騰訊 Robotics X 機器人實驗室 1 號員工 |
| 核心觀點 | 重複性動作應交給固定化程序,不應每次都付 token 費 |
| 分工思路 | 具身模型負責物理執行,遇到問題再用自然語言詢問基礎大模型 |
| 對軟件的啓發 | AI 工作流需要劃分固定程序、專用模型、基礎大模型的調用邊界 |
需要強調的是,專訪內容是創始人觀點,文中沒有給出成本實測或第三方驗證數據。我們借用的是它的分工邏輯,而不是任何具體結論。
來傑的”打視頻問媽媽”比喻:大模型只補上下文
專訪裏有一個比”打螺絲”更能說明分工的比喻。來傑說,自己不會做飯但想做,就給媽媽打視頻電話,媽媽會說”先在熱鍋裏放點油”,但不用說哪瓶是油;有疑問時再追問。關鍵在於:媽媽負責補充上下文知識,但放油這個動作必須自己會,因爲媽媽在電話那頭沒法替你放油。
對應到機器人上,具身模型要自己感知重量、捏握力度、有沒有抓穩這些物理參數,只在”捏不住有點不穩該怎麼辦”這類問題上去問基礎大模型。來傑認爲把觸覺信息也訓練進基礎大模型”不是做不到,而是成本不合適,並且通訊的帶寬也會有問題”。他還補充,這不是簡單的分層,而更像螞蟻式的智能體化:每個智能體能力未必強,但組合起來很強大。
| 機器人系統中的角色 | 專訪中的職責 | 軟件工作流中的類比角色 |
|---|---|---|
| 固定化程序 | 24 小時重複打螺絲 | 規則引擎、正則、腳本、數據庫查詢 |
| 具身模型 | 物理執行、感知參數、把狀態翻譯成自然語言 | 分類、抽取、向量檢索等專用小模型 |
| 基礎大模型 | 補充上下文知識、給出疑難方案 | 複雜推理、開放式生成、異常決策 |
| AOS 操作系統 | 把能力封裝成技能模塊,與大模型和 Agent 適配 | 工作流編排層、工具調用層、路由器 |
這張映射表是本文的推演,不是專訪原話。機器人涉及物理世界的實時控制和通訊帶寬限制,軟件工作流則更多受 token 計費、延遲和穩定性約束,兩者的瓶頸並不完全相同。
AI 應用哪些環節不該調用大模型:5 條判斷標準
很多團隊做 Agent 的第一版,習慣把所有步驟都塞給大模型:格式校驗讓大模型做,日期轉換讓大模型做,甚至”判斷字段是否爲空”也寫成提示詞。原型階段這樣做很快,但上線後每一次請求都在爲確定性工作付費,還引入了不必要的隨機性。
借用”打螺絲”的思路,我們可以用下面 5 條標準判斷一個環節是否值得調用大模型。
| 判斷維度 | 傾向固定程序 | 傾向專用模型 | 傾向基礎大模型 |
|---|---|---|---|
| 輸入是否結構化 | 字段固定、格式明確 | 半結構化文本 | 開放式自然語言 |
| 輸出是否唯一 | 有唯一正確答案 | 有限類別 | 多種合理答案 |
| 規則能否窮舉 | 能寫成 if/else | 規則多但模式穩定 | 規則無法窮舉 |
| 出錯代價 | 必須零誤差 | 可接受少量誤差並複覈 | 需要綜合權衡 |
| 調用頻率 | 極高頻、每次都執行 | 高頻 | 低頻、按需觸發 |
適合交給固定程序的”螺絲型”環節
以下幾類環節通常屬於”打螺絲”,確定性高、重複性強,用大模型反而降低穩定性:
- 格式校驗與清洗:郵箱、手機號、JSON 結構、必填字段檢查,正則和 Schema 校驗即可完成。
- 數據查詢與計算:訂單狀態、庫存數量、金額彙總,應直接查數據庫或調用業務接口,不要讓大模型”推算”。
- 固定模板輸出:通知短信、標準回執、報表表頭,用模板引擎填充變量即可。
- 流程控制與重試:分支跳轉、超時重試、限流排隊,屬於編排層邏輯,不需要模型參與。
- 高頻緩存命中:同一問題被反覆詢問時,先查緩存或 FAQ 庫,命中就直接返回。
真正需要大模型判斷的環節
與之相對,真正值得調用基礎大模型的,是”媽媽在電話那頭才能回答的問題”:用戶意圖模糊需要澄清、需要綜合多份資料寫出結論、遇到規則沒覆蓋的異常情況、需要生成有創造性的內容。這些環節的共同點是:答案不唯一,規則無法窮舉,且出現頻率相對較低。
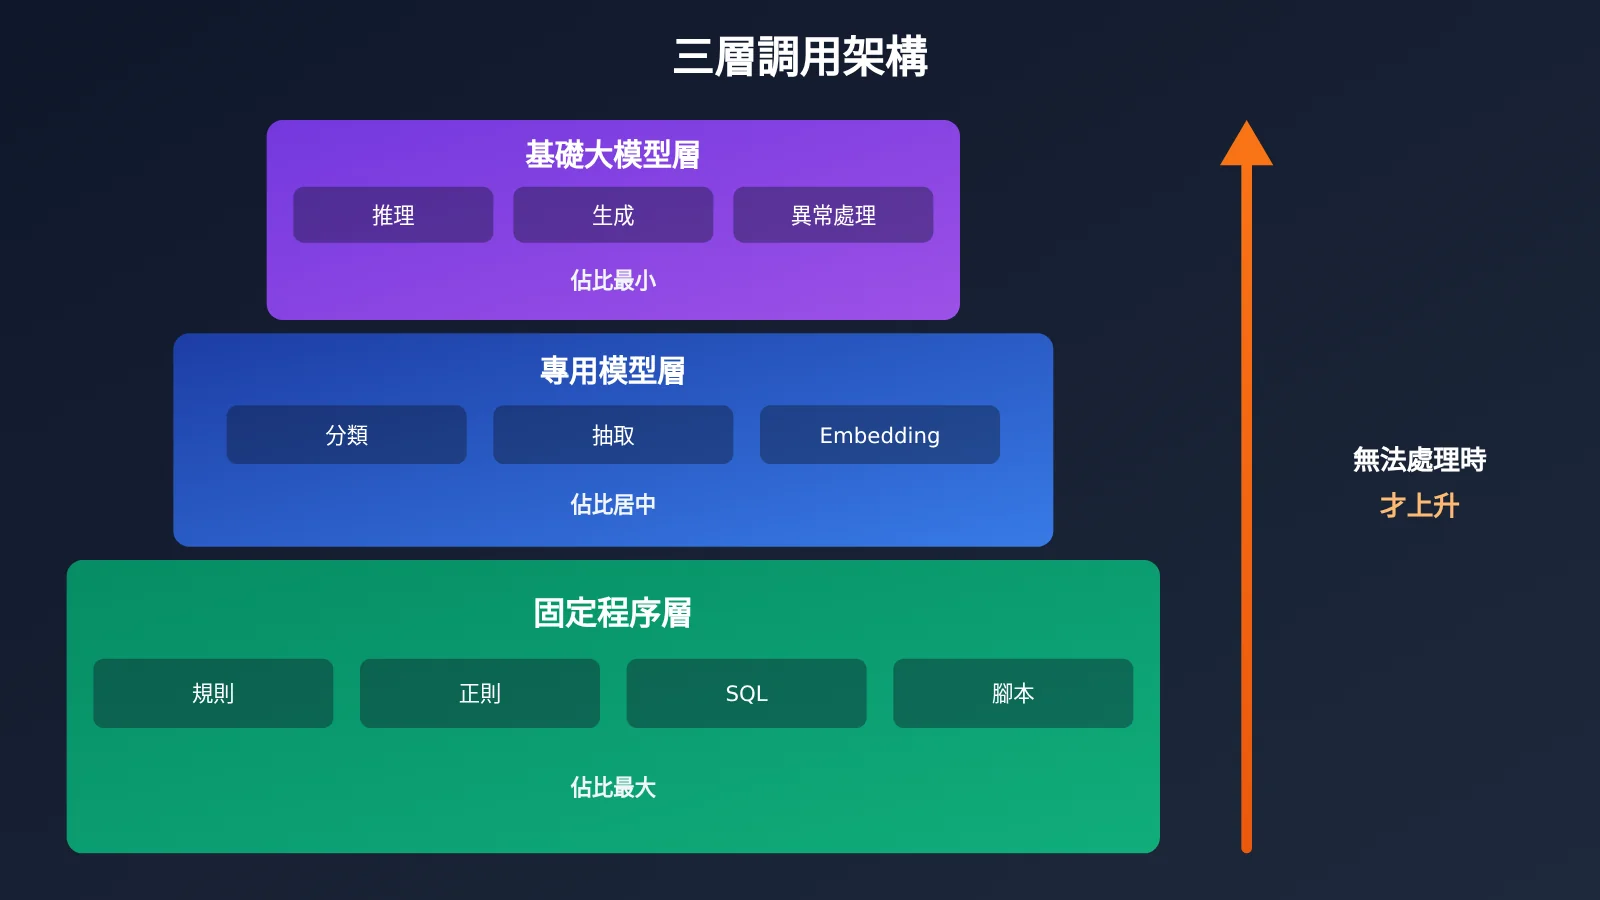
專用模型則處在兩者之間。意圖分類、實體抽取、情感判斷、文本向量化這類任務,用較小的模型往往就能勝任,可以理解爲軟件版的”具身模型”:自己把能做的做完,把處理不了的情況整理成清晰的問題交給上一層。
AI 工作流分層設計示例:不該調用大模型的環節先攔截
下面以一個常見的”客服工單自動處理”流程爲例,演示如何把調用邊界落到具體步驟上。這是一個設計示例,並非真實項目的實測數據。
| 工作流步驟 | 負責層 | 處理方式 | 是否消耗 token |
|---|---|---|---|
| 工單字段校驗 | 固定程序 | Schema 校驗,缺字段直接打回 | 否 |
| 查詢訂單與物流狀態 | 固定程序 | 調用業務數據庫接口 | 否 |
| 常見問題匹配 | 固定程序 / 專用模型 | 關鍵詞規則優先,向量檢索兜底 | 少量 |
| 意圖分類 | 專用模型 | 小模型輸出有限類別 | 少量 |
| 複雜投訴與異常處理 | 基礎大模型 | 結合訂單上下文生成處理建議 | 是 |
| 回覆模板填充 | 固定程序 | 模板引擎輸出最終文本 | 否 |
可以看到,6 個步驟中只有一步必須調用基礎大模型。具體能節省多少 token、成功率是否下降、延遲如何變化,取決於你的流量結構和規則覆蓋率,必須用實際日誌來評估。
極簡示例:規則優先,模型兜底
下面這段代碼展示了最小化的分層路由思路:先用規則攔截”螺絲型”請求,再交給小模型分類,只有複雜情況才調用大模型。模型名稱僅爲示例,請以平臺實際可用的模型列表爲準。
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

def handle(query: str) -> str:
    # 第一層:固定程序,能用規則解決的不調用模型
    if re.search(r"(訂單號|單號)\s*[::]?\s*\d{8,}", query):
        return "已爲您查詢訂單狀態(走業務接口,不消耗 token)"
    # 第二層:小模型做意圖分類
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只輸出類別(諮詢/投訴/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投訴":
        return f"已歸類爲:{intent},轉入標準流程"
    # 第三層:只有複雜投訴才調用基礎大模型
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"請給出投訴處理建議:{query}"}],
    ).choices[0].message.content
查看帶用量記錄的完整實現代碼
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # 示例:分類/抽取用的小模型
LARGE_MODEL = "claude-sonnet-4"   # 示例:複雜推理用的大模型

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(訂單號|單號)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(營業時間|幾點開門)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[規則層] 執行動作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只輸出一個類別(諮詢/投訴/其他),不要解釋:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投訴" not in intent:
        return f"[專用模型層] 歸類爲:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是資深客服主管,請針對以下投訴給出處理建議:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["訂單號:2026110612345 到哪了", "你們營業時間是?", "收到的商品破損,客服一直不回覆"]:
        print(handle(q))
    print(log.summary())
🚀 快速上手建議:分層路由要跑出可信結論,關鍵是用同一套接口在不同層切換模型並記錄消耗。推薦通過 API易 apiyi.com 用一個 API Key 同時調用小模型和大模型,配合平臺用量統計對比各層的 token 消耗,新用戶可先用免費測試額度做原型驗證。
「別打一個螺絲收我一份 token 費」的影響分析
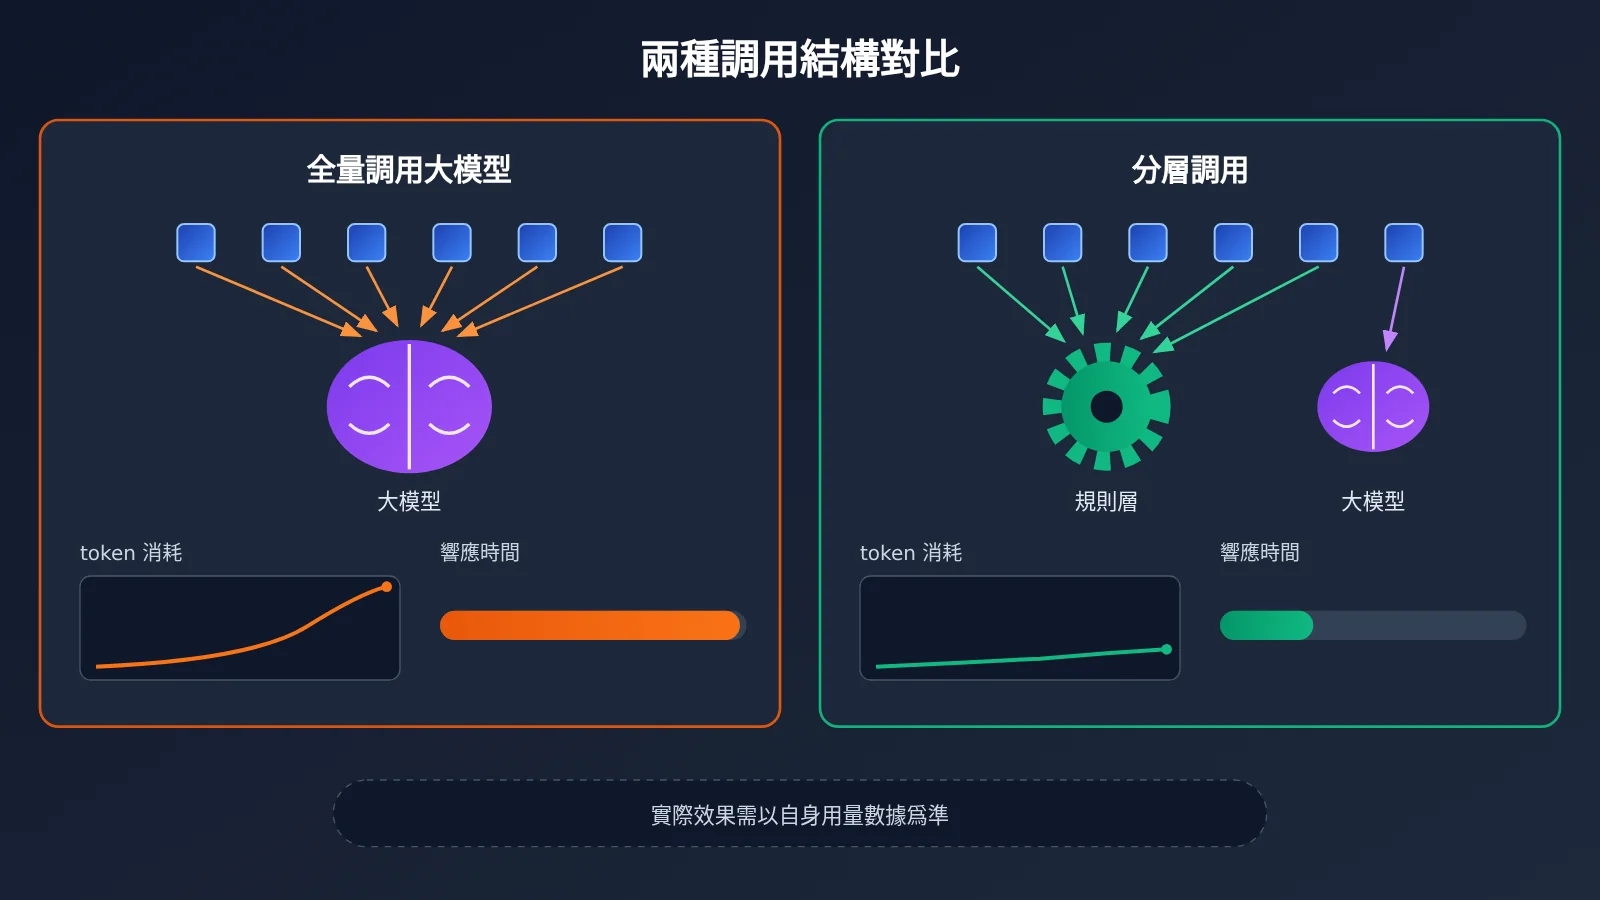
上圖展示的是兩種設計的結構差異,而不是實測數值。具體對比數據建議在 API易 apiyi.com 上用相同請求集分別跑兩種方案,再結合用量記錄得出結論。
| 對比維度 | 全量調用大模型 | 分層調用 | 可用平臺 |
|---|---|---|---|
| 開發速度 | 原型最快,寫提示詞即可 | 需要額外梳理規則和路由 | API易 apiyi.com、各家官方 API |
| token 消耗 | 每個環節都計費 | 只有疑難環節計費爲主 | 同上 |
| 結果確定性 | 確定性任務也可能出現隨機偏差 | 規則層結果可預期 | 同上 |
| 響應延遲 | 每步都需等待模型生成 | 規則層幾乎即時返回 | 同上 |
| 維護成本 | 提示詞越堆越長 | 規則需要隨業務更新 | 同上 |
對工作流搭建者和開發者的影響
- 設計順序會反過來:不再是”先接大模型,再想辦法省錢”,而是先列出所有步驟,標記哪些是”螺絲”,再決定模型放在哪裏。
- 專用模型的位置更重要:像具身模型把物理狀態翻譯成自然語言一樣,中間層的價值在於把模糊輸入整理成結構化問題,讓大模型的每次調用都更聚焦。
- 可觀測性成爲剛需:分層之後必須按層記錄調用次數、token 和延遲,否則無法判斷某一層是否該上調或下沉。
對產品負責人的影響
- 成本模型更可預測:確定性環節不計 token,費用主要集中在可估算的疑難請求上。
- 需要接受”不是越智能越好”:把查訂單交給大模型看起來更智能,但用戶真正需要的是準確和快速。
- 驗證指標要提前定義:分層前後的 token 消耗、任務成功率、端到端延遲,這三項應作爲上線前的對比基線。
對行業的影響
來傑的觀點代表了一種思路:基礎大模型越來越強,並不意味着所有能力都要塞進同一個模型,而是讓不同能力的”智能體”各司其職。在軟件領域,這與工具調用、Agent 編排的發展方向是一致的。不過,專訪討論的是機器人場景,這一思路在軟件工作流中的收益有多大,還缺少公開的案例數據,需要更多團隊的實踐來檢驗。
常見問題 FAQ
Q1:「別打一個螺絲收我一份 token 費」這句話是什麼意思?
這是星塵智能創始人來傑在 2026 年 11 月愛範兒專訪中的說法。他認爲機器人進廠打螺絲這類重複勞動應該交給固定化程序 24 小時運轉,而不是每一次動作都調用模型並支付 token 費。放到 AI 應用中,就是確定性、高頻的環節不該調用大模型。
Q2:機器人的分層思路可以直接用到軟件工作流嗎?
不能直接等同。機器人涉及實時控制、觸覺感知和通訊帶寬,軟件工作流主要受 token 計費、延遲和穩定性約束。可以借鑑的是”執行層自己完成、疑難問題再上升”的分工邏輯,具體收益需要用實際案例驗證。
Q3:怎麼判斷一個環節該用小模型還是大模型?
看輸出是否有限、規則是否穩定。輸出是有限類別、模式穩定的任務(如意圖分類、字段抽取),優先嚐試小模型;需要綜合推理、開放生成或處理異常的任務再交給大模型。建議在 API易 apiyi.com 用同一批樣本分別測試不同模型,比較準確率和消耗後再定。
Q4:分層之後一定能降低成本嗎?
不一定。如果業務請求本身大部分都是複雜問題,規則層攔截不了多少,分層收益就有限;如果規則寫得過寬導致誤攔截,還可能降低成功率。正確做法是先記錄現狀,再對比分層前後的 token 消耗、成功率和延遲。
Q5:如何快速搭建一個分層調用的原型?
可以按以下步驟:
1. 列出工作流全部步驟,標記”螺絲型”環節並用規則實現
2. 訪問 API易 apiyi.com 註冊並獲取 API Key,用 OpenAI 兼容接口同時接入小模型和大模型
3. 參考本文代碼實現路由,並按層記錄 token 和延遲
統一接口的好處是切換模型只需改 `model` 參數,便於反覆對比。
Q6:分層設計有哪些常見坑?
– **規則膨脹**:規則越寫越多,最後比提示詞還難維護,需要定期清理。
– **層間信息丟失**:小模型分類後沒有把上下文傳給大模型,導致大模型重複理解。
– **缺少兜底**:規則和小模型都判斷失敗時,應有轉大模型或轉人工的出口。
「別打一個螺絲收我一份 token 費」核心要點 Key Takeaways
- 觀點來源:出自 2026 年 11 月愛範兒對星塵智能來傑的專訪,屬於創始人觀點。
- 分工邏輯:執行層自己完成動作,只在疑難問題上詢問基礎大模型補充上下文。
- 5 類螺絲環節:格式校驗、數據查詢、模板輸出、流程控制、緩存命中不該調用大模型。
- 三層結構:固定程序打底、專用模型居中、基礎大模型只處理開放和異常問題。
- 類比有邊界:機器人結論不能直接套用軟件場景,收益需用自身數據驗證。
- 驗證三指標:分層前後對比 token 消耗、任務成功率、端到端延遲。
- 上手方式:可通過 API易 apiyi.com 統一接口切換各層模型並觀察用量。
總結
「別打一個螺絲收我一份 token 費」這句話,本質上是在提醒我們重新審視 AI 工作流的調用邊界:
- 先識別螺絲:確定性高、頻率高、有唯一答案的環節,交給固定程序。
- 再放專用模型:有限類別、模式穩定的任務,用小模型完成並整理問題。
- 最後纔是大模型:開放推理、異常決策、創造性生成,才值得爲之付 token 費。
這套方法不依賴某個具體模型或某次發佈,可以長期作爲 Agent 設計的檢查清單。真正落地時,請務必用自己的業務日誌驗證分層前後的差異,而不是直接假設成本一定下降。
如果你正在設計分層工作流,可以通過 API易 apiyi.com 用一個 API Key 接入不同規格的模型,在各層靈活切換並對照用量統計,用數據決定每一顆”螺絲”該由誰來擰。
📚 參考資料
- 愛範兒 – 對話星塵智能來傑:「多樣性公司」欄目第 15 篇專訪
- 鏈接:
ifanr.com/1687805 -
說明: 本文”打螺絲與 token 費”比喻、具身模型與基礎大模型分工思路的原始出處
-
OpenAI Chat Completions 接口文檔:OpenAI 兼容接口參數說明
- 鏈接:
platform.openai.com/docs/api-reference/chat - 說明: 理解
model、max_tokens、usage等字段,便於實現按層用量記錄
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 網站首頁聯繫我們,更多模型接入與用量統計說明可查閱 API易 文檔中心


