
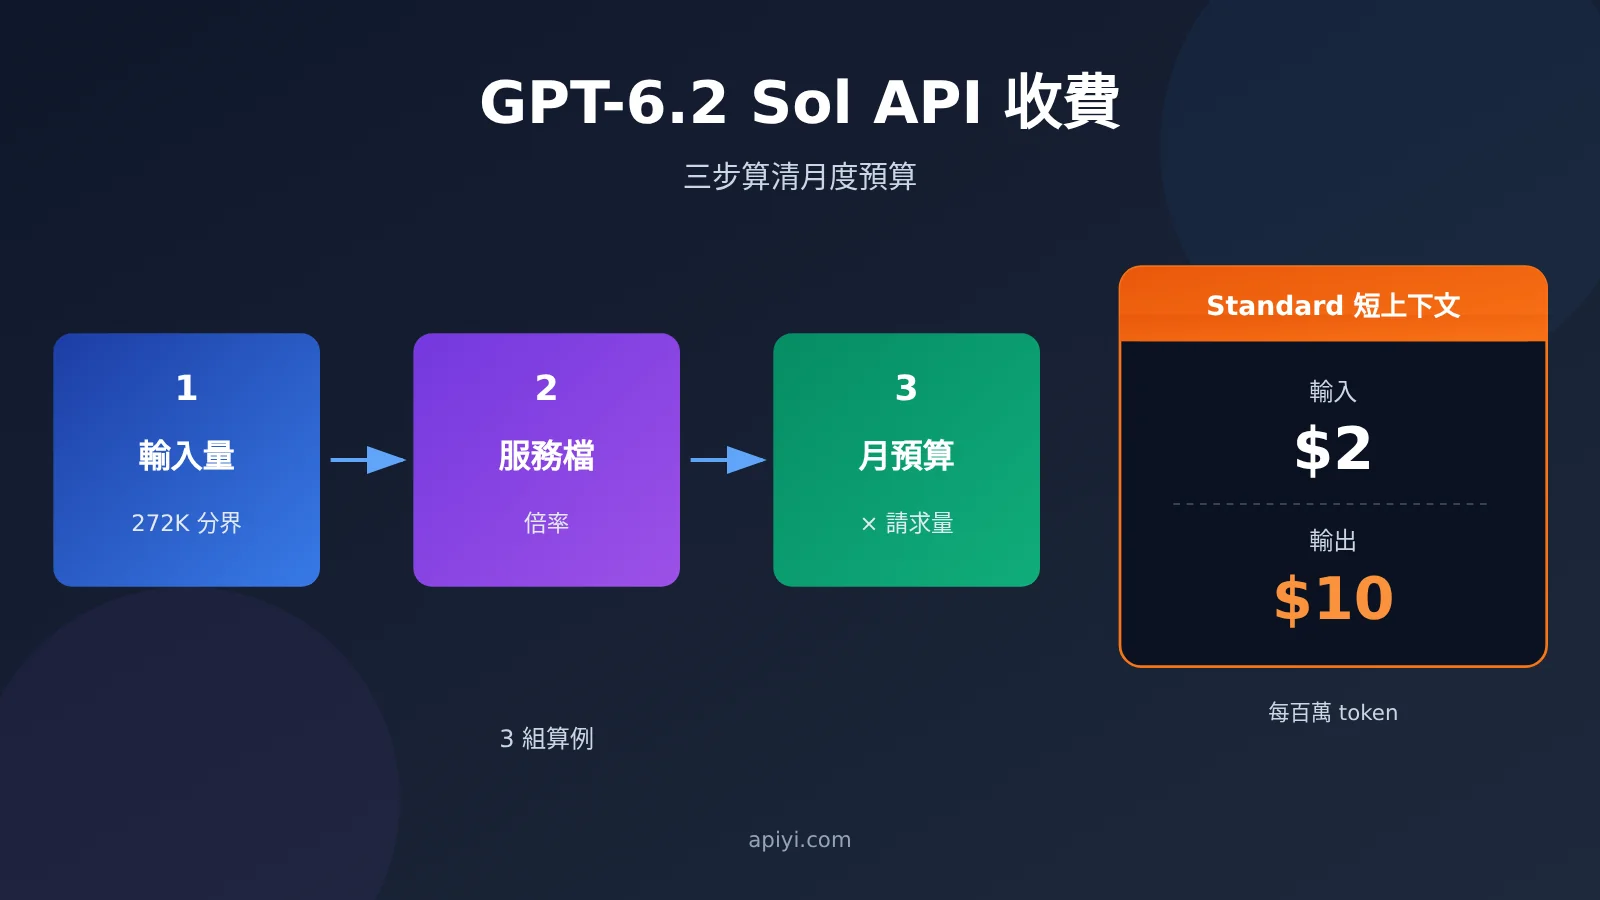
調用 GPT-6.2 Sol 的 API,費用由三步決定。第一步看單次請求的輸入總量,以 272K token 爲界區分短、長上下文;超過這個閾值時,整筆請求的輸入和緩存費率乘 2,輸出乘 1.5。第二步按交付時限選服務檔:Standard 是基準價,Batch 打五折,後臺 8h 與 2h 窗口分別按 60% 和 70% 計費,Fast 爲 2 倍,Ultrafast 在 2027-02-28(太平洋時間)之前爲 3 倍,之後爲 6 倍。第三步把單次費用乘以月請求量,再加上工具調用、適用的區域費用和重試。
短上下文 Standard 的標價爲:普通輸入每百萬 token $2.00,緩存讀取 $0.10,輸出(含推理 token)$10.00。按這個價格,一條 20,000 輸入、3,000 輸出的交互請求約 $0.07,每月 2,000 條約 $140。本文所有價格都以美元 / 百萬 token 計,覈驗日期爲 2026-11-20(北京時間)。
GPT-6.2 Sol API 收費知識地圖與閱讀索引
全文按“輸入量判斷 → 交付時限選檔 → 累計調用”的順序展開。下表把每個環節要回答的問題、輸出結果和正文編號放在一起,前一節的結果是後一節的輸入。
| 步驟 | 要回答的問題 | 本步輸出 | 正文編號 |
|---|---|---|---|
| 輸入量判斷 | 這筆請求落在短上下文還是長上下文 | 適用的基礎費率表 | 1、3.2 |
| 交付時限選檔 | 用戶在線等,還是可以幾小時後或隔日交付 | 服務檔倍率 | 2、3.1 |
| 累計調用 | 每月多少請求,另有哪些附加支出 | 月預算 | 2、4 |
| 渠道復算 | 換一個計費渠道,同一請求要花多少 | 渠道對照與預算表 | 4 |
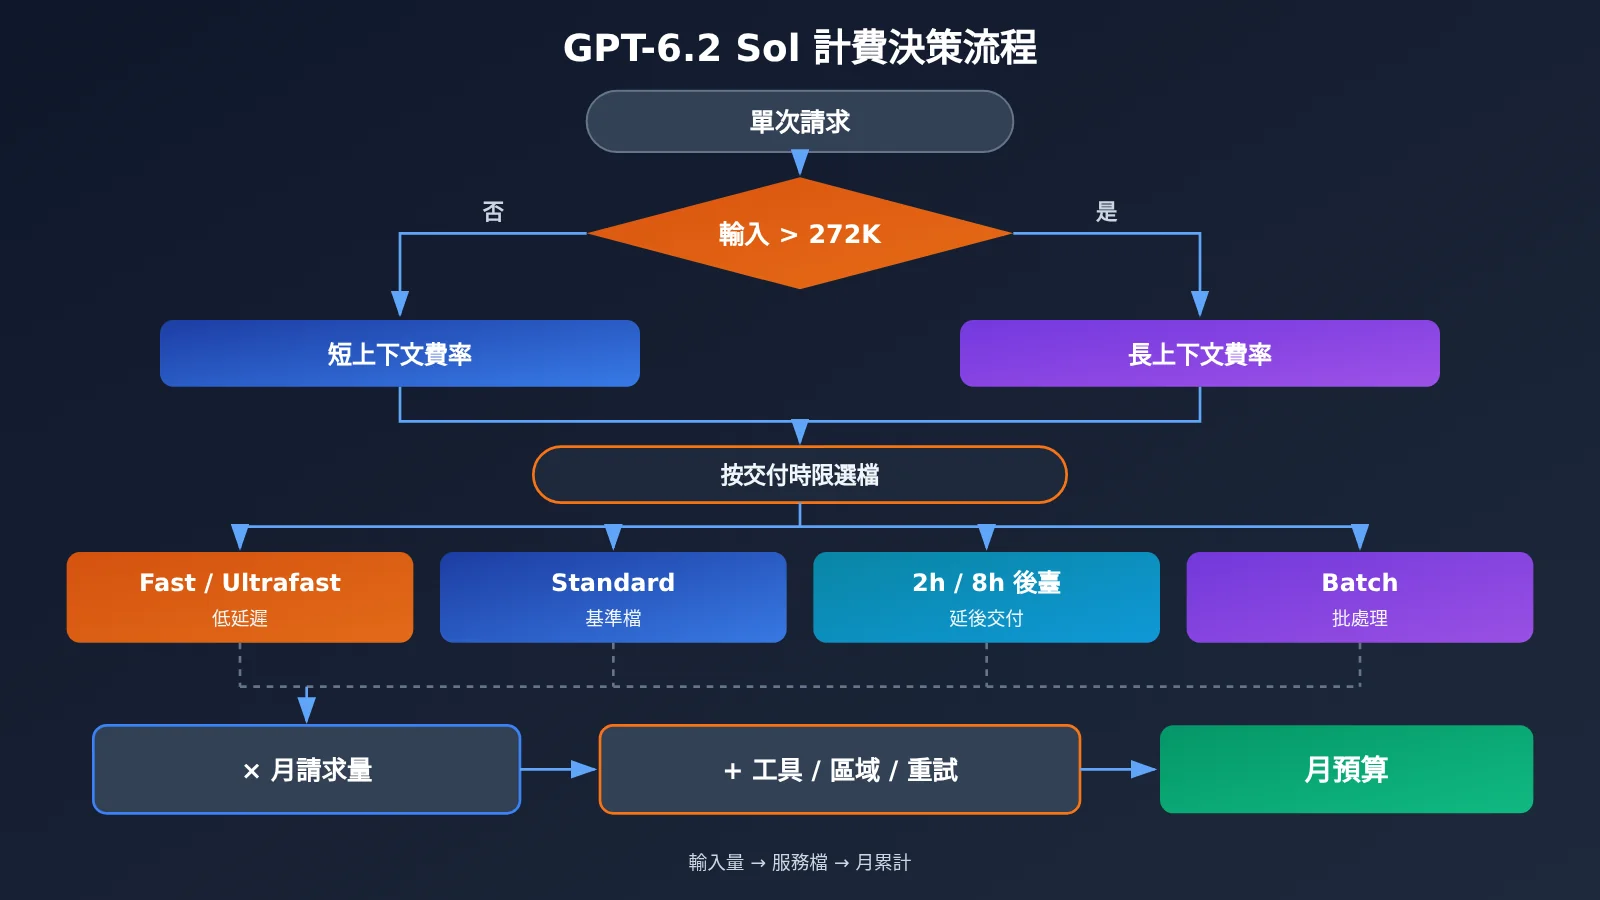
閱讀順序上,第 1 節給出基礎費率,是後面所有算例的依據。第 2 節和第 3 節分別對應“用戶在線等結果”和“允許延後交付”兩類業務,可以只讀與自己相關的那一節。第 4 節把前面的算法套到 API易 apiyi.com 公開價目和 OpenAI 官方費率上並列復算,最後給出一張可以直接填寫的月度預算表。
GPT-6.2 Sol 計費術語 To Know
| 術語 | 解釋 |
|---|---|
| Token | 模型計量文本和其他輸入輸出的基本單位,數量以服務端返回的統計爲準 |
| Standard | 官方 API 的常規處理檔,也是其他檔位倍率的計價基準 |
| 緩存讀取 | 請求複用已緩存的歷史前綴時,這部分輸入按緩存讀取費率計費 |
| 緩存寫入 | 爲以後複用而保存合格前綴的獨立計價類別,分 30 分鐘和 12 小時兩檔 |
| 計費輸出 | API 統計的輸出量,包括推理 token 和最終輸出 |
| Batch API | 把事先準備好的獨立請求以文件形式提交給後臺批處理的接口 |
| 完成窗口 | 後臺請求被接受後,針對初始響應設定的目標時限 |
| Fast 與 Ultrafast | 面向低延遲場景的兩個高費率檔 |
1. GPT-6.2 Sol API 一筆請求有哪些費率
1.1 Standard 檔的五個計費類別
GPT-6.2 Sol 的 API 模型 ID 是 gpt-6.2-sol,可通過 Responses 和 Chat Completions 兩個端點調用。一筆請求最多會涉及五個計費類別,下表是 Standard 檔的官方標價。短上下文的基礎標價與 GPT-6.1 Sol 相同;長上下文欄按模型卡倍率計算。
| Standard 計費類別 | 短上下文(≤272K 輸入) | 長上下文(>272K 輸入) |
|---|---|---|
| 普通輸入 | $2.00 | $4.00 |
| 緩存讀取 | $0.10 | $0.20 |
| 30 分鐘緩存寫入 | $2.50 | $5.00 |
| 12 小時緩存寫入 | $5.00 | $10.00 |
| 輸出(已含推理 token) | $10.00 | $15.00 |
表中有三點容易算錯。
- 緩存寫入不疊加普通輸入。 寫入緩存的那批 token 按 30 分鐘或 12 小時檔的完整費率計一次,不再額外按普通輸入計價。
- 推理 token 計入輸出。 Responses 返回的
usage.output_tokens是輸出總量,推理用量通常作爲子項列在output_tokens_details.reasoning_tokens中,預算按總量計算即可。 - 切檔按整筆請求。 輸入總量一旦超過 272K,整筆請求的輸入、緩存和輸出都換到長上下文費率,並非只對超出部分加價。
模型卡還列出 1,050,000 token 上下文窗口、922,000 token 最大輸入和 128,000 token 最大輸出。922K 是允許的最大輸入,272K 是計費切檔點,兩者互不相關。
1.2 模型費之外的支出
上表只覆蓋模型 token 費。Sol 在 Responses 中可以調用文件搜索、網頁搜索、代碼解釋器和圖像生成等工具,這些工具在實際使用時按各自的獨立規則計費。生成圖片時,Sol 負責發起工具調用,圖像由單獨的圖像工具輸出,圖像費用要另算。部署在特定區域時,還可能產生適用的區域費用。預算表裏應給這些項目單獨留列,不要把它們混進 token 單價。
1.3 用代碼讀取實際計費用量
估算之後,要用真實請求的 usage 字段校準。下面的示例通過 OpenAI 兼容接口調用 Sol,並按短上下文 Standard 費率換算這一次的模型費:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input="用三句話說明 Batch API 適合什麼任務。"
)

u = resp.usage
cached = getattr(getattr(u, "input_tokens_details", None), "cached_tokens", 0) or 0
plain_in = u.input_tokens - cached
cost = (plain_in * 2.00 + cached * 0.10 + u.output_tokens * 10.00) / 1e6
print(resp.output_text)
print(f"輸入 {u.input_tokens},其中緩存 {cached},輸出 {u.output_tokens},模型費約 ${cost:.6f}")
這個換算只適用於輸入不超過 272K、沒有緩存寫入的 Standard 請求。生產環境建議把每次請求的 usage 寫入日誌,按任務類型彙總後再填入第 4 節的預算表。
🎯 官方推薦做法:正式定預算之前,先用 20 到 50 條真實業務請求跑一輪,統計輸入和輸出的分佈。API易 apiyi.com 新用戶有免費測試額度,適合做這類小樣本標定。
2. GPT-6.2 Sol 交互檔位和月預算怎麼算
2.1 同一請求在三個交互檔的費用
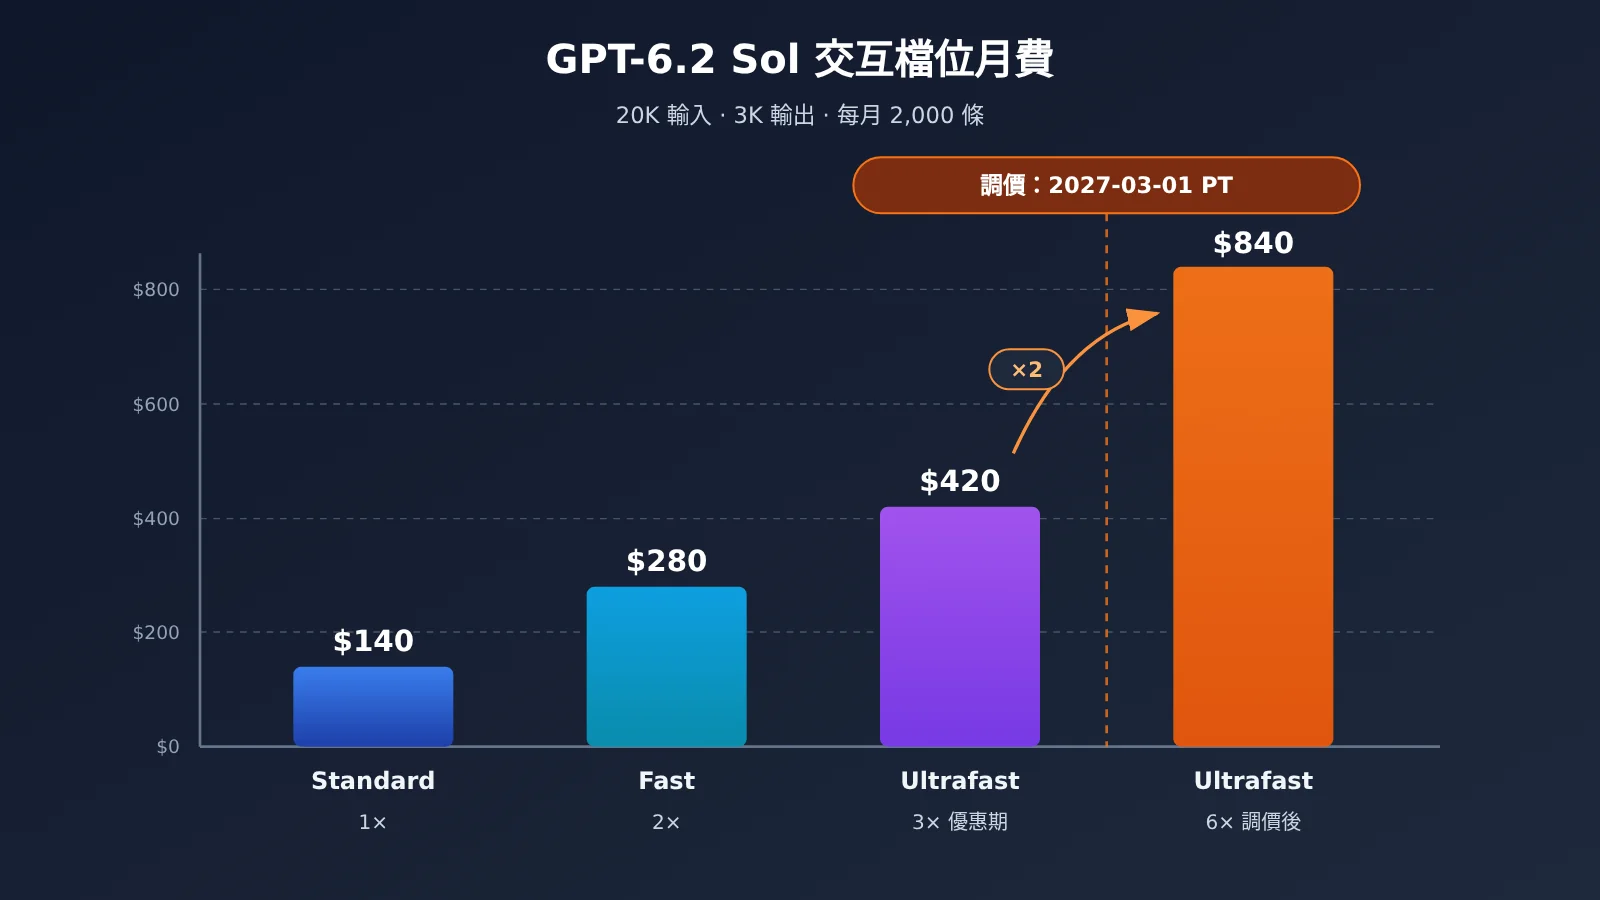
交互場景下,用戶在界面上等待結果,可選的是 Standard、Fast 和 Ultrafast。Fast 按 Standard 的 2 倍計費;Ultrafast 到 2027-02-28(太平洋時間)爲 3 倍,2027-03-01 起爲 6 倍。GPT-6.2 Sol 不支持 Flex 檔。
算例假設一條請求有 20,000 普通輸入、3,000 計費輸出 token,沒有緩存、工具、區域費用和重試,每月 2,000 條。Standard 單次費用爲 20000×2/1e6 + 3000×10/1e6 = $0.07。
| 服務檔 | 倍率 | 單次費用 | 每月 2,000 條 |
|---|---|---|---|
| Standard | 1× | $0.07 | $140 |
| Fast | 2× | $0.14 | $280 |
| Ultrafast(至 2027-02-28 PT) | 3× | $0.21 | $420 |
| Ultrafast(2027-03-01 PT 起) | 6× | $0.42 | $840 |
2.2 讀這張表時要注意的條件
表中固定了每條請求的用量,便於安排預算。實際上,同一任務在不同檔位的 token 消耗和延遲會隨請求變化,上線前應在每個候選檔位上各跑一批真實請求複覈。
如果在 2027 年 3 月之前用 Ultrafast 做預算,要同時準備一份按 6 倍計算的版本。以本例計算,調價後月費從 $420 變爲 $840,漲價發生在太平洋時間 3 月 1 日,換算成北京時間是 3 月 1 日下午。
💡 選檔建議:大多數交互請求先用 Standard 上線,只對延遲敏感的入口單獨切到 Fast 或 Ultrafast。通過 API易 apiyi.com 用同一個 API Key 並行測試,可以較快拿到各檔的真實延遲和用量數據。
3. GPT-6.2 Sol 夜間處理和長文檔費用怎麼估
3.1 夜間批量任務:2h、8h 與 Batch
不需要即時返回的任務有三種折扣方式。Responses 後臺模式的 2h 和 8h 完成窗口分別按 Standard 模型 token 費率的 70% 和 60% 收費,但請求必須是 Standard 且非流式,窗口指初始響應的目標時間;soonest 沒有窗口折扣。Batch API 按 Standard 的 50% 收費,以文件批量提交,週轉窗口爲 24 小時。
算例假設共 10,000 條請求,每條 50,000 普通輸入、4,000 計費輸出 token,無緩存和工具。Standard 單次費用爲 50000×2/1e6 + 4000×10/1e6 = $0.14。
| 方式 | 費率 | 單次費用 | 10,000 條合計 | 何時選用 |
|---|---|---|---|---|
| Standard | 100% | $0.14 | $1,400 | 需要儘快拿到結果 |
後臺 2h |
70% | $0.098 | $980 | 應用需在兩小時內拿到初始響應,任務中途要回填工具結果 |
後臺 8h |
60% | $0.084 | $840 | 當晚提交、次日上班前交付,且需要逐步交互 |
| Batch API | 50% | $0.07 | $700 | 請求事先已準備好、相互獨立,可以隔日交付 |
可以按任務形態來組織。分類、抽取這類彼此獨立、提交前就能全部寫好的任務,可以把 Batch 當作價格基準。任務中途需要應用提供工具結果再繼續的,按每一步分別估算,再根據應用端的總交付時限選擇 2h 或 8h 窗口。
還有一項容量約束:折扣後臺請求與 Batch 共享一個獨立的隊列額度。計劃大批量提交前,需要覈對積壓的輸入 token 配額,避免請求在隊列裏被卡住。
3.2 長文檔:跨過 272K 時的費用跳變
長文檔的費用跳變來自切檔規則。算例假設無緩存和工具,輸出固定 6,000 token,Standard 檔,輸入分別爲 270,000 和 280,000:
| 輸入量 | 適用費率 | 計算 | 單次模型費 |
|---|---|---|---|
| 270,000 | 短上下文 | 270000×2/1e6 + 6000×10/1e6 |
$0.60 |
| 280,000 | 長上下文 | 280000×4/1e6 + 6000×15/1e6 |
$1.21 |
輸入只多出 10,000 token,單次費用卻從 $0.60 變爲 $1.21,增加約一倍。原因是整筆請求都改按長上下文計價,輸出單價也從 $10 變成 $15。
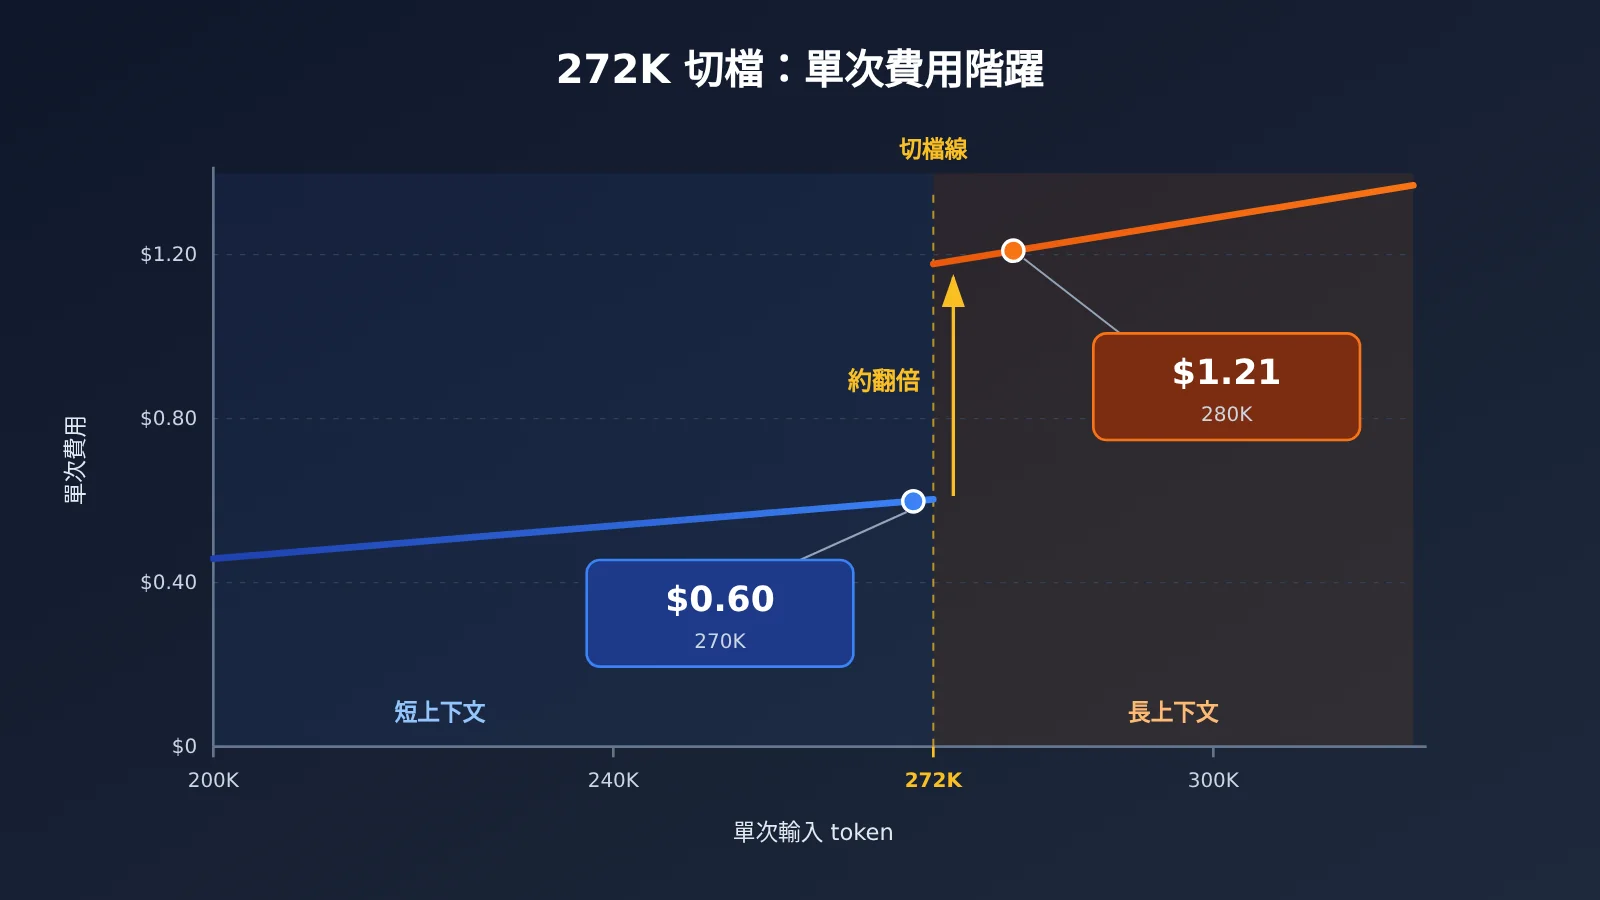
做預算時,應按業務隊列記錄每條請求的輸入分佈,把常態請求和長文檔高峯分開估算後再累加。如果打算通過裁剪文檔把輸入壓到 272K 以下,必須同時驗證裁剪後的內容是否還保留了交付所需的證據,否則省下的費用可能要用返工補回來。
4. 按渠道填寫 GPT-6.2 Sol 月預算
4.1 API易公開價目與 OpenAI 官方費率並列復算
2026-11-20 回讀 API易公開模型總表和公開定價接口,均可查到 gpt-6.2-sol,總表標註了 responses 和 chat 兩個入口。公開定價同樣以 272,000 輸入 token 切檔,但長檔的計價表達式與官方倍率不同。
| 計費類別(USD / 百萬 token) | OpenAI 短檔 | OpenAI 長檔 | API易 apiyi.com 短檔 | API易 apiyi.com 長檔 |
|---|---|---|---|---|
| 普通輸入 | $2.00 | $4.00 | $2.00 | $3.00 |
| 緩存讀取 | $0.10 | $0.20 | $0.10 | $0.15 |
| 緩存寫入 | $2.50(30 分鐘) | $5.00(30 分鐘) | $2.50 | $3.75 |
| 輸出 | $10.00 | $15.00 | $10.00 | $11.25 |
沿用 3.2 節的用量復算。270,000 輸入、6,000 輸出時,兩個渠道都是 $0.60。280,000 輸入、6,000 輸出時,OpenAI 官方爲 $1.21,按 API易公開公式爲 (280000×3 + 6000×11.25)÷1e6 = $0.9075,每條相差約 $0.30。長文檔佔比越高,這個差額對月預算的影響越大。
上述差額只根據雙方已公開的參數推導。前文的 Batch 和後臺窗口折扣用的是 OpenAI 官方算例;在 API易調用時,賬戶分組、實際扣費、可用檔位和 API 能力以 API易當前配置和賬單爲準。
4.2 一行一類任務的月度預算表
把前面的算法落到一張表上:每類任務佔一行,按單次請求的平均用量填寫,再乘以月請求數。工作流中有多次模型調用(例如 Agent 的多步推理)時,每一步單獨記一行,最後逐條累加。
| 任務類型 | 月請求數 | 平均普通輸入 | 平均緩存讀取 | 緩存寫入(檔位) | 平均計費輸出 | 上下文檔 | 服務檔 | 另計費用(工具 / 區域) | 預計重試率 | 月費用 |
|---|---|---|---|---|---|---|---|---|---|---|
| 客服交互 | 2,000 | 20,000 | 0 | 0 | 3,000 | 短 | Standard | 無 | 0% | $140 |
| 夜間分類 | 10,000 | 50,000 | 0 | 0 | 4,000 | 短 | Batch | 無 | 0% | $700 |
| 合同審閱 | 按實際填寫 | 按實際填寫 | 6,000 | 長 | Standard | 按實際填寫 | 按實際填寫 |
前兩行的數字來自本文的算例,可以作爲填寫參照。月費用的計算公式是“單次模型費 × 月請求數 × (1 + 重試率) + 另計費用”。其中,單次模型費要按該行的上下文檔和服務檔,從第 1 節的費率表中取值。
🚀 落地建議:預算表填完後,挑出金額最高的兩類任務,在 API易 apiyi.com 上用真實請求各跑一輪,拿
usage實測值替換估算值,就是一份可以交給財務的預算。
4.3 檢驗預算是否可靠
拿到第一個月的賬單後,逐行覈對三件事。
- 實際輸入分佈中,超過 272K 的請求佔比是否接近預估。
output_tokens中推理 token 的佔比是否明顯高於測試階段。- 重試和工具調用的實際次數是否被計入。
三項的偏差都在一成以內,下個月就可以直接沿用這張表;偏差更大的那一項,就是需要優先調整用量或檔位的地方。
參考資料
- OpenAI 官方 API 定價:各服務檔倍率與 Batch、後臺窗口折扣
- 鏈接:
developers.openai.com/api/docs/pricing
- 鏈接:
- GPT-6.2 Sol 模型卡:上下文窗口、272K 切檔規則與限額
- 鏈接:
developers.openai.com/api/docs/models/gpt-6.2-sol
- 鏈接:
- 後臺模式與 Batch API 指南:完成窗口、非流式要求與隊列額度
- 鏈接:
developers.openai.com/api/docs/guides/background、developers.openai.com/api/docs/guides/batch
- 鏈接:
- API易模型總表與公開定價接口:
gpt-6.2-sol掛牌入口與切檔計價表達式- 鏈接:
docs.apiyi.com/models.md、api.apiyi.com/api/pricing
- 鏈接:
作者:APIYI 技術團隊
技術交流:計費口徑和賬戶配置相關的問題,可在 API易官網首頁聯繫我們,更多接入資料見 docs.apiyi.com 文檔中心









