摘要:在 VibeVideoBench 的代碼驅動視頻任務中,GPT-6 Astra 已與 Claude Opus 5.5 處於同一水平,綜合質量略高、成本更低;Opus 5.5 交付更穩定;OpenAI 下一代通用模型尚未發佈,其視頻能力需要發佈後實測。
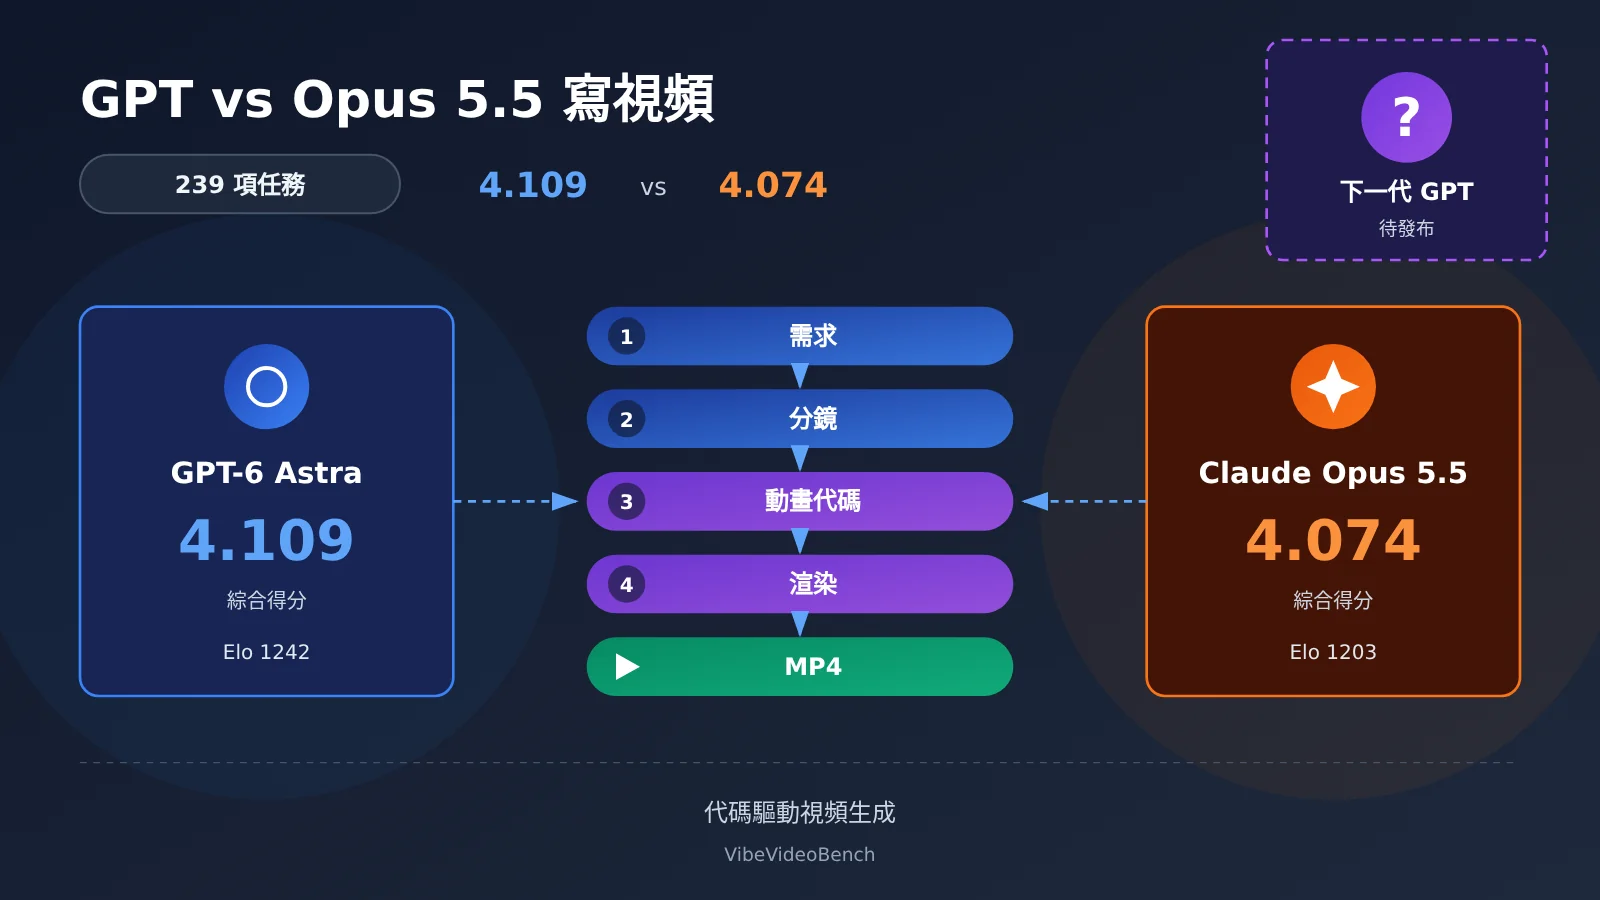
結論先行:截至 2026 年 11 月 15 日,在“Agent 編寫代碼、調用渲染工具、交付完整 MP4”這條路線上,GPT-6 Astra 與 Claude Opus 5.5 是 VibeVideoBench 中最接近的兩個系統。Astra 綜合質量得分 4.109,Opus 5.5 爲 4.074;人工盲測 Elo 分別爲 1242 和 1203,統計上無法區分。Opus 5.5 交付全部 239 項任務,嚴格任務成功率 76.3%,高於 Astra 的 74.5%;Astra 平均每項任務 API 成本 8.19 美元,約爲 Opus 5.5 的一半。OpenAI 已公開兩項內部模型顯著強於 Astra 的證據,但下一代通用 GPT 的名稱、發佈時間和視頻專項成績均未公佈。所以對標題問題的回答是:現款 GPT 已經趕上,下一代能否拉開差距取決於發佈後的實測。
內容預告:下文先界定評測範圍,再拆解 VibeVideoBench 的總體成績、分類成績、人工偏好和成本數據,說明兩者各自的優勢來自哪裏;隨後梳理 OpenAI 內部模型的公開信號與下一代模型的發佈狀態,分析視頻 Agent 真正的瓶頸;最後給出一套在新模型發佈後可直接複用的對比測試方法,幫助你判斷它是否值得替換現有方案。
To Know:閱讀本文前需要了解的術語
| 術語 | 解釋 |
|---|---|
| Code-driven Video Generation | 代碼驅動視頻生成:AI 編寫動畫和渲染程序,最終輸出 MP4 |
| Native Video Generation | 原生視頻生成:模型直接根據文字、圖片生成視頻畫面,代表產品有 Sora、Veo |
| VibeVideoBench | 專門測試 AI Agent 自主製作完整視頻的評測基準,2026 年 10 月 26 日發佈 |
| Harness | 模型運行環境,提供代碼執行、文件訪問、工具調用等能力,如 Codex CLI、Claude Code |
| L1 / L2 / L3 | 評測的三層:程序交付檢查、任務要求逐條檢查、多模態評審的視頻質量評分 |
| 嚴格任務成功率 | 視頻成功交付且滿足全部約束的任務比例,比單純“交付率”更嚴格 |
| Bradley–Terry Elo | 根據人工兩兩比較結果計算模型相對偏好的評分方法 |
| Multi-agent Orchestration | 多智能體編排:讓多個 Agent 分工協作,再整合結果 |
| Render Pipeline | 視頻渲染流水線:畫面生成、音頻處理、編碼合成到最終輸出 |
| Remotion / FFmpeg | 前者用 React 代碼寫視頻動畫,後者負責音視頻編碼與合成 |
| ffprobe | FFmpeg 附帶的檢查工具,用來讀取視頻的分辨率、幀率、時長、音軌等信息 |
| Cache Hit | 緩存命中率:重複上下文從緩存讀取的比例,直接影響長任務的 API 成本 |
| BenchCAD 2.0 | 測試 AI 三維零件重建、機械裝配設計和 PCB 連接識別能力的工程評測 |
1 先給結論:GPT 已經進入 Opus 5.5 的視頻創作競爭區間
1.1 本文比較的是哪一種“寫視頻”
AI 視頻創作目前有兩條路線。原生視頻生成由模型直接輸出連續畫面,擅長人物、物理運動和鏡頭語言;代碼驅動視頻生成則讓模型擔任導演兼程序員:理解需求、寫腳本和分鏡、用 Remotion、Three.js、Cairo 或 Blender 編寫動畫、用 TTS 生成旁白、再用 FFmpeg 合成並檢查成片。
本文討論的是第二條路線,也就是通過 Codex CLI、Claude Code 這類 Agent 交付完整 MP4 和可編輯工程的能力。這條路線適合數據可視化、產品介紹、知識科普、動態信息圖和品牌宣傳片,也是 GPT 與 Claude 目前有獨立基準可比的領域。
OpenAI 自己的原生視頻產品線已經發生變化:Sora 產品於 2026 年 4 月 26 日停止服務,Sora 2 模型及 Videos API 於 9 月 24 日關停,官方棄用公告註明沒有一對一替代 API。11 月 4 日發佈的 GPT-Image-2.6 支持 2—16 幀的 GIF 動畫輸出,適合表情包、循環動作和分鏡預覽,與完整 MP4 製作屬於不同工作流。因此,GPT 系列“寫視頻”的能力,當下主要體現在代碼驅動路線上。
1.2 一句話回答標題問題
GPT-6 Astra 在 VibeVideoBench 中與 Opus 5.5 極爲接近,綜合評分略高,交付穩定性略低。OpenAI 下一代模型具備繼續提升的技術信號,但公開的視頻專項成績仍以 Astra 爲基準。
2 239 項真實視頻任務:GPT-6 Astra 與 Opus 5.5 誰更強?
2.1 VibeVideoBench 如何測 GPT 與 Opus 5.5 的視頻能力
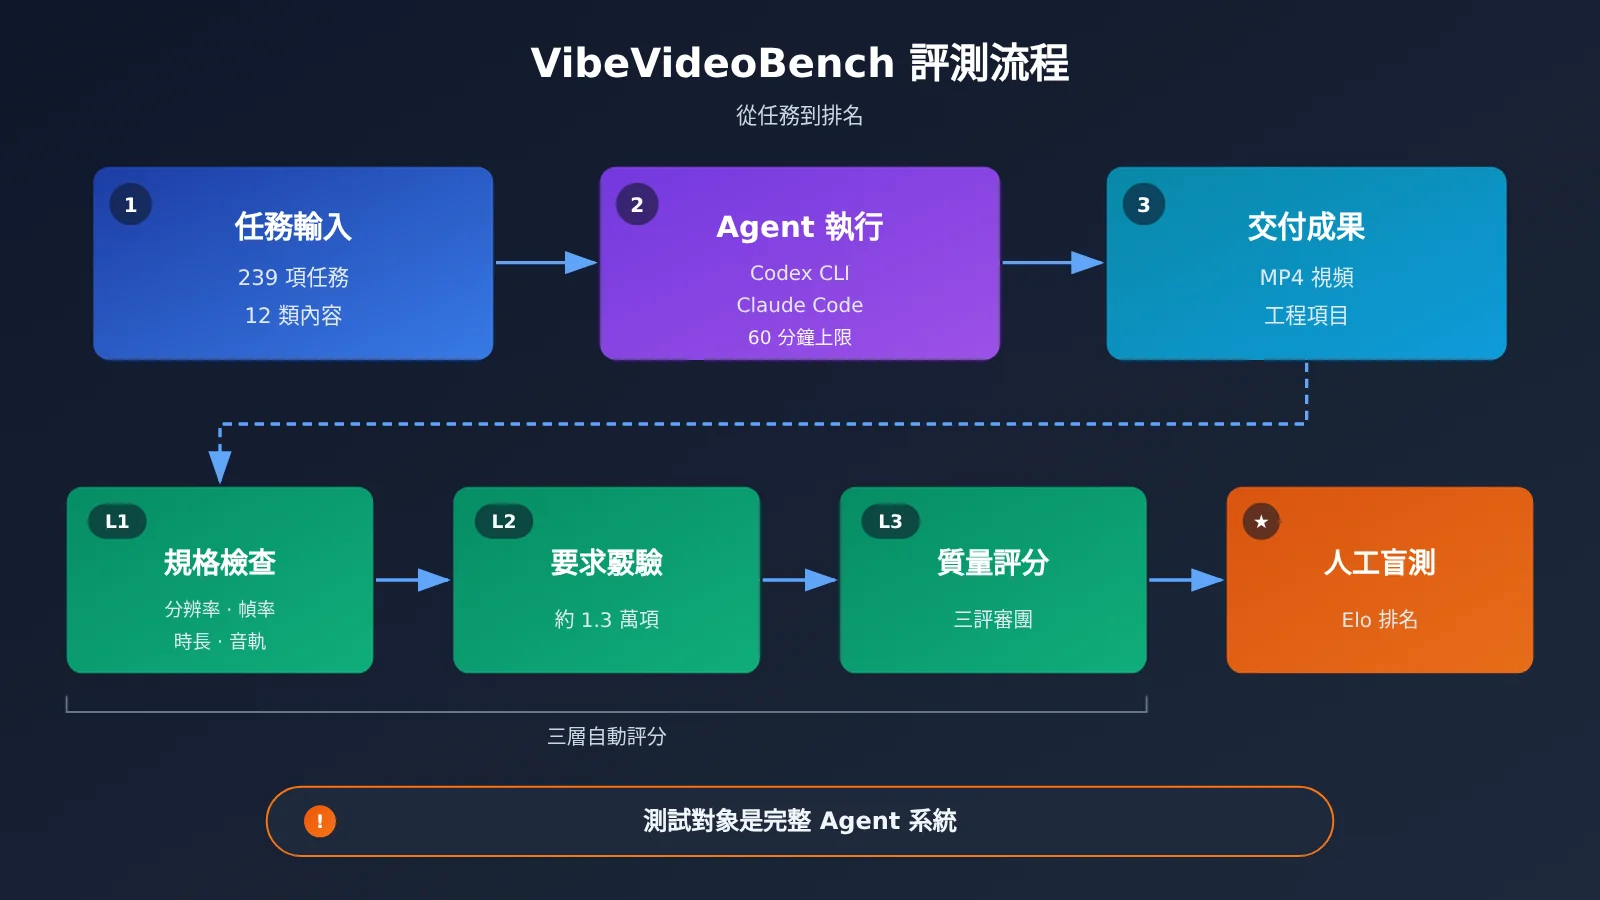
VibeVideoBench 構建了 239 項真實視頻製作任務,覆蓋 12 類內容,共測試 9 個 Agent 系統、2,151 次運行。每項任務要求 AI 在沙箱中自主完成,交付可播放 MP4、可重新生成視頻的工程項目以及製作說明。每項任務限時 60 分鐘,所有系統使用各自原生開發環境、最高可用推理強度,中途不追加人工指令。
GPT-6 Astra 運行在 Codex CLI 中,Claude Opus 5.5 運行在 Claude Code 中。其餘參測系統包括 Claude Sonnet 5.5、Gemini 4 Argon、DeepSeek V4.1 Flash、Kimi K3、GLM-5.3 Flash、GPT-5.6 Sol 和 Gemini 3.8 Flash。評分分三層:L1 檢查 MP4 是否交付及分辨率、幀率、時長、音軌等規格;L2 逐條驗證約 1.3 萬項任務要求;L3 由三個多模態評審系統評估畫質、美感、內容邏輯、運動節奏和音頻同步。
2.2 GPT-6 Astra 與 Opus 5.5 總體成績對比
| 指標 | GPT-6 Astra | Claude Opus 5.5 | 領先 |
|---|---|---|---|
| 成功交付視頻 | 238/239 | 239/239 | Opus |
| 視頻交付率 | 99.6% | 100% | Opus |
| 規格符合率 | 93.7% | 99.6% | Opus |
| 任務要求通過率 | 97.1% | 97.3% | Opus |
| 視頻質量 | 4.08 | 3.99 | Astra |
| 視覺美感 | 4.30 | 4.19 | Astra |
| 內容邏輯 | 4.20 | 4.18 | Astra |
| 運動與節奏 | 3.95 | 3.95 | 平 |
| 音頻質量與同步 | 4.10 | 4.07 | Astra |
| 綜合質量得分 | 4.109 | 4.074 | Astra |
| 嚴格任務成功率 | 74.5% | 76.3% | Opus |
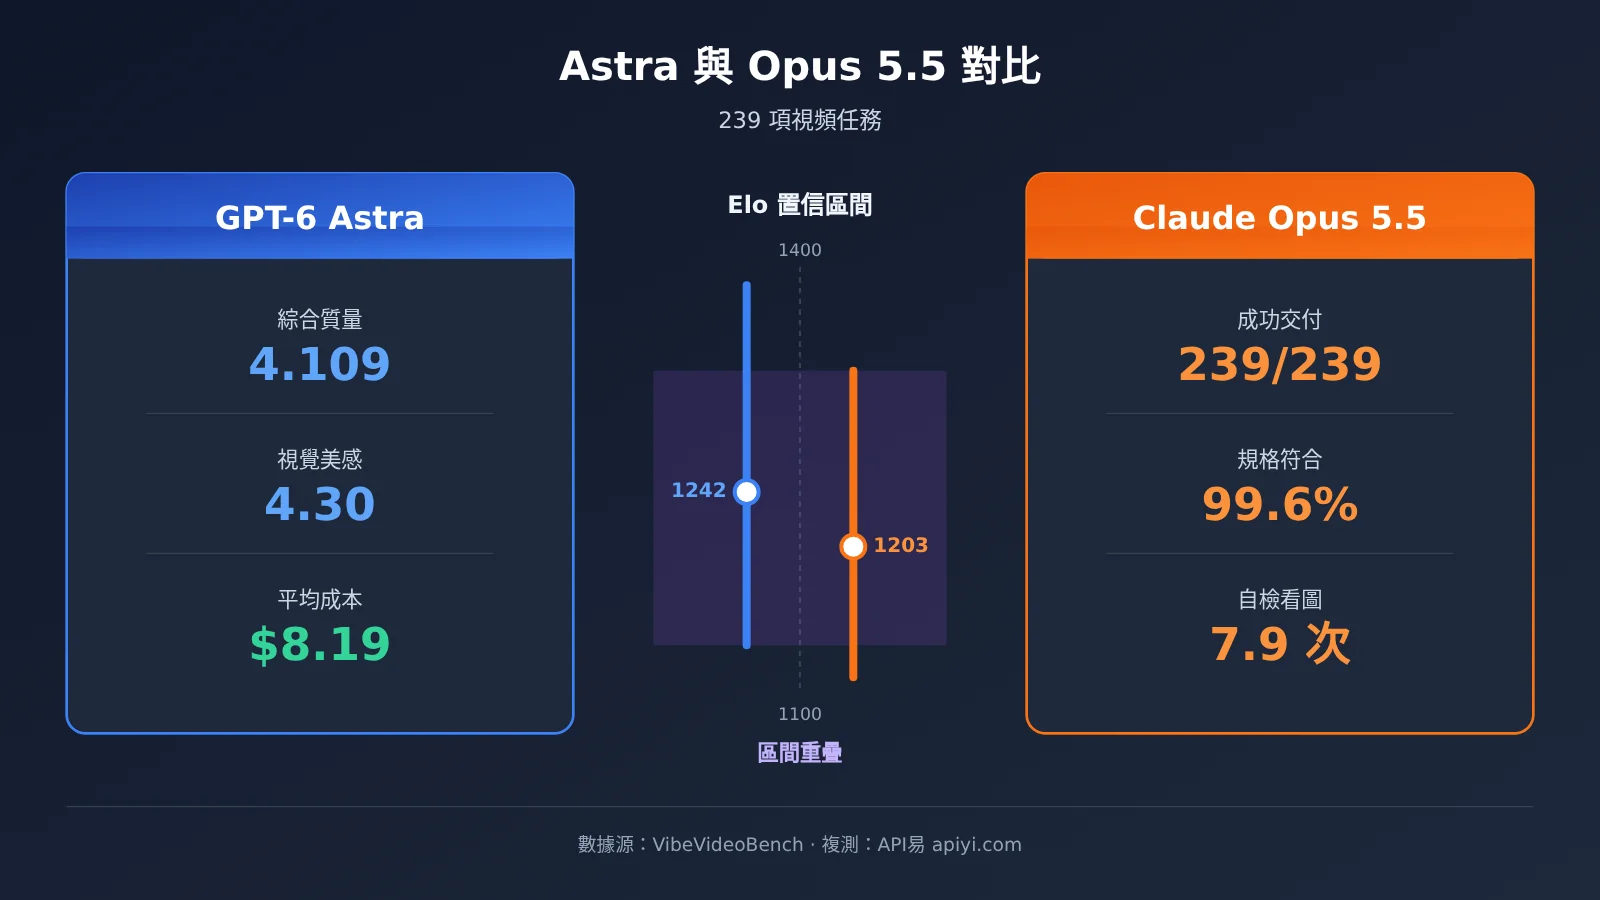
| 人類偏好 Elo | 1242 | 1203 | 統計上無法區分 |
數據來自三評審團平均結果,評分範圍 1—5 分。兩個系統均領先其他參測系統。
這張表呈現出清晰的分工:Astra 在“做出來的視頻好不好看”上略佔優勢,綜合質量領先 0.035 分,視覺美感領先 0.11 分;Opus 5.5 在“能不能按規格交出來”上更可靠,規格符合率高出 5.9 個百分點,嚴格任務成功率高出 1.8 個百分點。0.035 分的差距很小,結合 Elo 置信區間來看,兩者處於同一檔位。
2.3 不同視頻類型中 GPT 與 Opus 5.5 的優勢分佈
| 視頻類別 | Astra | Opus 5.5 | 領先者 |
|---|---|---|---|
| 品牌與營銷 | 4.18 | 4.18 | 平局 |
| 產品與功能展示 | 4.20 | 4.24 | Opus |
| 音樂與聲音驅動 | 3.83 | 3.92 | Opus |
| 論文解讀 | 4.03 | 4.07 | Opus |
| 概念與流程解釋 | 4.19 | 4.15 | Astra |
| 數據與事實故事 | 4.14 | 4.01 | Astra |
| 視覺藝術 | 3.94 | 3.91 | Astra |
| 遊戲與體育 | 4.15 | 4.12 | Astra |
| 活動與個人表達 | 4.03 | 3.93 | Astra |
| 故事與視覺喜劇 | 4.00 | 3.88 | Astra |
| 建造與製作流程 | 3.97 | 3.94 | Astra |
| 課堂教學 | 4.47 | 4.45 | Astra |
數據來自論文 Appendix E.4,計入未交付視頻的零分。
Astra 在 12 類中領先 8 類,差距最大的是數據與事實故事(0.13)和故事與視覺喜劇(0.12);Opus 5.5 在產品展示、音樂驅動和論文解讀中領先,音樂驅動的差距爲 0.09。音樂類任務對音畫對齊要求高,產品展示對規格和細節要求高,這與 Opus 在規格符合率上的優勢方向一致。大部分類別的差距在 0.05 分以內,模型選擇已出現任務類型差異,但單類差距仍需結合重複測試判斷。
2.4 Opus 5.5 爲什麼仍然有競爭力
人工盲測採用 Bradley–Terry 模型計算 Elo。Astra 爲 1242(95% 置信區間 1134–1387),Opus 爲 1203(1111–1327),兩者排名置信區間都是 1–3,論文給出的比較概率 P=0.69,結論是統計上無法區分。需要注意,人工測試只評價已經交付的視頻,無法衡量按時交付能力,而交付恰好是 Opus 的強項。
自檢行爲解釋了這一點。Opus 每次運行平均查看渲染圖片 7.9 次、使用 ffprobe 3.9 次;Astra 分別爲 3.4 次和 2.1 次。Opus 更頻繁地檢查自己的輸出、發現問題再修復,換來了 100% 的交付率和 99.6% 的規格符合率。Anthropic 將 Opus 5.5 定位爲長時間運行的 Agentic Coding 模型,社區也有用戶自述用它約 30 分鐘完成 iOS 應用宣傳片、自動製作 1080×1920 豎屏新聞短視頻並附帶 SRT 字幕,這些屬於個人案例,可作爲工作流完整性的旁證。
2.5 視頻任務成本:GPT-6 Astra 單價更高,單任務更便宜
| 指標 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| 標準輸入價(美元/百萬 Token) | 10 | 4 |
| 標準輸出價(美元/百萬 Token) | 50 | 20 |
| 平均任務成本 | $8.19 | $15.38 |
| 中位任務成本 | $7.88 | $10.19 |
| P90 任務成本 | $11.88 | $31.22 |
| 平均輸出 Token | 61K | 130.7K |
| 每項任務 API 調用 | 46 | 51 |
| Cache Hit | 97% | 65% |
Astra 的標準單價是 Opus 5.5 的 2.5 倍,但平均任務成本低約 46.7%。原因有兩個:Astra 輸出 Token 少約 53.3%;Astra 緩存命中率達到 97%,而 Opus 約 76% 的任務成本來自 Cache Write。P90 成本差距更明顯,Opus 在複雜任務上的成本波動更大。論文也指出,單純增加 Token 消耗並沒有帶來對應的質量提升。
這組成本是按公開 API 價格折算的等價成本,不含完整商業視頻的人工和素材費用。Opus 5.5 官方 Batch API 提供輸入輸出五折,離線批量製作時成本結構會變化。
💰 成本優化:視頻 Agent 的單任務成本受緩存命中和輸出長度影響很大,只看單價容易誤判。建議在 API易 apiyi.com 上用同一任務分別跑兩家模型,按“每條成片的實際消耗”來覈算,而不是按標價比較。
3 OpenAI 下一代 GPT 的能力提升信號
3.1 Navier–Stokes 研究:內部模型顯著強於 GPT-6 Astra
2026 年 9 月 8 日,OpenAI 發佈 Navier–Stokes 千禧年大獎問題研究成果。官方文章寫明,所用內部模型能力顯著強於 GPT-6 Astra,採用大規模強化學習訓練,公告發布時訓練仍在繼續。
這項研究的執行規模是多智能體能力的直接展示:約 10,000 個 Agent 同時參與,研究耗時約 88 小時,產生 270 萬條消息、約 1,300 億輸出 Token;Agent 分組研究不同版本的問題,小組之間交換信息,由 Codex 整合中間成果,系統持續把資源集中到更有希望的路線上。最後的 Lean 形式化驗證額外用時 17 小時,使用的是 GPT-6 Astra。
對視頻創作而言,這裏最相關的是長時程任務調度和多 Agent 協作,而非數學能力本身。一條複雜視頻同樣需要並行處理腳本、動畫、音頻,再整合、檢查、返工。
3.2 BenchCAD 2.0:工程能力從 0.594 提升到 0.875
2026 年 11 月 3 日,OpenAI 在《Accelerating engineering for the physical world》中公佈:一個較新的內部模型在 BenchCAD 2.0 獲得 0.875 的平均成績,GPT-6 Astra 在最高推理強度下爲 0.594,相對提升約 47.3%。測試內容包括三維零件重建、機械裝配設計和 PCB 連接識別。
這兩項證據應分開看待。OpenAI 沒有說明 BenchCAD 測試模型與 Navier–Stokes 研究模型是否爲同一個,名稱和發佈時間也均未公佈。BenchCAD 是 OpenAI 自己公佈的工程測試,屬於空間理解與複雜工程知識的進步信號,與視頻生成任務沒有直接對應關係。
3.3 下一代 GPT 何時發佈:截至 11 月 15 日的公開狀態
| 日期 | 公開進展 |
|---|---|
| 11 月 2 日 | 據 The National 報道,Altman 在 ADIPEC 表示數學研究使用了一個即將發佈的 GPT 模型,約 10,000 個 Agent 協作約四天;報道註明該表述未經獨立驗證 |
| 11 月 3 日 | OpenAI 公佈內部模型 BenchCAD 2.0 數據 |
| 11 月 4 日 | The Information 援引知情人士報道,OpenAI 可能最快 11 月 6 日推出新一代 Astra、Sol 和網絡安全模型 |
| 11 月 5 日 | OpenAI API Changelog 確認發佈 GPT-6 Cyber,未發佈新一代通用 Astra 或 Sol |
| 11 月 15 日 | 官方模型目錄的通用旗艦仍爲 GPT-6 Astra、GPT-6.1 Sol、GPT-6.1 Terra、GPT-6 Luna |
網絡上流傳的 GPT-6.2 Astra、GPT-6.2 Sol 等名稱目前沒有獲得 OpenAI 官方確認。同樣要注意,VibeVideoBench 測的是 GPT-6 Astra 和 GPT-5.6 Sol,Astra 的成績不能直接套用到 GPT-6.1 Sol 或 Terra 上。
4 下一代 GPT 要在視頻創作上超越 Opus 5.5,還需要什麼
4.1 視頻 Agent 的真正瓶頸:時間管理與交付
VibeVideoBench 全部 2,151 次運行中,有 224 次沒有交付可播放視頻。其中 169 次屬於時間管理問題:最終渲染啓動太晚、運行過慢或根本沒有啓動,約佔全部失敗的 75%。測試環境是 8 核 CPU、32GB 內存、無 GPU 的統一 Docker 容器,渲染本身就要佔用可觀時間。
這說明模型推理能力提升之後,還要落實到執行節奏上。一個模型把動畫寫得再精緻,如果在第 55 分鐘才啓動渲染,結果仍是零分。Astra 與 Opus 5.5 在質量上已經難分高下,下一代 GPT 拉開差距的空間主要在交付側。
4.2 下一代 GPT 在視頻工作流中的七個提升點
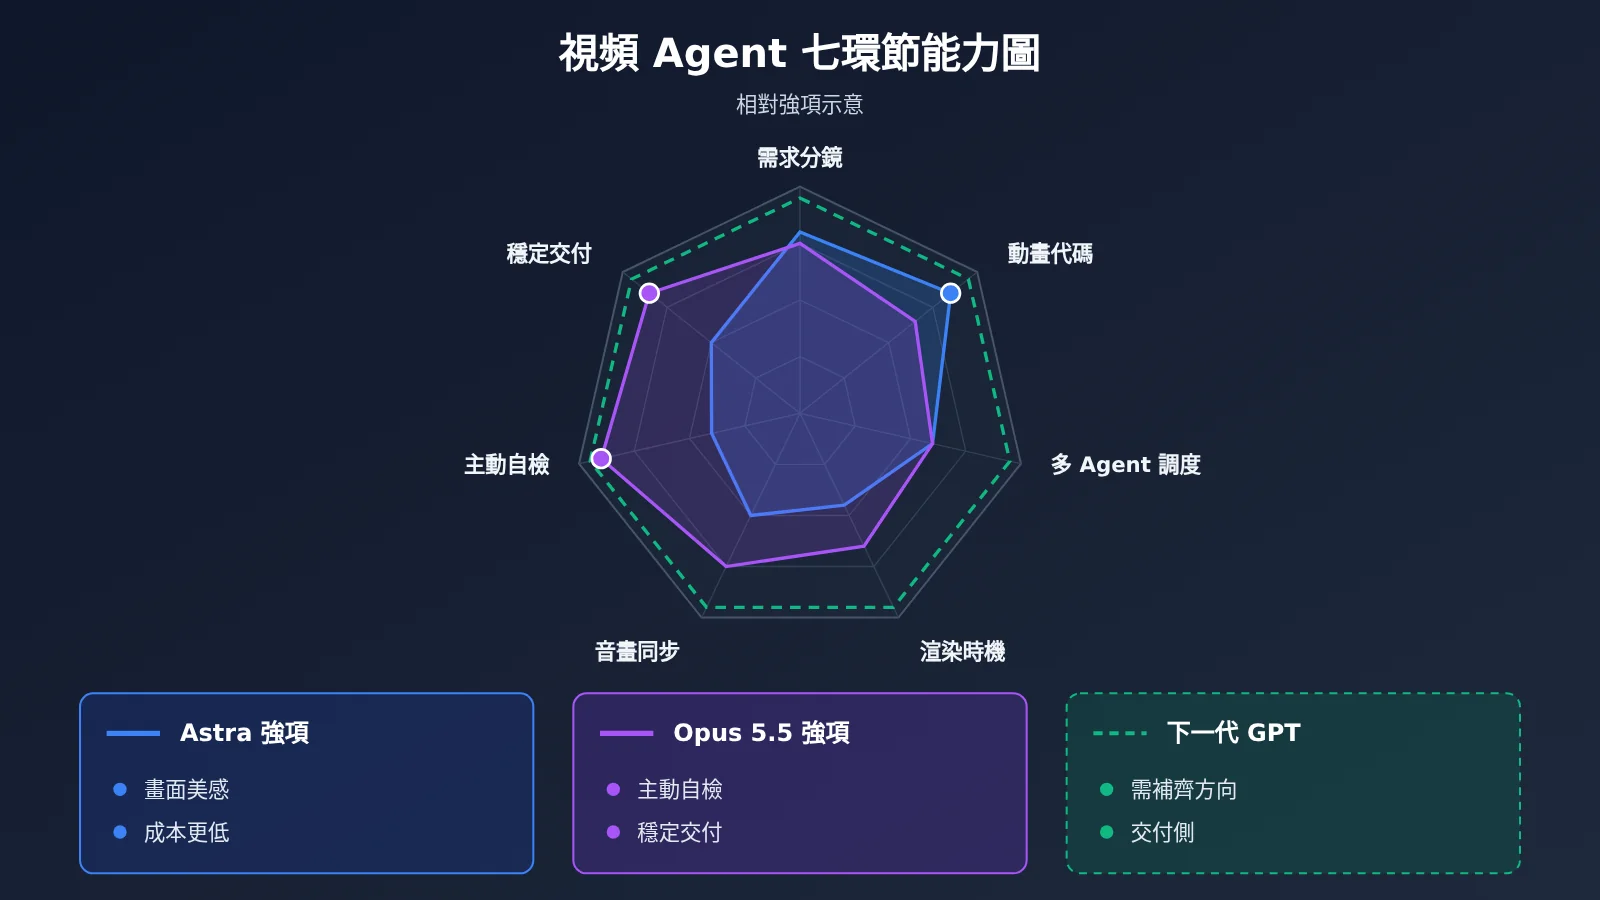
結合兩者當前的強弱項,下一代模型若要明顯超過 Opus 5.5,需要在以下環節同時進步:
- 需求與分鏡理解:準確把握主題、受衆、風格,把需求拆成鏡頭順序和時間軸。
- 複雜動畫代碼:Remotion、Three.js、Python 動畫一次寫對,減少返工渲染。
- 多 Agent 調度:把腳本、動畫、音頻並行化,內部模型在數學研究中展示的編排能力需要遷移到這類工程任務。
- 渲染時機:預留足夠渲染時間,避免佔失敗總數約四分之三的時間管理問題。
- 音畫同步:旁白、音效與畫面節奏對齊,這是 Opus 在音樂驅動類任務領先的方向。
- 主動自檢:Opus 平均看圖 7.9 次,Astra 爲 3.4 次,自檢頻率與規格符合率直接相關。
- 穩定交付:完整 MP4 加可編輯工程,規格一次達標。
5 下一代 GPT 發佈後,如何驗證它是否真的超過 Opus 5.5
5.1 七步對比測試方法
公開榜單隻運行一次、限時 60 分鐘、以英文任務爲主(239 項中 209 項爲英文),中文業務場景需要自己複測。以下方法可在新模型發佈當天直接複用:
| 步驟 | 做法 | 關注指標 |
|---|---|---|
| 1 固定任務集 | 選 10—20 條真實業務視頻需求,覆蓋腳本、動畫、數據可視化、產品展示 | 任務覆蓋度 |
| 2 固定環境 | 統一工具鏈(Remotion/FFmpeg 版本)、機器配置和時限;Harness 差異單獨記錄 | 可比性 |
| 3 分環節測試 | 先用 API 單測分鏡和動畫代碼,再在 Agent 環境跑全流程 | 環節得分 |
| 4 記錄消耗 | 每次運行的耗時、輸入輸出 Token、緩存命中 | 單位視頻成本 |
| 5 交付檢查 | 用 ffprobe 覈對分辨率、幀率、時長、音軌 | 交付率、規格符合率 |
| 6 盲測與重複 | 隱去模型名做兩兩比較,每任務至少跑 3 次 | 偏好勝率、方差 |
| 7 綜合打分 | 質量、成功率、修改成本、單位視頻成本加權 | 最終選型結論 |
第 3 步把“模型能力”和“Agent 環境能力”分開。VibeVideoBench 測的是完整 Agent 系統,Codex CLI 與 Claude Code 本身也有差異;用同一個 OpenAI 兼容接口直接調用兩家模型生成分鏡和動畫代碼,可以先剝離 Harness 的影響,看清模型本身的差距。
5.2 用統一接口做環節級對比的代碼示例
下面的極簡示例通過同一個 base_url 調用兩個模型,生成同一條視頻需求的分鏡腳本。模型名稱請以平臺模型列表爲準。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,一個 Key 調用 GPT 與 Claude
)

prompt = "爲一款記賬 App 設計 30 秒豎屏宣傳片:給出 6 個鏡頭的分鏡、旁白和每個鏡頭的時長。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
查看完整的多輪對比測試腳本(記錄耗時與 Token)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通過 API易 統一調用,便於切換和對比
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # 以平臺模型列表爲準;新模型發佈後直接追加
RUNS = 3  # 每個任務重複運行次數

TASKS = {
    "storyboard": "爲一款記賬 App 設計 30 秒豎屏宣傳片,輸出 6 個鏡頭的分鏡、旁白和時長(JSON)。",
    "remotion": "用 Remotion 寫一個 10 秒的柱狀圖增長動畫組件,數據爲 [12, 30, 45, 80],帶標題與數值標籤。",
    "data_story": "把“某城市 2020-2025 年新能源車滲透率從 5% 升至 48%”寫成 45 秒數據故事視頻的腳本和鏡頭說明。",
}

SYSTEM = "你是視頻導演兼前端動畫工程師,輸出可直接用於代碼驅動視頻製作的內容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# 保存結果,隱去模型名後交給評審做盲測
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 快速上手:環節級對比需要同時調用 GPT 與 Claude。通過 API易 apiyi.com 用一個 API Key、OpenAI 兼容接口即可切換兩家模型,新用戶有免費測試額度,下一代 GPT 上線後把模型名加進
MODELS列表就能復跑同一套任務。
5.3 全流程測試的注意事項
環節測試通過後,再在 Codex CLI 和 Claude Code 中跑完整視頻任務,記錄交付率和 ffprobe 檢查結果。人工盲測只評已交付視頻,交付率必須單獨統計,否則會重複 VibeVideoBench 人工測試的盲區。每個任務至少重複 3 次,取均值和方差,避免把單次運行的結果當成穩定性能。
6 決策建議:GPT 與 Opus 5.5 的視頻場景怎麼選
6.1 按場景選擇 GPT-6 Astra 或 Opus 5.5
依據 VibeVideoBench 的分類成績和交付數據,現階段可以這樣分配:
- 優先 GPT-6 Astra:數據與事實故事、概念與流程解釋、故事類和遊戲類視頻;批量生產、對單位成本敏感的場景,平均任務成本 8.19 美元,P90 成本也更可控。
- 優先 Claude Opus 5.5:產品與功能展示、音樂驅動視頻、論文解讀;對規格和交付有硬性要求的商業交付,如固定分辨率、時長、必須帶音軌的投放素材。
- 品牌營銷:兩者得分同爲 4.18,按成本和團隊已有工具鏈決定。
6.2 等待下一代 GPT 還是現在上線
現款兩個模型已經能穩定產出可用視頻,業務無需等待下一代模型。更實際的做法是用第 5 節的方法建立自己的任務集和基線成績,新模型發佈當天復跑,用數據決定是否切換。
💡 選擇建議:兩者差距集中在交付穩定性和成本結構上,最終選擇取決於你的視頻類型和交付要求。建議通過 API易 apiyi.com 用同一批真實任務分別測試,統一接口便於並排比較和後續切換到新模型。
7 最後結論:下一代 GPT 的競爭目標已經不只是追平 Opus 5.5
7.1 GPT 與 Opus 5.5 視頻能力核心要點
- 現狀:GPT-6 Astra 與 Claude Opus 5.5 在 VibeVideoBench 代碼驅動視頻任務中同處第一梯隊,綜合質量 4.109 對 4.074。
- Astra 的優勢:視覺美感、多數內容類別得分,以及約低 46.7% 的平均任務成本。
- Opus 5.5 的優勢:239/239 全部交付、99.6% 規格符合率、更頻繁的自檢。
- 人工偏好:1242 對 1203,置信區間重疊,統計上無法區分。
- 下一代信號:內部模型在 BenchCAD 2.0 達到 0.875(Astra 0.594),並展示了萬級 Agent 協作能力;名稱、發佈時間和視頻成績均未公佈。
- 真正瓶頸:約 75% 的交付失敗源於時間管理,競爭焦點正從生成質量轉向執行與交付。
- 驗證方式:固定任務、固定環境、多輪盲測、按單位視頻成本覈算,可在 API易 apiyi.com 上用統一接口完成環節級複測。
7.2 競爭終點是完整生產效率
回到標題:GPT 已經趕上 Opus 5.5,現款 Astra 在質量和成本上略佔優勢,Opus 5.5 在交付可靠性上保持領先。OpenAI 內部模型展示出更強的通用能力和多 Agent 執行潛力,下一代通用 GPT 有機會進一步提高視頻製作能力,具體幅度要等發佈後的獨立評測和你自己的業務測試來回答。
接下來的競爭會落在完整生產效率上:從理解創意到輸出一條可靠、精確、可修改的視頻,誰能以更低成本完成更多任務。建議現在就用 API易 apiyi.com 建好自己的視頻任務基線,新模型一上線即可直接對比。
參考資料
- VibeVideoBench 官方評測網站:視頻 Agent 排行榜與質量分數
- 鏈接:
vibevideobench.github.io -
說明: 總體榜單與評測設計概覽
-
VibeVideoBench 論文:方法論、分類成績、成本、人工偏好與失敗原因
- 鏈接:
arxiv.org/abs/2610.35864 -
說明: 本文表格數據的主要來源,分類成績見 Appendix E.4
-
Anthropic Claude Opus 5.5 發佈公告:模型定位與官方案例
- 鏈接:
anthropic.com/claude-opus-5-5 -
說明: Opus 5.5 能力與成本變化的官方描述
-
OpenAI:On the Navier–Stokes Millennium Prize Problem:內部模型與多 Agent 研究
- 鏈接:
openai.com/index/navier-stokes-solution -
說明: 10,000 併發 Agent、88 小時研究等數據
-
OpenAI:Accelerating engineering for the physical world:BenchCAD 2.0 內部模型成績
- 鏈接:
openai.com/index/accelerating-engineering-for-the-physical-world -
說明: 內部模型 0.875 與 GPT-6 Astra 0.594 的對比
-
OpenAI API Changelog 與模型目錄:發佈進展覈實
- 鏈接:
developers.openai.com/api/docs/changelog、developers.openai.com/api/docs/models -
說明: GPT-6 Cyber 發佈記錄與當前公開旗艦模型
-
OpenAI API Deprecations:Sora 2 與 Videos API 關停信息
- 鏈接:
developers.openai.com/api/docs/deprecations - 說明: 原生視頻生成路線的現狀
作者:API易 技術團隊
技術交流:歡迎在 API易 apiyi.com 首頁聯繫我們交流視頻 Agent 測試經驗,更多接入資料可訪問 docs.apiyi.com 文檔中心