
Примечание автора: разбираем опубликованные в рамках OpenAI Signals v3.0 данные об использовании ChatGPT по 165 категориям рабочих активностей, уточняем методологию подсчёта и оцениваем, чем это полезно разработчикам и компаниям, внедряющим ИИ.
26 октября 2026 года команда экономических исследований OpenAI выпустила отчёт «ChatGPT’s expanding world of work» (официальное китайское название — «ChatGPT 不断拓展的工作版图»), опубликовав данные об использовании ChatGPT, охватывающие почти 100 стран и регионов, 165 категорий рабочих активностей и 7 кварталов подряд. Эти данные относятся к программе OpenAI Signals v3.0 и распространяются бесплатно по лицензии CC BY 4.0 — исследователи могут взять CSV и сразу приступить к вторичному анализу.
Это не релиз новой модели и не анонс новой функции, а набор экономических данных об использовании продукта, ориентированный на исследователей. Официальный анонс, словарь данных и проверка исходных CSV независимыми медиа уже появились одновременно, так что цифры в разных источниках сходятся. В этой статье я явно разделяю выводы самой OpenAI и расчёты третьих сторон, чтобы «долю сообщений» не приняли за «замену профессий».
Главное: за несколько минут разберёмся, что именно измеряют данные OpenAI по 165 категориям рабочих активностей, какие выводы из них следуют и что это даёт разработчикам ИИ-приложений на практике.
Главное о данных OpenAI по 165 видам рабочих задач
Для начала — таблица с базовыми фактами о публикации данных по использованию ChatGPT:
| Параметр | Детали |
|---|---|
| Дата публикации | 26 октября 2026 года |
| Публикатор | Команда экономических исследований OpenAI (OpenAI Signals v3.0) |
| Система классификации | Промежуточные рабочие задачи (IWA) из американского O*NET |
| Охват | Около 100 стран и регионов, 165 видов рабочих задач |
| Период | С I квартала 2025 года по III квартал 2026 года, всего 7 кварталов |
| Источник выборки | Личные аккаунты Free, Go, Plus, Pro; заявленный возраст — от 18 лет |
| Что исключено | ChatGPT Enterprise, Codex, удалённые аккаунты, данные с запретом на использование для обучения |
| Лицензия на данные | CC BY 4.0 — бесплатный просмотр и скачивание CSV, требуется указание авторства |
165 видов рабочих задач — это не 165 профессий
Именно здесь чаще всего ошибаются при чтении этих данных. O*NET — официальная американская база данных о профессиях, которая разбивает «профессию» на несколько уровней «рабочих задач». Например, задача «редактировать письменные материалы» встречается и в работе редактора, и в повседневной работе учителя, юриста, инженера и финансиста.
Поэтому OpenAI считает, что люди делают с помощью ChatGPT, а не люди каких профессий используют ChatGPT. IWA (Intermediate Work Activities, промежуточные рабочие задачи) находятся между широкими видами деятельности и очень конкретными задачами; в справочной системе O*NET всего 332 записи IWA.
OpenAI отдельно отчиталась только по тем задачам, которые встречаются часто и проходят порог выборки, а редкие объединила. По проверке исходного CSV, которую провёл PPC Land, публичная таблица фактически содержит 164 именованные категории плюс одну объединённую категорию «Other IWA» — итого 165 классификационных результатов. Так что нельзя говорить, будто OpenAI полностью учла все 332 категории IWA.
Как собирались и классифицировались данные
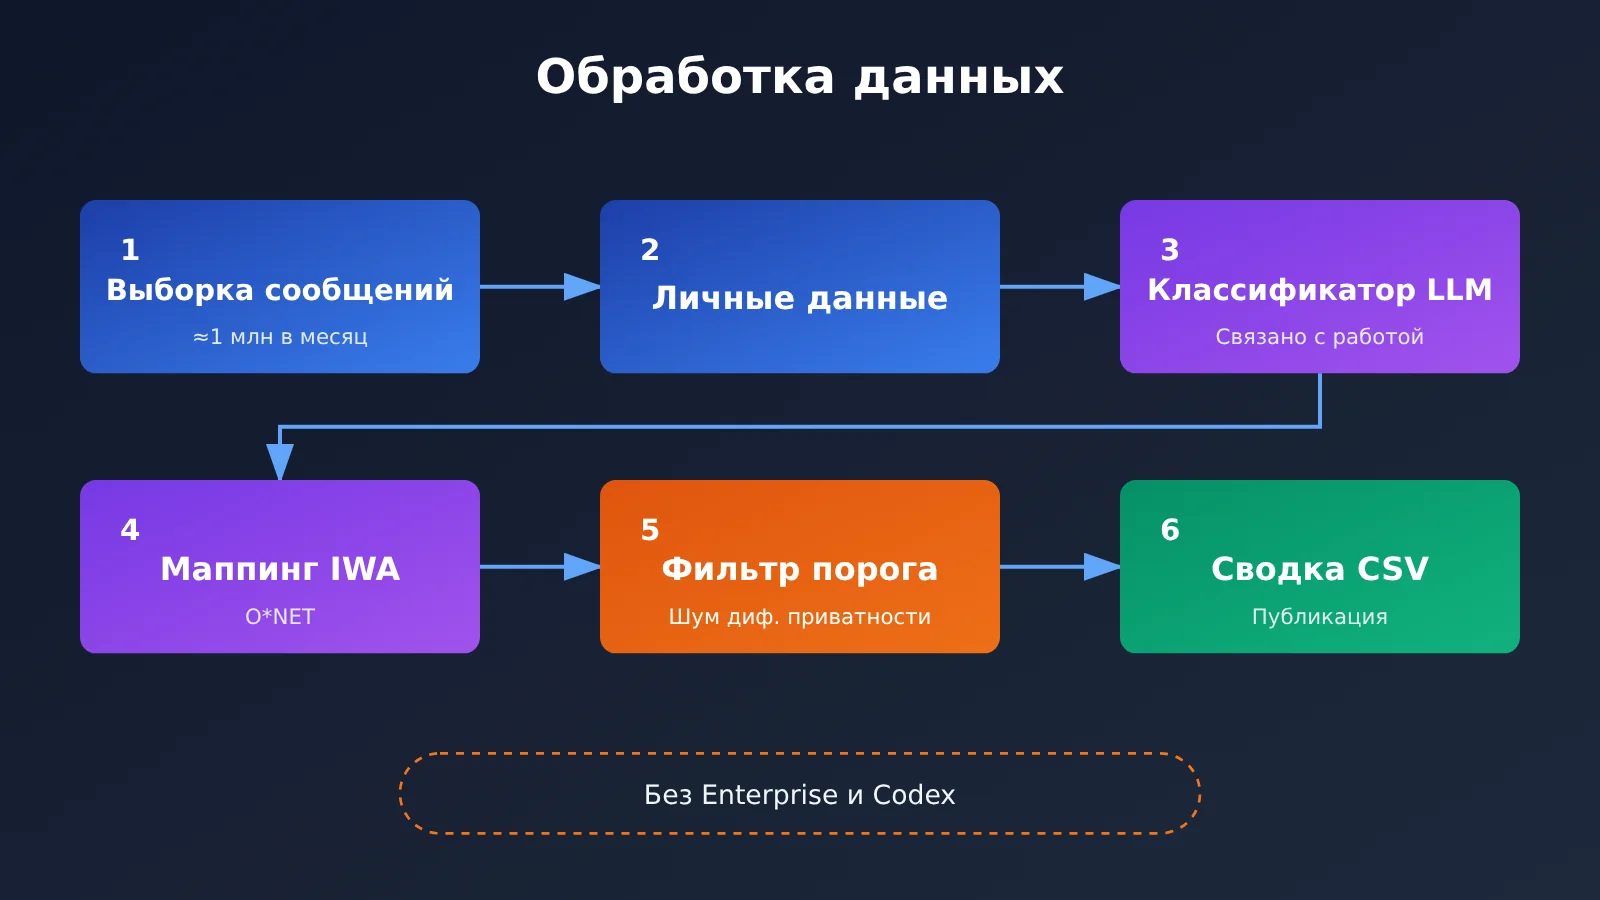
Signals v3.0 ежемесячно отбирает около 1 миллиона сообщений ChatGPT; в целом охвачен период с июля 2024 по сентябрь 2026 года — 27 месяцев, всего около 27 миллионов классифицированных样本ов. Важно понимать: 27 миллионов — это сумма выборок по месяцам, она не равна числу уникальных пользователей и не означает, что все сообщения были рабочими.
Классификацию выполняет автоматический классификатор на основе языковой модели: сначала он определяет, связано ли сообщение с работой, затем сопоставляет его с рабочей задачей из O*NET, попутно размечая тему, намерение, время и регион. Что касается приватности, OpenAI заявляет, что исследователи не читают исходные чаты напрямую, перед классификацией обрабатываются идентифицирующие данные, публикуются только агрегированные результаты, а для малых выборок применяется скрытие и добавление шума дифференциальной приватности. Распределение рабочих задач по странам и кварталам публикуется только при наличии не менее 1000 валидных сообщений.
Главный вывод из данных об использовании ChatGPT: рабочие сценарии становятся всё более разнообразными
Официальный топ-вывод OpenAI звучит так: типов рабочих задач, которые обычные пользователи решают с помощью ChatGPT, становится всё больше. В 74 странах и регионах, по которым есть полные данные за 7 кварталов, средняя доля десяти самых распространённых видов рабочих активностей в общем объёме классифицированных рабочих сообщений внутри страны заметно снизилась.
| Период | Средняя доля десяти самых популярных рабочих активностей по странам |
|---|---|
| I квартал 2025 года | 56,0% |
| III квартал 2026 года | 51,1% |
| Изменение | −4,9 п.п. |
Здесь важно сразу прояснить два методологических момента. Во-первых, 51,1% — это не доля какого-то единого глобального топ-10. Сначала считается собственный топ-10 для каждой страны, а затем эти значения усредняются по 74 странам, причём сами топ-10 в разных странах могут не совпадать. Во-вторых, снижение доли не означает снижения количества сообщений: если общий объём использования растёт, абсолютное число запросов по самым популярным активностям всё равно может увеличиваться.
Иными словами, более «длиннохвостые» рабочие активности получают всё большую долю. При этом 74 страны и почти 100 стран — это две разные выборки, и при цитировании их нельзя смешивать.
Какие конкретные рабочие задачи встречаются чаще всего
27 октября 2026 года PPC Land провёл независимый расчёт на основе всех публично доступных CSV-файлов: данные посчитали отдельно по каждой из 74 стран, а затем усреднили. Ниже — шесть самых частых именованных рабочих действий в третьем квартале 2026 года. Это сторонний расчёт, а не список, который OpenAI прямо приводит в своём объявлении.
| Место | Рабочее действие | Средняя доля сообщений по 74 странам |
|---|---|---|
| 1 | Редактирование письменных материалов или документов | 15,0% |
| 2 | Создание визуального дизайна или презентационного контента | 7,9% |
| 3 | Разработка маркетинговых или рекламных материалов | 5,1% |
| 4 | Объяснение языковой или культурной информации | 4,0% |
| 5 | Подготовка информационных или учебных материалов | 3,2% |
| 6 | Программирование компьютерных систем или производственного оборудования | 3,1% |
Редактирование документов по-прежнему остаётся самым распространённым рабочим сценарием, а визуальный дизайн поднялся на второе место. Маркетинговый контент, учебные материалы и межъязыковое понимание тоже явно востребованы. Программирование, конечно, важно, но в этой выборке личных аккаунтов оно не занимает самую большую долю.
Визуальный дизайн растёт, доля программирования падает
По расчётам PPC Land, средняя по 74 странам доля категории «создание визуального дизайна или презентационного контента» выросла с 3,1% в первом квартале 2025 года до 7,9% в третьем квартале 2026 года — плюс 4,8 процентного пункта. Это самый большой прирост среди 165 категорий. В США за тот же период показатель поднялся с 2,4% до 7,6%, а в третьем квартале 2026 года Бразилия достигла 11,2%, Индия — 8,7%.
Обратная картина с категорией «программирование компьютерных систем или производственного оборудования»: она упала с 7,8% до 3,1%, в США — с 6,7% до 2,4%, в Индии в третьем квартале 2026 года всё ещё держится на 5,8%. Синхронно просели и смежные виды деятельности — решение компьютерных проблем, исследование технического дизайна. Разумно предположить, что разработчики перешли на специализированные агенты для программирования вроде Codex, но сами данные эту миграцию не доказывают. Более осторожная формулировка: в этих данных, где исключены Codex и корпоративные аккаунты, доля рабочих сообщений, связанных с программированием, заметно снизилась.
Маркетинг — ещё один сигнал, на который стоит обратить внимание. Средняя доля категории «создание маркетинговых или рекламных материалов» изменилась с 5,2% до 5,1%, то есть практически не сдвинулась, а в Аргентине, Пакистане, Нигерии и ряде других стран в третьем квартале 2026 года она достигала около 9%. Получается, что доля универсального письма падает, а спрос именно на маркетинговый контент остаётся стабильным.
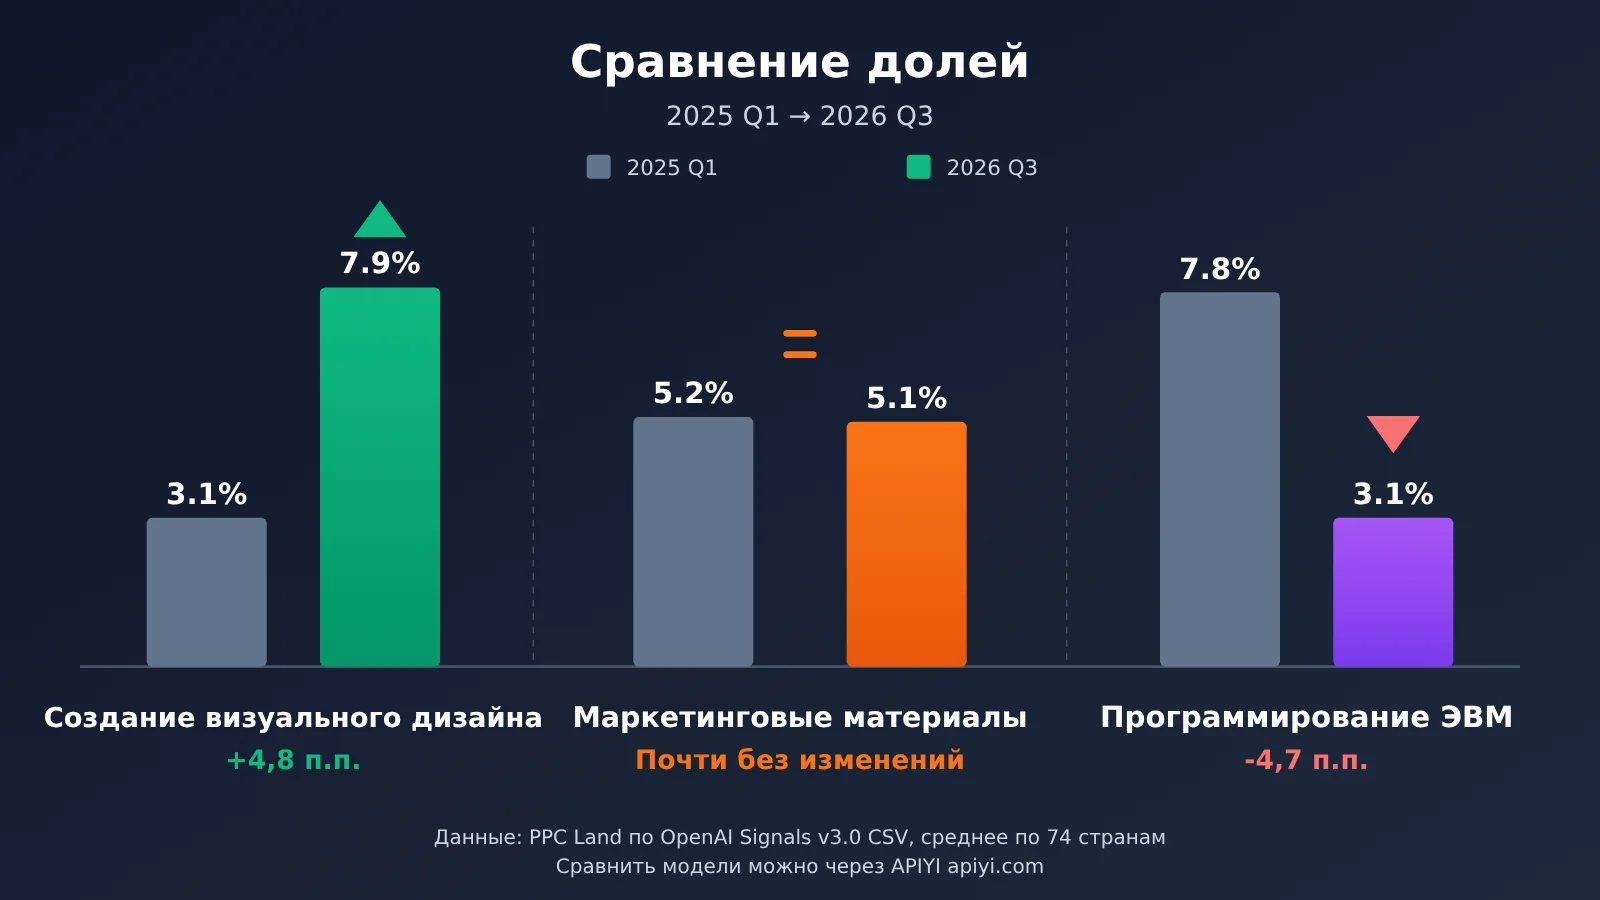
📊 Пояснение к графику: данные на схеме — результат повторного расчёта публичного CSV от OpenAI, выполненного PPC Land. Если вы хотите проверить на собственных задачах, какая модель лучше подходит для запросов «дизайн», «тексты» и «программирование», можно через APIYI apiyi.com с одним и тем же API-ключом переключаться между OpenAI, Claude, Gemini и другими моделями и устраивать небольшие сравнительные прогоны.
Сравнение структуры использования ChatGPT на работе в США и Германии
PPC Land также по пунктам разобрал более широкие категории Generalized Work Activities (обобщённые рабочие действия) из интерактивного графика OpenAI — обратите внимание, что это не тот же уровень, что IWA выше, и смешивать их нельзя. Доли рассчитаны от рабочих сообщений по каждой стране:
| Широкая рабочая деятельность | США, Q1 2025 | США, Q1 2026 | Германия, Q1 2025 | Германия, Q1 2026 |
|---|---|---|---|---|
| Принятие решений и решение проблем | 22,8% | 21,6% | 22,0% | 19,4% |
| Творческое мышление | 11,8% | 15,6% | 11,3% | 13,1% |
| Фиксация информации | 10,6% | 11,8% | 10,3% | 11,4% |
| Работа с компьютером | 11,7% | 6,7% | 12,7% | 8,4% |
| Консультирование и рекомендации | 5,5% | 9,0% | 7,1% | 11,7% |
| Объяснение информации другим | 5,1% | 4,0% | 9,5% | 8,6% |
В обеих странах «принятие решений и решение проблем» остаётся заметной сферой применения, а доля «творческого мышления» и «консультирования и рекомендаций» явно выросла. Речь идёт о типах пользовательских запросов — это не значит, что ChatGPT уже самостоятельно принимает бизнес-решения или даёт проверенные консультации уровня эксперта.
Что касается различий между странами, то показатель несходства распределений (общее вариационное расстояние), который считывал PPC Land, немного вырос — примерно с 22,2% до 23,0%. OpenAI также признаёт, что такая разница может объясняться структурой занятости, языком и культурой, доступностью инструментов и привычками использования; имеющихся данных недостаточно, чтобы доказать причинно-следственную связь.
Анализ влияния данных о 165 категориях рабочих активностей на разработчиков
Что это значит для разработчиков AI-приложений
- Запросы становятся шире: пользователи уже не ограничиваются правкой документов в ChatGPT — заметную долю занимают визуальный дизайн, маркетинг, учебные материалы и консультации. Инструментам с одной функцией стоит задуматься о сценариях с несколькими задачами.
- Мультимодальность важнее, чем раньше: визуальный дизайн — активность с самым большим приростом, а тема «мультимедиа» в личных сообщениях за тот же период выросла с 2,0% до 8,8% (расчёт PPC Land). Возможности работы с изображениями стоит закладывать в план продукта.
- Программирование уходит в специализированные инструменты: доля запросов про код в общем чате падает, и запросы на разработку, вероятно, всё чаще обрабатываются специализированными агентами или внутри корпоративных сред. Для этого лучше подходят отдельные кодовые модели и рабочие процессы.
- Метод классификации можно переиспользовать: OpenAI сопоставляет сообщения со стандартной системой задач с помощью LLM-классификатора. Тот же подход вполне применим и к анализу логов вашего собственного продукта.
Влияние на внедрение ИИ в компаниях
Данные личных аккаунтов не отражают корпоративное использование. Ещё один набор данных OpenAI — Enterprise Signals — показывает, что по состоянию на июнь 2026 года среди проанализированных корпоративных клиентов Codex отвечал за 64% суммарного объёма выходных токенов ChatGPT и Codex. Это говорит о том, что структура использования на стороне компаний может сильно отличаться от личных аккаунтов, и при оценке внутренних ИИ-решений стоит опираться на собственные логи задач, а не механически переносить персональные данные Signals.
🚀 Быстрый старт: Если хотите, как OpenAI, помечать собственные бизнес-запросы тегом «рабочая активность», рекомендуем быстро собрать прототип через APIYI apiyi.com. Платформа предоставляет OpenAI-совместимый интерфейс, у новых пользователей есть бесплатный тестовый лимит, и приведённый ниже пример можно запустить за несколько минут.
Воспроизводим идею «классификации рабочих активностей» через API
Ниже — максимально простой пример: с помощью большой языковой модели мы относим пользовательский запрос к небольшому набору меток рабочих активностей. Принцип тот же, что у классификатора OpenAI (метки упрощены для наглядности и не повторяют полную таксономию O*NET):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

labels = "编辑文档, 视觉设计, 营销推广, 语言解释, 教学材料, 编程, 决策分析, 其他"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"从[{labels}]中选一个标签描述这条工作请求,只输出标签:帮我写一份新品发布的公众号推文"}]
)
print(resp.choices[0].message.content)
Посмотреть полный код пакетной классификации и подсчёта долей
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Один ключ — переключение между несколькими моделями
)

LABELS = ["编辑文档", "视觉设计", "营销推广", "语言解释",
          "教学材料", "编程", "决策分析", "非工作", "其他"]

SYSTEM = (
    "你是工作活动分类器。先判断请求是否与工作相关,"
    f"再从以下标签中选择一个:{', '.join(LABELS)}。只输出标签本身。"
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "其他"
    except Exception as e:
        print(f"Error: {e}")
        return "其他"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "非工作"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "帮我润色这份季度汇报",
        "设计一组活动海报的构图建议",
        "这段 Python 为什么读不到数据",
        "周末去哪里露营比较好",
    ]
    print(activity_share(logs))
Как и в подходе OpenAI, такая автоматическая классификация иногда ошибается, а одна задача может распадаться на несколько сообщений. Поэтому подсчитанная «доля сообщений» не равна напрямую объёму работы или бизнес-ценности.
Справочник по выбору моделей для разных видов рабочих задач
Опираясь на виды деятельности, которые чаще всего встречаются в данных, можно сделать предварительный выбор модели под тип задачи. Конкретные результаты всё равно стоит проверять на собственных данных:
| Рабочая задача | Ключевая способность | Логика выбора | Доступные платформы |
|---|---|---|---|
| Редактирование письменных материалов | Понимание и переписывание текста | Универсальная диалоговая модель с хорошим соотношением цены и качества | APIYI apiyi.com, официальный API |
| Визуальный дизайн и презентации | Генерация и понимание изображений | Мультимодальная / графическая модель | APIYI apiyi.com, официальный API |
| Маркетинговые материалы | Креативность и контроль стиля | Флагманская модель со стабильным стилем письма | APIYI apiyi.com, официальный API |
| Программирование и отладка | Рассуждение по коду | Модель с сильными навыками кодинга или специализированный агент | APIYI apiyi.com, официальный API |
| Принятие решений и консультации | Рассуждение на длинном контексте | Рассуждающая модель в связке с проверкой человеком | APIYI apiyi.com, официальный API |
Ограничения данных OpenAI по 165 категориям рабочих задач
Эти данные очень ценны, но границы их применимости тоже чёткие. Вот на что стоит обратить внимание в первую очередь, когда на них ссылаешься:
- В выборке только личные аккаунты взрослых пользователей: Enterprise и Codex исключены, поэтому данные не отражают всё использование OpenAI в корпоративных продуктах.
- Классификация выполняется автоматически: LLM-классификатор может ошибочно понять намерение — например, «разработать план рекламной кампании» может быть реальной маркетинговой работой, а может и личным увлечением.
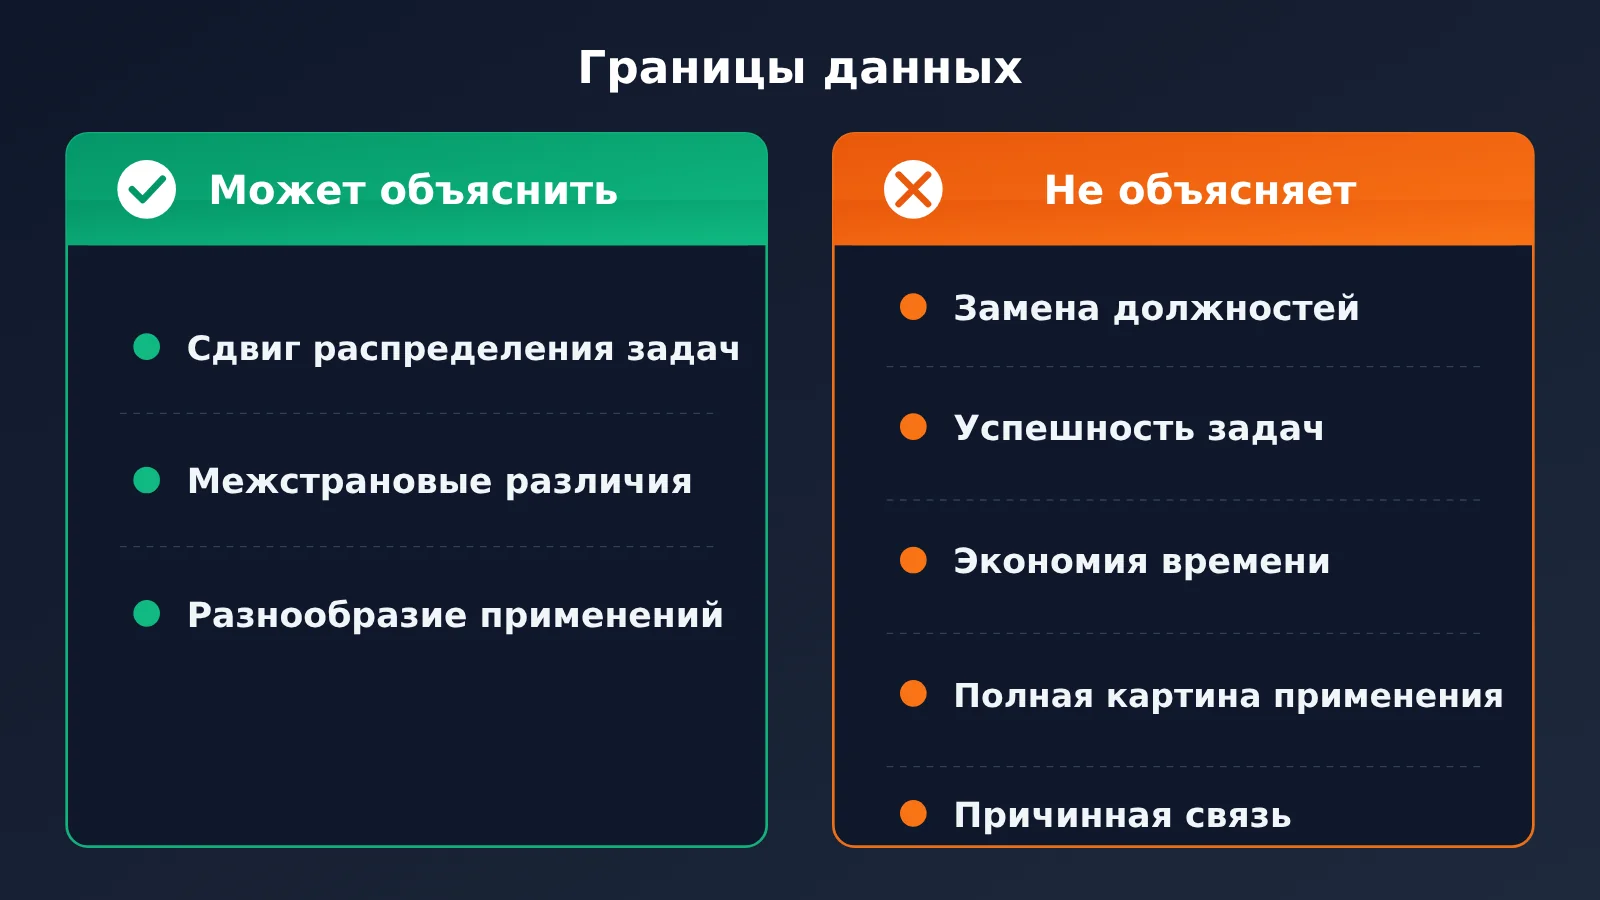
- Доля сообщений не равна объёму результата: она не говорит ни о количестве задач, ни о рабочих часах, ни о числе пользователей, ни о сэкономленном времени, ни об успешности.
- Есть шум приватности и порог по размеру выборки: результаты по малым выборкам скрыты, а в данные добавлен шум дифференциальной приватности.
- Прямого соответствия реальной экономике нет: при взвешивании по численности занятых около 43% реальных рабочих задач в США попадают в категорию «Other IWA». Это не значит, что 43% работы нельзя выполнить с помощью ИИ, и не значит, что остальные 57% уже покрыты ChatGPT.
Кроме того, по расчётам PPC Land, доля сообщений, помеченных как связанные с работой, среди всех личных сообщений снизилась примерно с 51,6% в июле 2024 года до примерно 32,2% в сентябре 2026 года. Скорее всего, это связано с массовым притоком нерабочих пользователей и с переходом части профессиональных задач на корпоративные аккаунты и специализированных агентов — делать из этого вывод, что ChatGPT стал менее важен для работы, нельзя.
Часто задаваемые вопросы (FAQ)
Вопрос 1: Что представляют собой опубликованные OpenAI данные о 165 видах рабочих активностей?
Это сводный набор данных, открытый в рамках инициативы OpenAI Signals v3.0. В нём рабочие сообщения индивидуальных пользователей ChatGPT сопоставлены со 165 промежуточными категориями рабочих активностей из классификации O*NET. Охват — около 100 стран и регионов, период — с I квартала 2025 по III квартал 2026 года, всего 7 кварталов. CSV можно скачать бесплатно.
Вопрос 2: Чем 165 видов рабочих активностей отличаются от 165 профессий?
Рабочая активность — это «что человек делает», профессия — это «какая у него должность». Одна и та же активность (например, редактирование документа) может встречаться в самых разных профессиях. Поэтому данные описывают, для каких типов работы используют ChatGPT, а не частоту использования по профессиям — и тем более не позволяют судить, какие профессии будут заменены.
Вопрос 3: Когда опубликованы данные и будут ли они обновляться?
OpenAI опубликовала их 26 октября 2026 года, данные актуальны по III квартал 2026 года. Официально изменения отслеживаются поквартально. Будут ли обновления продолжаться — смотрите анонсы на странице данных OpenAI Signals; здесь мы предположений не строим.
Вопрос 4: Доля сообщений по программированию падает — значит, спрос на AI-программирование сокращается?
Такой вывод делать нельзя. Данные исключают Codex и корпоративные аккаунты, а Enterprise Signals показывает высокую долю выходных токенов Codex на стороне бизнеса. Спрос на программирование мог перейти к специализированным агентам, а мог быть связан с изменением структуры пользователей — сами данные этого не различают.
Вопрос 5: Как воспроизвести похожий анализ классификации рабочих активностей через API?
Можно взять пример кода из этой статьи, разметить собственные пользовательские запросы с помощью большой языковой модели и посчитать доли:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ
2. Активируйте бесплатный тестовый лимит для новых пользователей
3. Укажите в коде `base_url` = `https://api.apiyi.com/v1` — и переключайте модели, чтобы сравнить качество классификации
Вопрос 6: Есть ли простой способ сравнить разные модели на задачах дизайна, копирайтинга и программирования?
Самый простой путь — вызывать модели разных провайдеров через единый интерфейс: прогнать один и тот же набор промптов и затем оценить результаты вручную. Через APIYI apiyi.com один ключ даёт доступ к OpenAI, Claude, Gemini и другим моделям с оплатой по факту использования — удобно для таких небольших сравнительных экспериментов.
Ключевые выводы из данных OpenAI о 165 типах рабочих активностей
- Считают активности, а не профессии: 165 категорий — это рабочие активности O*NET, включая 1 объединённую категорию «прочее».
- Назначения стали более разнообразными: средняя доля десяти самых популярных активностей в 74 странах снизилась с 56,0% до 51,1%.
- Наибольший рост — визуальный дизайн: по расчётам третьей стороны, с 3,1% до 7,9%.
- Доля программирования снизилась, но интерпретировать нужно осторожно: выборка не включает Codex и корпоративные аккаунты.
- Спрос на маркетинг стабилен: доля маркетинговых материалов держится около 5%.
- Доля сообщений не равна результату: из неё нельзя выводить замену должностей, экономию рабочего времени или успешность.
- Методику классификации можно переиспользовать: с помощью мультимодельного интерфейса APIYI apiyi.com можно быстро построить собственный анализ классификации задач.
Итог
Ключевая информация из данных об использовании ChatGPT по 165 типам рабочих активностей OpenAI:
- Характер данных: бесплатный открытый набор исследовательских данных с квартальным отслеживанием; он показывает, «какие рабочие активности выполняют с помощью ChatGPT» в личных аккаунтах.
- Основные находки: рабочие сценарии становятся более разнообразными; растут визуальный дизайн, консультирование и творческое мышление, а доля сообщений общего программирования снижается.
- Границы интерпретации: данные не включают корпоративные аккаунты и Codex; доля сообщений не равнозначна объёму работы, влиянию на должности или экономической ценности.
Эти данные на самом деле показывают не то, какие 165 профессий скоро исчезнут, а то, что AI всё более тонко и разнообразно встраивается в разные рабочие процессы — причём по-разному в зависимости от страны и типа задач. Разработчику стоит не спрашивать «кого заменит AI», а понять, какие активности пользователи реально выполняют с его помощью, и подобрать под эти активности правильную модель и рабочий процесс.
Рекомендуем быстро проверить, как разные модели справляются с вашими бизнес-сценариями, через APIYI apiyi.com — платформа предоставляет бесплатный тестовый лимит и единый интерфейс для нескольких моделей.
📚 Справочные материалы
- Официальный анонс OpenAI: ChatGPT’s expanding world of work — основной источник этого релиза
- Ссылка:
openai.com/index/chatgpt-expanding-world-of-work -
Пояснение: 165 категорий активности, почти 100 стран, официальные выводы о 56,0% → 51,1% и т. д.
-
Загрузка данных OpenAI Signals и описание методологии — доступ к исходным CSV и словарю данных
- Ссылка:
openai.com/signals/data-download -
Пояснение: объём выборки, обработка приватности и лицензия CC BY 4.0
-
PPC Land: Writing drops from 34% to 21% of ChatGPT requests since July 2024 — сторонний анализ CSV
- Ссылка:
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
Пояснение: рейтинг конкретных активностей, изменение долей визуального дизайна и программирования
-
PPC Land: Americans use ChatGPT at work most to make decisions — чтение интерактивных графиков США и Германии
- Ссылка:
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
Пояснение: данные сравнения стран по широким рабочим активностям
-
Официальный сайт O*NET — система классификации рабочих активностей и профессий
- Ссылка:
onetcenter.org -
Пояснение: понимание определений IWA и 332 справочных статей
-
OpenAI Enterprise Signals — данные использования корпоративных аккаунтов
- Ссылка:
openai.com/signals/enterprise-data - Пояснение: для разграничения данных частных и корпоративных пользователей
Автор: техническая команда APIYI
Обратная связь: пишите нам на главной странице сайта APIYI, больше материалов по интеграции — в центре документации docs.apiyi.com




