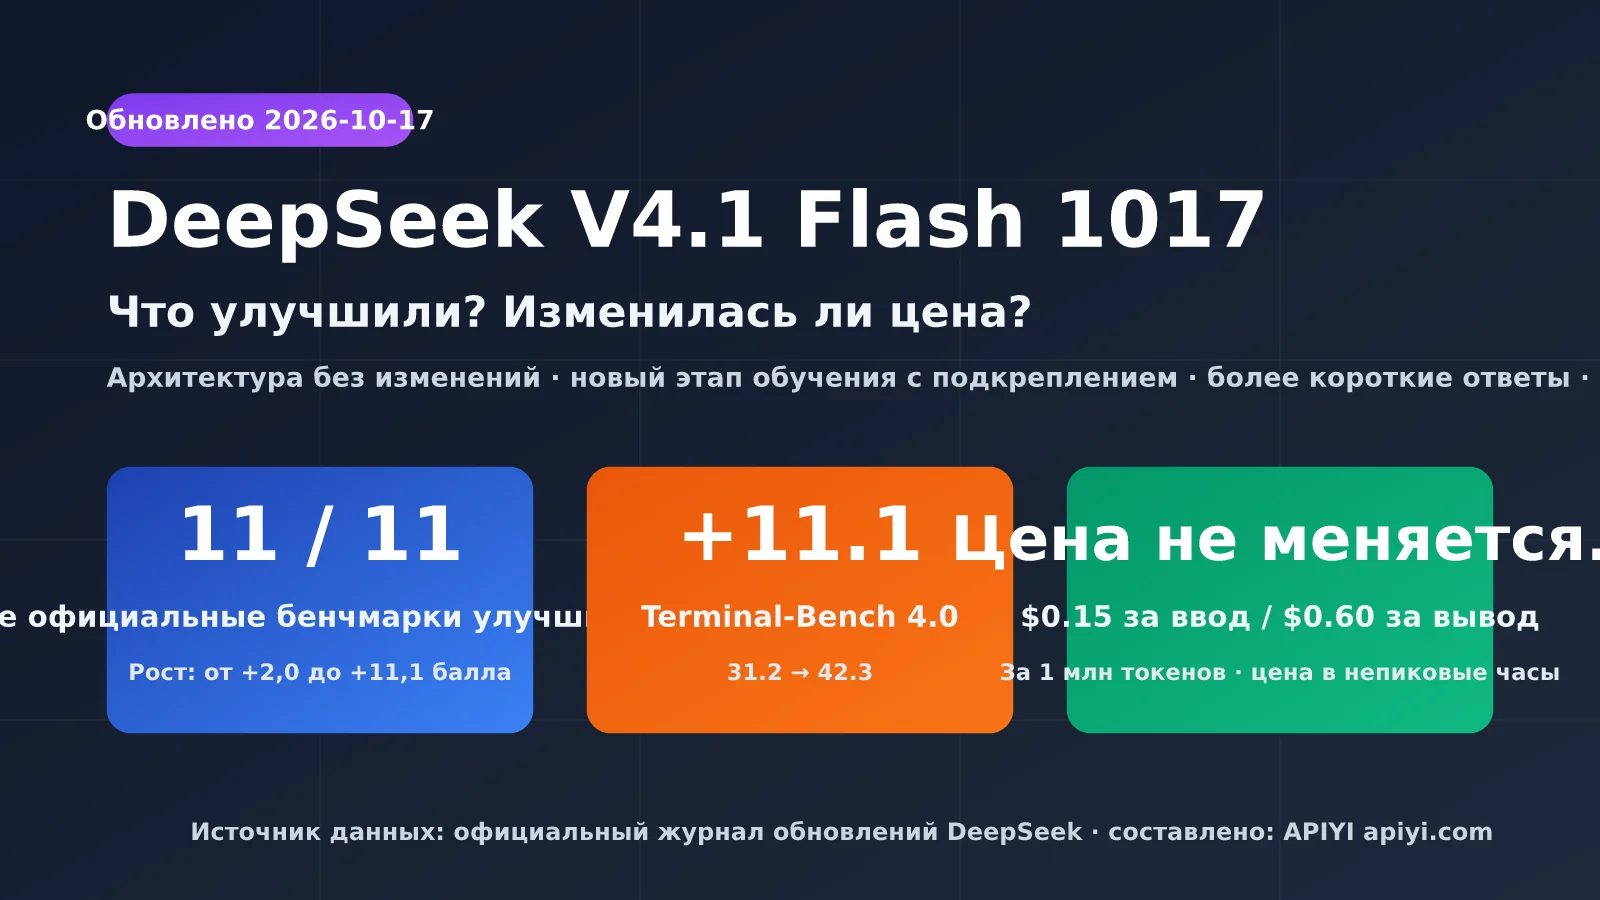
17 октября 2026 года DeepSeek незаметно обновила V4.1 Flash до DeepSeek-V4.1-Flash-1017. Официально это небольшое обновление, но опубликованные данные говорят об обратном: все 11 указанных компанией бенчмарков показали рост, а результат Terminal-Bench 4.0 вырос сразу на 11,1 балла. Это уже не просто косметические изменения.
Разработчиков больше всего интересуют два вопроса: что именно улучшили в DeepSeek V4.1 Flash 1017 и изменилась ли цена? В этой статье ответим на них, опираясь только на официальный журнал обновлений DeepSeek, страницу с ценами и данные из карточки модели на Hugging Face. Сведения от сторонних источников будут отмечены отдельно.
Главное: вы узнаете, насколько улучшилась версия 1017, почему неизменная цена на деле означает снижение стоимости и как сократить расходы на DeepSeek API ещё вдвое, используя часы с низкой нагрузкой.
Что такое DeepSeek V4.1 Flash 1017: небольшое обновление без смены архитектуры
DeepSeek V4.1 Flash — самая компактная модель в новом семействе архитектур, выпущенном 10 сентября 2026 года. Она изначально поддерживает понимание изображений. Версия 1017 вышла примерно через месяц после релиза и стала первым обновлением модели. В официальном журнале изменений всё описано кратко: модель обновлена до DeepSeek-V4.1-Flash-1017, веб-версия и приложение получили обновление одновременно, способ вызова API и цены не изменились.
Согласно технической информации на Hugging Face, в версии 1017 сохранена та же архитектура: 552 млрд параметров в основной модели, около 8 млрд активных параметров на токен на этапе префилла и около 16 млрд — на этапе декодирования. Кроме того, используется условная память Engram объёмом 196 млрд параметров. По мнению большинства участников англоязычного сообщества, изменения стали результатом нового этапа дообучения с подкреплением. Конфигурация, токенизатор и кодирование промптов не менялись, поэтому существующий код можно оставить без изменений.
| Параметр | DeepSeek V4.1 Flash 1017 | Примечание |
|---|---|---|
| Дата выпуска | 2026-10-17 | Первое обновление после релиза 10 сентября |
| Имя модели в API | deepseek-flash |
Псевдоним автоматически указывает на последнюю версию |
| Старые имена модели | deepseek-v4-flash и другие |
По-прежнему доступны, перенаправляются на 1017 и тарифицируются по цене Flash |
| Архитектура | MoE, 552 млрд параметров в основной модели, 8/16 млрд активных параметров | Без изменений по сравнению с первой версией |
| Контекст / максимальный вывод | 1M / 384K | Данные с официальной страницы с ценами |
| Режим рассуждений | С рассуждениями (по умолчанию) и без них | Доступны оба режима |
| Мультимодальность | Поддерживается ввод изображений | Версия Pro пока не поддерживает зрение |
| Лицензия с открытым исходным кодом | MIT | Веса опубликованы на Hugging Face и ModelScope |
| Лимит параллельных запросов | 2 500 | У версии Pro — 500 |
Стоит обратить внимание на отдельно отмеченную деталь: версию 1017 оптимизировали для DeepSeek Harness, Tencent CodeBuddy и WorkBuddy. Также рекомендуется использовать DeepSeek Harness версии 0.2.1-rc.1 или новее. Это показывает, что при обучении основное внимание уделили задачам агентного программирования. Если вы используете собственный цикл работы агента, реальный прирост может оказаться скромнее, чем показывают официальные цифры.
🎯 Технический совет: псевдоним модели автоматически указывает на новую версию, поэтому перед переключением рабочего трафика прогоните регрессионные тесты на собственных примерах. Через APIYI apiyi.com можно обращаться к DeepSeek и другим популярным моделям с одним и тем же API-ключом — так их удобно сравнивать в рамках одного набора тестов.
Что улучшилось в DeepSeek V4.1 Flash 1017: сравнение по 11 бенчмаркам
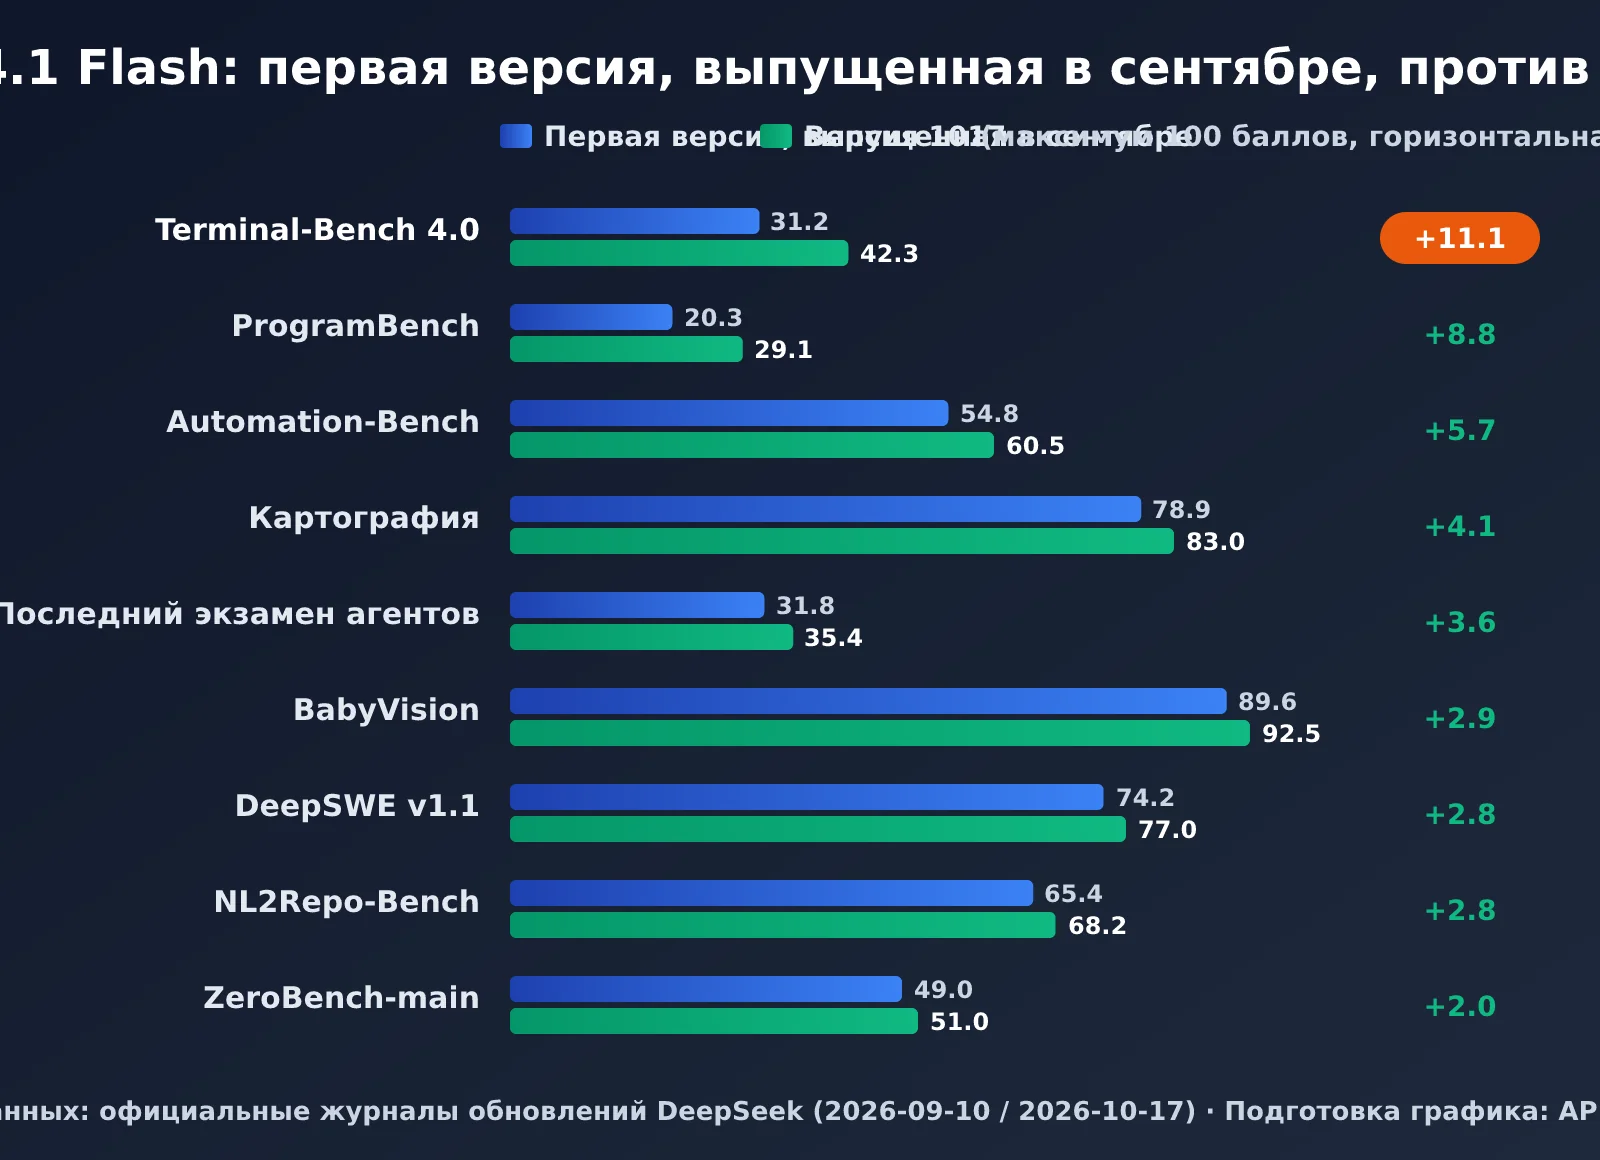
Проще всего ответить на вопрос «что улучшилось», если сравнить результаты официальной сентябрьской версии и версии 1017, вышедшей в октябре. Все данные в таблице взяты из официального журнала обновлений DeepSeek. Старый результат Apex Bench в журнале не указан — он взят из подборки англоязычного сообщества и приведён только для справки.
| Бенчмарк | Проверяемая способность | Сентябрьская версия | Версия 1017 | Прирост |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Задачи терминального агента | 31.2 | 42.3 | +11.1 |
| ProgramBench | Генерация программ | 20.3 | 29.1 | +8.8 |
| Apex Bench v1.1 | Комплексное рассуждение (старый результат — сторонние данные) | 64.6 | 72.1 | +7.5 |
| HLE (без инструментов) | Рассуждение на основе сложных знаний | 36.8 | 42.6 | +5.8 |
| Automation-Bench | Автоматизация рабочих процессов | 54.8 | 60.5 | +5.7 |
| Chartography (с инструментами) | Понимание диаграмм | 78.9 | 83.0 | +4.1 |
| Agents’ Last Exam | Универсальный агент | 31.8 | 35.4 | +3.6 |
| BabyVision (с инструментами) | Понимание изображений | 89.6 | 92.5 | +2.9 |
| DeepSWE v1.1 | Разработка ПО | 74.2 | 77.0 | +2.8 |
| NL2Repo-Bench | Создание репозитория по описанию на естественном языке | 65.4 | 68.2 | +2.8 |
| ZeroBench-main (с инструментами) | Визуальное рассуждение | 49.0 | 51.0 | +2.0 |
Из таблицы видны три тенденции. Во-первых, сильнее всего выросли результаты в задачах для агентов и программирования: относительный прирост на Terminal-Bench 4.0 и ProgramBench превышает 35%. Это согласуется с заявлением DeepSeek об оптимизации для Harness и CodeBuddy. Во-вторых, результаты на визуальных бенчмарках тоже стабильно выросли на 2–4 пункта — значит, постобучение не ухудшило мультимодальные способности. В-третьих, условия тестирования на некоторых бенчмарках могли различаться: например, для новой версии Automation-Bench указана версия v1.0.6, а для HLE в результатах первой версии не уточняется, использовались ли инструменты. Поэтому не стоит судить об изменениях только по отдельным цифрам.
Эффективность DeepSeek V4.1 Flash 1017: короче ответы и быстрее выполнение задач
Помимо результатов на бенчмарках, DeepSeek отмечает ещё одно важное изменение, которое легко упустить: версия 1017 выполняет задачи быстрее и выдаёт более короткие ответы. Для API с оплатой за токены это не менее важно, чем сами результаты: если для той же задачи требуется меньше токенов, счёт становится меньше.
Нужно учитывать, что DeepSeek не сообщил, на сколько процентов сократилось время или длина ответов. В англоязычном сообществе пока тоже нет надёжных сравнительных замеров. Оптимальный вариант — проверить собственные рабочие сценарии и сравнить изменения в usage.completion_tokens, чтобы оценить экономию по реальным данным.
В англоязычном сообществе этот подход к обучению назвали «программированием, управляемым целью» (Wish-Driven Programming): модель сначала самостоятельно выполняет проект от начала до конца, затем оценивает результат относительно цели и дорабатывает его. Среди показанных DeepSeek примеров — 3D-реконструкция Запретного города, гоночная игра для браузера и воссоздание Portal 2 на Godot. Такие масштабные задачи с длинной цепочкой действий как раз проверяют Terminal-Bench и ProgramBench — и объясняют, почему сильнее всего выросли результаты агентов.
Изменилась ли цена DeepSeek V4.1 Flash 1017: подробный разбор тарифов в часы пик и вне их
Короткий ответ: цена API DeepSeek V4.1 Flash 1017 не изменилась — она такая же, как у версии, выпущенной в сентябре. Но важно учитывать два обстоятельства: при сентябрьском запуске цена уже снижалась, а сейчас DeepSeek использует два тарифа — для часов пик и для остального времени. Фактическая стоимость за единицу в эти периоды различается вдвое.
| Статья расходов (за миллион токенов) | Flash, вне часов пик | Flash, часы пик | V4 Pro, вне часов пик | V4 Pro, часы пик |
|---|---|---|---|---|
| Ввод (попадание в кэш) | $0.003 | $0.006 | $0.022 | $0.044 |
| Ввод (промах кэша) | $0.15 | $0.30 | $0.66 | $1.32 |
| Вывод | $0.60 | $1.20 | $1.98 | $3.96 |
По определению DeepSeek, часы пик — с понедельника по пятницу, с 01:00 до 04:00 и с 06:00 до 10:00 UTC. По пекинскому времени это с 09:00 до 12:00 и с 14:00 до 18:00 в рабочие дни. На официальные праздники Китая часы пик не распространяются. Всё остальное время — включая ночь, обеденный перерыв, выходные и праздничные дни — тарифицируется по ставке вне часов пик, то есть вдвое дешевле.
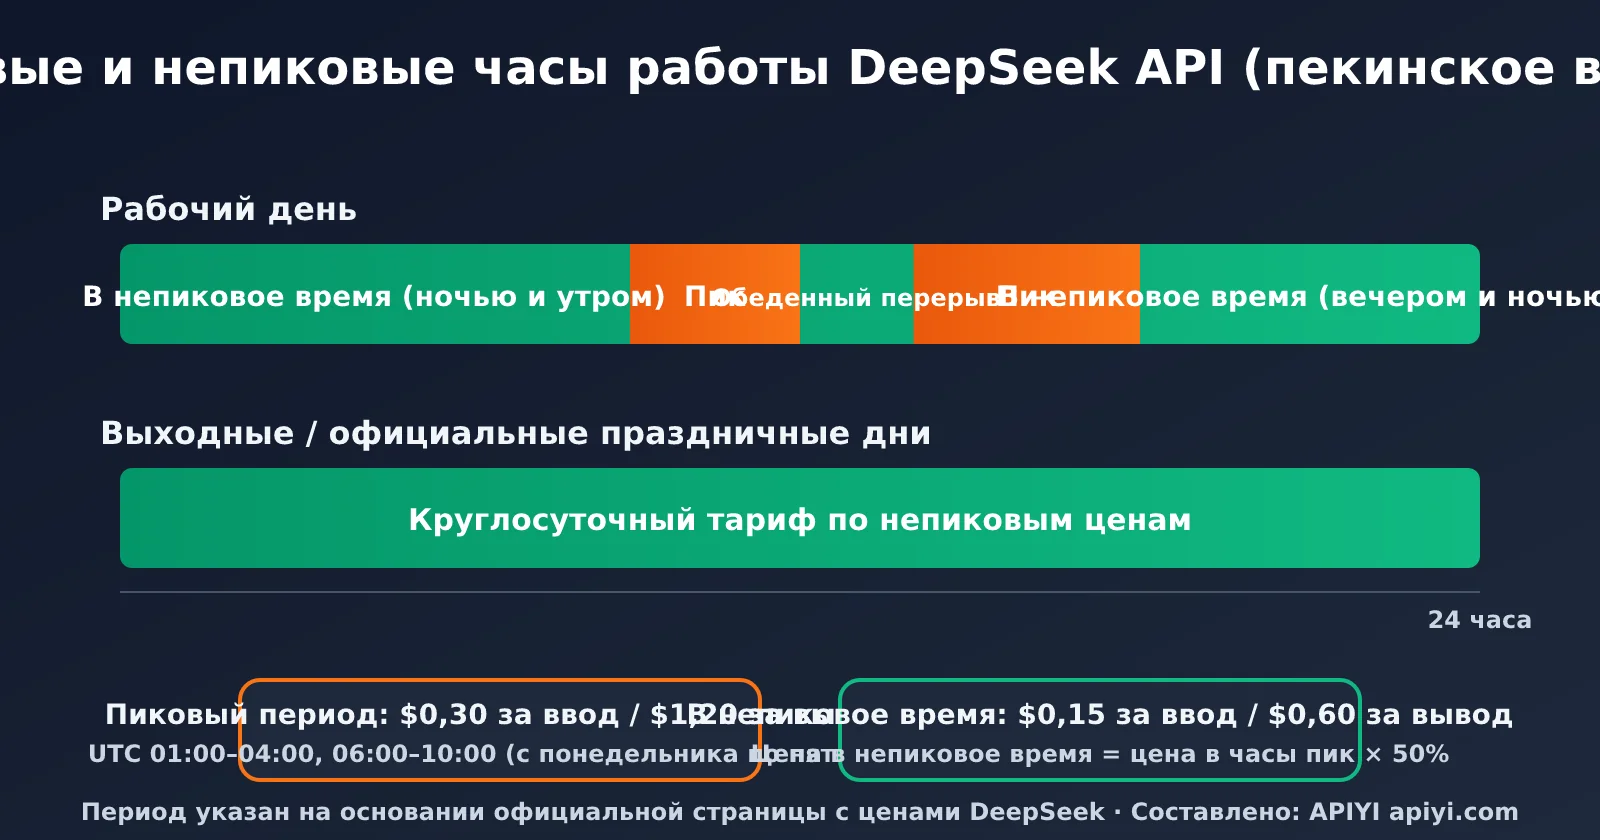
Для команд в Китае это расписание имеет прямое значение: часы пик почти полностью совпадают с рабочим временем. Если задача не требует мгновенного ответа — например, пакетный перевод, офлайн-разметка данных или сканирование репозитория с кодом, — запускайте её после 18:00 или в выходные. Цена сразу упадёт вдвое. Это даст больший эффект, чем любая оптимизация промпта.
Как менялась цена DeepSeek V4.1 Flash
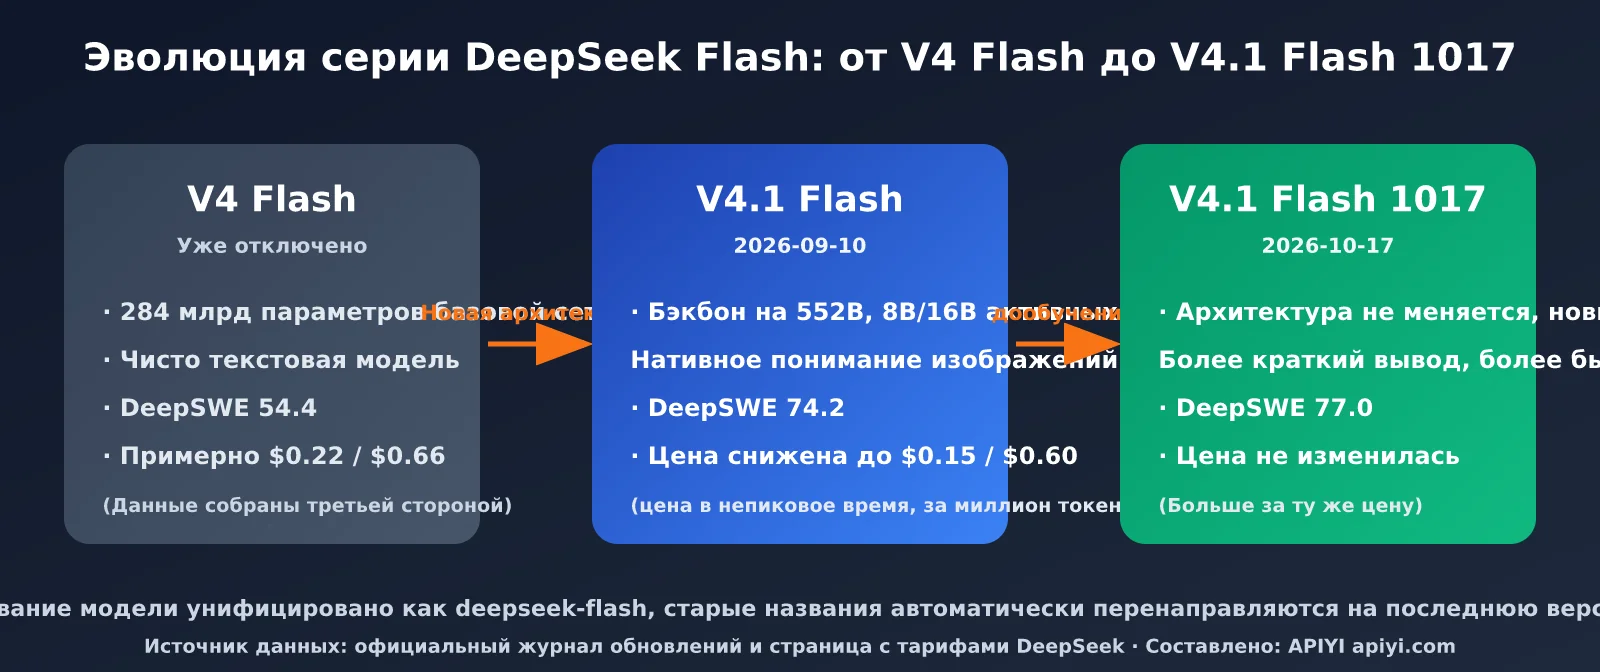
Если взглянуть на ситуацию шире, за два месяца серия Flash прошла путь от «снижения цены» до «больше возможностей за те же деньги». Цены на V4 Flash собраны англоязычным сообществом и приведены для справки; данные по сентябрьской и октябрьской версиям взяты из официальных источников.
| Версия | Дата выпуска | Ввод (промах кэша) | Ввод (попадание в кэш) | Вывод | Изменения |
|---|---|---|---|---|---|
| V4 Flash | До сентября 2026 года | Около $0.22 | Около $0.007 | Около $0.66 | Снята с поддержки |
| V4.1 Flash | 2026-09-10 | $0.15 | $0.003 | $0.60 | Официально объявлено снижение цены |
| V4.1 Flash 1017 | 2026-10-17 | $0.15 | $0.003 | $0.60 | Цена не изменилась, возможности улучшились |
Для серии V4.1 в таблице указаны цены вне часов пик. В часы пик они удваиваются.
Почему «цена не изменилась» на практике означает снижение стоимости
Цена за токен осталась прежней, но общие расходы на задачу зависят от произведения цены на количество токенов. Согласно официальной информации, в версии 1017 ответы стали короче, а значит, на одну и ту же задачу уходит меньше выходных токенов. При этом токены вывода стоят в четыре раза дороже входных, поэтому сокращение ответа экономит больше, чем сокращение входного текста.
Для примера: задача Agent в непиковое время использует 1 млн входных токенов без попадания в кэш и 200 тыс. выходных токенов. Стоимость составит примерно $0.15 + $0.12 = $0.27. Если объём вывода сократится на 20% (это лишь условный пример — фактические цифры зависят от ваших измерений), расходы на вывод уменьшатся с $0.12 примерно до $0.096. А повторное использование длинного контекста с тарифом $0.003 за попадание в кэш дополнительно снизит реальные затраты.
💰 Как сократить расходы: если у вас много пакетных вызовов или проект чувствителен к бюджету, перенесите задачи, не требующие ответа в реальном времени, на непиковые часы и по возможности используйте одни и те же системные промпты, чтобы повысить долю попаданий в кэш. При вызове моделей через платформу APIYI apiyi.com можно централизованно смотреть статистику использования и точнее рассчитывать стоимость каждого типа задач.
Search и Fetch API: новые платные функции, запущенные вместе с 1017
Одновременно с версией 1017 DeepSeek открыла для внешних разработчиков собственные функции Search (поиск в интернете) и Fetch (загрузка веб-страниц). За них взимается отдельная плата — $0.75 за тысячу успешных запросов. Она не входит в стоимость токенов модели.
На официальной странице с тарифами также указан переходный период: запросы через DeepSeek Harness, Claude Code или Codex пока бесплатны. С 00:00 1 ноября 2026 года по пекинскому времени они станут платными. Если в вашем сценарии Agent активно используется поиск в интернете, до ноября стоит подсчитать число вызовов и заранее оценить дополнительные расходы.
DeepSeek V4.1 Flash 1017: быстрый старт и примеры вызовов API
Поскольку версия 1017 использует то же имя модели — deepseek-flash, существующий код автоматически переключится на неё без изменений. Ниже — минимальный пример вызова через совместимый с OpenAI SDK:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

resp = client.chat.completions.create(
    model="deepseek-flash",  # 实际可用模型名以平台模型列表为准
    messages=[{"role": "user", "content": "用 Python 写一个读取 CSV 并按列求和的函数"}],
)
print(resp.choices[0].message.content)
print(resp.usage)  # 记录 Token 用量,便于对比新旧版本输出长度
Показать полный код: скрипт для сравнения длины ответов старой и новой версии
import time
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 调用多个模型
)

PROMPTS = [
    "解释 Python 中生成器和迭代器的区别,并给出示例",
    "写一个带重试和指数退避的 HTTP 请求函数",
    "把下面的 SQL 改写成 pandas 代码:SELECT city, AVG(price) FROM orders GROUP BY city",
]

def run(model: str, prompts: list[str]) -> dict:
    out_tokens, latency = [], []
    for p in prompts:
        start = time.time()
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": p}],
        )
        latency.append(time.time() - start)
        out_tokens.append(resp.usage.completion_tokens)
    return {
        "model": model,
        "avg_output_tokens": statistics.mean(out_tokens),
        "avg_latency_s": round(statistics.mean(latency), 2),
    }

if __name__ == "__main__":
    # 将历史记录中的 completion_tokens 与本次结果对比,即可估算 1017 的输出缩短幅度
    print(run("deepseek-flash", PROMPTS))
Несколько практических советов, которые помогут быстрее всё настроить:
- Режим рассуждений:
deepseek-flashпо умолчанию работает в режиме рассуждений. Для простых вопросов и преобразования форматов можно переключиться на режим без рассуждений — это поможет дополнительно сократить расход токенов на вывод. Точный формат параметров смотрите в официальной документации. - Параметры семплирования: в карточке модели на Hugging Face рекомендуются
temperature=1.0иtop_p=0.95. Если для предыдущей версии вы подбирали значение температуры, протестируйте его заново. - Старое имя модели:
deepseek-v4-flashпо-прежнему доступно, но теперь перенаправляет на версию 1017. Рекомендуем перейти наdeepseek-flash, чтобы избежать проблем, если старый псевдоним уберут. - Регрессионное тестирование: более короткий ответ может повлиять на нижестоящий парсинг, если он зависит от фиксированного формата или длины. Перед переключением проверьте работу на реальных примерах.
🚀 Быстрый старт: для быстрого создания прототипа рекомендуем платформу APIYI apiyi.com. Совместимый с OpenAI интерфейс работает сразу после подключения: за несколько минут вы интегрируете DeepSeek V4.1 Flash 1017 в существующий проект и сравните его с другими моделями в A/B-тесте.
Для каких задач подходит DeepSeek V4.1 Flash 1017: сравнение с V4 Pro
После обновления 1017 возникает практический вопрос: есть ли смысл переплачивать за V4 Pro? Судя по официальной странице с ценами, Flash выигрывает по стоимости, допустимому числу параллельных запросов и возможностям работы с изображениями. При этом Pro остаётся самой крупной моделью DeepSeek, доступной внешним пользователям.
| Критерий | deepseek-flash (V4.1 Flash 1017) | deepseek-v4-pro (V4 Pro 0813) | Рекомендация |
|---|---|---|---|
| Цена вывода (в непиковое время) | $0.60 / млн токенов | $1.98 / млн токенов | Flash стоит примерно 30% от цены Pro |
| Контекст / максимальный вывод | 1M / 384K | 1M / 384K | На одном уровне |
| Понимание изображений | Поддерживается | Не поддерживается | Для входных изображений выбирайте Flash |
| Лимит параллельных запросов | 2 500 | 500 | Для массовой обработки с высокой параллельностью выбирайте Flash |
| Оптимизация для программирующих агентов | Специальная оптимизация для Harness и CodeBuddy | Общего назначения | В первую очередь протестируйте Flash для программирующих агентов |
| Доступные платформы | Официальная платформа DeepSeek, APIYI apiyi.com и другие | Те же | Единый интерфейс упрощает переключение |
С учётом этих данных можно ориентироваться на следующие сценарии:
- Программирующие агенты и автоматизация в терминале: в первую очередь выбирайте Flash 1017. Именно в этих задачах обновление дало наиболее заметный прирост, а цена составляет примерно треть от стоимости Pro.
- Понимание графиков, скриншотов и документов: доступен только Flash — Pro пока не поддерживает входные изображения.
- Массовая пакетная обработка: лимит в 2 500 параллельных запросов у Flash и сниженная цена в непиковое время дают лучшее соотношение цены и производительности.
- Сложные рассуждения, где особенно важно качество каждого ответа: сравните Flash и Pro на одном и том же наборе примеров, прежде чем выбирать. Не ориентируйтесь только на результаты бенчмарков.
💡 Совет по выбору: подходящая модель зависит от типа задачи и требований к качеству. Рекомендуем протестировать Flash и Pro на одном наборе реальных примеров через платформу APIYI apiyi.com. Чтобы переключиться между моделями в едином интерфейсе, достаточно изменить имя модели — так вы быстрее сможете оценить результаты.
Часто задаваемые вопросы
Q1: Нужно ли менять код для DeepSeek V4.1 Flash 1017?
Нет. Официально подтверждено, что способ вызова API не изменился: deepseek-flash автоматически указывает на версию 1017, а старое имя deepseek-v4-flash также будет перенаправлять запросы на новую версию. Рекомендуется только провести регрессионное тестирование и убедиться, что более короткие ответы не нарушили работу последующего парсинга. На платформе APIYI apiyi.com можно получить тестовый лимит и быстро проверить новую версию в своих сценариях.
Q2: Изменилась ли цена DeepSeek V4.1 Flash 1017?
Стоимость за единицу не изменилась: в непиковые часы ввод без попадания в кэш стоит $0.15, ввод с попаданием в кэш — $0.003, вывод — $0.60 за миллион токенов. В часы пик цены удваиваются. Но поскольку версия 1017 генерирует более короткие ответы, общая стоимость той же задачи обычно снижается. Новые тарифы касаются только API Search и Fetch: по $0.75 за тысячу успешных запросов.
Q3: На какое время по Пекину приходятся часы пик?
В рабочие дни — с 09:00 до 12:00 и с 14:00 до 18:00 по пекинскому времени. Это соответствует интервалам 01:00–04:00 и 06:00–10:00 UTC. На официальные праздничные дни Китая пиковый тариф не распространяется. В остальное время действует непиковый тариф — вдвое ниже пикового.
Q4: Можно ли доверять улучшению результатов в тестах версии 1017?
Результаты опубликованы DeepSeek; независимая проверка третьими сторонами ещё продолжается. Некоторые бенчмарки зависят от конкретного фреймворка: например, Terminal-Bench 4.0 использует фреймворк Claude Code, а DeepSWE — Mini-SWE-V2. При использовании собственного цикла Agent результаты могут отличаться. Надёжнее всего проверить модель на своих данных и в своём фреймворке, а уже потом решать, переходить ли на новую версию.
Q5: Можно ли развернуть DeepSeek V4.1 Flash 1017 локально?
Да. Веса опубликованы на Hugging Face и ModelScope под лицензией MIT. Модель поддерживает фреймворки для инференса vLLM, SGLang, Transformers и другие. Однако основная модель с 552B параметров требует большого объёма видеопамяти, поэтому небольшим и средним командам обычно выгоднее напрямую вызывать API.
Главное
- Что улучшилось: архитектура не изменилась, но модель прошла новый этап обучения с подкреплением. По данным DeepSeek, результаты улучшились во всех 11 бенчмарках; показатель Terminal-Bench 4.0 вырос с 31.2 до 42.3.
- Что изменилось в эффективности: задачи выполняются быстрее, а ответы стали короче. При оплате за токены это напрямую снижает стоимость одной задачи.
- Изменилась ли цена: цена за единицу осталась прежней — $0.15 за ввод и $0.60 за вывод в непиковые часы. В часы пик тариф удваивается. Пиковые часы — с 9:00 до 12:00 и с 14:00 до 18:00 по пекинскому времени в рабочие дни.
- Новые платные функции: Search и Fetch стоят по $0.75 за тысячу запросов. С 1 ноября вводится плата за вызовы через Harness, Claude Code и Codex.
- Как подключиться: продолжайте использовать
deepseek-flash— менять код не нужно. Перед переходом достаточно провести регрессионное тестирование.
Итоги
Вернёмся к двум вопросам из заголовка. Короткий ответ — в трёх пунктах:
- Что улучшилось: DeepSeek V4.1 Flash 1017 — это повторное обучение модели на той же архитектуре. Заметнее всего выросли способности к программированию с помощью Agent, а понимание изображений стало немного стабильнее. Кроме того, ответы стали короче, а скорость — выше.
- Изменилась ли цена: нет, она осталась на уровне после сентябрьского снижения. Благодаря более коротким ответам фактические расходы стали ниже, а в часы низкой нагрузки цена уменьшается ещё вдвое.
- Что делать: менять код не нужно, но стоит провести регрессионное тестирование и оценить, как с ноября на рабочие процессы Agent повлияет тарификация Search/Fetch за каждый запрос.
Для команд, которые уже используют или планируют использовать DeepSeek для программирования с помощью Agent, пакетной обработки и анализа графиков, версия 1017 — обновление «больше возможностей за те же деньги». Стоит поскорее перейти на неё и проверить результаты. Быстро оценить модель можно через APIYI apiyi.com: сравните DeepSeek V4.1 Flash 1017 с другими популярными моделями на одном и том же наборе примеров через единый интерфейс, а затем решите, какую долю производственного трафика направлять на каждую модель.
Дополнительные материалы Related Articles
Если вас интересуют модели серии DeepSeek, рекомендуем прочитать:
- 📘 Первый обзор DeepSeek V4.1 Flash: новая архитектура и нативная мультимодальность — узнайте, что изменилось в версии, представленной в сентябре.
- 📊 Как сократить расходы на DeepSeek API: попадания в кэш и планирование нагрузки на непиковые часы — изучите практические способы снизить затраты на токены.
- 🚀 Как выбрать модель для программирования с помощью Agent: сравнение Flash, Pro и ведущих закрытых моделей — узнайте, какие сочетания лучше подходят для разных задач.
Справочные материалы
- Журнал обновлений DeepSeek API: официальные примечания к выпуску и результаты тестов для V4.1 Flash и версии 1017
- Ссылка:
api-docs.deepseek.com/updates -
Примечание: основной источник данных о результатах тестов и версиях, приведённых в статье
-
Модели и цены DeepSeek: официальные цены, правила тарификации в часы пик, а также для Search/Fetch
- Ссылка:
api-docs.deepseek.com/quick_start/pricing -
Примечание: актуальные цены смотрите на официальной странице
-
Карточка модели на Hugging Face: архитектура, параметры и рекомендуемые настройки семплирования для DeepSeek-V4.1-Flash
- Ссылка:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash -
Примечание: справочная информация для локального развёртывания и настройки параметров
-
Сравнительная статья Regolo: сравнение цен и результатов тестов V4 Flash и V4.1 Flash
- Ссылка:
regolo.ai - Примечание: прежняя цена V4 Flash, указанная в статье, взята из этой подборки стороннего ресурса
Автор: техническая команда APIYI
Техническое обсуждение: присоединяйтесь к обсуждению в комментариях. Больше материалов — в центре документации APIYI: docs.apiyi.com