У Gemini 4 Argon появились новости: после официального анонса 30 сентября и первоначального доступа для участников программы Fairwind, занимающихся киберзащитой, модель Gemini 4 Argon теперь доступна в Vertex AI — Google Cloud официально начал расширять доступ. Для большинства разработчиков главный практический вопрос теперь такой: сколько стоит Gemini 4 Argon и во сколько обойдётся его использование каждый месяц?
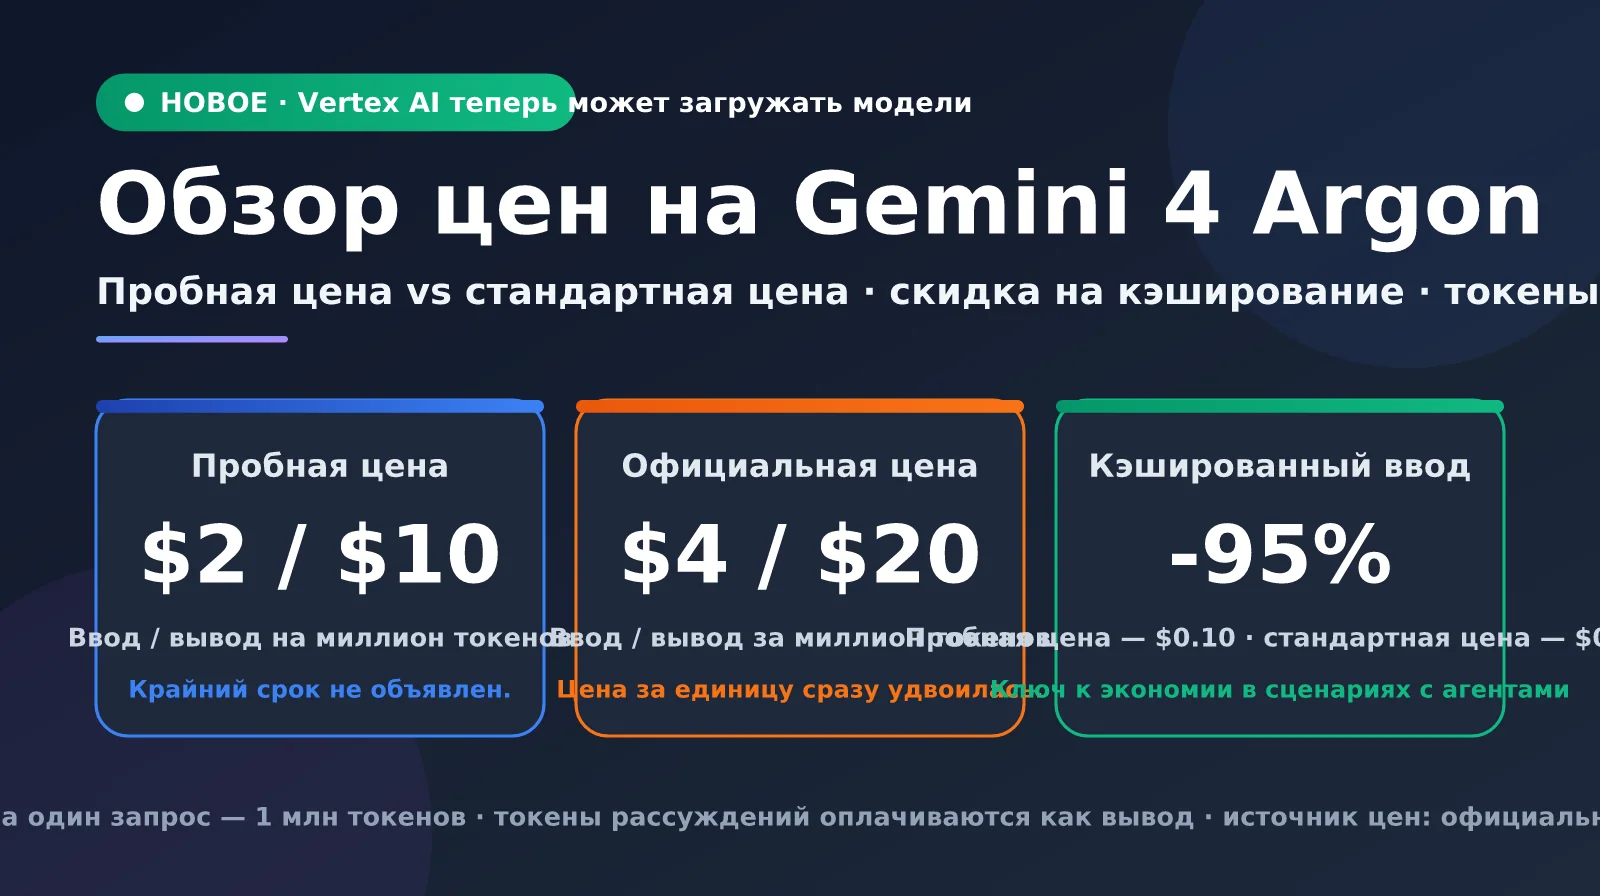
На первый взгляд, тарифы Argon устроены просто: на этапе раннего доступа входные токены стоят $2, а выходные — $10 за миллион токенов; после запуска по стандартным тарифам цены удваиваются — до $4/$20. На кэшированные входные токены действует скидка 95%. Но за этой таблицей тарифов скрывается несколько нюансов: как тарифицируются токены рассуждений, не приведёт ли лимит в 1 млн выходных токенов к чрезмерным расходам на один запрос и насколько расход токенов у Argon выше, чем у конкурентов. В этой статье мы разберём цены Gemini 4 Argon по пунктам, опираясь на официальную публикацию Google, материалы англоязычных СМИ и открытые данные независимых оценок. Также рассчитаем затраты для пяти типичных сценариев.
Главное: прочитав статью, вы сможете рассчитать реальную стоимость одной задачи на Gemini 4 Argon для своего бизнеса, понять, как изменится счёт после завершения периода раннего доступа, и сократить расходы с помощью кэширования и ограничения длины ответа.
Обзор цен на Gemini 4 Argon
Для начала сведём официальные цены Google в одну таблицу. Важно: Google опубликовала только два тарифа — для периода раннего доступа и стандартный. Сколько продлится ранний доступ, не уточняется. Также пока нет данных о скидках для пакетной обработки (Batch), тарифе Flex, ценах для длинного контекста и стоимости хранения кэша.
| Позиция | Ранний доступ (за 1 млн токенов) | Стандартный тариф (за 1 млн токенов) | Примечание |
|---|---|---|---|
| Входные токены | $2.00 | $4.00 | Продолжительность раннего доступа не объявлена |
| Выходные токены | $10.00 | $20.00 | Google отдельно не объяснила, как тарифицируются токены рассуждений |
| Кэшированные входные токены | $0.10 | $0.20 | Скидка 95% от цены входных токенов; для стандартного тарифа применена та же скидка |
| Максимальная длина ответа за один запрос | 1 млн токенов | 1 млн токенов | У предыдущих моделей Gemini лимит составлял 64 тыс. токенов |
| Batch / Flex | Не объявлено | Не объявлено | Для других моделей Gemini обычно предусмотрены скидки на пакетную обработку |
| Тарифы для длинного контекста | Не объявлено | Не объявлено | Официальный размер контекстного окна для входных данных также не указан |
Три важных нюанса в ценах на Gemini 4 Argon
Первый — токены рассуждений. Google не объяснила отдельно, как тарифицируются токены, которые Argon использует для размышлений. Однако в текущей линейке Gemini токены рассуждений обычно оплачиваются по тарифу на выходные токены. Для бюджета безопаснее всего исходить из того, что Argon будет работать по тому же правилу: все токены рассуждений войдут в счёт по цене $10 за миллион токенов в период раннего доступа или $20 — по стандартному тарифу.
Второй — скидка на кэширование. Скидка 95% означает, что в период раннего доступа кэшированные входные токены стоят всего $0.10 за миллион. В сценариях с агентами в каждом ходе диалога приходится повторно отправлять системный промпт, описания инструментов и контекст кодовой базы. При этом доля попаданий в кэш нередко превышает 70%, поэтому такая скидка может сильнее повлиять на общий счёт, чем исходная цена в $2.
Третий — неопределённость со сроками раннего доступа. После его окончания все цены сразу удвоятся, а Google пока не назвала дату. Поэтому, если вы оцениваете окупаемость по тарифам раннего доступа, стоит подготовить и расчёт по стандартным ценам — это поможет избежать неожиданного удвоения счёта.
🎯 Совет по бюджету: у Gemini 4 Argon немало переменных, влияющих на стоимость. Для начала протестируйте модель на небольшом трафике и оцените реальное распределение расхода токенов — и только потом решайте, стоит ли переводить на неё большую часть задач. Через платформу APIYI apiyi.com можно вызывать модели Gemini, GPT, Claude и других семейств через единый интерфейс и сравнивать их реальные затраты на одном и том же наборе задач.
Последние новости о запуске Gemini 4 Argon в Vertex AI
Сроки открытия доступа к Argon — один из главных вопросов для разработчиков. Согласно плану из блога Google, сначала Argon станет доступен участникам программы Fairwind — доверенным специалистам по киберзащите, — а также сотрудникам Google. Затем доступ получат клиенты платного API и подписчики Google AI Ultra. И только после этого модель станет доступна более широкому кругу разработчиков, компаний и пользователей. В таблице ниже собрана хронология: от официального анонса до появления модели в Vertex AI.
| Дата | Событие | Источник |
|---|---|---|
| 3 сентября | Запуск программы Fairwind. Первая модель — Gemini 3.8 Flash Cyber | Официальный блог Google |
| 30 сентября | Анонс Gemini 4 Argon, доступ для участников Fairwind | Официальный блог Google |
| 30 сентября | Проверка DataCamp: модели ещё нет в Vertex AI, Gemini CLI и других сервисах | DataCamp |
| 7–8 октября | Участники сообщества обнаружили в Vertex AI запись gemini-4-argon-cyber-permissive |
Сообщество и технологические СМИ |
| Середина октября | Модель Gemini 4 Argon уже можно запускать в Vertex AI | Последние новости |
Обнаруженный сообществом идентификатор gemini-4-argon-cyber-permissive заслуживает внимания. Название «cyber-permissive» намекает, что это версия для специалистов по киберзащите с ослабленными ограничениями в области кибербезопасности. Это совпадает с описанием из блога Google: для доверенных специалистов по защите сетей ограничения в этой области не применяются. Вероятно, у версии для обычных платных клиентов будет другой идентификатор, а все механизмы безопасности сохранятся. Поэтому при подключении ориентируйтесь на ID модели, который отображается в Model Garden вашей консоли Google Cloud, и не копируйте без проверки названия из интернета.
Цены на Gemini 4 Argon в Vertex AI и изменения платформы
По сообщениям сообщества, в Vertex AI для Argon указана глобальная цена: $4 за миллион входных токенов и $20 за миллион выходных — то есть официальный тариф из блога Google. Это важно учитывать: если при подключении через Vertex AI компания будет платить по официальному тарифу, все расчёты, сделанные по промоцене $2/$10, нужно удвоить. Google пока не уточнил, в каких каналах действует промоценa. Перед подключением проверьте фактические расценки на странице с тарифами в консоли.
Есть и ещё одно изменение, которое легко упустить: сама платформа. На конференции Cloud Next в апреле 2026 года Google объединила сервисы Vertex AI в Gemini Enterprise Agent Platform, а в документации старой версии Vertex AI появилась пометка, что она больше не обновляется. Существующие конечные точки продолжат работать, но документация и новые функции для таких моделей, как Argon, в первую очередь будут появляться на стороне Agent Platform. Кроме того, Gemini 2.5 Pro, 2.5 Flash и 2.5 Flash-Lite будут выведены из эксплуатации 16 октября. Команды, которые ещё используют эти модели, могут воспользоваться случаем и перейти на новые решения заодно.
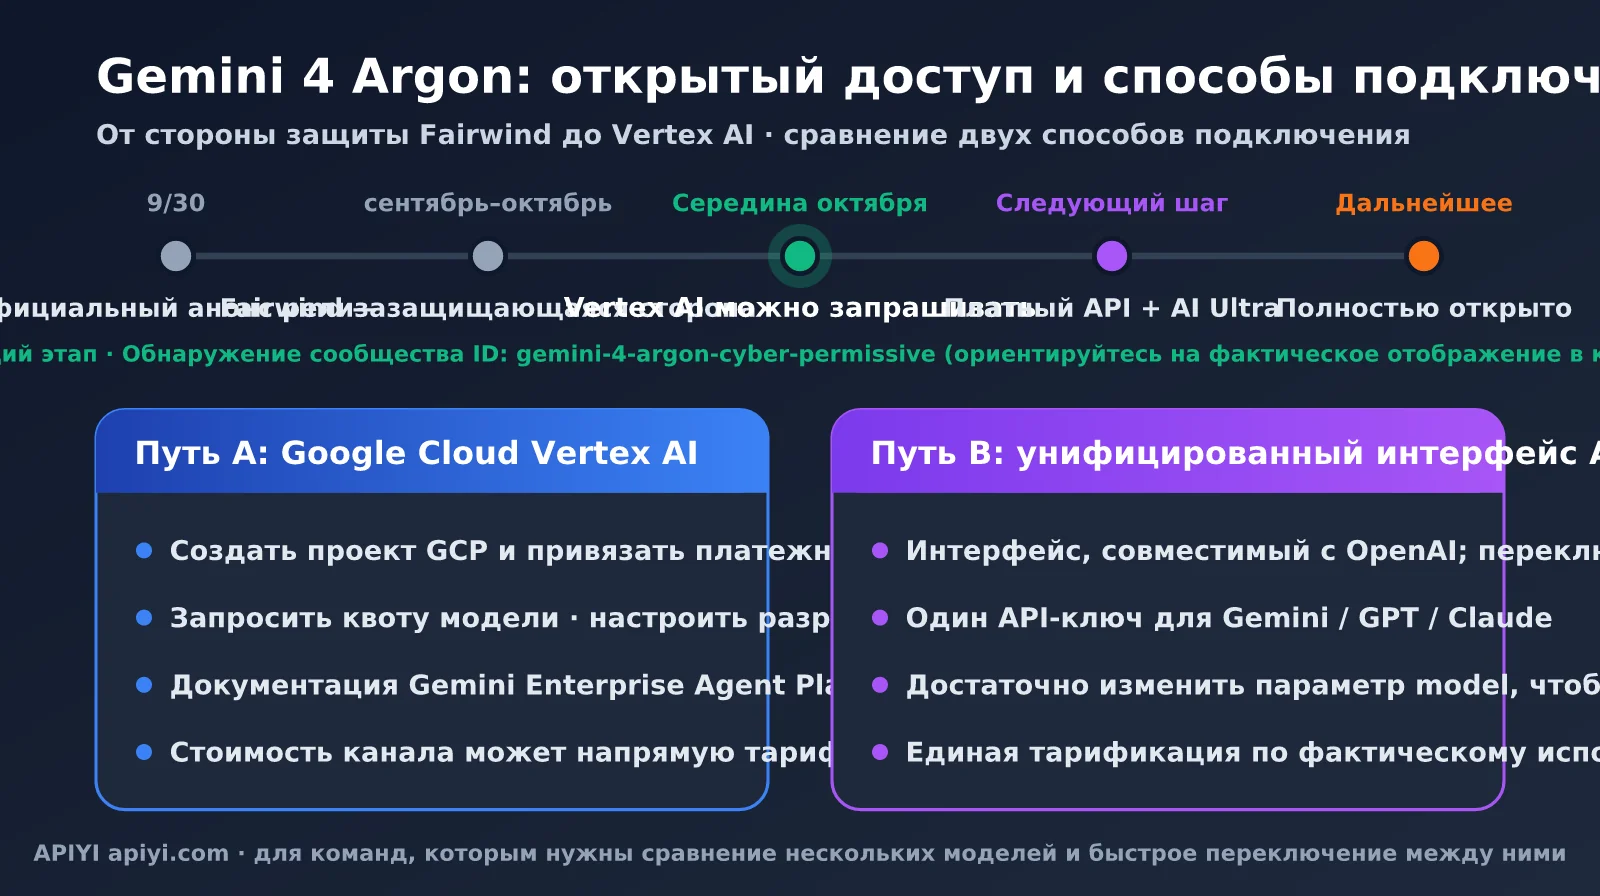
🚀 Совет по подключению: для прямой работы через Vertex AI нужны проект GCP, платёжный аккаунт, запрос квот и настройка IAM — для небольших и средних команд это может быть непросто. Мы рекомендуем подключаться к моделям Gemini через OpenAI-совместимый интерфейс платформы APIYI (apiyi.com): достаточно изменить параметр
model, чтобы переключаться между Argon и другими моделями.
Сравнение цен Gemini 4 Argon: модели той же линейки и конкуренты
По одной только цене за токены сложно понять, дорогой ли Argon. Для сравнения стоит рассмотреть его вместе с Gemini 3.8 Flash и флагманскими моделями конкурентов. В таблице указаны цены из открытых источников; цены конкурентов собраны сторонними аналитиками, актуальные данные лучше сверять на официальных сайтах производителей.
| Модель | Ввод / млн токенов | Вывод / млн токенов | Максимум токенов в ответе | Позиционирование |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | Основная модель на каждый день, хорошее соотношение цены и качества |
| Gemini 4 Argon (стартовая цена) | $2.00 | $10.00 | 1M | Флагман для длинных цепочек рассуждений |
| Gemini 4 Argon (обычная цена) | $4.00 | $20.00 | 1M | Флагман для длинных цепочек рассуждений |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | Флагман конкурента |
| GPT-6 Astra | $10.00 | $50.00 | 128K | Флагман конкурента |
При стартовой цене Argon примерно в 2,7 раза дороже Gemini 3.8 Flash. Обычная цена совпадает с ценой Claude Opus 5.5, а цена GPT-6 Astra в 2,5 раза выше. Но цена за токены — только половина картины. Вторая половина — сколько токенов нужно, чтобы выполнить ту же задачу. Именно на это стоит обратить особое внимание при оценке стоимости Argon.
Стоимость одной задачи в Gemini 4 Argon: главное — расход токенов
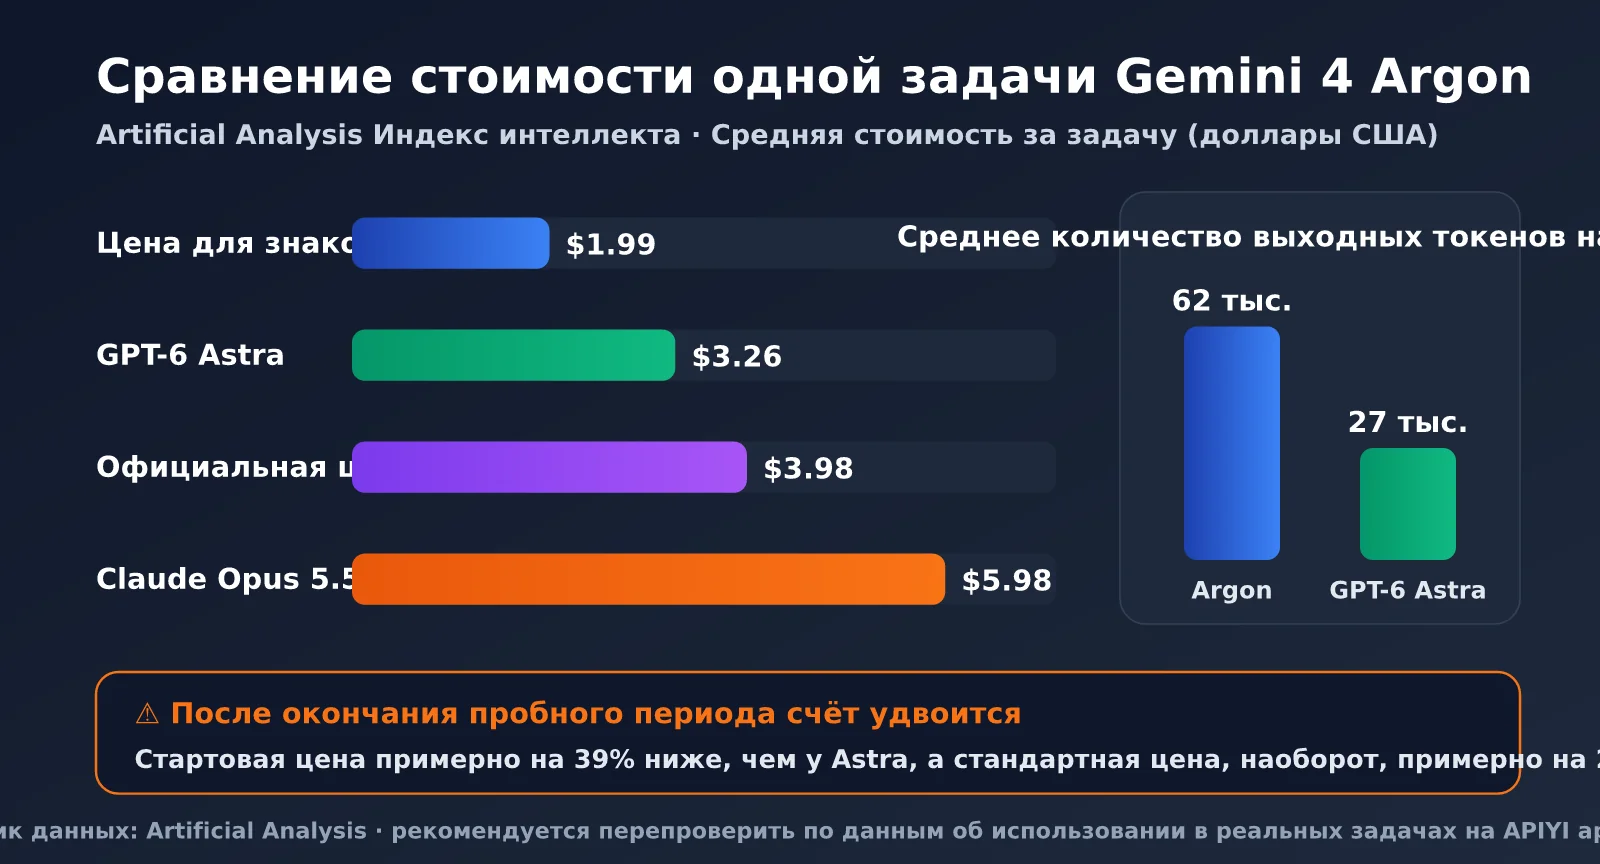
Стоимость выполнения одной задачи в тестах сторонних аналитиков позволяет лучше оценить расходы, чем цена за токены. По данным Artificial Analysis, в тесте Intelligence Index Argon в среднем генерировал около 62 тысяч выходных токенов на задачу. GPT-6 Astra набирал столько же, используя всего около 27 тысяч токенов: Argon «говорит» более чем вдвое больше конкурента.
| Методика оценки | Gemini 4 Argon | Модель для сравнения | Вывод |
|---|---|---|---|
| Стоимость задачи по AA (стартовая цена) | $1.99 | GPT-6 Astra — $3.26 | В период стартовой цены Argon примерно на 39% дешевле Astra |
| Стоимость задачи по AA (обычная цена) | $3.98 | GPT-6 Astra — $3.26 | При обычной цене Argon, наоборот, примерно на 22% дороже Astra |
| Стоимость задачи по AA | $1.99 | Claude Opus 5.5 — $5.98 | Примерно втрое дешевле Opus 5.5 |
| Стоимость одного теста Vals | $15.68 | Opus 5.5 — $32.14 / Sonnet 5.5 — $21.34 | Самая низкая стоимость для этой рабочей нагрузки |
| Среднее число выходных токенов на задачу | Около 62 тыс. | GPT-6 Astra — около 27 тыс. | Argon тратит заметно больше токенов на рассуждения |
Таблица показывает главное: пока действует стартовая цена, Argon предлагает хорошее соотношение цены и качества, но после её окончания на некоторых задачах он может обойтись дороже GPT-6 Astra, хотя у Astra выше цена за токены. Причина — в большом расходе выходных токенов. Однако тест Vals показывает, что на другом типе задач Argon оказывается самым дешёвым. Значит, итоговая стоимость сильно зависит от конкретной задачи — её нужно оценивать на собственных данных.
💡 Совет по выбору модели: низкая цена за токены не гарантирует низкий счёт. Попробуйте отправить одни и те же реальные задачи в Argon и другие флагманские модели через платформу APIYI apiyi.com. Сравните значения в поле
usageдля каждого запроса и выбирайте маршрутизацию по фактическому расходу токенов, а не по прайсу.
Реальная оценка стоимости Gemini 4 Argon: 5 типичных сценариев
Ниже рассчитаем стоимость одного запроса для пяти типичных сценариев по тарифам, опубликованным Google, — отдельно по ознакомительной и стандартной цене. Токены, затраченные на рассуждения, включены в выходные.
| Сценарий | Входные токены | Выходные токены | Стоимость по ознакомительной цене | Стоимость по стандартной цене |
|---|---|---|---|---|
| Повседневные вопросы и ответы | 2 万 | 5000 | $0.09 | $0.18 |
| Анализ длинных документов | 20 万 | 5 万 | $0.90 | $1.80 |
| Программирование с агентом (80% попаданий в кэш) | 60 万 | 6.2 万 | $0.91 | $1.82 |
| Масштабная миграция кода | 30 万 | 40 万 | $4.60 | $9.20 |
| Полный вывод в 1M токенов | Можно не учитывать | 100 万 | $10.00 | $20.00 |
Например, в сценарии программирования с агентом из 60 万 входных токенов 48 万 попадают в кэш и стоят всего $0.048 при тарифе $0.10. Оставшиеся 12 万 токенов тарифицируются по $2, то есть обходятся в $0.24. Вывод из 6.2 万 токенов по тарифу $10 стоит $0.62. Итого — около $0.91. Как видите, при эффективном использовании кэша на выходные токены приходится почти 70% общей стоимости. Поэтому ограничивать длину вывода важнее, чем сокращать входные данные.
Особенно внимательно нужно следить за расходами при масштабной миграции кода и полном выводе в 1M токенов. Максимальный объём вывода в 1M токенов — одно из главных преимуществ Argon, но один такой запрос по стандартному тарифу обойдётся в $20. Если из-за неправильно настроенного тайм-аута клиент сочтёт запрос неудачным и автоматически отправит его повторно, затраты сразу удвоятся. Для команд, которым ежедневно нужно запускать сотни длительных задач, такие скрытые расходы легко выходят из-под контроля и раздувают ежемесячный счёт.
Скрытые расходы при работе с Gemini 4 Argon
Учитывая приведённые расчёты, при подключении Argon стоит обратить особое внимание на следующие скрытые расходы:
- Рост числа токенов на рассуждения: в среднем Argon выдаёт более чем вдвое больше токенов, чем GPT-6 Astra. Плата за токены, затраченные на рассуждения, заметно увеличивает стоимость одной задачи.
- Слишком длинный вывод и повторные запросы: при максимальном выводе в 1M токенов неправильная настройка тайм-аутов клиента или балансировщика нагрузки может приводить к сбоям и повторным запросам, из-за чего расходы вырастут в разы.
- Промахи кэша: если структура промпта неудачная, доля попаданий в кэш будет низкой, а скидка в 95% пропадёт впустую.
- Окончание ознакомительного периода: все тарифы удвоятся, а чёткой даты окончания периода нет.
- Разница в ценах у разных каналов: в Vertex AI может сразу отображаться стандартная цена, которая вдвое выше расчётов по ознакомительному тарифу.
Как экономно подключить Gemini 4 Argon
Для сокращения описанных выше скрытых расходов лучше всего использовать три приёма: задавать верхний предел вывода для каждого запроса, размещать неизменяемую часть промпта в начале, чтобы чаще попадать в кэш, и выбирать модель с учётом сложности задачи. В примере ниже используется интерфейс, совместимый с OpenAI, а ID модели задаётся через переменную окружения.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# 模型 ID 以平台或 Vertex AI 控制台实际显示为准
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 显式设置输出上限,避免默认放开到 1M
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
Посмотреть полный код: маршрутизация по сложности и учёт расходов
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型与单价全部配置化,尝鲜期结束后只需改环境变量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 稳定前缀放在最前面,提升缓存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """简单示例:长任务、迁移、审计类任务走 Argon,其余走 Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 长输出任务放宽超时,避免失败重试导致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
В этом примере реализованы три принципа экономии. Во-первых, явно задавайте max_tokens, а не полагайтесь на огромный предел вывода по умолчанию. Во-вторых, размещайте системный промпт в начале как стабильный префикс, чтобы запросы в рамках диалога чаще попадали в кэш. В-третьих, выбирайте модель по сложности задачи: простые задачи отправляйте в Gemini 3.8 Flash, тарифы которого примерно втрое ниже, чем у Argon, а Argon оставьте для сложных задач с длинной цепочкой действий.
Совет: получите тестовый лимит в APIYI на apiyi.com и запустите приведённый скрипт маршрутизации на реальном потоке запросов в течение недели. Затем скорректируйте порог сложности и лимит вывода на основе логов usage.
Часто задаваемые вопросы
Вопрос 1. Сколько сейчас стоит Gemini 4 Argon: $2/$10 или $4/$20?
Google объявила стартовую цену $2/$10 и стандартную цену $4/$20, но не уточнила, сколько продлится период стартовой цены и будут ли все каналы доступа применять её одинаково. По сообщениям сообщества, в Vertex AI указана стандартная цена $4/$20. Ориентируйтесь на стоимость за единицу из счёта вашего канала доступа и закладывайте бюджет сразу по обоим тарифам.
Вопрос 2. Можно ли сразу использовать gemini-4-argon-cyber-permissive в Vertex AI?
Судя по названию, эта версия предназначена для специалистов по киберзащите и имеет менее строгие ограничения в области кибербезопасности. Для доступа к ней требуются разрешения в рамках программы Fairwind, которых обычно нет у обычных проектов. Платным клиентам стоит ориентироваться на идентификатор модели, отображаемый в Model Garden их консоли. Если не хотите разбираться с настройкой проектов GCP, квот и разрешений, можно вызывать модели серии Gemini через агрегатор, например APIYI apiyi.com.
Вопрос 3. Нужно ли отдельно платить за токены рассуждений Argon?
Google пока не уточнила этот вопрос отдельно. Однако у существующих моделей Gemini токены рассуждений тарифицируются по цене выходных токенов, поэтому для расчётов стоит использовать то же правило. Argon в среднем генерирует больше токенов, поэтому токены рассуждений часто составляют основную часть расходов. Контролировать затраты можно, ограничивая max_tokens и настраивая интенсивность рассуждений.
Вопрос 4. В каких случаях стоит платить за Gemini 4 Argon?
Argon особенно хорошо показывает себя в длительных задачах: масштабной миграции кода, профессиональном анализе объёмных документов, работе юридических и финансовых агентов, а также аудите безопасности. В таких случаях за его возможности стоит платить. Для повседневных вопросов, простого автодополнения кода и лёгких задач с высокой нагрузкой обычно выгоднее недорогие модели вроде Gemini 3.8 Flash. Надёжнее всего сравнить модели на реальных задачах с помощью A/B-тестирования на платформе APIYI apiyi.com, а затем определить долю запросов для каждой модели.
Итоги
Цену Gemini 4 Argon можно описать так: «выглядит привлекательно, но есть много переменных». Стартовый тариф $2/$10 очень конкурентоспособен среди флагманских моделей, а скидка 95% на кешированные запросы особенно выгодна для сценариев с агентами. Но высокий расход токенов рассуждений, удвоение цены после окончания стартового периода и возможное применение стандартного тарифа в Vertex AI могут заметно увеличить реальный счёт по сравнению с ожиданиями.
Теперь, когда Gemini 4 Argon можно подключить через Vertex AI, главное — не спешить переводить на неё весь трафик. Сначала измерьте распределение расхода токенов на реальных запросах, а затем контролируйте затраты с помощью ограничения вывода, кеширования префиксов и маршрутизации запросов по уровню сложности. Рекомендуем использовать Argon как флагманскую модель для сложных задач и сочетать её с моделями уровня Flash.
Мы рекомендуем подключать модели серии Gemini через платформу APIYI: единый интерфейс позволит сравнить стоимость и качество Argon и других моделей и выбрать стратегию на основе данных, а не заявленной цены.
Источники:
- Официальная публикация Google о выходе Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Страница Google о программе Fairwind: deepmind.google/fairwind-program
- Подборка бенчмарков и цен Gemini 4 Argon от DataCamp: datacamp.com/blog/gemini-4-argon
- Данные о стоимости моделей и индексе интеллектуальных возможностей от Artificial Analysis: artificialanalysis.ai
- Оценки моделей и данные о стоимости от Vals AI: vals.ai
Автор: команда APIYI | Следим за ценами на большие языковые модели и изменениями в способах их подключения. Больше новостей о подключении ИИ-моделей — на APIYI apiyi.com.