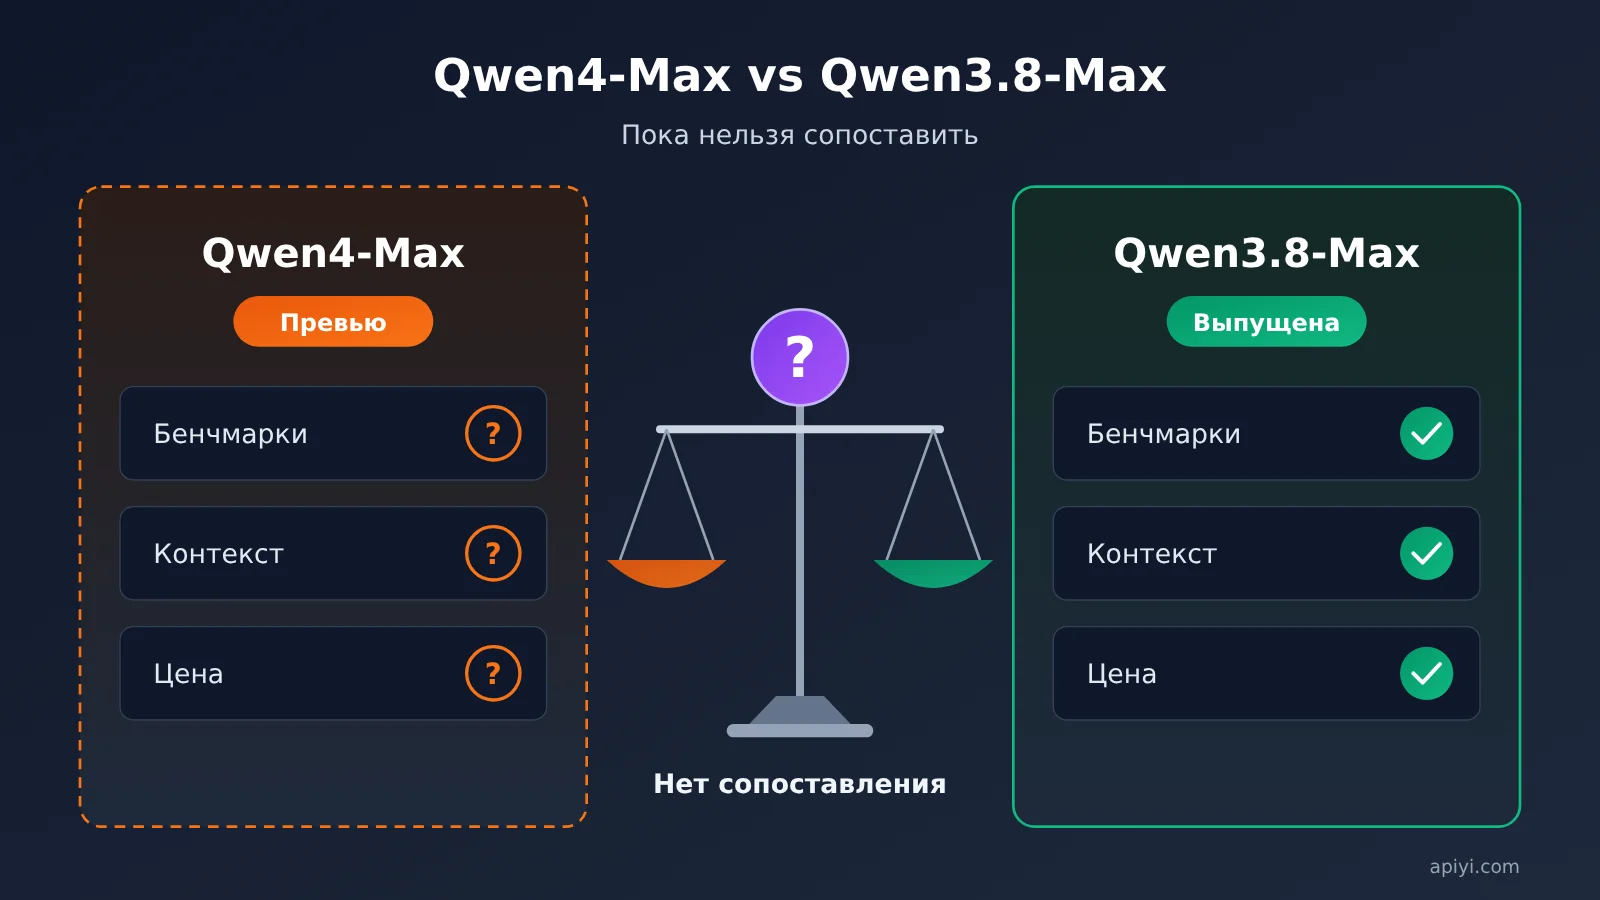
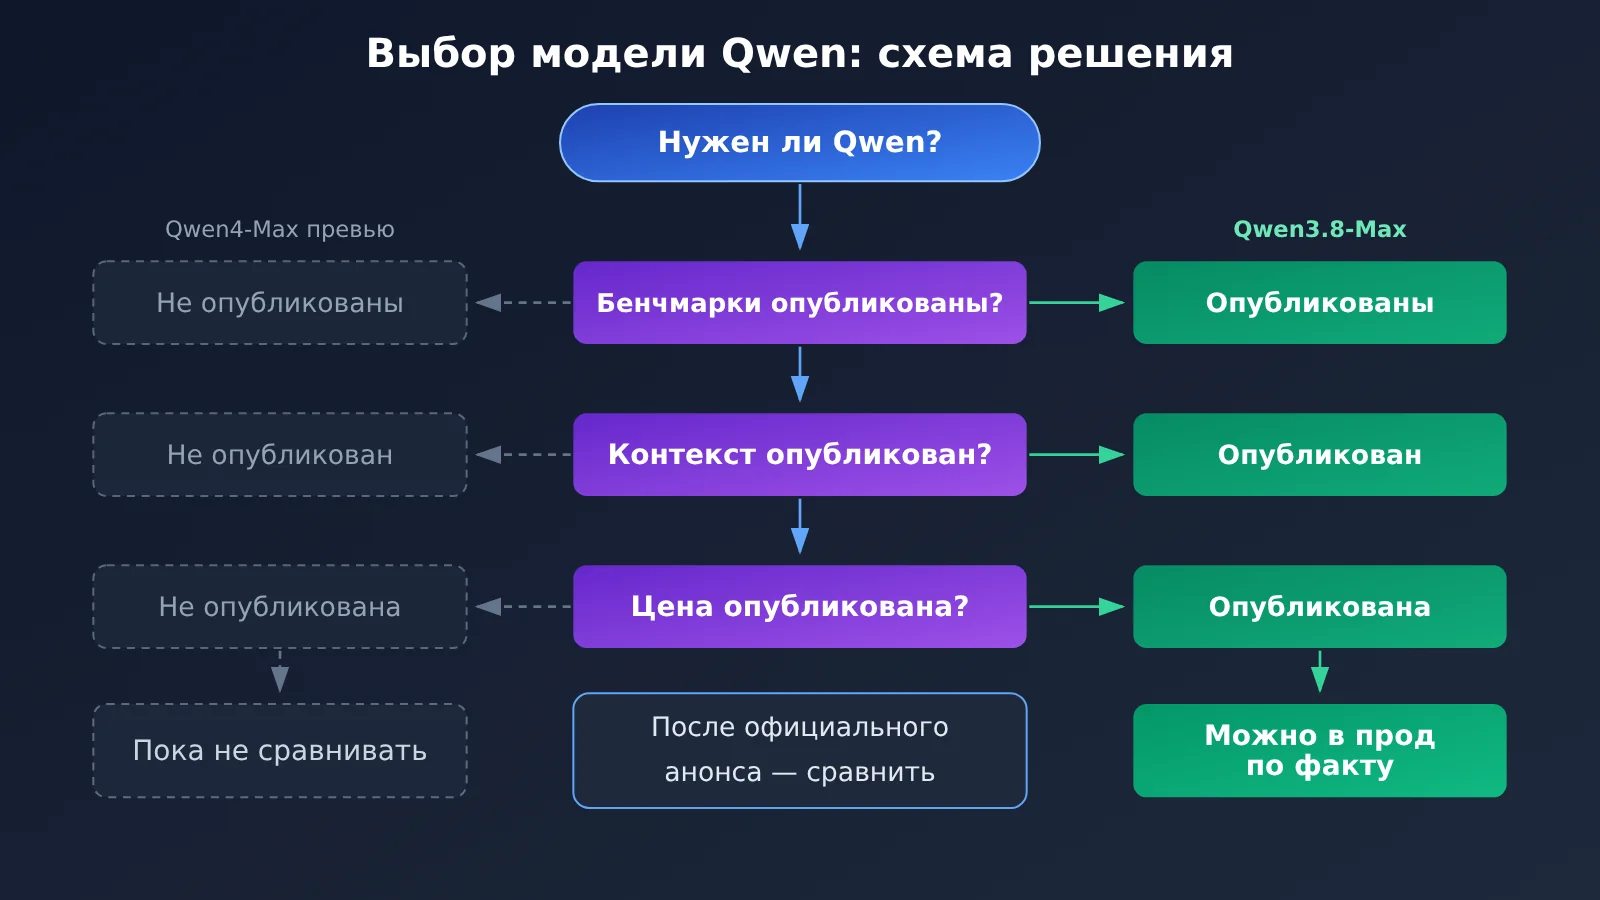
Примечание автора: Qwen4-Max пока на стадии превью. У неё нет публичных результатов бенчмарков, данных о длине контекста и цены за токен, поэтому по этим трём пунктам честно сравнить её с Qwen3.8-Max нельзя. Сейчас по факту использования можно вызывать только qwen3.8-max.
Как только вышло превью Qwen4-Max, разработчики, которые сидят на Qwen, первым делом спрашивают одно и то же: переходить или нет? Насколько она сильнее Qwen3.8-Max? И насколько дороже? Пока что на эти вопросы нельзя дать ответ, который можно было бы корректно сопоставить: у превью нет трёх публичных данных, без которых сравнение не имеет смысла.
Мы не хороним Qwen4-Max. Мы вообще не оцениваем, сильная она или слабая, а просто фиксируем факт. По состоянию на 2026-11-12 у превью Qwen4-Max нет публичных бенчмарков, длины контекста и цены за токен. Qwen3.8-Max при этом уже выпущена и доступна для вызова с оплатой по факту использования. Согласно списку моделей APIYI (apiyi.com) на 2026-11-12, напрямую подключить сейчас можно qwen3.8-max.
Главная польза: за 3 минуты вы поймёте, по каким пунктам превью Qwen4-Max и Qwen3.8-Max сегодня сравнивать нельзя, и как спланировать работу над проектом, пока официальной информации нет.
Qwen4-Max и Qwen3.8: краткая сводка ключевой информации
Сначала соберём в одном месте всё, что на данный момент можно подтвердить по обеим моделям. В таблице — только то, что подтверждается источниками. Всё, что не опубликовано, помечено как «не опубликовано», без домыслов.
| Параметр | Qwen4-Max (превью) | Qwen3.8-Max |
|---|---|---|
| Статус выпуска | Стадия превью | Выпущенная модель |
| Публичные бенчмарки | Не опубликованы | Модель выпущена, официальные материалы доступны |
| Длина контекста | Не опубликована | Смотрите официальную документацию и описание модели |
| Цена за токен | Не опубликована | Вход $1.65 / выход $4.95 / чтение из кэша $0.20625 (за 1M токенов) |
| Вызов с оплатой по факту | В списке моделей на 2026-11-12 пока отсутствует | Доступен, ID модели qwen3.8-max |
| Доступные платформы | Ждём официальных анонсов | APIYI и другие платформы |
«Не опубликовано» в таблице встречается трижды: бенчмарки, контекст и цена. Это как раз те параметры, по которым чаще всего выбирают модель. Если не хватает хотя бы одного, сравнивать модели по-честному не получится. Про открытое превью уже выходили материалы, поэтому здесь разберём только одно: почему эти три пункта нельзя сравнивать «на глаз».
На что влияют три недостающих параметра превью Qwen4-Max
Бенчмарки нужны, чтобы оценить возможности модели. Без официальных результатов у нас нет единой меры, чтобы понять, насколько Qwen4-Max лучше или хуже Qwen3.8-Max в рассуждениях, коде, работе с длинными текстами и других задачах. Разрозненные скриншоты из сообщества или личные впечатления от диалогов заменить их не могут: у каждого свои тестовые наборы, промпты и параметры сэмплирования.
Длина контекста определяет архитектуру. Размер чанков в RAG, стратегия обрезки истории диалога, решение «скормить длинный документ целиком или разбить на части» — всё это зависит от точного лимита контекстного окна. Пока цифры нет, нельзя оценить, получится ли после миграции выкинуть существующую логику разбиения, и нельзя понять, не начнутся ли ошибки из-за слишком длинного ввода.
Цена за токен определяет модель затрат. Бюджет, тарифы и политика лимитов строятся на цене. Даже если превью можно попробовать, это не значит, что появилась цена, которую можно вписать в смету. Сравнивать неопределённую цену с действующей ценой qwen3.8-max бессмысленно: вывод всё равно ничего не будет стоить.
Цена Qwen3.8-Max при оплате по факту использования и как подключиться
Условий для сравнения пока нет, поэтому в текущих проектах опираемся на уже выпущенные модели. В таблице ниже — цена qwen3.8-max из списка моделей от 2026-11-12, в расчёте на 1M токенов.
| Статья тарификации | Цена (за 1M токенов) | Пояснение |
|---|---|---|
| Вход | $1.65 | Часть промпта, не попавшая в кэш |
| Выход | $4.95 | Контент, который генерирует модель; цена в 3 раза выше входной |
| Чтение кэша | $0.20625 | Часть входа, попавшая в кэш; цена составляет 1/8 от входной |
Если посмотреть на структуру цен, выход стоит в 3 раза дороже входа, а чтение кэша — всего 12,5% от цены входа. Поэтому два самых прямых способа снизить расходы на qwen3.8-max — ограничивать длину вывода и повышать долю попаданий в кэш. Особенно заметна выгода от кэша, когда системный промпт длинный, а префикс многошагового диалога остаётся стабильным.
Примеры расчёта стоимости Qwen3.8-Max
По приведённым ценам можно посчитать стоимость нескольких типичных запросов. Все цифры ниже получены напрямую из публичных тарифов, так что их легко подставить под свои объёмы.
| Сценарий | Входных токенов | Из них попало в кэш | Выходных токенов | Стоимость одного запроса |
|---|---|---|---|---|
| Обычный разовый запрос | 10,000 | 0 | 2,000 | $0.0264 |
| Тот же запрос, префикс попал в кэш | 10,000 | 8,000 | 2,000 | $0.01485 |
| Пакетная обработка 1M входных токенов | 1,000,000 | 0 | 200,000 | $2.64 |
Во второй строке общий объём входа и выхода такой же, как в первой, просто 8,000 входных токенов попали в кэш — и стоимость одного запроса падает с $0.0264 до примерно $0.0149, то есть больше чем на 40%. Такой расчёт для превью Qwen4-Max сейчас сделать нельзя: его цена ещё не опубликована.
Как подключить qwen3.8-max
APIYI предоставляет OpenAI-совместимый интерфейс, поэтому подключиться можно через OpenAI SDK или любой совместимый клиент — достаточно поменять три параметра:
base_url:https://api.apiyi.com/v1(единый интерфейс APIYI)api_key: API-ключ, созданный в консоли APIYImodel:qwen3.8-max
Вызов устроен так же, как в Chat Completions: массив messages просто выстраивается по ролям system, user, assistant. Если проект уже работает с OpenAI-совместимым эндпоинтом, обычно достаточно заменить base_url и ID модели, а бизнес-код трогать не придётся.
🚀 Быстрый старт: зарегистрируйтесь на APIYI (apiyi.com) и получите бесплатные тестовые кредиты. Сначала прогоните на
qwen3.8-maxсобственные рабочие промпты и запишите реальные объёмы входа, выхода и долю попаданий в кэш — когда Qwen4-Max откроют официально, у вас уже будут данные для сравнения.
Влияние предварительной версии Qwen4-Max на существующие проекты с Qwen
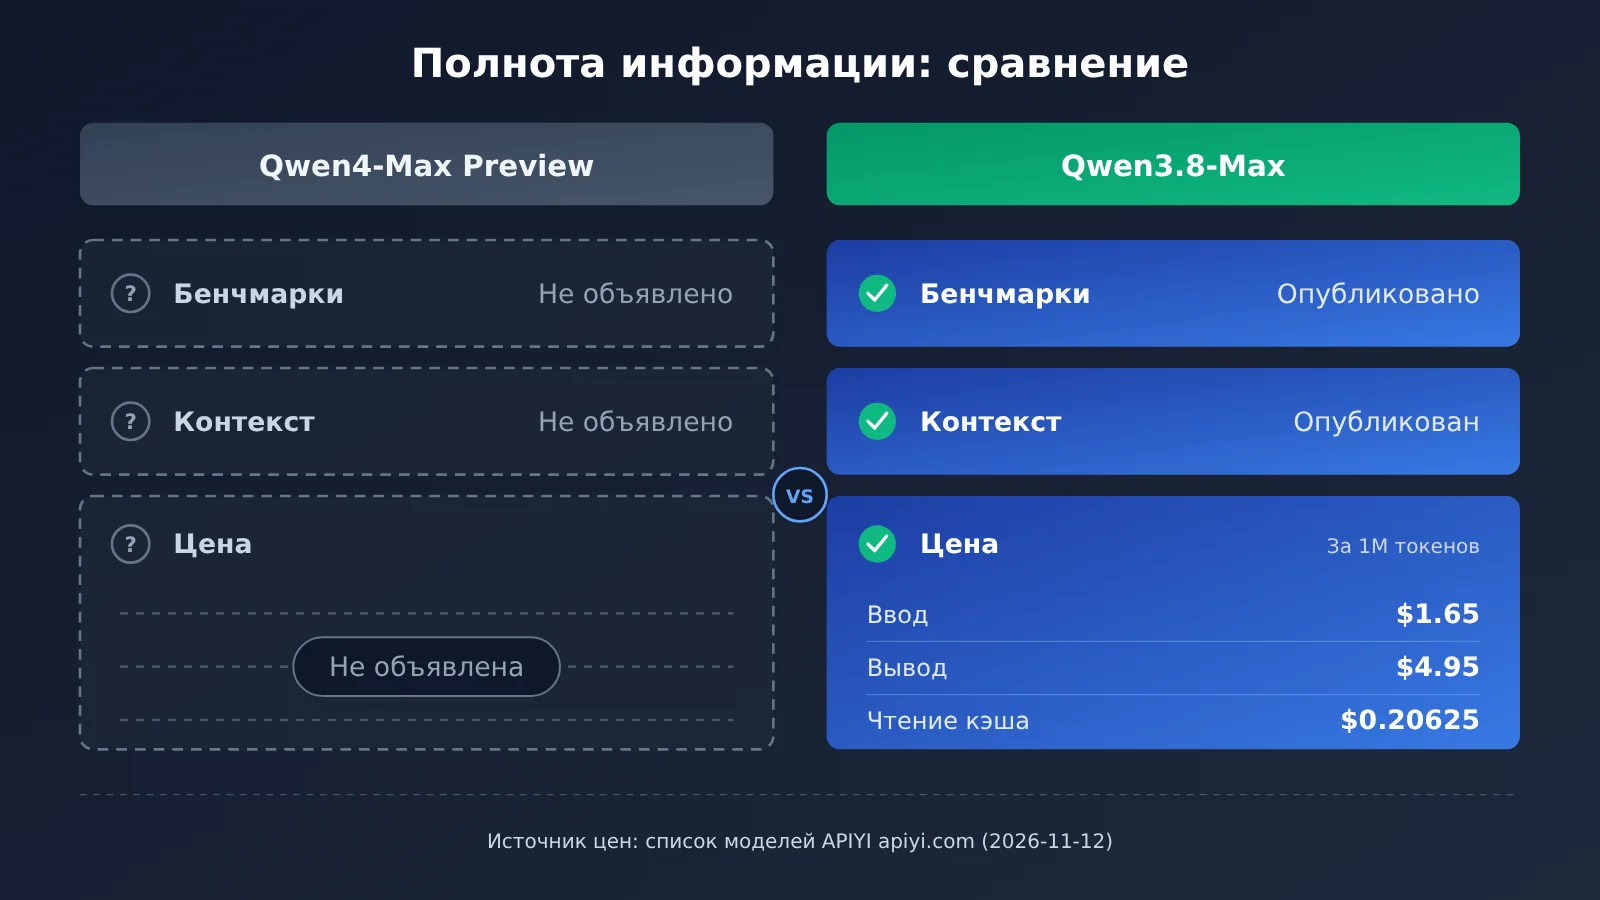
На схеме выше рядом показана полнота информации по обеим моделям: с одной стороны — три пустых места с пометкой «ожидается публикация», с другой — данные, которые можно проверить прямо сейчас. Пока так, любые выводы вроде «насколько лучше» или «насколько дороже» ничем не подкреплены. Цены можно сверить в списке моделей APIYI на apiyi.com.
Что это значит для разработчиков, которые уже используют Qwen
- Продакшен трогать не нужно: превью Qwen4-Max никак не влияет на доступность и цену qwen3.8-max, текущие вызовы работают как раньше.
- К оценке можно готовиться уже сейчас: соберите набор промптов, который отражает вашу реальную задачу, и критерии оценки. Когда появится официальная информация, вы сразу сможете сравнить две модели.
- Бюджет по-прежнему считайте на qwen3.8-max: у превью пока нет цены, так что закладывать Qwen4-Max в бюджет или коммерческое предложение на следующий этап не стоит.
- Доработки под контекст лучше отложить: пока длина контекста Qwen4-Max не объявлена, не меняйте из-за неё логику разбиения на чанки или обрезки.
Что делать разным ролям в команде
| Роль | Что можно сделать сейчас | Что делать после публикации официальной информации |
|---|---|---|
| Прикладной разработчик | Продолжать использовать qwen3.8-max, копить собственный набор тестов |
Прогнать оба модели на одном и том же наборе тестов |
| Архитектор | Проектировать стратегию работы с контекстом исходя из реального лимита qwen3.8-max | Оценить, можно ли упростить разбиение на чанки, исходя из длины контекста Qwen4-Max |
| Ответственный за затраты | Считать бюджет по ценам: вход $1.65, выход $4.95 за 1M токенов | Пересчитать стоимость миграции, когда будет известна цена Qwen4-Max |
| Продакт-менеджер | В коммуникации опираться на возможности уже выпущенных моделей | Решить, стоит ли заявлять об апгрейде, по публичным бенчмаркам |
Что это говорит о процессе выбора модели
Главная ловушка превью-версий — принять «выглядит новее» за «уже лучше». Нормальный процесс выбора опирается минимум на три публичных источника данных: возможности (бенчмарки), объём (контекст) и стоимость (цена). Пока нет всех трёх, новую модель стоит держать в списке наблюдения, а не закладывать в продакшен-решение.
У единого интерфейса для вызова моделей есть ещё один плюс: когда Qwen4-Max откроют для оплаты по факту использования, для A/B-сравнения достаточно будет поменять параметр model, а не подключать заново отдельный SDK.
💡 Рекомендация: пока три ключевых параметра Qwen4-Max не опубликованы, оставляйте основной рабочей лошадкой qwen3.8-max. Если подключиться через единый интерфейс APIYI на apiyi.com, то после выхода новой модели переключаться и сравнивать её можно будет в том же коде.
Часто задаваемые вопросы (FAQ)
Q1: Можно ли сейчас сравнить превью Qwen4-Max с Qwen3.8-Max?
По трём параметрам — результатам бенчмарков, длине контекста и цене за токен — пока нельзя. Qwen4-Max всё ещё на стадии превью, и ни один из этих показателей публично не раскрыт, так что единой базы для сравнения нет. Надёжно известен только статус релиза: Qwen3.8-Max уже вышла, и её можно вызывать с оплатой по факту использования, а Qwen4-Max пока в превью.
Q2: Qwen4-Max уже полностью превзошла Qwen3.8-Max?
Публичных данных, которые подтверждали бы такой вывод, сейчас нет. Более высокий номер версии не значит, что модель сильнее во всех задачах, и тем более не гарантирует более выгодную цену. Есть ли превосходство и в каких именно задачах, можно будет судить только после публикации официальных бенчмарков. Лучше ещё и проверить это на собственном наборе тестов для вашего бизнеса.
Q3: Сколько сейчас стоит вызов Qwen3.8-Max?
По списку моделей на 2026-11-12 цены для qwen3.8-max такие (за 1M токенов): ввод — $1.65, вывод — $4.95, чтение из кэша — $0.20625. Чтение из кэша стоит всего 1/8 от цены входа, так что в сценариях со стабильным префиксом промпта можно заметно сэкономить.
Q4: Как быстро вызвать Qwen3.8-Max через API?
Рекомендую использовать API-агрегатор с поддержкой нескольких моделей:
1. Зайдите на APIYI (apiyi.com), зарегистрируйте аккаунт и получите API-ключ и бесплатный тестовый лимит
2. Укажите в `base_url` значение `https://api.apiyi.com/v1`
3. В качестве ID модели укажите `qwen3.8-max` и вызывайте её в формате Chat Completions, совместимом с OpenAI
Q5: Дорого ли будет мигрировать, когда Qwen4-Max откроют официально?
Стоимость миграции на уровне интерфейса зависит от способа подключения. Если вы управляете моделями через OpenAI-совместимый интерфейс, обычно достаточно сменить ID модели. По-настоящему оценивать придётся разницу в качестве и в стоимости. Советую уже сейчас накапливать данные тестов на qwen3.8-max через APIYI (apiyi.com), чтобы потом сразу сравнить.
Q6: На какие ограничения стоит обратить внимание на стадии превью?
На стадии превью любые ключевые параметры могут измениться. Бенчмарки не опубликованы, поэтому границы возможностей модели оценить нельзя. Длина контекста неизвестна, а значит, решение для работы с длинными текстами не зафиксировать. Цены неизвестны, и в бюджет их не заложить. Поэтому превью-модели не стоит использовать в продакшене, где важны стабильность и предсказуемость затрат.
Qwen4-Max и Qwen3.8: ключевые выводы (Key Takeaways)
- Разный статус релиза: Qwen4-Max пока доступна только в виде превью, а Qwen3.8-Max уже выпущена, и её можно вызывать с оплатой по факту использования.
- По трём параметрам прямое сравнение невозможно: результаты бенчмарков, длина контекста и цена за токен для Qwen4-Max не опубликованы.
- Не спешите с выводами: пока нет открытых данных, нельзя утверждать, что Qwen4-Max везде превосходит Qwen3.8-Max.
- Актуальные цены известны: qwen3.8-max стоит $1,65 за 1M токенов на вход, $4,95 на выход и $0,20625 за чтение из кеша.
- Кеш — главный способ сэкономить: чтение из кеша стоит всего 1/8 от цены входных токенов, так что при стабильном префиксе выгода заметная.
- В продакшене ориентируйтесь на qwen3.8-max: подключайтесь через единый интерфейс APIYI, и при смене модели достаточно поменять только ID модели.
Итоги
Как соотносятся превью Qwen4-Max и Qwen3.8-Max — коротко по главному:
- Для сравнения пока нет условий: у превью Qwen4-Max нет публичных результатов бенчмарков, данных о длине контекста и цены за токен, так что ни по одному из этих пунктов его нельзя честно сопоставить с Qwen3.8-Max.
- Сейчас можно использовать qwen3.8-max: цены у неё понятны — $1,65 за вход, $4,95 за выход и $0,20625 за чтение из кеша (за 1M токенов).
- Готовьтесь сейчас, сравнивайте после официального анонса: сначала соберите собственный набор тестов для вашей задачи и данные по стоимости, а решение о переходе принимайте, когда появится вся информация.
Пока официальной информации о Qwen4-Max нет, разумнее всего продолжать работать на qwen3.8-max и параллельно подготовить базовые метрики качества и стоимости. Подключить qwen3.8-max удобно через APIYI (apiyi.com): платформа предлагает единый OpenAI-совместимый интерфейс и бесплатный тестовый лимит, а когда выйдет новая модель, вы сможете сравнить её с текущей в том же коде.
📚 Справочные материалы
- Список моделей и цен APIYI: сверка доступных для вызова моделей на 2026-11-12
- Ссылка:
api.apiyi.com/api/pricing -
Описание: используется, чтобы убедиться, какие модели Qwen сейчас доступны с оплатой по факту использования
-
Документация по моделям APIYI: тарифы на qwen3.8-max
- Ссылка:
docs.apiyi.com/models - Описание: содержит цены на входные и выходные токены qwen3.8-max, а также на чтение из кэша
Автор: техническая команда APIYI
Обратная связь: пишите нам на главной странице APIYI, а больше материалов по подключению моделей найдёте в центре документации APIYI