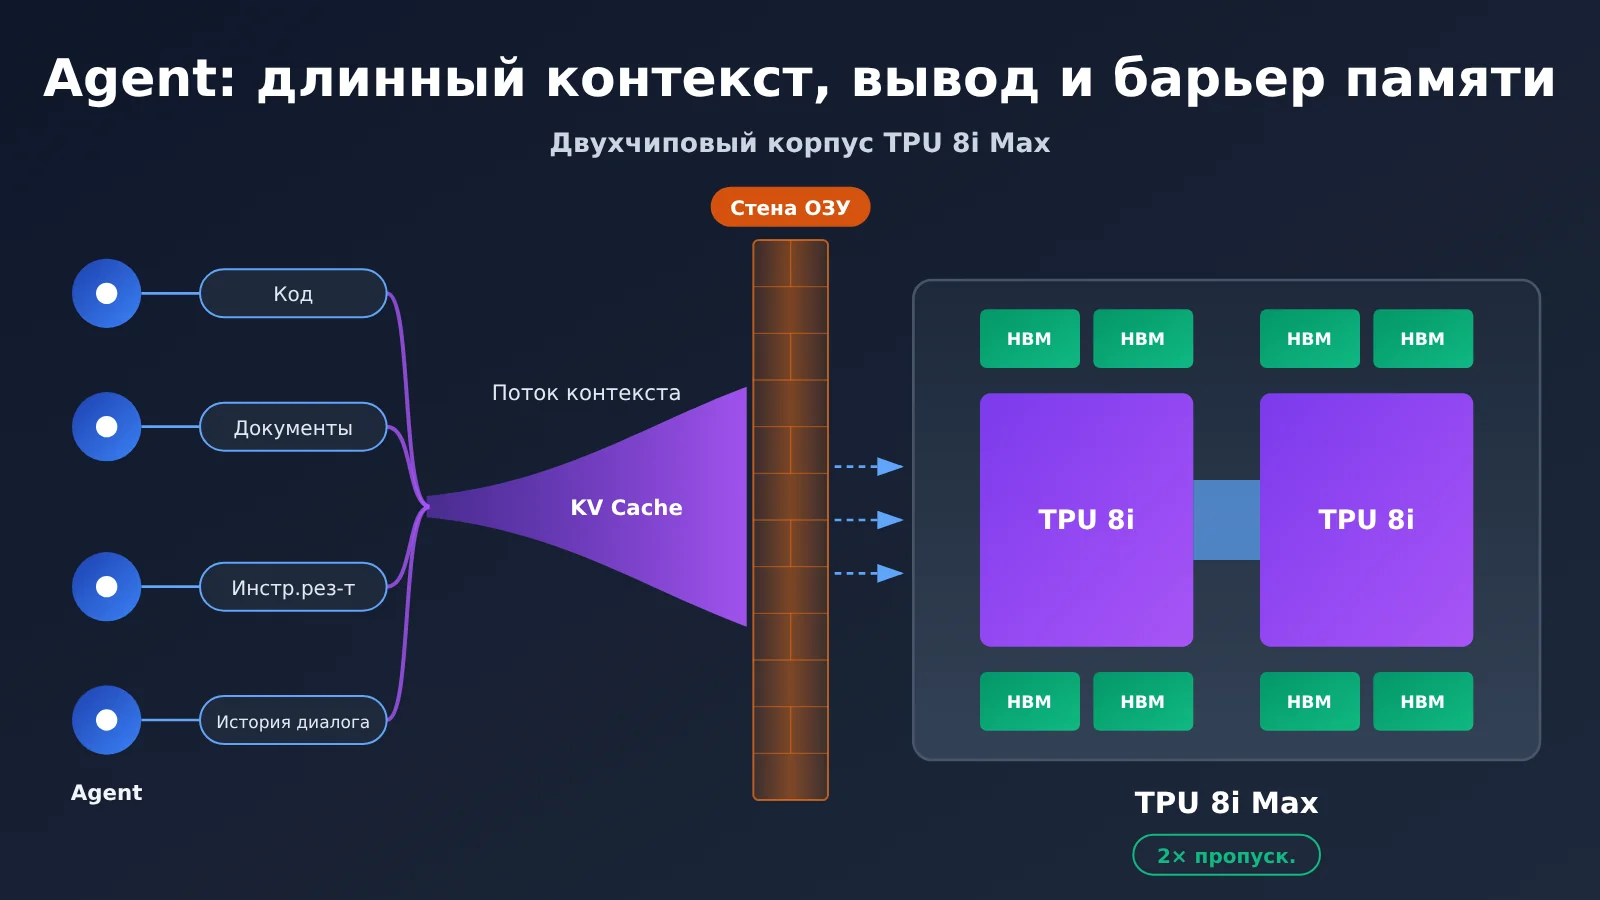
9 ноября 2026 года Google Cloud представила две новые конфигурации систем на TPU восьмого поколения: TPU 8tx и TPU 8i Max. В TPU 8i Max два чипа TPU 8i объединены в одном корпусе: вычислительная мощность, встроенная SRAM и пропускная способность HBM увеличены вдвое. Система рассчитана на обработку длинного контекста, высокую параллельную нагрузку и совместную работу нескольких агентов.
Это не просто очередной анонс наращивания вычислительной мощности. Официальное заявление Google, опубликованный одновременно анонс о сотрудничестве с AMD и краткие обзоры в нескольких СМИ подтверждают эту информацию. В статье мы не будем перечислять характеристики чипов, а на примере расчётов KV Cache покажем, как меняется узкое место в инференсе для агентов: вместо вопроса «как быстро считать?» всё важнее становится вопрос «успеют ли данные вовремя попасть в вычислительные блоки?».
Главное: прочитав статью, вы сможете самостоятельно оценить, сколько памяти займёт запрос с длинным контекстом, понять, откуда берётся стена памяти, и разобраться, что системы вроде TPU 8i Max могут дать вашему сервису для агентов.
Ключевые сведения о TPU 8i Max и длинном контексте для Agent
| Параметр | Подробности |
|---|---|
| Дата анонса | 9 ноября 2026 года |
| Компания | Google Cloud |
| Тип продукта | Системная конфигурация TPU восьмого поколения, а не совершенно новый самостоятельный чип |
| Компоновка | Два TPU 8i интегрированы в одном корпусе |
| Подтверждённый прирост производительности | Вычислительная мощность, объём SRAM и пропускная способность HBM в 2 раза выше, чем у TPU 8i |
| Параметры из брифинга для СМИ | 384 ГБ HBM, пропускная способность HBM — 17,2 ТБ/с, 768 МБ SRAM |
| Целевые сценарии | Длинный контекст, высокопараллельный инференс, совместная работа нескольких Agent, анализ длинных видео и другие задачи |
| Доступность | На официальной странице продукта указано «Скоро»; цены и дата общего доступа (GA) пока не объявлены |
Важно отметить, что в анонсе Google чётко разделяет понятия chip и system — чип и система. Разработка чипа занимает годы, тогда как системную конфигурацию можно быстрее адаптировать к новым рабочим нагрузкам, изменяя компоновку, память, сеть и компоненты безопасности. TPU 8i Max — результат именно такого подхода: в нём используется тот же кристалл, что и в TPU 8i, а изменения коснулись корпуса и системного уровня.
Почему Agent с длинным контекстом расходует больше памяти, чем обычный чат
Обычный чат обычно строится по схеме «вопрос — ответ»: контекст растёт медленно, а после завершения беседы состояние можно удалить. С Agent всё иначе: он разбивает цель на несколько подзадач, постоянно изучает внешние материалы, вызывает инструменты, продолжает рассуждать с учётом полученных результатов и сохраняет состояние, пока ждёт ответов. Результаты каждого шага добавляются в контекст, поэтому тот только растёт.
Например, во время одной задачи Agent для разработки ПО может одновременно работать с такими данными:
- Кодовая база: сотни файлов исходного кода и связи между ними
- Документация проекта: описание архитектуры, соглашения об интерфейсах, правила оформления кода
- История диалога: уточнения требований пользователя и правки, предложенные за несколько раундов
- Результаты работы инструментов: логи компиляции, результаты тестов, стеки ошибок
- Результаты работы дочерних Agent: ответы от дочерних Agent, отвечающих за тестирование, проверку и рефакторинг
Ещё важнее то, что задачи выполняются параллельно. Когда главный Agent запускает 4 дочерних, в системе одновременно существуют 5 отдельных контекстов. Каждый из них должен постоянно находиться в памяти во время обработки. Поэтому Google и называет «совместную разработку крупного ПО несколькими Agent» типичным сценарием использования TPU 8i Max. Важно уточнить: упомянутый Google «контекст на миллион токенов» — это описание целевого сценария применения, а не опубликованная фиксированная максимальная длина контекста.
Как KV-кэш линейно растёт при работе агента с длинным контекстом
Для чего нужен KV-кэш
При генерации каждого нового токена Transformer использует Query текущего токена, чтобы вычислить оценки внимания для Key всех предыдущих токенов, а затем суммирует их Value с учётом полученных весов. Если при генерации каждого токена заново вычислять Key и Value для всей истории, объём вычислений будет резко расти вместе с длиной последовательности. KV-кэш позволяет повторно использовать уже вычисленные Key и Value предыдущих токенов: мы расходуем память, чтобы сократить вычисления.
Цена этого подхода — кэш постоянно растёт вместе с длиной контекста и числом одновременных запросов. Приведённая ниже формула оценки соответствует организации памяти KV-кэша в vLLM:
M_KV = 2 × L × H_KV × D × B × T × N
| Параметр | Значение | Для Llama 3.1 70B |
|---|---|---|
| 2 | Отдельные кэши для Key и Value | 2 |
| L | Число слоёв Transformer | 80 |
| H_KV | Число голов внимания Key/Value | 8 (GQA) |
| D | Размерность каждой KV-головы | 128 |
| B | Число байт на элемент | 2 (BF16) |
| T | Число токенов в запросе | Зависит от сценария |
| N | Число одновременных запросов | Зависит от сценария |
Пример расчёта KV Cache для Llama 3.1 70B
Сначала рассчитаем объём для одного токена: 2 × 80 × 8 × 128 × 2 = 327,680 байт, то есть примерно 320 KiB на токен. На первый взгляд, это немного, но с ростом длины контекста объём быстро увеличивается.
| Сценарий | Длина контекста | Параллельные запросы | Теоретический объём KV Cache |
|---|---|---|---|
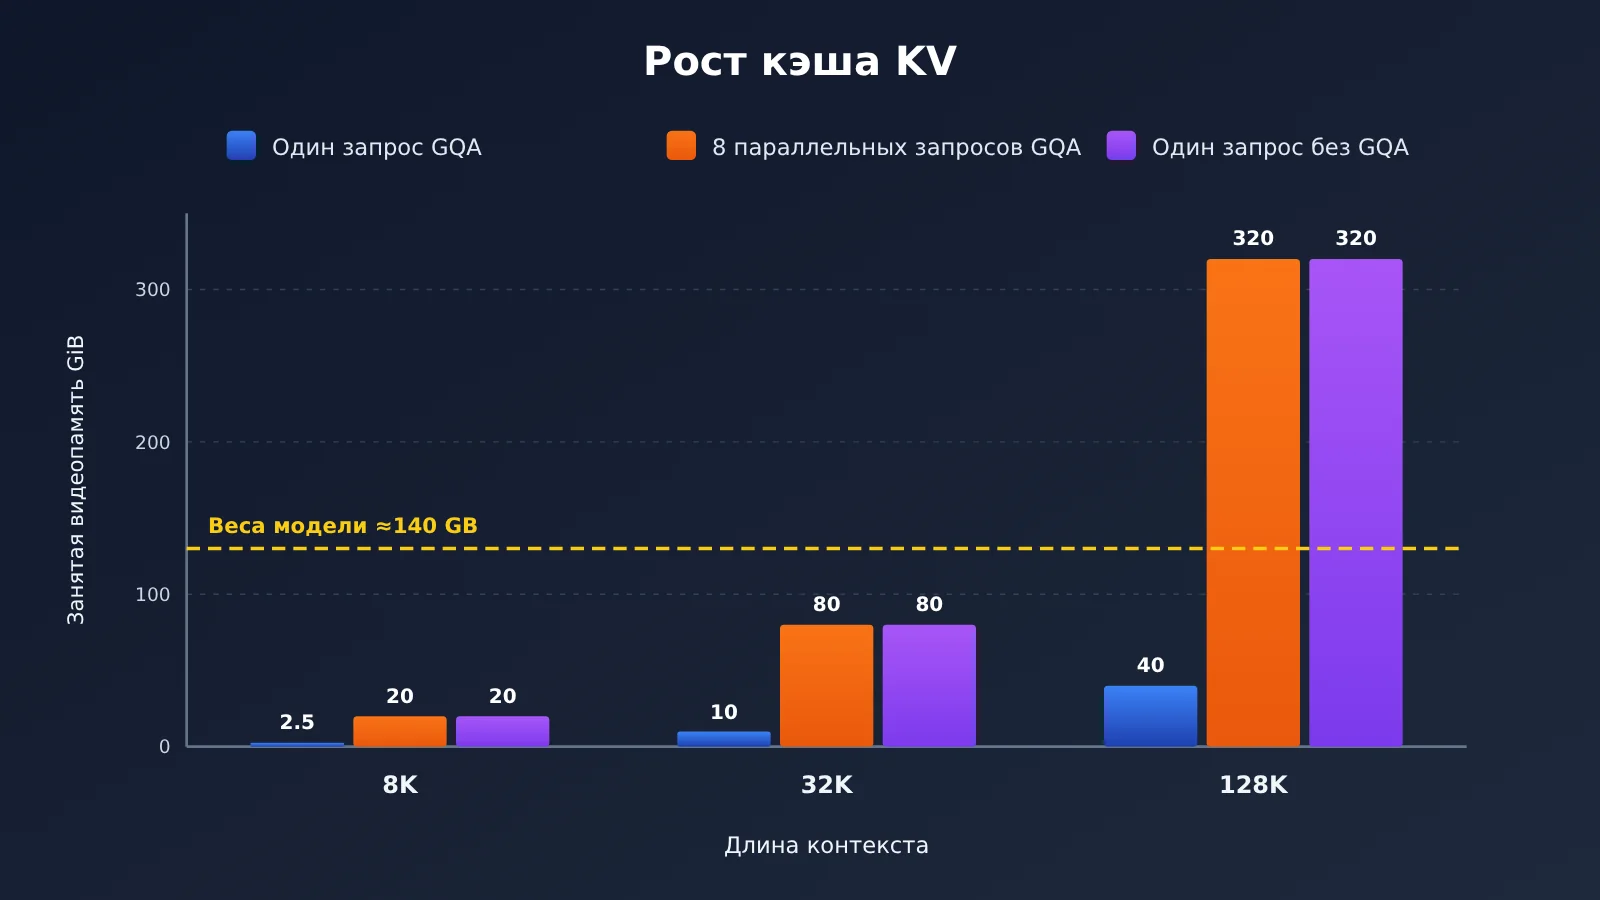
| Короткая задача | 8K | 1 | 2.5 GiB |
| Задача со средним объёмом кода | 32K | 1 | 10 GiB |
| Agent с длинным контекстом | 128K | 1 | 40 GiB |
| Несколько Agent параллельно | 128K | 8 | 320 GiB |
Здесь учитывается только KV Cache — без весов модели, рабочей памяти среды выполнения и накладных расходов из-за фрагментации. Для сравнения: веса модели с 70 млрд параметров в формате BF16 занимают около 140 GB. Иными словами, KV Cache для 8 параллельных сеансов с контекстом 128K уже более чем вдвое превышает объём весов модели.
Как GQA влияет на объём памяти для KV Cache
У Llama 3.1 70B — 64 Attention Head, но всего 8 KV Head. Это и есть GQA (Grouped-Query Attention): каждая группа из 8 Query-голов использует общую пару Key/Value. При расчёте нужно подставлять 8, а не 64, иначе результат будет завышен в 8 раз.
Ценность GQA хорошо видна на контрфактическом примере. Если бы в модели использовалось стандартное многоголовое внимание и для всех 64 голов хранились отдельные KV, KV Cache для одного запроса с контекстом 128K вырос бы с 40 GiB до 320 GiB — столько же, сколько требуется для 8 параллельных запросов с GQA. При MQA число KV Head сокращается до 1, что ещё сильнее экономит память, но может повлиять на качество модели. Дополнительно объём можно уменьшить вдвое, если квантовать KV Cache, например перейти с BF16 на 8 бит. Однако при этом нужно оценить возможную потерю точности.
Приведённый ниже скрипт можно использовать с этой формулой, чтобы быстро оценить объём KV Cache для своей модели при разной длине контекста и количестве параллельных запросов:
def kv_cache_gib(layers, kv_heads, head_dim, bytes_per_elem, tokens, concurrency=1):
    """Оценивает объём KV Cache в GiB по формуле M_KV = 2 × L × H_KV × D × B × T × N"""
    total = 2 * layers * kv_heads * head_dim * bytes_per_elem * tokens * concurrency
    return total / (1024 ** 3)

# Llama 3.1 70B: 80 слоёв, 8 KV Head, размерность 128, BF16
for ctx in (8_192, 32_768, 131_072):
    print(f"{ctx:>7} tokens -> {kv_cache_gib(80, 8, 128, 2, ctx):.1f} GiB")

print("8 并发 x 128K ->", kv_cache_gib(80, 8, 128, 2, 131_072, 8), "GiB")
print("FP8 KV 量化 128K ->", kv_cache_gib(80, 8, 128, 1, 131_072), "GiB")
Что такое стена памяти при рассуждениях агента с длинным контекстом
Ёмкость, пропускная способность и SRAM — три независимых параметра
Самая распространённая ошибка при обсуждении стены памяти — считать, что «большая память» означает «быструю память». На практике в системе памяти ИИ-ускорителя есть как минимум три независимых параметра:
| Параметр | Что определяет | Значение для агента |
|---|---|---|
| Ёмкость HBM | Сколько данных можно хранить | Сколько весов модели и KV-кэша можно держать одновременно, а значит, сколько контекстов обрабатывать параллельно |
| Пропускная способность HBM | Сколько данных можно передать за единицу времени | Успевают ли веса и KV-кэш быстро поступать к вычислительным ядрам при генерации каждого токена |
| Встроенная SRAM | Быстрая память, расположенная ближе всего к вычислительным ядрам | Можно ли хранить часто используемые данные на кристалле и реже обращаться к HBM |
HBM — это DRAM с высокой параллельностью доступа, обеспеченной многослойной компоновкой и передовой упаковкой. SRAM быстрее и расположена ближе к вычислительным блокам, но её ёмкость обходится дорого и ограничена физической площадью. Поэтому современные ускорители используют многоуровневую иерархию памяти, а не стремятся нарастить ёмкость какого-то одного её типа.
Prefill и Decode предъявляют совершенно разные требования к данным
Инференс LLM состоит из двух этапов. На этапе Prefill модель обрабатывает весь входной контекст за один раз и формирует KV-кэш. Большое количество токенов можно вычислять параллельно, поэтому это типичная задача с высокой вычислительной нагрузкой. На этапе Decode модель генерирует выходные токены по одному: на каждом шаге обрабатывается всего один новый токен, но при этом нужно прочитать все веса и весь KV-кэш. Вычислений здесь мало, зато данных приходится перемещать много, поэтому это задача с высокой нагрузкой на пропускную способность памяти.
Оценка в идеализированных условиях поможет понять нагрузку на Decode. KV-кэш для одного запроса на 128K токенов занимает около 40 GiB (примерно 43 GB), и при генерации каждого токена его нужно считывать целиком. При пропускной способности HBM около 8.6 TB/s на одном чипе TPU 8i одно только чтение KV-кэша занимает около 5 миллисекунд. При пропускной способности 17.2 TB/s у TPU 8i Max нижняя оценка составляет около 2.5 миллисекунд. Это теоретический минимум, не учитывающий чтение весов, перекрытие вычислений и параллельное разбиение данных. Но даже эта оценка показывает: чем длиннее контекст, тем сильнее время Decode зависит от перемещения данных, а не от вычислений.
Почему вычислительные блоки «ждут данные»
Когда вычислительное ядро может выполнять операции намного быстрее, чем память успевает подавать данные, вычислительный блок простаивает в ожидании — это и есть стена памяти. Для агента длинный контекст увеличивает объём данных, которые нужно считывать на каждом шаге Decode. Высокая параллельность означает, что приходится хранить больше KV-кэша, а многошаговое рассуждение требует многократно считывать и обновлять кэш. В результате предельная отдача от одного лишь увеличения пиковой вычислительной мощности постоянно снижается.
🎯 Технический совет: прежде чем оценивать своё приложение на базе агента, измерьте задержку до первого токена (TTFT) и скорость генерации при разной длине контекста. Посмотрите, как меняется задержка с ростом контекста. Через APIYI apiyi.com можно переключаться между Claude, Gemini, GPT и другими моделями с одним API-ключом — так удобнее сравнивать их работу с длинным контекстом.
Как двухчиповая компоновка TPU 8i Max увеличивает пропускную способность памяти
Как объединены два чипа TPU 8i
TPU 8i Max — четвёртая системная конфигурация TPU восьмого поколения. В Google заметили, что при одновременной работе нескольких агентов с большими кодовыми базами, длинными видео или сложными документами узким местом часто становится не вычислительная мощность, а скорость чтения и обмена данными между чипами. Решение — объединить два низколатентных чипа TPU 8i в одном корпусе и разместить в том же пространстве стойки вдвое больше кремния.
| Показатель | TPU 8i | TPU 8i Max | Изменение |
|---|---|---|---|
| Компоновка чипов | Один чип | Два чипа | — |
| Вычислительная мощность | Базовая | В 2 раза выше | Удвоение |
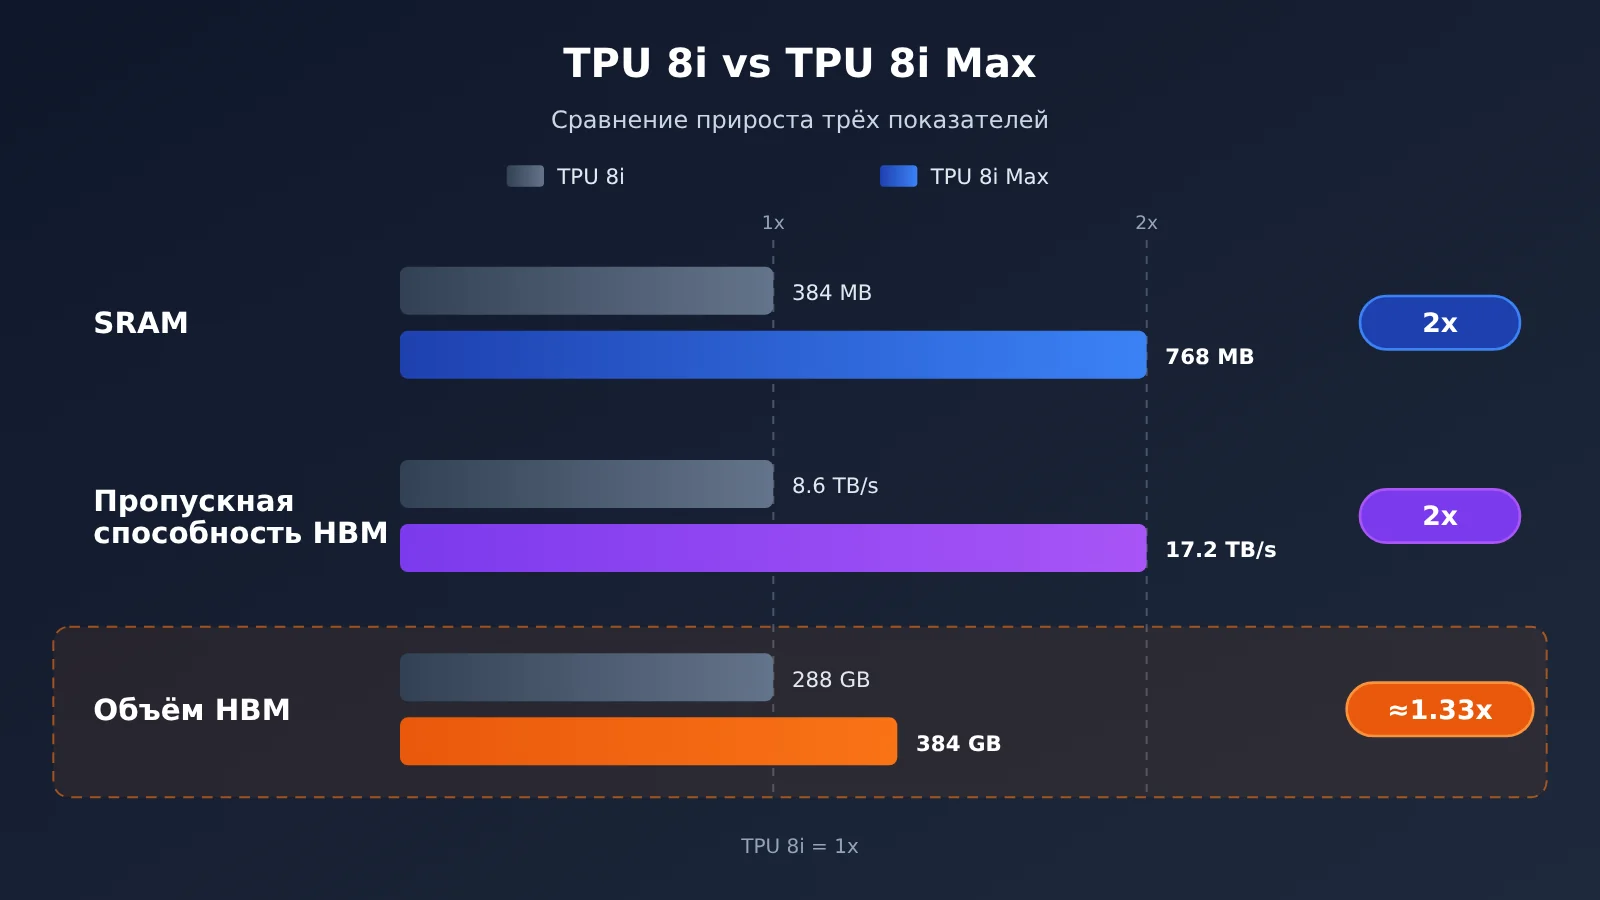
| Встроенная SRAM | 384 MB | 768 MB | Удвоение |
| Пропускная способность HBM | 8,601 GB/s | 17,200 GB/s | Примерно вдвое выше |
| Ёмкость HBM | 288 GB | 384 GB | Примерно на 33% больше |
Примечание: данные о TPU 8i взяты из технической статьи Google об архитектуре, опубликованной в апреле 2026 года. Абсолютные значения для TPU 8i Max приводит СМИ в обзоре брифинга от 9 ноября. В официальной статье о выпуске прямо подтверждено, что вычислительная мощность, объём SRAM и пропускная способность HBM удвоились.
Почему синхронное масштабирование важнее простого увеличения вычислительной мощности
Если увеличить только вычислительную мощность, на этапе декодирования система будет ещё сильнее упираться в пропускную способность памяти. Если же нарастить только пропускную способность, вычислительные блоки могут простаивать. В TPU 8i Max вычислительная мощность, объём SRAM и пропускная способность HBM увеличиваются примерно в одинаковой пропорции, поэтому соотношение «скорость подачи данных / скорость вычислений» остаётся примерно на прежнем уровне. Удвоенный объём SRAM позволяет хранить больше часто используемых данных прямо на чипе и реже обращаться к HBM.
Ёмкость HBM выросла примерно на 33%, а не вдвое
Эту деталь легче всего указать неверно. Пропускная способность HBM увеличилась примерно с 8,6 до 17,2 TB/s — вдвое, а её ёмкость выросла только с 288 до 384 GB, то есть примерно на 33%. Что это означает на практике? На каждый гигабайт памяти в TPU 8i Max приходится большая пропускная способность, поэтому чтение KV Cache одинакового размера занимает меньше времени. Но общий объём контекста, который система может одновременно «держать» в памяти, увеличивается гораздо меньше, чем пропускная способность.
Иными словами, главное преимущество TPU 8i Max — не удвоение максимального контекста одной модели, а более эффективная работа с большим числом параллельных контекстов. Если памяти не хватает, по-прежнему нужны программные методы вроде выгрузки KV Cache, квантования и распределения вычислений между несколькими чипами.
Сравнение архитектуры памяти GPU и TPU 8i Max
Чтобы понять, для каких задач предназначен TPU 8i Max, можно сравнить его с GPU NVIDIA на базе новейшей архитектуры Rubin.
| Параметр | GPU NVIDIA Rubin | Google TPU 8i Max |
|---|---|---|
| Единица сравнения | Один GPU | Упаковка с двумя чипами TPU |
| Объём HBM | 288 ГБ HBM4 | 384 ГБ HBM (по данным СМИ) |
| Пропускная способность HBM | 22 ТБ/с | 17,2 ТБ/с (по данным СМИ) |
| Память на кристалле | Зависит от конкретной конфигурации архитектуры | 768 МБ SRAM (по данным СМИ) |
| Межчиповое соединение | NVLink 6 | Сеть с низкой задержкой Boardfly (экосистема TPU 8i) |
| Программная экосистема | CUDA и популярные движки инференса | JAX, TorchTPU, бэкенды vLLM / SGLang для TPU |
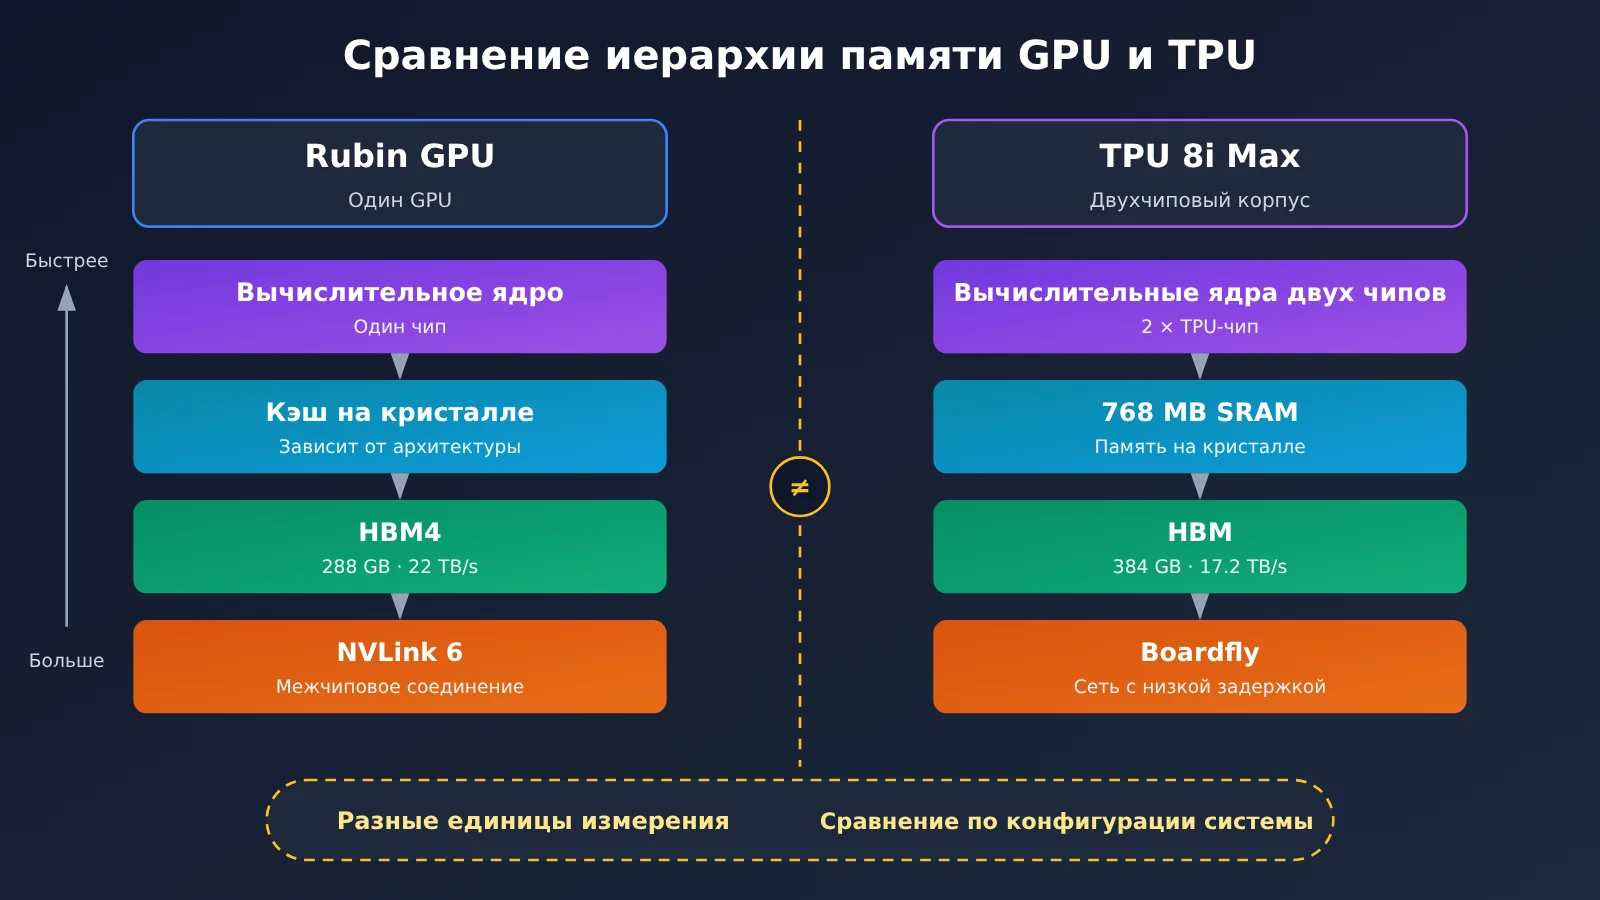
Эту таблицу не стоит использовать для простого ранжирования. В одном случае сравниваются 384 ГБ в упаковке с двумя чипами, в другом — 288 ГБ на одном GPU. Различаются поколения HBM, способы соединения чипов, вычислительные архитектуры и конфигурации целых систем. По пропускной способности один Rubin впереди, а по объёму памяти — TPU 8i Max. Но отдельно от масштаба системы эти показатели мало о чём говорят.
Гораздо важнее сравнить, сколько активных контекстов вся система способна стабильно обслуживать при одинаковых энергопотреблении, занимаемом месте в стойке и стоимости, а также какие пропускную способность, задержку и энергоэффективность она обеспечивает при их поддержке. По состоянию на 10 ноября 2026 года независимых публично проверяемых результатов тестирования TPU 8i Max ещё нет. Для такого сравнения на уровне систем придётся дождаться данных после официального коммерческого запуска.
💡 Совет по выбору: большинству команд, которые создают агентов через API, не нужно самостоятельно решать, работает ли модель на GPU или TPU. Практичнее сравнить задержку и стоимость моделей при работе с длинным контекстом. Для этого можно параллельно протестировать несколько моделей через единый интерфейс APIYI apiyi.com, используя промпты из реальных рабочих сценариев.
Как TPU 8i Max влияет на разработчиков агентных систем
Различайте контекстное окно, фактическую параллельность и задержку инференса
Заявленное контекстное окно модели показывает лишь, «сколько данных теоретически можно вместить». Оно не означает, что сервер сможет поддерживать такое же количество параллельных запросов при максимальной длине контекста, и тем более не гарантирует приемлемую задержку. Как показывают предыдущие расчёты, при одинаковом контексте в 128K KV-кэш для 8 сессий в 8 раз больше, чем для одной. Разработчикам стоит рассматривать три показателя отдельно:
- Контекстное окно: максимальный объём данных, который модель может обработать за один раз.
- Фактическая параллельность: сколько длинных сессий можно одновременно поддерживать на заданном оборудовании; этот показатель ограничен ёмкостью HBM.
- Задержка инференса: на TTFT влияет объём вычислений при Prefill, а скорость генерации токенов зависит от пропускной способности памяти и размера KV-кэша.
Три набирающих популярность метода снижения нагрузки
Аппаратное обеспечение — лишь половина решения проблемы упирающейся в память. Вторая половина — программные методы. Одновременно с этим Google открыла исходный код TPU Sync, а также версий vLLM и SGLang для TPU. Все они используют следующие технологии:
| Технология | Какую проблему решает | Издержки и нюансы |
|---|---|---|
| Выгрузка KV-кэша | Переносит временно неиспользуемый кэш из HBM в оперативную память хоста, на SSD или в общее хранилище, преодолевая ограничения по ёмкости | При восстановлении требуется время на передачу данных; необходимы эффективный DMA и асинхронная передача |
| Квантование KV-кэша | Уменьшает число байтов на элемент, снижая объём занимаемой памяти и нагрузку на пропускную способность | Нужно оценить влияние на точность |
| Разделение Prefill и Decode | Размещает Prefill, интенсивно использующий вычислительные ресурсы, и Decode, интенсивно использующий пропускную способность памяти, на разных узлах | Между узлами нужна быстрая передача KV-кэша |
| Кэширование префиксов | Повторно использует одинаковые системные промпты и предыдущие фрагменты контекста, чтобы не выполнять Prefill заново | Эффективность зависит от частоты повторения префиксов запросов |
По опубликованным Google данным о TPU Sync, задержку передачи KV-кэша можно снизить более чем на 90%, а в сценарии кэширования префикса с контекстом в 64K TTFT сокращается максимум на 90%. Однако тесты проводились на TPU Ironwood седьмого поколения, а в README на GitHub в качестве оборудования, прошедшего активную проверку, сейчас указаны v7x и v6e. Поэтому эти результаты нельзя напрямую считать показателями TPU 8i Max.
Практическая производительность и стоимость ресурсов
Для пользователей API эти низкоуровневые оптимизации в конечном счёте важны по двум причинам: насколько стабильно время задержки запросов с длинным контекстом и снижается ли стоимость, которая рассчитывается по токенам. На уровне приложения тоже можно использовать принцип «занимать меньше памяти»: сокращать системный промпт и сохранять его префикс неизменным, чтобы попадать в кеш; суммировать вывод инструментов перед добавлением в контекст; передавать субагенту только нужные ему фрагменты, а не всю историю.
В примере ниже потоковая генерация используется для измерения задержки до первого токена при разной длине контекста. Так можно увидеть, как рост контекста влияет на Prefill:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Совместимый с OpenAI интерфейс APIYI
)

def measure_ttft(context: str, model: str = "gpt-4o-mini") -> float:
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": context + "\n请用一句话总结上文。"}],
        stream=True,
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            return time.perf_counter() - start
    return -1.0

print(f"TTFT: {measure_ttft('示例代码片段 ' * 2000):.2f}s")
Показать код пакетного тестирования нескольких моделей и длин контекста
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Переключение между моделями разных провайдеров с одним ключом
)

MODELS = ["gpt-4o-mini", "claude-sonnet-4", "gemini-2.5-flash"]
LENGTHS = [1_000, 5_000, 20_000]  # Число повторов фрагмента, приблизительно увеличивающее контекст

def run_once(model: str, repeat: int) -> dict:
    context = "def handler(event):\n    return process(event)\n" * repeat
    start = time.perf_counter()
    first, tokens = None, 0
    try:
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": context + "\n指出上面代码的潜在问题。"}],
            stream=True,
            max_tokens=200,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                tokens += 1
                if first is None:
                    first = time.perf_counter() - start
        total = time.perf_counter() - start
        return {"model": model, "repeat": repeat, "ttft": first, "total": total, "chunks": tokens}
    except Exception as e:
        return {"model": model, "repeat": repeat, "error": str(e)}

for m in MODELS:
    for n in LENGTHS:
        print(run_once(m, n))
🚀 Быстрый старт: зарегистрируйтесь на APIYI apiyi.com и получите бесплатный тестовый лимит. Оставьте в скрипте
base_urlравнымhttps://api.apiyi.com/v1— и уже через несколько минут вы получите графики TTFT для нескольких моделей с контекстом разной длины.
Влияние на отрасль
- Ускорение системной кастомизации: Google быстро выпускает конфигурации для специализированных нагрузок по принципу «один и тот же кристалл — разные системы». Это показывает, что конкуренция в сфере ускорителей смещается от характеристик отдельных чипов к проектированию систем.
- Совместная разработка аппаратного и программного обеспечения становится стандартом: TPU 8i Max представили вместе с TPU Sync, Agent Compute Engine и движком инференса для TPU. Решение проблемы «стены памяти» зависит одновременно от пропускной способности аппаратного обеспечения и программного планирования.
- Коммерциализация пока на раннем этапе: TPU 8i Max, как и 8t, 8i и 8tx, имеет статус Coming soon. Публичных цен и официальной даты начала продаж пока нет, поэтому реальное соотношение цены и производительности ещё предстоит проверить.
Часто задаваемые вопросы
Вопрос 1. Что такое TPU 8i Max?
TPU 8i Max — это конфигурация системы TPU восьмого поколения, которую Google представила 9 ноября 2026 года. В одном корпусе объединены два TPU 8i. Вычислительная мощность, объём встроенной SRAM и пропускная способность HBM вдвое выше, чем у TPU 8i. Система рассчитана прежде всего на инференс с длинным контекстом, высокой параллельной нагрузкой и совместной работой нескольких агентов. Это не совершенно новый чип.
Вопрос 2. Объём HBM в TPU 8i Max увеличился вдвое?
Нет. Согласно информации из брифинга для СМИ, объём HBM вырос с 288 до 384 ГБ — примерно на 33%. Вдвое увеличились пропускная способность HBM (примерно с 8,6 до 17,2 ТБ/с) и объём SRAM (с 384 до 768 МБ). Объём и пропускная способность — разные показатели, их не стоит путать.
Вопрос 3. Можно ли уже использовать TPU 8i Max и сколько он стоит?
По состоянию на 10 ноября 2026 года на официальной странице продукта Google Cloud для TPU 8i Max указан статус Coming soon («Скоро»). Публичные цены и официальная дата общего доступа (GA) пока не объявлены. Нет и независимых тестов производительности, которые можно было бы проверить. Пока ориентироваться можно только на официальные заявления Google и параметры из брифинга для СМИ.
Вопрос 4. Позволяет ли TPU 8i Max запускать отдельные модели с контекстом в миллион токенов?
Google называет контекст в миллион токенов среди целевых сценариев применения, но это не опубликованное фиксированное ограничение максимальной длины контекста. Максимальная длина контекста в первую очередь зависит от самой модели. Аппаратное обеспечение определяет, сколько запросов можно обрабатывать параллельно при такой длине и останется ли задержка приемлемой.
Вопрос 5. Как разработчику приложения проверить влияние длинного контекста на задержку?
Проще всего измерить TTFT и скорость генерации на реальных контекстах разной длины:
1. Зарегистрируйтесь на APIYI apiyi.com, получите API-ключ и бесплатный тестовый лимит.
2. Используйте тестовый скрипт из этой статьи и задайте `base_url` равным `https://api.apiyi.com/v1`.
3. На одном и том же наборе контекстов сравните несколько моделей и посмотрите, как растёт задержка с увеличением длины.
Вопрос 6. Какие ограничения есть у квантования и выгрузки KV-кэша?
Квантование напрямую снижает нагрузку на память и пропускную способность, но может ухудшить точность — это нужно проверять на целевых задачах. Выгрузка позволяет обойти ограничения объёма HBM, однако при восстановлении данных требуется время на передачу. Если данные недостаточно быстро перемещаются между уровнями памяти, задержка может, наоборот, увеличиться. Оба подхода нужно настраивать с учётом масштаба параллельной нагрузки и целевых показателей задержки.
Ключевые выводы о длинном контексте в Agent и TPU 8i Max
- Узкое место смещается: при инференсе Agent важен уже не только объём вычислений, но и баланс между вычислительными ресурсами и подачей данных из памяти
- KV Cache растёт линейно: для Llama 3.1 70B на каждый токен приходится около 320 KiB, а один запрос с контекстом 128K занимает примерно 40 GiB
- GQA играет важную роль: при 8 KV-головах кэш занимает в восемь раз меньше места, чем при стандартном многоголовом внимании
- Decode зависит от пропускной способности памяти: при генерации каждого токена приходится полностью считывать KV Cache, поэтому при длинном контексте задержку определяет пропускная способность
- Ресурсы масштабируются синхронно: у TPU 8i Max вычислительная мощность, объём SRAM и пропускная способность HBM увеличились вдвое, а объём HBM — лишь примерно на 33%
- Не менее важно программное обеспечение: основные способы преодолеть ограничения памяти — выгрузка данных, квантование, раздельная обработка Prefill и Decode, а также кэширование префиксов
- Проверьте на практике: с помощью единого интерфейса APIYI apiyi.com можно измерить задержку длинного контекста у разных моделей
Итоги
Главное о проблеме нехватки памяти при инференсе Agent с длинным контекстом:
- Откуда возникает нагрузка: кодовые базы, результаты работы инструментов и выходные данные дочерних Agent постоянно накапливаются. При параллельной работе нескольких Agent объём KV Cache растёт ещё сильнее.
- Подход к аппаратному обеспечению: TPU 8i Max не просто наращивает вычислительную мощность — вместе с ней масштабируются SRAM и пропускная способность HBM, чтобы сохранить баланс между вычислениями и подачей данных.
- Ограничения применимости: объём HBM увеличился незначительно, а продукт ещё не вышел на коммерческий рынок. Его реальную ценность покажут только системные испытания.
Большинству разработчиков сейчас разумнее разобраться в том, как формируются затраты на KV Cache, контролировать рост контекста на уровне приложения и следить за изменениями задержки и стоимости сервисов моделей при работе с длинным контекстом. Для сравнения моделей на реальных рабочих данных рекомендуем APIYI apiyi.com: платформа предоставляет совместимый с OpenAI интерфейс и бесплатный лимит для новых пользователей.
📚 Источники
- Google Cloud Blog — Introducing TPU 8tx and TPU 8i Max: официальный технический анонс
- Ссылка:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Примечание: подтверждает использование двух чипов в одном корпусе, а также двукратное увеличение вычислительной мощности, объёма SRAM и пропускной способности HBM
-
Google Cloud — Inside the eighth-generation TPU: подробный разбор архитектуры TPU восьмого поколения
- Ссылка:
cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive -
Примечание: исходные характеристики TPU 8i и архитектура сети Boardfly
-
Google Cloud — Introducing TPU Sync: библиотека для передачи KV-кэша и весов
- Ссылка:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Примечание: многоуровневая система памяти и результаты тестирования выгрузки KV-кэша (на базе Ironwood)
-
Network World — Google targets AI’s next infrastructure bottlenecks: краткий обзор в СМИ
- Ссылка:
networkworld.com/article/4245897 -
Примечание: точные значения ёмкости HBM, пропускной способности и объёма SRAM TPU 8i Max
-
Google TPU Sync GitHub: репозиторий с открытым исходным кодом
- Ссылка:
github.com/google/tpu-sync - Примечание: информация о совместимом оборудовании и статусе разработки
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами на главной странице сайта APIYI. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com