Примечание автора: для независимых разработчиков — планирование схемы мультимодельного подключения AI Agent и Workflow в проекте одного человека по 5 этапам: разделение задач по уровням, единый интерфейс, маршрутизация с деградацией, контроль затрат, мониторинг и оценка.
Когда делаешь AI-продукт в одиночку, застрять чаще всего получается не на промптах, а на подключении нескольких моделей. Планируя Agent и Workflow, быстро упираешься в несколько вопросов: какую модель выбрать, подключать ли сразу нескольких провайдеров, как управлять ключами, как контролировать счета, что делать, когда один из сервисов начинает сбоить. В этой статье — методика планирования мультимодельного подключения «разделение задач по уровням + единый интерфейс + маршрутизация с деградацией», которая поможет в проекте одного человека сделать это и без лишней головной боли, и с запасом на рост.
Это не уменьшенная копия архитектуры большой компании. В командах есть отдельные люди, которые поддерживают шлюзы, мониторинг и сверку финансов, — у проекта одного человека таких условий нет. Все рекомендации ниже строятся вокруг одного принципа: минимальные затраты на поддержку в обмен на достаточную гибкость.
Ключевая ценность: после прочтения вы будете знать, как разбить модели по уровням для своих AI Agent и Workflow, унифицировать способ подключения, спроектировать цепочку деградации — и при этом видеть, сколько стоит каждый вызов.
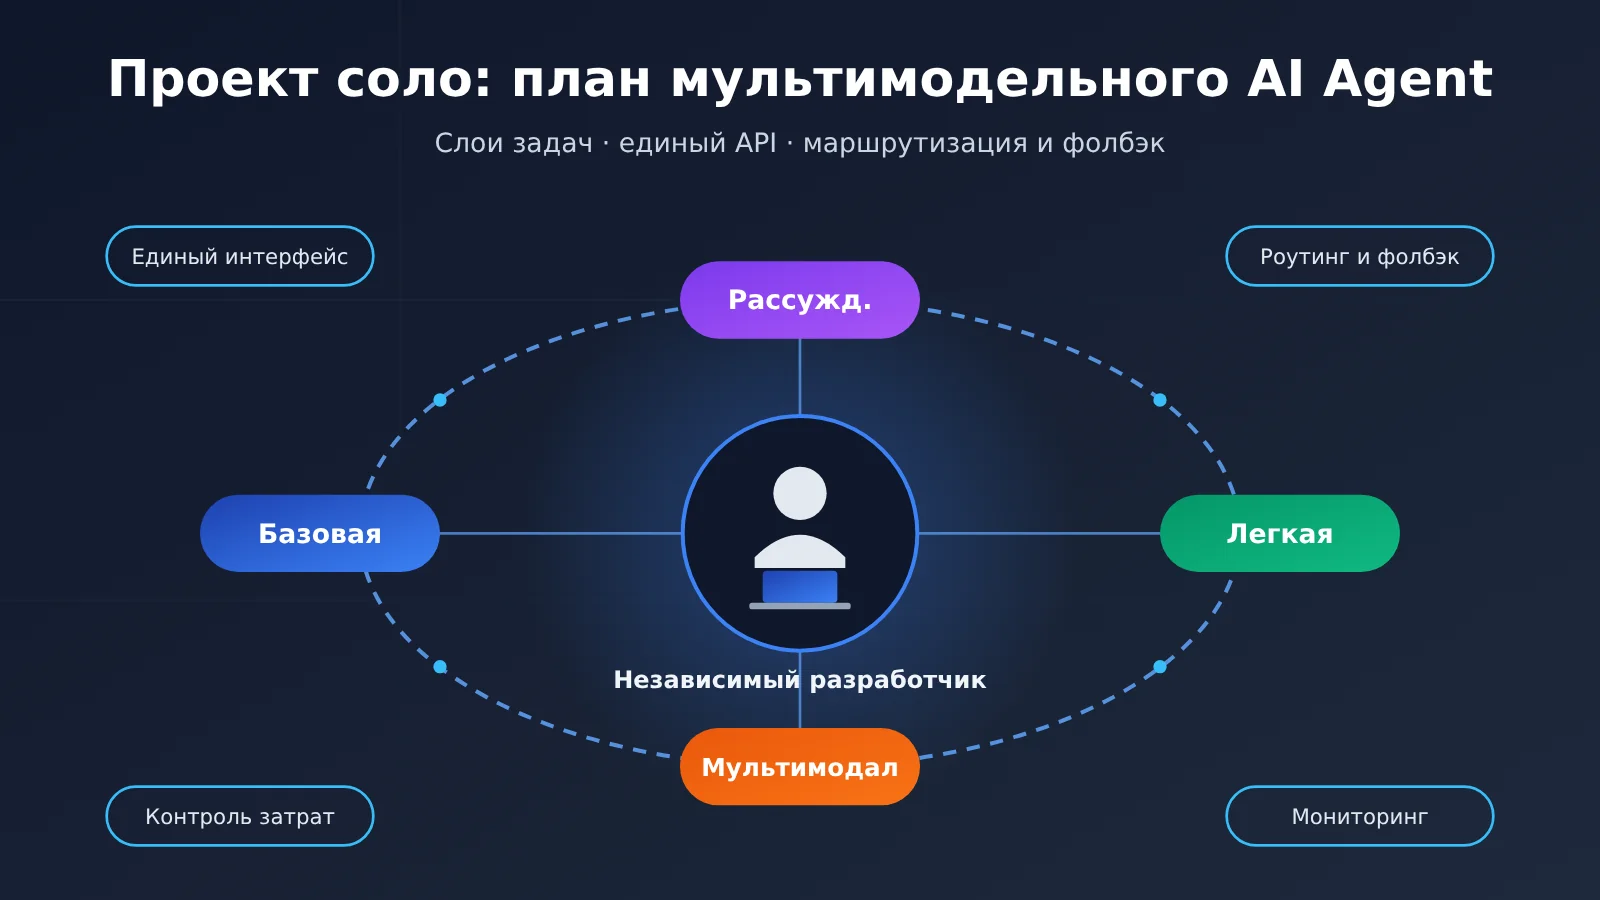
Ключевые моменты мультимодельного подключения AI-агента в соло-проекте
Прежде чем писать код, продумайте пять моментов ниже. От них зависит, чем вы будете заниматься следующие три месяца: развивать продукт или чинить интеграционный слой.
| Момент | Что это значит | Польза для соло-проекта |
|---|---|---|
| Разделение задач по уровням | Разделить вызовы в AI-агенте и workflow на 3-4 уровня по сложности и частоте | Дорогие модели используются только на ключевых участках, общая стоимость остаётся под контролем |
| Единый интерфейс | Все модели используют один формат запросов, например совместимый с OpenAI | Для смены модели меняется один параметр, бизнес-код переписывать не нужно |
| Маршрутизация и отказоустойчивость | Для каждого уровня настраивается основная и запасная модель | При сбое одного сервиса продукт не становится полностью недоступным |
| Подход к расчёту стоимости | Разделять статьи тарификации: вход, выход, кеш и т. д.; сверяться со страницей цен платформы | Чтобы счёт в конце месяца не вышел из-под контроля |
| Наблюдаемость и оценка | Записывать по каждому вызову модель, время выполнения, токены и качество результата | Менять модель по данным, а не по ощущениям |
Что важно учесть при планировании мультимодельного подключения
Разделение задач по уровням — отправная точка всего планирования. Типичный AI-агент делает много разных вещей: понимает намерение пользователя, планирует шаги, вызывает инструменты, обобщает результат и форматирует вывод. Требования к возможностям модели на этих этапах сильно различаются. Для классификации намерений и извлечения полей обычно достаточно лёгкой модели; флагманская нужна для многошагового планирования, сложной генерации кода и рассуждений по длинным документам. Если весь процесс гонять через самую сильную модель, стоимость и задержка вырастут в разы; если всё делать лёгкой моделью, на ключевых этапах легко получить ошибки. Сначала слои, потом выбор моделей — самый выгодный подход для соло-проекта.
Единый интерфейс определяет стоимость поддержки. У официальных SDK разных моделей по-разному называются параметры, отличается формат потокового ответа и структура вызова инструментов. Если подключаться напрямую к трём-четырём официальным API, придётся поддерживать три-четыре набора адаптерного кода, три-четыре аккаунта и три-четыре счёта. Для одного человека эти силы лучше направить в продукт. Практичнее выбрать агрегирующий слой доступа, совместимый с форматами OpenAI и Anthropic: бизнес-сторона знает только один протокол, а модель становится заменяемой настройкой.
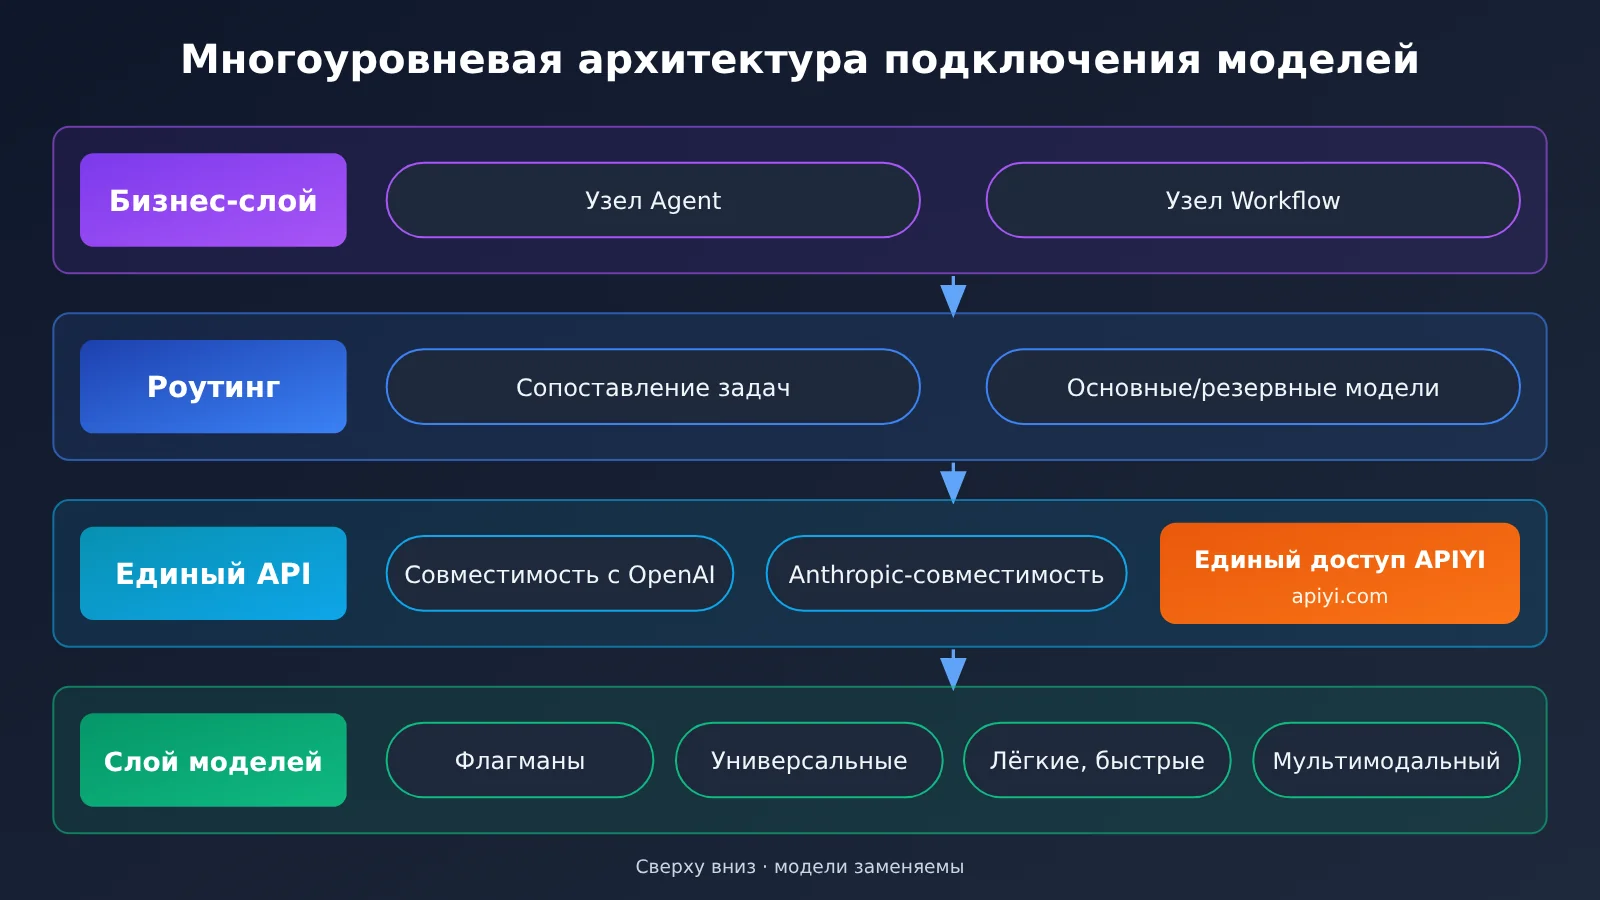
Как в AI-агенте для соло-проекта выбирать модели по уровням задач
Смысл уровней в том, чтобы делить по характеру задач, а не по названиям моделей. Ниже — четыре уровня, которые подойдут большинству AI-агентов и воркфлоу. Можно взять их как отправную точку и подстроить под свой продукт.
| Уровень | Типичные задачи | Требования к возможностям модели | Как выбирать |
|---|---|---|---|
| L1 — слой рассуждений | Многошаговое планирование, сложный код, анализ длинных документов | Глубокие рассуждения, хорошее следование инструкциям, большое контекстное окно | Флагманские или reasoning-модели, низкая частота вызовов |
| L2 — основной слой | Обычные диалоги, генерация контента, вызов инструментов | Сбалансированные возможности, стабильные вызовы инструментов | Популярные универсальные модели, на них идёт основная нагрузка |
| L3 — лёгкий слой | Классификация намерений, извлечение полей, суммаризация, переписывание | Быстрые, дешёвые, стабильный формат | Лёгкие или mini-модели, высокая частота вызовов |
| L4 — специализированный слой | Понимание изображений, генерация изображений, речь, векторизация | Способности в конкретной модальности | Выбирать отдельно под функцию, не смешивая с текстовой цепочкой |
Три принципа внедрения уровней в воркфлоу соло-проекта
Нарисовать таблицу уровней несложно. Сложнее реально следовать ей в воркфлоу. Эти три принципа помогут сэкономить время и нервы:
- По умолчанию ставьте модель ниже, поднимайте уровень только после проверки. Когда добавляете новый узел, сначала прогоните его на лёгкой модели L3; если результат не дотягивает, переходите на L2 или L1. Так вы не будете по привычке тащить самую дорогую модель во всё подряд.
- Разделяйте планирование и выполнение. «Понять, что делать» в агенте отдайте L1, а «конкретно делать» — L2 или L3. Многие фреймворки для агентов позволяют задать разные модели для планировщика и исполнителя — это самая выгодная оптимизация по соотношению цена/качество.
- Для структурированного вывода выбирайте модели со стабильным форматом. Ниже по воркфлоу часто нужно разбирать JSON, и если модель иногда добавляет лишний текст, вся цепочка падает. Для таких узлов смотрите на стабильность формата, а не только на «умность».
Стоит помнить: версии моделей обновляются быстро, поэтому в таблице выше я намеренно не привязывался к конкретным названиям. Надёжнее выбрать в списке моделей платформы по 2–3 кандидата на каждый уровень и прогнать их на своих реальных примерах, а потом решать. В списке моделей APIYI есть текстовые, reasoning- и мультимодальные модели от основных вендоров; сравнивать их можно в рамках одного аккаунта — удобно для тестов при выборе модели в соло-проекте.
Быстрый старт: мультимодельная интеграция в Workflow для проекта одного человека
В этом разделе шаги практической реализации идут по порядку. Для удобства чтения все параметры конфигурации описаны таблицами и текстом, без развёрнутого кода.
Шаг 1. Определите единый протокол подключения
Рекомендую на стороне бизнес-логики использовать единый формат Chat Completions, совместимый с OpenAI. Популярные Agent-фреймворки, инструменты оркестрации Workflow и большинство open-source проектов поддерживают его по умолчанию — совместимость с экосистемой здесь лучшая. Если вы активно используете особенности линейки Claude — например, нативную структуру вызова инструментов или кэширование промптов — можно на соответствующих узлах применять формат Anthropic Messages. APIYI одновременно совместим с интерфейсами OpenAI и Anthropic, и оба протокола могут работать с одним аккаунтом и одним ключом.
Шаг 2. Вынесите параметры модели в конфигурацию
Не вшивайте имя модели в бизнес-логику. Все параметры, связанные с моделью, стоит вынести в файл конфигурации или переменные окружения. В таблице ниже — параметры, которые рекомендуется вынести:
| Параметр | Назначение | Что делать |
|---|---|---|
base_url |
адрес интерфейса | укажите адрес подключения из документации APIYI docs.apiyi.com — единственное место во всём проекте |
api_key |
ключ аутентификации | храните в переменных окружения, для разработки и продакшена используйте разные ключи |
model |
имя модели | называйте по уровням, например MODEL_L1, MODEL_L2, MODEL_L3 |
fallback_model |
резервная модель | на каждый уровень минимум одна, желательно от другого провайдера |
timeout |
тайм-аут | для L3 ставьте короче, для L1 длиннее, чтобы рассуждающие модели не уходили в ложный тайм-аут |
max_tokens |
лимит вывода | задавайте по узлам, чтобы аномально длинный вывод не раздувал расходы |
После этого для смены модели достаточно поменять конфигурацию — логика Agent и оркестрация Workflow остаются нетронутыми.
Шаг 3. Отметьте уровни на узлах Workflow
Откройте схему оркестрации Workflow и отметьте каждый узел, который вызывает модель, уровнем от L1 до L4. Неважно, используете вы визуальный инструмент оркестрации или собственный код процесса — можно указать уровень в описании узла или в параметрах, а затем читать соответствующую модель из конфигурации. Этот шаг делается быстро, зато сразу видно, на каких узлах сосредоточены основные затраты.
Шаг 4. Настройте деградацию и повторы
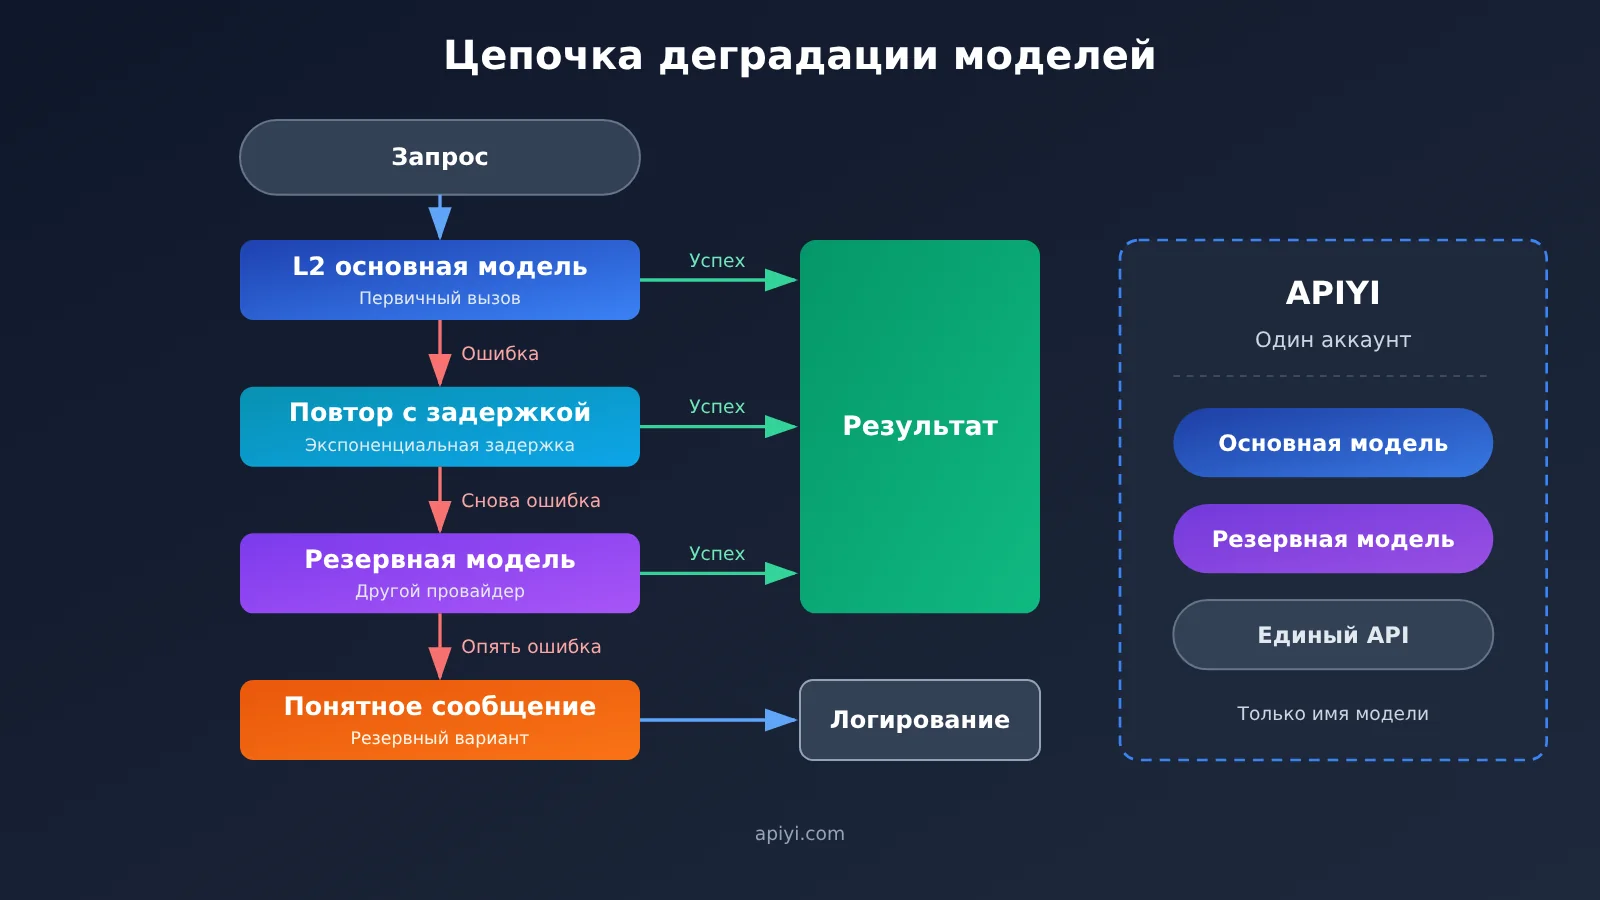
Для каждого уровня настройте порядок «основная модель → резервная модель». Если основная модель вернула ошибку лимита запросов, тайм-аут или ошибку сервера, сначала сделайте одну-две повторные попытки с задержкой, а если не помогло — переключитесь на резервную модель. Резервную модель лучше брать того же класса, но у другого провайдера: так вы обойдёте массовый сбой у одного поставщика.
Шаг 5. Логируйте каждый вызов
Как минимум фиксируйте: время, имя узла, уровень, имя модели, входные токены, выходные токены, время выполнения, был ли переход на резервную модель и итоговый успех. Достаточно простой таблицы логов или лёгкого инструмента наблюдаемости — главное, делать это регулярно.
🚀 Совет для быстрого старта: в проекте одного человека я советую сначала зарегистрироваться на APIYI apiyi.com и получить тестовый лимит, затем одним и тем же ключом прогнать реальные примеры через все модели-кандидаты от L1 до L3. Записать в конфигурацию уже после выбора — гораздо меньше хлопот, чем сначала подключить, а потом раз за разом править код.
Сравнение вариантов подключения нескольких моделей к AI Agent в проекте одного разработчика
Подключить несколько моделей можно примерно четырьмя путями, и затраты на поддержку у них сильно различаются.
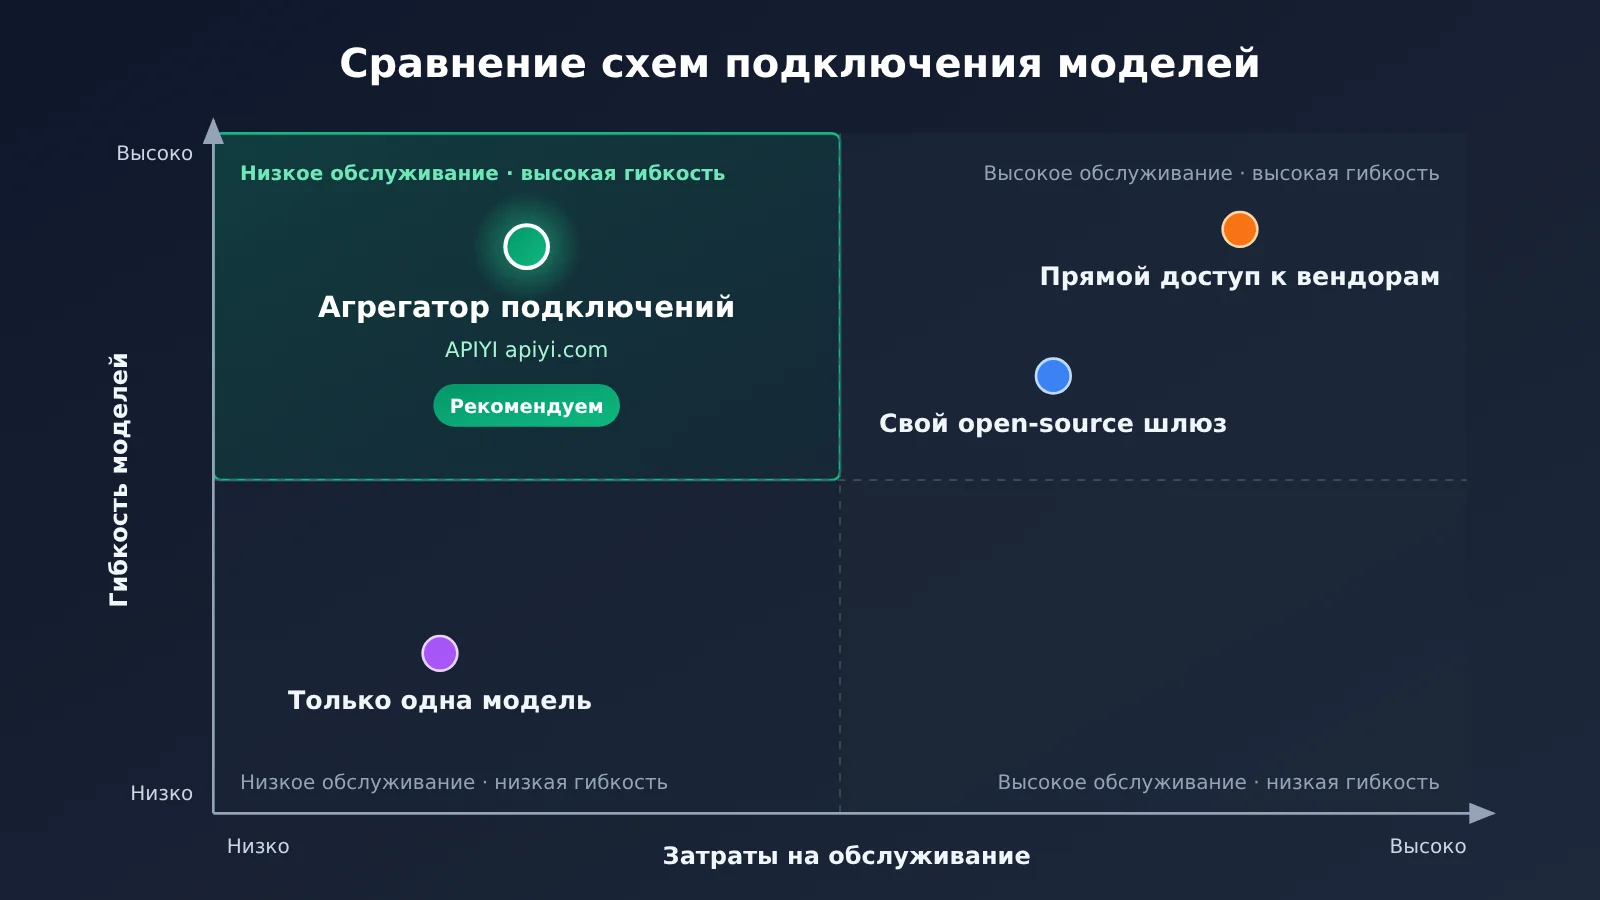
| Вариант | Ключевая особенность | Когда подходит | Нагрузка на поддержку в проекте одного разработчика |
|---|---|---|---|
| Одна модель | Один провайдер, одна модель — максимально просто | Проверка прототипа, небольшие инструменты с одной функцией | Низкая, но нет запасного варианта |
| Прямое подключение к нескольким официальным API | Отдельная интеграция с официальными API каждого провайдера | Есть глубокая зависимость от возможностей конкретного провайдера | Высокая: нужны несколько SDK, аккаунтов и счетов |
| Собственный шлюз с открытым исходным кодом | Самостоятельное развёртывание единого прокси-слоя | Есть опыт эксплуатации и нужно приватное развёртывание | Средняя или высокая: нужно самим разворачивать, обновлять и устранять неполадки |
| Агрегирующая платформа | Один интерфейс для нескольких моделей | Нужны несколько моделей, но не хочется поддерживать слой интеграции | Низкая: APIYI apiyi.com и подобные платформы дают единый интерфейс |
Сравнительный анализ вариантов подключения нескольких моделей
Сравнение с вариантом одной модели: на старте одна модель — самый эффективный путь, не нужно продумывать маршрутизацию. Но доступность и стоимость полностью зависят от одного провайдера: если он введёт лимиты или изменит цены, пространства для манёвра почти не останется. Если заранее заложить единый интерфейс и настраиваемые параметры модели, трудозатраты почти не вырастут, зато появится задел для расширения.
Сравнение с прямым подключением к официальным API: прямое подключение к официальным интерфейсам помогает быстрее подхватывать новые возможности — можно сразу использовать только что выпущенную функцию конкретного провайдера. Но поддержка нескольких наборов кода адаптеров, нескольких платёжных аккаунтов и нескольких сверок счетов постоянно съедает силы одного человека. Для большинства проектов одного разработчика реалистичнее подключаться напрямую только там, где действительно нужна уникальная официальная функция, а остальные узлы пускать через единый интерфейс.
Сравнение с собственным шлюзом: собственный шлюз с открытым исходным кодом даёт максимальный контроль и подходит для приватного развёртывания. Но развёртывание, обновления, мониторинг и разбор инцидентов ложатся на вас — по сути, вы поддерживаете ещё один сервис. Если главная цель — как можно быстрее выпустить продукт, агрегирующая платформа обычно будет более надёжной отправной точкой; а когда бизнес вырастет, можно оценить, нужен ли собственный шлюз.
💡 Совет по выбору: если сомневаетесь, начните с APIYI: прогоните через него все узлы, а на стороне приложения оставьте зависимость только от OpenAI-совместимого формата. Тогда даже при будущем переезде на собственный шлюз или прямое подключение к официальным API изменения затронут только слой конфигурации.
Контроль затрат и стабильности при подключении нескольких моделей в соло-проекте
В соло-проекте нет финансового менеджера, который следит за счетами, поэтому контроль затрат нужно закладывать в архитектуру. В таблице ниже собраны самые полезные рычаги:
| Рычаг снижения затрат | Как делать | Пояснение по тарификации |
|---|---|---|
| Понижение уровня моделей | Для узлов с высокой частотой вызовов использовать лёгкую модель L3 | Цены разных моделей заметно различаются; ориентируйтесь на страницу цен APIYI |
| Ограничение длины вывода | Задать max_tokens для каждого узла |
У большинства моделей вывод стоит дороже ввода; точные цифры — на странице цен |
| Использование кэша | Фиксированные системные промпты и определения инструментов размещать в начале запроса | Поддержка кэширования и способ тарификации кэша зависят от модели; ориентируйтесь на страницу цен |
| Сжатие контекста | Периодически суммировать многоходовые диалоги агента, не накапливать историю бесконечно | Входные токены растут линейно с числом ходов — это скрытая, но крупная статья расходов |
| Оповещения о бюджете | Считать расход токенов по дням и уведомлять при превышении порога | Сверять с логами вызовов и счётом платформы |
О ценах в этой статье намеренно нет конкретных цифр. Цена ввода и вывода, стоимость чтения и записи кэша, а также правила тарификации меняются вслед за политикой вендоров. Оценивать по памяти или старым данным легко ошибиться. Для планирования затрат ориентируйтесь на фактические данные со страницы цен APIYI docs.apiyi.com/models, оценивайте месячные расходы по формуле «среднее число вызовов в день на каждом уровне × среднее число входных токенов × цена входного токена + среднее число выходных токенов × цена выходного токена» и отдельно закладывайте колонку для попаданий в кэш.
Что касается стабильности, до запуска стоит сделать три вещи:
- Прогон цепочки деградации: вручную подставьте недопустимое имя основной модели и убедитесь, что Workflow автоматически переключается на резервную модель и штатно завершается.
- Градация тайм-аутов: рассуждающие модели думают дольше, поэтому порог тайм-аута должен быть заметно выше, чем у лёгких моделей. Иначе получится «чем умнее модель, тем чаще тайм-аут».
- Идемпотентность: вызовы инструментов с побочными эффектами — отправка писем, запись в базу данных — должны быть защищены от повторного выполнения при ретраях.
Частые вопросы (FAQ)
Вопрос 1: Что такое планирование подключения нескольких моделей в проекте одного разработчика?
Это когда в условиях независимой разработки вы заранее решаете, на каких этапах AI Agent и Workflow использовать какие модели, через какой интерфейс их подключать, как откатываться при ошибках и как считать расходы. Цель — одновременно получить и выигрыш по стоимости, и гарантию доступности, не увеличивая при этом нагрузку на поддержку.
Вопрос 2: В чём разница между AI Agent и Workflow при подключении моделей?
Шаги Workflow прописаны заранее, модель для каждого узла можно задать статически, и разбиение по уровням получается довольно наглядным. Agent сам решает, в каком порядке и сколько раз вызывать модели, поэтому объём вызовов плохо прогнозируется. Здесь тем более нужно разделять модели для планирования и для выполнения, а также задавать максимальное число раундов и бюджет токенов на одну задачу.
Вопрос 3: Нужно ли подключать несколько моделей с самого старта?
Не обязательно сразу подключать много провайдеров, но интерфейс должен быть единым с самого начала. Рекомендую уже в первой версии вынести название модели в конфиг, использовать формат, совместимый с OpenAI, и зарезервировать резервную модель для ключевых узлов. Так вы добавите совсем немного работы при разработке, зато дальше расширяться будет гораздо проще.
Вопрос 4: Для каких сценариев проекта одного разработчика лучше всего подходит подключение нескольких моделей?
— **AI-инструменты для письма и контента**: план — L1, основной текст — L2, переписывание заголовков — L3.
— **Agent умной поддержки клиентов**: распознавание намерения — L3, сложные вопросы эскалируются на L2 или L1.
— **Workflow обработки данных**: массовое извлечение и классификация — L3, аномальные примеры уходят на проверку L2.
— **Инструменты помощи в программировании**: планирование кода — L1, автодополнение и комментарии — L2 или L3.
Вопрос 5: Как быстро вызывать несколько моделей через единый интерфейс?
Можно использовать APIYI, совместимый с форматами интерфейсов OpenAI и Anthropic:
1. Зайдите на APIYI apiyi.com, зарегистрируйте аккаунт и получите API-ключ.
2. Настройте `base_url` и ключ по документации APIYI docs.apiyi.com.
3. Меняйте параметр `model`, чтобы переключаться между моделями разных вендоров — бизнес-код при этом менять не нужно.
Все упомянутые в статье reasoning-модели, универсальные, лёгкие и мультимодальные модели можно вызывать и сравнивать через единый интерфейс APIYI.
Вопрос 6: Как оценить месячные расходы на мультимодельную схему?
Сначала посчитайте по логам вызовов среднее число вызовов в день и среднее количество токенов для каждого уровня, затем сверьтесь с ценами на вход, выход и кэширование каждой модели на странице цен APIYI docs.apiyi.com/models. Не опирайтесь на цены из старых статей или по памяти — берите фактические данные со страницы цен и перепроверяйте раз в месяц.
Вопрос 7: Какие известные ограничения есть у мультимодельной схемы?
Разные модели по-разному отвечают на один и тот же промпт: после переключения на резервную модель формат вывода может слегка отличаться, поэтому парсеру на принимающей стороне нужна устойчивость к таким расхождениям. Уникальные возможности отдельных вендоров в совместимом формате могут быть доступны не полностью. Кроме того, чем больше моделей, тем больше работы по оценке, — поэтому число кандидатов на каждом слое лучше держать в пределах двух-трёх.
Ключевые выводы: подключение нескольких моделей к AI Agent в проекте одного человека
- Сначала слои, потом выбор модели: делим на L1–L4 по сложности и частоте задач, а не по названиям моделей.
- Единый интерфейс: бизнес-логика зависит только от одного протокола, а имя модели — заменяемый параметр конфигурации.
- Планирование и выполнение — раздельно: планирование для Agent — на сильной модели, выполнение — на основной или лёгкой.
- Деградацию нужно отрабатывать: основная и резервная модели — от разных вендоров; перед запуском вручную смоделируйте сбой и проверьте.
- Цены — по странице цен: все цены за единицу и тарификацию кэша сверяйте на docs.apiyi.com/models.
- Логи — основа решений: фиксируйте модель, токены, время и случаи деградации, а модель меняйте по данным.
- Начать можно с агрегатора: APIYI совместим с форматами OpenAI и Anthropic — один ключ закрывает тестирование нескольких моделей.
Итоги
Когда один человек собирает AI-агента и workflow, планирование подключения нескольких моделей сводится к трём пунктам:
- Разделение задач по уровням: пусть каждый этап использует ровно ту модель, которой достаточно — тогда и стоимость, и качество остаются под контролем.
- Единый интерфейс плюс конфигурируемость: модель превращается в заменяемый параметр, а нагрузка на поддержку остаётся в пределах, которые по силам одному человеку.
- Деградация и наблюдаемость: есть запасной вариант на случай недоступности, есть данные для решений — только так проект может долго и стабильно развиваться.
Совет: сначала прогнать все узлы через единый интерфейс, а затем, опираясь на данные логов, постепенно оптимизировать выбор моделей. Если не хочется самому поддерживать слой доступа, можно через APIYI apiyi.com вызывать популярные модели единообразно — интерфейс совместим с форматами OpenAI и Anthropic. Инструкция по подключению есть в документации APIYI docs.apiyi.com, а цены на модели и правила тарификации — на странице цен docs.apiyi.com/models.
📚 Справочные материалы
- Центр документации APIYI: адрес подключения, аутентификация и описание форматов API
- Ссылка:
docs.apiyi.com -
Пояснение: сюда заглядывайте при настройке
base_url, ключа и переключении между форматами OpenAI и Anthropic -
Страница моделей и цен APIYI: список моделей, цена за вход и выход, тарификация кэша
- Ссылка:
docs.apiyi.com/models -
Пояснение: все данные о стоимости в этой статье опираются на фактические цифры с этой страницы
-
Документация OpenAI API: справка по формату интерфейса Chat Completions
- Ссылка:
platform.openai.com/docs -
Пояснение: пригодится, чтобы разобраться с параметрами OpenAI-совместимого формата и структурой вызова инструментов
-
Официальная документация Anthropic: интерфейс Messages и кэширование промптов
- Ссылка:
docs.anthropic.com - Пояснение: на неё опирайтесь, когда в узле Claude используете формат Anthropic
Автор: техническая команда APIYI
Технический контакт: пишите нам через главную страницу APIYI — там же, в центре документации docs.apiyi.com, можно найти больше материалов по подключению