Примечание автора: в статье на трёх измерениях — сложность задачи, цена ошибки и размер контекста — показано, как выстроить маршрутизацию больших языковых моделей по уровням задач и отдавать флагманскую модель только тем запросам, которым она действительно нужна.
Многие команды, начиная работать с большими языковыми моделями, первым делом отправляют все запросы самой мощной на текущий момент флагманской модели. На этапе прототипа это нормально, но когда объём запросов вырастает, счёт начинает расти очень быстро — при этом большинство запросов вполне по силам средним и небольшим моделям. В этой статье рассказывается, как внедрить маршрутизацию больших языковых моделей по уровням задач и понять, какие запросы действительно заслуживают флагманской модели.
Это не рекламная статья в духе «дешёвые модели не хуже». У флагманских моделей по-прежнему есть заметное преимущество в сложных рассуждениях, многошаговом изменении кода и высокорисковых ответах. Маршрутизация по уровням должна решать задачу «отдать правильный запрос правильной модели», а не любой ценой снижать затраты.
Ключевая ценность: после прочтения у вас будет набор критериев для трёхуровневой классификации задач, чек-лист настройки правил маршрутизации и методика калибровки стратегии маршрутизации по данным после запуска.
Ключевые принципы многоуровневой маршрутизации больших языковых моделей по задачам
Прежде чем переходить к конкретной конфигурации, перечислим несколько ключевых критериев многоуровневой маршрутизации. Именно они определяют, на какой уровень должен попасть запрос, а также то, можно ли поддерживать стратегию маршрутизации в рабочем состоянии долгое время.
| Ключевой принцип | Описание | Польза |
|---|---|---|
| Разделять по задачам, а не по пользователям | У одного и того же пользователя запросы могут сильно отличаться по сложности, поэтому маршрутизировать нужно по признакам конкретной задачи | Не тратим ресурсы на сценарий «все запросы VIP-пользователей отправляем во флагманскую модель» |
| Стоимость ошибки важнее сложности задачи | Даже простая задача с серьёзными последствиями ошибки может требовать флагманской модели или повторной проверки | Снижаем риск инцидентов в продакшене |
| По умолчанию — средний уровень, повышение и понижение по сигналам | Основная модель обрабатывает большую часть трафика, а повышение или понижение уровня включается при выполнении определённых условий | Мало правил, просто поддерживать и откатывать |
| При неудаче можно повысить уровень | Если вывод модели нижнего уровня не прошёл проверку, автоматически повторяем запрос на уровень выше | Небольшие затраты на повторные попытки в обмен на общее качество |
| Калибровать по данным | Фиксируем успешность, долю повторов и стоимость одной задачи для каждого уровня и регулярно корректируем пороги | Стратегия маршрутизации остаётся актуальной по мере обновления моделей |
Подробно о многоуровневой маршрутизации: почему нельзя всё делать флагманскими моделями
Расстановка моделей в 2026 году делает многоуровневую маршрутизацию ещё более оправданной. Если взять публичную информацию из справочных материалов, OpenAI 24 апреля 2026 года выпустила GPT-5.5 с контекстным окном в миллион токенов; в тот же день DeepSeek представила серию V4 в двух вариантах — Pro и Flash, тоже с поддержкой контекста 1M и открытыми весами под Apache 2.0. При этом Claude Opus, Gemini 3.1 Pro, Kimi K2.6 и другие модели постепенно сокращают отставание в задачах кодирования и рассуждений.
Когда ведущие модели показывают всё более близкие результаты на распространённых бенчмарках, ключевым показателем различия становится «стоимость одной задачи». Некоторые сторонние обзоры отмечают, что оценки моделей на бенчмарках кодирования уже очень близки, а реальная разница — в том, сколько стоит выполнение каждой задачи. Другие материалы анализируют, что в сценариях агентов для кодирования вроде Claude Code большая часть расхода токенов не требует самой топовой модели. Это сторонние мнения, конкретные пропорции зависят от бизнеса, но направление ясное: использовать флагманскую модель там, где она действительно нужна, выгоднее, чем гонять её на всё.
Ещё один момент, который легко упустить, — задержка. Флагманские модели обычно думают глубже и выдают более длинные ответы, поэтому в быстрых задачах вроде классификации, извлечения данных или переписывания пользователю приходится ждать дольше. В справочных материалах упоминается, что после того, как GPT-5.5 Instant стала моделью по умолчанию в ChatGPT, длина ответов заметно сократилась, а уровень галлюцинаций снизился. Это показывает: облегчённая версия под «быстрый вопрос — быстрый ответ» — сама по себе признанное вендорами продуктовое направление.
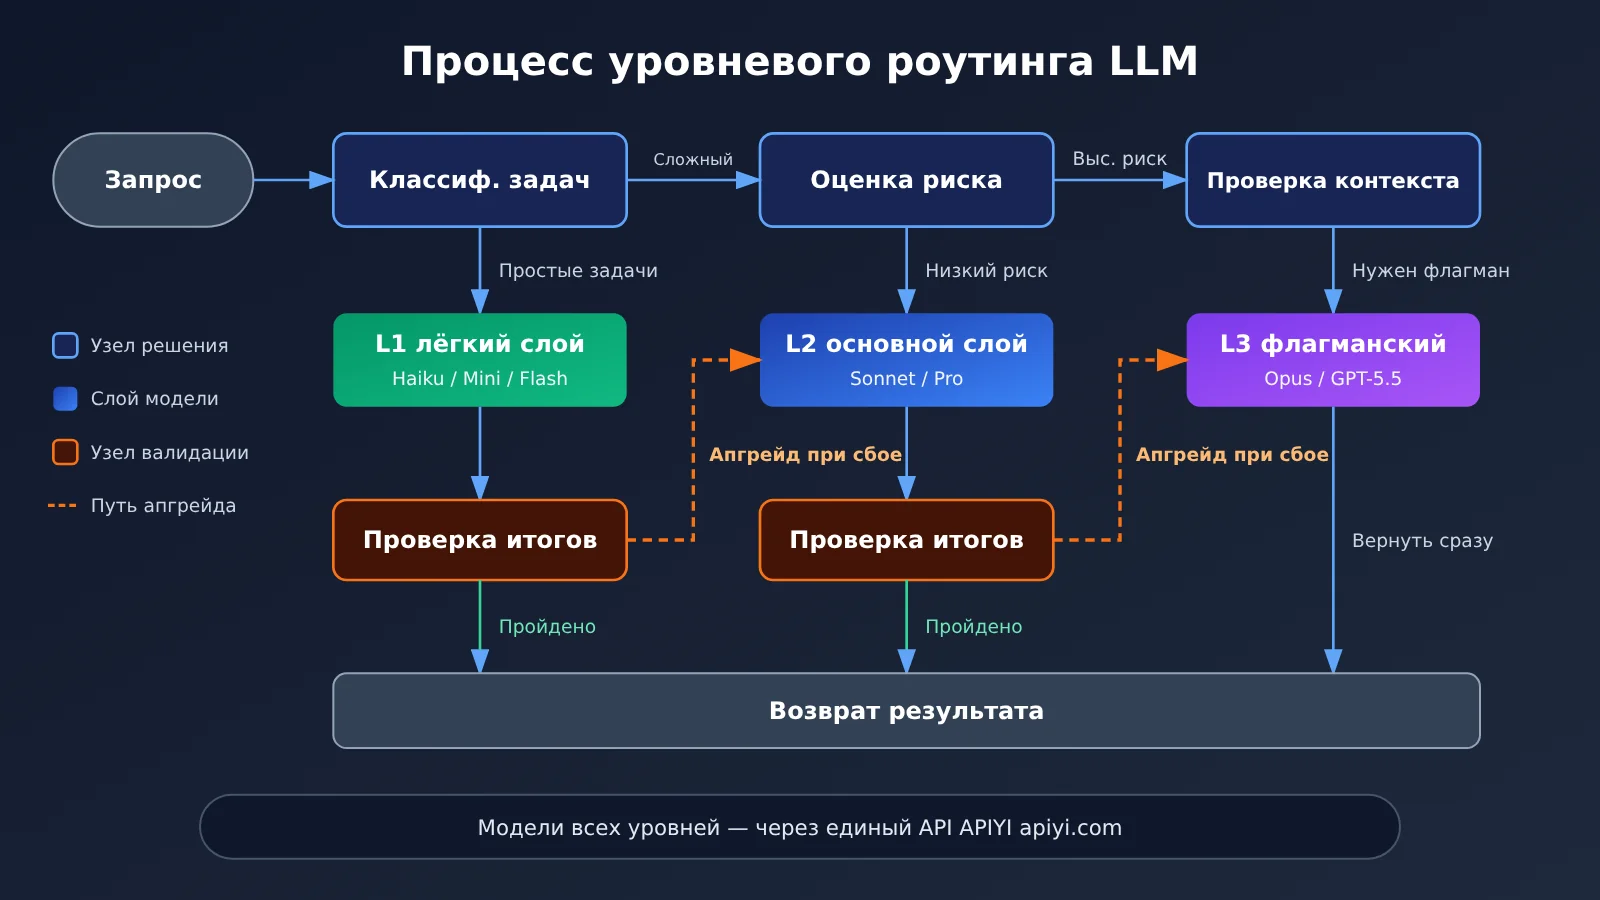
Как разбить задачи на 3 уровня при многоуровневой маршрутизации больших языковых моделей
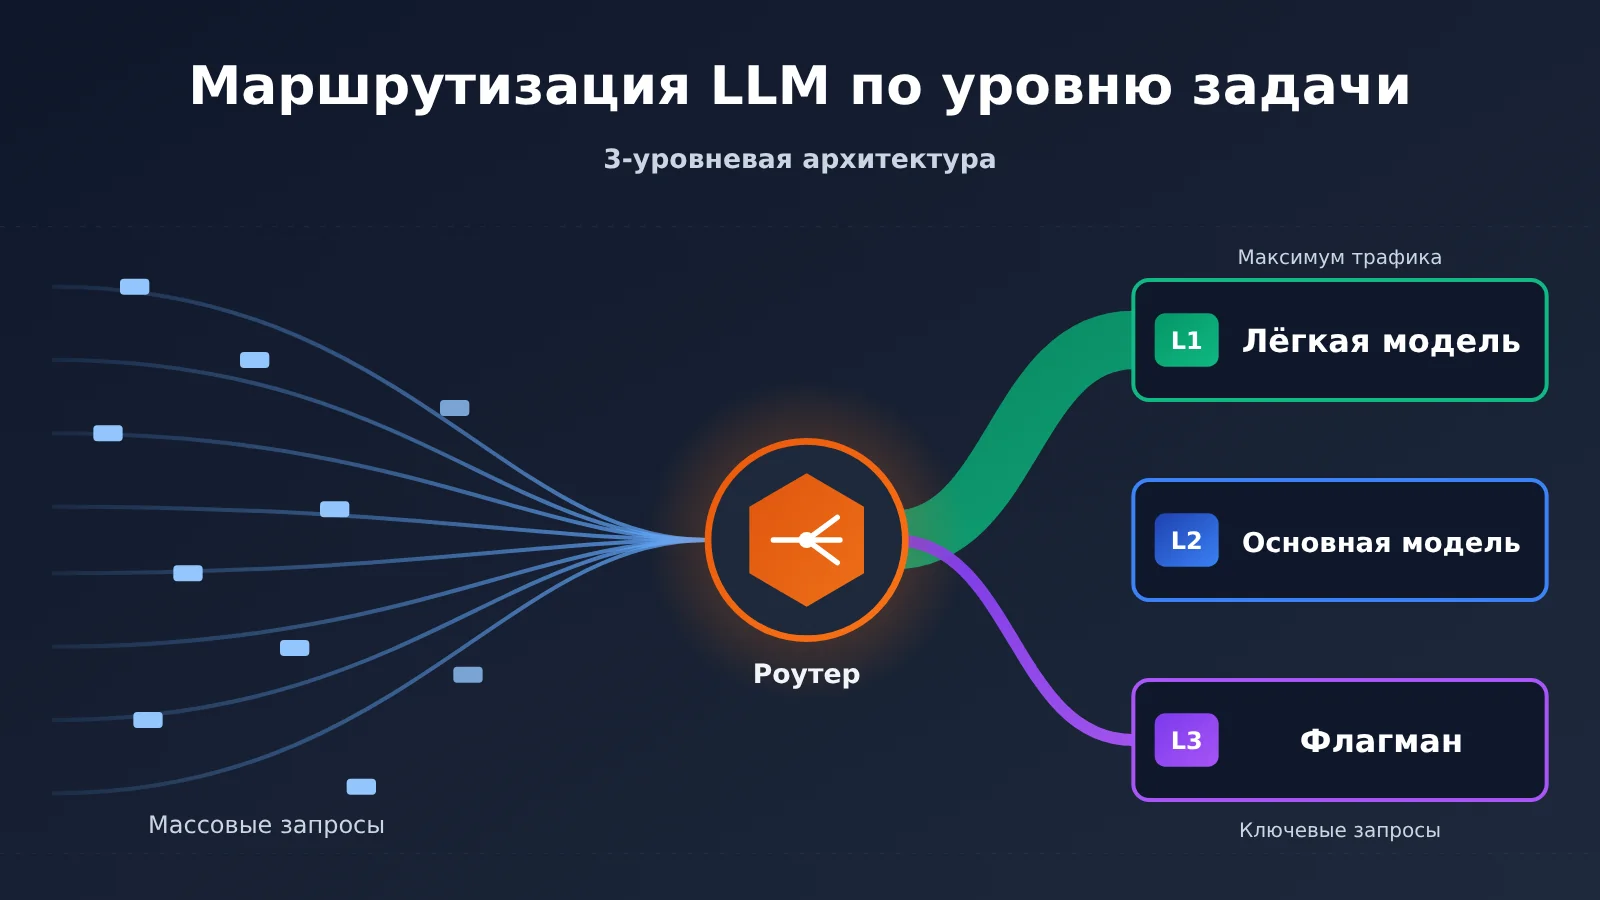
Суть разделения на уровни — подобрать для каждого типа задач модель, которая «ровно достаточна». Таблица ниже — это обобщённая схема, которую мы вывели в нескольких проектах; можете добавлять или убирать строки под свой бизнес.
| Уровень | Типичные задачи | Признаки | Рекомендуемый тип модели |
|---|---|---|---|
| L1 — лёгкий уровень | Классификация намерений, извлечение ключевых слов, преобразование форматов, переписывание коротких текстов, простые вопросы-ответы | Короткий ввод, фиксированная структура вывода, есть чёткие правила проверки | Модели уровня Haiku, Mini, Flash |
| L2 — основной уровень | Обычные диалоги, суммирование документов, генерация кода средней сложности, вопросы-ответы по RAG | Нужны понимание и умение структурировать, но ошибки можно заметить и исправить | Модели уровня Sonnet, открытые модели с большим числом параметров, универсальные модели уровня Pro |
| L3 — флагманский уровень | Многошаговые рассуждения, рефакторинг кода в нескольких файлах, проектирование архитектуры, юридические или финансовые выводы с высоким риском | Многошаговые зависимости, ошибки скрытые и дорогие, анализ сверхдлинного контекста | Флагманские модели уровня Opus, GPT-5.5 и т.п. |
Как определять задачи для лёгкого уровня L1
Ключевая особенность уровня L1 — «результат можно проверить программно». Например, при классификации интентов модель выбирает только один вариант из фиксированного набора меток, извлечение JSON можно проверить по схеме, а при преобразовании форматов — сравнить полноту полей. Если правила проверки достаточно строгие, ошибки лёгкой модели будут автоматически отсекаться и отправляться на обработку уровнем выше.
В справочных материалах есть сравнительная статья, где отмечается, что у небольших моделей вроде Claude Haiku 4.5 и GPT-5.4 Mini разные сильные стороны: первая лучше показывает себя в качестве кода, вторая выигрывает в скорости. Такие модели подходят для высокочастотного трафика с низкой сложностью и служат основным источником экономии в многоуровневой маршрутизации.
Как определять задачи для основного уровня L2
Уровень L2 берёт на себя большинство запросов, которые «требуют подумать, но не слишком сложны», и именно его рекомендуют выбирать как маршрут по умолчанию. Если поставить значение по умолчанию на средний уровень, есть два плюса: во-первых, ошибки классификатора не приведут к тому, что масса сложных запросов уедет на лёгкий уровень; во-вторых, правила повышения и понижения уровня останутся простыми.
На этом уровне стоит обратить внимание на открытые модели. В справочных материалах приводится сторонний тест, по оценке которого DeepSeek V4 Flash на задачах по кодированию с чёткими границами не сильно отстаёт от V4 Pro, а Kimi K2.6 на популярных бенчмарках по кодированию отстаёт от Claude Opus 4.6 всего на несколько баллов. Это значит, что многие задачи по кодированию, которые раньше по умолчанию отдавали флагманской модели, можно сначала попробовать на основном уровне.
Как понять, что задача действительно относится к флагманскому уровню L3
Запросы, для которых действительно стоит использовать флагманскую модель, обычно одновременно удовлетворяют как минимум двум условиям из списка:
- Длинная цепочка рассуждений: нужно многошаговое планирование и многократная проверка промежуточных выводов — например, сложная локализация багов, математические доказательства, планирование с множеством ограничений.
- Ошибки скрытые и дорогостоящие: ответ выглядит правдоподобно, но ошибки в деталях трудно заметить — например, анализ пунктов договора, расчёты по финансовой методологии, код, связанный с безопасностью.
- Сложная интеграция контекста: нужно связывать информацию между абзацами в материале на сотни тысяч токенов, а не просто находить отдельный фрагмент.
- Нижний уровень уже не справился: вывод L2 не прошёл проверку или пользователь явно сообщил, что результат непригоден.
🎯 Техническая рекомендация: для маршрутизации по уровням нужно подключать несколько моделей. Если с каждой заключать отдельный договор и отдельно адаптировать SDK, затраты на поддержку съедят выгоду от маршрутизации. APIYI apiyi.com предоставляет API-доступ к упомянутым в статье моделям серий GPT, Claude, Gemini, DeepSeek и совместим с двумя форматами интерфейсов — OpenAI и Anthropic. При смене модели обычно достаточно изменить параметр с именем модели.
Быстрый старт с многоуровневой маршрутизацией больших языковых моделей
Ниже — минимально рабочая схема многоуровневой маршрутизации, изложенная в виде чек-листа по настройке. Готовых фрагментов кода в статье нет: все ключевые параметры конфигурации собраны в таблицы, а уж как их реализовать — решайте исходя из своего фреймворка.
Шаг 1. Единый слой доступа
Основа многоуровневой маршрутизации — принцип «меняем модель, а не код». Рекомендую пропускать все запросы к моделям через одну универсальную функцию вызова: она принимает только тип задачи, содержимое сообщения и необязательный параметр переопределения уровня, а внутри уже по правилам маршрутизации решает, какую модель вызывать на самом деле.
Теперь про подключение: если в вашем проекте уже используется OpenAI SDK, можно спокойно продолжать работать через интерфейс в стиле chat completions; если Anthropic SDK — через интерфейс в стиле messages. APIYI поддерживает оба формата одновременно. Актуальные адреса подключения, способы аутентификации и список имён моделей смотрите в документации APIYI — docs.apiyi.com.
Шаг 2: Определение конфигурации правил маршрутизации
В таблице ниже собраны самые часто используемые параметры набора правил маршрутизации. Их лучше вынести в отдельный конфигурационный файл, чтобы можно было менять правила без перезапуска сервиса.
| Параметр конфигурации | Что означает | Рекомендации по выбору значения |
|---|---|---|
task_type |
Тег типа задачи: classify, extract, summarize, code, reason | Проставлять прямо на входе в бизнес-процесс — это надёжнее, чем классификация моделью |
default_tier |
Уровень, который используется, если ни одно правило не сработало | Рекомендуется L2 — основной уровень |
risk_level |
Тег бизнес-риска: low, medium, high | При high сразу маршрутизировать на L3 или добавить этап проверки |
context_threshold |
Порог количества входных токенов, при котором запускается повышение уровня | Задавать с учётом контекстных окон моделей и их поведения на длинных текстах |
validator |
Способ проверки вывода: JSON schema, регулярное выражение, юнит-тесты, повторная оценка моделью | Для уровня L1 обязателен, для L2 рекомендуется |
max_escalation |
Сколько максимум раз можно повысить уровень после неудачной проверки | Обычно 1–2 раза, чтобы не уйти в бесконечные повторные попытки |
tier_model_map |
Названия основной и резервной моделей для каждого уровня | Названия моделей — по списку моделей в документации APIYI |
Шаг 3. Настраиваем логику повышения и понижения уровня
Правила маршрутизации лучше проверять в таком порядке — чем выше правило, тем выше его приоритет:
- Если вызывающая сторона явно передала параметр переопределения уровня, используем указанный уровень — так удобнее отлаживать и вмешиваться вручную.
- Если
risk_levelравен high, запрос уходит на флагманский уровень L3. - Если длина входа превышает
context_threshold, направляем запрос как минимум на L2, а в зависимости от типа задачи решаем, не повысить ли его до L3. - Смотрим в таблицу по
task_type: задачи классификации, извлечения данных и преобразования формата уходят на L1. - Если ни одно правило не сработало, используем
default_tier. - Если вывод не прошёл проверку
validator, повышаем уровень на один и повторяем попытку — пока не упрёмся в лимитmax_escalation.
Шаг 4. Логируем ключевые метрики каждого уровня
После запуска маршрутизации нужно как минимум фиксировать по каждому запросу: уровень, имя модели, число входных и выходных токенов, попадание в кэш, был ли повтор с повышением уровня и прошла ли проверка валидатором. Эти данные — единственная опора для последующей подстройки порогов. Стратегия маршрутизации без логов настраивается только «на ощущениях».
🚀 Быстрый старт: советуем сначала прогнать в тестовой среде одну и ту же пачку реальных запросов через все три уровня — L1, L2 и L3 — и сравнить долю успешных ответов и стоимость одной задачи. Через APIYI apiyi.com можно переключаться между моделями на одном и том же наборе интерфейсов, так что такие сравнительные эксперименты делаются быстро.
Сравнение флагманских и основных моделей в маршрутизации по уровням
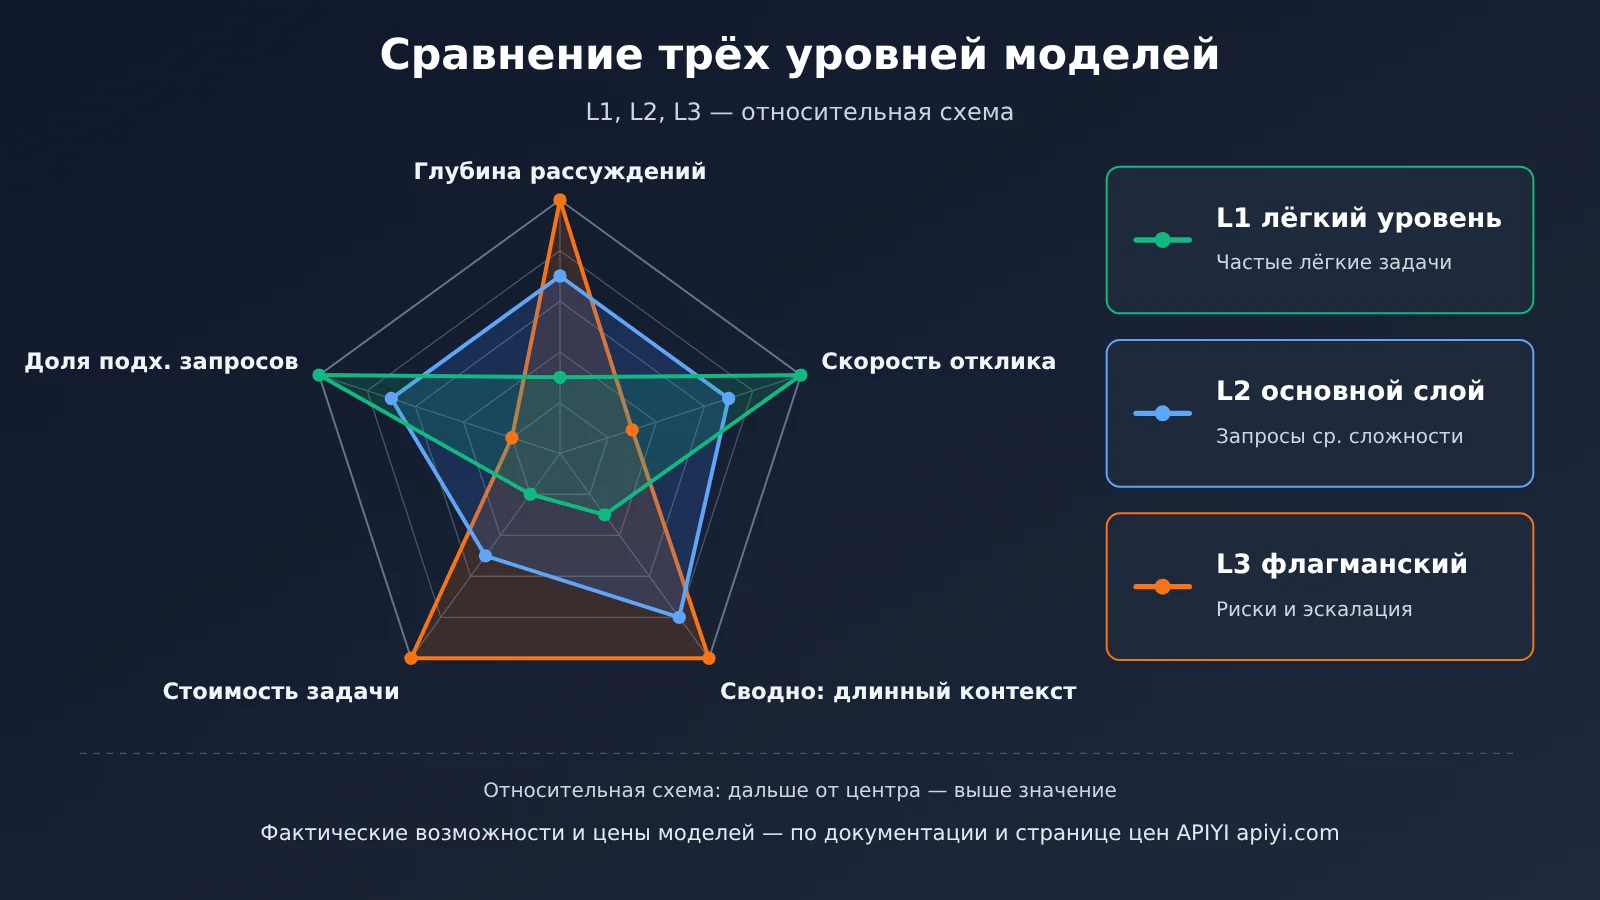
В таблице ниже основные модели, упомянутые в справочных материалах, разнесены по уровням — так проще выбрать кандидатов для каждого уровня. Позиционирование в таблице основано на публичных источниках и сторонних оценках; конкретные показатели меняются с выходом новых версий, поэтому рекомендуем перепроверить их на своих бизнес-данных.
| Модель | Типичное позиционирование | Подходящий уровень | Доступная платформа |
|---|---|---|---|
| Claude Opus 4.7 / 4.6 | Сложное программирование и многошаговые рассуждения | L3, флагманский уровень | APIYI apiyi.com, официальный API |
| GPT-5.5 | Универсальный флагман, контекст 1M | L3, флагманский уровень | APIYI apiyi.com, официальный API |
| Gemini 3.1 Pro | Рассуждения и длинный контекст, выгодное соотношение цены и качества | От L2 до L3 | APIYI apiyi.com, официальный API |
| DeepSeek V4 Pro | Открытая модель с большим числом параметров, контекст 1M | L2, основной уровень | APIYI apiyi.com, официальный API |
| Kimi K2.6 | Навыки программирования близки к флагманам | L2, основной уровень | APIYI apiyi.com, официальный API |
| DeepSeek V4 Flash | Низкая стоимость, подходит для задач с чёткими границами | От L1 до L2 | APIYI apiyi.com, официальный API |
| Claude Haiku 4.5 / GPT-5.4 Mini | Частые лёгкие задачи | L1, лёгкий уровень | APIYI apiyi.com, официальный API |
Сравнительный анализ флагманских и основных моделей
Сравнительный анализ флагманских моделей: флагманские модели вроде Claude Opus и GPT-5.5 по-прежнему лидируют в многошаговых рассуждениях, правках кода в нескольких файлах и поиске скрытых ошибок. Но у них заметно выше цена за токен и задержка ответа, поэтому использовать их для простых задач вроде классификации или переписывания текста — явное нерациональное расходование ресурсов. Зато флагманы лучше всего подходят для уровня L3: там они обрабатывают только запросы с высоким риском и эскалации после сбоев на нижних уровнях.
Сравнительный анализ открытых основных моделей: DeepSeek V4 и Kimi K2.6 хорошо справляются с обычным программированием и работой с документами; сторонние тесты показывают, что по многим задачам они уже совсем немного отстают от флагманов. Но на задачах, где нужны длинные цепочки рассуждений и много неявных ограничений, разрыв всё ещё есть. Для большинства запросов средней сложности модели основного уровня остаются более надёжным и экономичным выбором по умолчанию.
💡 Совет по выбору: какую модель брать на каждый уровень, зависит прежде всего от распределения ваших задач и требований к качеству. Рекомендуем через APIYI apiyi.com прогнать кандидатов на одном и том же наборе примеров и уже потом решать, какая модель будет основной, а какая — запасной на каждом уровне.
Методика расчёта стоимости многоуровневой маршрутизации
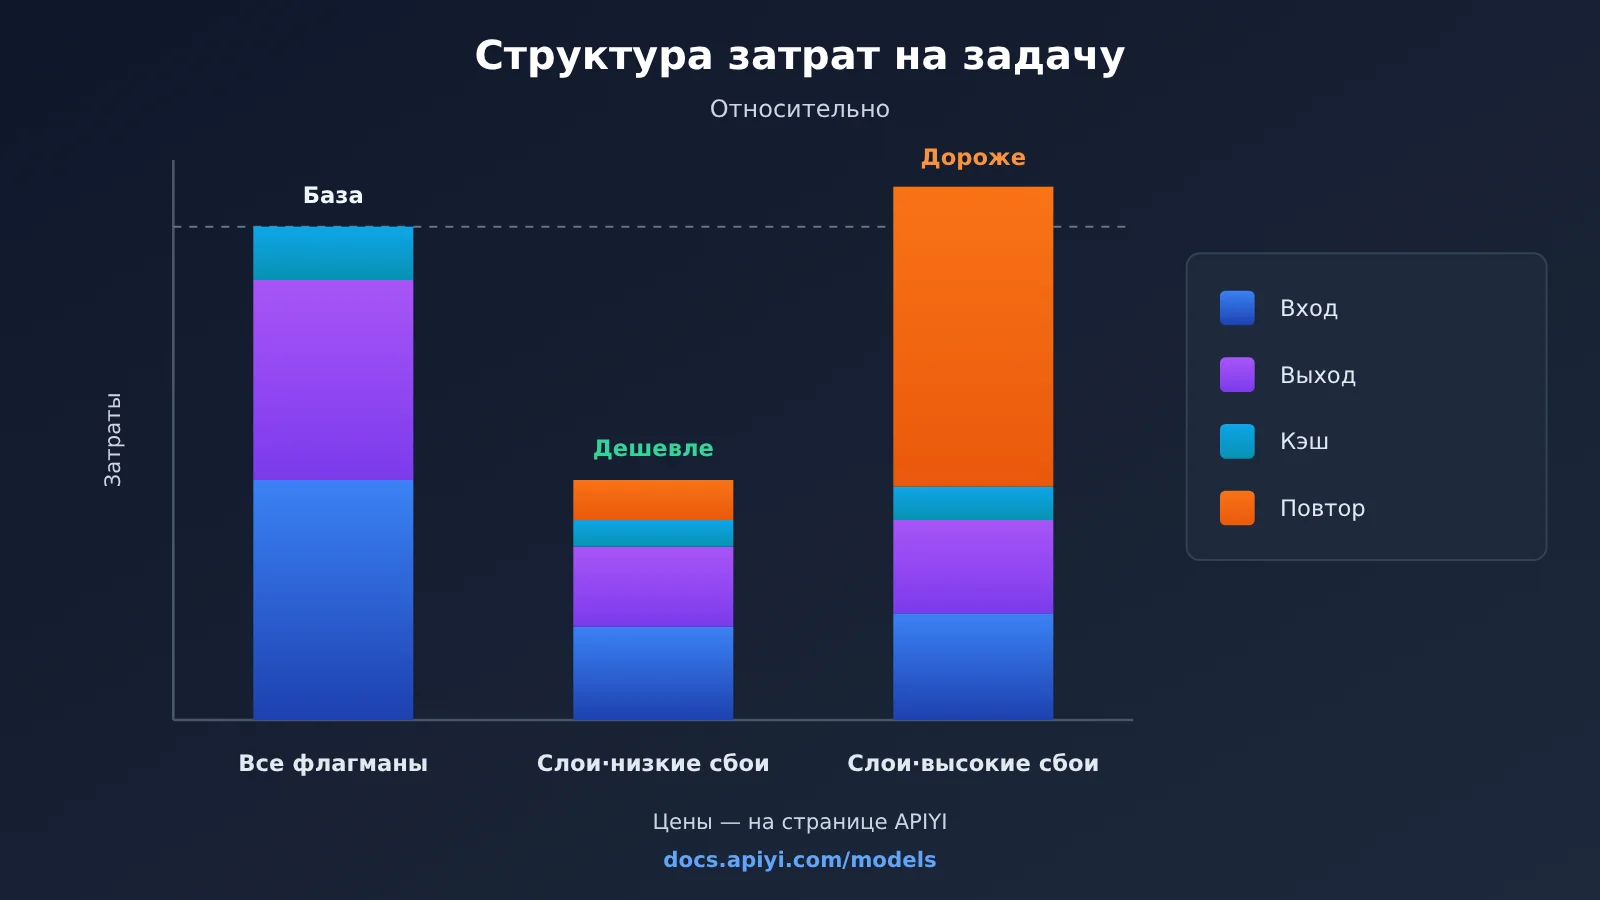
Экономит ли многоуровневая маршрутизация, нельзя понять только по цене за единицу — нужно смотреть на «общую стоимость одной задачи». Стоимость задачи обычно складывается из нескольких статей расходов, и ошибка хотя бы в одной искажает выводы.
| Статья расходов | Что входит | Источник цены |
|---|---|---|
| Входные токены | Суммарный объём промптов, контекста и истории сообщений | По фактическим данным со страницы цен APIYI docs.apiyi.com/models |
| Выходные токены | Сгенерированный моделью контент; у моделей с рассуждением сюда могут входить токены рассуждений | По фактическим данным со страницы цен APIYI docs.apiyi.com/models |
| Чтение кэша | Часть входа, попавшая в кэш промптов | По фактическим данным со страницы цен APIYI docs.apiyi.com/models |
| Запись кэша | Часть входа, впервые записываемая в кэш; некоторые модели тарифицируют её отдельно | По фактическим данным со страницы цен APIYI docs.apiyi.com/models |
| Эскалация и повтор | Все расходы на повторное выполнение на высоком уровне после сбоя на низком | Суммируются по фактическим уровням вызова |
Частые ошибки при расчёте стоимости одной задачи в многоуровневой маршрутизации
Первая ошибка — двойной учёт токенов кэша. В справочных материалах есть статья, которая специально предупреждает: при расчёте стоимости кэша нужно отдельно учитывать чтение, запись, обычный вход, выход и повторные попытки, иначе легко посчитать одну и ту же партию токенов дважды. Вторая ошибка — игнорировать стоимость эскалации и повторов. Если на уровне L1 высокая доля ошибок проверки, то стратегия «сначала попробовать дешёвую модель» может обойтись дороже, чем сразу использовать основную модель.
Поэтому для оценки того, подходит ли задача для нижнего уровня, полезно использовать простую формулу: стоимость одного прохода на нижнем уровне плюс «доля ошибок, умноженная на стоимость одного прохода на высоком уровне». Если это значение заметно ниже стоимости прямого использования высокого уровня и итоговое качество приемлемо, задачу стоит переносить на нижний уровень. Конкретные цены за единицу, цены кэша и правила тарификации по каждой модели смотрите в актуальных данных на странице цен APIYI docs.apiyi.com/models — в этой статье мы не приводим конкретные цифры.
💰 Оптимизация затрат: при расчёте стоимости лучше сразу брать цены на вход, выход и кэш для каждой модели со страницы цен APIYI, а затем вместе со своими данными из логов считать стоимость одной задачи. В рамках одной платформы правила тарификации одинаковы, поэтому при сравнении разных моделей ошибиться сложнее.
Часто задаваемые вопросы (FAQ)
В1: Что такое маршрутизация больших языковых моделей по уровням задач?
Это подход, при котором каждый запрос направляется модели с подходящим уровнем возможностей и стоимости — в зависимости от типа задачи, уровня риска и объёма контекста. Простые задачи отдаются лёгким моделям, типовые — основным, а сложные или рискованные — только флагманским.
В2: Чем уровневая маршрутизация отличается от простого «переключения на дешёвую модель»?
Простое переключение обычно означает глобальную замену, и качество падает по всему фронту работ. Уровневая маршрутизация подходит к задачам дифференцированно и включает проверку с автоматическим повышением уровня: запросы, провалившиеся на нижнем уровне, передаются более сильной модели на переработку. Так удаётся сдерживать стоимость, не переступая нижнюю границу качества.
В3: После выхода новых моделей в 2026 году нужно ли пересматривать стратегию маршрутизации?
Да, нужно. В первой половине 2026 года плотно выходят GPT-5.5, DeepSeek V4, новые версии Claude Opus и другие модели, и границы возможностей между уровнями меняются быстро. Рекомендую после каждого крупного обновления моделей прогонять фиксированный тестовый набор по всем уровням, замерять долю прохождений и уже потом решать, менять ли сопоставление уровней.
В4: Какие запросы выгоднее всего отдавать флагманским моделям?
В основном следующие категории:
— **Межфайловый рефакторинг кода и поиск сложных багов**: нужно понимать зависимости в большом объёме контекста.
— **Вывод в областях высокого риска**: например, проверка договоров, сверка финансовых формулировок, генерация политик безопасности.
— **Задачи рассуждения с множеством ограничений**: сложное планирование, взвешивание вариантов, математические выводы.
— **Запросы, уже провалившиеся на нижних уровнях**: как страховка при повышении уровня.
В5: Как быстро собрать тестовую среду для уровневой маршрутизации через API?
Рекомендую использовать агрегаторную платформу API с поддержкой нескольких моделей:
1. Зайдите на APIYI apiyi.com, зарегистрируйте аккаунт и получите API Key.
2. В центре документации APIYI docs.apiyi.com посмотрите адрес подключения и доступные имена моделей.
3. По чек-листу из этой статьи выберите по одной модели для L1, L2 и L3 и сравните долю прохождений на одной и той же выборке образцов.
APIYI совместим с форматами интерфейсов OpenAI и Anthropic, так что существующие проекты обычно подключаются почти без переделок.
В6: Если классификацию задач делать самой моделью, не вырастут ли расходы?
Небольшие дополнительные расходы будут, поэтому советую в первую очередь размечать прямо на входе в бизнес-процесс: например, «вход в чат поддержки» по умолчанию относится к определённому типу задач. И только когда по входу различить задачу нельзя, привлекать лёгкую модель L1 для классификации. Эти расходы обычно намного ниже, чем потери от ошибочного использования флагманской модели.
В7: Какие известные ограничения есть у уровневой маршрутизации?
Есть три основных момента: во-первых, правила нужно постоянно поддерживать — после обновления модели пороги могут перестать работать; во-вторых, повторные попытки с повышением уровня добавляют задержку части запросов, и для сценариев с очень высокими требованиями к реальному времени нужно искать компромисс; в-третьих, стиль вывода у разных моделей неодинаков, и продуктам, ориентированным на пользователя, может понадобиться единая постобработка. Если такие проблемы возникают, можно немного поднять уровень по умолчанию или сократить количество уровней.
Q8: На какие цены ориентироваться при многоуровневой маршрутизации?
Актуальные цены на вход, выход и кэширование для всех моделей, а также правила тарификации смотрите на странице цен APIYI: docs.apiyi.com/models. Цены в сторонних статьях могут отличаться от тарифов канала, который вы фактически используете, поэтому не стоит брать их напрямую для бюджета.
Ключевые выводы: многоуровневая маршрутизация больших языковых моделей по задачам
- Основа для уровней — задача, а не пользователь: сложность запросов одного и того же пользователя сильно различается, поэтому оценивать нужно каждый запрос отдельно.
- Цена ошибки важнее сложности: простые, но рискованные задачи тоже заслуживают флагманской модели.
- Надёжнее по умолчанию использовать основной уровень: средний уровень подстраховывает, повышение и понижение происходят по сигналам — правила простые и легко поддерживаются.
- Низкий уровень обязательно должен иметь проверку: лёгким моделям стоит доверять только те выходы, которые можно проверить программно.
- Стоимость считайте по сумме на задачу: вход, выход, кэширование и повторные попытки нужно учитывать отдельно.
- После обновления моделей нужен повторный тест: в 2026 году модели обновляются быстро, поэтому сопоставление уровней нужно регулярно пересматривать.
- Единый интерфейс снижает затраты на переключение: через APIYI apiyi.com можно вызывать модели нескольких провайдеров через один и тот же интерфейс.
Итог
Ключевые моменты маршрутизации больших языковых моделей по уровням задач:
- Три уровня: L1 обрабатывает лёгкие задачи с возможностью проверки, L2 берёт на себя трафик по умолчанию, L3 принимает только сложные, высокорисковые запросы и запросы на эскалацию.
- Приоритет правил: ручное переопределение, метки риска, длина контекста, тип задачи и уровень по умолчанию оцениваются по порядку; при сбое происходит автоматическая эскалация.
- Опора на данные: фиксируйте долю успешных прохождений на каждом уровне, долю повторных попыток и стоимость одной задачи — и настраивайте пороги по реальным данным, а не по ощущениям.
Маршрутизация по уровням вовсе не стремится к тому, чтобы «всё делать на самой дешёвой модели». Её смысл — тратить возможности флагманской модели там, где они действительно нужны. Рекомендую начать с одной-двух высокочастотных задач, отладить полную цепочку «классификация → вызов → проверка → эскалация → запись», а затем постепенно расширять её на другие бизнес-сценарии.
Для быстрой проверки схемы уровней рекомендую APIYI apiyi.com: платформа предоставляет единый интерфейс к множеству моделей. Инструкции по подключению — в docs.apiyi.com, цены — на docs.apiyi.com/models.
📚 Источники
- Список статей блога Ofox.ai (апрель–май 2026 года): охватывает выпуск и сравнение таких моделей, как GPT-5.5, DeepSeek V4, Claude Opus
- Ссылка:
ofox.ai/blog/page/35 -
Пояснение: включает сторонние аналитические материалы о маршрутизации гибридных моделей и расчёте стоимости кэширования; в этой статье используются только фактические сведения из них
-
Список статей блога Ofox.ai (выпуск и оценка моделей): охватывает GPT-5.5 Instant, бенчмарки основных моделей и сравнение стоимости одной задачи
- Ссылка:
ofox.ai/blog/page/36 -
Пояснение: подойдёт, чтобы понять публичное позиционирование основных моделей 2026 года
-
Список статей блога Ofox.ai (малые и открытые модели): охватывает лёгкие и открытые модели вроде Claude Haiku, GPT-5.4 Mini, Llama 4
- Ссылка:
ofox.ai/blog/page/37 -
Пояснение: пригодится при выборе моделей-кандидатов для уровней L1 и L2
-
Центр документации APIYI: адреса подключения, форматы интерфейсов и описание названий моделей
- Ссылка:
docs.apiyi.com -
Пояснение: сверьтесь перед подключением к интерфейсам, совместимым с OpenAI или Anthropic
-
Страница цен моделей APIYI: данные по тарификации входа, выхода и кэширования для каждой модели
- Ссылка:
docs.apiyi.com/models - Пояснение: все расчёты затрат в этой статье основаны на фактических данных с этой страницы
Автор: техническая команда APIYI
Техническая связь: будем рады обратной связи — свяжитесь с нами на главной странице сайта APIYI apiyi.com, а больше материалов по подключению найдёте в центре документации docs.apiyi.com