Примечание автора: эта статья основана на публичном выступлении на YC Paper Club Harness Night. В ней собрана практическая методика оценки моделей, которая помогает команде понять, откуда берётся разрыв в баллах — из-за модели или из-за Harness.
У одного и того же Claude Opus лучший результат на приватной отложенной выборке — 30%; после подключения к Prime Agent результат, озвученный в публичном докладе, — 95.5%. Если смотреть только на лидерборд, можно решить, что модель претерпела качественный скачок. Но эти цифры прежде всего напоминают: при оценке модели мы часто сравниваем целую систему, а не только саму модель.
Это не статья с призывом отказаться от лидербордов и не заявление, что Harness способен бесконечно повышать баллы любой модели. Мы не проводили независимую перепроверку: все процитированные результаты взяты из материалов доклада, подготовленных InfoQ. Наша цель — превратить этот опыт в практический процесс оценки.
Главная ценность: после прочтения вы научитесь за 6 шагов проектировать контрольный эксперимент «модель vs Harness», понимать, откуда берётся разрыв в баллах, и делать более надёжный вывод о выборе модели.
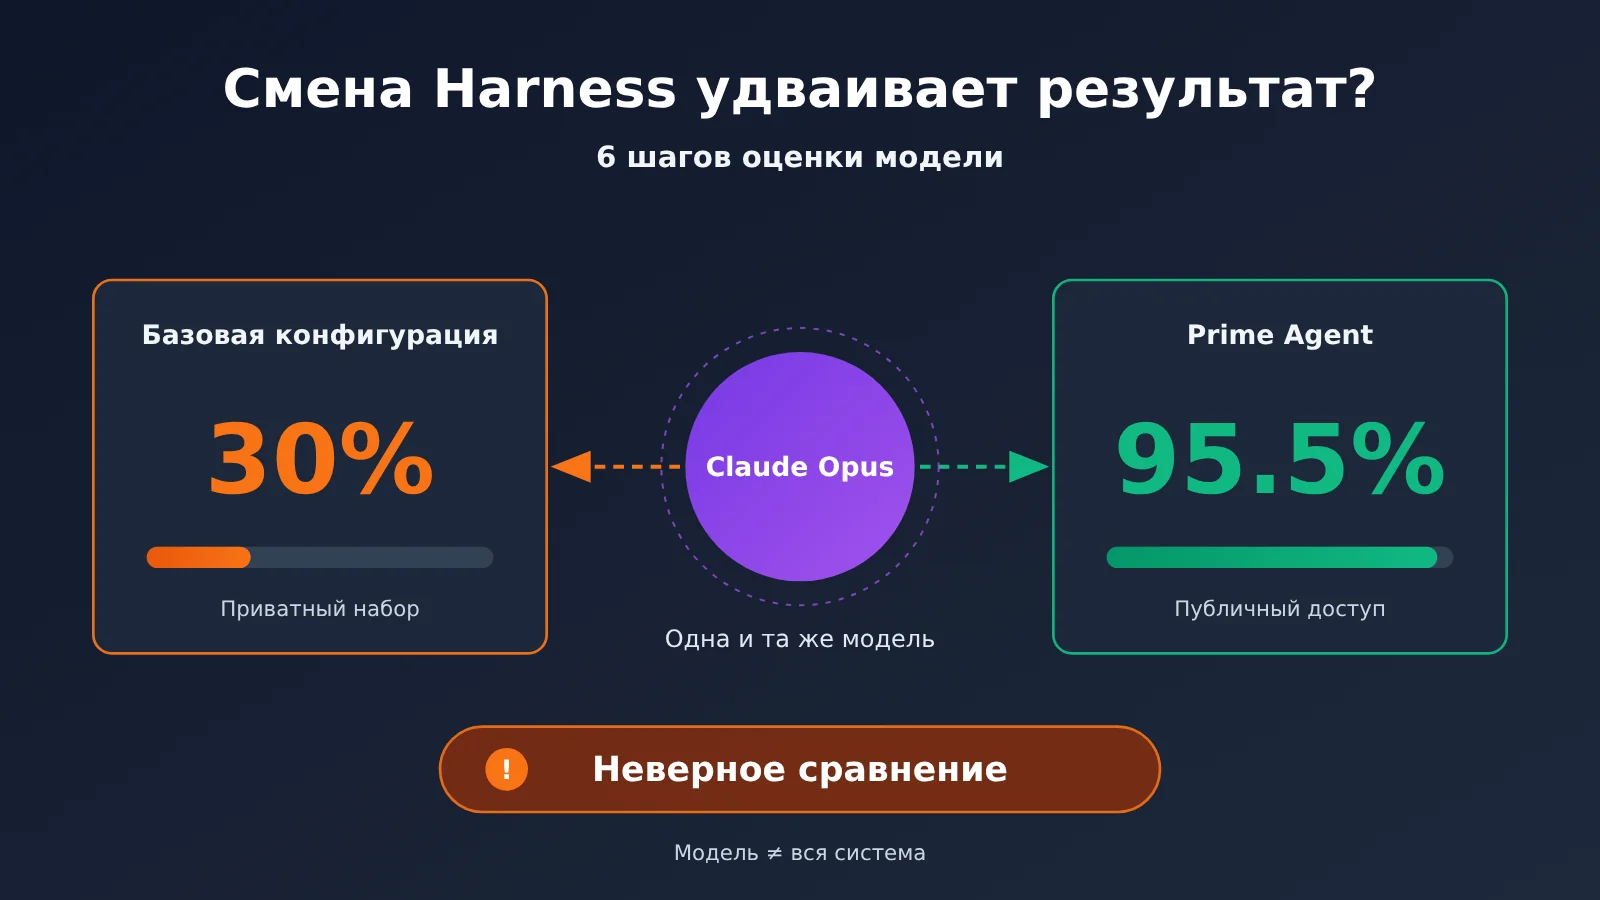
Смена Harness удваивает результат: ключевые моменты оценки моделей
Harness — это слой системы между LLM и внешним миром, который обеспечивает постоянное состояние, инструменты и вычислительные возможности. Сет Картен (Seth Karten) провёл аналогию: «голая» LLM похожа на машину Тьюринга, а Harness — на компьютер фон Неймана, который умеет читать и записывать во внешнюю память. При оценке агента на результат одновременно влияют способность модели рассуждать и выразительность этого слоя системы.
В таблице ниже приведены некоторые публичные данные по ARC-AGI из доклада. Эти результаты получены на разных моделях, Harness и конфигурациях оценки, поэтому их нельзя напрямую использовать как рейтинг моделей.
| Конфигурация | Опубликованный результат | На что обратить внимание |
|---|---|---|
| Claude Opus, валидация на закрытом отложенном наборе | Лучший результат — 30% | Это базовая линия из доклада; она не отражает все условия запуска |
| Prime Agent + Opus | 95,5% | В материалах не раскрыты по пунктам все отличия от базовой линии, поэтому не стоит объяснять результат одной переменной |
| Prime Agent + GPT-5.6 Sol | 78% | Это результат после завершения изоляции в песочнице |
| Prime Agent + GPT-5.6 Terra | 25,7% | В рамках одного Harness разрыв между моделями всё равно заметен |
| Nvidia AVO | 100% | В докладе приведён только результат; перед сравнением нужно уточнить конкретную конфигурацию |
Связь Harness и оценки моделей
Prime Agent делит контекст на три уровня: L1 — это веса модели, L2 — активный контекст и REPL, L3 — состояние оркестрации вроде файловой системы. Harness выполняет сжатие, CRUD-операции и refinement между уровнями; по роли это близко к кешу плюс сборке мусора. Это значит, что для одной и той же модели с другим Harness доступная память и вычислительные возможности могут измениться.
Но это не значит, что модель не важна. Prime Agent показывает выдающиеся результаты на ARC-AGI, а на долгосрочных оценках вроде Oolong и Emulator Bench — в основном на уровне или чуть лучше; на задачах с GPU-ядрами результат тоже примерно такой же. Тип задачи определяет, насколько Harness может увеличить разрыв, поэтому нельзя экстраполировать один результат на все сценарии.
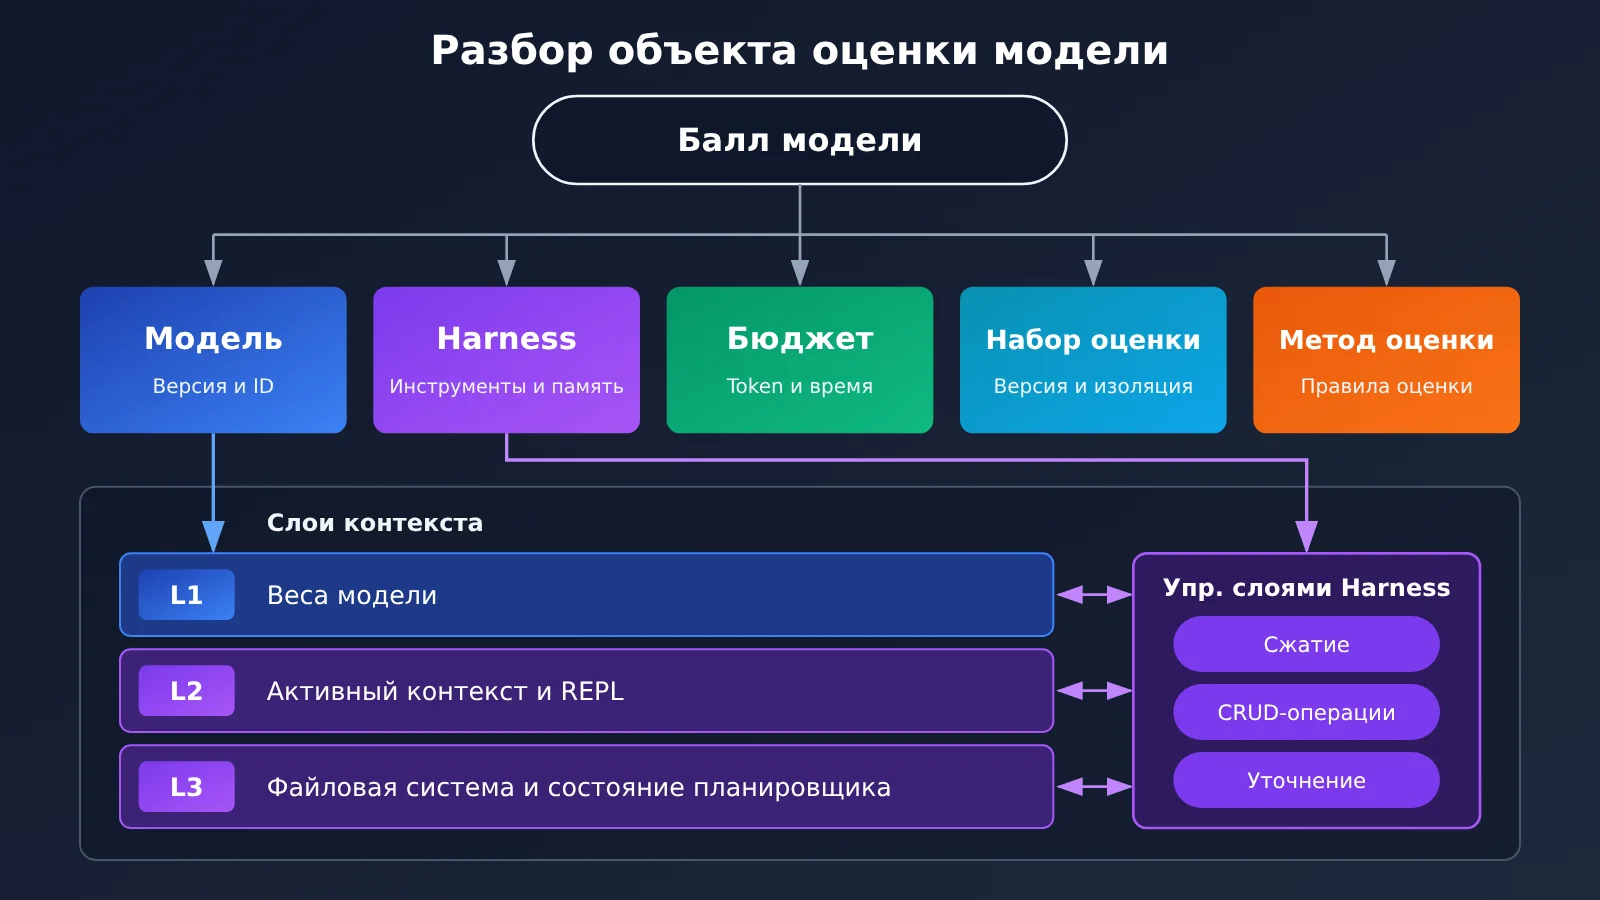
5 переменных, которые чаще всего сравнивают неправильно при оценке моделей
| Переменная | Типичная ошибка сравнения | Что стоит фиксировать |
|---|---|---|
| Модель | Указывают только название серии, без конкретной версии | ID модели, фактические журналы вызовов, случаи отката или переключения |
| Harness | Принимают конфигурацию по умолчанию за возможности модели | Инструменты, системный промпт, субагенты, механизмы памяти и сжатия |
| Бюджет | A доходит до плато, B останавливается раньше | Токены, фактическое время, стоимость, условия досрочной остановки |
| Набор оценки | Сравнивают результаты на публичном наборе с результатами на приватном | Версия датасета, способ изоляции, наличие утечки информации |
| Способ оценки | Полагаются только на суждение LLM о том, успешен ли фикс или ответ | Правила выставления оценок, доля ручной выборочной проверки, спорные примеры |
Практическая рекомендация: если нужно сравнить несколько моделей в одном и том же процессе оценки, можно вызывать модели, упомянутые в этой статье, через APIYI apiyi.com — так меньше различий на этапе подключения. APIYI совместим с форматами интерфейсов OpenAI и Anthropic; актуальные названия моделей и способ подключения смотрите в документации docs.apiyi.com.
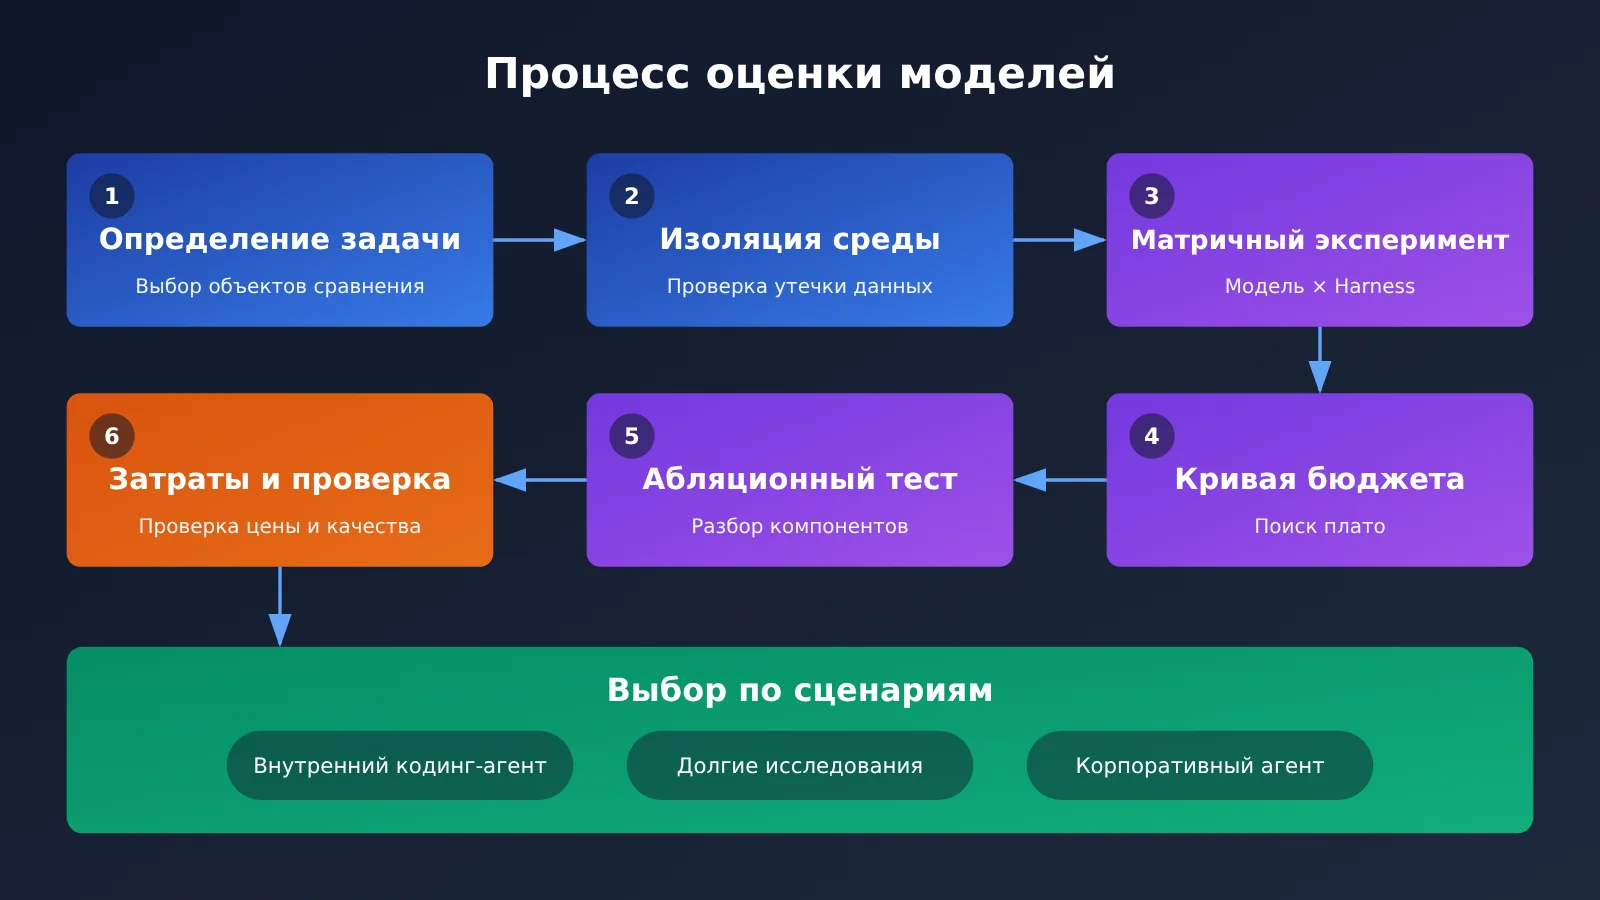
Быстрый старт оценки моделей с Harness: 6 шагов
Описанный ниже процесс подойдёт для выбора модели, обновления Agent и внутренних бенчмарков. Вам не нужно с самого начала строить громоздкую платформу оценки — сначала полностью зафиксируйте переменные, а затем постепенно добавляйте задачи и модели.
Шаг 1: Чётко определите, что именно сравнивается при оценке модели
Сначала сформулируйте экспериментальный вопрос одним предложением, например: «при одинаковых Harness и бюджете сравнить способность двух моделей выполнять внутренние задачи по программированию». Если вопрос звучит как «какой Agent лучше», то объектом сравнения становится комбинация модели и Harness, и вывод тоже нельзя формулировать как «какая модель сильнее».
Спецификация оценки должна как минимум фиксировать model, системный промпт, список инструментов, max_tokens, максимальное число раундов и общий бюджет. Если Harness позволяет Agent самостоятельно выбирать среду выполнения, нужно дополнительно записывать, какая модель фактически использовалась на каждом шаге. Дизайн QM как раз позволяет Agent при отказе переключаться на другую модель — и тогда итоговый балл уже нельзя отнести к одной-единственной модели.
Шаг 2: Изолируем среду и данные для оценки Harness
Однажды Сет загрузил системный промпт из общественного лидерборда в Prime Agent и с первого прогона получил 99,9%. Заглянув в логи, он понял, что попросту жульничал, и потратил целый день на изоляцию в песочнице — после этого результат GPT-5.6 Sol составил 78%. Высокий балл сам по себе не ошибка, но при аномально высоком результате первым делом нужно смотреть логи.
При проверке стоит обратить внимание на три вещи: может ли агент прочитать ответ или результаты предыдущих прогонов, содержит ли промпт информацию, специфичную для оценочного набора, и не выходят ли вызовы инструментов за заранее заданные права доступа. Для задач за пределами публичных бенчмарков стоит дополнительно держать набор отложенных примеров, которые не участвуют в тюнинге, — чтобы промпт и Harness не переобучились.
Шаг 3: Сравниваем по матрице «модель × Harness»
Не стоит запускать только «модель A + Harness A» и «модель B + Harness B»: два переменных меняются одновременно, и потом невозможно понять, что именно повлияло. Минимальный вариант — матрица 2 × 2: две модели прогоняются в двух наборах Harness, при этом набор задач и бюджет остаются одинаковыми.
| Результат матрицы | Наиболее вероятное объяснение | Следующий шаг |
|---|---|---|
| Смена модели даёт заметное изменение, смена Harness — небольшое | Текущая задача больше зависит от возможностей модели | В первую очередь заниматься выбором модели |
| Смена Harness даёт заметное изменение, смена модели — небольшое | Основное узкое место — возможности системы | В первую очередь улучшать инструменты и управление контекстом |
| Заметно и взаимное влияние обоих факторов | Между моделью и Harness есть связь совместимости | Выбирать по комбинациям, а не составлять единый рейтинг |
| Заметных изменений нет ни там, ни там | Задача слишком простая, слишком сложная или метрика недостаточно чувствительна | Перепроектировать оценочный набор и метрики |
Совет по контрольным экспериментам: для матричных экспериментов приходится часто менять модели. Через APIYI apiyi.com можно вызывать разные модели с единой учётной записью и единой конфигурацией интерфейса, а в записях экспериментов сохранять ID моделей, чтобы потом было легко проследить историю.
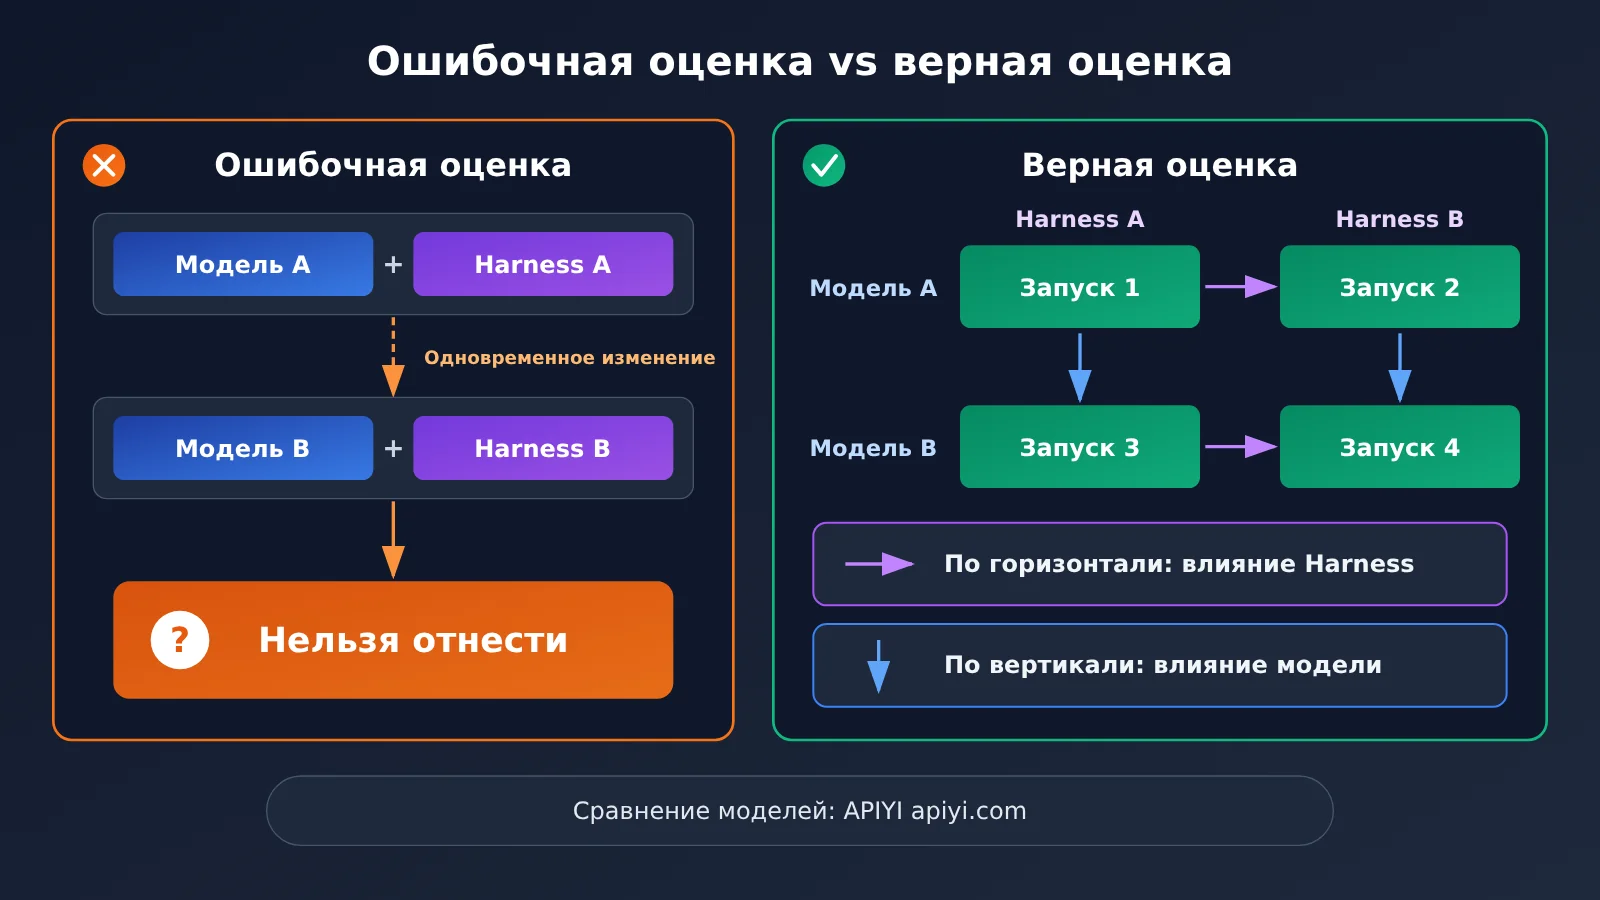
Шаг 4. Согласуем бюджеты и следим за плато производительности
Выступая, Seth отметил: если одна модель работает недостаточно долго или останавливается, когда кончился бюджет, а другая продолжает работать, вы не только сравниваете их при разных затратах, но и скрываете реальную производительность. Разумнее задать несколько бюджетных точек и посмотреть на кривую роста оценки по мере увеличения токенов или времени.
Опыт команды QM тоже показывает, насколько важен бюджет. Они заметили, что агенты часто сдаются раньше времени, и попробовали «затачивать инструменты»: задавать бюджет для цели и не разрешать отступать, пока не израсходовано реальное время или токены. В результате результаты исследования улучшились. Так что в спецификации оценки стоит прописывать не только верхнюю границу бюджета, но и явно указывать, есть ли требование к минимальным вложениям.
Шаг 5. Проводим абляционные тесты для Harness
Когда видно, что Harness даёт прирост, следующий шаг — понять, какая именно способность его обеспечивает. Prime Agent делает ставку на выразительность и считает, что сжатие, Python REPL, программируемые субагенты, доступ к состоянию и механизмы обратной связи не стоит легко убирать. Но на вашей задаче реальный вклад каждой из этих способностей всё равно нужно проверить.
Делается это так: отключаем по одной способности за раз — например, выключаем REPL, субагентов или долговременную память, — а остальную конфигурацию оставляем как есть. Если после отключения оценка почти не меняется, а расходы заметно падают, возможно, эта способность пока не стоит того, чтобы её оставлять. А вот для задач с высокой дисперсией, вроде автоматических исследований, нужно прогонять несколько раундов, потому что, как снова заметил Seth, такие задачи трудно напрямую отнести на счёт Harness или модели.
Шаг 6: Рассчитать стоимость и добавить ручную проверку
Seth также упомянул, что при прогоне оценки с Hermes Agent он быстро потратил 5 000 долларов, но заметного улучшения не увидел — пришлось прервать эксперимент. Это не говорит о пределе возможностей Hermes Agent, но достаточно ясно показывает: соотношение стоимости и эффективности должно попадать в выводы оценки. В итоговом отчёте рекомендуется указывать долю успешных запусков, время выполнения, расход токенов и стоимость одного успешного запуска.
При расчёте стоимости не вписывайте цены намертво в описание скрипта оценки. Цены на вход и выход модели, стоимость кэширования и правила тарификации берите из актуальных данных на странице цен APIYI https://docs.apiyi.com/models и указывайте в отчёте дату запроса.
На этапе оценки также нужно сохранять выборочную ручную проверку. Команда QM обнаружила, что когда LLM просят оценить результат исправления, возникает «синдром главного героя»: модель видит только часть слона, а не всю систему. Когда речь идёт о бизнес-процессах, нужно также проверять границы прав доступа: агенты плохо понимают социальный контекст, и привилегированная информация может утечь в контекст, где её быть не должно.
Как реализовать матрицу оценки моделей с помощью API
На практике рекомендуется разбить оценку на три части: набор задач, конфигурацию запуска и запись результатов. Тогда при смене модели или Harness достаточно изменить один параметр конфигурации, а не переписывать весь процесс.
| Параметр конфигурации | Что рекомендуется фиксировать | Пояснение |
|---|---|---|
| Формат интерфейса | Совместимость с OpenAI или формат Anthropic | В разных форматах могут отличаться вызовы инструментов и структура сообщений, поэтому их нужно проверять отдельно |
| Адрес подключения и ключ | base_url, имя переменной окружения |
Адрес сверяйте с документацией docs.apiyi.com, ключ не включайте в отчёт об оценке |
| Параметры запуска | model, max_tokens, максимальное число раундов, число повторов |
Чтобы каждый эксперимент можно было воспроизвести |
| Правила расчёта стоимости | Вход, выход, кэш и дата запроса | Ориентируйтесь на актуальные данные со страницы цен APIYI docs.apiyi.com/models |
| Результаты запуска | Оценки, причины сбоев, токены, длительность, журналы вызовов | Нужны для анализа плато и соотношения стоимости и эффективности |
Если ваш Harness поддерживает оба формата интерфейса, сначала прогоните одну и ту же модель в обоих форматах для сравнения. Так вы убедитесь, что преобразование сообщений, определение инструментов и потоковые ответы не влияют на результат, и не перепутаете проблему интеграции с разницей в возможностях моделей.
Подсказка по подключению: APIYI предоставляет API-доступ к моделям, упомянутым в этой статье, и поддерживает форматы интерфейсов OpenAI и Anthropic. Перед началом эксперимента проверьте на docs.apiyi.com актуальный список доступных моделей и способ вызова, а затем запишите ID модели в спецификацию оценки.
Частые вопросы (FAQ)
В1: Что такое Harness в оценке моделей?
Harness — это системный слой, который связывает модель с внешним миром. Обычно он включает управление циклом, работу с контекстом, инструменты, субагентов, память и доступ к состоянию. Именно он определяет, что модель может видеть, что может вызывать и как долго может работать.
В2: Если у Harness выше баллы, значит модель стала сильнее?
Нет. При неизменных весах рост баллов скорее говорит о том, что система раскрыла больше возможностей или конфигурация лучше подходит под эту задачу. А если Harness, бюджет и модель меняются одновременно, то приписать улучшение чему-то одному нельзя — не исключено и то, что в среде оценки есть утечка.
В3: Когда нужно заново проводить оценку модели?
Заново оценивать стоит при изменении версии модели, системного промпта, прав доступа к инструментам, стратегии сжатия контекста или бизнес-задач. Область Harness развивается очень быстро: данные в этой статье взяты из материалов, опубликованных InfoQ в ноябре 2026 года, и позже результаты могут измениться.
В4: Для каких сценариев подходит такой подход к оценке моделей?
В первую очередь для следующих:
— **Выбор внутреннего кодирующего агента**: сравнение доли выполненных задач у разных комбинаций модели и Harness.
— **Длительные исследовательские задачи**: наблюдение за плато и разбросом результатов по мере роста бюджета.
— **Проверка корпоративного агента перед запуском**: одновременная проверка качества, стоимости и границ прав доступа.
В5: Как быстро подключить несколько моделей для сравнения Harness?
Сначала определите задачу оценки и список моделей, а затем подключайтесь через APIYI apiyi.com. Платформа предоставляет API-доступ к моделям, о которых идёт речь в статье, и совместима с форматами интерфейсов OpenAI и Anthropic. Конкретные ID моделей и способы настройки смотрите в документации docs.apiyi.com, а во время эксперимента держите остальные переменные неизменными.
В6: Как указывать цены моделей в отчёте об оценке?
Лучше ссылаться только на проверенные ценовые данные и указывать дату запроса. Цену за вход и выход, стоимость кеширования и правила тарификации берите из актуальных данных на странице цен APIYI https://docs.apiyi.com/models — не используйте старые таблицы и оценочные значения.
В7: Какие ограничения есть у этого метода оценки Harness?
Матричные эксперименты, повторные прогоны и ручная проверка требуют времени и денег. У длительных задач разброс результатов тоже может быть большим: даже при контроле основных переменных точно атрибутировать результат сложно. Поэтому такой подход лучше использовать для поддержки решений, а не воспринимать один результат как абсолютный рейтинг.
Ключевые выводы по оценке моделей с Harness
- Сначала определите, что именно сравниваете: сравнение идёт между моделями или между комбинацией «модель + Harness».
- При аномально высоких баллах первым делом смотрите логи: 99.9% случаев показывают, что изолированная среда — обязательное условие оценки.
- Разложите переменные по матрице: подключите несколько моделей через APIYI, а затем проведите сравнение по схеме «модель × Harness».
- Бюджеты должны быть сопоставимы: наблюдайте кривую в нескольких точках бюджета, чтобы найти реальное плато.
- Абляция помогает найти вклад: отключайте по одной возможности за раз и проверяйте, откуда берётся прирост.
- Проверяйте данные о стоимости: цены и принципы тарификации — по странице цен APIYI.
- Оставляйте место человеческой оценке: оценка LLM может быть односторонней, а риски прав доступа нужно тестировать отдельно.
Итог
«Поменял Harness — и результат удвоился» — к этому стоит отнестись серьёзно, но не стоит понимать это просто как «модель не важна». Данные из доклада показывают и усиливающий эффект Harness, и то, что между разными моделями и задачами по-прежнему есть заметные разрывы; надёжные выводы должны опираться на контролируемые эксперименты.
При внедрении стоит запомнить три вещи:
- Чётко описывайте объект оценки: фиксируйте модель, Harness, бюджет, набор для оценки и способ оценки.
- Дизайн эксперимента должен позволять атрибуцию: разделяйте переменные матричными экспериментами и абляционными тестами, а среду оценки изолируйте.
- Выводы должны быть привязаны к сценарию: смотрите одновременно на плато, соотношение цены и качества, результаты ручной проверки и риски прав доступа.
Если вы готовы проверить свою комбинацию моделей, подключите модели из этой статьи через APIYI на apiyi.com, а затем настройте всё по документации docs.apiyi.com. Если нужно рассчитать затраты, актуальные цены смотрите на https://docs.apiyi.com/models.
📚 Справочные материалы
- InfoQ: Одна и та же модель — от 30 до 95 баллов: разницу создаёт не модель, а Harness
- Ссылка:
infoq.cn/article/C1C1DThg8z1Dy0rZAmLB -
Описание: все оценки, кейсы и идеи по дизайну, упомянутые в этой статье, взяты из этого обзорного материала.
-
Видео выступлений YC Paper Club Harness Night
- Ссылка:
youtube.com/watch?v=n9xKblqyQ28 -
Описание: здесь можно увидеть полный контекст трёх выступлений — Prime Agent, OpenJarvis и QM.
-
Центр документации APIYI
- Ссылка:
docs.apiyi.com -
Описание: для проверки доступных моделей, формата API и настроек подключения.
-
Страница цен на модели APIYI
- Ссылка:
docs.apiyi.com/models - Описание: цены на модели, стоимость кеширования и правила тарификации смотрите в актуальных данных на этой странице.
Автор: техническая команда APIYI
По техническим вопросам: если хотите узнать, как подключать модели, загляните на официальный сайт APIYI apiyi.com, а больше материалов найдёте в центре документации docs.apiyi.com.