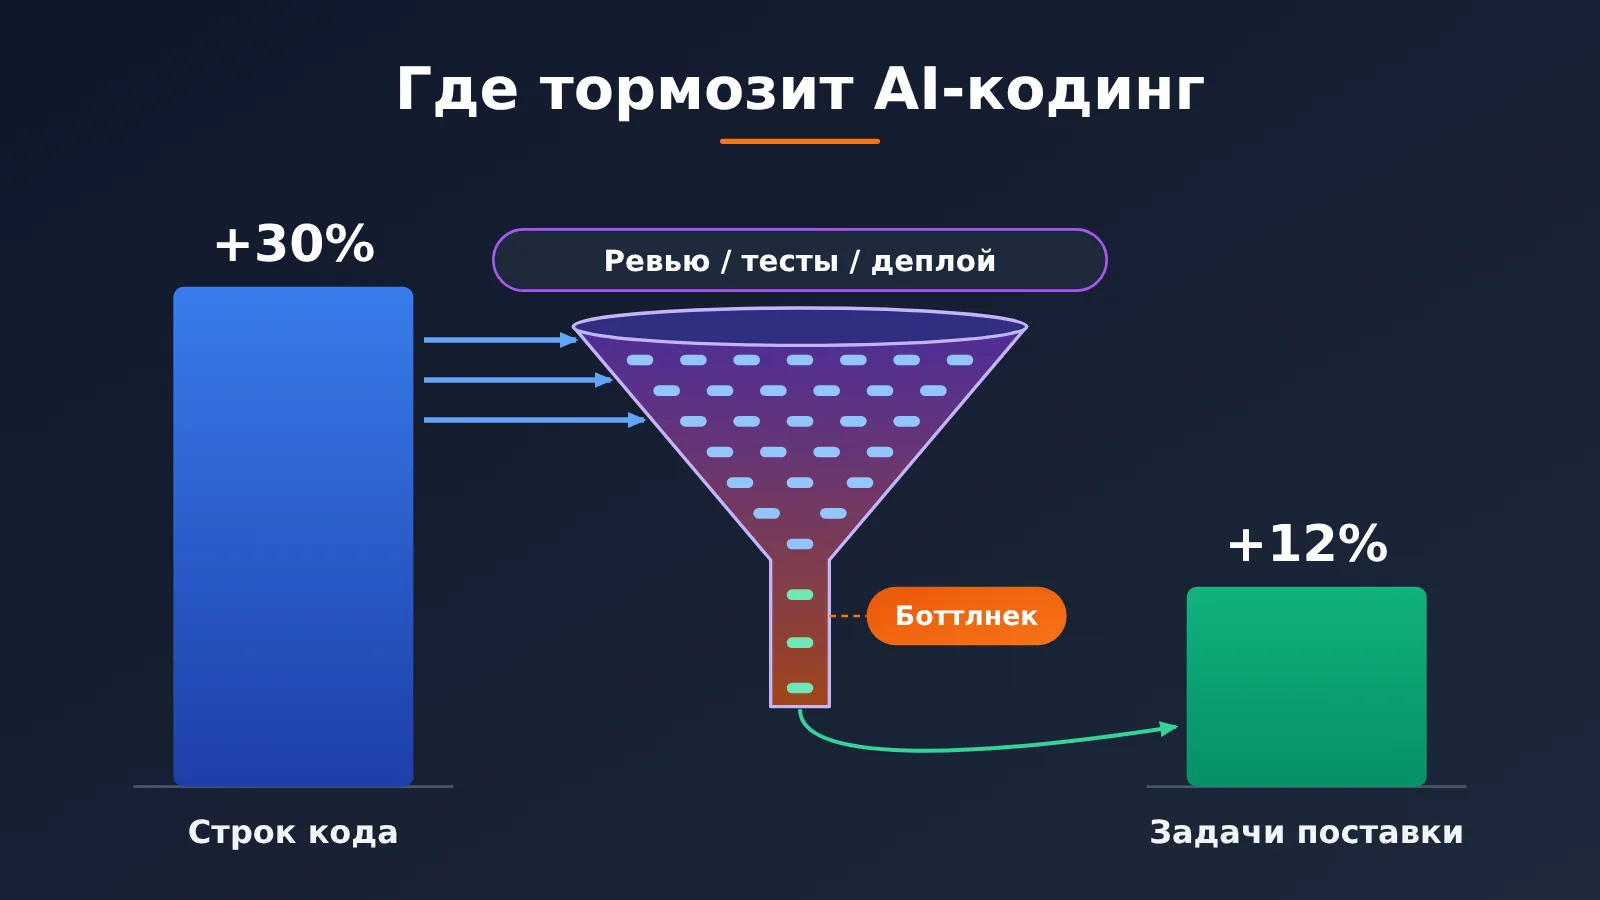
Примечание автора: AI-агенты увеличили число строк кода на 30%, а выполненных тикетов — только на 12%. В этой статье мы по данным исследований находим узкое место и даём командам шаги, которые можно внедрить сразу.
Многие команды, внедрив AI-агентов, замечают: коммитов больше, пул-реквестов больше, а требования доставляются не сильно быстрее. Недавнее исследование Гарвардского университета на платформе Jellyfish, охватившее 718 компаний, дало количественный вывод: объём кода вырос на 30%, а поставка — только на 12%; разрыв в основном съедают последующие этапы вроде код-ревью.
Это не очередная статья с критикой AI-программирования. Вывод исследования однозначен: AI-агенты действительно дают рост производительности, проблема в том, что весь конвейер доставки не масштабировался вместе с ними. Сначала разберём данные, а затем предложим метод из 5 шагов — от метрик до перестройки процессов.
Главная польза: после прочтения вы сможете определить, на каком этапе у вашей команды буксует рост эффективности AI-кодинга, и поймёте, что менять в первую очередь и как измерять, даёт ли улучшение результат.
Главное о том, где на самом деле упирается рост эффективности AI в разработке
Данные исследования охватывают период с января 2021 года по март 2026 года: более 700 компаний, 700 000 сотрудников и около 300 млн рабочих событий. Источники данных — HR-системы, системы контроля версий кода, системы тикетов, инструменты календарного планирования, а также записи использования генеративных AI-инструментов: GitHub Copilot, Cursor, Claude Code и других. Для исследований такого типа это редкий по масштабу набор данных.
| Пункт | Что выяснили | Что это значит для команды |
|---|---|---|
| Рост выпуска | AI-агенты дают +30% строк кода, +20% коммитов, +23% merge request’ов | Этап кодирования действительно ускорился |
| Рост поставки | Число закрытых тикетов на человека в месяц выросло всего на 12% | Рост выпуска не конвертируется в поставку в той же пропорции |
| Распределение времени | Инженеры тратят на написание кода только 30–40% времени | Если оптимизировать только кодирование, потолок очень низкий |
| Нагрузка на ревью | Время на ревью +49%, комментариев +53%, доля merge request’ов, требующих доработки, удвоилась | Узкое место сместилось на ревью |
| AI-ревью | После внедрения AI-ассистента для ревью доля участников ревью всё равно выросла на 14% | Просто добавить AI-инструмент для ревью недостаточно |
Чем отличаются эффекты от AI-ассистентов и AI-агентов
Исследование разделяет два типа инструментов. AI-ассистенты для программирования (в основном автодополнение и диалог) дали скромный прирост: +12% строк кода, +9% коммитов, +5% merge request’ов, причём статистически значимым был только рост числа коммитов. Что важнее, ассистенты не увеличили число закрытых тикетов — то есть на поставку они почти не повлияли измеримым образом.
AI-агенты (которые самостоятельно выполняют многошаговые задачи) показали значимый рост по всем трём метрикам выпуска и дали +12% к числу закрытых тикетов. Это говорит о том, что «дать AI целую задачу» ценнее, чем «попросить AI дописать пару строк», но одновременно означает, что вниз по потоку приходит больше кода и нагрузка на ревью растёт. Исследователи отдельно отмечают: рост объёма ревью нельзя объяснить только тем, что отдельные merge request’ы стали крупнее. Проблема в том, что сам код требует больше обсуждений и правок.
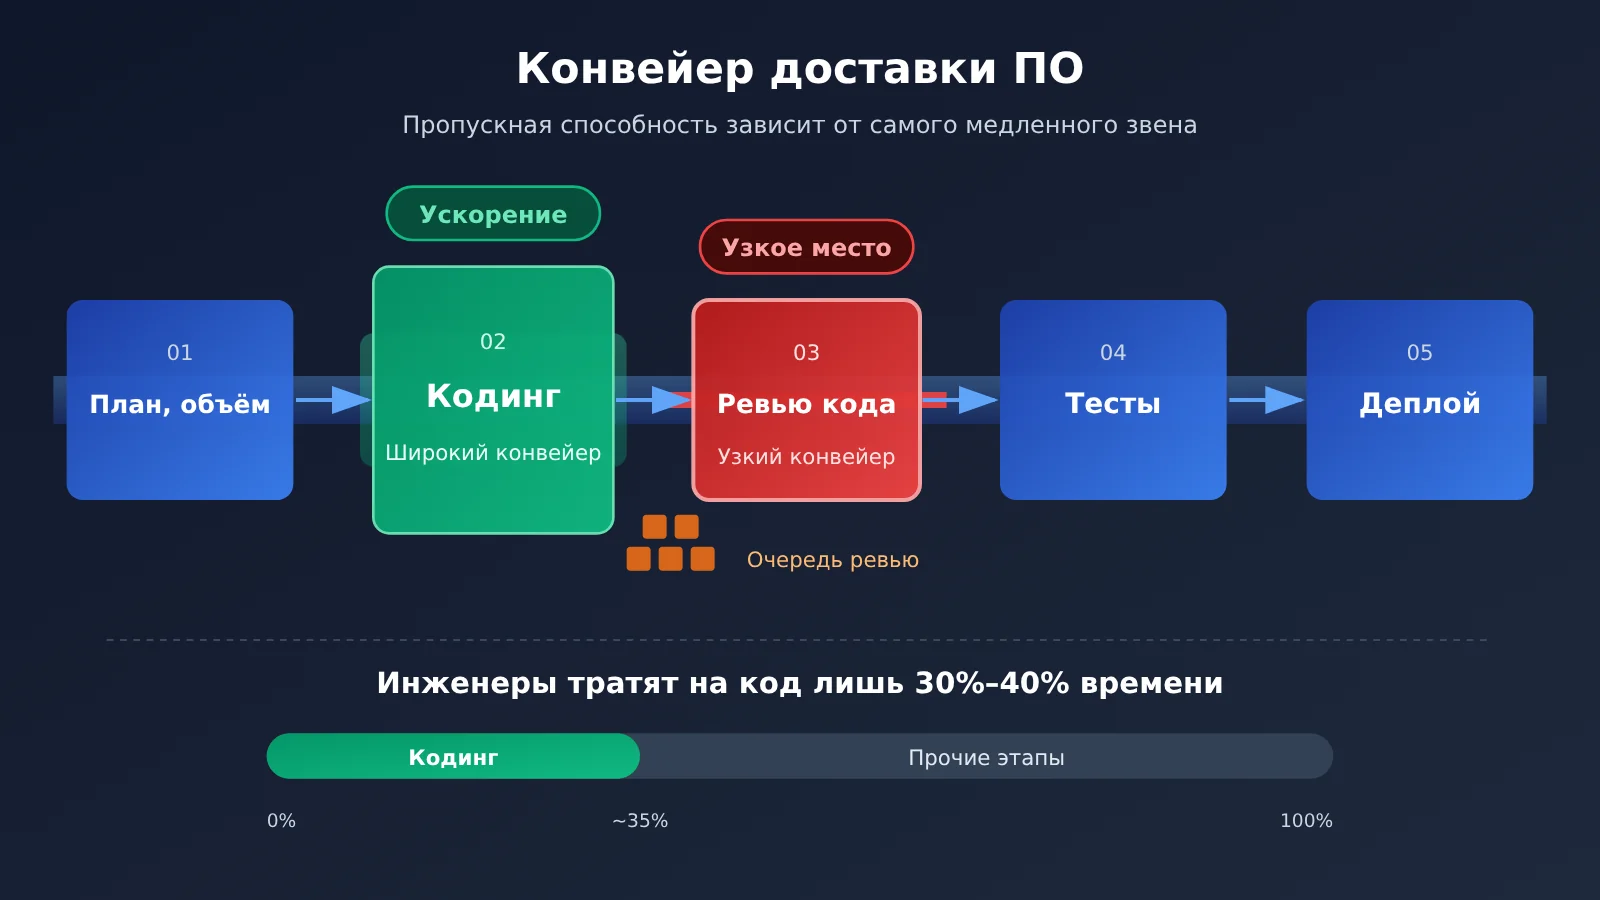
Где узкое место в повышении эффективности AI-кодинга: взгляд через теорию ограничений
Пропускная способность конвейера поставки определяется самым медленным его звеном. Если кодинг занимает у инженера всего 30–40% времени, то даже удвоение скорости кодинга сократит общий цикл максимум примерно на треть. А на практике ускоренный кодинг ещё и подкидывает ревью и тестированию дополнительную работу в очереди.
Несколько цифр из исследований складываются в цельную причинно-следственную цепочку: агент пишет больше — количество merge request’ов растёт; число комментариев на каждый merge request увеличивается на 53%, то есть ревьюерам приходится тратить больше сил на то, чтобы разобраться в написанном AI коде и оспорить его; доля merge request’ов, которые приходится дорабатывать, удваивается — значит, качество первого коммита падает. Все эти издержки ложатся на живых ревьюеров, а ревьюеры как раз самые опытные в команде люди — и самые занятые.
| Этап | Что изменил AI | Типичные симптомы | Приоритет |
|---|---|---|---|
| Планирование и рамки задачи | При нечётком описании требований AI «уверенно» уходит не в ту сторону | Переделки, merge request отклоняют целиком | Высокий |
| Кодинг | Скорость заметно выросла | Объём кода взлетает, выработка отдельного разработчика выглядит отлично | Уже оптимизирован |
| Код-ревью | Одновременно растут и количество, и сложность того, что нужно проверить | Очередь на ревью, бесконечные споры в комментариях | Наивысший |
| Тестирование | Покрытие не успевает за ростом объёма кода | Регрессий становится больше | Высокий |
| Деплой и эксплуатация | Инженеры хуже понимают код | Диагностика инцидентов замедляется | Средне- и долгосрочный |
Обсуждения в сообществе это подтверждают. Один разработчик заметил, что «каждая строка кода — потенциальный риск». Другой указал, что агент — не слишком надёжный соратник и ради выполнения задачи может выкинуть что-то совсем абсурдное. Есть и мнение, что среднее время восстановления после сбоя (MTTR) станет важным показателем влияния AI: чем хуже инженер понимает код, который сам же отдал в прод, тем труднее разбираться с инцидентами.
Быстрый старт: 5 шагов к повышению эффективности AI-кодинга
Методы ниже расположены по возрастанию затрат — команда может внедрять их по порядку. На каждом шаге старайтесь задавать измеримые показатели, чтобы избежать недоказуемых суждений вроде «кажется, стало быстрее».
Шаг 1. Постройте базовую линию поставки для повышения эффективности AI-кодинга
Не спешите менять инструменты — сначала постройте систему измерений. Исследование смогло обнаружить разрыв именно потому, что смотрело одновременно и на показатели выработки, и на показатели поставки. Многие команды смотрят только на строки кода и число коммитов и потому ошибочно решают, что повышение эффективности удалось.
Рекомендуется отслеживать две группы показателей: со стороны выработки — число коммитов и мерж-реквестов; со стороны поставки — количество закрытых тикетов на человека в месяц и цикл требования от старта до релиза. Добавьте к этому три показателя со стороны ревью: среднее время ревью мерж-реквеста, число комментариев к одному мерж-реквесту и долю случаев, требующих переделки. Эти данные обычно можно напрямую выгрузить из Git-платформы и тикет-систем вроде Jira.
| Категория показателей | Конкретные показатели | Источник данных | На что смотреть |
|---|---|---|---|
| Выработка | Число коммитов, число мерж-реквестов | Git-платформа | Только для справки, не для оценки |
| Поставка | Число закрытых тикетов на человека в месяц, цикл требования | Тикет-система | Ключевые целевые показатели |
| Ревью | Время ревью, число комментариев, доля переделок | Git-платформа | Раннее предупреждение об узких местах |
| Качество | Число инцидентов в проде, MTTR | Мониторинг и записи об инцидентах | Долгосрочное здоровье |
Шаг 2. Заранее передайте планирование требований ИИ-агенту для написания кода
Когда требования размыты, агент чаще всего «уверенно уходит не в ту сторону». Вместо того чтобы на этапе ревью разворачивать весь merge request целиком, лучше потратить десять минут до начала работы и чётко описать задачу: какие модули менять, какие интерфейсы трогать нельзя, каковы критерии приёмки и какие тесты нужно добавить.
Практичный подход — сначала попросить агента выдать план реализации, а после подтверждения инженером переходить к кодированию. Правки на этапе плана обходятся гораздо дешевле, чем на этапе кода, к тому же ревьюеры заранее понимают масштаб изменений. На первый взгляд этот шаг добавляет времени на старте, но зато напрямую снижает такие проблемы, как «доля merge request’ов, требующих переделки, выросла вдвое».
Шаг 3. Контролируйте гранулярность merge request’ов со сгенерированным ИИ кодом
Внимание ревьюера — ограниченный ресурс. Даже если исследования показывают, что рост нагрузки на ревью не полностью объясняется увеличением отдельных merge request’ов, контроль гранулярности всё равно остаётся самым прямым способом снизить когнитивную нагрузку. Рекомендуется задавать чёткие границы задач для агента: один merge request решает одну проблему, рефакторинг и изменения функциональности отправляются отдельно.
Заодно требуйте от агента, чтобы в описании merge request’а он указывал мотивацию изменений, затронутую область и результаты самопроверки. Ревьюеру достаточно прочитать описание, чтобы оценить риски, а не восстанавливать намерения автора по сотням строк диффа — количество встречных комментариев заметно сократится.
🎯 Техническая рекомендация: разные модели заметно отличаются по качеству декомпозиции задач и планирования. APIYI apiyi.com предоставляет доступ к API популярных моделей, упомянутых в этой статье, включая Claude и GPT, и совместим сразу с двумя форматами интерфейсов — OpenAI и Anthropic. Команда может переключать модели в рамках одного рабочего процесса агента и сравнивать, у какой модели доля merge request’ов, требующих переделки, ниже. Как подключиться — см. документацию APIYI docs.apiyi.com.
Шаг 4. Переложите тесты и самопроверку на ИИ-агента, а не на ревьюера
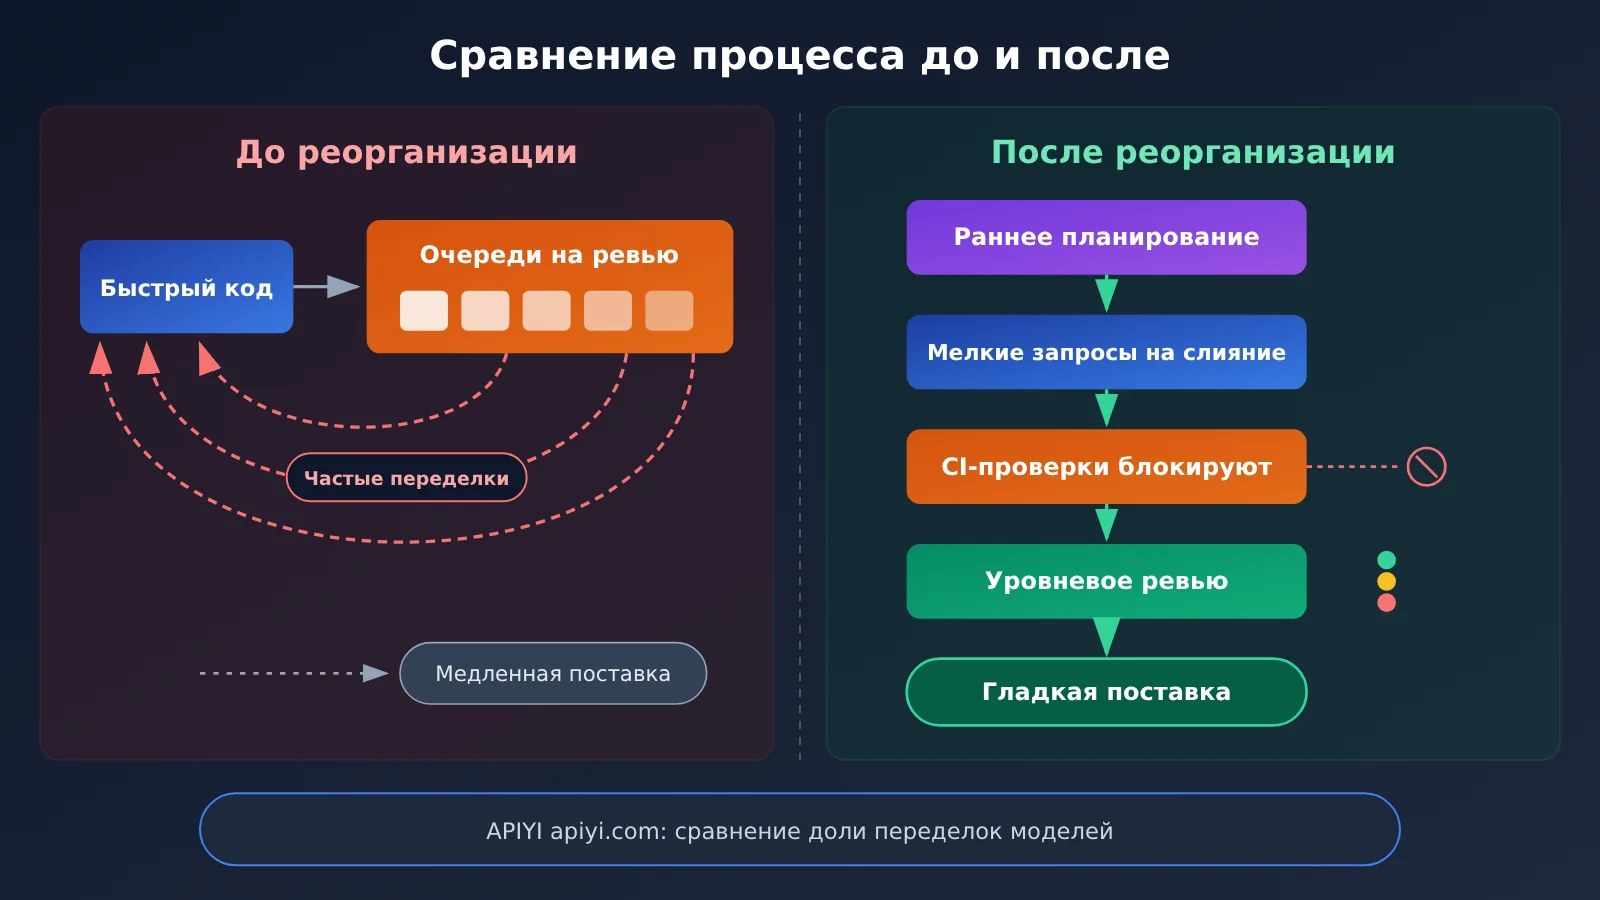
Исследование показало: после внедрения ИИ-помощника для ревью доля сотрудников, участвующих в ревью, всё равно выросла на 14%. Это говорит о том, что просто добавить ИИ на этапе ревью недостаточно. Гораздо эффективнее перенести контроль качества на более ранний этап: пусть ИИ-агент ещё до отправки изменений дополняет юнит-тесты, запускает тесты локально, прогоняет статические проверки и форматирует код.
Можно сделать «тесты проходят, проверки проходят» жёстким обязательным условием для отправки мерж-реквеста — CI будет блокировать такие изменения автоматически. Тогда ревьюер сможет сосредоточиться на продуманности дизайна, граничных случаях и бизнес-логике, а не на выискивании null pointer и проблем с неймингом. ИИ-инструменты для ревью хорошо работают как первый фильтр, но финальное решение всё равно должно оставаться за человеком, который понимает бизнес.
Шаг 5. Ревью по уровням и классификация рисков ИИ-кода
Не любой ИИ-код требует одинаково строгого ревью. Изменения можно разделить по уровню риска: документация, тесты и шаблонный код проходят лёгкое ревью; бизнес-логика — обычное ревью; изменения, связанные с аутентификацией, платежами, миграциями данных и конкурентностью, обязательно проходят глубокое ревью у старшего инженера, а автор должен быть способен объяснить каждое изменение.
| Уровень риска | Тип изменений | Формат ревью | Рекомендуемое число ревьюеров |
|---|---|---|---|
| Низкий | Документация, тестовые случаи, шаблонный код | Первичное ИИ-ревью + быстрая проверка человеком | 1 человек |
| Средний | Обычная бизнес-логика | Полное человеческое ревью | 1–2 человека |
| Высокий | Аутентификация, платежи, миграции данных, конкурентность | Глубокое ревью старшего инженера + объяснение от автора | 2 и более человек |
И последнее: MTTR стоит включить в долгосрочный мониторинг. Если инженеры понимают код всё поверхностнее, проблемы вылезут в продакшен-инцидентах. Регулярно просить автора объяснять свой ИИ-код после мержа — дешёвый способ не допустить ситуации «этот код на самом деле никто не понимает».
🚀 Быстрый старт: если вы как раз делаете внутреннего ИИ-агента для кодинга, начните с заявки на тестовые кредиты в APIYI apiyi.com. Затем дайте разным моделям один и тот же набор задач, замерьте время ревью сгенерированных мерж-реквестов и долю переделок — и уже потом решайте, какая модель будет основной.
Справочник по выбору моделей для ИИ-агентов, пишущих код
Сам по себе выбор модели не устраняет узкие места процесса, но влияет на качество первого коммита, а значит, и на нагрузку при ревью. В таблице ниже — ориентиры с точки зрения роли в рабочем процессе; конкретные результаты лучше проверять на своей команде.
| Роль в рабочем процессе | Ключевые способности | Как выбирать | Доступные платформы |
|---|---|---|---|
| Генерация плана реализации | Понимание длинного контекста, декомпозиция задач | Выбирайте флагманскую модель с сильными навыками рассуждения | APIYI apiyi.com, официальный API |
| Написание и рефакторинг кода | Качество кода, соблюдение ограничений | Выбирайте модель с хорошими результатами в бенчмарках по программированию | APIYI apiyi.com, официальный API |
| Дополнение тестов и самопроверка | Стабильность, большой объём вызовов | Выбирайте модель с хорошим соотношением цены и качества | APIYI apiyi.com, официальный API |
| Первичное ИИ-ревью | Выявление типичных дефектов | Берите другую модель, чем для написания кода, чтобы избежать слепых зон из-за общего источника | APIYI apiyi.com, официальный API |
💰 О стоимости: в рабочих процессах агентов много вызовов, и на итоговую стоимость напрямую влияет схема тарификации (цена за входные и выходные токены и за попадания в кэш). В этой статье мы не приводим конкретные цены — актуальные цены и правила тарификации всех моделей смотрите на странице цен APIYI: docs.apiyi.com/models.
Частые вопросы (FAQ)
Вопрос 1: что означает «объём кода вырос на 30 %, а поставка — только на 12 %» в AI-разработке?
Это вывод исследования Гарвардского университета на данных Jellyfish: после внедрения AI-агентов количество строк кода выросло на 30 %, но число задач, которые каждый инженер закрывает за месяц, увеличилось лишь на 12 %. Разрыв возникает потому, что ревью кода, тестирование и другие звенья ниже по потоку становятся новым узким местом.
Вопрос 2: насколько отличается прирост эффективности от AI-ассистента программиста и от AI-агента?
У ассистента программиста прирост выпуска скромнее: статистически значимым оказался только рост коммитов на 9 %, при этом количество закрытых задач не выросло. AI-агент даёт рост строк кода, коммитов и запросов на слияние на 30 %, 20 % и 23 % соответственно, плюс 12 % прироста закрытых задач.
Вопрос 3: можно ли доверять данным этого исследования об эффективности AI в разработке?
Период данных — с января 2021 по март 2026 года, охват — более 700 компаний, 700 тысяч сотрудников и около 300 миллионов рабочих событий. Оценка распределения рабочего времени дополнительно проверена опросом 100 инженеров, так что и размер выборки, и перекрёстная проверка выглядят надёжно.
Вопрос 4: поможет ли внедрение AI-инструментов для ревью кода снять узкое место на ревью?
Только ими не обойтись. Исследование показывает: после внедрения AI-ассистированного ревью доля людей, участвующих в ревью, всё равно выросла на 14 %. Эффективнее сдвинуть тесты и самопроверку на этап до коммита, а затем добавить многоуровневое ревью, чтобы человек сосредоточился на рискованных изменениях.
Вопрос 5: как с малыми затратами проверить, как разные модели влияют на нагрузку при ревью?
Советуем сравнить несколько моделей на одном наборе реальных задач:
1. Зарегистрироваться на APIYI apiyi.com и получить тестовый лимит
2. Подключить существующего агента в формате, совместимом с OpenAI или Anthropic, по инструкции из документации APIYI docs.apiyi.com
3. Записывать для каждой модели время ревью сгенерированного запроса на слияние, число комментариев и долю переделок
Так вы выберете модель по данным, а не по впечатлению.
Вопрос 6: как оценить стоимость использования AI-агентов для разработки в команде?
Сначала посчитайте средний расход входных и выходных токенов на одну задачу, затем умножьте на цену модели и месячное число задач. У агентных задач контекст обычно длинный, и попадание в кэш заметно влияет на стоимость. Конкретные цены и правила тарификации кэша смотрите на странице цен APIYI docs.apiyi.com/models.
Вопрос 7: какие долгосрочные риски несёт рост эффективности за счёт AI в разработке?
Главный риск — инженеры начинают хуже понимать код. В сообществе считают: когда кодовая база постоянно растёт, а понимания не хватает, сбои случаются чаще, а разбираться с ними сложнее. Рекомендуем отслеживать среднее время восстановления после сбоя и требовать, чтобы автор мог внятно объяснить AI-код, который он смёржил.
—
## Ключевые выводы: эффективность AI-кодинга
— **Объём кода — ещё не результат**: AI-агенты увеличивают объём кода на 30%, а число сданных задач — только на 12%.
— **Кодинг занимает лишь 30–40% времени**: если оптимизировать только написание кода, потолок общего ускорения будет очень низким.
— **Код-ревью — узкое место №1**: время ревью +49%, комментариев +53%, доля переделок удвоилась.
— **AI-ревью — не панацея**: после его внедрения доля сотрудников, участвующих в ревью, всё равно выросла на 14%.
— **Контроль качества нужно смещать раньше**: планирование заранее, мелкие коммиты и самопроверка перед коммитом работают лучше всего.
— **В долгую следите за MTTR**: чтобы команда не начала «писать много, а понимать мало» про AI-код.
— **Выбирайте модель по данным**: через единый интерфейс APIYI apiyi.com можно сравнить долю переделок у разных моделей.
—
## Итоги
Где застревает повышение эффективности AI-кодинга — исследование уже дало ответ:
1. **Узкое место сместилось**: когда кодинг ускорился, ревью кода, тестирование и планирование стали новыми ограничителями скорости.
2. **Метрики нужно смотреть в паре**: показатели объёма выхода обязательно отслеживать вместе с метриками поставки, ревью и качества.
3. **Менять процессы важнее, чем менять инструменты**: планирование заранее, контроль гранулярности, смещение самопроверки, уровневое ревью — двигаться по порядку.
Настоящее ускорение — не в том, чтобы AI писал больше кода, а в том, чтобы меньше кода проходило ревью с более высоким качеством с первого раза. Рекомендую сначала за один итерационный цикл собрать базовые метрики, а затем постепенно внедрять 5 шагов выше.
Если нужно сравнить поведение разных моделей в агентных рабочих процессах, рекомендую быстро проверить через APIYI apiyi.com: платформа совместима с форматами API OpenAI и Anthropic, цены смотрите на docs.apiyi.com/models.
—
## 📚 Справочные материалы
1. **InfoQ 中文: код, сгенерированный ИИ, сдерживается узкими местами на последующих этапах** — китайская версия исследовательского репортажа.
— Ссылка: `infoq.cn/article/c3vTLNrRwfCzw8SAmz90`
— Описание: включает методику исследования, ключевые данные и обсуждение в сообществе.
2. **InfoQ 英文原文: Jellyfish AI Productivity** — английская версия исследовательского репортажа.
— Ссылка: `infoq.com/news/2026/10/jellyfish-ai-productivity`
— Описание: подойдёт тем, кому нужны оригинальные формулировки на английском.
3. **Центр документации APIYI** — подключение моделей и описание интерфейсов.
— Ссылка: `docs.apiyi.com`
— Описание: способы подключения в форматах, совместимых с OpenAI и Anthropic.
4. **Страница цен на модели APIYI** — тарифы по каждому модельному продукту.
— Ссылка: `docs.apiyi.com/models`
— Описание: стоимость входных и выходных токенов, а также кэша — по актуальным данным на этой странице.
—
> **Автор**: техническая команда APIYI
> **Обсуждение технологий**: будем рады обратной связи — свяжитесь с нами на главной странице APIYI apiyi.com, а дополнительные материалы по подключению ищите в центре документации docs.apiyi.com.