Примечание автора: исследование Стэнфорда показало, что 44% распространённых выводов о больших языковых моделях уже устарели, а их средний срок актуальности составляет всего 15,7 месяца. В этой статье мы превратили результаты исследования в чек-лист повторной проверки моделей, который команды разработчиков могут сразу взять в работу.
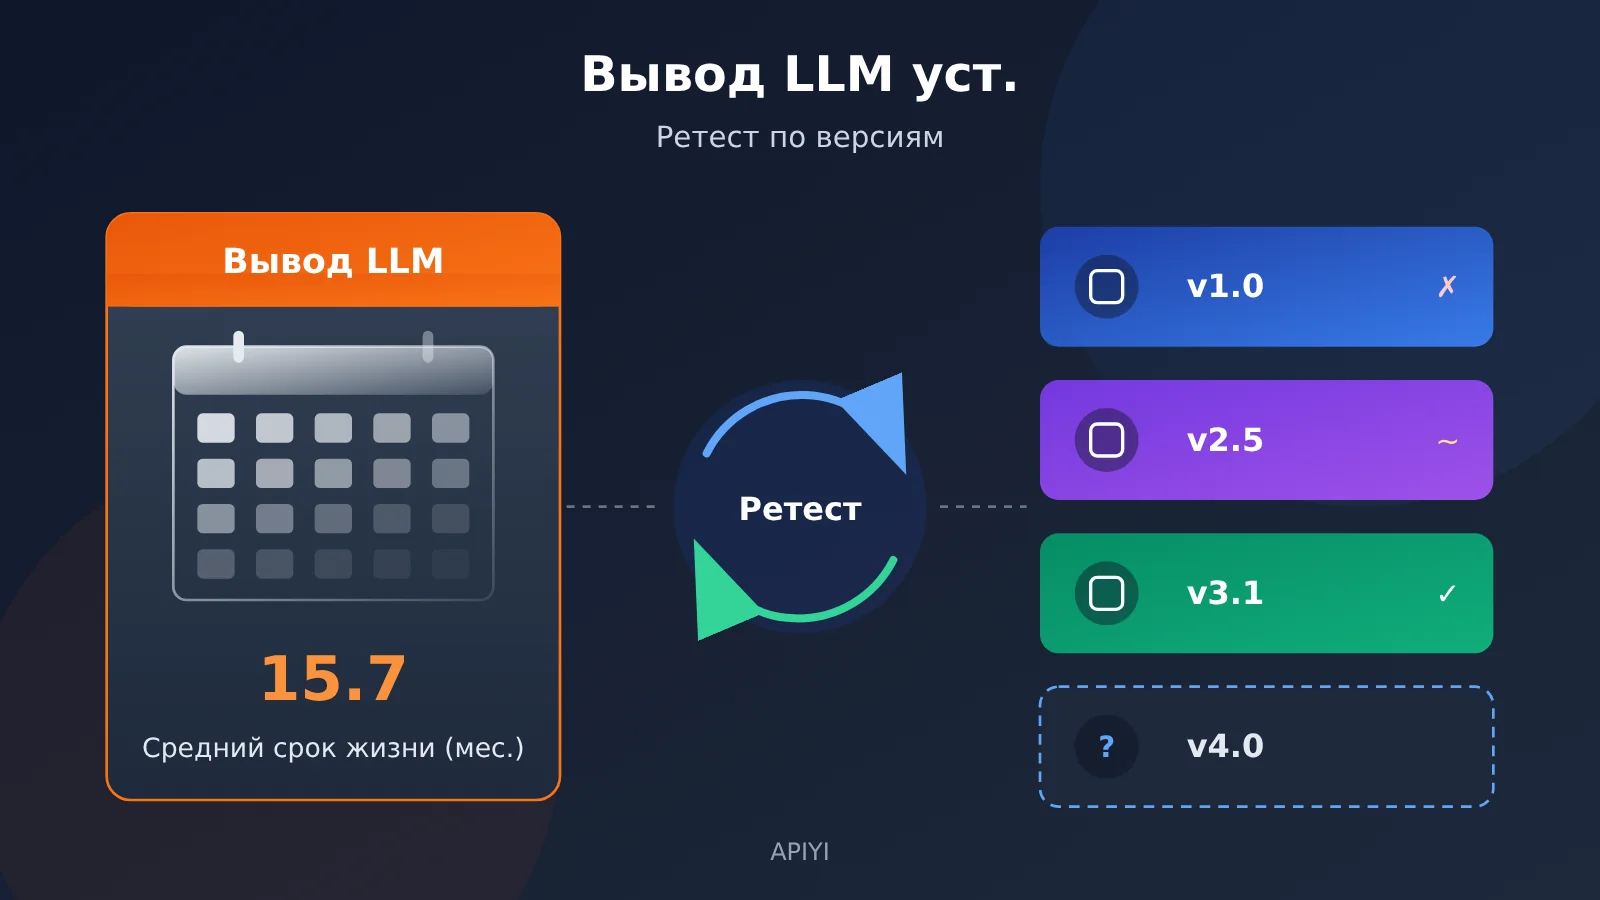
«Некоторые модели не могут сосчитать буквы r в слове strawberry», «информация в середине длинного контекста теряется», «модели любят выдумывать ссылки на источники» — наверняка вы не раз слышали эти утверждения в статьях, технических чатах и на встречах по выбору моделей. Исследователи из Стэнфорда Owen Queen и James Zou повторно проверили 50 широко цитируемых выводов о LLM на 20 моделях. Оказалось, что 44% из них уже устарели, а выводы, для которых удалось оценить срок актуальности, в среднем сохранялись всего 15,7 месяца.
Это не очередное рассуждение в духе «модели становятся всё мощнее». Исследование даёт конкретные данные: какие выводы устаревают быстрее всего, какие держатся дольше и насколько сильно могут различаться модели одного поколения. Мы превратим рекомендации исследователей для научного сообщества в пошаговый процесс, которым команды разработчиков смогут пользоваться при выборе моделей.
Главная польза: прочитав статью, вы узнаете, каким утверждениям вида «модель плохо справляется с X» стоит доверять меньше всего, и выработаете привычку при выборе модели записывать её название, версию и дату, сохранять промпты и повторно проверять результаты на целевой модели.
Главное об устаревании выводов об LLM
Для начала соберём ключевые цифры исследования в одной таблице. Изученные модели были выпущены в период с июля 2024 года по сентябрь 2026 года и разработаны 8 разными компаниями. Публикация об исследовании вышла 3 ноября 2026 года.
| Показатель | Данные исследования | Что это значит при выборе модели |
|---|---|---|
| Доля устаревших выводов | Из 50 выводов 44% устарели, а 34% заметно ослабли | Большинство распространённых в интернете утверждений о недостатках моделей уже нельзя применять без проверки |
| Доля выводов, которые всё ещё актуальны | Лишь 16% сохранились, а 6% даже усилились | За некоторыми «устойчивыми» склонностями стоит следить в долгосрочной перспективе |
| Средний срок актуальности | Для 22 выводов, срок устаревания которых удалось оценить, среднее значение составило 15,7 месяца | К выводам оценок, проведённых больше года назад, стоит изначально относиться с оговорками |
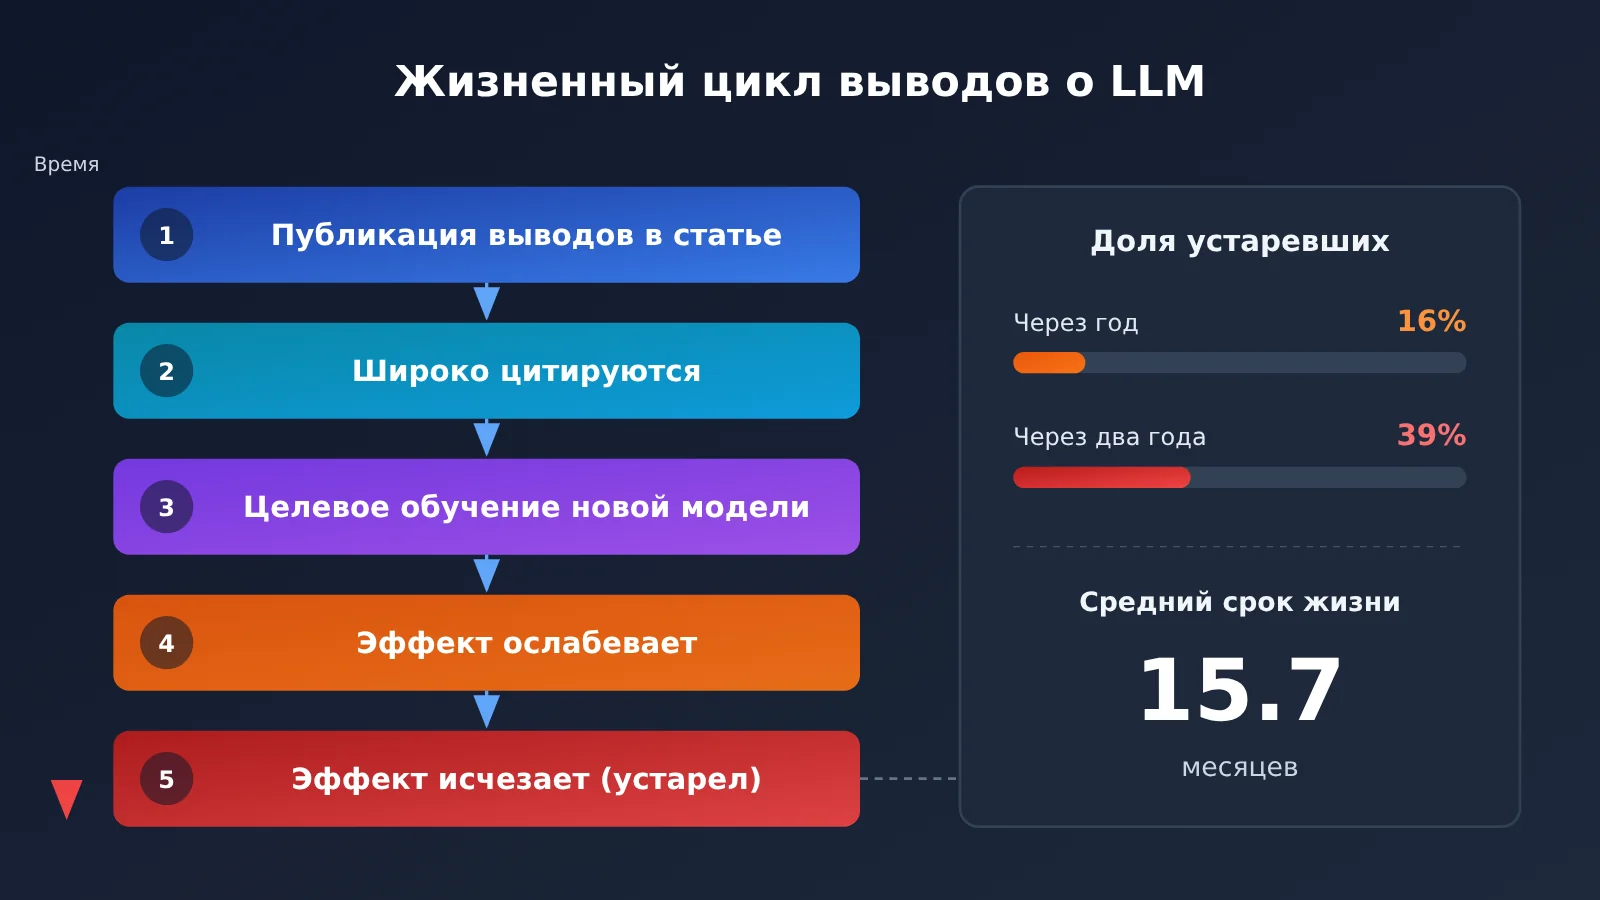
| Устаревание со временем | Через год устарели 16% выводов, через два года — уже 39% | Чем старше вывод, тем важнее перепроверить его |
| Различия между моделями одного поколения | У моделей, выпущенных в июле–сентябре 2026 года, число устаревших выводов варьировалось от 11 до 30 | По дате выпуска нельзя судить о возможностях модели |
Два ключевых вывода об устаревании выводов об LLM
Первый важный момент — что именно означает «устаревание». В исследовании вывод считается устаревшим, если эффект, на котором он основан, в новых моделях практически исчез, а не просто стал менее выраженным. Ещё 34% выводов «заметно ослабли»: проблема по-прежнему существует, но её масштаб уже далеко не так велик, как описывалось в исходной работе. В сумме это означает, что почти восемь из десяти популярных выводов уже нельзя в прежнем виде применять к сегодняшним моделям.
Второй важный момент — «срок жизни» вывода сильно зависит от его типа. Быстрее всего устаревают выводы об ограничениях возможностей — о том, чего модель «не умеет делать». А выводы о предпочтениях — о том, как модель «склонна поступать», — сохраняются дольше. Исследователи объясняют это так: у ошибок, связанных с возможностями, обычно есть «правильный ответ», поэтому разработчики могут поставить чёткую цель обучения и оптимизировать модель. У предпочтений и склонностей стандартного ответа нет, поэтому «исправить» их сложнее.
Какие выводы об LLM устаревают быстрее всего
Чтобы расставить приоритеты повторной проверки, сначала нужно понять, к какому типу относится вывод. В таблице ниже типичные выводы из исследовательского обзора разделены на две категории: «быстро устаревающие» и «относительно устойчивые».
| Тип вывода | Типичные примеры | Статус в исследовании | Приоритет повторной проверки |
|---|---|---|---|
| Недостатки рассуждений и способностей | Подсчёт букв в слове strawberry, арифметика в непривычных системах счисления, потеря информации из середины длинного контекста, отказ от правильного ответа после возражения пользователя | Из 9 выводов о рассуждениях 5 устарели, ни один не сохранился в прежнем виде и не усилился | Максимальный: перед цитированием повторная проверка обязательна |
| Фактическая точность и галлюцинации | Выдуманные ссылки на научные публикации | У некоторых моделей частота снизилась почти до 0, у отдельных моделей остаётся высокой | Высокий: различия огромны, каждую модель нужно проверять отдельно |
| Комбинационное рассуждение | Вопросы с двухшаговым рассуждением, «проклятие обратного порядка», противоречивые ответы на парные вопросы о времени | Эффект ослаб, но всё ещё обнаруживается | Выше среднего: проблема остаётся, но её масштаб сильно меняется |
| Предпочтения в роли оценщика | Предпочтение собственных ответов, близкие оценки принятых и отклонённых научных статей, влияние формулировок медицинских аннотаций | Сохраняются или усиливаются | Средний: долгосрочный риск, но нужна периодическая проверка |
| Угодливость и поддакивание пользователю | Согласие с точкой зрения пользователя | Такие выводы составляют значительную долю сохранившихся или усилившихся | Средний: приоритетно для клиентской поддержки и приложений-консультантов |
| Тенденции в распределении ответов | Левый политический уклон, высокая схожесть ответов на открытые вопросы, неравномерное распределение генерируемых случайных чисел | Сохраняются или усиливаются | Средний: важно учитывать при генерации контента и выборке |
Стоит уточнить: в основном тексте обзора сказано, что «5 из 9 выводов о рассуждениях устарели, а ни один не сохранился и не усилился», тогда как подпись к рисунку утверждает, что «все 9 эффектов ослабли». В совокупности это, вероятно, означает, что 5 выводов устарели, а остальные тоже ослабли и ни один не сохранился в прежнем виде. Поскольку нам не удалось ознакомиться с полным списком из 50 выводов и методами повторной проверки в оригинальной работе, за точной классификацией следует обращаться к ней.
Почему выводы о предпочтениях LLM сохраняют актуальность дольше
Из 11 выводов, которые сохранили актуальность или получили дополнительное подтверждение, три связаны с использованием LLM в качестве оценщика, ещё три — со склонностью модели угождать пользователю. Остальные касаются политических предпочтений, однообразия ответов на открытые вопросы и неравномерного распределения случайных чисел. У этих проблем есть общая черта: сложно определить, какой ответ считать «правильным», а значит, и устранить их с помощью целенаправленного обучения непросто.
Для команд разработки это означает неочевидный порядок рисков. Проблема, о которой все любят говорить, — «модель не умеет считать буквы» — зачастую уже не актуальна. А вот по-настоящему насторожить должны менее заметные систематические склонности. Если вы используете LLM для автоматической оценки, выставления баллов или рекомендаций, проблемы, связанные с предпочтениями модели, стоит включить в регулярные регрессионные тесты.
Выводы о социальных предубеждениях LLM неоднозначны
Исследователи особо отмечают, что социальные предубеждения меняются по-разному. Смещение в сторону левых политических взглядов сохраняется, гендерные стереотипы и предубеждения, основанные на неявных ассоциациях, ослабли, а предубеждение против носителей афроамериканского варианта английского языка, судя по данным, со временем даже сменилось на противоположное. Это ещё раз показывает: общие утверждения вроде «моделям свойственно определённое предубеждение» имеют смысл только применительно к конкретной модели и конкретному моменту времени.
Почему нельзя судить о результатах LLM по разработчику или дате выпуска
При выборе модели многие команды исходят из простой логики: новая модель обязательно лучше старой, модели одного разработчика показывают похожие результаты, а большая модель работает стабильнее маленькой. Данные исследования прямо опровергают эти предположения.
Показательный пример — тест на выдумывание ссылок на источники. В исходном исследовании Walters и Wilder, проведённом в 2023 году, GPT-3.5 выдумала 55% ссылок. Исследователи из Стэнфорда проверили современные модели с теми же промптами: у GPT-6.1 Sol доля выдуманных ссылок составила 0%, у Claude Sonnet 5.5 — 1%, а у Qwen3.7-Flash, выпущенной в том же 2026 году, — 69%. Это даже больше, чем у GPT-3.5 трёхлетней давности.
Разброс среди моделей, выпущенных в один период, тоже впечатляет. У моделей, вышедших с июля по сентябрь 2026 года, число «опровергнутых» выводов варьировалось от 11 у DeepSeek V4 Pro до 30 у GPT-6.1 Sol. Исследователи прямо отмечают: ни дата выпуска, ни разработчик, ни размер модели не позволяют надёжно предсказать этот показатель.
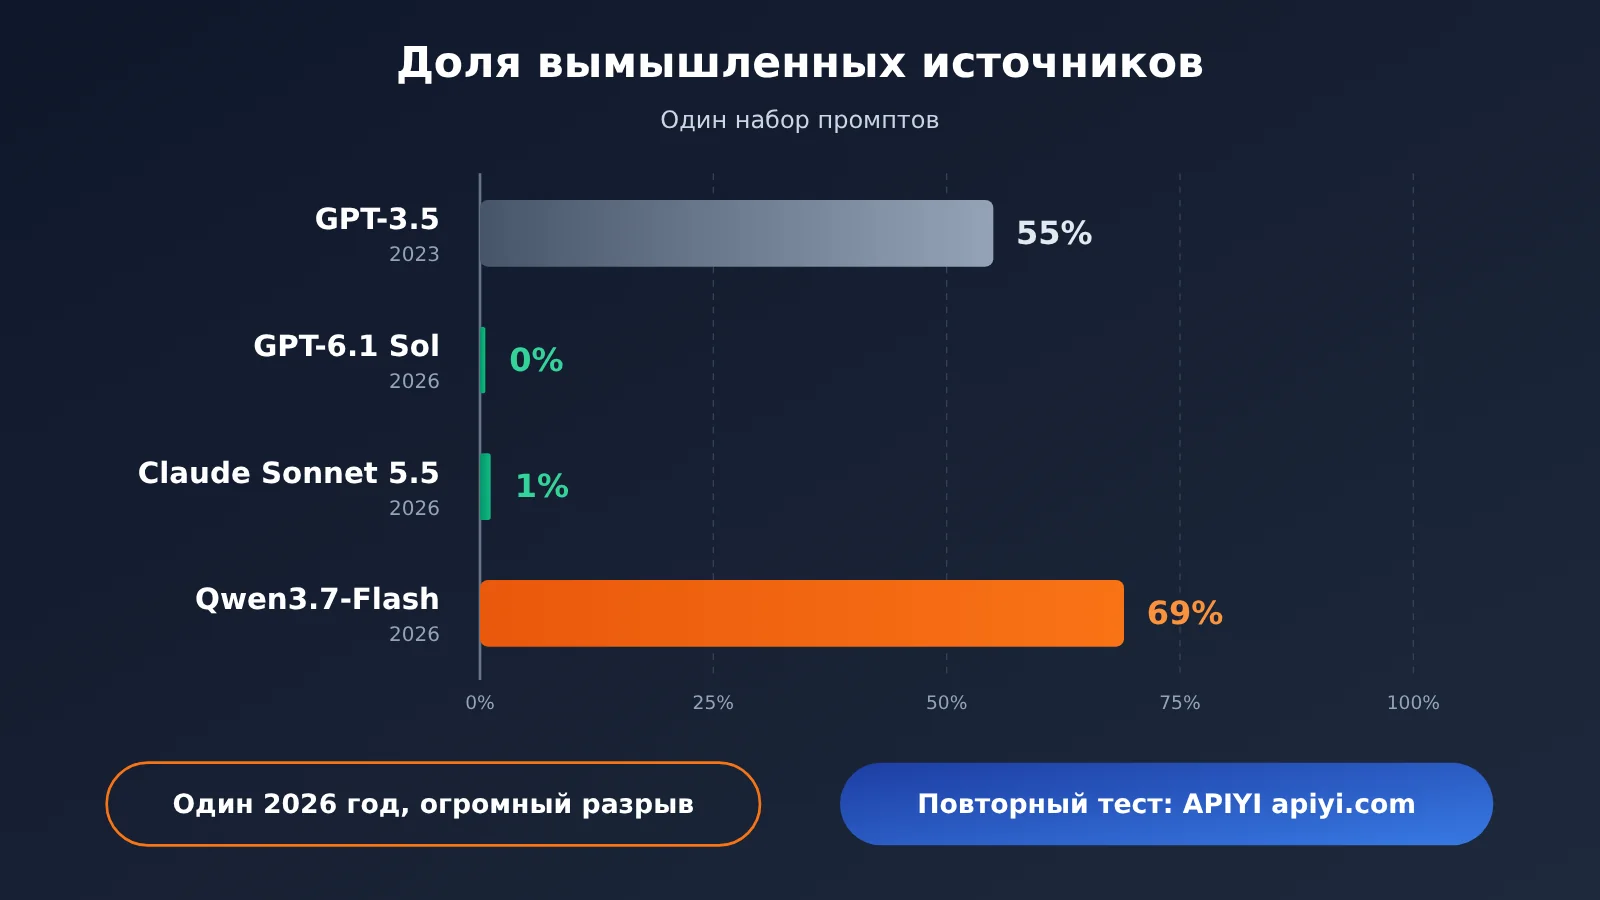
Главная мысль этой диаграммы: модели одного поколения могут показать противоположные результаты в одном и том же тесте. Если вы хотите повторить такое сравнение внутри команды, можно использовать платформу с единым интерфейсом, например APIYI apiyi.com, и проверить несколько моделей-кандидатов с одним набором промптов. Доступные модели уточняйте в официальном списке платформы.
Исследователи также предупреждают: улучшение результатов не означает, что проблема полностью решена. В вопросах с двумя шагами рассуждения, где нужно объединить два известных факта, Claude Sonnet 5.5 ошибалась примерно в 10% случаев, даже если могла правильно ответить на оба промежуточных вопроса по отдельности. В исходной статье для ChatGPT был указан показатель 43%. Число ошибок действительно сильно сократилось, но если ваш продукт зависит от объединения фактов за несколько шагов, эти 10% всё ещё могут привести к инциденту в продакшене.
Как быстро повторно протестировать LLM при выборе: чек-лист из 5 шагов
Исследователи рекомендуют научному сообществу считать эмпирические выводы о LLM не универсальными истинами, а «наблюдениями за конкретной моделью в определённый момент времени». В научных работах стоит указывать модель, версию и дату, а также публиковать промпты и код анализа, чтобы в будущем можно было повторить тесты на новых моделях. Эти рекомендации почти без изменений можно перенести в процесс выбора модели в команде разработки.
Шаг 1. Добавьте метаданные к каждому выводу об LLM
Независимо от того, откуда взят вывод — из статьи, блога, опыта коллег или ваших собственных тестов, — сначала заполните поля из таблицы ниже. Вывод без ключевых данных можно рассматривать только как «гипотезу для проверки», но не как основание для решения.
| Поле метаданных | Что записать | Зачем это нужно |
|---|---|---|
| Название модели | Полное название модели, а не «модель от такого-то производителя» | Модели одного производителя могут сильно различаться |
| Конкретная версия | Номер версии или идентификатор снимка | После обновления модель с тем же названием может работать иначе |
| Дата тестирования | С точностью до дня | Помогает оценить «возраст» вывода с учётом среднего срока его актуальности в 15,7 месяца |
| Полный промпт | Системный промпт, пользовательский ввод, примеры | С другим промптом результат нельзя воспроизвести |
| Параметры вызова | Температура, максимальная длина ответа и т. д. | Параметры сэмплирования влияют на выводы о стабильности |
| Критерии оценки | Что считается успехом, а что — неудачей | Иначе результаты разных тестировщиков нельзя сравнить |
| Размер выборки | Сколько тестовых случаев проверено | Один скриншот диалога не позволяет оценить долю успешных результатов |
Шаг 2: определите приоритет повторного тестирования LLM по типу вывода
Получив вывод, сначала определите, к какой категории он относится. Выводы о недостатках возможностей модели — не умеет считать, ошибается в вычислениях, забывает информацию, меняет ответ при возражении — по умолчанию считайте «скорее всего устаревшими» и обязательно проверяйте заново перед цитированием. Выводы о склонностях и предпочтениях — предпочтение собственных ответов, угодничество, однообразие результатов — по умолчанию считайте «скорее всего всё ещё актуальными» и включайте в долгосрочное регрессионное тестирование.
Учитывайте и возраст вывода: по данным исследования, для выводов старше года вероятность устаревания составляет около 16%, а старше двух лет — уже 39%. Если модель, о которой идёт речь, уже заменена моделью, которую вы рассматриваете, проведите повторный тест независимо от того, насколько известен этот вывод.
Шаг 3: превратите выводы в исполнимые тестовые сценарии для LLM
Утверждение «модель плохо понимает длинные документы» нельзя проверить напрямую — его нужно превратить в конкретный сценарий. Например, поместите важный факт в начало, середину и конец длинного документа, каждый раз задайте вопрос о нём и подсчитайте долю правильных ответов. Или попросите модель дать правильный ответ, затем имитируйте возражение пользователя и подсчитайте, как часто она меняет ответ.
При составлении сценариев старайтесь использовать данные, близкие к вашим реальным бизнес-задачам, а не просто брать упрощённые примеры из научных статей. Модели разных разработчиков вполне могли специально обучать на тех классических задачах, которые в исследовании признали «устаревшими». Успех на таких задачах не гарантирует, что модель справится и с вашими данными.
Шаг 4. Повторно протестируйте все модели-кандидаты на одном наборе промптов
Главное при повторном тестировании — контролировать переменные: используйте один набор промптов, одинаковые параметры и критерии оценки, меняя только модель. Если для каждой модели приходится подключать отдельный SDK и настраивать авторизацию, тестирование может стать слишком трудоёмким для команды.
🚀 Практический совет: APIYI apiyi.com использует единый стандарт OpenAI API и позволяет вызывать более 200 моделей с одним токеном. При смене модели-кандидата достаточно изменить параметр model, оставив промпты и остальные параметры без изменений. Это удобно для сравнительного тестирования. Актуальный список поддерживаемых моделей и версий смотрите в официальном списке платформы.
Шаг 5. Ведите архив выводов о LLM и регулярно их перепроверяйте
Сохраняйте результаты каждого повторного тестирования в отдельной записи. Как минимум укажите исходный текст вывода, метаданные, результаты проверки и дату следующего пересмотра. Учитывая средний срок актуальности в 15,7 месяца, выводы, от которых зависят ключевые бизнес-процессы, стоит проверять раз в квартал или полгода. А при планировании обновления версии модели каждый раз проводите полное повторное тестирование.
| Сценарий | Рекомендуемый охват повторного тестирования | Когда проводить |
|---|---|---|
| Первичный выбор модели | Все выводы, влияющие на решение, и ключевые бизнес-сценарии | Перед рассмотрением выбора |
| Обновление версии модели | Все регрессионные тесты | Перед переключением в продакшене |
| Использование внешних выводов | Только соответствующие выводы | Прежде чем включить их в проектную документацию |
| Повседневная работа | Выводы о предпочтениях модели и сценарии с высоким риском | Раз в квартал или полгода |
| Сбой в продакшене | Возможности, связанные со сбоем | Немедленно |
💡 Совет по выбору: вместо того чтобы сразу спрашивать «Какая модель самая сильная?», сначала определите, какие ошибки наиболее критичны для вашего бизнеса. Затем проверьте модели-кандидаты именно по этим сценариям. Единый интерфейс APIYI apiyi.com позволяет сравнить несколько моделей в рамках одного процесса тестирования и уменьшить число дополнительных переменных на уровне интеграции.
Часто задаваемые вопросы
Q1: Что значит, что вывод об LLM «устарел»?
В этом исследовании Стэнфордского университета «устаревшим» называют эмпирический вывод об LLM, если эффект, на котором он основан, в новых моделях практически исчез. Это отличается от «ослабления»: в таком случае проблема сохраняется, но выражена заметно меньше. Из 50 выводов устарели 44%, а для 34% эффект ослаб.
Q2: Чем выводы об ограничениях возможностей LLM отличаются от выводов о её склонностях?
Выводы об ограничениях описывают, «чего модель не умеет делать»: например, считать буквы, выполнять арифметические действия или сохранять информацию в длинном контексте. Для таких задач есть однозначный правильный ответ, а проблемы проще устранить с помощью целевого обучения, поэтому такие выводы устаревают быстрее всего. Выводы о склонностях описывают, «как модель предпочитает поступать»: например, отдавать предпочтение собственным ответам или поддакивать пользователю. Стандартного ответа здесь нет, поэтому такие склонности сохраняются дольше.
Q3: Когда было опубликовано исследование об устаревании выводов об LLM?
Публикация об исследовании вышла 3 ноября 2026 года. В исследовании протестировали 20 моделей от 8 разработчиков, выпущенных с июля 2024 года по сентябрь 2026 года. Поскольку модели быстро развиваются, конкретные данные в этой статье тоже могут устареть. Перед их использованием рекомендуется обратиться к оригинальной научной работе.
Q4: Каким командам особенно важно повторно тестировать каждую версию LLM?
В первую очередь это касается следующих случаев:
— **Команды, которые выбирают или меняют модель**: важно не исключать кандидатов из-за представлений об их недостатках двухлетней давности
— **Команды, которые используют LLM для оценки и выставления баллов**: склонность предпочитать собственные ответы и поддаваться влиянию формулировок по-прежнему сохраняется
— **Приложения, для которых важна фактическая точность**: доля вымышленных библиографических ссылок у моделей одного поколения варьируется от 0% до 69%
— **Диалоговые продукты для поддержки клиентов и консультаций**: склонность поддакивать и угождать пользователю нужно отслеживать постоянно
Q5: Как недорого провести повторное тестирование на нескольких LLM?
Главное — использовать единый интерфейс доступа, чтобы было легко менять только модель, не затрагивая остальные переменные:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ
2. В официальном списке моделей проверьте доступность нужных моделей и версий
3. Используя один и тот же набор промптов и параметров, последовательно вызывайте модели, меняя только параметр model, и записывайте результаты и метаданные
Так можно сосредоточиться на разработке тестовых сценариев, а не на повторном подключении к интерфейсам разных поставщиков.
Q6: Можно ли вместо повторного тестирования просто посмотреть результаты новой модели в рейтингах?
Полностью полагаться на них не стоит. Исследование показало, что дата выпуска, разработчик и размер модели не позволяют надёжно предсказать её поведение в конкретных ситуациях. Модели, выпущенные примерно в одно время, могут сильно отличаться друг от друга. Рейтинги подходят для предварительного отбора, но окончательное решение лучше принимать по результатам повторного тестирования на ваших собственных бизнес-данных.
Q7: Какие ограничения есть у самого исследования LLM?
Во-первых, полный список из 50 выводов и методы повторного тестирования нужно смотреть в оригинальной статье: вторичные публикации не охватывают всех деталей. Во-вторых, формулировки выводов о способности к рассуждению в тексте публикации и в подписях к рисункам различаются, поэтому ориентироваться нужно на первоисточник. Наконец, результаты исследования тоже отражают наблюдения за «конкретными моделями в конкретный момент времени» и, по логике самих исследователей, со временем устареют.
Как устаревают выводы о LLM: главное
- Доля устаревших выводов высока: из 50 популярных выводов об LLM 44% уже устарели, а 34% заметно утратили актуальность
- Срок актуальности короток: выводы, для которых его удалось оценить, оставались актуальными в среднем всего 15,7 месяца; через два года устаревают почти 40%
- Выводы о недостатках чаще устаревают: утверждения о трудностях с подсчётом букв, арифметикой и потерей информации в длинном контексте стоит перепроверять в первую очередь
- Поведенческие склонности сохраняются дольше: предпочтение собственных ответов, угодливость и однообразие результатов стоит включить в долгосрочные регрессионные тесты
- Нельзя судить по производителю или дате выпуска: даже среди моделей 2026 года доля вымышленных ссылок варьируется от 0% до 69%
- Метаданные необходимы: без названия модели, версии, даты или промпта воспроизвести вывод будет сложно
- Единый интерфейс снижает затраты на повторное тестирование: с помощью APIYI apiyi.com можно сравнивать модели, меняя только параметр model
Итоги
Выводы о LLM устаревают в среднем за 15,7 месяца. Эти данные напоминают нам о трёх вещах:
- У выводов есть срок годности: любое утверждение об LLM стоит воспринимать как наблюдение за конкретной моделью в конкретный момент времени
- Тип вывода определяет приоритет: выводы о недостатках возможностей стоит перепроверять в первую очередь, а предпочтения и склонности моделей — отслеживать в долгосрочной перспективе
- Версия решает всё: ни разработчик, ни дата выпуска, ни размер модели не заменят тестирование конкретной версии
В следующий раз, когда на встрече по выбору модели услышите «эта модель плохо справляется с X», задайте три вопроса: какая версия? Когда её тестировали? Сохранился ли промпт? Если ответов нет, добавьте утверждение в список для повторной проверки.
Рекомендуем подключить модели-кандидаты к единому процессу тестирования через APIYI apiyi.com и быстро перепроверить их на одном наборе промптов. Список доступных моделей уточняйте в официальном перечне.
📚 Источники
- THE DECODER — Rapid LLM development is outrunning the research meant to explain it, study finds: публикация об исследовании Стэнфорда, посвящённом устареванию выводов об LLM
- Ссылка:
the-decoder.com/rapid-llm-development-is-outrunning-the-research-meant-to-explain-it-study-finds -
Описание: содержит ключевые данные, в том числе об устаревании 44% выводов, среднем сроке их актуальности в 15,7 месяца, примерах выдуманных ссылок и различиях между моделями одного поколения
-
Оригинальная научная работа Owen Queen и James Zou: исследование Стэнфорда, в котором авторы повторно проверили 50 выводов об LLM
- Ссылка: найдите работу на академических поисковых платформах по именам авторов и названию
- Описание: авторы этой статьи не смогли получить полный текст работы; список из 50 выводов и методы повторного тестирования уточняйте по оригиналу
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами на главной странице сайта APIYI apiyi.com; дополнительные материалы по подключению моделей доступны в документации на docs.apiyi.com