Примечание автора: разберём структуру расходов на токены в длительных задачах агента, выясним, почему основная доля приходится на входные токены, и как организовать контекст, чтобы чаще использовать кэш префиксов.
Многие команды после внедрения многошаговых агентов в продукт обнаруживают проблему только в конце месяца, когда получают счёт: пользователь отправил всего один запрос, а токенов израсходовано в десятки раз больше, чем при обычном диалоге. Первая реакция обычно такая: «Модель отвечает слишком многословно» — и команда начинает сокращать длину ответов. Но на самом деле основная часть расходов приходится на входные токены, прежде всего на историю контекста, которую приходится заново передавать на каждом шаге.
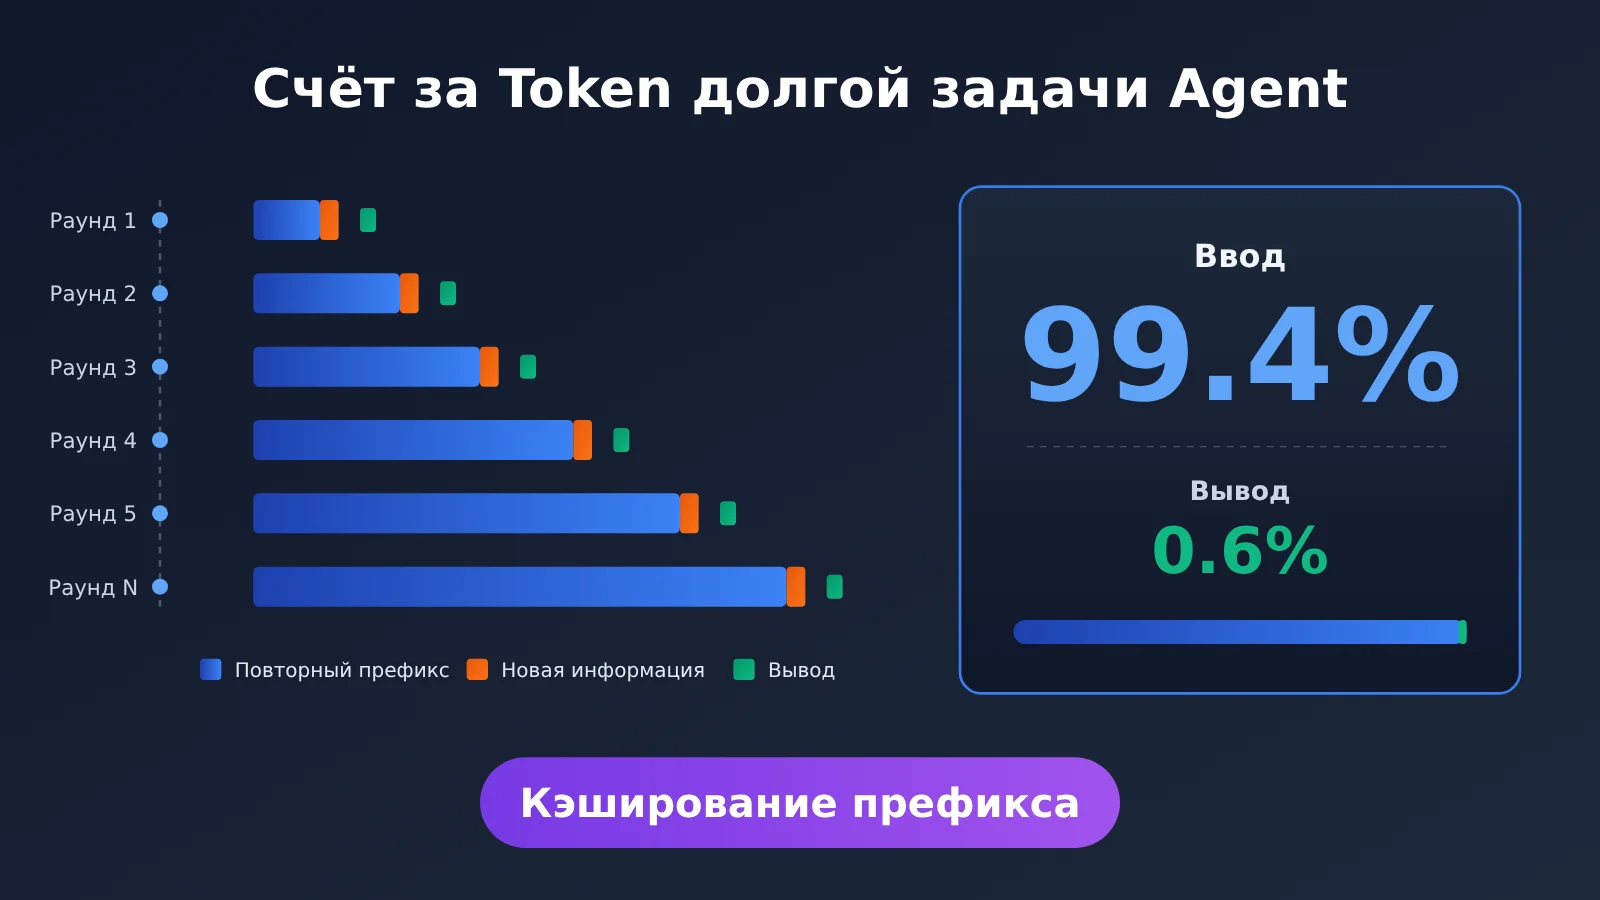
Это не просто предположение. В недавних открытых публикациях инженеров приведены вполне конкретные данные: в китайских продакшен-сценариях один пользовательский запрос запускает в среднем около 7,2 вызова модели; в цепочке из 50 шагов входные токены составляют около 99,4%, а выходные — всего около 0,6%. Команды, разрабатывающие движки инференса, описывают нагрузку от агентов похожим образом: длинный префикс, короткий ответ и много повторных вызовов.
Главное: прочитав эту статью, вы разберётесь в структуре расходов на токены для длительных задач агента, поймёте, почему кэширование префиксов помогает снизить затраты, и узнаете 5 способов организации контекста, которые можно применить на стороне приложения.
Главное о расходе токенов в длительных задачах агента
Для начала сведём выводы в таблицу, а в следующих разделах разберём их подробнее.
| Тезис | Пояснение | Чем это полезно |
|---|---|---|
| Число вызовов растёт | На один запрос пользователя приходится в среднем около 7,2 вызова модели, а сложные задачи нередко занимают больше 50 шагов | Оценивать расходы нужно по задачам, а не по запросам |
| Входные токены занимают почти весь объём | В цепочке из 50 вызовов на вход приходится около 99,4% токенов, на выход — около 0,6% | Чтобы сократить расходы, в первую очередь стоит оптимизировать входные данные |
| Главная причина — повторение контекста | На каждом шаге история передаётся заново, и плата за одно и то же содержимое взимается снова | Помогает определить настоящий источник расходов |
| Префиксный кеш позволяет повторно использовать данные | Если одинаковая часть префикса найдена в кеше, её не нужно заново обрабатывать на этапе prefill | Контекст со стабильной структурой обходится дешевле |
| Структура влияет на попадание в кеш | Сохраняйте промпт и структуру инструментов неизменными, размещайте переменные данные в конце и вовремя сжимайте историю | Снизить расходы можно и без смены модели |
Подробнее о расходе токенов в длительных задачах агента
Главное отличие агента от обычного чата — работа в цикле. Например, чтобы создать презентацию PPT, системе нужно прочитать материалы, составить план, подготовить содержимое слайдов, создать презентацию с помощью инструментов и проверить результат. Для пользователя это одна задача, но внутри системы она состоит из нескольких раундов рассуждений и вызовов инструментов. При этом на каждом шаге контекст может считываться заново, а если результат не подходит, приходится возвращаться и вносить правки.
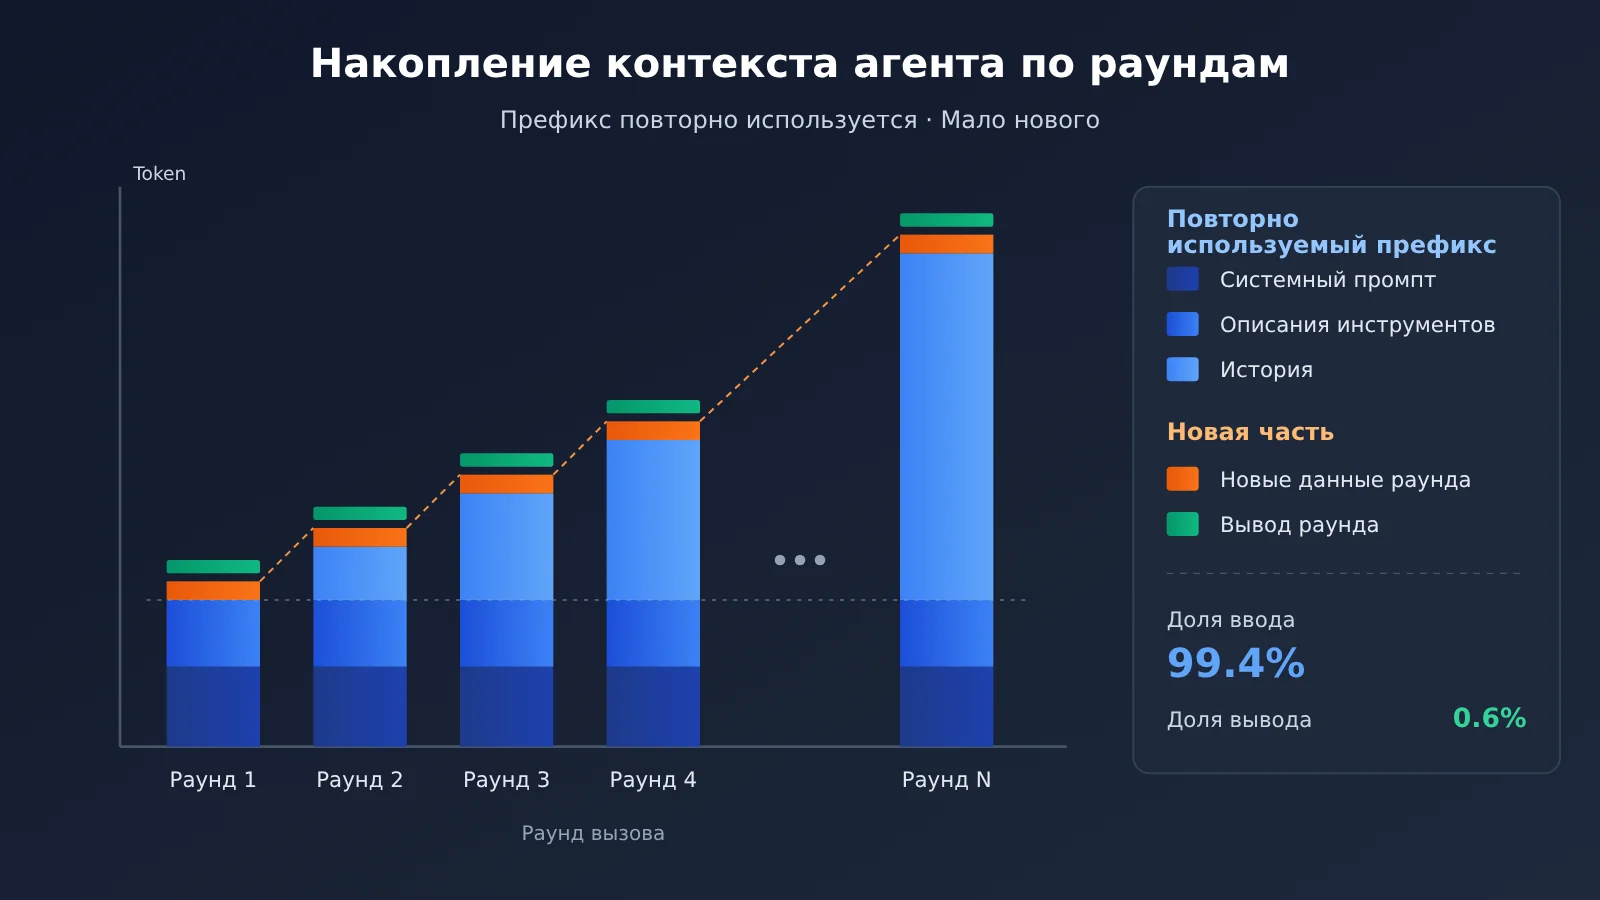
При каждом вызове модель получает «системный промпт + определения инструментов + всю накопленную историю + новую информацию текущего шага». История становится всё длиннее, хотя новых данных за один шаг добавляется немного. За десятки раундов один и тот же префикс оплачивается десятки раз. Так и набираются 99,4% входных токенов.
Почему в длительных задачах агента входных токенов гораздо больше, чем выходных
Если посмотреть со стороны движка инференса, картина становится понятнее. В докладе TokenSpeed в качестве примера приводится агент для написания кода: модель постоянно рассуждает, вызывает инструменты, получает результаты и снова рассуждает. Весь процесс состоит из множества коротких запросов. Уже первый запрос может содержать несколько десятков тысяч токенов префиксного контекста, а на каждом последующем шаге модель обычно выдаёт лишь несколько сотен токенов.
В таблице ниже мы сравнили нагрузку от чата и длительных задач агента, чтобы было проще определить, к какому типу относится ваше приложение.
| Критерий | Традиционная нагрузка чата | Нагрузка длительных задач агента |
|---|---|---|
| Формат запросов | Один вопрос — один полный ответ | Цикл коротких запросов с вызовами инструментов |
| Длина префикса | Обычно небольшая | С самого начала может достигать десятков тысяч токенов и растёт с каждым шагом |
| Вывод за один шаг | Относительно длинный | Обычно всего несколько сотен токенов |
| Повторное использование контекста | После однократной загрузки освобождается | Один и тот же префикс многократно передаётся в рамках задачи |
| Основная составляющая затрат | Значимы и входные, и выходные токены | Подавляющую часть составляют входные токены, особенно повторяющийся префикс |
Как работает кэширование префикса в длительных задачах агента
Движок инференса обрабатывает запрос в два этапа: на этапе prefill он вычисляет весь входной текст и создаёт KV Cache, а на этапе decode генерирует выходные токены по одному. В задачах агента префикс длиной в десятки тысяч токенов приходится обрабатывать на этапе prefill на каждом шаге — именно эти вычисления и создают затраты. Если тот же префикс уже был обработан, а результат остался в кэше, его можно использовать повторно и избежать этих вычислений.
Команды, разрабатывающие движки инференса, считают долю повторного использования KV Cache одним из ключевых факторов стоимости инференса. В докладе утверждается, что у DeepSeek этот показатель превышает 99%, тогда как у большинства систем в индустрии сейчас он составляет от 70% до 80%. При нагрузке от агентов доля попаданий в кэш префикса на этапе prefill обычно превышает 90%: при попадании нужно дополнительно вычислить лишь несколько сотен токенов.
Есть ещё одна деталь, которую легко упустить: сопоставление префикса с кэшем происходит последовательно с самого начала. На раннем этапе TokenSpeed позаимствовал подход SGLang и использовал Radix Tree для управления кэшем префиксов. Каждый узел дерева соответствовал последовательности токенов, а сопоставление запроса начиналось с корня. Позже команда перешла на архитектуру Flat KV, но повторное использование по-прежнему происходит на уровне логических блоков фиксированного размера — по 128 токенов. Для разработчика приложения вывод простой: если хотя бы один токен в начале отличается, последующее содержимое повторно использовать не получится.
Как организовать контекст, чтобы повысить частоту попаданий в кеш префикса при длительных задачах агента
Когда понятно, как происходит сопоставление с кешем, направление оптимизации становится очевидным: нужно сделать начало каждого запроса как можно длиннее и сохранять его неизменным. Команда WorkBuddy фиксирует структуру промпта и инструментов, помещает изменяющуюся информацию в конец контекста, а когда он становится слишком длинным — сжимает историю. Разберём этот подход в виде пяти практических рекомендаций.
| Приём | Что делать | Типичная ошибка |
|---|---|---|
| 1. Зафиксировать системный промпт | Сохранять системный промпт без изменений вплоть до каждого слова, обновления выпускать централизованно | Вставлять в начало текущее время, имя пользователя или случайные примеры |
| 2. Зафиксировать структуру инструментов | Сохранять порядок списка инструментов и описания параметров | Добавлять и удалять инструменты на каждом шаге или менять порядок сериализации |
| 3. Помещать изменяющуюся информацию в конец | Добавлять в конец временные метки, результаты текущих наблюдений и динамическое состояние | Указывать «текущий прогресс» в начале системного промпта |
| 4. Только дополнять историю, не переписывая её | Сохранять отправленную историю без изменений и добавлять новые данные в конец | На каждом шаге заново форматировать или переставлять предыдущие сообщения |
| 5. Периодически сжимать историю | Когда контекст становится слишком длинным, сжать историю в контрольной точке и продолжить её дополнять | На каждом шаге заново создавать краткое изложение, из-за чего префикс постоянно меняется |
Длительные задачи агента: фиксированная структура промпта и инструментов
Пункты 1 и 2 проще всего упустить из виду. Многие фреймворки добавляют текущую дату в системный промпт или динамически выбирают инструменты на каждом шаге. В обоих случаях начало запроса меняется от раунда к раунду, и кеш префикса перестаёт срабатывать с первого же токена. Надёжнее оставить в системном промпте только правила и роль, а дату и другие переменные данные поместить в конце как обычное сообщение. Полный набор инструментов стоит перечислить один раз, а в промпте указать, какие из них можно использовать на текущем этапе, не меняя сам список.
Также стоит обратить внимание на сериализацию. Если порядок полей JSON в одном и том же определении инструментов различается между процессами, на уровне байтов это будут два разных префикса. Рекомендуется фиксировать порядок полей перед отправкой, а в логах записывать хеш префикса. Это поможет разобраться, почему кеш не сработал, хотя вроде бы ничего не менялось.
Длительные задачи агента: компромисс между сжатием истории и повторным использованием кеша
В пункте 5 есть важный компромисс. Сжатие истории уменьшает длину входных данных, но при этом меняет префикс, поэтому в текущем раунде кеш неизбежно промахнётся. Если сжимать историю на каждом раунде, повторно использовать кеш не получится. Разумнее задать порог: например, сжимать историю, когда контекст достигнет определённой длины или завершится подзадача. Сжатая версия станет новым стабильным префиксом, к которому дальше можно только добавлять данные, не переписывая его.
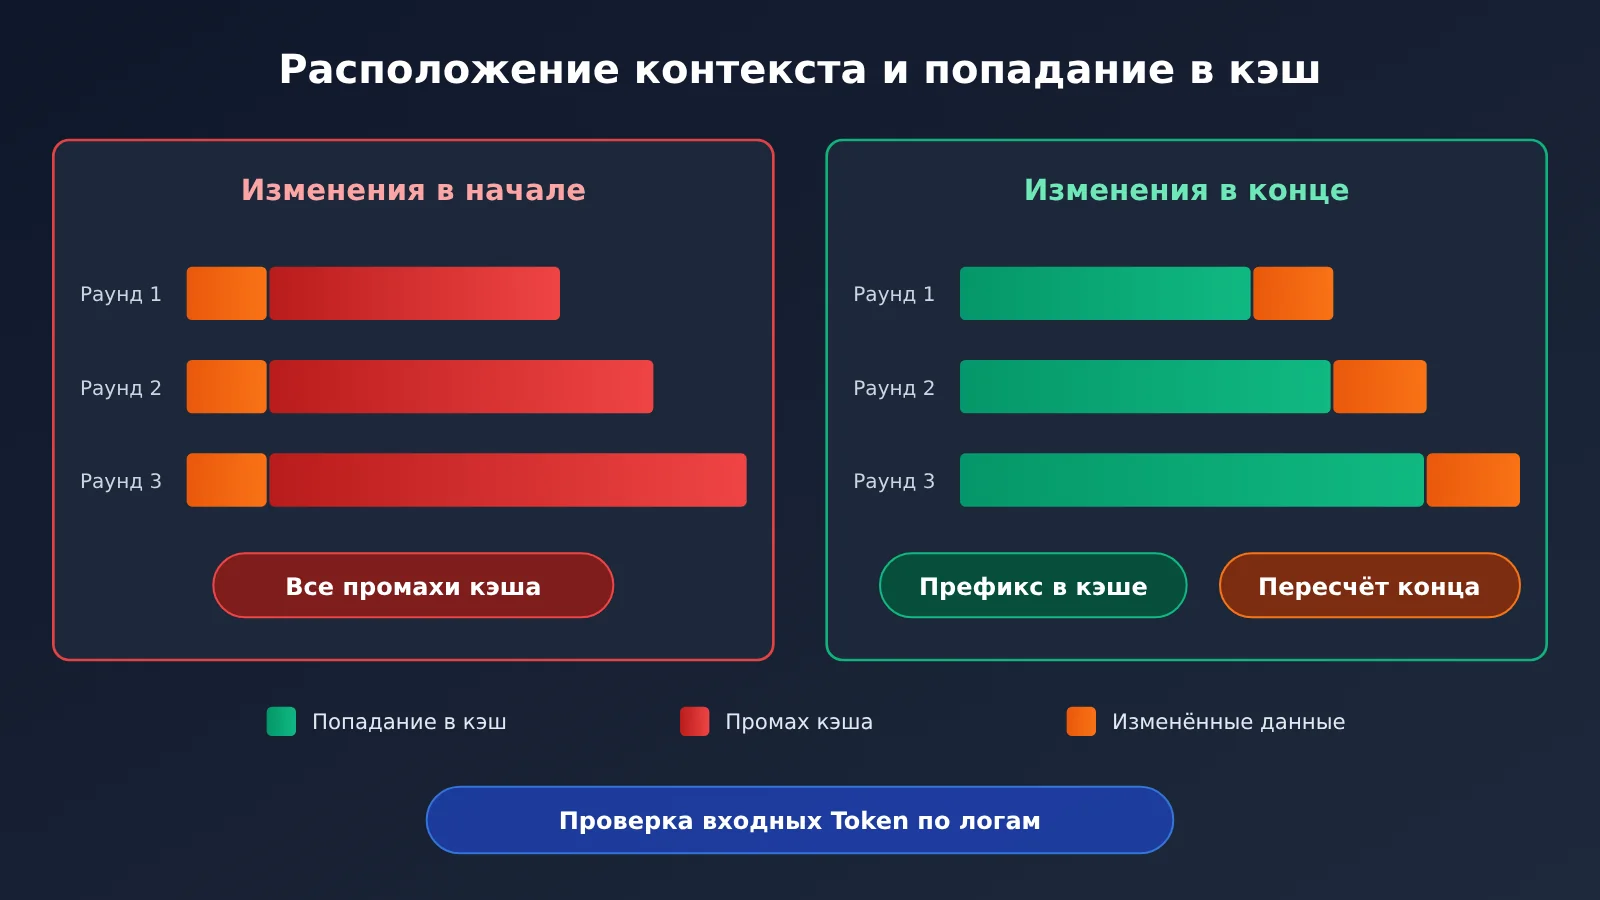
Для отдельного запроса разница между двумя вариантами на схеме почти незаметна. Но в длительной задаче на десятки раундов она ощутимо скажется на счёте. Чтобы понять, какой вариант используется в вашем приложении, проще всего проследить в логах вызовов, как меняется количество входных токенов от раунда к раунду. APIYI apiyi.com предоставляет единый биллинг, статистику использования и логи вызовов. Данные по нескольким моделям можно сравнить в одном месте — это удобно для анализа структуры расходов.
Как быстро оптимизировать расходы на токены в длительных задачах агента
В этом разделе не будет кода — только последовательность практических шагов. Выполняйте их по порядку.
Шаг 1. Разбейте расходы на токены по задачам
- Присвойте каждой задаче пользователя ID и записывайте его в лог при каждом вызове модели в рамках этой задачи.
- Из поля
usageкаждого ответа записывайте количество входных и выходных токенов. Некоторые поставщики также отдельно возвращают количество токенов, для которых было попадание в кэш; названия полей уточняйте в официальной документации. - Сведите по каждой задаче три показателя: количество вызовов, соотношение входных и выходных токенов, долю попаданий в кэш.
Если вы используете модели разных поставщиков, формат и состав логов часто различаются. Подключив модели через APIYI, вы сможете просматривать детализацию расхода и историю вызовов в одной консоли. Сопоставьте эти данные с записанными ID задач — и получите полную картину: сколько стоила каждая задача и на каком этапе возникли расходы.
Шаг 2: найдите место, где нарушается префикс
- Возьмите два последовательных запроса в рамках одной задачи и сравните по частям системный промпт, определения инструментов и историю сообщений. Проверьте, совпадают ли они посимвольно.
- Обратите внимание на расположение динамических полей: временных меток, случайных чисел и состояния пользователя.
- Проверьте, стабилен ли порядок сериализации определений инструментов и сообщений в разных запросах.
Шаг 3: внесите изменения с учётом 5 рекомендаций и повторите тест
- Перенесите динамическое содержимое в конец, зафиксируйте системный промпт и список инструментов.
- Задайте порог сжатия истории и выполняйте сжатие в контрольных точках, а не на каждом шаге.
- Запустите одну и ту же выборку тестовых задач на версиях до и после изменений. Сравните количество входных токенов и долю попаданий в кэш для каждой задачи.
🚀 Совет для начала: сравнивайте результаты до и после изменений обязательно на одной и той же выборке задач и одной и той же модели. Иначе данные не будут показательными. Благодаря единому интерфейсу APIYI при повторном тестировании с другой моделью не нужно заново адаптировать интерфейс, а статистика использования собрана в одном месте. Это помогает отдельно оценить влияние оптимизации структуры и различий между моделями.
Ограничения расчёта затрат
WorkBuddy приводила такой расчёт: при её масштабе задач и тарифных ценах флагманского уровня TokenHub стоимость одной задачи при доле попаданий в кэш 90% может снизиться примерно с 21,06 до 3,36 юаня. Важно учитывать, что эти цифры относятся к конкретной длине контекста и конкретным ценовым условиям. Полные условия не раскрыты, поэтому перепроверить расчёт невозможно. Напрямую применять его к своему приложению тоже нельзя.
| Фактор | Почему он влияет на результат | Что нужно проверить |
|---|---|---|
| Длина контекста | Чем длиннее префикс, тем больше экономия от повторного использования кэша | Среднюю длину префикса в своих задачах |
| Тарификация кэша | Скидка на закэшированную часть зависит от поставщика | Цены на кэширование в официальной документации целевой модели |
| Условия срабатывания кэша | Минимальная длина, срок действия и другие правила различаются | Правила срабатывания и истечения срока действия кэша в официальной документации |
| Интервал между вызовами | Если между двумя раундами проходит слишком много времени, срок действия кэша может истечь | Соответствует ли время выполнения инструмента сроку действия кэша |
| Число шагов задачи | Чем больше шагов, тем сильнее накапливается объём повторяющихся префиксов | Распределение числа шагов в реальных задачах |
Дополнительные способы снизить расходы на токены в длительных задачах агента
Помимо структуры контекста, в том же докладе упоминались две стратегии на стороне приложения, которые можно использовать вместе с кешированием префикса.
- Выбирать модель для каждого шага: по словам команды WorkBuddy, около 80% простых шагов можно поручить лёгкой модели, снизив стоимость одной задачи примерно на 57%. Для сбора материалов или преобразования форматов флагманская модель нужна не всегда.
- Учитывать причину сбоя: при тайм-ауте, отклонении запроса или сбое у провайдера можно ограниченно повторить запрос, скорректировать контекст или переключить модель — в зависимости от причины. Бесконечные повторы приведут к тому, что за один и тот же длинный префикс придётся платить снова и снова.
Важно помнить: при смене модели используется другой кеш, поэтому повторное использование префикса придётся начинать с нуля. При маршрутизации запросов лучше оставлять последовательные шаги одной подзадачи на одной модели, а переключаться на границах подзадач.
Частые вопросы FAQ
Q1: Что такое кеширование префикса в длительных задачах агента?
При кешировании префикса сервис инференса сохраняет уже вычисленный входной префикс (KV Cache). Если следующий запрос начинается с того же префикса, сервис использует сохранённые данные и не тратит ресурсы на повторный prefill. В каждом раунде агент передаёт большую часть той же истории, поэтому кеширование особенно полезно.
Q2: Чем кеширование префикса отличается от сжатия истории контекста?
Кеширование префикса не уменьшает объём входных данных, а лишь удешевляет обработку повторяющейся части. Сжатие истории сокращает входные данные, но меняет префикс, поэтому в текущем раунде кеш не сработает. Эти подходы стоит сочетать: обычно только добавлять новые данные, чтобы кеш срабатывал, а в контрольной точке сжимать историю.
Q3: Доля входных токенов в 99,4% характерна для всех агентов?
Не обязательно. Эта цифра взята из описания цепочки вызовов в 50 шагов. В задачах с меньшим числом шагов и более длинными ответами в каждом раунде доля входных токенов будет ниже. Но если задача устроена по схеме «длинный префикс, короткий ответ, много раундов», входные токены обычно составляют основную часть. Рекомендуем проверить это по собственным логам.
Q4: Для каких сценариев работы агентов особенно важно оптимизировать кеширование префикса?
— **Агенты для написания кода**: большой контекст репозитория, частые циклы чтения файлов, изменения кода и запуска тестов
— **Создание документов или презентаций PPT**: после чтения материалов страницы создаются поочерёдно, а префикс во многом повторяется
— **Агенты для анализа данных**: структура таблиц и описание показателей остаются неизменными, в каждом раунде добавляются только результаты запросов
Q5: Как быстро разобраться в соотношении входных и выходных токенов в приложении?
Проще всего собрать данные usage по каждому раунду и сгруппировать их по ID задачи. Если приложение использует несколько моделей, для их вызова можно использовать единую платформу APIYI apiyi.com. На ней доступны статистика использования и логи вызовов, что позволяет смотреть соотношение входных и выходных токенов по моделям и периодам. Сведения о поддержке кеширования промптов и тарифах для каждой модели уточняйте в документации платформы.
Q6: Какие ограничения есть у кеширования префикса?
— Условия срабатывания, например минимальная длина и срок действия кеша, различаются у разных поставщиков — проверяйте их в официальной документации
— Если инструмент выполняется слишком долго, срок действия кеша может истечь до следующего раунда
— Смена модели или изменение системного промпта полностью сбрасывает кеш
— Скидка на обработку кешированной части зависит от модели, поэтому фактическую экономию нужно проверять на практике
Ключевые выводы: расход токенов в длинных задачах агента
- Стоимость считайте на уровне задачи: один запрос включает в среднем около 7,2 вызова, а длинная задача может занимать больше 50 шагов.
- Основной расход — входные токены: в цепочке из 50 шагов на них приходится около 99,4% токенов, поэтому сокращение ответа мало помогает.
- Кэш ищет совпадение с самого начала: если в начале отличается хотя бы один токен, последующее содержимое нельзя использовать повторно.
- Структура важнее модели: держите промпт и структуру инструментов постоянными, а меняющуюся информацию помещайте в конец.
- Сжимайте контекст в нужный момент: делайте это на контрольных точках, а не переписывайте префикс после каждого шага.
- Не переносите чужие расчёты на свои задачи: опубликованные оценки зависят от конкретной длины контекста и цен — проверяйте их на своих данных.
- Сначала наблюдайте, потом оптимизируйте: используйте статистику потребления и журналы вызовов APIYI, чтобы разобраться в структуре расходов.
Итоги
Главное о расходе токенов в длинных задачах агента:
- Структура расходов: основные затраты связаны с историей контекста, которая повторно передаётся на каждом шаге. Входные токены составляют подавляющую часть расхода.
- Как снизить затраты: кэширование префикса избавляет от повторных вычислений на этапе prefill. Доля попаданий в кэш зависит от структуры контекста.
- Что делать на практике: сохраняйте промпт и инструменты неизменными, помещайте меняющуюся информацию в конец, только дополняйте историю и периодически сжимайте её. Дополнительно подбирайте модель для каждого шага.
Для начала потратьте неделю на анализ журналов в разрезе задач: выясните долю входных токенов и частоту попаданий в кэш. Затем последовательно примените пять описанных в статье приёмов. Если вы используете несколько моделей, APIYI apiyi.com поможет подключить их через единый интерфейс и просматривать статистику потребления и записи вызовов в одном месте. Так вы сможете оценить результат каждой оптимизации на одних и тех же данных.
📚 Источники
- Создание нового поколения движков инференса LLM для агентных рассуждений: обзор выступления TokenSpeed на AICon 2026 в Шэньчжэне
- Ссылка:
infoq.cn/article/YwAayF1ylWb7oN4P0lyC -
Описание: особенности агентной нагрузки — «длинный префикс, короткий ответ», повторное использование KV-кеша и устройство кеша префиксов
-
От вызова модели к выполнению задачи: как MaaS входит в продакшен агентных систем: обзор специальной сессии Tencent Cloud о MaaS
- Ссылка:
infoq.cn/article/zZutPTX8bsr6NWQYNC3A - Описание: данные WorkBuddy о количестве вызовов, доле входных токенов, кешировании префиксов и маршрутизации моделей
Автор: техническая команда APIYI
Технические вопросы: по вопросам вызова нескольких моделей и анализа их использования обращайтесь к нам через APIYI apiyi.com. Дополнительные материалы доступны в центре документации docs.apiyi.com