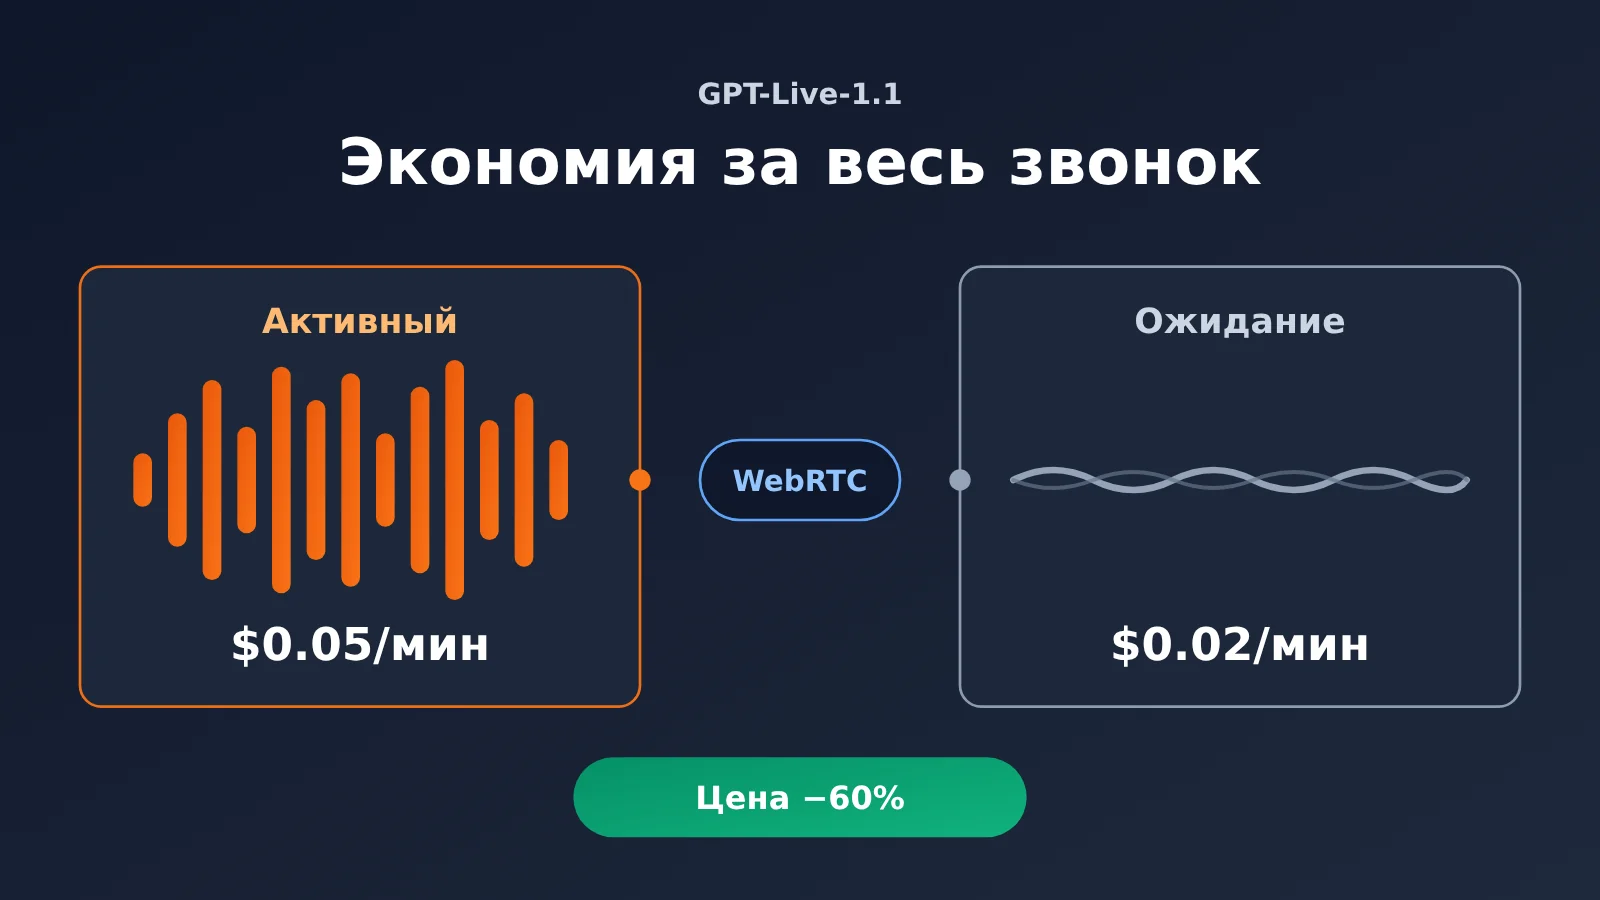
Примечание автора: когда сессия WebRTC в GPT-Live-1.1 переходит в режим ожидания, цена голоса падает с $0.05 до $0.02 за минуту. В этой статье — как это настроить, как проверить расчёты и сколько реально экономит один звонок.
Кратко в одном предложении: после того как сессия WebRTC в GPT-Live-1.1 выполняет нужные условия и переходит в режим ожидания, цена голоса снижается с $0.05 до $0.02 за минуту. Сколько именно вы сэкономите, зависит от того, какую долю времени сессия активна, а какую — в ожидании, а также от расхода на бэкенд-модель и инструменты.
У вывода есть оговорка. Сниженную цену — $0.02 за минуту в режиме ожидания — можно получить только в сессии WebRTC, где настроен режим ожидания и推理 приостановлен. При этом условии доля экономии примерно равна «доля времени в режиме ожидания × 60%». Если в сессии кто-то говорит непрерывно или используется основное соединение WebSocket либо SIP, это снижение цены вам практически не поможет. Кроме того, инференс на бэкенде и вызовы инструментов тарифицируются отдельно, и в долгих звонках эта часть часто выходит дороже самой голосовой связи.
Это не новостная заметка с пересказом прайс-листа. Ниже — разбор условий тарификации и полей конфигурации по официальной документации OpenAI плюс методика расчёта, по которой можно сверяться со счётом. Все числовые примеры в статье — гипотетические, они нужны только для иллюстрации способа расчёта и не отражают реальный счёт.
Термины режима ожидания WebRTC в GPT-Live-1.1 (что нужно знать)
Сначала договоримся о терминах — дальнейшие расчёты стоимости и настройки будут опираться на эти определения:
- WebRTC — технология связи для передачи аудио и других медиа между браузером и устройством в реальном времени. Это ещё и единственный транспорт, подходящий для нативного режима ожидания GPT-Live.
- WebSocket — постоянное двунаправленное соединение. Приложение может передавать по нему аудио, события сеанса или управляющие сообщения по боковому каналу.
- SIP — протокол установления и управления сеансами, обычно используемый в телефонных сетях. Подключение GPT-Live к телефонии идёт через него.
- Режим ожидания — в этой статье: состояние биллинга, когда WebRTC-сеанс соответствует условиям и остаётся подключённым, но инференс остановлен.
- Активное время — этап, который тарифицируется по ставке активного времени; может включать период тишины до достижения условия паузы.
- Активация по голосу — сервис обнаруживает речь и запускает или возобновляет инференс.
- Порог простоя — определяет, через сколько времени без речи сеанс переходит в режим ожидания; настраивается.
- Боковое соединение — соединение, отдельное от основного голосового, для управления сервером и мониторинга событий; чаще всего это sideband WebSocket.
GPT-Live-1.1 WebRTC: ключевые моменты режима ожидания
| Момент | Описание | Что это даёт разработчику |
|---|---|---|
| Два тарифа | Активный режим — $0.05/мин, WebRTC-режим ожидания при выполнении условий — $0.02/мин (OpenAI Pricing) | В тихие периоды цена минуты падает на 60% |
| Посекундная тарификация | Оба тарифа считаются по секундам, без округления до целой минуты | Даже короткие паузы засчитываются в экономию |
| Только WebRTC | Низкий тариф ожидания действует лишь для WebRTC-сессий, где настроен режим ожидания и вывод приостановлен | О стоимости стоит задуматься уже при выборе транспорта |
| Бэкенд считается отдельно | Расход модели и инструментов на бэкенде тарифицируется отдельно | Ожидание оптимизирует лишь одну строку в счёте |
| Задержка первого ответа | После пробуждения из ожидания первый ответ на короткую реплику может быть медленнее | Приходится выбирать между экономией и качеством опыта |
Разбираемся по таблице тарифов, что служит знаменателем для 60% у GPT-Live-1.1 в режиме ожидания
Сначала о датах. В OpenAI API Changelog это обновление датировано 2026-11-19, а на странице анонса в сообществе разработчиков OpenAI указано 2026-11-20. Разница в один день, скорее всего, из-за разных часовых поясов — там, где ниже речь идёт о датах, я указываю источник. По данным страницы OpenAI Pricing, у обеих моделей GPT-Live активная голосовая связь стоит $0.05/мин, а WebRTC-режим ожидания при выполнении условий — $0.02/мин; тарификация посекундная, расход модели и инструментов на бэкенде считается отдельно.
«Скидку 60%» часто понимают как «вся сессия дешевле на 60%». Но знаменатель этих 60% — цена активной минуты: (0.05 − 0.02) ÷ 0.05 = 60%. Это лишь снижение цены за минуту после перехода в ожидание. Чтобы получить экономию по всей сессии, её нужно ещё умножить на долю времени в ожидании.
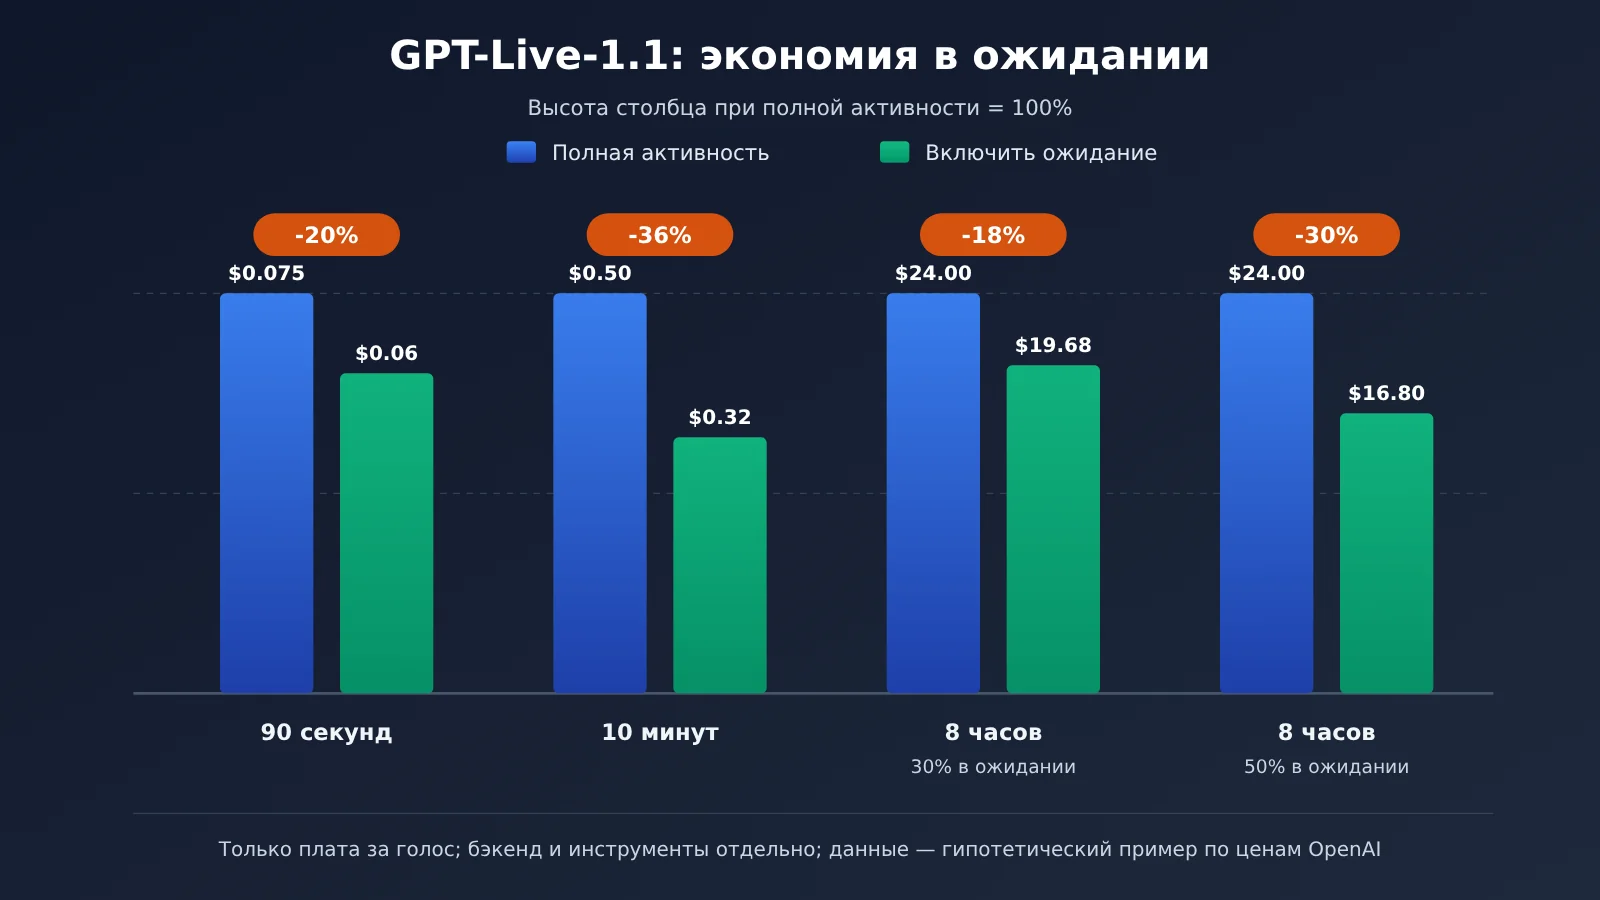
Возьмём пример с допущениями. Сессия на 10 минут: 4 минуты активны, 6 минут в ожидании. Плата за голос: 4×0.05 + 6×0.02 = $0.32. Если бы все 10 минут были активными — $0.50. Итого голосовая часть дешевле на 36%, что ровно равно 60% × 60% (доля времени в ожидании).
| Статья расходов | Цена (официальный прайс OpenAI) | Гранулярность | Зависит ли от ожидания |
|---|---|---|---|
| Активный голос | $0.05/мин | по секундам | Да, частично заменяется ожиданием |
| Голос в WebRTC-ожидании | $0.02/мин | по секундам | Только при выполнении условий WebRTC |
| Токены модели на бэкенде | по прайсу выбранной модели | по токенам | Нет |
| Вызов инструментов | по прайсу инструмента | по вызовам или объёму | Нет |
Как настроить режим ожидания GPT-Live-1.1 WebRTC: от параметров сессии до сверки счёта
Согласно документу OpenAI «Managing GPT-Live sessions», у режима ожидания WebRTC не так много параметров, но каждый из них напрямую влияет на то, как будут разграничиваться этапы тарификации.
| Поле / событие | Значение или смысл | Что важно при настройке |
|---|---|---|
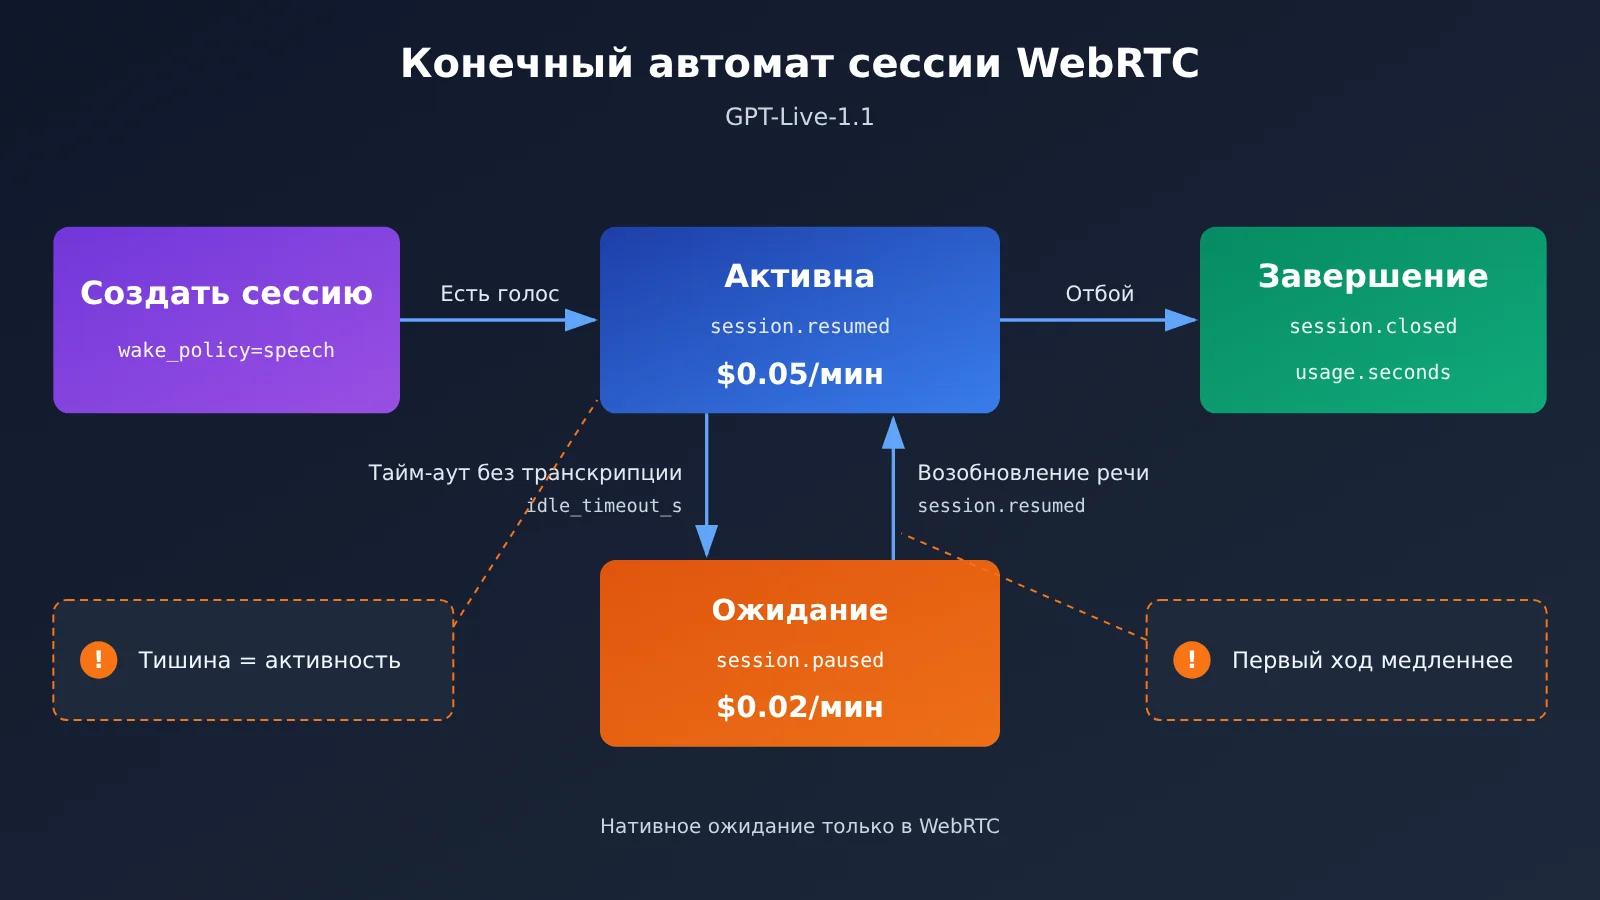
session.wake_policy.type |
Установите "speech" |
Сессия начинает инференс только после обнаружения речи, а не сразу после подключения |
session.idle_timeout_s |
Целое число от 5 до 60 (секунды) | Если параметр не задан, после первого пробуждения инференс остаётся активным всё время |
session.wake_policy.vad_threshold |
От 0 до 1, по умолчанию 0.5 (по сводке документации от стороннего OrcaRouter) | В шумной обстановке или при частых ложных пробуждениях значение стоит повысить |
session.paused |
После тайм-аута простоя инференс приостанавливается | Считается началом режима ожидания |
session.resumed |
Инференс готов возобновиться; событие также срабатывает при первом пробуждении | Считается началом активного режима |
session.closed |
Сессия завершена; событие содержит итоговое значение usage.seconds |
Для сверки с выставленным счётом |
4 шага настройки режима ожидания GPT-Live-1.1
- При создании WebRTC-сессии включите пробуждение по голосу: установите
session.wake_policy.type = "speech". - Задайте порог простоя:
session.idle_timeout_s— целое число от 5 до 60. Чем короче порог, тем раньше сессия перейдёт в режим ожидания, но при чуть более длинной паузе пользователя может сработать приостановка. - Поддерживайте активность дорожки микрофона: во время режима ожидания дорожка микрофона должна оставаться активной, чтобы сервис мог обнаружить речь и пробудить сессию. Подключение и ID сессии не меняются, при возобновлении сохраняется история диалога.
- Слушайте события и фиксируйте метки времени: по
session.pausedиsession.resumedопределяйте, на каком этапе сейчас находится сервер.
Ниже — пример фрагмента конфигурации сессии. Пути полей взяты из официальной документации; полную структуру запроса см. в OpenAI «Create session»:
{
  "session": {
    "wake_policy": {
      "type": "speech",
      "vad_threshold": 0.5
    },
    "idle_timeout_s": 15
  }
}
Какие периоды тишины всё ещё тарифицируются по активной цене
Есть три вида «тишины», на которых проще всего ошибки в расчётах:
- Тишина до истечения тайм-аута: с момента окончания последней фразы до истечения
idle_timeout_sсессия по-прежнему считается активной. Если порог равен 30 секундам, каждая пауза даст как минимум 30 секунд по активному тарифу. - Выключенный микрофон: если пользователь отключил микрофон в клиенте, сессия не переходит в ожидание и остаётся активной.
- Ожидание ответа бэкенда: время, пока инференс не приостановлен и идёт ожидание результата от бэкенд-модели или инструмента, тоже тарифицируется как активная фаза.
Есть ещё плата за инициализацию. По данным OrcaRouter, основанным на официальной документации, при создании WebRTC-сессии через POST /v1/live/sessions сначала списываются 15 секунд голосовой длительности, а после запуска сессии они вычитаются из платы за длительность. Для приложений, которые часто создают пробные сессии, это реальные расходы; окончательные цифры смотрите в OpenAI Pricing.
Сверка расходов по времени событий
Идея сверки такая: по временным меткам событий оценить длительность каждого этапа, а затем сравнить итоговое usage.seconds из session.closed с фактическим счётом. Ниже — пример регистратора событий. По какому каналу приходят события (WebRTC data channel или sideband-соединение), уточняйте в официальной документации:
const timeline = [];
function onServerEvent(evt) {
  if (["session.resumed", "session.paused", "session.closed"].includes(evt.type)) {
    timeline.push({ type: evt.type, t: Date.now() / 1000 });
  }
  if (evt.type === "session.closed") {
    console.log("usage.seconds =", evt.usage?.seconds, timeline);
  }
}
При тестировании один и тот же сценарий, один и тот же бэкенд и одну и ту же запись нужно прогнать дважды — с включённым и выключенным режимом ожидания, — а также отдельно фиксировать время возврата первого аудиофрагмента, чтобы измерить задержку первого ответа после пробуждения.
И ещё одно напоминание на уровне рабочего процесса. CellCog опубликовал контрольный эксперимент с одинаковой конфигурацией: сначала 560 сценарных звонков, затем ещё 120 для повторной проверки. В исходном сценарии вопрос задавался рано: старая версия передала бэкенду 134 из 160 вопросов, а версия 1.1 — 91, то есть примерно 84% против 57%. В повторном тесте первый вопрос задавался после 10-й секунды, и обе версии показали 48/60 (80%). Это лишь поведение делегирования одной команды на коротких встречах с конкретными промптами; стоимость ожидания не измерялась. Но это показывает: количество делегирований бэкенду меняется в зависимости от сценария, а стоимость бэкенда от режима ожидания не зависит.
Границы реализации режима ожидания GPT-Live-1.1 в WebSocket и SIP
OpenAI поддерживает три типа Live-подключений: WebRTC, WebSocket и телефонный SIP, но встроенный льготный режим ожидания доступен только для WebRTC. Важно различать: к сессии WebRTC или SIP можно дополнительно подключить вспомогательный WebSocket для управления и мониторинга — это не то же самое, что «передавать основной аудиопоток через WebSocket». Даже если к основному соединению WebRTC подключён вспомогательный WebSocket, встроенный режим ожидания всё равно доступен.
| Основной аудиотранспорт | Встроенный режим ожидания $0.02 | Официально рекомендуемая обработка простоя | На что обратить внимание по затратам |
|---|---|---|---|
| WebRTC | ✅ при выполнении условий | wake_policy + idle_timeout_s |
Период тишины до тайм-аута тарифицируется как активный |
| WebRTC + вспомогательный WebSocket | ✅ применяется к основному соединению | Вспомогательный канал отвечает только за управление и события | Сам по себе он не меняет фазу тарификации |
| Основной WebSocket | ❌ нет оснований | Приложение само определяет простой; после закрытия — пересоздание | Пересоздание сессии имеет затраты на инициализацию |
| SIP-телефония | ❌ нет оснований | Сначала проверьте, как закрытие сессии повлияет на входящий вызов | Пока вызов удерживается, расходы считаются как для активной сессии |
Что делать с основным WebSocket: управляйте состоянием простоя на стороне приложения, отслеживая входящий и исходящий аудиопоток, состояние воспроизведения и фоновые задачи, которые ещё должны завершиться. Только когда тишина длится долго и разрыв соединения допустим, вызывайте session.close и дожидайтесь session.closed. Когда пользователь возвращается, пересоздайте сессию: для старой сессии, которую разрешено сохранять и запись которой уже завершена, можно выполнить fork, либо восстановить контекст из текстового состояния, сохранённого самим приложением. Если включено локальное голосовое пробуждение, сначала буферизуйте начальный аудиофрагмент, чтобы во время установки соединения не потерялись слова.
Что делать с SIP: закрытие сессии может повлиять на сам входящий вызов, поэтому «положить трубку и переподключиться» нельзя считать режимом ожидания на месте. Если вызов обязательно должен оставаться активным, пусть приложение или телефонная система обрабатывает поток удержания, а расходы OpenAI на активную голосовую сессию нужно закладывать в бюджет. Другой вариант — построить собственный медиамост и на стороне OpenAI реально использовать и проверять режим ожидания WebRTC. Всё это — границы реализации на уровне транспорта и состояния сессии; нет никаких оснований утверждать, что транспорт, отличный от WebRTC, тоже может получить цену режима ожидания $0.02.
Сколько можно сэкономить за весь звонок: быстрый старт по стоимости режима ожидания GPT-Live-1.1
Простой расчёт стоимости
Функция ниже реализует формулу «доля экономии = доля ожидания × 60%»; входные параметры задаются в секундах:
ACTIVE, STANDBY = 0.05, 0.02  # Официальные цены OpenAI, долларов в минуту

def voice_cost(active_s: float, standby_s: float) -> tuple[float, float]:
    with_standby = active_s / 60 * ACTIVE + standby_s / 60 * STANDBY
    all_active = (active_s + standby_s) / 60 * ACTIVE
    return round(with_standby, 4), round(1 - with_standby / all_active, 4)

print(voice_cost(240, 360))      # 10 минут: активны 4 минуты + ожидание 6 минут
print(voice_cost(60, 30))        # 90 секунд: активны 60 секунд + ожидание 30 секунд
| Гипотетический сценарий | Активность / ожидание | Стоимость голоса с ожиданием | Стоимость голоса при полной активности | Снижение стоимости голоса |
|---|---|---|---|---|
| Официальный пример (в пересказе OrcaRouter) | 60 секунд / 30 секунд | $0.06 | $0.075 | 20% |
| 10-минутная консультация (допущение из этой статьи) | 4 минуты / 6 минут | $0.32 | $0.50 | 36% |
| 8-часовое дежурство, 30% ожидания (расчёт OrcaRouter) | 5.6 ч / 2.4 ч | $19.68 | $24.00 | 18% |
| 8-часовое дежурство, 50% ожидания (расчёт OrcaRouter) | 4 ч / 4 ч | $16.80 | $24.00 | 30% |
В таблице учитывается только стоимость голоса. В реальном развёртывании расходы на бэкенд-модели и инструменты часто оказываются более крупной статьёй счёта. В статье OrcaRouter упоминается, что документация OpenAI рекомендует сначала использовать gpt-6-luna, а для сложных бэкенд-задач переключаться на gpt-6-sol; обе модели тарифицируются по токенам по стандартным правилам. В длинных звонках расходы на бэкенд вполне могут превысить стоимость голоса.
💡 Совет по расчёту: Все данные в таблице выше — гипотетические оценки по официальным ценам; реальный счёт нужно сверять с
usage.secondsи биллингом платформы. Если вы параллельно оцениваете другие решения для голосовой связи в реальном времени, можно воспользоваться бесплатным тестовым лимитом APIYI apiyi.com и сравнить на одном и том же сценарии разговора Realtime-модели с оплатой по токенам.
Разделяем голосовой слой, бэкенд-модель и точку входа API для GPT-Live-1.1
На дату проверки (2026-11-20) специализированный интерфейс сессий и поминутная тарификация GPT-Live-1.1 указаны на официальном сайте OpenAI. Согласно сводке стороннего OrcaRouter, GPT-Live подключается только через эндпоинт Live sessions; Chat Completions, Responses, Realtime и другие эндпоинты не поддерживаются.
Что касается APIYI, в публичном реестре моделей (сформирован 2026-11-20 15:17 UTC+8, всего 289 записей) нет gpt-live-1 или gpt-live-1.1, а в динамическом архиве нет анонса о запуске. Поэтому сейчас нельзя считать, что APIYI уже предоставляет линейку GPT-Live, /v1/live/sessions или поминутную тарификацию. Нельзя и делать вывод о поддержке таких специализированных голосовых сессий только потому, что APIYI совместим с интерфейсом OpenAI.
Уже открытый вариант realtime-голоса в APIYI — это отдельный продукт Realtime:
| Вариант | Способ подключения | Тарификация | Ожидание / WebRTC / SIP | Доступная платформа |
|---|---|---|---|---|
| GPT-Live-1.1 | /v1/live/sessions, WebRTC / WebSocket / SIP |
Активная сессия — $0.05, ожидание — $0.02 за минуту; бэкенд оплачивается отдельно | WebRTC поддерживает нативный режим ожидания | Официальный OpenAI |
| gpt-realtime-2.1 | /v1/realtime WebSocket |
Аудиовход/аудиовыход — $32/$64 за миллион аудиотокенов | WebRTC и SIP недоступны | APIYI apiyi.com |
| gpt-realtime-2.1-mini | /v1/realtime WebSocket |
Аудиовход/аудиовыход — $10/$20 за миллион аудиотокенов | WebRTC и SIP недоступны | APIYI |
Цены APIYI Realtime взяты из документации (на странице указана сверка от 2026-09-14). Тарификация идёт по токенам текста, аудио и изображений, поэтому её нельзя напрямую пересчитать в поминутную тарификацию GPT-Live.
APIYI Realtime — минимальный пример подключения
import os, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # единый интерфейс APIYI
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1"

async def main():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        print(await ws.recv())  # вывести первое событие от сервера

asyncio.run(main())
Посмотреть полный код: закрытие по простою на стороне приложения для основного WebSocket
import os, time, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # точка входа APIYI Realtime
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1-mini"
IDLE_LIMIT_S = 45          # порог простоя на стороне приложения, можно настроить под бизнес-логику
pending_backend_tasks = 0  # ведёт приложение: число незавершённых задач на бэкенде
is_playing = False         # ведёт приложение: воспроизводится ли сейчас аудио

async def run_session():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    last_activity = time.monotonic()
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        async def reader():
            nonlocal last_activity
            async for _ in ws:
                last_activity = time.monotonic()  # любое событие от сервера считаем активностью

        task = asyncio.create_task(reader())
        while True:
            await asyncio.sleep(1)
            idle = time.monotonic() - last_activity
            busy = pending_backend_tasks > 0 or is_playing
            if idle > IDLE_LIMIT_S and not busy:
                print(f"空闲 {idle:.0f}s,主动关闭,用户回来后再重建")
                await ws.close()
                break
        task.cancel()

asyncio.run(run_session())
Формат событий и параметры запроса — согласно документации APIYI «Realtime: голос в реальном времени (WebSocket)». Такой способ «закрыть и потом создать заново» лишь экономит простаивающие соединения на уровне приложения и не соответствует никакому официальному тарифу за дешёвое ожидание.
🚀 Рекомендация по подключению: для сценариев WebRTC, где нужен нативный режим ожидания GPT-Live, сейчас подключайтесь напрямую к OpenAI. Если нужно быстро собрать прототип голоса в реальном времени на WebSocket и единообразно управлять несколькими моделями, сначала прогоните весь процесс на APIYI apiyi.com с
gpt-realtime-2.1-mini, а затем уже по стоимости выбирайте рабочее решение.
Частые вопросы (FAQ)
Вопрос 1: Что такое режим ожидания WebRTC в GPT-Live-1.1?
Это особое состояние тарификации сессии WebRTC: когда настроены голосовая активация и порог простоя, сессия перестаёт выполнять инференс в периоды без речи, но соединение сохраняется, и оплата идёт по $0,02 в минуту. Когда кто-то снова говорит, инференс возобновляется с сохранённой историей диалога.
Вопрос 2: Снижение цены на 60% — значит, весь звонок подешевеет на 60%?
Нет. 60% — это снижение цены минуты в режиме ожидания относительно минуты активной работы. Снижение стоимости голосовой части всего звонка равно доле ожидания, умноженной на 60%: если ожидание занимает половину времени, голосовая часть экономит около 30%. Затраты на бэкенд и инструменты не меняются.
Вопрос 3: Когда GPT-Live-1.1 появился в API?
Дата записи в OpenAI API Changelog — 2026-11-19, а на странице анонсов в сообществе разработчиков OpenAI указано 2026-11-20; разница, вероятно, из-за часовых поясов. GPT-Live-1 ранее стал общедоступным 2026-09-10 (по данным OrcaRouter).
Вопрос 4: В каких сценариях режим ожидания выгоднее всего?
— **Ожидание в очереди в поддержке**: клиент висит на линии, но долго молчит.
— **Автомобильные или настольные ассистенты**: постоянное соединение, редкие активации.
— **Долгие дежурные места операторов**: чем выше доля ожидания, тем больше экономия.
В коротких сессиях с интенсивным диалогом доля ожидания мала, к тому же приходится платить замедлением первого ответа после активации — выгода ограничена.
Вопрос 5: Можно ли вызывать GPT-Live-1.1 через APIYI?
По состоянию на 2026-11-20 в публичном реестре моделей APIYI нет серии GPT-Live и нет анонса о её подключении. Если нужна речь в реальном времени, можно использовать уже опубликованные в APIYI apiyi.com модели `gpt-realtime-2.1` / `gpt-realtime-2.1-mini`, подключаясь через WebSocket по адресу `/v1/realtime` с оплатой по аудиотокенам. Новым пользователям доступен бесплатный тестовый лимит, чтобы всё проверить.
Вопрос 6: Какие известны ограничения режима ожидания GPT-Live-1.1?
— Работает только в WebRTC; для WebSocket и основного соединения SIP оснований для $0,02 нет.
— Тихий период до тайм-аута, выключенный микрофон и время ожидания бэкенда тарифицируются как активные.
— После активации первый ответ на короткую реплику может быть медленнее.
— Сейчас не хватает сторонних данных о пробуждении из ожидания и сверке счетов; оценки в рейтинге Artificial Analysis относятся только к GPT-Live-1 и их нельзя переносить на 1.1.
GPT-Live-1.1 WebRTC: ключевые моменты режима ожидания (Key Takeaways)
- Цена: активная сессия — $0.05/мин, подходящий режим ожидания WebRTC — $0.02/мин, в обоих случаях оплата по секундам.
- Формула: снижение платы за голос по всему звонку равно доле простоя, умноженной на 60%, а не фиксированным 60%.
- Настройка:
wake_policy.type="speech"плюсidle_timeout_sв диапазоне 5–60 секунд, аудиодорожка микрофона остаётся активной. - Проверка счёта: по временным меткам paused/resumed оцените длительность этапов, а затем сверьте
usage.secondsс выставленным счётом. - Ограничения: WebSocket и SIP можно пересоздать только после закрытия на стороне приложения — как дешёвый режим ожидания это не считается.
- Входная точка: GPT-Live требует прямого подключения к OpenAI; голос в реальном времени через WebSocket можно попробовать на APIYI apiyi.com с моделью Realtime.
Итог
Ключевые моменты режима ожидания WebRTC в GPT-Live-1.1:
- Скидка с условием: по $0.02/мин тарифицируются только те WebRTC-сессии, где режим ожидания настроен и вывод уже приостановлен.
- Экономия зависит от доли: если из 10 минут 6 уходят в простой, плата за голос падает с $0.50 до $0.32 — экономия около 36%.
- Счёт смотрят целиком: модель на бэкенде и инструменты тарифицируются отдельно, режим ожидания оптимизирует лишь одну статью расходов.
Совет: сначала проведите A/B-тест с одним и тем же сценарием — с включённым и выключённым режимом ожидания, — фиксируйте время событий и задержку первого ответа, и уже потом выбирайте порог простоя. Если вы всё ещё сравниваете разные варианты речи в реальном времени, рекомендую сначала прогнать прототип Realtime через APIYI apiyi.com и на бесплатной квоте сравнить стоимость и качество работы.
📚 Справочные материалы
-
OpenAI API Pricing: тарифы GPT-Live за активный режим и режим ожидания
- Ссылка:
developers.openai.com/api/docs/pricing - Описание: источник официальных цен $0.05 и $0.02
- Ссылка:
-
OpenAI Managing GPT-Live sessions: настройка режима ожидания и описание событий
- Ссылка:
developers.openai.com/api/docs/guides/live-conversations - Описание:
wake_policy,idle_timeout_sи границы транспорта
- Ссылка:
-
OpenAI API Changelog: запись об обновлении GPT-Live-1.1
- Ссылка:
developers.openai.com/api/docs/changelog - Описание: дата записи 2026-11-19
- Ссылка:
-
Сравнительный эксперимент CellCog: GPT-Live-1.1 vs GPT-Live-1
- Ссылка:
cellcog.ai/blog/gpt-live-1-1-vs-gpt-live-1/ - Описание: данные по делегированию для 680 сценарных созвонов, без учета стоимости режима ожидания
- Ссылка:
-
Разбор релиза от OrcaRouter: анализ тарификации режима ожидания GPT-Live-1.1
- Ссылка:
orcarouter.ai/blog/gpt-live-1-1-api-release-standby-pricing - Описание: пересказ официального примера расчета и расчет для 8-часовой смены
- Ссылка:
Автор: техническая команда APIYI
По техническим вопросам: пишите нам через главную страницу сайта APIYI; подробности подключения Realtime — в центре документации docs.apiyi.com