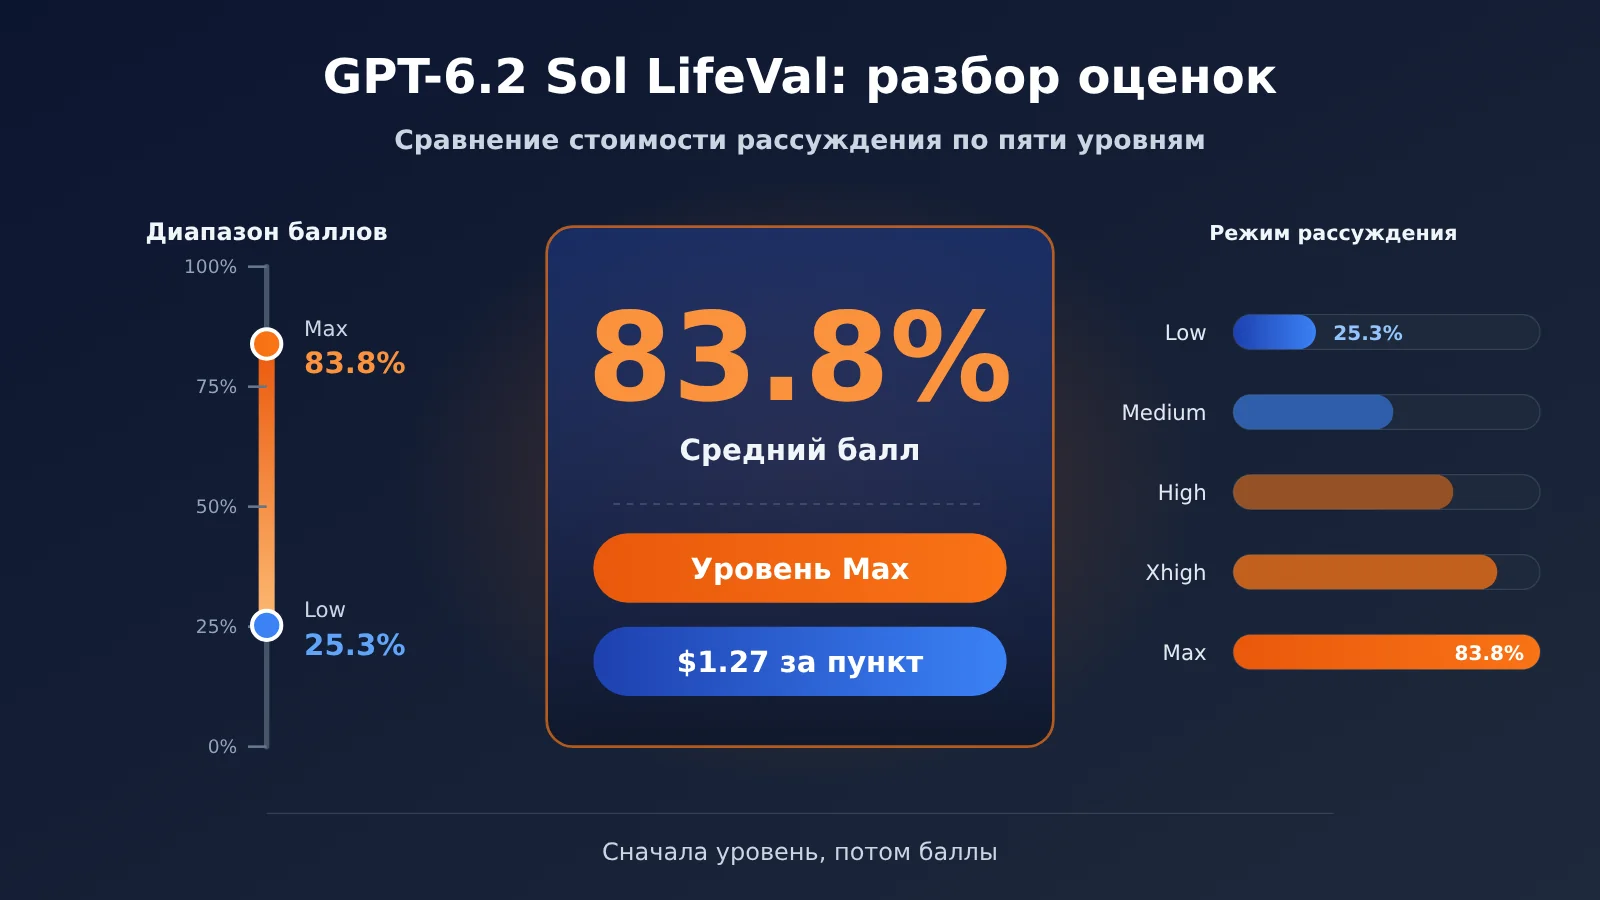
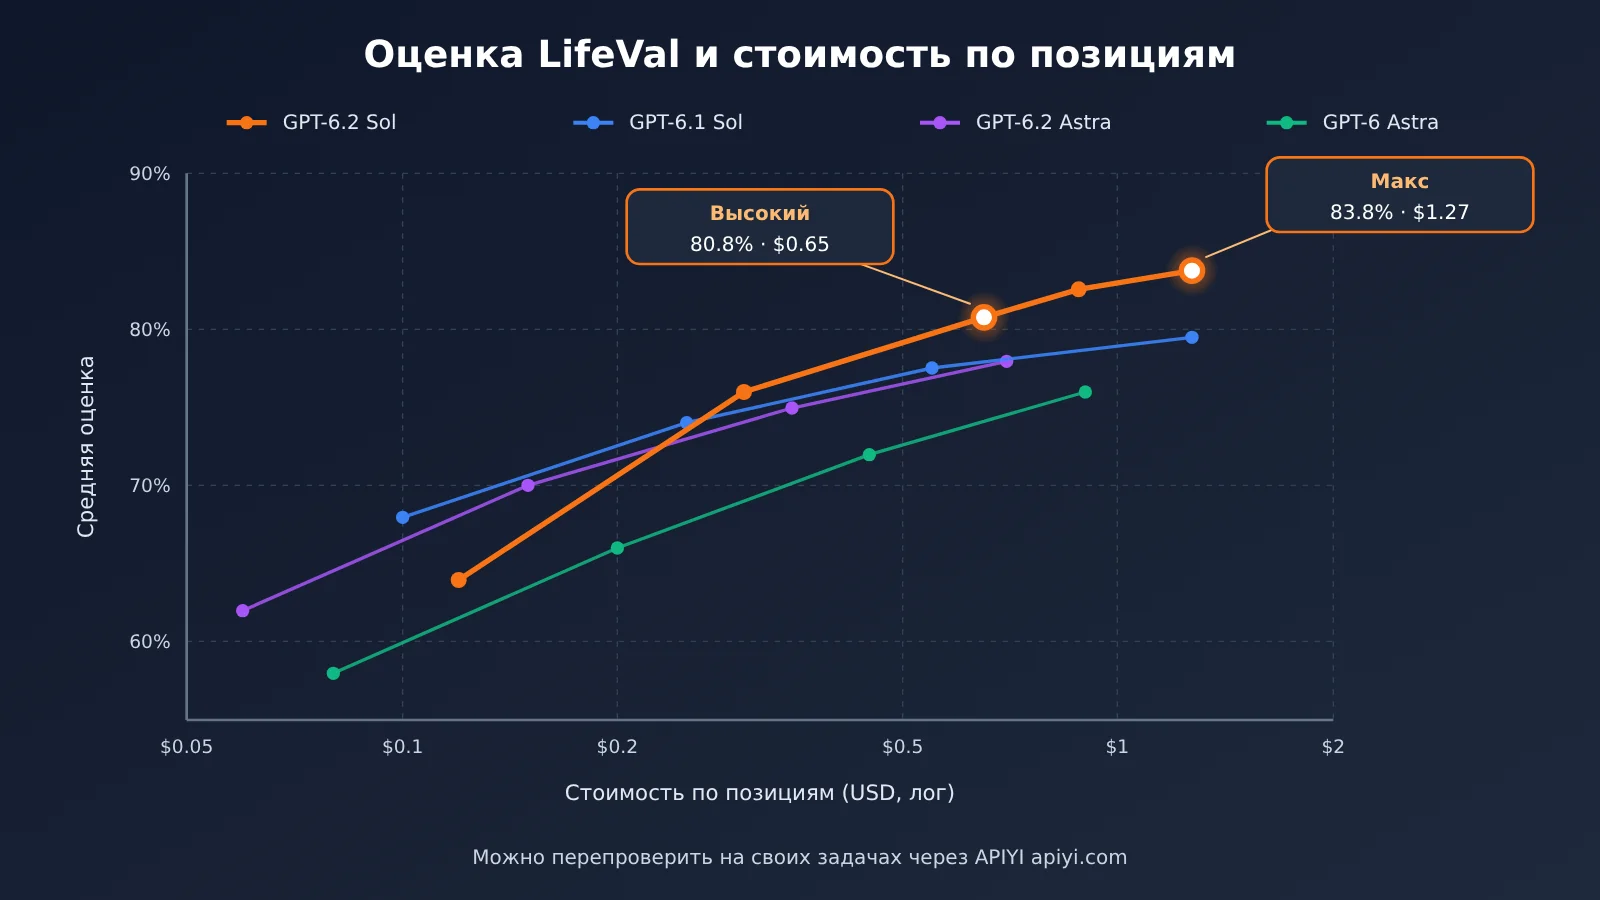
83.8% — это не «83.8% задач выполнены полностью», а средний балл GPT-6.2 Sol на LifeVal в режиме рассуждений Max. Этот показатель получен суммированием баллов, выставленных по каждому пункту критериев оценки каждой задачи; средняя стоимость одной задачи — $1.27. У той же модели в режиме Low средний балл составляет всего 25.3%, в режиме High — 80.8% при стоимости одной задачи $0.65. Поэтому, обсуждая результаты GPT-6.2 Sol на LifeVal, нужно сначала уточнить, о каком режиме идёт речь.
Вывод: официальный рейтинг даёт «комбинацию оценки и стоимости для конкретных задач и конкретной среды», а не общий рейтинг, который можно напрямую перенести в ваш продукт. В наборе данных LifeVal режим High — отправная точка, которую стоит тестировать первой. А какой режим использовать в итоге, всё равно нужно проверять на собственных задачах — по полученным артефактам и реальному состоянию.
Что вы узнаете из этой статьи?
- Какие задачи измеряет LifeVal и как правильно формулировать результат 83.8%.
- Баллы и стоимость пяти режимов рассуждений GPT-6.2 Sol, а также сравнение с GPT-6.1 Sol, GPT-6 Astra и GPT-6.2 Astra в тех же режимах.
- Почему официальные формулировки «стоимость около одной седьмой» и «резкое падение в режиме Low» могут быть верны одновременно.
- Как заимствовать методику проверки LifeVal и разработать воспроизводимые оценочные задачи для собственного повседневного ассистента.
Навигация: в таблице To Know сначала объясняются термины оценки, которые понадобятся дальше; в блоке «Кратко о влиянии» отдельно говорится, на что обратить внимание обычным пользователям и разработчикам. В части с объективными фактами последовательно описываются источник задач LifeVal и способ начисления баллов, а также данные по режимам из инфографики, опубликованной 17 ноября. В аналитической части сначала разбираются знаменатели нескольких сравнений, затем приводится готовый к адаптации пример проверки ассистента для маршрутов и расписания и объясняются границы переноса.
Что нужно знать: ключевые понятия для понимания оценки GPT-6.2 Sol LifeVal
| Понятие | Краткое объяснение |
|---|---|
| LifeVal | Бенчмарк OpenAI для оценки того, как AI-ассистент справляется с персонализированными повседневными цифровыми задачами |
| Персонализированный контекст | Информация, которая меняет «правильный ответ»: предпочтения пользователя, история данных, специфические условия задачи и т. п. |
| Критерии оценки | Разбиение выполнения задачи на отдельные проверяемые требования |
| Контролируемая среда | Заранее настроенная среда оценки с приложениями, данными и исходным состоянием — чтобы можно было сверять результаты действий |
| Разница состояний бэкенда | Изменения состояния приложения, записанные до и после теста — по ним видно, действительно ли сработала работа с инструментами |
| Среднее значение награды | Сводный показатель по всем задачам после начисления баллов по критериям оценки; проценты на графике релиза — как раз такие «средние баллы» |
| Интенсивность рассуждений | Уровень вычислительных усилий модели при рассуждениях; в этой статье сравниваются Low, Medium, High, Xhigh, Max |
| Стоимость одного задания | Средняя стоимость одной задачи на графике оценки; зависит от объёма использования модели и тарифов |
GPT-6.2 Sol LifeVal: краткий обзор влияния
- Обычные пользователи: когда видите «83.8%», воспринимайте это как «средний балл на наборе повседневных задач американских англоязычных пользователей», а не как долю успешных выполнений. Кроме того, у одной и той же модели разрыв между разными уровнями рассуждений очень большой — итоговый опыт зависит от того, какой уровень выберет разработчик продукта.
- Продуктовые менеджеры: уровень Low — самый дешёвый, но на этот раз в LifeVal он сильно отстал от уровня Low предыдущего поколения Sol. Если переносить конфигурацию уровней со старой версии при обновлении, можно столкнуться с ситуацией «поставили новую модель, а стало хуже».
- Разработчики API: полезно заимствовать подход к приёмке в LifeVal — отдельная оценка результата поставки, состояния среды и ответа. Сравнивать уровни Low, Medium и High на одном и том же наборе собственных задач надёжнее, чем просто ссылаться на цифры из рейтинга.
Объективные факты: на каких задачах GPT-6.2 Sol проходит оценку LifeVal
Происхождение LifeVal и хронология публикации
LifeVal — это бенчмарк OpenAI для оценки персонализированных задач повседневного ассистента. Дата на исследовательской странице OpenAI — 2 ноября 2026 года, дата сопутствующей статьи — 3 ноября. 17 ноября OpenAI выпускает GPT-6.2 Astra и GPT-6.2 Sol и прикладывает к странице релиза график LifeVal с результатами новых моделей по уровням (идентификатор графика lifeval-v2).
Распределение задач в статье взято из исследований использования времени в США и ряде других стран, а также с учётом платного опроса о готовности платить, проведённого среди населения США; в итоге повседневные занятия были сведены в 148 категорий. В экспериментах статьи использовалось 169 задач. Важно учитывать: в самой статье оценка моделей заканчивается на GPT-6 Astra, а цифры по уровням для линейки GPT-6.2 появляются только позже — на официальном графике релиза.
Согласно официальному позиционированию, Sol ориентирован на частые рабочие задачи, повседневное программирование и масштабируемых многошаговых агентов, а Astra — на более сложные рассуждения и профессиональные результаты. Это позиционирование согласуется с тем, что измеряет LifeVal, — «задачами повседневного ассистента».
Дизайн заданий LifeVal: один запрос — разные правильные ответы
Ключевая особенность LifeVal — персонализация. Возьмём пример: после переезда человек сравнивает школы. У пользователей разный возраст детей, разные маршруты поездок на работу, разные предпочтения по школьным районам — и правильный ответ у каждого будет свой. Другой пример — поиск жилья с балансом между бюджетом и временем на дорогу: верхняя граница бюджета и приемлемая длительность поездки напрямую определяют, какие варианты вообще считаются подходящими.
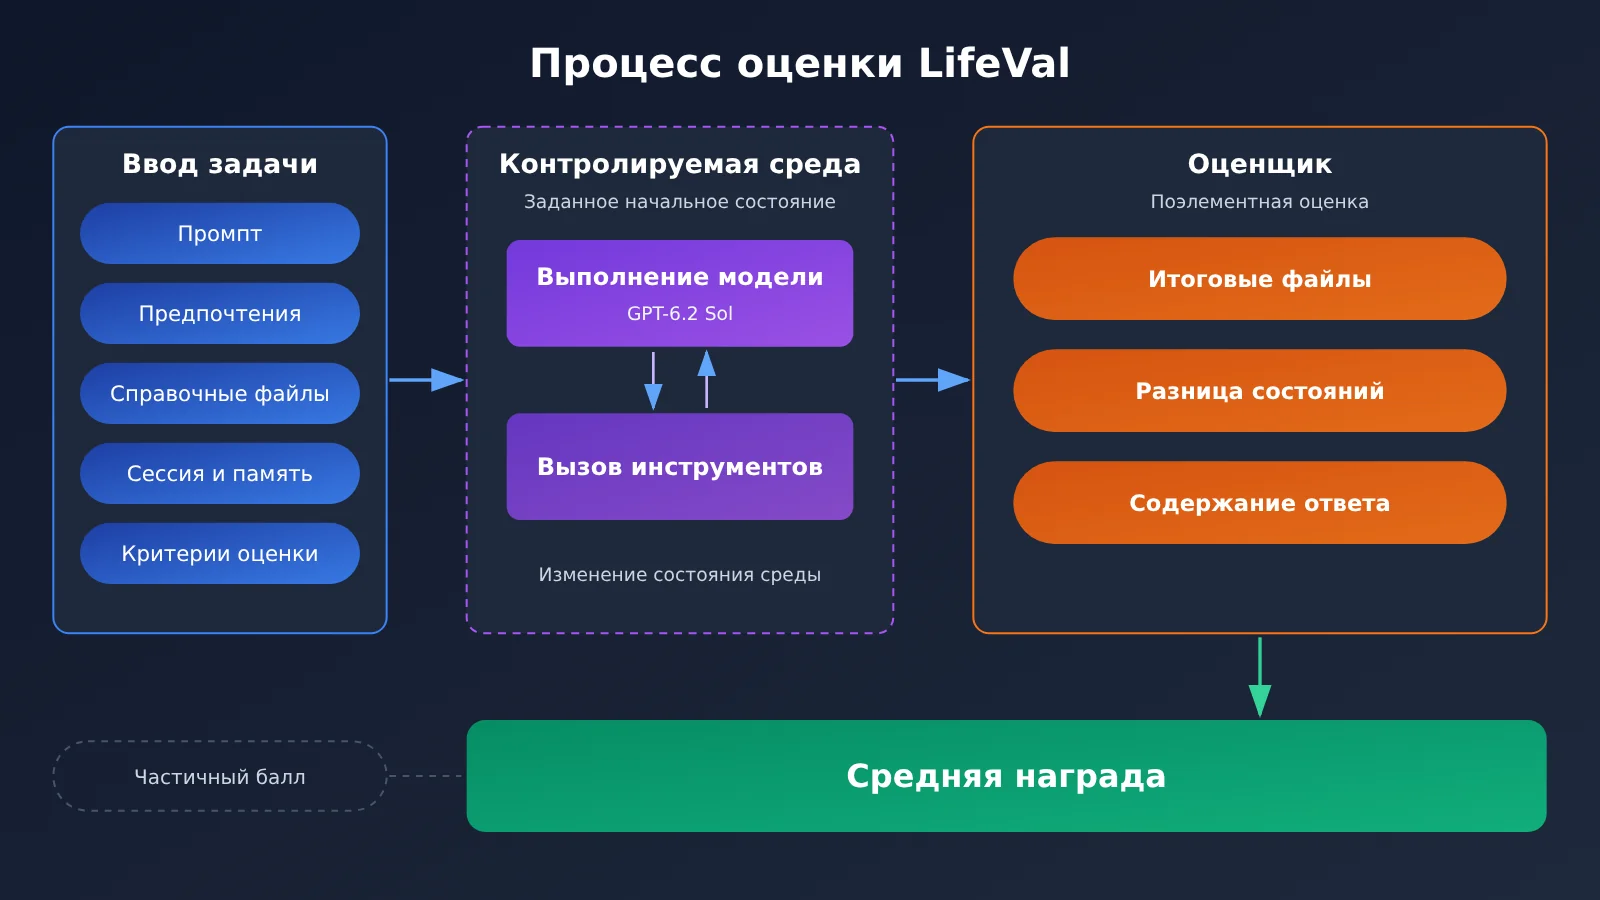
По методологии из статьи каждое задание включает промпт, пользовательские предпочтения, эталонные файлы, связанные сессии и память, критерии оценки, а также контролируемую среду с заранее заданным состоянием. После завершения выполнения оценщик проверяет три вещи: файлы, которые сдала модель, состояние среды до и после операций с инструментами и сам ответ модели — и затем отдельно начисляет баллы по каждому требованию задания.
Почему 83.8% можно называть только «средним баллом»
По вертикальной оси графика результатов в статье отложено среднее значение награды. Поэтому 83.8% следует читать как «средний балл», а не как «83.8% задач выполнены полностью успешно». Даже если задача закрывает лишь часть критериев оценки, она всё равно приносит часть баллов.
В статье также указано несколько ограничений: в офлайн-среде и в кэшированных веб-страницах остаётся часть информации, которая со временем меняется, а выборка ориентирована в основном на англоязычных пользователей из США. Это значит, что баллы нельзя напрямую переносить на другие регионы, другие языки или другие экосистемы приложений.
График релиза GPT-6.2 Sol на LifeVal: баллы по пяти уровням и стоимость одной задачи
Таблица ниже считана из открытых данных интерактивного графика LifeVal на странице релиза OpenAI от 17 ноября 2026 года. В каждой ячейке — «средний балл / средняя стоимость одной задачи (USD)». Это публичные данные оценки, которые OpenAI сообщает сама, а не измерения независимой организации.
| Модель | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25.3% / $0.089 | 70.3% / $0.38 | 80.8% / $0.65 | 82.6% / $0.88 | 83.8% / $1.27 |
| GPT-6.1 Sol | 66.8% / $0.52 | 75.5% / $0.73 | 77.1% / $0.88 | 77.8% / $0.96 | 79.5% / $1.27 |
| GPT-6.2 Astra | 46.3% / $0.59 | 78.9% / $1.56 | 83.1% / $2.41 | 83.7% / $2.94 | 86.1% / $4.23 |
| GPT-6 Astra | 67.5% / $3.51 | 74.3% / $5.30 | 76.0% / $6.52 | 77.5% / $6.94 | 79.8% / $9.04 |
В тексте анонса сказано: в LifeVal Sol показывает балл выше, чем GPT-6 Astra, а стоимость — примерно в семь раз ниже. Здесь сравнение идёт с флагманом предыдущего поколения GPT-6 Astra, а не с GPT-6.2 Astra того же периода. Другое сравнение из анонса — по FrontierCode 2.0 — как раз использует GPT-6.2 Astra, так что при чтении не стоит смешивать эти два вывода.
📌 Замечание о методике данных: «стоимость одной задачи» в таблице — это среднее значение из официального графика оценки, на неё влияют длина входа, длина выхода и использование инструментов в этом тесте. Стоимость вашей собственной задачи нужно перепроверять на реальных запросах: через APIYI apiyi.com можно с одним и тем же ключом последовательно прогнать разные уровни Sol и напрямую сравнить счёт.
Информация о доступе к API GPT-6.2 Sol
ID модели API — gpt-6.2-sol. Вызывать её можно через Responses и Chat Completions; вызовы функций и встроенные инструменты идут по пути Responses. Ни один из двух эндпоинтов не принимает уровень рассуждений none. Официальная цена Standard для короткого контекста — $2.00 за вход и $10.00 за выход (USD за миллион токенов, токены рассуждений уже включены в выход), столько же, сколько у GPT-6.1 Sol.
По состоянию на 20 ноября 2026 года gpt-6.2-sol уже присутствует в публичной сводной таблице моделей и в интерфейсе ценообразования APIYI, с пометками о входах responses и chat. Тариф для короткого контекста совпадает с официальным; фактически доступные группы, диапазоны параметров и выставление счетов определяются текущей конфигурацией и биллингом APIYI на apiyi.com.
Аналитическая оценка: как в GPT-6.2 Sol LifeVal одновременно уживаются «одна седьмая стоимости» и просадка Low
Сначала выровняем объекты сравнения и знаменатели
По одной и той же диаграмме можно вынести впечатление и «существенного прогресса», и «заметного регресса» — корень в том, что объекты сравнения и уровни разные. Разницы и пропорции в таблице ниже рассчитаны по официально опубликованным значениям.
| Группа сравнения | Значения сторон | Разница в баллах | Соотношение расходов |
|---|---|---|---|
| 6.2 Sol Max vs флагман прошлого поколения GPT-6 Astra Max | 83.8%/$1.27 vs 79.8%/$9.04 | +4.0 процентных пункта | около 14.0%, то есть «примерно одна седьмая» |
| 6.2 Sol Max vs 6.1 Sol Max | 83.8%/$1.27 vs 79.5%/$1.27 | +4.3 процентных пункта | расходы одинаковые |
| 6.2 Sol Low vs 6.1 Sol Low | 25.3%/$0.089 vs 66.8%/$0.52 | −41.5 процентных пункта | расходы ниже, но баллы заметно просели |
| 6.2 Sol Medium vs 6.1 Sol Medium | 70.3%/$0.38 vs 75.5%/$0.73 | −5.2 процентных пункта | расходы примерно вдвое меньше |
| 6.2 Sol High vs 6.1 Sol Max | 80.8%/$0.65 vs 79.5%/$1.27 | +1.3 процентных пункта | примерно половина |
| 6.2 Sol Max vs 6.2 Astra Max | 83.8%/$1.27 vs 86.1%/$4.23 | −2.3 процентных пункта | около 30% |
В этих числах «процентные пункты» описывают разницу средних баллов, а «соотношение расходов» — отношение средней стоимости одного задания; пересчитывать одно в другое нельзя. «Одна седьмая» верна только для группы «6.2 Sol Max против GPT-6 Astra Max». Если взять GPT-6.2 Astra того же периода, то Sol на уровне Max оказывается ниже на 2.3 процентных пункта.
💡 Подсказка по выбору: разрыв между уровнями одной и той же модели может быть больше, чем между разными моделями. Советую сначала прогнать на APIYI apiyi.com сравнение по уровням на фиксированном наборе задач и только потом решать, какой уровень ставить по умолчанию, — не переносите конфигурацию уровней от старой модели напрямую.
Сигнал уровня Low: при обновлении нельзя просто «слепо заменять»
Уровень Low модели 6.2 Sol в LifeVal даёт лишь 25.3% — на 41.5 процентного пункта меньше, чем 6.1 Sol Low. В официальных материалах релиза упоминается, что на ряде задач Sol расходует меньше выходных токенов, а средняя стоимость одной задачи на уровне Low составляет всего $0.089. Разумное предположение: на персонализированных многошаговых задачах низкого объёма рассуждений не хватает, чтобы покрыть ограничения предпочтений и операции с инструментами. Это лишь предположение — официального объяснения снижения на уровне Low нет.
Для продуктовой команды последствия прямые. Если ваше приложение раньше использовало уровень Low на 6.1 Sol, чтобы экономить, то простое переключение ID модели без изменения уровня может заметно снизить качество на сложных повседневных задачах. Напротив, уровень Max при той же средней стоимости одной задачи на 4.3 процентного пункта выше, чем у предыдущего поколения Sol, — значит, верхняя планка у новой модели действительно выросла.
Почему High — уровень, который в этом тесте стоит тестировать в первую очередь
У 6.2 Sol при переходе от High к Xhigh и затем к Max прирост между соседними уровнями составляет всего 1.8 и 1.2 процентного пункта, а средняя стоимость одной задачи при этом растёт на $0.23 и $0.39 соответственно. Уровень High за $0.65 даёт 80.8% — уже выше, чем уровень Max у 6.1 Sol и уровень Max у GPT-6 Astra. Если ограничиваться только LifeVal, High — отправная точка с относительно сбалансированным соотношением качества и стоимости.
Однако у этого вывода три предпосылки: распределение задач близко к LifeVal; язык и среда применения близки к сценарию американских англоязычных пользователей; структура затрат близка к соотношению входа и выхода в этом тесте. Если не выполняется хотя бы одно условие, вывод может измениться. На практике надёжнее начать с High, а затем по доле успешных задач в собственных сценариях решать, спускаться ли до Medium или подниматься до Xhigh и Max.
Анализ и оценка: как провести приёмку собственного GPT-6.2 Sol-ассистента по методике LifeVal
Собираем низкорисковую задачу с семейным маршрутом
В LifeVal самое ценное для заимствования — не сами баллы, а подход «принимать по артефактам и состоянию». Ниже пример семейной поездки: заранее даём ассистенту три жёстких ограничения — точки отправления и назначения, условия безбарьерного передвижения и верхний лимит бюджета — и требуем выдать варианты с проверяемыми маршрутами плюс редактируемый черновик расписания.
| Критерий оценки | Способ проверки | Можно ли автоматизировать |
|---|---|---|
| Соблюдены ли ограничения по локациям | Начальная и конечная точки в варианте совпадают с входными | Проверяется автоматически |
| Соблюдены ли условия безбарьерности | В описании маршрута явно учтены требования безбарьерности | Частично автоматически, нужна выборочная проверка человеком |
| Бюджет не превышен | Извлечь суммы из варианта и сравнить с лимитом | Проверяется автоматически |
| Ссылки подтверждают информацию | Ссылки доступны, а их содержимое совпадает с вариантом | Нужен просмотр человеком |
| Существует ли файл черновика расписания | Проверить состояние до и после у выходного файла или записи в календаре | Проверяется автоматически |
| Задаёт ли вопросы при нехватке ключевой информации | Намеренно опустить дату и подобные данные и посмотреть, переспросит ли | Нужно решение человека |
Эти критерии соответствуют трём каналам приёмки LifeVal: артефакт (черновик расписания), изменение состояния (действительно ли файл или запись сохранены) и качество ответа (соблюдение ограничений и проактивные уточнения). Прогоняем один и тот же набор задач отдельно на Low, Medium и High, а затем по доле прохождения и стоимости определяем начальный уровень.
Минимальный пример: вызов GPT-6.2 Sol и учёт расхода на рассуждения
В примере ниже через Responses API вызывается gpt-6.2-sol, а также считываются выходные токены и токены рассуждений внутри них — так проще потом отдельно посчитать стоимость по каждой статье.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Посмотреть скрипт сравнения уровней (Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Один ключ — можно сравнить несколько уровней
)

# Цены Standard для короткого контекста, USD / миллион токенов (выходные токены уже включают токены рассуждений)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # Намеренно нет даты — проверяем, будет ли модель уточнять
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """Оценивает каждый пункт по критериям и возвращает оценку от 0 до 1"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
Автоматические проверки в скрипте покрывают только те критерии, которые можно проверить машиной; достоверность ссылок и качество уточняющих вопросов всё ещё нужно проверять вручную. Значения параметров для уровней рассуждений (особенно строки для Xhigh и Max) сверяйтесь с актуальной официальной документацией и описанием параметров в используемом сервисе.
🚀 Быстрый старт: зарегистрируйтесь на APIYI apiyi.com и получите бесплатные тестовые кредиты. Платформа предоставляет OpenAI-совместимый интерфейс; скрипт выше заработает, если просто заменить ключ. Это удобно, чтобы перед окончательным выбором уровня провести небольшую проверку на выборке.
Границы переноса выводов LifeVal для GPT-6.2 Sol
Перенося выводы LifeVal на собственный продукт, стоит учитывать как минимум три различия. Первое — язык и регион: выборка в статье в основном состоит из англоязычных пользователей из США, а в китайскоязычном сценарии экосистемы карт, платежей и календарей совсем другие. Второе — среда: LifeVal работает в контролируемой среде и на кэшированных веб-страницах, а реальный продукт сталкивается с нестабильной сетью, отказами в авторизации инструментов и различиями в состоянии аккаунтов. Третье — структура затрат: официальная стоимость отдельного пункта соответствует соотношению входа и выхода в этом тесте; если запрос с длинным контекстом превышает 272K входных токенов, он целиком переключается на более высокий тариф, поэтому стоимость отдельного пункта может сильно расходиться с графиком.
Поэтому разумнее использовать официальные графики как основание, чтобы «сузить список кандидатов», а собственный набор задач — как основание для «окончательного решения». Для сложного повседневного ассистента можно сначала построить базовую линию на уровне High, а затем отдельно проверить, удерживает ли Medium ключевые жёсткие ограничения и заметно ли Xhigh или Max сокращают ручную доработку; ориентироваться стоит на фактическую долю успешно выполненных задач и счета.
Когда ваш набор задач, критерии оценки и проверки среды готовы, обновление модели перестаёт быть «сменой модели по рейтингу» и становится инженерным процессом, который можно повторно тестировать каждый раз. Если нужно многократно сравнивать несколько моделей и уровней, можно воспользоваться единым интерфейсом APIYI apiyi.com и запустить GPT-6.2 Sol, GPT-6.2 Astra и другие в одном наборе приёмочных скриптов.
Справочные материалы
-
Анонс выпуска OpenAI GPT-6.2 Astra и Sol (с диаграммой разбивки LifeVal по уровням)
- Ссылка:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - Описание: опубликовано 2026-11-17; источник данных по уровням в этой статье
- Ссылка:
-
Страница исследования LifeVal и статья
- Ссылки:
openai.com/index/lifeval,cdn.openai.com/pdf/lifeval.pdf - Описание: источник заданий, метод подсчёта баллов и описание ограничений (разделы §3–§5 статьи)
- Ссылки:
-
Карточка модели GPT-6.2 Sol и официальные цены
- Ссылка:
developers.openai.com/api/docs/models/gpt-6.2-sol - Описание: спецификации контекстного окна, правила тарификации короткого и длинного контекста и лимиты
- Ссылка:
-
Сводная таблица моделей APIYI
- Ссылка:
docs.apiyi.com/models.md - Описание: публично доступные модели, точки входа и информация о тарифах
- Ссылка:
Автор: Техническая команда APIYI
По техническим вопросам: свяжитесь с нами на официальном сайте APIYI apiyi.com; больше материалов по интеграции — в центре документации docs.apiyi.com