Стоимость вызова API GPT-6.2 Sol складывается из трёх шагов. Шаг первый — общий объём ввода в одном запросе: порог 272K токенов отделяет короткий контекст от длинного. Если порог превышен, для всего запроса ставки на ввод и кеш умножаются на 2, а на вывод — на 1,5. Шаг второй — класс обслуживания по сроку выполнения: Standard идёт по базовой цене, Batch — 50% от неё, фоновые окна 8h и 2h — 60% и 70% соответственно, Fast — ×2, Ultrafast — ×3 до 2027-02-28 (по тихоокеанскому времени) и ×6 после. Шаг третий — умножаем стоимость одного запроса на месячное количество запросов и добавляем вызовы инструментов, применимые региональные сборы и повторы.
Цены для короткого контекста Standard по прайсу: обычный ввод — $2.00 за миллион токенов, чтение из кеша — $0.10, вывод (включая reasoning-токены) — $10.00. При таких ценах интерактивный запрос на 20 000 токенов ввода и 3 000 токенов вывода стоит примерно $0.07, а 2 000 таких запросов в месяц — около $140. Все цены в статье — в долларах за миллион токенов; проверено 2026-11-20 (по пекинскому времени).
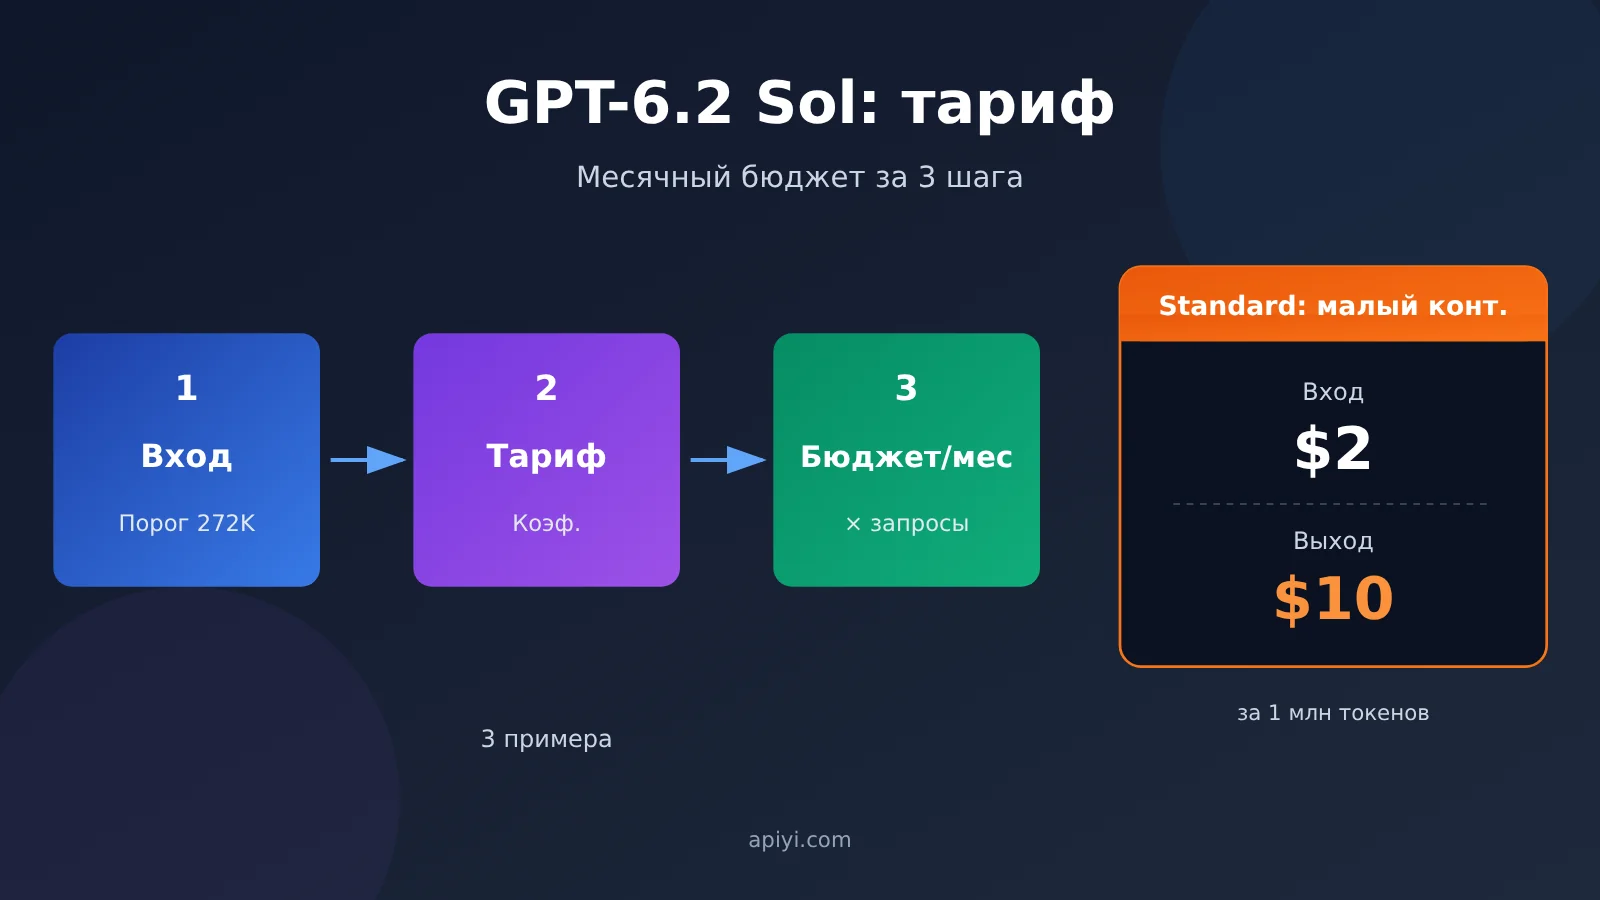
Карта знаний и индекс для чтения по тарификации GPT-6.2 Sol API
Весь текст разворачивается в порядке «оценка объёма ввода → выбор по сроку доставки → совокупные вызовы». В таблице ниже для каждого шага собраны вопрос, на который нужно ответить, его результат и номер раздела в тексте: результат предыдущего раздела служит входом для следующего.
| Шаг | Вопрос, на который отвечаем | Результат шага | Раздел в тексте |
|---|---|---|---|
| Оценка объёма ввода | Попадает ли этот запрос в короткий или длинный контекст | Применимая базовая таблица тарифов | 1, 3.2 |
| Выбор по сроку доставки | Пользователь ждёт онлайн или можно доставить через несколько часов или на следующий день | Коэффициент сервисного уровня | 2, 3.1 |
| Совокупные вызовы | Сколько запросов в месяц и какие ещё есть дополнительные расходы | Месячный бюджет | 2, 4 |
| Пересчёт по каналам | Сколько будет стоить тот же запрос через другой канал биллинга | Сравнение каналов и таблица бюджета | 4 |
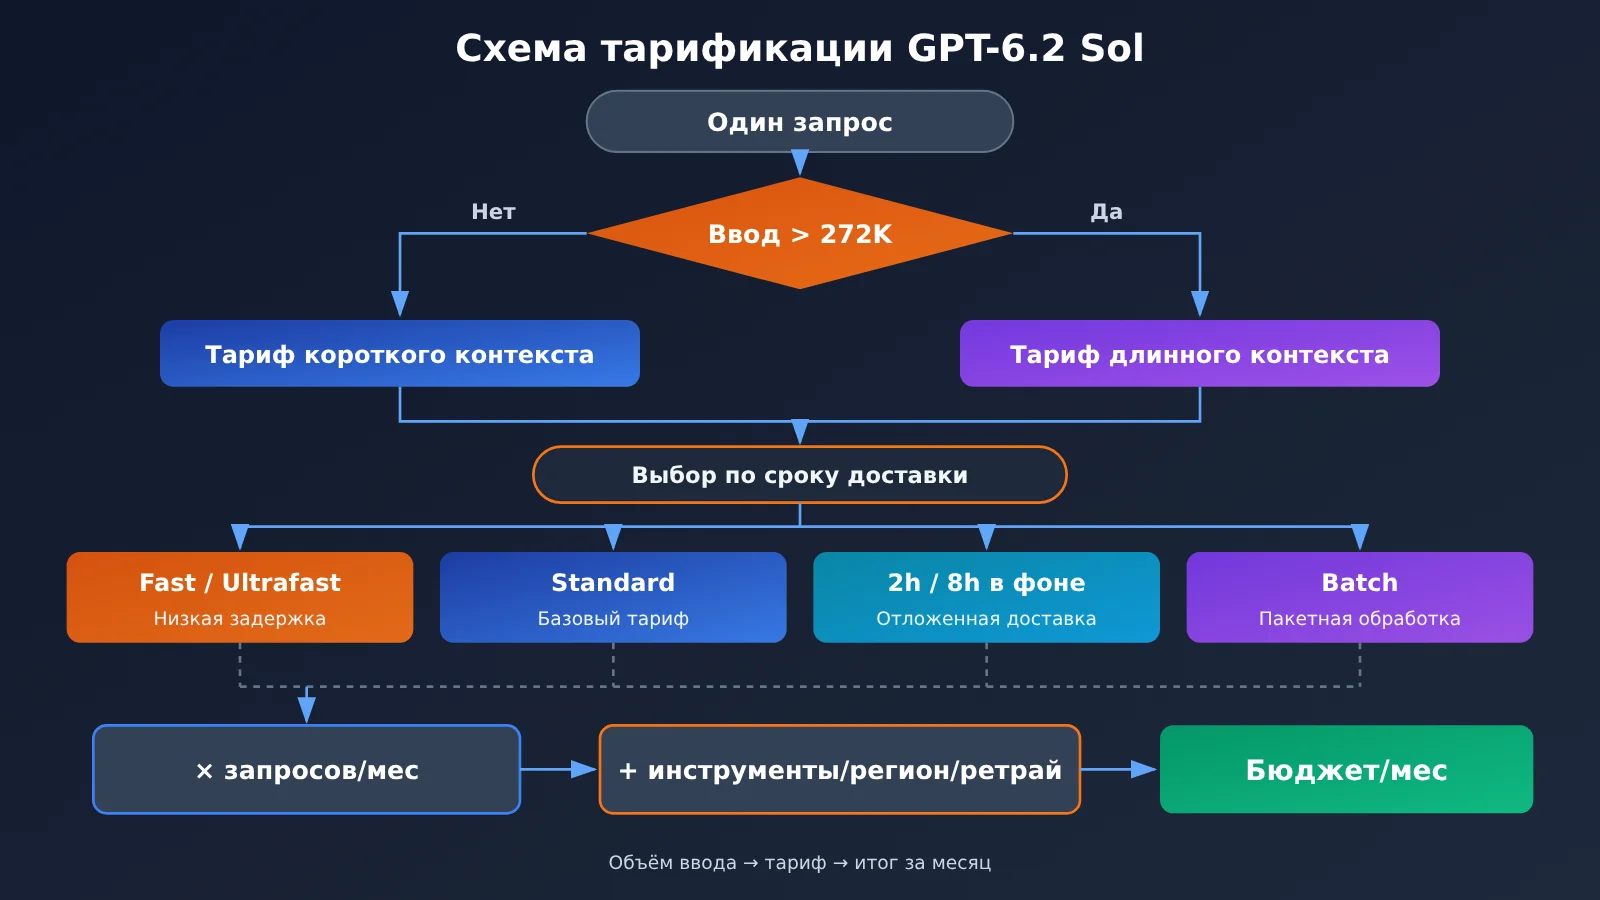
Что касается порядка чтения: раздел 1 даёт базовые тарифы — это основа для всех последующих расчётов. Разделы 2 и 3 соответствуют двум типам бизнеса — «пользователь ждёт результат онлайн» и «допускается отложенная доставка» — и можно читать только тот раздел, который относится к вашему случаю. Раздел 4 применяет прежнюю методику к публичному прайс-листу APIYI apiyi.com и официальным тарифам OpenAI, выполняя параллельный пересчёт, и в конце даёт таблицу месячного бюджета, которую можно заполнить напрямую.
Термины тарификации GPT-6.2 Sol To Know
| Термин | Пояснение |
|---|---|
| Token | Базовая единица измерения текста и других входных и выходных данных модели; количество определяется статистикой, возвращаемой сервером |
| Standard | Стандартный режим обработки официального API, а также базовая точка отсчёта для коэффициентов других уровней |
| Чтение кэша | Когда запрос повторно использует уже кэшированный исторический префикс, эта часть ввода тарифицируется по ставке чтения кэша |
| Запись кэша | Отдельная категория тарификации для сохранения подходящего префикса с целью повторного использования в будущем, с двумя уровнями: 30 минут и 12 часов |
| Тарифицируемый вывод | Объём вывода, который фиксирует API, включая токены рассуждения и конечный вывод |
| Batch API | Интерфейс для отправки заранее подготовленных независимых запросов в виде файла на фоновую пакетную обработку |
| Окно завершения | Целевой срок для начального ответа, установленный после принятия фонового запроса |
| Fast и Ultrafast | Два уровня с высокой ставкой для сценариев с низкой задержкой |
1. Какие тарифы действуют на один запрос к API GPT-6.2 Sol
1.1 Пять категорий тарификации в тарифе Standard
ID модели API у GPT-6.2 Sol — gpt-6.2-sol, её можно вызывать через два эндпоинта: Responses и Chat Completions. Один запрос может затрагивать до пяти категорий тарификации; в таблице ниже — официальные цены тарифа Standard. Базовые цены для короткого контекста такие же, как у GPT-6.1 Sol; значения в столбце длинного контекста рассчитаны по коэффициентам из карточки модели.
| Категория тарификации Standard | Короткий контекст (≤272K входа) | Длинный контекст (>272K входа) |
|---|---|---|
| Обычный вход | $2.00 | $4.00 |
| Чтение из кэша | $0.10 | $0.20 |
| Запись в кэш на 30 минут | $2.50 | $5.00 |
| Запись в кэш на 12 часов | $5.00 | $10.00 |
| Выход (включая токены рассуждений) | $10.00 | $15.00 |
В таблице есть три момента, на которых легко ошибиться в расчётах.
- Запись в кэш не складывается с обычным входом. Токены, записанные в кэш, тарифицируются один раз по полной ставке тарифа на 30 минут или на 12 часов и больше не считаются дополнительно по обычному входу.
- Токены рассуждений входят в выход. Возвращаемый Responses
usage.output_tokens— это общий объём выхода, расход на рассуждения обычно указывается подпунктом вoutput_tokens_details.reasoning_tokens, так что бюджет достаточно считать по общему объёму. - Переключение тарифа применяется ко всему запросу. Как только общий объём входа превышает 272K, вход, кэш и выход всего запроса переводятся на тариф длинного контекста — наценка не применяется только к превышающей части.
В карточке модели также указаны контекстное окно 1 050 000 токенов, максимальный вход 922 000 токенов и максимальный выход 128 000 токенов. 922K — это максимально допустимый вход, 272K — точка переключения тарификации, и эти два значения друг с другом никак не связаны.
1.2 Расходы сверх стоимости модели
Таблица выше покрывает только плату за токены модели. В Responses Sol может вызывать такие инструменты, как поиск по файлам, веб-поиск, интерпретатор кода и генерация изображений, — и при реальном использовании каждый из них тарифицируется по своим отдельным правилам. При генерации изображений Sol инициирует вызов инструмента, а само изображение выдаёт отдельный инструмент изображений, поэтому плату за изображения считают separately. При развёртывании в конкретном регионе могут также возникать применимые региональные сборы. В бюджетной таблице стоит отвести под эти статьи отдельные колонки и не смешивать их с ценой за токен.
1.3 Считываем фактическое потребление с помощью кода
После оценки нужно сверяться с полем usage реальных запросов. В примере ниже Sol вызывается через OpenAI-совместимый интерфейс, а стоимость модели за этот вызов пересчитывается по тарифу Standard для короткого контекста:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input="用三句话说明 Batch API 适合什么任务。"
)

u = resp.usage
cached = getattr(getattr(u, "input_tokens_details", None), "cached_tokens", 0) or 0
plain_in = u.input_tokens - cached
cost = (plain_in * 2.00 + cached * 0.10 + u.output_tokens * 10.00) / 1e6
print(resp.output_text)
print(f"输入 {u.input_tokens},其中缓存 {cached},输出 {u.output_tokens},模型费约 ${cost:.6f}")
Этот пересчёт применим только к Standard-запросам с входом не более 272K и без записи в кэш. В продакшене советую писать usage каждого запроса в логи, а потом, агрегировав по типам задач, заполнять бюджетную таблицу из раздела 4.
🎯 Официальная рекомендация: прежде чем окончательно утверждать бюджет, прогоните 20–50 реальных бизнес-запросов и посмотрите на распределение входа и выхода. У новых пользователей APIYI apiyi.com есть бесплатная тестовая квота — как раз для такой калибровки на небольшой выборке.
2. Как рассчитать интерактивные тарифы и месячный бюджет для GPT-6.2 Sol
2.1. Стоимость одного запроса в трёх интерактивных тарифах
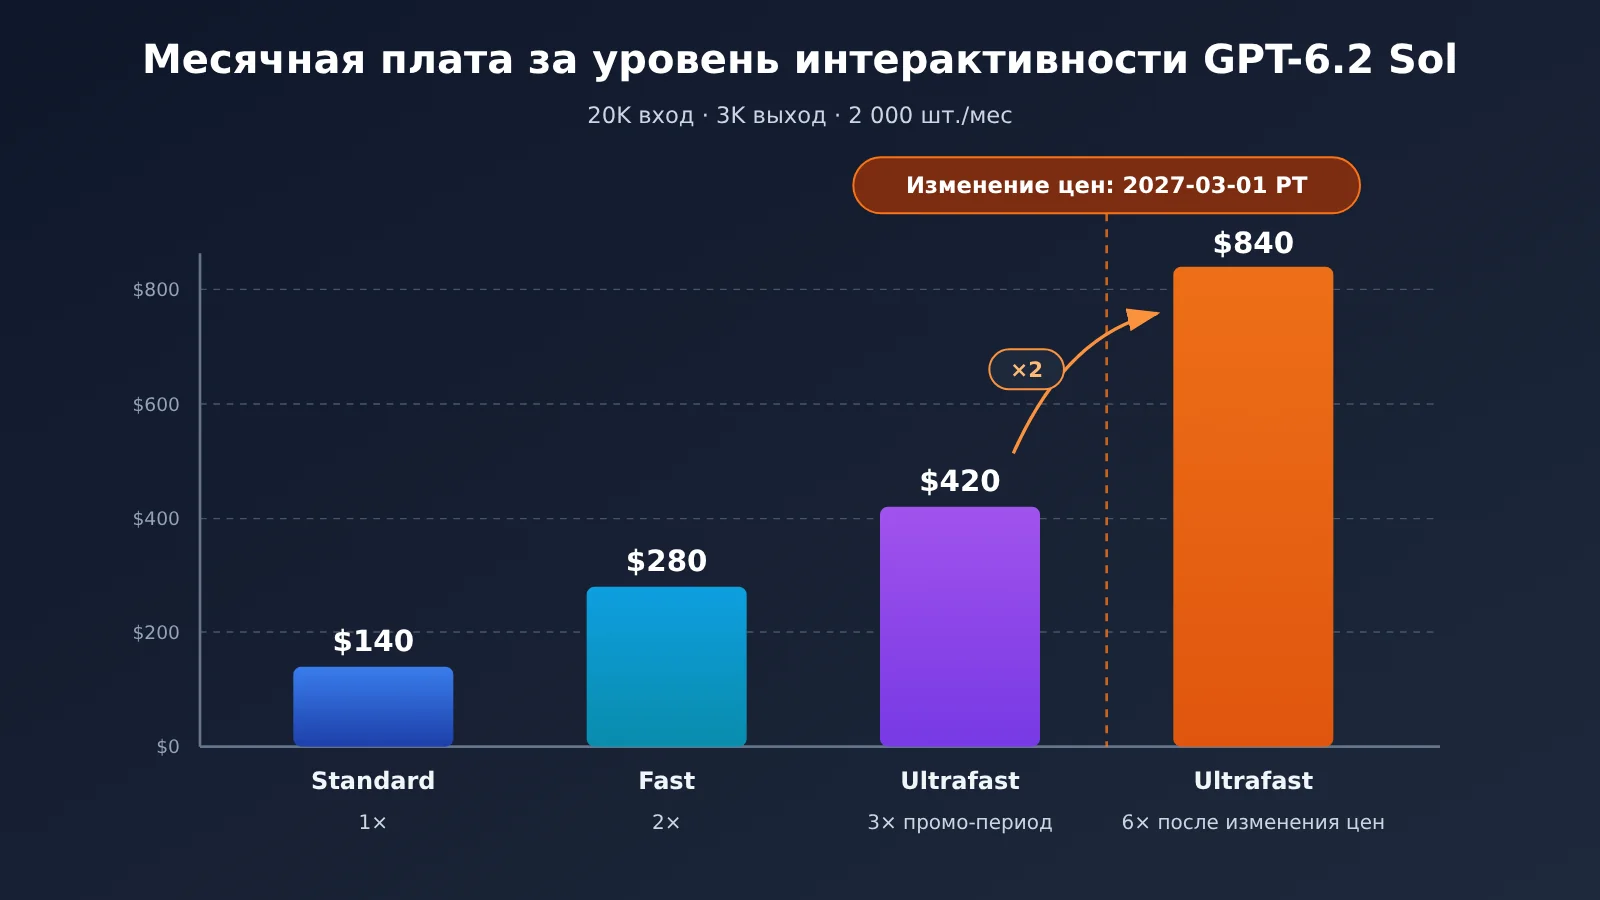
В интерактивных сценариях пользователь ждёт результат в интерфейсе, и ему доступны Standard, Fast и Ultrafast. Fast тарифицируется с коэффициентом 2× к Standard; Ultrafast до 2027-02-28 (по тихоокеанскому времени, PT) идёт с коэффициентом 3×, а с 2027-03-01 — 6×. GPT-6.2 Sol не поддерживает тариф Flex.
В примере предполагается, что один запрос содержит 20 000 обычных входных и 3 000 оплачиваемых выходных токенов; кеширование, инструменты, региональные сборы и повторные попытки не учитываются; в месяц — 2 000 запросов. Стоимость одного запроса в Standard: 20000×2/1e6 + 3000×10/1e6 = $0.07.
| Тариф | Коэффициент | Стоимость за запрос | За 2 000 запросов в месяц |
|---|---|---|---|
| Standard | 1× | $0.07 | $140 |
| Fast | 2× | $0.14 | $280 |
| Ultrafast (до 2027-02-28, PT) | 3× | $0.21 | $420 |
| Ultrafast (с 2027-03-01, PT) | 6× | $0.42 | $840 |
2.2. Какие условия важно учитывать при чтении таблицы
В таблице фиксируется расход на один запрос, чтобы удобнее планировать бюджет. На практике для одной и той же задачи расход токенов и задержка на разных тарифах будут меняться от запроса к запросу, поэтому перед запуском стоит прогнать партию реальных запросов на каждом из кандидатных тарифов и перепроверить расчёт.
Если вы планируете бюджет на Ultrafast до марта 2027 года, подготовьте также вариант с коэффициентом 6×. В нашем примере после изменения цены месячная стоимость вырастет с $420 до $840. Цена меняется 1 марта по тихоокеанскому времени; по Пекину это вторая половина дня 1 марта.
💡 Совет по выбору тарифа: большинство интерактивных запросов стоит сначала запускать на Standard, а на Fast или Ultrafast переключать только отдельные чувствительные к задержке точки входа. Через APIYI apiyi.com можно параллельно тестировать с одним и тем же API-ключом и быстрее получить реальные данные по задержке и расходу для каждого тарифа.
3. Как оценить расходы на ночную обработку и длинные документы в GPT-6.2 Sol
3.1 Ночные пакетные задачи: 2h, 8h и Batch
Для задач, где не нужен мгновенный ответ, есть три способа получить скидку. В фоновом режиме Responses окна завершения 2h и 8h тарифицируются как 70% и 60% от ставки за токены Standard-модели соответственно, но запрос должен быть Standard и нестриминговым, а окно означает целевое время для начального ответа; у soonest скидки за окно нет. Batch API стоит 50% от Standard, запросы отправляются пакетом через файл, а срок выполнения — 24 часа.
В примере расчёта — 10 000 запросов, в каждом 50 000 обычных входных и 4 000 тарифицируемых выходных токенов, без кеша и инструментов. Стоимость одного вызова по Standard: 50000×2/1e6 + 4000×10/1e6 = $0.14.
| Способ | Ставка | Стоимость за запрос | Итого за 10 000 | Когда использовать |
|---|---|---|---|---|
| Standard | 100% | $0.14 | $1,400 | Результат нужен как можно скорее |
Фоновый 2h |
70% | $0.098 | $980 | Приложению нужен начальный ответ в течение двух часов, а по ходу задачи требуется подставлять результаты инструментов |
Фоновый 8h |
60% | $0.084 | $840 | Отправить вечером, получить до начала работы на следующий день, при этом нужна пошаговая интерактивность |
| Batch API | 50% | $0.07 | $700 | Запросы уже готовы, независимы друг от друга, можно выдать на следующий день |
Отталкиваться можно от характера задачи. Независимые задачи вроде классификации или извлечения данных, которые можно целиком подготовить до отправки, удобно считать по цене Batch как по базовой. Если по ходу задачи приложению нужно подставлять результаты инструментов и продолжать, оценивайте каждый шаг отдельно, а затем выбирайте окно 2h или 8h исходя из общего срока выдачи результата на стороне приложения.
Есть ещё ограничение по ёмкости: запросы со скидкой в фоновом режиме и Batch делят одну отдельную квоту очереди. Перед тем как планировать массовую отправку, стоит проверить квоту на накопленные входные токены, чтобы запросы не застряли в очереди.
3.2 Длинные документы: скачок стоимости при пересечении 272K
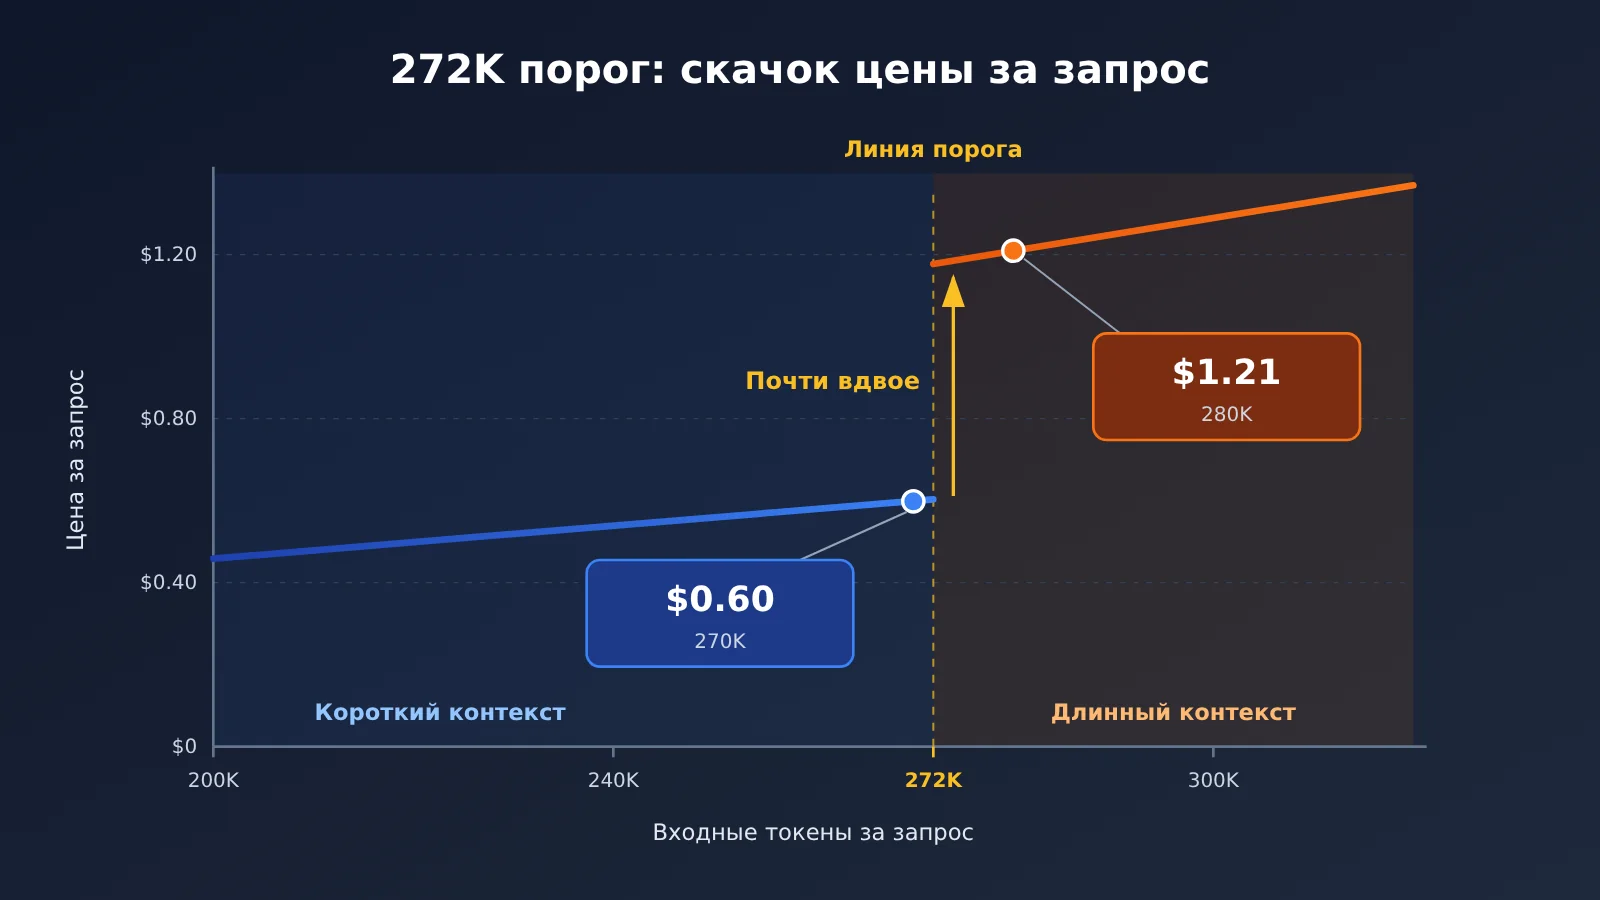
Скачок стоимости на длинных документах возникает из-за правил смены тарифа. В расчёте предполагается отсутствие кеша и инструментов, фиксированный объём вывода 6,000 токенов, тариф Standard, а входные данные — 270,000 и 280,000 токенов соответственно:
| Объём ввода | Применяемый тариф | Расчёт | Стоимость одного вызова модели |
|---|---|---|---|
| 270,000 | короткий контекст | 270000×2/1e6 + 6000×10/1e6 |
$0.60 |
| 280,000 | длинный контекст | 280000×4/1e6 + 6000×15/1e6 |
$1.21 |
Ввод вырос всего на 10,000 токенов, но стоимость одного вызова изменилась с $0.60 до $1.21 — примерно вдвое. Причина в том, что весь запрос целиком пересчитывается по тарифу длинного контекста, а цена вывода тоже поднимается с $10 до $15.
При планировании бюджета стоит фиксировать распределение входных данных по каждому запросу в разрезе бизнес-очередей, а затем оценивать обычные запросы и пиковые нагрузки с длинными документами отдельно и уже потом суммировать. Если вы собираетесь обрезать документы, чтобы уложить ввод ниже 272K, обязательно проверьте, сохранился ли после обрезки весь объём доказательств, необходимый для сдачи результата. Иначе экономию могут съесть затраты на переделку.
4. Заполнение месячного бюджета GPT-6.2 Sol по каналам
4.1 Сопоставительный пересчёт по публичному прайс-листу APIYI и официальным тарифам OpenAI
Если снова открыть публичную сводную таблицу моделей APIYI и публичный интерфейс цен по состоянию на 2026-11-20, в обоих можно найти gpt-6.2-sol; в сводной таблице указаны два входа — responses и chat. Публичные цены тоже делятся на ступени по 272,000 входных токенов, но формула расчёта для длинной ступени отличается от официального множителя.
| Категория тарификации (USD / миллион токенов) | OpenAI, короткая ступень | OpenAI, длинная ступень | APIYI apiyi.com, короткая ступень | APIYI apiyi.com, длинная ступень |
|---|---|---|---|---|
| Обычный ввод | $2.00 | $4.00 | $2.00 | $3.00 |
| Чтение кэша | $0.10 | $0.20 | $0.10 | $0.15 |
| Запись в кэш | $2.50 (30 минут) | $5.00 (30 минут) | $2.50 | $3.75 |
| Вывод | $10.00 | $15.00 | $10.00 | $11.25 |
Возьмём тот же расчёт по объёму использования, что и в разделе 3.2. При 270,000 входных и 6,000 выходных токенов оба канала дают $0.60. При 280,000 входных и 6,000 выходных токенов у официального OpenAI получается $1.21, а по публичной формуле APIYI — (280000×3 + 6000×11.25)÷1e6 = $0.9075; разница составляет около $0.30 на каждый запрос. Чем выше доля длинных документов, тем сильнее эта разница влияет на месячный бюджет.
Приведённая выше разница выведена только из параметров, которые обе стороны уже опубликовали. В предыдущем тексте скидки Batch и фонового окна считались по официальному примеру OpenAI; при вызовах через APIYI группа аккаунта, фактические списания, доступные ступени и возможности API определяются текущей конфигурацией APIYI и данными биллинга.
4.2 Таблица месячного бюджета: одна строка — один тип задачи
Переложим предыдущий алгоритм на таблицу: каждый тип задачи занимает одну строку, заполняем по среднему расходу на один запрос, затем умножаем на число запросов в месяц. Если в рабочем процессе есть несколько вызовов модели (например, многошаговое рассуждение агента), каждый шаг записывается отдельной строкой, а в конце всё суммируется построчно.
| Тип задачи | Запросов в месяц | Средний обычный ввод | Среднее чтение кэша | Запись в кэш (уровень) | Средний оплачиваемый вывод | Контекстное окно | Уровень обслуживания | Отдельные расходы (инструменты / регион) | Ожидаемый процент повторов | Месячная стоимость |
|---|---|---|---|---|---|---|---|---|---|---|
| Взаимодействие с поддержкой | 2,000 | 20,000 | 0 | 0 | 3,000 | Короткое | Standard | Нет | 0% | $140 |
| Ночная классификация | 10,000 | 50,000 | 0 | 0 | 4,000 | Короткое | Batch | Нет | 0% | $700 |
| Проверка договоров | По факту | По факту | 6,000 | Длинное | Standard | По факту | По факту |
Цифры в первых двух строках взяты из примеров расчёта в этой статье — можно использовать их как образец для заполнения. Формула месячной стоимости: «стоимость одного вызова модели × число запросов в месяц × (1 + процент повторов) + отдельные расходы». При этом стоимость одного вызова модели берётся из таблицы тарифов в разделе 1 — по уровню контекстного окна и уровню обслуживания, указанным в этой строке.
🚀 Практический совет: после заполнения таблицы бюджета выберите два типа задач с самыми большими суммами и прогоните на APIYI apiyi.com по одному циклу реальных запросов, затем замените оценки фактическими значениями из
usage— и получите бюджет, который можно отдать в бухгалтерию.
4.3 Проверка надёжности бюджета
Получив счёт за первый месяц, постройчно проверьте три пункта.
- Близка ли доля запросов с длиной более 272K в фактическом распределении входных данных к прогнозу.
- Заметно ли доля токенов рассуждения в
output_tokensвыше, чем на этапе тестирования. - Учтены ли фактические количества повторных попыток и вызовов инструментов.
Если отклонение по всем трём пунктам в пределах 10%, в следующем месяце можно просто работать с этой таблицей. Пункт с бо́льшим отклонением — это то место, где в первую очередь нужно корректировать объём использования или уровень обслуживания.
Справочные материалы
- Официальное ценообразование API OpenAI: коэффициенты для уровней обслуживания, скидки на Batch и фоновое окно
- Ссылка:
developers.openai.com/api/docs/pricing
- Ссылка:
- Карточка модели GPT-6.2 Sol: контекстное окно, правила переключения уровней на 272K и ограничения
- Ссылка:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Ссылка:
- Руководство по фоновому режиму и Batch API: окна завершения, требования к нестриминговым запросам и квоты очереди
- Ссылка:
developers.openai.com/api/docs/guides/background,developers.openai.com/api/docs/guides/batch
- Ссылка:
- Сводная таблица моделей APIYI и открытый интерфейс ценообразования: точка входа для
gpt-6.2-solи формулы расчёта стоимости при переключении уровней- Ссылка:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing
- Ссылка:
Автор: Техническая команда APIYI
Техническая связь: по вопросам методики расчёта стоимости и настройки аккаунта вы можете связаться с нами через главную страницу официального сайта APIYI. Больше материалов по интеграции см. в центре документации docs.apiyi.com