Примечание автора: разберём публичные баллы Gemini 4 Neon по трём блокам — программирование, интеллектуальная работа и наука, — с указанием источника по каждому пункту, чтобы вы поняли, какие задачи имеет смысл ему поручать.
18 ноября 2026 года Google выпустила Gemini 4 Neon. Сундар Пичаи в посте о релизе описал её позиционирование как «быстрее доводить до конца» сложные задачи программной инженерии, интеллектуальной работы и научных процессов. В тот же день DeepMind опубликовал карточку модели, а Artificial Analysis выпустила статью с независимыми измерениями и страницу модели — публичных данных сразу стало несколько наборов.
Проблема в том, что у этих наборов цифр разная методика. В блоге Google — официальные данные от самой компании; хотя в сравнительной таблице карточки модели указаны Claude Opus 5.5 и GPT-6.2 Sol, в примечаниях к оценке сказано, что результаты не-Gemini по умолчанию взяты из самоотчётов соответствующих компаний; только Artificial Analysis — независимое измерение. В этой статье дата сверки данных — 19 ноября 2026 года; для каждого пункта сохранён ярлык источника, а расходящиеся цифры из двух наборов приведены рядом, без усреднения.
Главное: после прочтения у вас будет таблица по типам задач — вы увидите, в каких пунктах по программированию, чтению материалов и науке Gemini 4 Neon официально назван первым, где в карточке модели конкуренты выше, а где по независимым замерам он впереди всего на 1 балл.
Gemini 4 Neon: ключевые моменты — сначала входная точка, потом три блока
Общий балл — это цифра, которую большинство видит первой. В статье Artificial Analysis указано, что Gemini 4 Neon на уровне рассуждений xhigh получает 61 балл интеллекта и занимает 3-е место в общем зачёте, впереди — GPT-6.2 Astra (max) и Claude Fable 5.2 (max). В блоге Google (официальные данные) тоже указаны 61 и 3-е место, плюс добавлено: «уступает более крупным и медленным моделям». В карточке модели в строке AA Index v5.0.1 тоже стоит 61, для сравнения Opus 5.5 — 59, Sol — 57.
Эти 61 совпадают во всех трёх источниках, но это лишь входная точка. Общий балл смешивает программирование, чтение материалов и науку, а задача, которую вам нужно сдать, обычно относится только к одному из этих блоков. В таблице ниже сначала поясняется характер трёх типов источников, а в следующих разделах разберём каждый блок по отдельности.
| Источник | Характер | Что в статье берём из него |
|---|---|---|
| Блог Google | Официальные данные | Какие пункты Google называет первыми и какие у них оценки |
| Карточка модели DeepMind | Официальная сводка; результаты не-Gemini в основном предоставлены самими компаниями | Постатейное сравнение трёх колонок: Neon, Opus 5.5 и Sol |
| Статья Artificial Analysis | Независимые измерения | Coding Agent Index, GDP.pdf, MKA и т. д. |
| Страница модели Artificial Analysis | Независимые измерения с разбивкой по уровням рассуждений | Разница в баллах интеллекта между четырьмя уровнями рассуждений |
Место Gemini 4 Neon в семействе
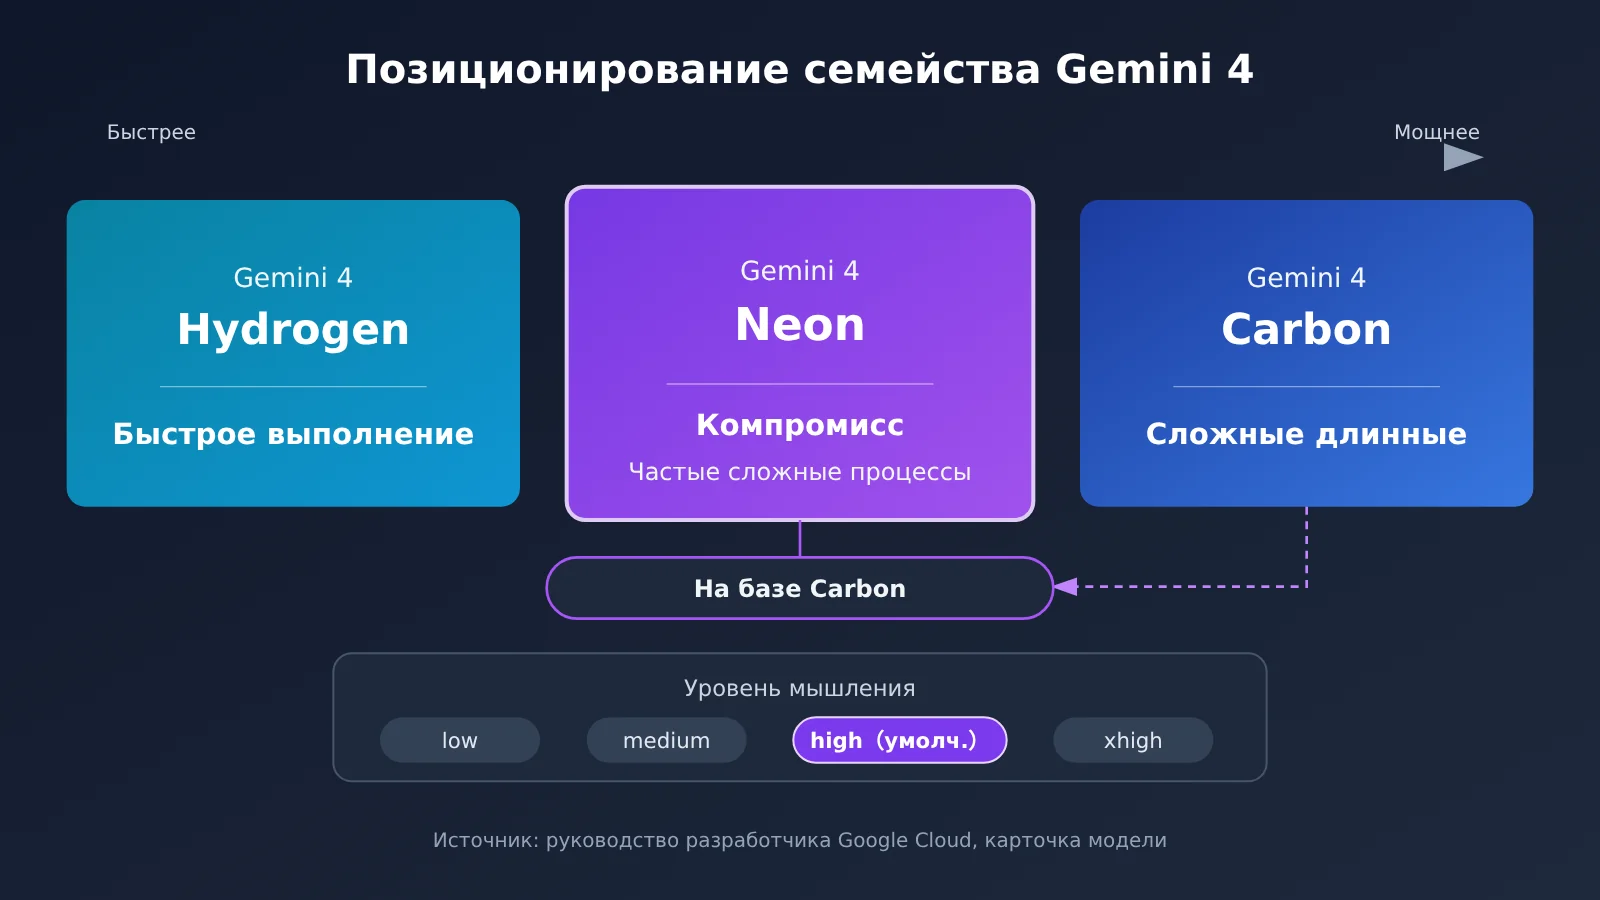
В карточке модели указано, что Gemini 4 Neon создан на основе Gemini 4 Carbon, знания отсечены по март 2026 года, на входе поддерживаются текст, изображения, аудио и видео, а единое контекстное окно — до 1 млн токенов. В руководстве для разработчиков Google Cloud его ставят между Hydrogen (повседневные быстрые циклы) и Carbon (сложные длительные задачи), а официальный блог говорит, что модель рассчитана на высокочастотные сложные процессы.
Понимание этого позиционирования помогает читать дальнейшие оценки. В разных источниках у Neon разные объекты сравнения: в карточке модели есть только две колонки — Opus 5.5 и Sol, без Fable 5.2, Astra и Carbon; Artificial Analysis в основном сравнивает его с Carbon, Fable и Opus. При сравнении по отдельным пунктам мы не будем подставлять данные из других ячеек, чтобы заполнить пробелы.
Программирование на Gemini 4 Neon: два показателя впереди, два — немного уступают Opus
Программированию в блоге Google уделено больше всего места. По официальным данным, Gemini 4 Neon набирает 58.6 в Artificial Analysis Coding Agent Index и занимает 1-е место в общем зачёте. В статье Artificial Analysis приводится цифра 59, измеренная на Antigravity CLI с Neon xhigh. 58.6 и 59 взяты из двух источников — в этой статье мы сохраняем обе.
Отдельно стоит посмотреть на отрыв от третьих сторон. В статье Artificial Analysis Fable xhigh на Claude Code и Opus 5.5 max показывают по 58, Carbon high — 55. То есть преимущество Neon над этими двумя моделями Claude составляет 1 балл.
В модельной карточке разбивка детальнее, и в двух пунктах Opus 5.5 выше.
| Пункт программирования (модельная карточка) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | нет данных |
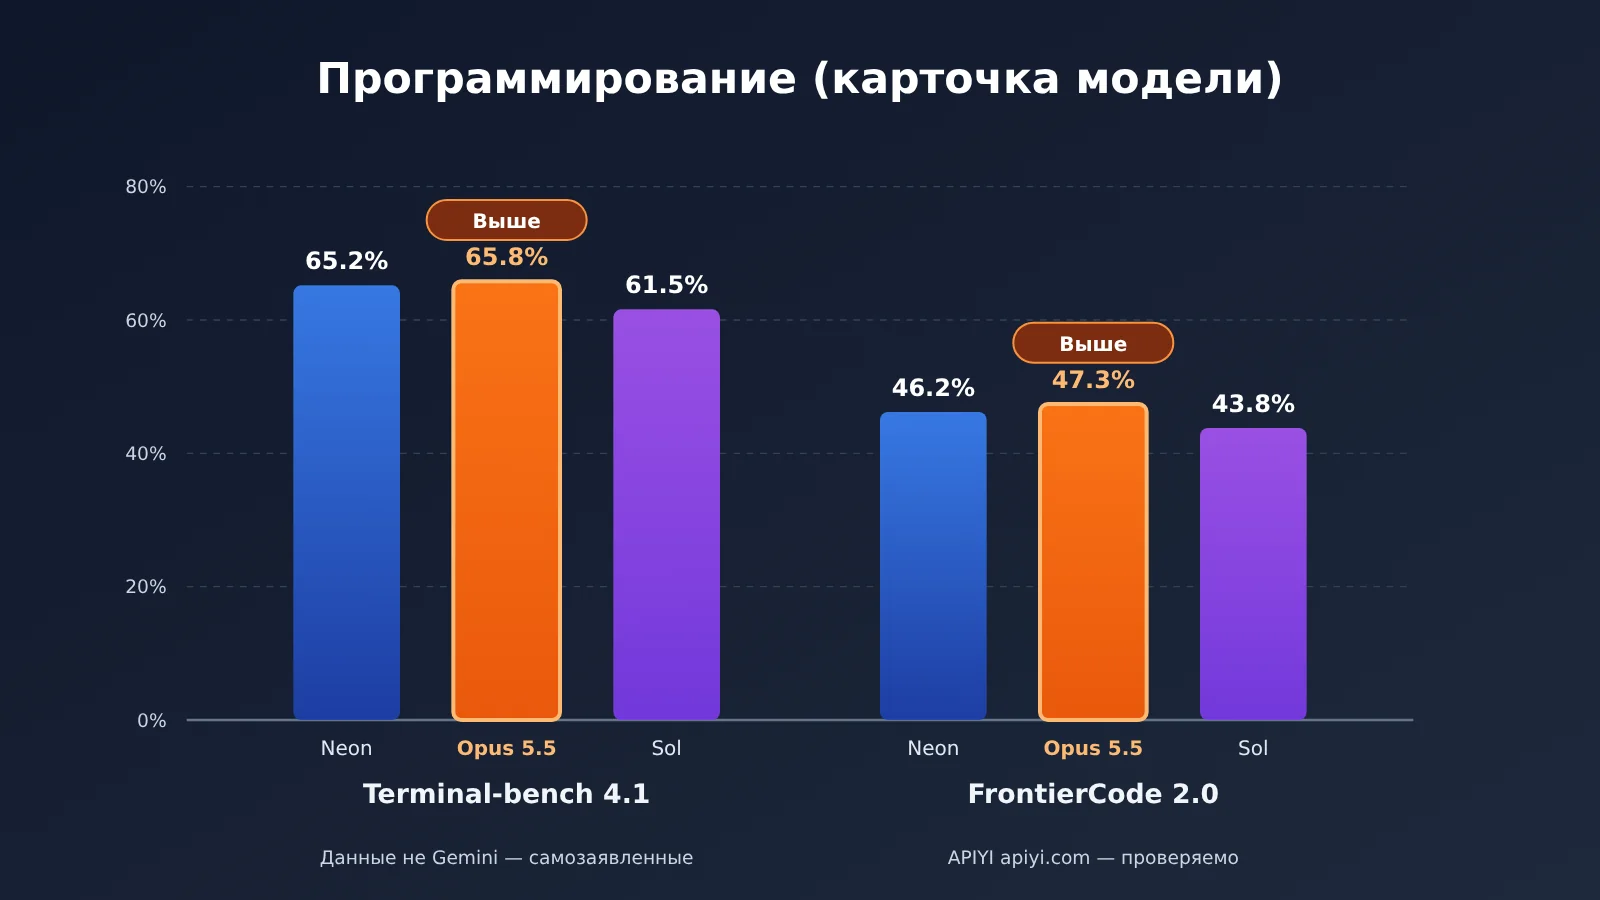
| Terminal-bench 4.1 (после поправки на читерство) | 65.2% | 65.8% | 61.5% |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% |
| SWE-sweep, harness производителя | 39.0% | 10.1% | 8.3% |
| SWE-sweep, harness mini-SWE | 12.8% | 3.6% | 11.6% |
Как читать программировочные баллы Gemini 4 Neon
На Terminal-bench 4.1 у Opus 5.5 — 65.8%, у Neon — 65.2%; на FrontierCode 2.0 у Opus 5.5 — 47.3%, у Neon — 46.2%. Разница в обоих случаях около одного процентного пункта, но в сторону чуть более высокого Opus. В официальном блоге 46.2% на FrontierCode 2.0 помечены как уровень high по умолчанию.
Два числа SWE-sweep проще всего прочитать неверно. 12.8% — результат под harness mini-SWE, 39.0% — результат в Google Antigravity (harness производителя). В официальном блоге разрыв между ними описывают как «разблокировку», которую даёт harness: это отражает роль инструментальной цепочки, и не стоит читать это как трёхкратное различие самих моделей. Обратите внимание: под harness mini-SWE Sol показывает 11.6%, что довольно близко к 12.8% у Neon.
Работа со знаниями в Gemini 4 Neon: в большинстве пунктов лидирует, Chartography — единственный, где выше Sol
В блоке про работу со знаниями официальный блог перечисляет немало «первых мест». Legal Research Bench и Tax Agent Bench названы первыми, но блог не приводит процентных значений по этим двум пунктам; по финансам, бухгалтерии, табличному моделированию и задачам со сложными ограничениями на Surge тоже говорится, что в большинстве случаев первые места, и тоже без баллов по каждому пункту. Всё это можно записать лишь как ранжирование, заявленное официально; в этой статье мы не подставляем цифры.
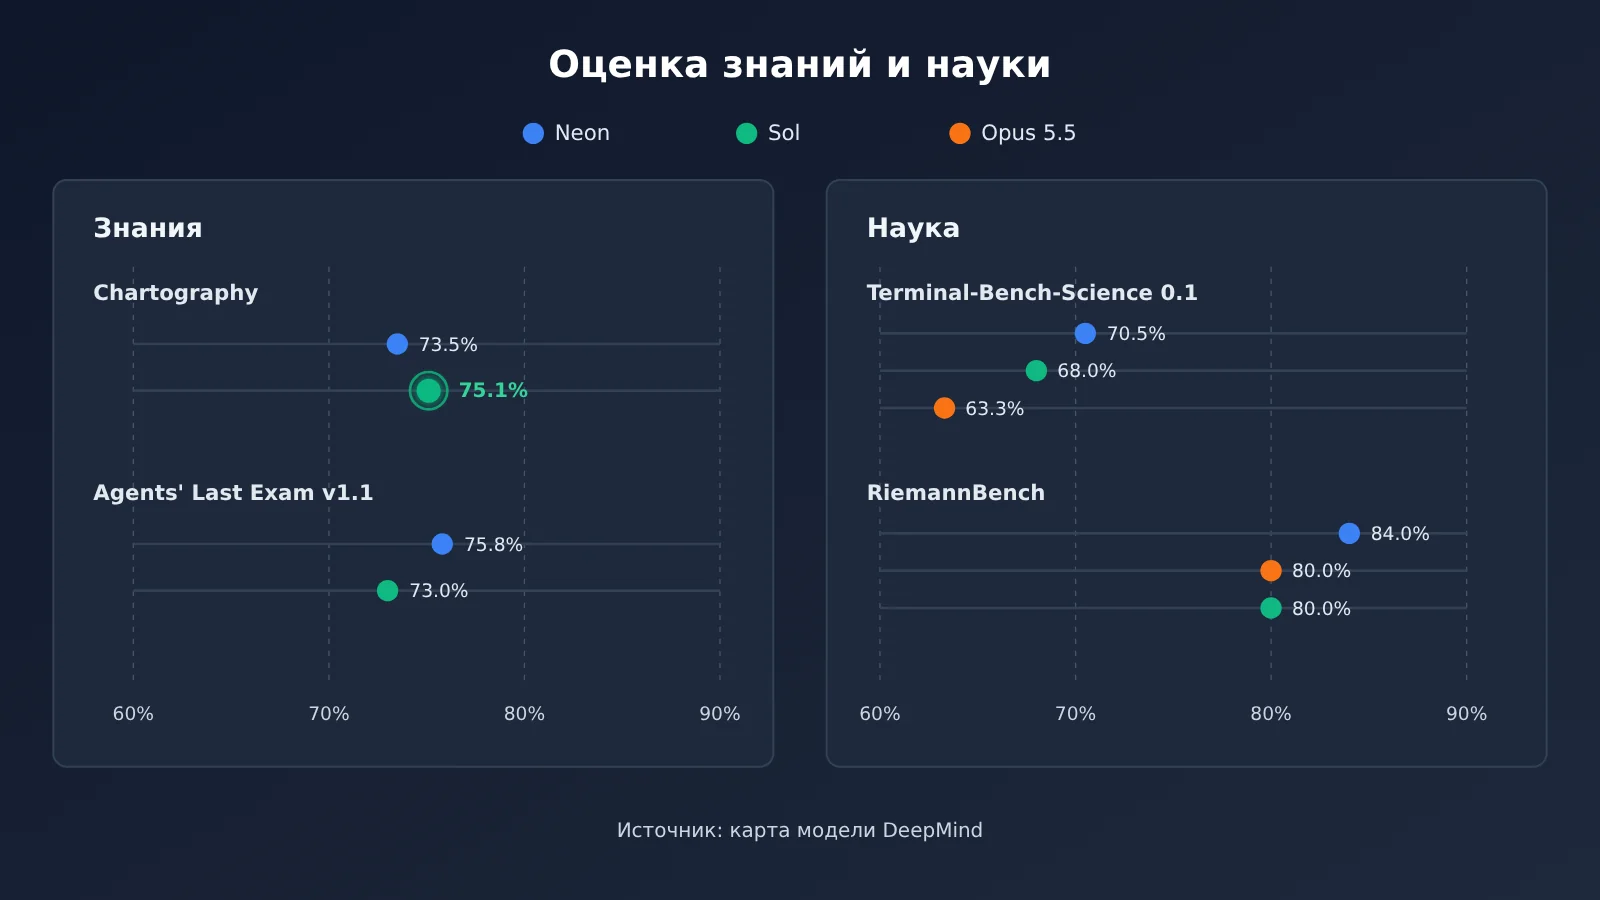
Пункты, по которым баллы есть, можно сверять с карточкой модели. Zapier AutomationBench в официальном блоге — 1-е место, 56.3%, Andon Labs Vending-Bench 2 — 1-е место, 16 843 доллара. Chartography — единственный в этом блоке подпункт, где выше Sol: Sol 75.1%, Neon 73.5%.
Независимые измерения дают больше деталей. В статье Artificial Analysis видно, что на GDP.pdf у Neon high — 33.4%, у Neon xhigh, наоборот, 28.0%, у Carbon high — 28.4%; это говорит о том, что повышение уровня рассуждений не обязательно даёт более высокий балл. На AA-Briefcase у Neon xhigh итоговый балл 1700 Elo, качество оформления 1771 Elo — выше, чем 1726 у Claude Sonnet 5.5 max. По пункту MKA статья Artificial Analysis указывает у Neon 56%, что близко к 57% у Fable max и на 2 пункта выше, чем у Carbon; карточка модели указывает 56.5% — оба числа сохраняем как есть.
Научные возможности Gemini 4 Neon: три показателя официально названы best in class
Наука — та часть из трёх, где официальные формулировки самые сильные. В блоге Google утверждается, что Terminal-Bench Science 70.5%, RiemannBench 84.0% и HLE-Diamond 71.3% — все три best in class; это данные самой компании. Сравнительная таблица в карточке модели с ними совпадает: по всем трём показателям Neon выше Opus 5.5 и Sol, но в колонках для сравнения тоже собраны самоотчёты производителей.
| Знания и научные показатели (карточка модели) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| GraphWalks (256k–1M, BFS F1) | 95.2% | 66.8% | 80.1% |
| MKA Climb WSR | 56.5% | 53.0% | 52.7% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
На GraphWalks в диапазоне длинного контекста от 256k до 1M Neon показывает 95.2% — заметный отрыв от 66.8% у Opus 5.5; на это стоит в первую очередь смотреть в сценариях чтения очень длинных материалов. На Terminal-Bench-Science Sol даёт 68.0%, разница с 70.5% у Neon — 2.5 процентного пункта; это наименьший разрыв среди трёх научных тестов.
Gemini 4 Neon по задачам: одна общая таблица
Сведём три блока вместе и разложим их по трём ситуациям — «официально первое место», «в карточке модели у конкурента выше» и «третья сторона опережает всего на 1 балл». Так получается таблица по задачам ниже. Она не отвечает, кто сильнее во всём, а лишь показывает, на какие доказательства опирается оценка для каждого типа задач.
| Тип задачи | Официально заявлено 1-е место | В карточке модели конкурент выше | Третья сторона впереди всего на 1 балл |
|---|---|---|---|
| Программирование | Coding Agent Index 58.6 — 1-е место в общем зачёте | Terminal-bench 4.1, FrontierCode 2.0: Opus 5.5 выше | Coding Agent Index 59 против 58 у Fable xhigh и Opus 5.5 max |
| Работа со знаниями | Legal Research Bench, Tax Agent Bench, AutomationBench, Vending-Bench 2 | Chartography: Sol выше | MKA 56% против 57% у Fable max (Neon ниже на 1 балл) |
| Наука | Terminal-Bench Science, RiemannBench, HLE-Diamond | Нет | Нет отдельной оценки науки от третьей стороны |
| Общая точка входа | Vals Index — 2-е место (70.9%) | Нет | AA Intelligence Score — 61, на 1 балл выше, чем у Carbon high |
Разбор плюсов и минусов Gemini 4 Neon
Сильные стороны
- Лидирует по всем трём научным бенчмаркам: и официально заявленные результаты, и карточка модели показывают, что Terminal-Bench Science, RiemannBench и HLE-Diamond выше, чем у двух моделей для сравнения.
- Хорошо работает с длинным контекстом: в карточке модели GraphWalks показывает BFS F1 95.2% в диапазоне 256k–1M, что соответствует единому окну на 1 млн токенов.
- Заметно выигрывает от инструментов: SWE-sweep под тестовым стендом производителя даёт 39.0%, то есть в агентной среде вроде Antigravity модель получает существенную прибавку.
- Полный набор мультимодальных входов: в карточке модели указаны входы текст, изображение, аудио и видео; на странице модели в Artificial Analysis у Opus 5.5 входы только текст и изображение.
Ограничения
- В программировании не первый по всем пунктам: на Terminal-bench 4.1 и FrontierCode 2.0 Opus 5.5 немного выше; для чисто терминальных задач и задач по передовому коду стоит тестировать обе модели.
- В понимании графиков есть соперник сильнее: на Chartography Sol выше; в задачах по отчётам с плотной графикой стоит включить Sol в сравнение.
- Более высокий режим не гарантирует лучший результат: в статье Artificial Analysis для GDP.pdf xhigh ниже high, поэтому режим рассуждений нужно подбирать под задачу.
- Жёсткие ограничения по параметрам: в руководстве для разработчиков указано, что передача
thinking_budgetилиMINIMALвернётHTTP 400; явное кеширование контекста не поддерживается — работает только неявное кеширование общего префикса длиной от 4096 токенов.
О цене и скорости здесь скажем одной фразой: стоимость одной задачи в сравнении с Carbon оценивают по-разному — Google заявляет, что она ниже на 32%, а в статье Artificial Analysis речь примерно о 17% меньше; подробности оставим для отдельной статьи о ценообразовании, а время выполнения и скорость вывода для разных режимов рассуждений — для отдельной статьи о скорости.
Быстрый старт с Gemini 4 Neon: сначала задача, потом уровень рассуждений
Рекомендую действовать в три шага: сначала по сводной таблице выше выбрать тип задачи, затем уровень рассуждений, а в конце проверить по сводной таблице APIYI, хватает ли уже доступных моделей семейства Gemini 4.
- Выберите тип задачи: для научных рассуждений и чтения длинных материалов в первую очередь смотрите на сильные стороны Neon; для программирования в терминале и понимания графиков добавьте Opus 5.5 или Sol в список кандидатов.
- Выберите уровень рассуждений: в руководстве для разработчиков указано, что у Neon есть только четыре уровня —
low,medium,highиxhigh, по умолчаниюhigh. На странице модели Artificial Analysis четыре уровня интеллекта оцениваются в 44, 55, 60 и 61 балл соответственно; отhighдоxhighразница всего 1 балл, а на GDP.pdf уhighрезультат даже выше, поэтому для большинства задач можно начинать с уровня по умолчанию. - Проверьте доступные модели: для задач оркестрации можно последовать примеру из руководства для разработчиков — отдать основную роль сильной модели, а быстрые подзадачи —
gemini-4-hydrogen; для самых сложных долгосрочных задач смотрите наgemini-4-carbon.
Что касается адресов вызова: в OpenAI-совместимом интерфейсе укажите base_url как https://api.apiyi.com/v1, а для нативного интерфейса Gemini используйте https://api.apiyi.com и версию v1beta. Ключ читайте из переменной окружения, например APIYI_API_KEY, и не записывайте его в код в открытом виде. При вызове в model достаточно указать gemini-4-carbon или gemini-4-hydrogen; в сводной таблице APIYI у обеих моделей в качестве эндпоинтов указаны chat и gemini.
В таблице ниже — модели из сводной таблицы APIYI, обновлённой 2026-11-16 (docs.apiyi.com/models.md), и из интерфейса цен, запрошенного 2026-11-19 (api.apiyi.com/api/pricing, всего 285 моделей), которые можно использовать для сравнения; цены указаны в долларах за миллион токенов.
| ID модели | Ввод | Чтение кэша | Вывод | Где доступна |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | Сводная таблица APIYI, интерфейс цен |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | Сводная таблица APIYI, интерфейс цен |
claude-opus-5-5 |
4 | 0.2 | 20 | Сводная таблица APIYI, интерфейс цен |
gpt-6.2-sol |
2 (при вводе свыше 272000 токенов — 3) | 0.1 | 10 (в верхнем тарифе интерфейса цен — около 11.25) | Сводная таблица APIYI, интерфейс цен |
2/10 у gemini-4-carbon — это текущая цена APIYI на витрине, соответствующая вводной цене Google до 2026-11-30. На странице цен Google AI Studio для Gemini 4 Neon указана цена 3.00 за ввод и 15.00 за вывод в долларах за миллион токенов, бесплатного тарифа нет; в сводной таблице APIYI и в интерфейсе цен она ещё не появилась. Пока модель не размещена, но мы скоро её добавим; актуальные модели и цены смотрите в списке моделей платформы.
🚀 Совет по началу работы: пока Neon не размещён, можно через APIYI apiyi.com с одним и тем же ключом по очереди вызвать
gemini-4-carbon,claude-opus-5-5иgpt-6.2-sol, прогнать на них свои задачи по программированию или отчётности и понять, какие задачи требуют возможностей уровня Neon.
Часто задаваемые вопросы (FAQ)
Q1: Какую нишу занимает модель Gemini 4 Neon?
Google выпустила промежуточную модель семейства Gemini 4 18 ноября 2026 года — она построена на базе Carbon. В руководстве для разработчиков её ставят между Hydrogen и Carbon, а в официальном блоге говорят, что она рассчитана на высокочастотные сложные процессы. ID модели — `gemini-4-neon`.
Q2: Общий балл Gemini 4 Neon — 61. Какое это место?
В статье Artificial Analysis указано 61 балл в категории xhigh и третье место в общем зачёте — впереди только GPT-6.2 Astra (max) и Claude Fable 5.2 (max). В блоге Google и карточке модели тоже стоит 61, так что цифры совпадают. Но общий балл годится лишь как точка входа — по подкатегориям надо смотреть на конкретную задачу.
Q3: Так Coding Agent Index — это 58.6 или 59?
Верно и то, и другое, просто источники разные. 58.6 — цифра из блога Google (официальная, заявленная самими разработчиками), 59 — результат из статьи Artificial Analysis, где Neon в режиме xhigh тестировали на Antigravity CLI. Складывать или усреднять эти значения нельзя.
Q4: Разница между 12.8% и 39.0% в SWE-sweep такая большая — о чём это говорит?
Это результаты двух разных harness: 12.8% получены на mini-SWE harness, 39.0% — на Google Antigravity. В официальном блоге эту разницу объясняют тем, что harness раскрывает потенциал модели. При выборе стоит смотреть на то агентное окружение, которое вы реально используете.
Q5: В каких задачах конкуренты обходят Gemini 4 Neon?
В карточке модели на Terminal-bench 4.1 и FrontierCode 2.0 чуть выше Claude Opus 5.5, а на Chartography — чуть выше GPT-6.2 Sol. В статье Artificial Analysis по MKA у Fable max 57% против 56% у Neon.
Q6: Можно ли сейчас вызывать Gemini 4 Neon через API?
Со стороны Google модель уже доступна — например, в Gemini API в AI Studio. В сводной таблице и интерфейсе цен APIYI apiyi.com пока нет `gemini-4-neon` — модель ещё не добавлена, но мы стараемся сделать это как можно скорее; актуальные модели и цены смотрите в списке моделей на платформе.
Q7: Чем можно заменить модель для тестов, пока она не появилась?
В APIYI apiyi.com можно вызывать `gemini-4-carbon` или `gemini-4-hydrogen` по адресу, совместимому с OpenAI: `https://api.apiyi.com/v1`. Тем же ключом можно переключаться на `claude-opus-5-5` и `gpt-6.2-sol` для横向-сравнения — у новых пользователей есть бесплатная тестовая квота.
Q8: Какие ограничения при вызове Gemini 4 Neon?
В руководстве для разработчиков указано: режим размышления бывает только четырёх уровней — от `low` до `xhigh`, а передача `thinking_budget` или `MINIMAL` возвращает `HTTP 400`; явное кэширование контекста не поддерживается; единый лимит — 1048576 токенов, включая вход и выход, а максимальный объём вывода за один фрагмент по умолчанию — 65536.
Ключевые моменты Gemini 4 Neon
- Общий балл — только отправная точка: балл интеллекта AA (Artificial Analysis) 61 и третье место совпадают во всех трёх источниках, но выбор модели всё равно нужно раскладывать по задачам.
- В программировании по двум пунктам модель обошли: в карточке модели Terminal-bench 4.1 и FrontierCode 2.0 у Opus 5.5 немного выше.
- В стороннем рейтинге программирования лидирует на 1 балл: Coding Agent Index 59 против 58 у Fable xhigh и Opus 5.5 max.
- В работе со знаниями лидирует по большинству пунктов: в Chartography выше Sol, а в GraphWalks преимущество на длинном контексте самое заметное.
- В науке три пункта официально названы best in class: в сравнении по карточке модели тоже лидирует, но данные конкурентов — самозаявленные каждой компанией.
- Уровни размышления начинаются с high: разница в балле интеллекта между high и xhigh всего 1, а на GDP.pdf high выше.
- Начинайте с тестирования уже доступных моделей: пока Neon не вышел, можно на APIYI apiyi.com прогонять задачи на Carbon и Hydrogen.
Итог
Насколько силён Gemini 4 Neon, будет гораздо понятнее, если разобрать его по трём блокам:
- Программирование: официально заявленный Coding Agent Index — первое место, но сторонний рейтинг даёт преимущество всего в 1 балл, а в карточке модели Opus 5.5 по двум пунктам чуть выше.
- Работа со знаниями: лидирует в большинстве — AutomationBench, длинный контекст GraphWalks и другие; в Chartography выше Sol.
- Наука: три пункта официально названы best in class, сравнение по карточке модели тоже показывает лидерство — это самый стройный по доказательствам блок из трёх.
Совет: сначала отнесите свою задачу к одной из этих категорий, а затем сверьтесь со сводной таблицей из этой статьи, чтобы решить, нужен ли вам Neon. До релиза можно через APIYI apiyi.com вызывать Gemini 4 Carbon, Hydrogen, а также Opus и Sol через единый интерфейс для сравнения, а когда gemini-4-neon выйдет, просто заменить ID модели и повторить замеры.
📚 Справочные материалы
-
Блог Google — Introducing Gemini 4 Neon: официальный анонс и собственные заявленные результаты
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Пояснение: официально заявленные рейтинги, результаты по программированию и науке
- Ссылка:
-
Карточка модели DeepMind — Gemini 4 Neon: таблица сравнения трёх моделей и спецификации
- Ссылка:
deepmind.google/models/model-cards/gemini-4-neon/ - Пояснение: результаты Neon, Opus 5.5 и Sol по отдельным пунктам; результаты моделей, отличных от Gemini, по умолчанию взяты из собственных отчётов каждой компании
- Ссылка:
-
Руководство разработчика Google Cloud — Gemini 4 Neon: параметры и ограничения при вызове
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Пояснение: уровни размышления, лимиты токенов, кэширование и коды ошибок
- Ссылка:
-
Статья Artificial Analysis — Gemini 4 Neon intelligence gain: сторонние измерения
- Ссылка:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Пояснение: Coding Agent Index 59, GDP.pdf, MKA и другие
- Ссылка:
-
Страница модели Artificial Analysis — Gemini 4 Neon: индексы по уровням размышления
- Ссылка:
artificialanalysis.ai/models/gemini-4-neon - Пояснение: сопоставление баллов интеллекта по четырём уровням
- Ссылка:
-
Сводная таблица моделей APIYI: доступные модели и цены
- Ссылка:
docs.apiyi.com/models.md - Пояснение: модели и цены соответствуют списку моделей на платформе
- Ссылка:
Автор: Техническая команда APIYI
Техническая связь: свяжитесь с нами на главной странице сайта APIYI; больше материалов — в документационном центре docs.apiyi.com