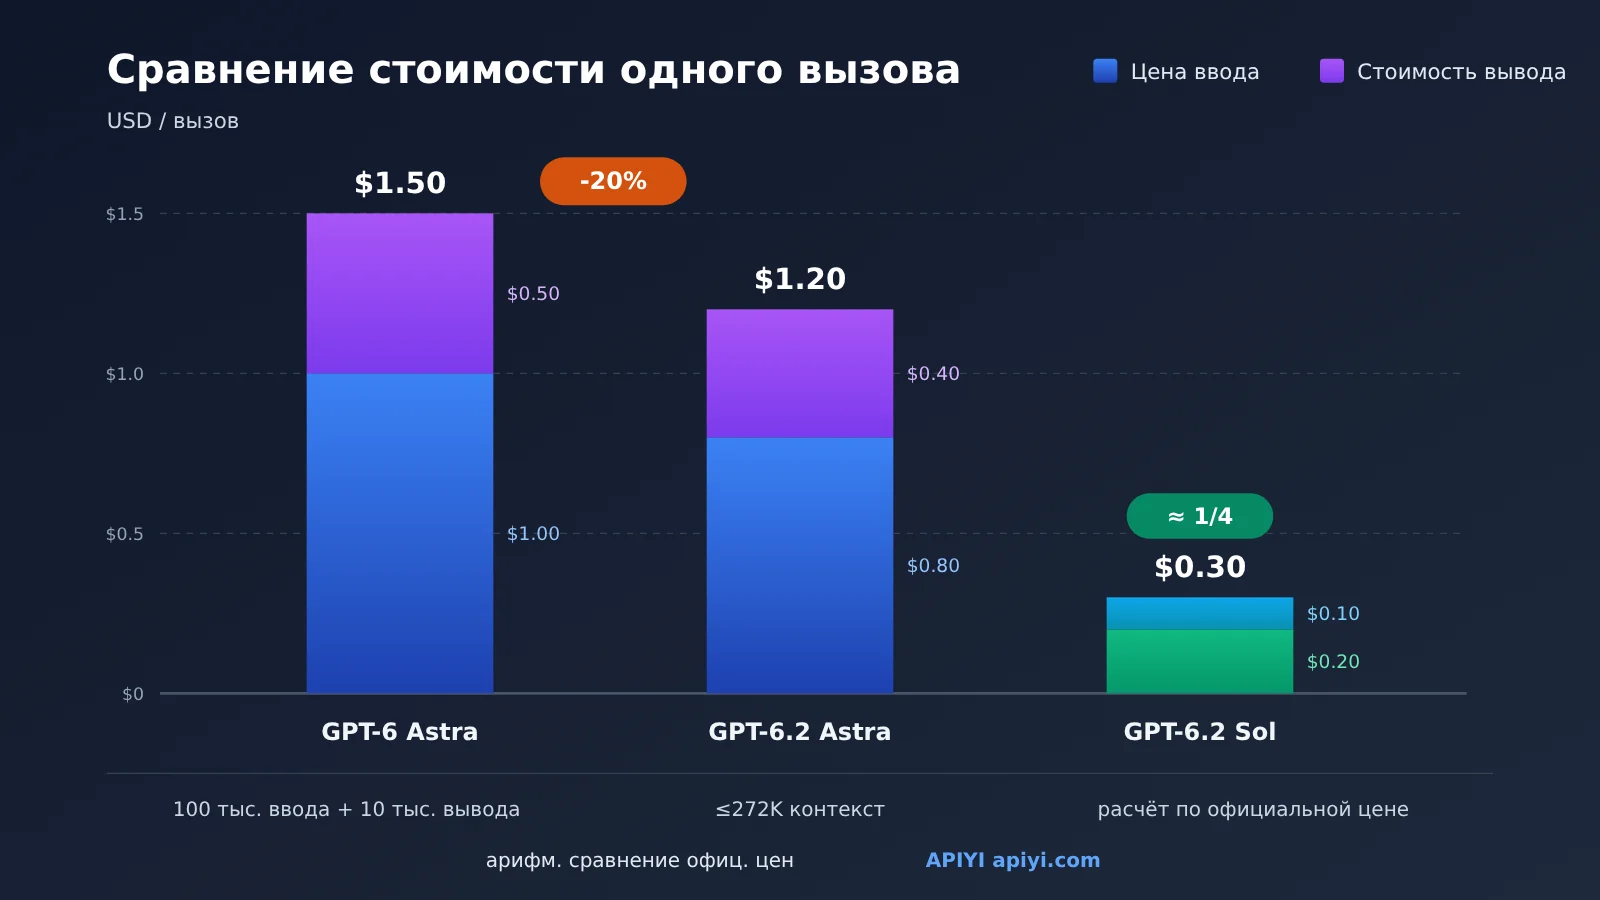
Возьмём для примера стандартный запрос «100 тыс. входных токенов без кэширования + 10 тыс. выходных, вход не превышает 272K»: по официальным базовым расценкам GPT-6 Astra обойдётся примерно в $1.50, GPT-6.2 Astra — примерно в $1.20, то есть на $0.30 меньше за запрос — ровно 20%. Тот же объём токенов на GPT-6.2 Sol стоит около $0.30. Важно: речь идёт именно о «снижении цены за токен на 20%». Кэширование, ступенчатые тарифы для длинного контекста, объём reasoning-вывода, вызовы инструментов — всё это влияет на итоговую сумму, и реальный счёт вовсе не обязательно уменьшится ровно на 20%.
Что вы узнаете из этой статьи?
- Сколько стоят по официальным базовым расценкам GPT-6.2 Astra и Sol, выпущенные OpenAI 17 ноября 2026 года.
- Как считается стоимость одного запроса к API: каждое умножение, перевод единиц и исходные допущения.
- Насколько чтение из кэша, длинный контекст свыше 272K и изменение числа выходных токенов отклоняют фактическую стоимость от «скидки 20%».
- Как разработчикам и тем, кто отвечает за бюджет, заново оценить свои затраты на вызовы.
Структура: сначала — концептуальная таблица и краткий обзор влияния, чтобы задать контекст. В первой части, «Объективные факты», собраны официальная информация о релизе, таблица цен и официальные бенчмарки, а также три примера расчёта по официальным расценкам. Во второй части, «Анализ и выводы», показано расхождение между падением цены за токен и падением суммы в счёте, даны рекомендации для разных ролей и приложен готовый к запуску код оценки стоимости.
Что нужно знать о снижении цен на GPT-6.2 Astra
| Понятие | Краткое объяснение |
|---|---|
| Токен | Базовая единица тарификации и обработки текста в модели; API тарифицируется «за миллион токенов» |
| Некэшированный ввод | В этой статье — обычная часть ввода, которая не тарифицируется ни как чтение из кэша, ни как запись в кэш |
| Чтение из кэша | Часть запроса, попавшая в кэш промптов; цена за единицу значительно ниже, чем для некэшированного ввода |
| Запись в кэш | Токены записи используют отдельный общий тариф; к одному и тому же токену обычная плата за ввод больше не добавляется |
| Ступенчатый тариф длинного контекста | Когда ввод превышает 272K токенов, тарифы на ввод и кэш для всего запроса удваиваются, а тариф на вывод вырастает в 1,5 раза |
| Уровень рассуждений | Интенсивность рассуждений, которую модель вкладывает перед ответом; чем выше уровень, тем обычно больше токенов расходуется |
| GDPval v2 / ALE / FrontierCode 2.0 | Три бенчмарка, на которые ссылается OpenAI в анонсе; объекты оценки и методики у них разные, результаты нельзя пересчитывать друг в друга |
Краткий обзор последствий снижения цен на GPT-6.2 Astra на 20%
| Кто | Основное влияние |
|---|---|
| Разработчики API | При запросах обычной длины цена за ввод и вывод Astra снижается на 20%, и стоимость того же объёма вызовов падает соответственно; запросы со сверхдлинным контекстом нужно считать отдельно |
| Ответственные за бюджет | Можно пересчитать бюджет на основе цены Astra со скидкой 20%, но реальное снижение зависит от доли попаданий в кэш, длины контекста и объёма вывода — сверяйте с данными счетов |
| Команды на этапе выбора модели | Стандартная цена Sol примерно в 1/4 от цены Astra — для задач, чувствительных к стоимости, появился ещё один вариант, который стоит оценить |
| Обычные пользователи ChatGPT | В этот раз изменения в основном поэтапно открываются для ChatGPT Work, Codex и API; обычный Chat в этот раунд не входит |
1. Объективные факты о снижении цены GPT-6.2 Astra на 20%
Приведённые ниже сведения взяты с официальной страницы релиза OpenAI, из документации моделей и со страницы с ценами; дата проверки — 18 ноября 2026 года. Все данные бенчмарков взяты из официальных отчётов и не являются результатами собственных тестов нашей команды.
1.1 Основная информация о релизе GPT-6.2 Astra и Sol
OpenAI выпустила GPT-6.2 Astra и GPT-6.2 Sol 17 ноября 2026 года. Обе модели принимают на вход текст и изображения, а на выходе дают текст; нативно генерировать видео они не умеют.
Что касается охвата: официально заявлено, что новые модели будут постепенно открываться пользователям ChatGPT Work, Codex и API, а обычный Chat в текущем раунде в список не входит. Точный график развёртывания — согласно справочной документации OpenAI.
1.2 Официальные стандартные цены API GPT-6.2 Astra
В таблице ниже — цены официального тарифа Standard от OpenAI при вводе не более 272K токенов. Единица — доллары США за миллион токенов; это не тарифы APIYI. Объём вывода рассчитывается по общему оплачиваемому объёму вывода в usage, включая токены рассуждений, и не равен длине видимого текста.
| Модель | Ввод без кэша | Чтение из кэша | Вывод | Источник данных |
|---|---|---|---|---|
| GPT-6 Astra (предыдущее поколение) | $10 | $1.00 | $50 | Страница модели OpenAI |
| GPT-6.2 Astra | $8 | $0.4 | $40 | Страница модели OpenAI / страница тарифов |
| GPT-6.2 Sol | $2 | $0.1 | $10 | Страница модели OpenAI / страница тарифов |
В официальных правилах есть ещё два момента по тарификации, о которых стоит помнить:
- Запись в кэш тарифицируется по отдельному общему тарифу: для Astra со стандартным коротким контекстом стоимость записи составляет $10 за миллион токенов при сроке хранения 30 минут и $20 за миллион токенов при сроке хранения 12 часов. Это не дополнительная плата сверх обычного ввода за $8. Один и тот же входной токен должен относиться только к одному из вариантов — обычный ввод, чтение из кэша или запись в кэш с соответствующим сроком хранения; повторная тарификация не допускается.
- Если ввод превышает 272K токенов, тарифы на ввод и кэш для всего запроса умножаются на 2, а тариф на вывод — на 1,5.
По сравнению с предыдущим поколением ввод без кэша у Astra снизился с $10 до $8, а вывод — с $50 до $40; оба показателя упали на 20%. Вот что точно означает «снижение цены на 20%»: стандартная цена за единицу снизилась на 20%.
1.3 Официальные результаты оценки GPT-6.2 Astra (не наши собственные измерения)
OpenAI в анонсе привёл несколько результатов оценки. У разных бенчмарков разные методики, и смешивать их при интерпретации нельзя:
- GDPval v2: GPT-6.2 Astra опережает GPT-6 Astra на 6,2 процентного пункта, при этом выходных токенов на 22% меньше; GPT-6.2 Sol опережает GPT-6.1 Sol на 5,3 процентного пункта.
- ALE: GPT-6.2 Astra прибавляет 5,2 балла. Это отдельный бенчмарк, его нельзя складывать с процентными пунктами GDPval или сравнивать с ними.
- FrontierCode 2.0: на максимальном уровне рассуждений Sol получает на 0,5 балла меньше, чем Astra, а стоимость задачи составляет примерно 1/5 от стоимости у Astra. Это верно только для данного теста и данного уровня — делать из этого общий вывод о стоимости нельзя.
1.4 Пример самостоятельного расчёта стоимости одного запроса GPT-6.2 Astra
Три приведённых ниже примера — это наша арифметика по стандартным ценам с официального сайта, а не реальные замеры через API и не фактические счета какого-либо аккаунта. Формула расчёта такая:
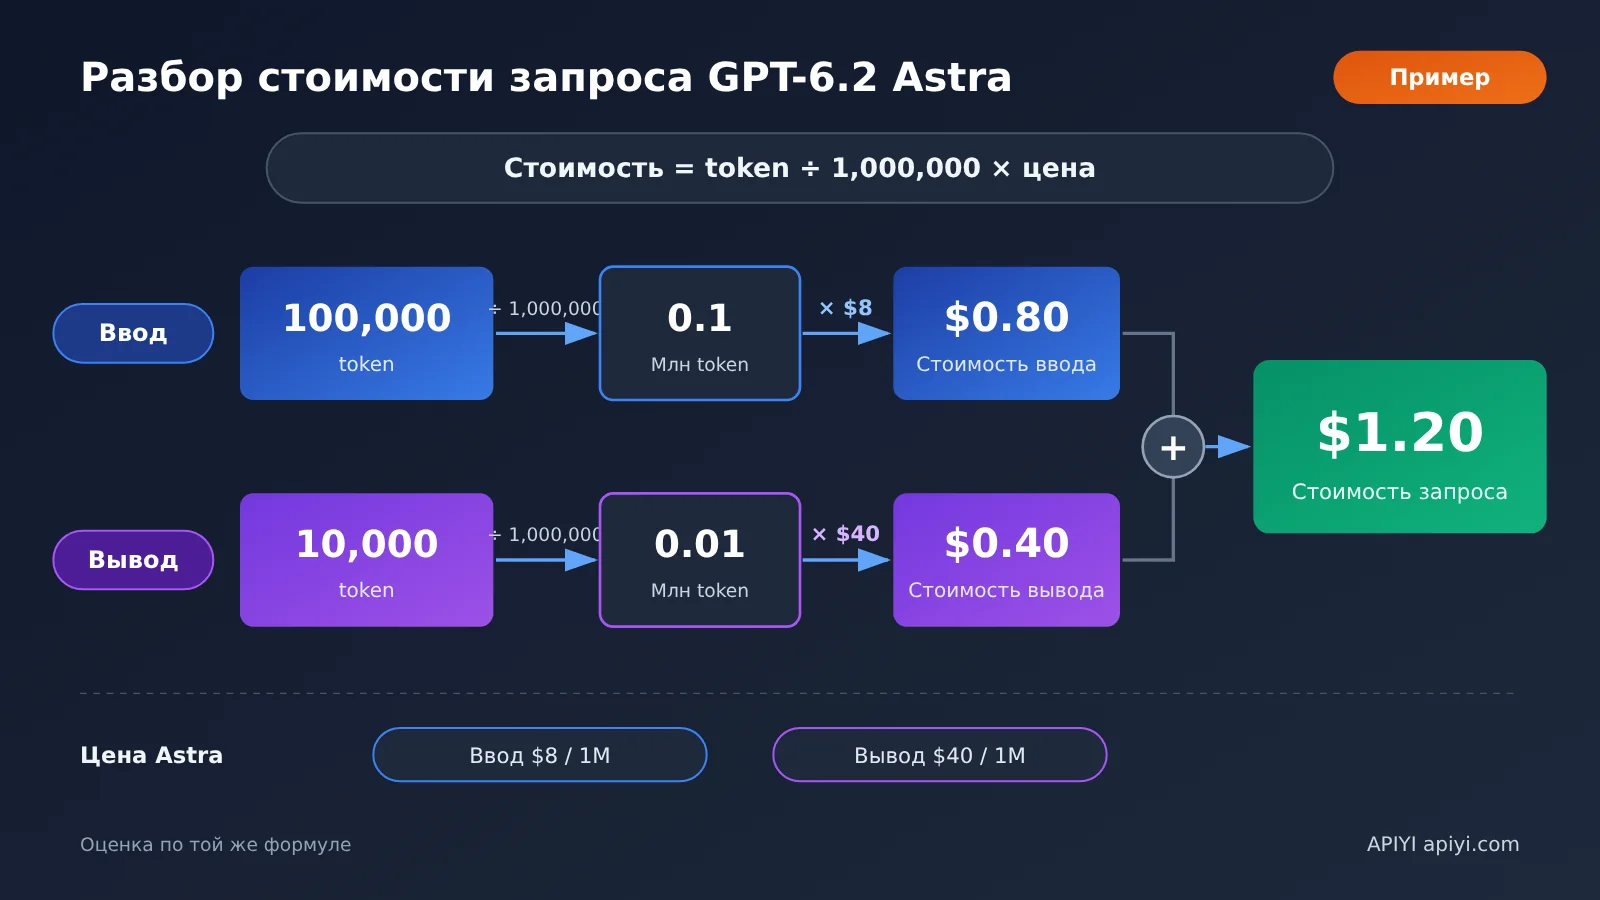
Стоимость = количество токенов ÷ 1,000,000 × цена за миллион токенов
Пример 1: стандартный запрос, сравнение старой и новой Astra с Sol
Допущения: некэшированный ввод 100,000 токенов, вывод 10,000 токенов, ввод не превышает 272K, чтения и записи кэша нет, вызовов инструментов нет, расчёт по стандартной цене.
| Позиция | GPT-6 Astra | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|
| Стоимость входа | 0.1 × $10 = $1.00 | 0.1 × $8 = $0.80 | 0.1 × $2 = $0.20 |
| Стоимость выхода | 0.01 × $50 = $0.50 | 0.01 × $40 = $0.40 | 0.01 × $10 = $0.10 |
| Итого за запрос | $1.50 | $1.20 | $0.30 |
| Относительно GPT-6 Astra | базовый уровень | меньше на $0.30 (-20%) | меньше на $1.20 (-80%) |
«0.1» в таблице означает 100,000 ÷ 1,000,000, а «0.01» — 10,000 ÷ 1,000,000. Если отправлять 10,000 таких одинаковых запросов в месяц, то по этим допущениям GPT-6 Astra выйдет примерно в $15,000, а GPT-6.2 Astra — примерно в $12,000. Это лишь линейная экстраполяция и никакое не обещание по расходам.
Пример 2: запрос GPT-6.2 Astra с попаданием в кэш
Допущения: общий ввод 100,000 токенов, из них 80,000 токенов попадают в кэш на чтение, 20,000 токенов — обычный ввод без записи в кэш, вывод 10,000 токенов; объём записи в кэш в этом запросе принят равным нулю, стоимость создания предыдущего кэша в этот пример не включается.
- Некэшированный ввод: 0.02 × $8 = $0.16
- Чтение из кэша: 0.08 × $0.4 = $0.032
- Вывод: 0.01 × $40 = $0.40
- Итого: около $0.592
У предыдущего поколения GPT-6 Astra цена чтения из кэша составляла $1.00 за миллион токенов, у новой версии — $0.40, снижение на 60%. При том же наборе токенов у предыдущего поколения выходит $0.20 + $0.08 + $0.50 = $0.78; у новой версии — $0.592, то есть на $0.188 меньше, примерно на 24.1%. В обоих случаях не учтены запись в кэш, инструменты и прочие расходы, поэтому это нельзя считать полным счётом.
Пример 3: длинноконтекстный запрос GPT-6.2 Astra, превышающий 272K
Допущения: обычный ввод 300,000 токенов (больше 272K), вывод 10,000 токенов, объём чтения из кэша и записи в кэш равен нулю.
- Вход: 0.3 × ($8 × 2) = $4.80
- Выход: 0.01 × ($40 × 1.5) = $0.60
- Итого: $5.40
Обратите внимание: тарифная ступень рассчитывается по всему запросу целиком. Как только вход превышает 272K, весь вход этого запроса тарифицируется по двойному тарифу — наценка применяется не только к превышающей части.
Срок жизни кэша настраивается через prompt_cache_options.ttl в Responses API: по умолчанию "30m", можно выбрать "12h", а для отдельной явной контрольной точки значение переопределяется через prompt_cache_breakpoint.ttl. Это минимальный срок жизни кэша, а не срок удаления данных, поэтому его не стоит путать с параметром prompt_cache_retention у старых моделей.
Когда вход превышает 272K, для Astra в тарифе Standard обычный вход, чтение из кэша, запись на 30 минут, запись на 12 часов и выход стоят соответственно $16, $0.80, $20, $40 и $60 за миллион токенов; множитель применяется ко всему запросу, а не только к превышающей части.
1.5 Официальные источники по GPT-6.2 Astra
-
Анонс OpenAI: openai.com/index/introducing-gpt-6-2-astra-sol/
- Документация модели GPT-6 Astra: официальные цены старой модели
- Документация модели GPT-6.2 Astra: официальные цены новой модели и условия тарифов
- Документация модели GPT-6.2 Sol: developers.openai.com/api/docs/models/gpt-6.2-sol
- Страница цен OpenAI API: developers.openai.com/api/docs/pricing
- Справочные материалы ChatGPT Work и Codex: help.openai.com/en/articles/20001275-chatgpt-work-and-codex
2. Анализ и выводы о снижении цены GPT-6.2 Astra на 20%
Ниже — интерпретация редакции на основе перечисленных фактов. Это анализ и суждение, а не официальный вывод.
2.1 Цена за единицу снизилась на 20% — почему счёт не обязательно уменьшится на 20%
В примере 1 строгие 20% получаются потому, что он включает только две позиции — некэшированный ввод и стандартный вывод, — и обе подешевели ровно на 20%. В реальном бизнесе счёт обычно состоит из нескольких видов затрат, и изменение доли любой из них может увести общее снижение от 20%.
| Фактор затрат | Возможное влияние на фактический счёт | Основание для оценки |
|---|---|---|
| Чтение и запись кэша | Цена чтения из кэша снизилась на 60%, это не то же самое, что 20% для некэшированного ввода; считать нужно отдельно по количеству токенов в каждом случае и нельзя заранее предполагать общее снижение; запись в кэш тарифицируется по отдельной общей ставке и не складывается с обычной платой за ввод | Официальный прайс-лист |
| Ступенчатая тарификация длинного контекста | При превышении 272K ставка за весь запрос повышается, поэтому стоимость одного запроса в сценариях с длинными документами может быть заметно выше, чем в примере 1 | Официальные правила тарификации |
| Количество выходных токенов / токенов рассуждения | В GDPval v2 официально сообщается о на 22% меньшем количестве выходных токенов; если в ваших задачах будет похожее изменение, экономия может превысить 20%; если уровень рассуждений выше, может выйти и дороже | Официальная оценка (конкретная задача) |
| Вызовы инструментов и уровни скорости | В GPT-6.2 Astra режим Fast стоит вдвое дороже ставки Standard для того же контекста, а Batch — 50%; расходы на инструменты считаются отдельно по используемым инструментам | Официальная страница модели и страница цен |
| Канал вызова | При вызове через сторонние платформы, такие как APIYI apiyi.com, ориентируйтесь на фактическую тарификацию, опубликованную платформой; напрямую применять официальную цену нельзя | Разница каналов |
Один легко упускаемый момент — это «выходных токенов на 22% меньше». Эта цифра взята из одной оценки GDPval v2. Если напрямую перенести её на все бизнес-задачи и сделать вывод «на практике экономия больше 30%», вы превратите результат официального теста в конкретной задаче в универсальную закономерность. Надёжнее провести небольшой тест на собственных реальных запросах, записать количество токенов в поле usage и уже потом судить.
2.2 Как выбрать между GPT-6.2 Astra и Sol
Если смотреть на стандартные цены, каждая позиция тарифа Sol примерно в 4 раза дешевле, чем у Astra. В первом тестовом примере разовая стоимость Sol составила лишь четверть от стоимости Astra. Результаты FrontierCode 2.0 показывают, что в максимальном режиме рассуждений разрыв между Sol и Astra небольшой, но официально не уточняется, можно ли переносить этот вывод на другие задачи.
Поэтому наш вывод такой: в сценариях, чувствительных к стоимости и со средней сложностью задач, Sol стоит оценивать в первую очередь; в сценариях с высокими требованиями к качеству или сложными задачами порог входа у Astra после снижения цены тоже стал ниже. Что выбрать в итоге, лучше решать через A/B-сравнение на собственном наборе задач.
💡 Рекомендация по выбору: если нужно в одном и том же коде сравнивать расход токенов и качество вывода нескольких моделей, можно переключать модели через такие агрегированные интерфейсы, совместимые с OpenAI, как APIYI apiyi.com. Доступна ли серия GPT-6.2 на платформе и сколько она стоит — смотрите в списке моделей и на странице тарифов платформы.
2.3 Код оценки стоимости GPT-6.2 Astra
Скрипт ниже выполняет только локальную арифметику и не обращается к API. Входные данные разбиваются на четыре непересекающиеся категории: обычный ввод, чтение из кэша, запись на 30 минут и запись на 12 часов; общий объём ввода используется для определения тарифной ступени 272K. Тариф за запись — это полный тариф, к токенам записи больше не добавляется плата за обычный ввод.
# Тарифы OpenAI Standard, доллары за миллион токенов; без учёта инструментов, налогов и других тарифных уровней
PRICES = {
    "gpt-6-astra":   {"input": 10.0, "cached": 1.0, "output": 50.0},
    "gpt-6.2-astra": {"input": 8.0, "cached": 0.4, "output": 40.0},
    "gpt-6.2-sol":   {"input": 2.0, "cached": 0.1, "output": 10.0},
}

def estimate_cost(model, ordinary_input, output_tokens, cached_read=0,
                  write_30m=0, write_12h=0):
    counts = (ordinary_input, output_tokens, cached_read, write_30m, write_12h)
    if any(n < 0 for n in counts):
        raise ValueError("token 数不得为负")
    p = PRICES[model]
    total_input = ordinary_input + cached_read + write_30m + write_12h
    im, om = (2.0, 1.5) if total_input > 272_000 else (1.0, 1.0)
    input_cost = (ordinary_input * p["input"] + cached_read * p["cached"]
                  + write_30m * p["input"] * 1.25
                  + write_12h * p["input"] * 2.5) * im
    return round((input_cost + output_tokens * p["output"] * om) / 1e6, 6)

print(estimate_cost("gpt-6-astra", 100_000, 10_000))  # 1.5
print(estimate_cost("gpt-6.2-astra", 100_000, 10_000))  # 1.2
print(estimate_cost("gpt-6.2-sol", 100_000, 10_000))  # 0.3
print(estimate_cost("gpt-6.2-astra", 20_000, 10_000, cached_read=80_000))  # 0.592
# Те же 100 тыс. ввода целиком тарифицируются как запись на 30 минут: это не 1.2 плюс 1.0
print(estimate_cost("gpt-6.2-astra", 0, 10_000, write_30m=100_000))  # 1.4
Для usage в Responses сначала нужно определить объём чтения из кэша и объём записи, а затем вычесть их из общего ввода, чтобы получить обычный ввод. При сочетании сроков жизни 30 минут и 12 часов нужно распределять объём записи согласно фактической детализации тарификации; нельзя применять один тариф ко всем записям. Если в канале отсутствует детализация записи или методика расчёта отличается, сверяйтесь со счётом этого канала — не стоит по умолчанию считать объём записи нулевым. Если тарифицируемый вывод уже включает токены рассуждений, не добавляйте объём рассуждений повторно. В этой статье мы не выполняли реальных вызовов API; поддерживает ли сторонняя платформа эти конфигурации и как она взимает плату, уточняйте в её документации.
2.4 Что делать после снижения цен на GPT-6.2 Astra
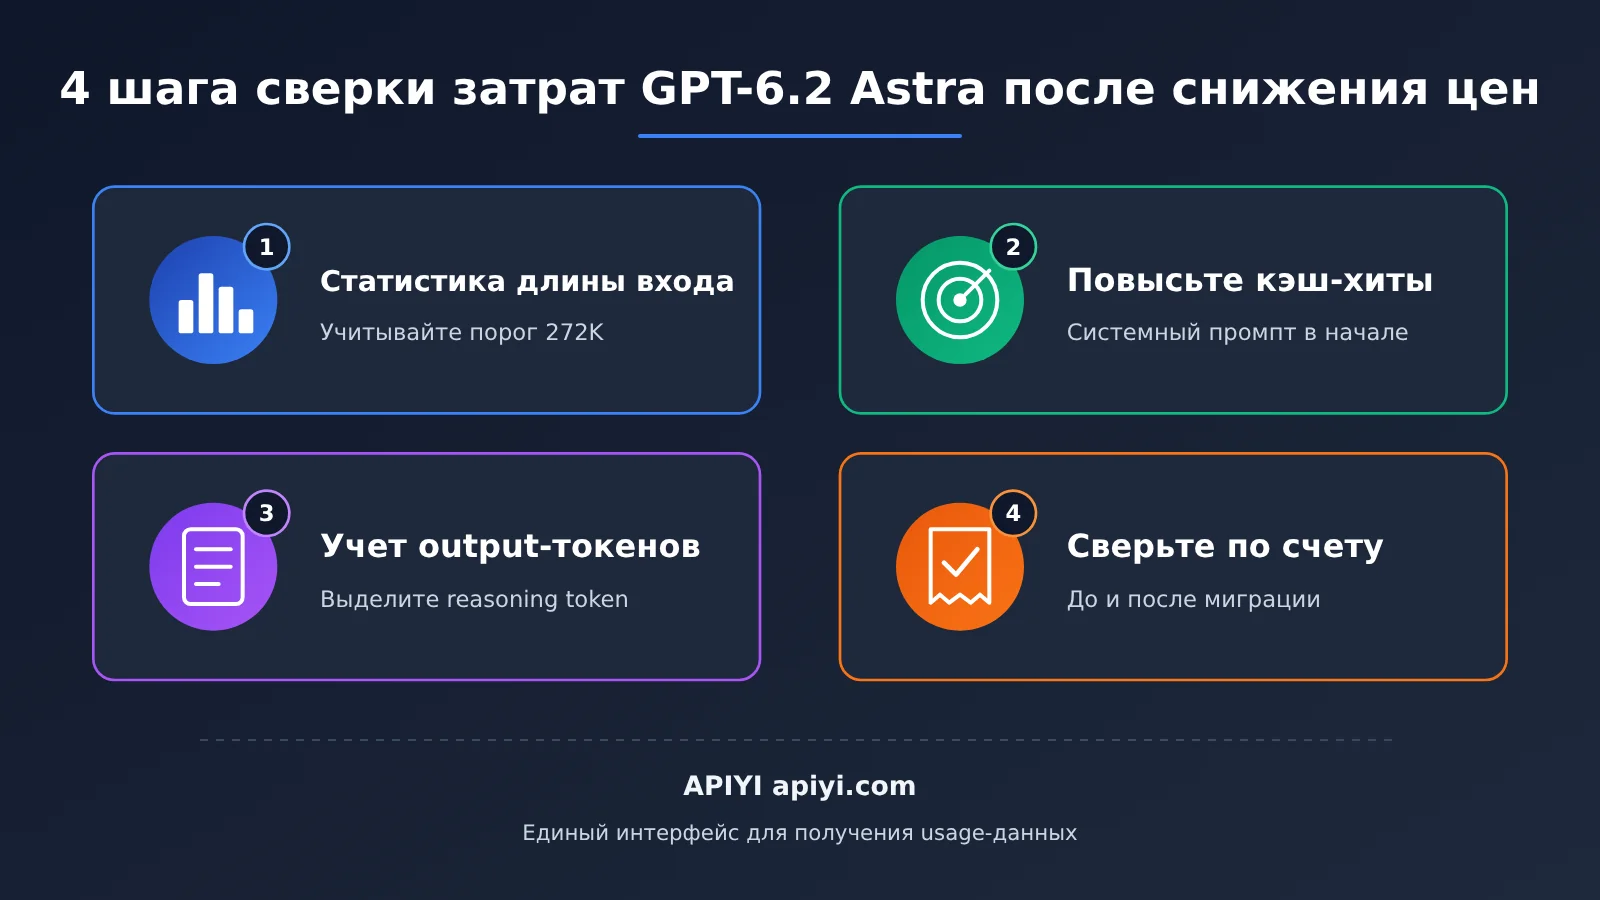
Разработчикам: сначала соберите статистику распределения длины входных данных в текущих запросах и посмотрите, сколько из них приближается к 272K или переваливает за этот порог. Если доля запросов с длинным контекстом велика, вход можно удерживать в пределах тарифной ступени — нарезкой при поиске (retrieval chunking), сжатием через суммаризацию и другими приёмами. Экономия на этом может оказаться больше, чем от самого снижения цены на 20%. Заодно ставьте фиксированный системный промпт в начало запроса — так выше шанс попасть в кеш.
Тем, кто отвечает за бюджет: «снижение стандартной цены Astra на 20%» стоит воспринимать как ориентир для бюджета при том же объёме некэшируемых входных и выходных данных, а не как потолок фактического снижения или гарантированную сумму экономии. Рекомендую сравнить реальные счета за периоды до и после миграции и отдельно перечислить изменения по кешу, длинному контексту и выходным токенам. Командам, которые ходят через платформы вроде APIYI apiyi.com, нужно ориентироваться на то, как считает платформа в своих счетах.
Что ещё нужно отслеживать: обновления официальных цен, ход открытия каналов доступа и то, смогут ли независимые сторонние тесты воспроизвести официальные цифры. Официальные тарифы на запись в кеш и на скоростные тарифные планы уже опубликованы — при оценке сверяйтесь с выбранным тарифом и не считайте их неопубликованными. У нового Astra в режиме Standard при коротком контексте запись в кеш с хранением 30 минут стоит $10 за миллион токенов, с хранением 12 часов — $20 за миллион токенов. Во всех трёх основных расчётах в этой статье предполагается нулевой объём записи в кеш — это не значит, что обычный запрос к API обязательно ничего не записывает.
Если хочется сначала отладить процесс сверки биллинга, можно на APIYI apiyi.com прогнать один и тот же код и сравнить данные usage у разных моделей. Когда серия GPT-6.2 появится в вашем канале, останется только подставить реальные числа токенов в функцию оценки выше.
Снижение цены на 20% — сигнал ясный, но цифра в счёте зависит от того, насколько длинный вход в каждом запросе, сколько попало в кеш и сколько ушло на выход. Разобраться в каждом отдельном умножении полезнее, чем запомнить один процент.
“Beware of little expenses; a small leak will sink a great ship.”
— Бенджамин Франклин, «Альманах бедного Ричарда»
(Следите за мелкими расходами: маленькая течь потопит большой корабль.)