Примечание автора: в статье отдельно разбираются сторонний интегральный балл GPT-6.2 Sol и Claude Fable 5.2, официальные цены, чтение из кэша и сравнения по отдельным пунктам — и объясняется, какие цифры можно сравнивать напрямую, а какие нельзя сворачивать к одному общему «кто сильнее».
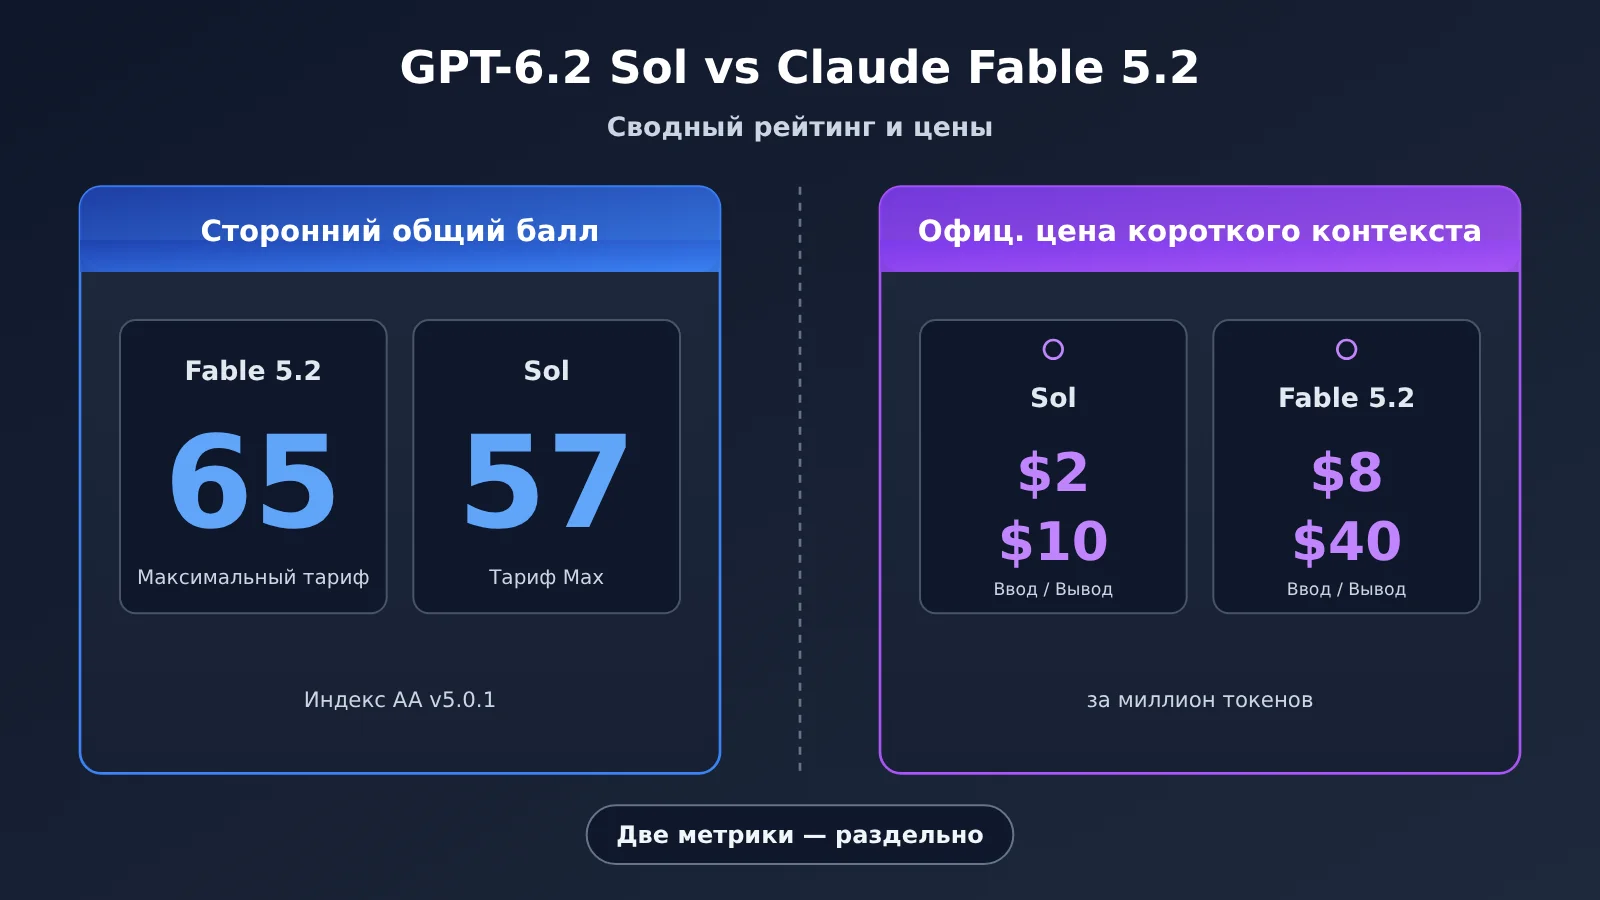
Когда вы ставите GPT-6.2 Sol и Claude Fable 5.2 рядом, самая частая ошибка — свести все цифры к одному вопросу «кто сильнее». 17 ноября 2026 года OpenAI выпустила GPT-6.2 Astra и GPT-6.2 Sol, и стороннее агентство Artificial Analysis в тот же день обновило интегральный рейтинг: Claude Fable 5.2 в наивысшем режиме рассуждений набрал 65 баллов, а GPT-6.2 Sol на уровне Max — 57 баллов. С другой стороны, по официальным ценам обеих компаний для короткого контекста входная и выходная цена Sol составляет всего четверть от цен Fable.
Разрыв в баллах большой, разрыв в ценах тоже большой — оба факта верны, но они не компенсируют друг друга, и их нельзя объединять в один вывод. Эта статья не будет выбирать сторону за вас. Самоотчёты разработчиков, сторонние рейтинги и прайсы вендоров — это три разные системы измерения: в статье мы разбираем их послойно и отдельно перечисляем, какие пункты вообще не имеют прямого официального сравнения Sol против Fable.
Главная ценность: дочитав статью, вы получите три группы проверяемых цифр — интегральный балл, цены и чтение из кэша, будете знать, какие пункты нельзя использовать для сравнения Sol с Fable, и сможете, отталкиваясь от своей задачи, решить, данные какой стороны проверять в первую очередь.
GPT-6.2 Sol и Claude Fable 5.2: ключевые моменты
Сначала — таблица с цифрами на уровне выводов; для каждой строки указано, откуда данные и как их читать. В следующих разделах разберём каждую строку отдельно.
| Показатель | Цифры | Откуда данные и как читать |
|---|---|---|
| Сводный балл | Fable 5.2 — 65, Sol (Max) — 57 | Сторонний Artificial Analysis Intelligence Index v5.0.1, у каждой модели — максимальный уровень рассуждений |
| Прайс на вход/выход при коротком контексте | Sol — $2 / $10, Fable — $8 / $40 (за 1 млн токенов) | Официальные цены обеих компаний; Sol в четыре раза дешевле Fable, но только по этим двум позициям |
| Прайс на чтение из кэша | Sol — $0.10, Fable — $0.20 | Официальные цены; Sol в два раза дешевле Fable, а не в четыре |
| Прямое сравнение из официальных материалов | Elo слепого сравнения людьми в AA-3D: Sol — 1259, Fable — 1271 | Данные в пересказе из официальных источников; остальные официальные единичные показатели — это в основном Astra против Fable или Sol против прежних моделей самой OpenAI |
| Доступность на APIYI | claude-fable-5-2 уже доступна; gpt-6.2-sol пока недоступна |
Ориентируйтесь на список моделей на платформе |
Про цену GPT-6.2 Sol из таблицы: выше — официальный прайс OpenAI. Модель пока не добавлена на платформу, но мы добавим её как можно скорее. Актуальные модели и цены всегда смотрите в списке моделей на платформе.
Зачем разбивать сравнение GPT-6.2 Sol и Claude Fable 5.2 на уровни
Сводный индекс спрессовывает десятки задач в один балл. Он хорошо отвечает на вопрос «на каком примерно уровне модель в целом», но не на вопрос «кто лучше справится именно с моей задачей». Прайс отвечает на вопрос «сколько стоит миллион токенов», но это не то же самое, что стоимость выполнения задачи: уровень рассуждений, объём токенов «размышлений» и доля попаданий в кэш у обеих моделей по-разному влияют на итоговый счёт.
Отдельные задачи — это уже третий уровень. Когда OpenAI в релизной статье упоминает единичные результаты Fable, сравнивает она их по большей части с GPT-6.2 Astra, а не с Sol. Приписывать достижения Astra модели Sol — самая частая ошибка в подобных сравнениях, поэтому в этой статье мы намеренно держим эти две модели отдельно.
GPT-6.2 Sol против Claude Fable 5.2: ключевые различия
Независимые совокупные оценки GPT-6.2 Sol и Claude Fable 5.2
Artificial Analysis — это независимое стороннее агентство, которое тестирует модели, так что цифры ниже — не самоотчёты OpenAI или Anthropic. В Intelligence Index v5.0.1 оно оценивает каждую модель отдельно по каждому уровню рассуждений, поэтому при сравнении важно уточнять, какой именно уровень имеется в виду.
| Модель | Уровень рассуждений | Intelligence Index v5.0.1 | Стоимость одной задачи по совокупному индексу (со страниц моделей) |
|---|---|---|---|
| Claude Fable 5.2 | Максимальный уровень рассуждений | 65 (1-е место в рейтинге) | $26.54 |
| GPT-6.2 Astra | Max / Xhigh | 62 | $4.00 (Max) |
| Gemini 4 Carbon | Максимальный уровень | 60 | — |
| Claude Opus 5.5 | Максимальный уровень | 59 | — |
| GPT-6.2 Sol | Max | 57 | $1.01 |
| GPT-6.2 Sol | Xhigh / High / Medium / Low | 56 / 55 / 53 / 41 | — |
По данным Artificial Analysis, Sol набрал на 2 балла больше, чем GPT-6.1 Sol, — итого 57, столько же, сколько у GPT-6 Astra, а стоимость одной задачи у него — примерно 15% от стоимости GPT-6 Astra. «Стоимость одной задачи» в таблице — это расходы стороннего агентства на прогон данного индекса: она отражает совокупный эффект уровня рассуждений, длины размышлений и прейскурантных цен, а не официальную цену API.
Важный нюанс: официально OpenAI заявляет, что стоимость Astra на Agents’ Last Exam — около 5% от стоимости Fable, но это уже другой набор задач. Пересчитывать $26.54 в официальные «5%» (и наоборот) нельзя, а переносить эти цифры на Sol — тем более.
Официальные цены и кэширование GPT-6.2 Sol и Claude Fable 5.2
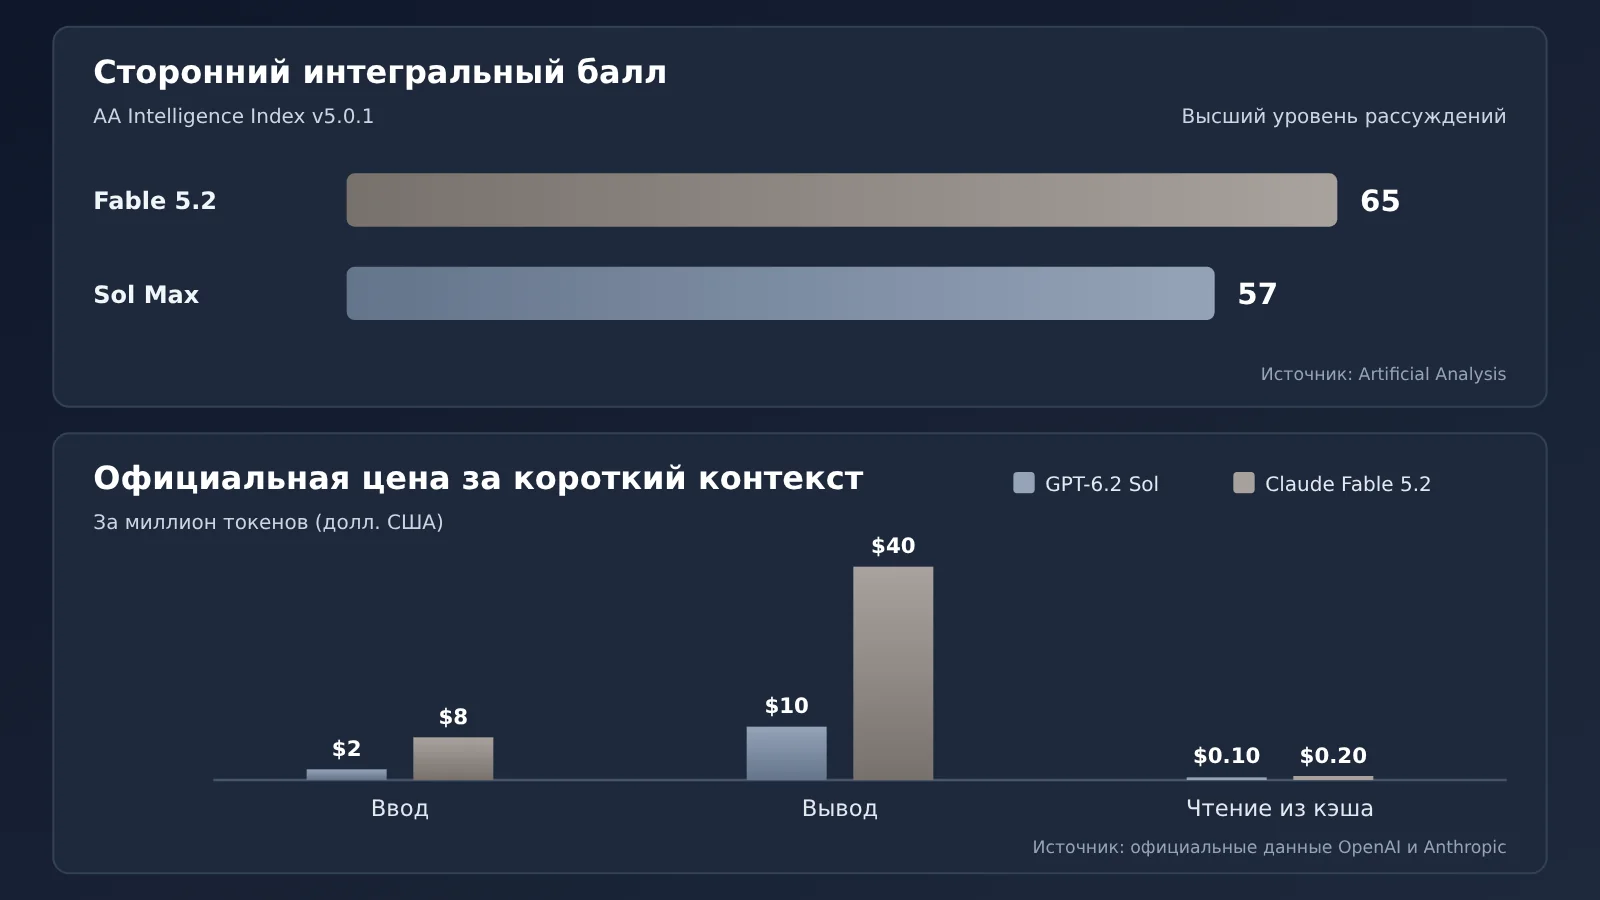
Начнём с GPT-6.2 Sol. На странице моделей OpenAI стандартные цены для короткого контекста такие: вход — $2, чтение кэша — $0.10, запись в кэш (срок хранения 30 минут) — $2.50, запись в кэш на 12 часов — $5, выход — $10. Модель пока недоступна на платформе — мы добавим её как можно скорее; актуальные модели и цены смотрите в списке моделей платформы. В анонсе релиза сказано, что Sol использует те же цены API за токены, что и GPT-6.1 Sol.
Согласно документации Anthropic, у Claude Fable 5.2 цены такие: вход — $8, выход — $40, запись в кэш на 5 минут — $10, запись в кэш на 1 час — $16, чтение кэша — $0.20. В общей таблице моделей APIYI (apiyi.com) для claude-fable-5-2 и claude-fable-5-2-thinking указаны вход, выход и чтение кэша — $8 / $40 / $0.2, что совпадает с официальными данными; страницы описания обеих моделей сейчас возвращают 404, так что ориентируйтесь на общую таблицу.
| Позиция тарифа (за 1 млн токенов) | GPT-6.2 Sol (официально OpenAI) | Claude Fable 5.2 (официально Anthropic) | Соотношение |
|---|---|---|---|
| Вход (короткий контекст) | $2 | $8 | в 4 раза дешевле |
| Выход (короткий контекст) | $10 | $40 | в 4 раза дешевле |
| Чтение кэша | $0.10 | $0.20 | в 2 раза дешевле |
| Запись в кэш | 30 минут — $2.50; 12 часов — $5 | 5 минут — $10; 1 час — $16 | сроки хранения разные — напрямую делить некорректно |
| Batch | 50% от стандартной цены | вход и выход за полцены | правила близки |
| Ускоренный режим | Fast — 2× стандартной цены; Ultrafast до 2027-02-28 — 3×, с 2027-03-01 — 6× | Fast mode: вход $16, выход $80, скорость до ~2.5× | механизмы разные |
Все позиции GPT-6.2 Sol в таблице — это официальные цены OpenAI. Модель пока недоступна на платформе — мы добавим её как можно скорее; актуальные модели и цены смотрите в списке моделей платформы.
«Sol — это четверть от Fable» — верно только для входа и выхода при коротком контексте. На странице моделей OpenAI есть ещё одно правило: если вход одного запроса превышает 272K токенов, цены на вход и кэш удваиваются, а выход считается по 1.5-кратной цене короткого контекста — причём повышенные расценки применяются ко всему запросу целиком. В такой ситуации цена выхода Sol уже не $10, и прикидка «в четыре раза дешевле» даст ошибку; тарификацию длинного контекста со стороны Fable сверяйте с документацией Anthropic.
Характеристики и интерфейсы GPT-6.2 Sol и Claude Fable 5.2
Контекстное окно у обеих моделей — порядка миллиона токенов, максимальный вывод одинаковый — 128K. Различия кроются во входных модальностях, настройках режима рассуждений и интерфейсах — а от этого напрямую зависит, как встраивать модель в проект.
| Параметр | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| Контекст / максимальный вывод | 1,050,000 (макс. ввод 922,000) / 128,000 | 1M / 128K |
| Ввод / вывод | текст, изображения / текст | согласно документации Anthropic |
| Дата среза знаний | 2026-06-01 | 2026-06 |
| Настройки рассуждений | API не позволяет выставить reasoning effort в значение none | effort по умолчанию — high, thinking включён, и отключить его нельзя |
| Официальные эндпоинты | Chat Completions, Responses, Batch | Anthropic API |
| APIYI | нет в каталоге | claude-fable-5-2, claude-fable-5-2-thinking, эндпоинты chat, messages |
Если вызываете уже доступную на APIYI модель Fable через OpenAI-совместимый интерфейс, base URL будет https://api.apiyi.com/v1, а в поле модели укажите claude-fable-5-2. Если же проект изначально работает по протоколу Anthropic Messages, можно воспользоваться messages-эндпоинтом платформы. Что касается групп, в общей таблице перечислены ClaudeCode, Claude_Reverse, Claude_Enterprise, Default и SVIP.
GPT-6.2 Sol против Claude Fable 5.2: сравниваем по отдельным заданиям
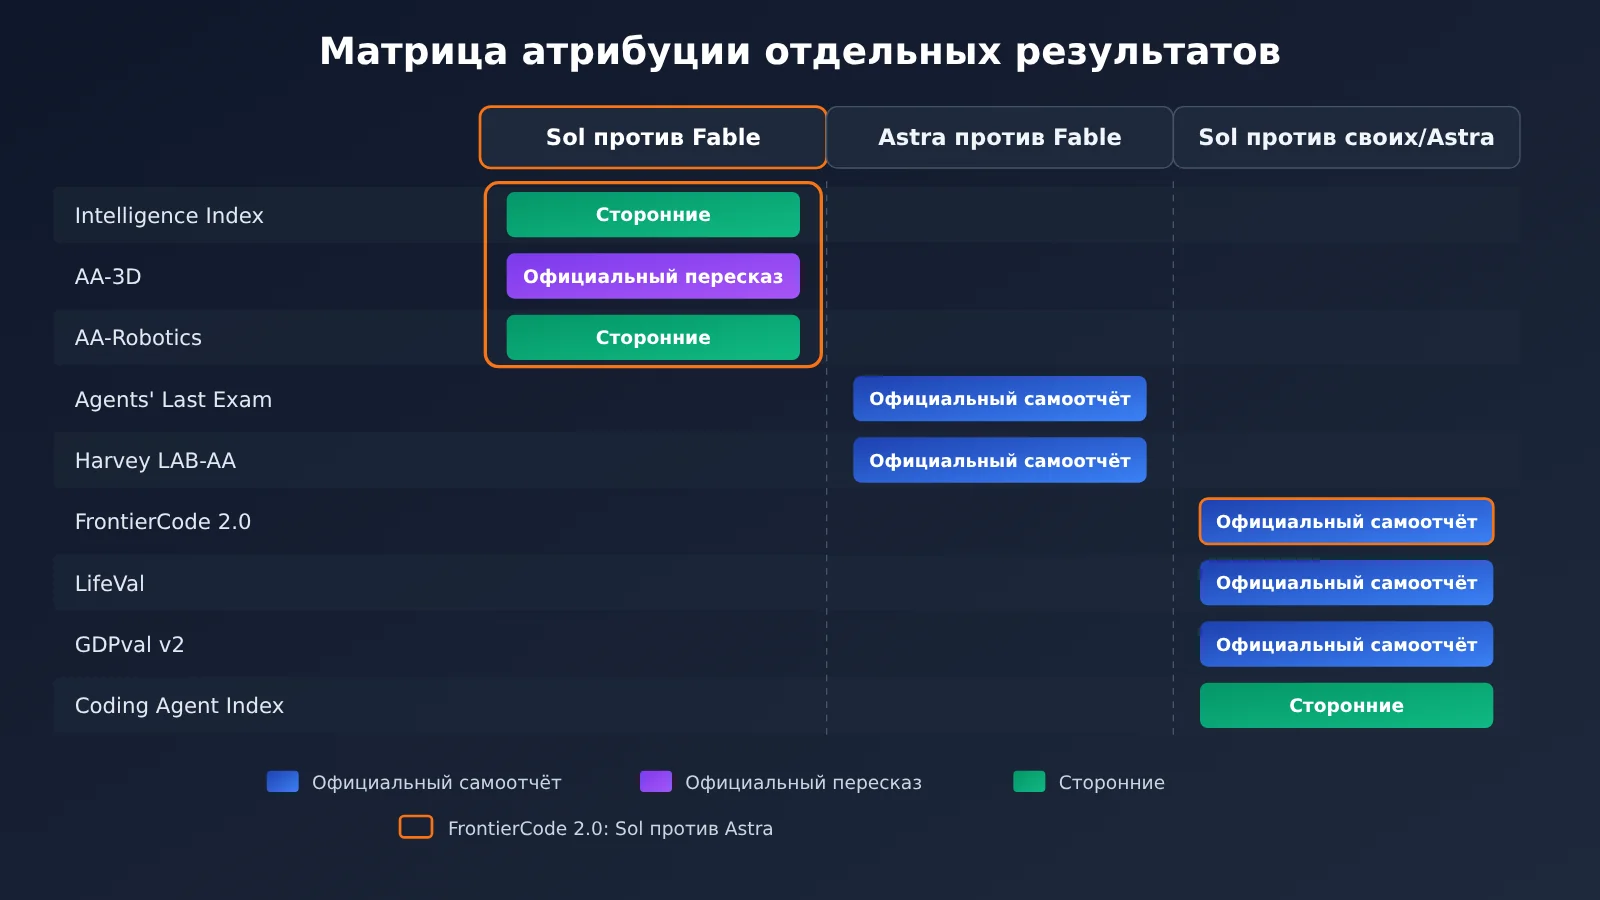
Это самый важный раздел статьи. В анонсе OpenAI немало отдельных результатов, но прямых сравнений «Sol против Fable» среди них совсем мало. В таблице ниже каждый пункт разобран отдельно — с указанием источника и того, кто с кем сравнивается.
| Показатель | Источник | Сравнение и результат | Прямое сравнение Sol против Fable? |
|---|---|---|---|
| Intelligence Index v5.0.1 | Сторонний AA, максимальный уровень рассуждений | Fable 65, Sol (Max) 57 | Да (сводная оценка стороннего AA) |
| AA-3D: Elo слепой оценки людьми | Официальный пересказ | Sol 1259, Fable 1271 | Да (единственный такой пункт в официальных материалах) |
| AA-Robotics v0.1 | Сторонний AA, research preview | Sol 78, Fable 75 | Да (стороннее превью, уровень рассуждений — по данным на странице AA) |
| Agents’ Last Exam | Самоотчёт разработчика | Astra выше Fable на 5,5 балла, стоимость — около 5% | Нет, это Astra против Fable |
| Harvey LAB-AA v1.1 | Самоотчёт разработчика | Показатель прохождения у Astra более чем вдвое выше, чем у Fable, стоимость — примерно 1/6 | Нет, это Astra против Fable |
| FrontierCode 2.0 | Самоотчёт разработчика | Разница между Sol и Astra меньше 0,5 балла, стоимость — примерно 1/5, обе модели в режиме Max | Нет, это Sol против Astra |
| LifeVal | Самоотчёт разработчика | Sol выше GPT-6 Astra, стоимость — примерно 1/7 | Нет |
| GDPval v2 | Самоотчёт разработчика | Sol выше GPT-6.1 Sol на 5,3 балла | Нет |
| Coding Agent Index | Сторонний AA, режим max | Sol ниже GPT-6.1 Sol на 3 балла | Нет |
Результаты GPT-6.2 Sol в FrontierCode 2.0 нельзя переносить на сравнение с Fable
FrontierCode 2.0 — бенчмарк от Cognition, который проверяет, примут ли мейнтейнеры изменения в реальных кодовых базах. По собственным данным разработчиков, разрыв между Sol и Astra — менее 0,5 балла, при этом Sol обходится примерно в пять раз дешевле Astra; оба тестируются на тарифе Max. Fable здесь вообще не участвует, поэтому писать «Sol в FrontierCode отличается от Fable менее чем на 0,5 балла» нельзя.
То же самое с Agents’ Last Exam и Harvey LAB-AA: там Fable опережает Astra. Как Sol соотносится с Fable по этим двум пунктам, в релизе не сказано — домысливать не стоит.
Научные и кодовые показатели GPT-6.2 Sol и Claude Fable 5.2
С Terminal-Bench-Science 0.1 тоже нужно быть аккуратным. Сами разработчики заявляют, что Astra опережает GPT-6 Astra на 9 процентных пунктов; в сносках у Fable 5.2 вообще фигурируют два числа: одно — из теста Artificial Analysis с агентом mini-swe-agent, другое — 74,6%, которые Anthropic показала в Claude Code на максимальной интенсивности рассуждений (Max). Эти два показателя Fable получены в разных тестах, сравнивать их как один замер нельзя — и к Sol они отношения не имеют.
Что касается независимых измерений: Artificial Analysis отмечает, что Sol в Coding Agent Index (Codex harness, max) на 3 балла ниже, чем GPT-6.1 Sol, — в основном из-за SWE-Atlas-QnA-AA, где отставание достигло 14 баллов. Этот ключевой факт легко упустить. Уровень галлюцинаций в AA-Omniscience (Max), измеренный Artificial Analysis, у Sol составляет 55%. Парных значений для Fable у этих цифр нет, так что годятся они лишь для понимания слабых мест самого Sol.
GPT-6.2 Sol и Claude Fable 5.2: рекомендации по сценариям
Этот раздел не станет решать за вас, какую модель выбрать, — он лишь подскажет, на какие данные в первую очередь смотреть для разных типов задач.
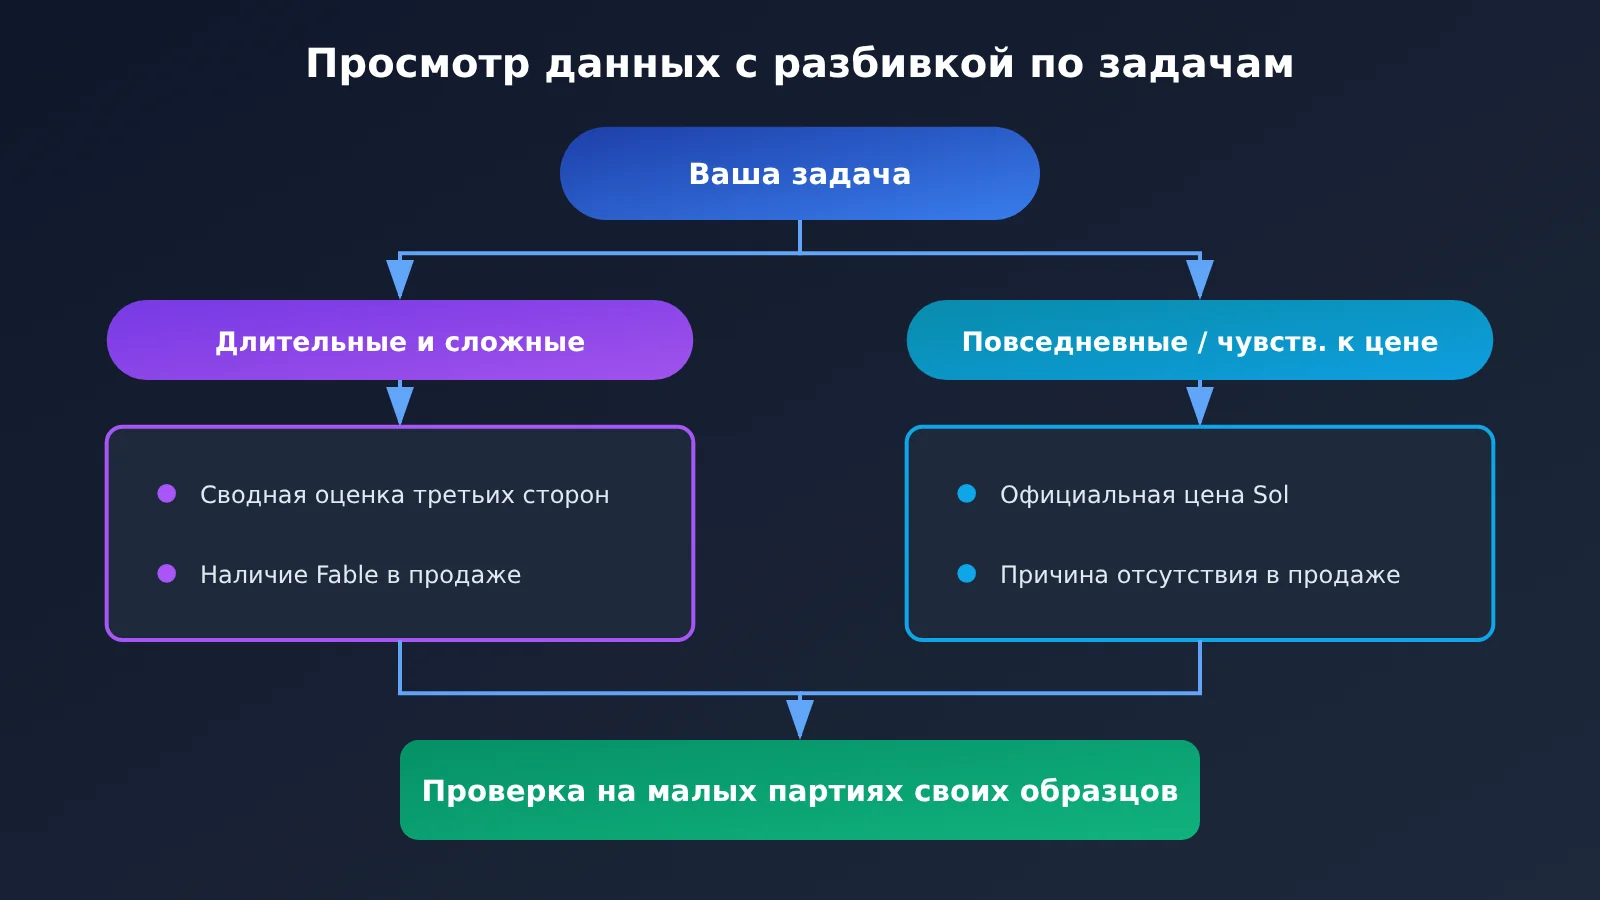
Задачи, для которых сначала смотрите данные Claude Fable 5.2
- Длинные, сложные, многошаговые комплексные задачи: начните со стороннего комплексного балла. В Intelligence Index v5.0.1 Fable на высшем уровне рассуждений набрал 65 и возглавил рейтинг — это единственные комплексные данные, которые сейчас можно напрямую сравнить с Sol.
- Проекты, которые нужно подключать уже сейчас:
claude-fable-5-2уже доступен на APIYI — можно сразу протестировать модель на собственных примерах. - Проекты, где важно учесть затраты на «размышления»: у Fable режим размышлений включён по умолчанию, и отключить его нельзя; effort по умолчанию равен high. При расчёте бюджета обязательно закладывайте токены размышлений.
Задачи, для которых сначала смотрите данные GPT-6.2 Sol
- Повседневные задачи и пакетная обработка, чувствительная к цене: сначала посмотрите официальные цены на короткий контекст и правила Batch, а затем — результаты на повседневных задачах, которые приводит сам разработчик: LifeVal, GDPval v2 и подобные.
- Запросы, в основном укладывающиеся в 272K: разница в ценах — вход и выход у Sol стоят четверть — проявляется главным образом именно в этом диапазоне.
- Команды, которые уже работают в ChatGPT Work или Codex: по официальной информации, тарифы Plus, Pro, Enterprise и Edu доступны уже с сегодняшнего дня, а Pro 200 впервые получает Ultrafast — предоставляется начиная с Sol.
Быстрый старт с GPT-6.2 Sol и Claude Fable 5.2
В этом разделе порядок действий расписан по типам задач. Кода в тексте нет — названия моделей и адреса указаны прямо в предложениях.
Длинные сложные задачи: сначала смотрите общий балл Fable и наличие модели на платформе. Создайте API-ключ в консоли APIYI, поменяйте base URL в OpenAI-совместимом SDK на https://api.apiyi.com/v1, а в поле model укажите claude-fable-5-2; если хотите, чтобы в названии модели явно фигурировал режим размышления, можно взять claude-fable-5-2-thinking. В сводной таблице заявлены цены: вход $8, выход $40, чтение кэша $0.2 — совпадает с официальными ценами Anthropic. Советуем сначала прогнать 20–50 своих реальных задач, зафиксировав долю успешных завершений и расход токенов, и только потом судить, проявится ли балл 65 в вашем сценарии.
Повседневные задачи, где важна цена: дальше смотрите официальные цены Sol и пометку о том, что модель ещё не добавлена. Официальные цены OpenAI на GPT-6.2 Sol: вход $2, чтение кэша $0.10, выход $10. Модель пока не доступна на платформе — мы добавим её как можно скорее; актуальные названия моделей и цены смотрите в списке моделей платформы. До этого момента регулярно проверяйте список моделей на apiyi.com и не подменяйте тесты моделями gpt-6.1-sol или gpt-6-sol с платформы — это не 6.2, к тому же у gpt-6-sol другая цена чтения кэша.
Когда Sol появится на платформе, учтите три момента: reasoning effort нельзя ставить в значение none; при вводе свыше 272K наценка применяется ко всему запросу целиком; официальный эндпоинт поддерживает Chat Completions и Responses — доступные эндпоинты платформы смотрите в списке моделей.
🚀 Быстрый старт: один и тот же API-ключ подходит для вызова разных моделей на платформе. Рекомендуем сначала отладить Fable на APIYI (apiyi.com) с бесплатным тестовым балансом, подготовить скрипты оценки и набор примеров — а когда Sol добавят, просто заменить название модели и сравнить результаты на тех же примерах.
Рекомендации по выбору между GPT-6.2 Sol и Claude Fable 5.2
Ниже — чек-лист, который поможет соотнести эти цифры с вашими собственными задачами.
- Сначала уточните, что за цифры перед вами: это сторонний комплексный балл, официально заявленный результат по отдельному пункту или официальная цена из прайса? Не суммируйте их и не пересчитывайте одно в другое.
- Сверьте режим рассуждений: 57 баллов у Sol — это режим Max, в режиме High — 55, а в Low — всего 41. Ориентируйтесь на баллы того режима, который реально используете.
- Считайте с учётом длины запроса: в пределах 272K ввод и вывод можно оценивать по четверти; после 272K придётся пересчитывать по правилам OpenAI для целых заказов.
- Считайте кэш отдельно: чтение из кэша — $0.10 против $0.20, разница в два раза; у записи в кэш разное время хранения, так что оценивайте каждый вариант под свою стратегию кэширования.
- Проверьте, есть ли прямое сравнение: если по интересующему вас пункту есть только данные «Astra против Fable» или «Sol против Astra», их нельзя принимать за вывод о паре «Sol против Fable».
- Учитывайте политику безопасности: по официальным данным, обе модели 6.2 достигли уровня «критический» по кибербезопасности в рамках фреймворка готовности (Preparedness Framework); защитные барьеры стали строже, и часть легитимных запросов на исследование уязвимостей будет отклоняться.
💡 Совет по выбору: какую модель взять, зависит от длины задачи, режима рассуждений и доли попаданий в кэш. Прогоните один и тот же набор образцов через обе модели на платформе APIYI — пусть говорят счета и процент успешных завершений, а не один-единственный рейтинг.
Часто задаваемые вопросы FAQ
Q1: Что такое GPT-6.2 Sol и Claude Fable 5.2?
GPT-6.2 Sol — модель, которую OpenAI выпустила 2026-11-17 вместе с GPT-6.2 Astra; идентификатор модели — `gpt-6.2-sol`. Она принимает на вход текст и изображения и выдаёт текст, контекстное окно — 1 050 000. Claude Fable 5.2 — модель от Anthropic, выпущенная 2026-11-09: контекст — 1M, максимальный вывод — 128K, режим размышлений включён по умолчанию, и отключить его нельзя.
Q2: В общем рейтинге 65 против 57 — значит ли это, что Claude Fable 5.2 полностью обходит GPT-6.2 Sol?
Нет. Результат 65 против 57 — это данные стороннего бенчмарка Artificial Analysis Intelligence Index v5.0.1, где Fable тестировался на максимальном уровне рассуждений, а Sol — на уровне Max. Это отражает общую картину по данному индексу, но вовсе не означает, что по каждой отдельной метрике разрыв именно такой. В официально упомянутых слепых человеческих оценках AA-3D по Elo у Sol 1259, у Fable 1271 — разрыв заметно меньше; а в стороннем исследовательском превью AA-Robotics v0.1 у Sol 78, у Fable 75.
Q3: Цена GPT-6.2 Sol действительно вчетверо ниже, чем у Claude Fable 5.2?
Это верно только для входа и вывода при коротком контексте. По официальным ценам Sol стоит $2 за вход и $10 за вывод, Fable — $8 за вход и $40 за вывод. Пока модель недоступна на платформе, но мы добавим её как можно скорее; актуальные модели и цены смотрите в списке моделей на платформе. Чтение из кэша — $0.10 против $0.20, то есть вдвое дешевле. А вот при вводе свыше 272K у Sol применяется надбавка ко всему запросу, и вывод становится в 1.5 раза дороже, чем при коротком контексте — в этом случае оценка «вчетверо дешевле» уже не работает.
Q4: Насколько GPT-6.2 Sol отличается от Claude Fable 5.2 в FrontierCode 2.0?
В официальных материалах такого сравнения нет. Утверждение «разница менее 0.5 балла» в FrontierCode 2.0 касается сравнения GPT-6.2 Sol и GPT-6.2 Astra — оба на уровне Max, при этом стоимость Sol примерно в пять раз ниже. Fable в этом сравнении не участвовал.
Q5: Как вызывать GPT-6.2 Sol и Claude Fable 5.2 через API?
Шаги следующие:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ и бесплатный тестовый лимит.
2. Укажите base URL платформы в OpenAI-совместимом SDK, а в поле model впишите `claude-fable-5-2` — и можно вызывать Fable.
3. `gpt-6.2-sol` пока не добавлен на платформу; после добавления ориентируйтесь на список моделей и цены на платформе, а затем протестируйте на том же наборе примеров.
Q6: Какие известные ограничения есть у GPT-6.2 Sol и Claude Fable 5.2?
По Sol: сторонний Artificial Analysis (AA) намерил уровень галлюцинаций на максимальном уровне Max — 55%, а Coding Agent Index на 3 балла ниже, чем у GPT-6.1 Sol — в основном потому, что модель чаще упускает ключевые факты; reasoning effort нельзя выставить в значение none; фильтры по кибербезопасности строже — часть легитимных исследований уязвимостей отклоняется. По Fable: размышления нельзя отключить, effort по умолчанию — high, а токены размышлений учитываются в стоимости; в Fast mode цены такие: $16 за вход, $80 за выход.
Q7: Официально заявляют, что Astra обходится всего в 5% от стоимости Fable — можно ли это сопоставить со сторонним показателем $26.54?
Нет. «Около 5%» — это официально заявленная стоимость в бенчмарке Agents’ Last Exam, где сравниваются Astra и Fable; а $26.54 — это стоимость одного задания для Fable при прогоне сводного индекса от Artificial Analysis. Задачи разные, источники разные — делить одно на другое нельзя, да и стоимость Sol из этого не вычислить. Если хотите просто прикинуть порядок величин, надёжнее будет вести учёт реальных счетов на собственных примерах через платформу APIYI.
GPT-6.2 Sol и Claude Fable 5.2: ключевые выводы (Key Takeaways)
- Общий балл: в индексе стороннего AA Fable на максимальном уровне размышлений набирает 65, Sol на уровне Max — 57; это прямое сравнение в одном и том же рейтинге.
- Прейскурант: при коротком контексте вход и выход у Sol стоят четверть от цен Fable ($2 против $8, $10 против $40).
- Чтение из кэша: $0.10 против $0.20 — разница вдвое, четверть здесь не подходит.
- Длинный контекст: у Sol при вводе свыше 272K наценка применяется ко всему запросу целиком, прежние пропорции больше не работают.
- Мало прямых сравнений: в официальных материалах Sol сопоставляется с Fable только по одному пункту — AA-3D, 1259 против 1271.
- Не переносите результаты: FrontierCode 2.0 — это Sol против Astra, а ALE и Harvey — Astra против Fable.
- Доступность: Fable можно вызывать напрямую через APIYI на apiyi.com, Sol пока не добавлен в каталог — ориентируйтесь на актуальный список моделей.
Итоги
Сравнивая GPT-6.2 Sol и Claude Fable 5.2, важно разделить цифры на три уровня:
- Сводный балл от третьих сторон: Fable — 65, Sol (Max) — 57; по нему оценивают общий уровень модели.
- Официальные цены: по вводу и выводу при коротком контексте разница составляет четверть, по чтению кэша — половину; длинный контекст тарифицируется отдельно по правилам каждой модели.
- Отдельные задачи: большинство официальных одиночных результатов — это не прямое сравнение Sol с Fable, поэтому перед цитированием уточняйте, кто именно с кем сравнивается.
Разницу в баллах и разницу в ценах нельзя свести к одной фразе «что выгоднее». Более надёжный подход — взять собственные примеры, зафиксировать уровень рассуждений (reasoning tier) и отдельно отслеживать долю успешно выполненных задач и счета. Fable уже сейчас можно протестировать на APIYI apiyi.com; GPT-6.2 Sol пока не добавлен — мы добавим эту модель как можно скорее. Актуальные модели и цены смотрите в списке моделей платформы.
📚 Справочные материалы
-
Пост OpenAI о релизе: заметки о выпуске GPT-6.2 Astra и Sol и официально заявленные результаты по отдельным задачам
- Ссылка:
openai.com/index/introducing-gpt-6-2-astra-sol - Примечание: официально заявленные результаты по отдельным задачам, область доступности и сводка цен
- Ссылка:
-
Страница модели OpenAI — GPT-6.2 Sol: характеристики, цены и правила тарификации 272K
- Ссылка:
platform.openai.com/docs/models/gpt-6.2-sol - Примечание: цену записи в кэш, надбавку за длинный контекст и коэффициенты ускоренного режима уточняйте здесь
- Ссылка:
-
Системная карта OpenAI: оценка безопасности GPT-6.2 Astra и Sol
- Ссылка:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Примечание: категории фреймворка готовности (Preparedness Framework) и оценки выравнивания
- Ссылка:
-
Статья и страница модели Artificial Analysis: сторонний Intelligence Index v5.0.1
- Ссылка:
artificialanalysis.ai/models/claude-fable-5-2 - Примечание: сводные баллы по уровням, стоимость отдельных задач и Coding Agent Index
- Ссылка:
-
Документация Anthropic — Claude Fable 5.2: официальные цены и характеристики
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview - Примечание: запись в кэш, чтение кэша, режим Fast mode и настройки effort
- Ссылка:
-
Сводная таблица моделей APIYI: модели и цены, доступные на платформе
- Ссылка:
docs.apiyi.com/models.md - Примечание: данные на 2026-11-17 15:54 (UTC+8); актуальные модели и цены смотрите в списке моделей платформы
- Ссылка:
Автор: техническая команда APIYI
Технические вопросы: будем рады вашему обращению на главной странице сайта APIYI; подробнее о моделях и интерфейсах — в документации docs.apiyi.com