Авторская заметка: в этой статье мы разложили по полочкам сторонние сводные баллы GPT-6.2 Sol и Claude Opus 5.5, официальные цены, стоимость чтения кэша и наличие моделей на APIYI — чтобы вы выбирали модель под конкретную задачу, а не по одному общему баллу.
OpenAI выпустила GPT-6.2 Astra и GPT-6.2 Sol 17 ноября 2026 года. У многих команд Claude Opus 5.5 уже давно в работе, и теперь им предстоит решить, стоит ли переключаться. В этой статье мы сравниваем GPT-6.2 Sol и Claude Opus 5.5 и даём рекомендации по нескольким осям: сводный балл, цены, чтение кэша, протоколы и текущая доступность вызова.
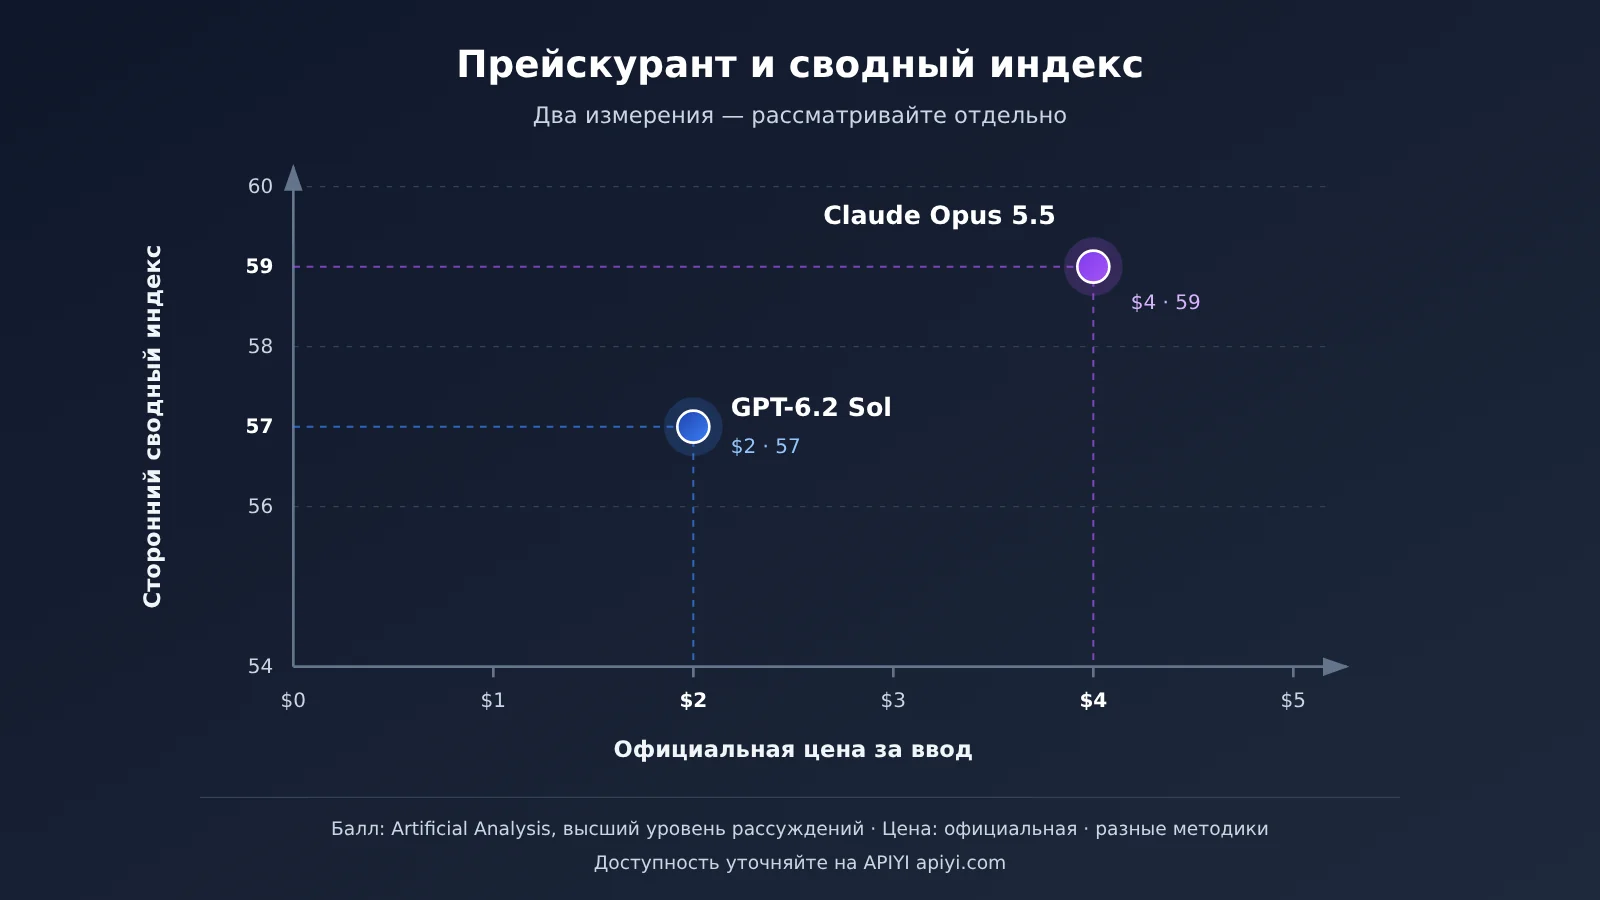
Это не статья про то, кто сильнее или кто дешевле. В стороннем сводном индексе высшая категория Sol на 2 балла ниже, чем высшая категория Opus. По официальным ценам для короткого контекста вход, выход и чтение кэша у Sol стоят примерно вдвое дешевле, чем у Opus. Эти два факта нужно оценивать вместе — по отдельности любой из них даёт неполную картину для принятия решения.
Главная ценность: прочитав статью, вы будете знать, какие у этих двух моделей сводные баллы, цены и стоимость чтения кэша; какие цифры заявлены официально, а какие измерены третьими сторонами; и какую модель сейчас можно вызвать на APIYI.
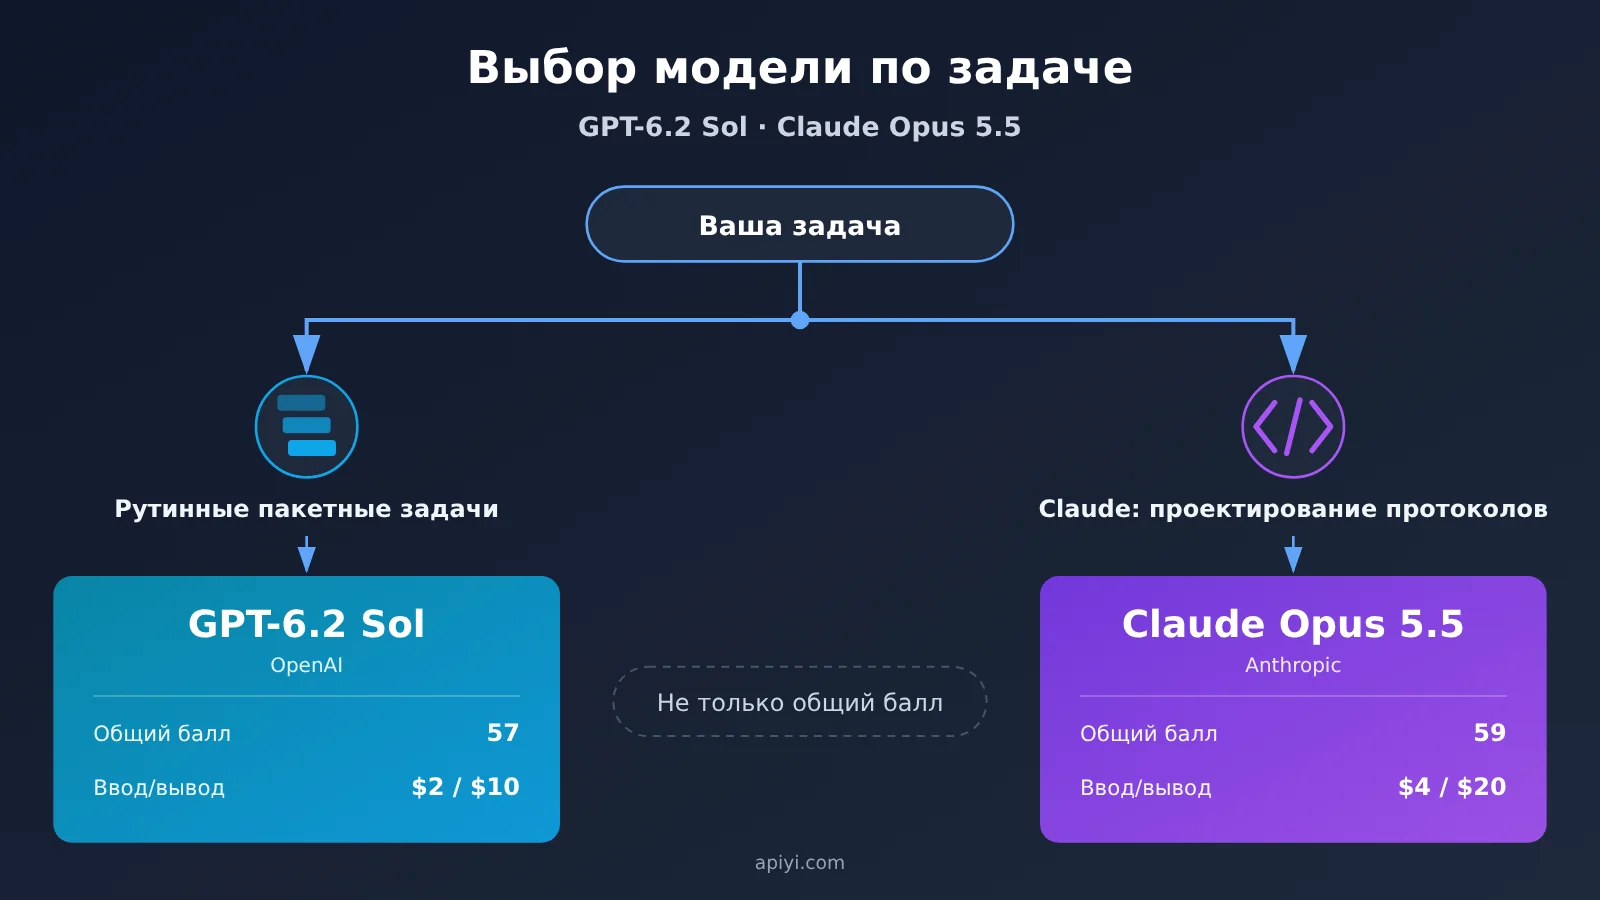
GPT-6.2 Sol и Claude Opus 5.5: быстрый обзор ключевых различий
Начнём с таблицы, в которой собраны пять самых востребованных при выборе модели групп данных. У каждой строки указан источник цифр, а в следующих разделах каждый пункт разбирается подробнее.
| Критерий сравнения | GPT-6.2 Sol | Claude Opus 5.5 | Источник цифр |
|---|---|---|---|
| Сторонний сводный индекс (максимальный уровень рассуждений) | 57 (уровень Max) | 59 (высший уровень) | Artificial Analysis, сторонний источник |
| Официальная цена входа / выхода при коротком контексте | $2 / $10 | $4 / $20 | Официальные прайсы каждой компании, за 1 млн токенов |
| Цена чтения из кеша | $0.10 | $0.20 | Страница моделей OpenAI; по Opus — пересказ прайс-листа Anthropic |
| Контекст / максимальный вывод | 1,050,000 / 128,000 | 1M / 128K | Официальные страницы моделей и документация |
| Текущий статус на APIYI | Пока недоступна | Доступна: claude-opus-5-5 |
Общая таблица моделей APIYI и API с ценами |
Отставание на 2 балла при цене примерно вдвое ниже: почему смотреть на оба показателя вместе
Если смотреть только на сводный балл, получится «Opus выше», а если только на прайс — «Sol дешевле». Оба вывода верны, но каждый показывает лишь половину картины. Сводный балл отражает средний результат на наборе смешанных задач, цена — стоимость одного миллиона токенов, а ваш реальный счёт зависит ещё и от того, сколько токенов потребляет каждая конкретная задача.
К тому же разница в 2 балла получена Artificial Analysis на тестах с максимальным уровнем рассуждений. Если в ваших задачах используется уровень рассуждений по умолчанию или тип задач сильно отличается от тех, на которых построен этот индекс, эти 2 балла вовсе не обязательно перенесутся напрямую. Поэтому логика этой статьи такая: сначала раскладываем цифры по полочкам, а уже потом выбираем по типу задач.
Сравнение GPT-6.2 Sol и Claude Opus 5.5: официальные цены и чтение из кэша
При выборе модели именно цены чаще всего понимают неверно. В таблице ниже официальные прейскурантные цены и цены платформы APIYI разнесены по отдельным колонкам; все цифры указаны за 1 миллион токенов, по умолчанию — стандартный тариф для короткого контекста.
| Позиция тарификации | Официальная цена GPT-6.2 Sol | Официальная цена Claude Opus 5.5 | Claude Opus 5.5 на APIYI | GPT-6.2 Sol на APIYI |
|---|---|---|---|---|
| Вход | $2 | $4 | $4 | Пока не добавлена |
| Выход | $10 | $20 | $20 | Пока не добавлена |
| Чтение из кэша | $0.10 | $0.20 | $0.2 | Пока не добавлена |
| Запись в кэш | 30 минут — $2.50; 12 часов — $5 | 5 минут — $5; 1 час — $8 (по пересказу прайса) | По списку моделей платформы | Пока не добавлена |
| Правила для сверхдлинного ввода | При превышении 272K — наценка на весь запрос | В источниках не отражено | По списку моделей платформы | Пока не добавлена |
Официальные цены GPT-6.2 Sol для короткого контекста: вход $2, выход $10, чтение из кэша $0.10. В анонсе сказано, что модель сохранила API-цены за токены от GPT-6.1 Sol. На APIYI модель GPT-6.2 Sol пока не добавлена — мы добавим её как можно скорее; точные модели и цены смотрите в списке моделей на платформе.
Официальные цены Claude Opus 5.5: вход $4, выход $20. Цена чтения из кэша $0.20 и цены записи в кэш (5 минут — $5, 1 час — $8) взяты из пересказа прайса Anthropic; по цене записи ориентируйтесь на официальную страницу Anthropic. В общей таблице моделей APIYI (данные на 2026-11-17 15:54, UTC+8) обе модели — claude-opus-5-5 и claude-opus-5-5-thinking — уже в наличии, платформенные цены: $4 / $20 / $0.2. Все эти пункты можно проверить прямо в списке моделей на APIYI apiyi.com.
Важный момент: gpt-6.1-sol ($2 / $10 / $0.1) и gpt-6-sol ($2 / $10 / $0.2), которые сейчас видны в общей таблице APIYI, — это не 6.2. Их цены нельзя принимать за платформенную цену GPT-6.2 Sol, и о возможностях 6.2 они ничего не говорят.
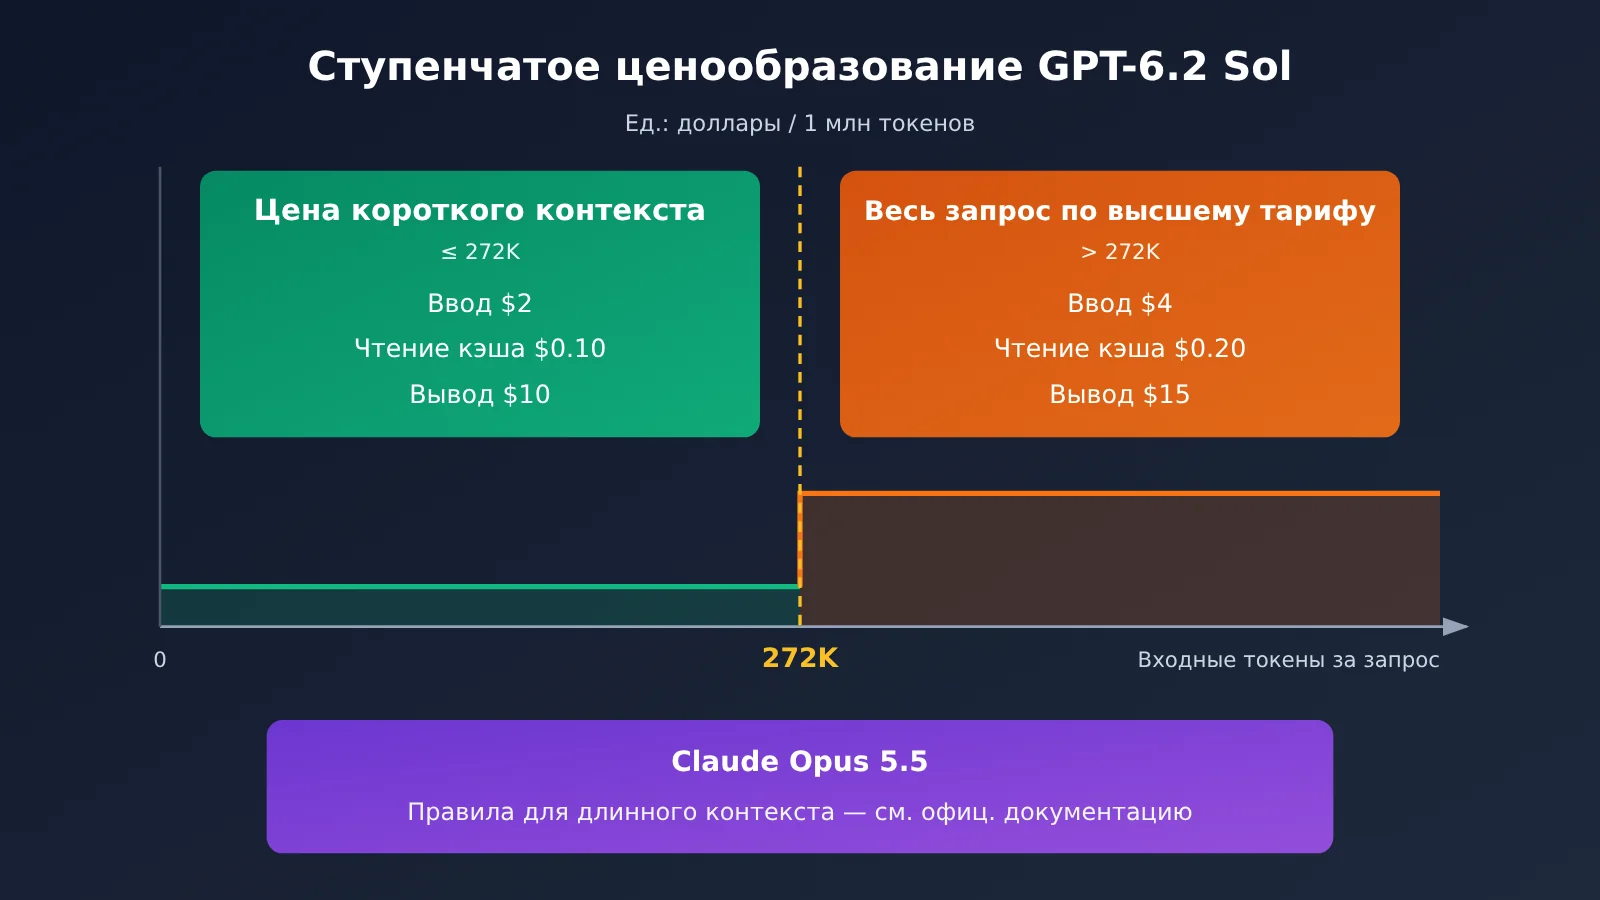
Правила тарификации всего запроса у GPT-6.2 Sol при 272K
На странице моделей OpenAI прямо сказано: если входные данные одного запроса превышают 272K токенов, цена входа и кэша удваивается, а выход считается как 1.5× от цены короткого контекста. Причём тарифицируется весь запрос по новой цене, а не только превышающая часть. В пересчёте на Sol это выглядит так: вход — $4, чтение кэша — $0.20, выход — $15.
Это правило сильно влияет на задачи с длинными документами. Если ваши типичные запросы часто балансируют около отметки 272K, заявленное преимущество «примерно вдвое дешевле» по прейскуранту заметно сокращается. Есть ли у Opus 5.5 похожее правило для длинного контекста — в источниках этой статьи об этом не сказано, поэтому лучше сначала заглянуть в документацию Anthropic, а уже потом сравнивать.
Кроме того, Batch у Sol стоит 50% от стандартной цены, а Fast — 2× от стандартной цены при той же длине контекста. Ultrafast до 2027-02-28 (по тихоокеанскому времени) стоит 3× от стандартной цены, а с 2027-03-01 — уже 6×.
Примерный расчёт одного запроса по официальным ценам
Чтобы было нагляднее, ниже — чисто математический пример по прейскуранту, и он не отражает никакой реальный счёт. Допустим, в одном запросе 100 тыс. токенов на входе и 10 тыс. на выходе, без кэша: Sol — примерно $0.20 + $0.10 = $0.30, Opus — примерно $0.40 + $0.20 = $0.60.
У этого примера два допущения: обе модели расходуют одинаковое число токенов на одной и той же задаче, а сам запрос не превышает 272K. На практике расход reasoning-токенов зависит от модели, интенсивности рассуждений и конкретной задачи, поэтому реальную стоимость нужно посчитать на своей задаче — прогоните её хотя бы раз и сравните.
Показатели возможностей GPT-6.2 Sol и Claude Opus 5.5: две системы измерения — читаем раздельно
У цифр возможностей два источника: первый — независимое тестирование Artificial Analysis, второй — официальные данные из релизных материалов OpenAI и страниц моделей. У этих двух наборов разные задачи, режимы рассуждений и методики подсчёта затрат, поэтому ниже они перечислены раздельно — без сведения к единому выводу.
Независимый сводный индекс Artificial Analysis (Intelligence Index v5.0.1)
| Модель и режим рассуждений | Сводный индекс | Стоимость одной задачи по сводному индексу | Примечание |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 57 | $1.01 | На 2 балла выше GPT-6.1 Sol |
| GPT-6.2 Sol (Xhigh) | 56 | не указана отдельно | независимый источник |
| GPT-6.2 Sol (High) | 55 | не указана отдельно | независимый источник |
| GPT-6.2 Sol (Medium) | 53 | не указана отдельно | независимый источник |
| GPT-6.2 Sol (Low) | 41 | не указана отдельно | независимый источник |
| Claude Opus 5.5 (максимальный режим) | 59 | нет данных в материалах статьи | из той же публикации |
$1.01 у Sol — это лишь средняя стоимость выполнения одной задачи в рамках этого сводного индекса, а не единая цена для всех задач, и её нельзя брать и делить на цифры затрат из других источников. Стоимости одной задачи для Opus 5.5 в этом индексе в исходных материалах нет, поэтому в статье мы её не высчитываем.
В той же независимой статье приведены ещё несколько заслуживающих внимания детальных результатов. В Coding Agent Index (Codex harness, Max) Sol на 3 балла ниже GPT-6.1 Sol — в основном из-за SWE-Atlas-QnA-AA, где отставание составило 14 баллов: модель чаще пропускает ключевые факты. Уровень галлюцинаций AA-Omniscience (Max) у Sol — 55%. В исследовательском превью AA-Robotics v0.1 Sol набирает 78. Сравнительных цифр для Opus 5.5 по этим детальным показателям нет, так что они помогают понять лишь сильные и слабые стороны самого Sol.
Официальные данные OpenAI о GPT-6.2 Sol (самоотчёт)
Все цифры ниже взяты из релизных материалов OpenAI — это официальный самоотчёт, и сравнивают в нём модель в основном с продуктами самой OpenAI, а не с Claude Opus 5.5:
- FrontierCode 2.0 (от Cognition; проверяет, примут ли мейнтейнеры изменения, внесённые в реальные кодовые базы): разрыв между Sol и GPT-6.2 Astra — менее 0,5 балла, при этом Sol стоит примерно в пять раз дешевле; обе модели работали в режиме Max.
- LifeVal (собственный набор повседневных задач OpenAI): Sol набирает больше, чем GPT-6 Astra, при стоимости примерно в семь раз ниже.
- GDPval v2 (внутренний официальный бенчмарк): Sol выше GPT-6.1 Sol на 5,3 балла.
- AA-3D, Elo по слепой оценке людей (приводится со слов OpenAI): у Sol — 1259.
Почему эти два набора цифр нельзя складывать
Сторонний агрегированный индекс считается на максимальном режиме рассуждений по фиксированному набору задач, а официальный самоотчёт — это по большей части относительные формулировки вроде «на сколько выше предыдущего поколения» и «во сколько раз дешевле». У двух подходов разные бенчмарки, разные режимы рассуждений и разная методика подсчёта стоимости. Если склеить «агрегированный балл ниже на 2 очка» с «почти догнал Astra в одном из официальных тестов», никакого вывода в духе «Sol в целом сильнее» или «Opus в целом сильнее» из этого не выйдет.
Более практичный способ читать эти данные: сторонний агрегированный балл показывает, где обе модели примерно находятся в универсальных смешанных задачах, а официальные самоотчёты говорят о том, какие сценарии OpenAI целенаправленно оптимизировала в Sol — например, повседневные задачи и задачи на принятие изменений в код. В конечном счёте решать всё равно должна производительность на ваших собственных задачах.
Различия в спецификациях и протоколах GPT-6.2 Sol и Claude Opus 5.5
Помимо оценок и цен, способ подключения часто оказывается решающим фактором: именно от него зависит, получится ли переключиться прямо сейчас. В таблице ниже — различия двух моделей по спецификациям и эндпоинтам.
| Параметр | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Входные модальности | Текст, изображения (аудио и видео не поддерживаются) | В официальных материалах отдельно не указано |
| Контекстное окно | 1 050 000 (макс. ввод 922 000) | 1M |
| Максимальный вывод | 128 000 | 128K |
| Дата среза знаний | 2026-06-01 | 2026-06 |
| Интенсивность рассуждений | Поддерживаются токены рассуждений; API не принимает effort = none | По умолчанию effort = medium |
| Официальные эндпоинты | Chat Completions, Responses, Batch | Anthropic Messages |
| Эндпоинты APIYI | Пока недоступна | chat, messages |
Если ваш инструментарий завязан на протокол Messages от Claude — например, Claude Code или агент, написанный на базе Anthropic SDK, — то Opus 5.5 на APIYI доступен сразу через два эндпоинта: chat и messages, а группы включают ClaudeCode, Claude_Reverse, Claude_Enterprise, Default и SVIP. Переключение сводится практически к замене base URL и API-ключа.
GPT-6.2 Sol работает через Chat Completions и Responses от OpenAI. На официальной странице модели прямо сказано, что Realtime, Assistants, дообучение, генерация изображений, видео и голос не поддерживаются — с такими задачами к ней обращаться не стоит.
GPT-6.2 Sol или Claude Opus 5.5: рекомендации по сценариям
Выбирать по типу задач надёжнее, чем по общему баллу. Ниже разберём два типа сценариев, а под конец сведём всё в одну таблицу.
Сценарии, где выбирать Claude Opus 5.5
- Нужен именно протокол Claude: ваш код уже построен на Anthropic Messages или завязан на инструменты вроде Claude Code — переделка под другой протокол обойдётся дороже, чем разница в цене за токен.
- Запуск нужен прямо сейчас: Opus 5.5 уже доступна на APIYI, можно подключаться немедленно, не дожидаясь выхода новой модели.
- Общий балл — жёсткий критерий: ваши задачи близки к универсальным смешанным бенчмаркам, а те самые 2 балла на максимальном уровне рассуждений реально влияют на результат.
Сценарии, где сначала стоит посмотреть на GPT-6.2 Sol
- Повседневные массовые задачи с высокой чувствительностью к цене: официальная цена за короткий контекст примерно вдвое ниже, чем у Opus, чтение кэша — тоже вдвое дешевле. Идеально для частых вызовов с активным переиспользованием промптов.
- Большинство запросов укладывается в 272K: только так вы стабильно получаете цену короткого контекста и избегаете надбавки на весь запрос.
- Вы уже в экосистеме протокола OpenAI: работаете через Responses или Chat Completions — при миграции менять придётся минимум.
Важно понимать: «сначала попробовать Sol» не значит, что у Sol выше общий балл — сторонние цифры говорят ровно наоборот. Речь о том, что при чувствительности к цене и повседневном характере задач имеет смысл сначала прогнать Sol на собственных задачах.
| Тип задач | Что выбрать | Основная причина | Где доступно |
|---|---|---|---|
| Инженерные задачи на протоколе Claude Code / Messages | Claude Opus 5.5 | Нативная поддержка протокола, переделка не нужна | APIYI apiyi.com, уже доступна |
| Продакшн-задачи, требующие немедленного запуска | Claude Opus 5.5 | Доступна уже сейчас | APIYI, уже доступна |
| Частые повседневные задачи, кэш и переиспользование промптов | GPT-6.2 Sol | Официальные цены на ввод, вывод и чтение кэша примерно вдвое ниже | OpenAI API; на APIYI пока недоступна |
| Работа с длинными документами свыше 272K | Обе модели — считать по фактическому расходу токенов | У Sol действует правило надбавки на весь запрос | Ориентируйтесь на списки моделей каждой платформы |
| Вопрос-ответ, где критичен пропуск ключевых фактов | Сначала провести прицельное тестирование | У Sol просадка на SWE-Atlas-QnA-AA (по сторонним данным) | Ориентируйтесь на списки моделей каждой платформы |
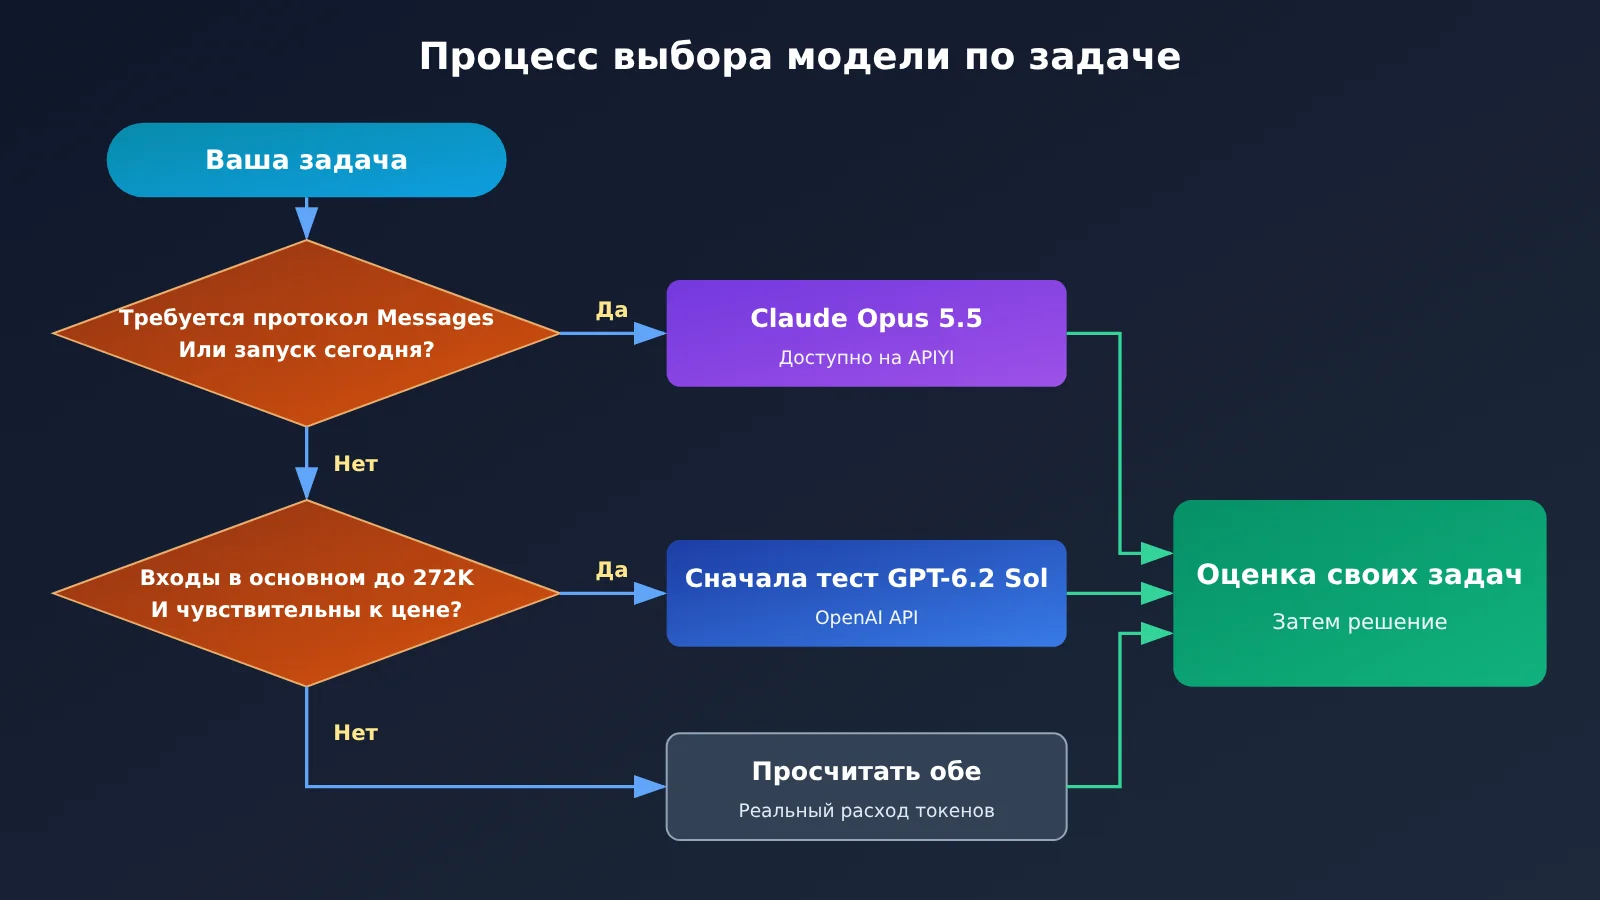
Быстрый старт с GPT-6.2 Sol и Claude Opus 5.5
Сейчас напрямую через APIYI можно вызывать Claude Opus 5.5. Шаги подключения описаны ниже — всё сводится к изменению настроек, дополнительные зависимости не понадобятся:
- Зарегистрируйтесь на APIYI и создайте API-ключ — новым пользователям доступен бесплатный тестовый лимит.
- Установите в клиенте base URL
https://api.apiyi.com/v1— это адрес OpenAI-совместимого интерфейса. - В поле имени модели укажите
claude-opus-5-5; если нужен явный процесс рассуждений, возьмитеclaude-opus-5-5-thinking. - Если у вас клиент в стиле Anthropic, работайте напрямую с эндпоинтом messages; при использовании OpenAI SDK — с эндпоинтом chat.
- Прогоните 5–10 реальных рабочих запросов, зафиксируйте количество токенов на вход, выход и попадания в кэш, а затем по ценам платформы $4 / $20 / $0.2 посчитайте стоимость одной задачи.
Идентификатор модели GPT-6.2 Sol — gpt-6.2-sol. Официально её можно вызывать через OpenAI API, к тому же она уже открыта в ChatGPT Work и Codex для тарифов Plus, Pro, Enterprise и Edu. На APIYI эта модель пока не добавлена, но мы скоро её подключим; актуальные модели и цены смотрите в списке моделей на платформе. А до того момента не используйте gpt-6.1-sol вместо неё для оценки — это не одна и та же модель.
🚀 Быстрый старт: рекомендуем сначала на APIYI (apiyi.com) прогнать
claude-opus-5-5на бесплатном лимите и записать расход токенов для своих задач. Когдаgpt-6.2-solпоявится на платформе, повторите прогон с тем же набором запросов и тем же base URL, поменяв только имя модели, — тогда стоимость и качество обеих моделей можно будет сравнить в одной таблице.
Рекомендации по выбору между GPT-6.2 Sol и Claude Opus 5.5
💡 Как выбрать: если вам нужен протокол Claude и возможность вызывать модель уже сегодня — берите Claude Opus 5.5; если хочется повседневную модель с более низкой официальной ценой — присмотритесь к GPT-6.2 Sol, но только не утверждайте, что его общий балл выше. В конечном счёте тестируйте на собственных задачах: через единый интерфейс APIYI на apiyi.com обе модели работают с одним и тем же кодом вызова — при переключении достаточно поменять имя модели.
На практике стоит учесть три момента. Во-первых, при тестировании уровень рассуждений у обеих моделей должен совпадать: сторонние общие баллы получены на максимальном уровне, а у Opus по умолчанию стоит medium — при разных уровнях меняются и баллы, и расход токенов. Во-вторых, для задач со стабильным префиксом промпта обязательно закладывайте в расчёты кэш: цена чтения из кэша у обеих моделей составляет одну двадцатую цены входных токенов, и при высоком проценте попаданий разница в счетах может как вырасти, так и сократиться. В-третьих, для задач с длинными документами обязательно отдельно просчитывайте случаи, когда объём превышает 272K.
Часто задаваемые вопросы (FAQ)
В1: Что собой представляют GPT-6.2 Sol и Claude Opus 5.5 и какое у них позиционирование?
GPT-6.2 Sol — модель, которую OpenAI выпустила 2026-11-17. Она принимает на вход текст и изображения, а выдаёт текст; контекстное окно — 1 050 000 токенов. Официально она позиционируется как модель для эффективного решения повседневных и реальных рабочих задач. Claude Opus 5.5 — модель от Anthropic: контекстное окно 1M, максимальный вывод 128K, уровень рассуждений по умолчанию — medium.
В2: Кто сильнее — GPT-6.2 Sol или Claude Opus 5.5?
Одним общим баллом на этот вопрос не ответить. В стороннем сводном индексе Artificial Analysis у Sol на уровне Max — 57 баллов, а лучший результат Opus — 59. В официальных результатах Sol выделяется в FrontierCode 2.0, LifeVal и других тестах, но сравнивается там в основном с моделями самой OpenAI. Советуем оценивать модели под конкретную задачу, а не выбирать по общему баллу.
В3: Можно ли уже сейчас вызвать GPT-6.2 Sol через APIYI?
Пока нельзя. В общей таблице моделей APIYI (на 2026-11-17 15:54, UTC+8) и в открытом интерфейсе прайсинга модели `gpt-6.2-sol` нет. GPT-6.2 Sol ещё не добавлен на платформу — мы добавим его как можно скорее; актуальные названия моделей и цены смотрите в списке моделей платформы.
В4: Какая цена и какие эндпоинты у Claude Opus 5.5 на APIYI?
Обе модели — `claude-opus-5-5` и `claude-opus-5-5-thinking` — уже доступны. Цены на платформе: вход $4, вывод $20, чтение из кэша $0.2 (за 1 миллион токенов). Эндпоинты поддерживают chat и messages. Вызывать можно тем же API-ключом от APIYI (apiyi.com), в качестве base URL укажите `https://api.apiyi.com/v1`.
В5: Можно ли напрямую брать стоимость задачи $1.01 у Sol для своих расчётов?
Нет. $1.01 — это средняя стоимость, которую Artificial Analytics измерил на наборе задач сводного индекса при максимальном уровне рассуждений (Max); она относится только к этому набору тестов. Длина ваших задач и объём рассуждений будут другими — другой будет и стоимость. Стоимость одной задачи для Opus 5.5 на этом индексе в материалах статьи не приводится, поэтому делить одно на другое тоже не получится.
В6: Как связана GPT-6.2 Astra с Sol и стоит ли её тоже рассматривать?
Astra — ещё одна модель из того же релиза. Официальные цены для короткого контекста: вход $8, чтение из кэша $0.40, вывод $40; в стороннем сводном индексе она набирает больше, чем Sol. На APIYI модель GPT-6.2 Astra пока не добавлена — мы добавим её как можно скорее; актуальные названия моделей и цены смотрите в списке моделей платформы. В этой статье сравниваются Sol и Opus 5.5, а Astra находится в другом ценовом диапазоне.
В7: Есть ли другие модели в том же ценовом диапазоне для сравнения?
Можно взглянуть на Gemini 4 Carbon. APIYI уже добавил gemini-4-carbon в каталог, и на странице платформы указана цена на период запуска: вход $2, чтение кэша $0.1, выход $10. Учтите: официальные цены Google с 2026-12-01 меняются на вход $4, выход $20 и чтение кэша $0.20. На странице платформы информации об этом повышении пока нет, так что после 1 декабря ориентируйтесь на список моделей APIYI на apiyi.com.
Q8: Какие известные ограничения у GPT-6.2 Sol?
На официальной странице модели прямо сказано: не поддерживаются аудио- и видеовход, нет поддержки Realtime, Assistants, дообучения (fine-tuning), генерации изображений и речи, а API не принимает уровень рассуждений (reasoning effort) со значением none. По данным третьих сторон, на SWE-Atlas-QnA-AA она на 14 баллов ниже, чем GPT-6.1 Sol, и чаще упускает ключевые факты. В официальной оценке alignment также отмечается, что серия 6.2 в двух тестах чаще не сообщает о блокирующих работу проблемах — например, об отсутствии файла или недоступности поискового инструмента.
GPT-6.2 Sol и Claude Opus 5.5: ключевые выводы Key Takeaways
- Общий балл: на максимальном уровне рассуждений по данным третьих сторон Sol (Max) набирает 57, Opus 5.5 — 59, разница — 2 балла.
- Официальные цены: у Sol вход $2, выход $10, чтение кэша $0.10; у Opus — $4, $20 и $0.20.
- Длинный контекст: когда разовый ввод Sol превышает 272K, весь запрос тарифицируется с надбавкой: вход и кэш — вдвое дороже, выход — в 1.5 раза.
- Разные методики: результаты, заявленные разработчиком, и сторонние бенчмарки используют разные задачи и уровни рассуждений — сводить их в один вывод нельзя.
- Доступность сейчас: Opus 5.5 уже есть в каталоге APIYI; Sol пока не добавлен — ориентируйтесь на список моделей платформы.
- Как выбирать: нужен протокол Claude и доступность прямо сейчас — берите Opus; для повседневных задач, чувствительных к цене за токен, сначала протестируйте Sol.
Итоги
Выбор между GPT-6.2 Sol и Claude Opus 5.5 сводится к трём пунктам:
- Смотрите на оценки и цену вместе: по независимым сводным оценкам Sol уступает на 2 балла, а его официальный прайс на короткий контекст — примерно вдвое ниже, чем у Opus. Ни один из этих факторов по отдельности не достаточен для решения.
- Выбирайте по задаче и протоколу: если задача зависит от протокола Claude или требует немедленного запуска — берите Opus 5.5; если важна цена за единицу, а запросы обычно укладываются в 272K, стоит сначала протестировать Sol.
- Считайте на своих задачах: стоимость одной задачи от независимых тестов относится только к их методике; реальная цена зависит от вашего потребления токенов, попаданий в кэш и уровня рассуждений.
На данном этапе самое практичное решение — сначала выстроить процесс тестирования на Opus 5.5, а когда Sol появится в продаже, прогнать тот же набор запросов и добрать сравнение. Рекомендуем использовать APIYI (apiyi.com): один API-ключ для одновременного управления несколькими моделями, а бесплатного лимита хватит на первый раунд проверки.
📚 Источники
-
Анонс OpenAI: примечания к релизу GPT-6.2 Astra и Sol и официальные самооценки
- Ссылка:
openai.com/index/introducing-gpt-6-2-astra-sol - Описание: сводка цен, зоны доступности и официальные сравнения по каждому пункту
- Ссылка:
-
Страница модели OpenAI gpt-6.2-sol: спецификации, эндпоинты и полные правила тарификации
- Ссылка:
platform.openai.com/docs/models/gpt-6.2-sol - Описание: цена записи в кэш, правило 272K на весь заказ, коэффициенты Batch / Fast / Ultrafast
- Ссылка:
-
Системная карта OpenAI: оценка безопасности и выравнивания
- Ссылка:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Описание: уровни по Preparedness Framework и выводы тестов на выравнивание
- Ссылка:
-
Статья независимой оценки от Artificial Analysis: результаты Intelligence Index v5.0.1
- Ссылка:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Описание: сводные баллы по каждому уровню рассуждений, детальные индексы и сравнение с максимальным уровнем Opus 5.5
- Ссылка:
-
Страница модели GPT-6.2 Sol на Artificial Analysis: стоимость одной задачи и другие метрики
- Ссылка:
artificialanalysis.ai/models/gpt-6-2-sol - Описание: стоимость одной задачи по сводному индексу — $1.01 (уровень Max)
- Ссылка:
-
Документация моделей Claude: спецификации Opus 5.5 и официальный прайс для сравнения
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview - Описание: цены на вход и выход Opus 5.5, контекстное окно, уровень рассуждений по умолчанию
- Ссылка:
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами на главной странице сайта APIYI; актуальные данные по моделям и ценам можно найти в общей таблице моделей в центре документации docs.apiyi.com